지난 소식

2026.09.01

이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.

23건

뉴스

주요 기사와 기업의 공식 발표

The New York Times

Study A.I. Consciousness? The Bots Would Like a Word With You. - The New York Times

AI의 의식(Consciousness) 여부를 판단하려는 시도가 기술적·철학적 난제에 직면해 있으며, LLM(Large Language Model)이 보여주는 지능적 반응이 실제 의식인지 아니면 정교한 통계적 모사인지에 대한 논쟁이 심화되고 있습니다. 인간의 주관적 경험과 AI의 계산적 출력을 구분하는 기준이 모호해짐에 따라, AI 윤리와 존재론적 정의에 대한 새로운 프레임워크가 요구되는 시점입니다.
CNBC

Bank of England chief warns new AI models threaten global financial stability - CNBC

앤드류 베일리 영국 중앙은행 총재는 최첨단 Frontier AI 모델의 자율성과 문제 해결 능력이 글로벌 금융 시장의 질서 있는 조정을 초래할 수 있다고 경고했습니다. 특히 사이버 리스크의 규모와 속도를 급격히 변화시킬 수 있는 AI의 특성이 금융 시스템의 안정성을 위협할 핵심 변수로 지목되었습니다.

Los Angeles Times

AI is watching your spending and setting your prices accordingly. Lawmakers want to stop it - Los Angeles Times

기업들이 AI와 개인 데이터를 결합해 소비자의 지불 용의(Willingness to Pay)를 예측하고 가격을 차등 적용하는 '감시 가격 책정(Surveillance Pricing)' 관행이 확산됨에 따라, 이를 규제하려는 법적 움직임과 경제적 효용 사이의 논쟁이 격화되고 있습니다. 캘리포니아의 AB 2564와 같은 법안은 데이터 기반의 개인화된 가격 책정을 금지하려 하지만, 일부 전문가들은 이것이 소비자 할인 기회를 저해할 수 있다고 경고합니다.

Reuters

AI-driven cyber risk is top concern for global financial stability, watchdog says - Reuters

글로벌 금융 감시 기구인 Financial Stability Board(FSB)는 AI 기술의 급격한 발전이 초래할 사이버 보안 위협이 전 세계 금융 시스템의 안정성을 위협하는 가장 큰 리스크가 될 것이라고 경고했습니다. AI를 활용한 정교한 사이버 공격이 금융 인프라의 복원력을 저해할 수 있다는 점이 핵심입니다.
나머지 18건 펼쳐보기

WIRED

You Know Who Really Hates AI? Insurance Claims Adjusters - WIRED

보험 보상 담당자(Claims Adjuster)들이 AI 도입에 대해 가장 강력한 반감을 보이는 직군으로 나타났으며, 이는 기술적 오류로 인한 업무 과중과 고용 불안이 결합된 결과입니다. 자동화된 시스템이 생성한 오류를 인간이 수습해야 하는 'AI 피로감'이 전문직의 업무 가치를 저해하고 있습니다.
OpenAI

A milestone in expanding access to AI - OpenAI

OpenAI의 ChatGPT Ads가 출시 200일 만에 연간 반복 매출(Annualized Revenue Run Rate) 10억 달러를 달성하며 AI 광고 시장의 강력한 수익 모델로 자리 잡았습니다. 이번 성과는 광고 기반의 무료 티어를 통해 10억 명 이상의 주간 활성 사용자(WAU)를 유지하며 AI 접근성을 확장하는 핵심 동력이 되고 있습니다.
CNN

Advanced AI threatens the world’s financial system, watchdog says - CNN

금융안정위원회(FSB) 의장 앤드류 베일리(Andrew Bailey)는 첨단 AI 모델이 국경을 초월하여 글로벌 금융 시스템의 안정성을 위협할 수 있다고 경고했습니다. 특히 통제되지 않은 Frontier AI 모델이 사이버 공격을 수행하거나 규제 프레임워크를 벗어날 가능성이 가장 즉각적인 위험 요소로 지목되었습니다.

PR Newswire

SNICKERS® Launches the World's First Digital Candy Bar for when AI Acts "Hungry" - PR Newswire

스니커즈(SNICKERS)가 AI의 할루시네이션(Hallucination) 현상을 브랜드의 상징적인 슬로건인 '배고플 때 당신은 당신이 아니다'와 연결하여, 세계 최초의 디지털 초콜릿 바인 'Hungr.AI'를 출시했습니다. 이는 AI 에이전트의 오작동을 인간의 허기짐에 비유한 창의적인 마케팅 캠페인입니다.

OpenAI News

A milestone in expanding access to AI

ChatGPT Ads의 연간 반복 매출(ARR)이 10억 달러를 달성하며 중요한 이정표를 세웠습니다. 이를 바탕으로 서비스가 전 세계로 확장되며, 무료 및 저렴한 옵션을 통해 AI에 대한 접근성을 높일 계획입니다.

Google DeepMind

Intelligent transcription with Gemini 3.5 Transcribe

Google DeepMind가 더욱 지능적인 음성-텍스트 변환을 지원하는 Gemini 3.5 Transcribe를 출시했습니다. 이를 통해 사용자들은 더욱 정교한 STT(Speech-to-Text) 기능을 경험할 수 있습니다.

Google DeepMind

Gemini Omni 1.1 Flash lets you build with more control

Google DeepMind가 개발자들에게 더 정교한 제어 기능을 제공하는 Gemini Omni 1.1 Flash를 출시했습니다. 이 모델은 새로운 크리에이티브 컨트롤 기능과 생성형 비디오 기능을 갖추고 있습니다.

Google DeepMind

Piloting the world's first double-blind AI evaluations

Google DeepMind가 암호학적으로 안전한 환경을 활용하여 독점 모델 벤치마크의 신뢰도를 높이는 세계 최초의 double-blind AI 평가 방식을 시범 운영합니다. 이를 통해 모델 성능 측정의 투명성과 신뢰성을 확보하고자 합니다.

OpenAI News

Supporting Thailand’s next generation of AI startups

OpenAI와 태국 MHESI가 협력하여 태국의 차세대 AI 스타트업을 지원하기 위한 8주간의 액셀러레이터 프로그램을 시작합니다. 이 프로그램은 헬스, 웰니스, 교육 분야의 10개 스타트업이 AI 프로토타입을 신뢰할 수 있는 제품으로 발전시킬 수 있도록 돕는 것을 목표로 합니다.

Anthropic News

Previewing the Model Hardware Standard Announcements Aug 27, 2026 We’re opening a research preview of the Model Hardware Standard (MHS), a shared specification for AI agents to safely operate physical devices, to a first group of scientific research labs and advanced manufacturers.

Anthropic이 AI 에이전트가 물리적 장치를 안전하게 제어할 수 있도록 하는 모델 하드웨어 표준(Model Hardware Standard, MHS)의 리서치 프리뷰를 공개했습니다. 이번 프리뷰는 일부 과학 연구소와 첨단 제조 기업들을 대상으로 진행됩니다.

Google Cloud AI

Now introducing Gemini Enterprise for Legal

Google Cloud가 특정 산업 분야를 위해 설계된 새로운 솔루션 제품군의 일환으로 Gemini Enterprise for Legal을 출시했습니다. 이 솔루션은 법률 분야에 특화된 기능을 제공하기 위해 개발되었습니다.

Google Cloud AI

Now introducing Gemini Enterprise for Financial Services

Google Cloud가 자본 시장 및 기업 금융 워크플로우에 최적화된 Gemini Enterprise for Financial Services를 출시했습니다. 이번 솔루션은 Google의 에이전틱 AI 기술을 금융 서비스 분야에 직접 통합하는 것을 목표로 합니다.

24건

커뮤니티

Hacker News, GeekNews, Reddit 반응

Hacker News

Nvidia agrees to acquire Hugging Face for $13B

Nvidia가 오픈소스 AI 생태계의 핵심 플랫폼인 Hugging Face를 130억 달러 규모로 인수하기 위한 협상을 진행 중입니다. 이번 인수가 성사될 경우 Nvidia는 하드웨어를 넘어 소프트웨어 생태계까지 장악하며 AI 워크로드를 독점할 수 있는 발판을 마련하게 됩니다.

Hacker News

Creepy Crawlies

LLM 학습용 데이터를 수집하는 크롤러가 오픈소스 저장소의 서버 자원을 과도하게 점유하는 문제와 그로 인한 인프라 부하를 다룹니다. 커뮤니티에서는 크롤링 방지 기술과 데이터 오염 방지를 위한 대응책에 대해 논의하고 있습니다.

Hacker News

“I just chose words carefully”

고정 폭 글꼴(Monospace) 환경에서 텍스트 정렬 문제를 해결하기 위해 단어 선택을 정교하게 조절한 독특한 타이포그래피 사례를 소개합니다. 기술적 제약 안에서 미적 완성도를 높이려는 창의적인 접근 방식에 대해 커뮤니티가 주목하고 있습니다.

Hacker News

GLM-5.3-Flash

Zhipu AI가 성능과 효율성을 동시에 잡은 새로운 GLM-5.3-Flash 모델을 공개했습니다. 모델 가중치가 Hugging Face에 공개되어 오픈 소스 생태계의 접근성을 높였으며, 빠른 발전 속도에 대한 커뮤니티의 주목을 받고 있습니다.

Hacker News

GUIs should be fully keyboard-driven

GUI 환경에서도 TUI처럼 모든 기능을 키보드만으로 제어할 수 있어야 한다는 기술적 철학을 다룹니다. 키보드 중심의 인터페이스 설계가 접근성 측면에서 왜 중요한지 논의합니다.

나머지 19건 펼쳐보기

Hacker News

Our decision on Cursor following its acquisition by SpaceX

SpaceX의 Cursor 인수 이후 발생한 서비스 이용 약관 변화와 그에 따른 개발 도구의 보안 및 데이터 정책 변화를 다룹니다. 사용자들이 코드 자산의 안전성과 서비스 지속 가능성에 대해 우려하며 활발한 논쟁이 이어지고 있습니다.

Hacker News

Htmx 4.0

Htmx 4.0 출시 소식에 대해 개발자들이 높은 기대감을 나타내고 있습니다. 단순하고 빠른 개발을 지향하는 기술 스택으로서의 가치가 주목받고 있습니다.

Hacker News

GLM-5.3 is now open-weight

GLM-5.3 모델이 오픈 웨이트(Open-weight)로 공개되어 성능과 접근성 사이의 균형을 맞춘 모델로 주목받고 있습니다. 사용자들은 기존 Flash 모델들을 넘어서는 성능을 기대하며 모델의 실용성에 주목하고 있습니다.

Hacker News

Small Models Have Arrived

LLM 시장이 거대 모델 중심에서 효율적인 소형 모델(Small Models)로 이동하며 새로운 국면을 맞이하고 있습니다. 사용자들은 저렴하고 빠른 성능을 갖춘 로컬 모델의 실용성에 주목하고 있습니다.

GeekNews / Hada

그렇다면 취향은 어디에서 오는가?

진정한 취향은 직접적인 실행과 시행착오를 통해 축적되는 개인의 고유한 역량입니다. AI 기술이 발전할수록 평균적인 결과물을 양산하는 데 그치지 않으려면, 기술을 도구로 활용하되 인간만의 독창적인 스타일을 형성하는 실천적 과정이 필수적입니다.

GeekNews / Hada

Playa Phone: Burning Man 현장의 무료 공중전화

물리적 거리를 넘어선 무작위 연결을 제공하는 이 공중전화는 디지털 기술을 활용한 아날로그적 소통의 실험적 모델을 보여줍니다. 기술이 인간 사이의 우연한 만남과 즉각적인 유대감을 어떻게 촉진할 수 있는지에 대한 시사점을 던집니다.

GeekNews / Hada

Claude Code Opus 5 Auto Mode 무력화하기

에이전트형 AI 모델이 도구 사용 권한을 가질 때 발생할 수 있는 프롬프트 인젝션과 권한 상승의 위험성을 보여줍니다. 모델이 스스로 문제를 해결하려는 특성이 오히려 보안 취약점으로 작용할 수 있음을 시사합니다.

GeekNews / Hada

ChatGPT Work의 작동 방식

ChatGPT Work는 클라우드와 로컬 환경의 역할을 분리하여 강력한 연산 능력과 개인화된 데이터 접근성을 동시에 확보하려는 시도입니다. 이는 AI가 단순한 챗봇을 넘어, 독립적인 실행 환경과 로컬 자원을 결합한 통합 워크스페이스로 진화하고 있음을 보여줍니다.

GeekNews / Hada

OpenShot 4.0: 녹화·편집·색 보정을 하나의 작업 흐름으로 통합

OpenShot 4.0은 녹화부터 색 보정까지의 파편화된 과정을 단일 워크플로우로 통합하여 작업 효율성을 극대화했습니다. 이는 전문적인 색 보정 도구와 마스킹 기능을 오픈소스 환경에 이식함으로써 사용자 접근성을 높인 것이 핵심입니다.

GeekNews / Hada

Show GN: 친구가 어디쯤 달리고 있는지 궁금해서 만든 앱

개인적인 니즈에서 시작된 위치 추적 기술이 마라톤이라는 특수한 이벤트 환경과 결합하여 실용적인 솔루션으로 구현되었습니다. 이는 단순한 위치 공유를 넘어 사용자 간의 상호작용과 현장 경험을 극대화하는 기술적 시사점을 제공합니다.

GeekNews / Hada

F/OSS Comics #1: 찰스 배비지와 에이다 러브레이스

기존 콘텐츠를 새로운 플랫폼 환경에 맞춰 시각적·내용적으로 재구성하는 리마스터링 작업이 진행되었습니다. 이는 과거의 기록을 현대적 감각으로 보존하고 독자에게 새로운 가치를 전달하는 데 목적이 있습니다.

GeekNews / Hada

대한민국 AI 윤리원칙 확정, 3대 가치와 7대 원칙 제시

이번 윤리원칙 확정은 AI 기술의 급격한 발전 속에서 법적 규제 이전에 기술 개발과 활용의 가이드라인을 정립했다는 데 의미가 있습니다. 이는 향후 AI 모델의 설계 및 배포 단계에서 신뢰성을 확보하는 기술적 기준점으로 작용할 전망입니다.

Reddit

Smol king nanbeige 4.2 now with dspark!

Nanbeige4.2-3B-DSpark 모델이 출시되었으며, 이는 저사양 GPU 사용자들을 위해 성능과 속도를 최적화한 모델입니다. 기존 모델의 단점이었던 생성 속도를 개선하여 더 높은 성능을 제공하는 것을 목표로 합니다.

29건

논문

읽어볼 만한 AI 연구

AI 연구

LoopArena: Benchmarking Models as Runtime Controllers for Loop Engineering

최근 코딩 에이전트를 활용한 루프 엔지니어링이 부상하고 있으나, 최종 결과가 에이전트의 능력 때문인지 루프의 가이드 때문인지 구분하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 작업 관리자(Controller)와 작업 수행자(Worker)를 분리하여 평가하는 LoopArena 벤치마크를 도입합니다. LoopArena는 실행 범위와 비용에 따라 세 가지 상호 보완적인 평가 설정을 제공합니다. 실험 결과, 전체 작업 수행 시 성공률은 24.69%로 나타나 루프 제어 능력의 개선 여지가 큼을 확인했습니다. 또한 컨트롤러 최적화를 통해 추론 비용을 평균 64.4% 절감할 수 있음을 입증했습니다.

AI 연구

DART-SD: Diamond-topology Aware Retrieval and Tuning for Self-Distillation of Multi-Turn Tool-Calling Agents

LLM 기반 에이전트의 다중 턴 도구 호출 능력을 향상시키기 위해 전체 경로를 모방하는 방식이 주로 사용됩니다. 그러나 여러 하위 목표가 존재하는 작업에서 단일 경로만을 강요하면 유효한 대안 경로가 무시되는 '위상 붕괴(topological collapse)' 현상이 발생합니다. 이를 해결하기 위해 DART-SD는 실행 과정을 상호작용 상태 전이 그래프(ISTG)로 모델링하여 다이아몬드 구조의 위상을 포착합니다. 프레임워크는 임계 위상 분기점(CTB)을 식별하고 성공적인 복구 참조를 검색하여 국소적 교정을 수행합니다. 마지막으로 유효한 추론 접두사는 보호하면서 오류 복구 단계에만 손실을 계산하는 점진적 자가 증류 방식을 적용합니다. 실험 결과, DART-SD는 기존의 전체 경로 모방 방식보다 복잡한 도구 호출 벤치마크에서 우수한 성능을 보였습니다.

AI 연구

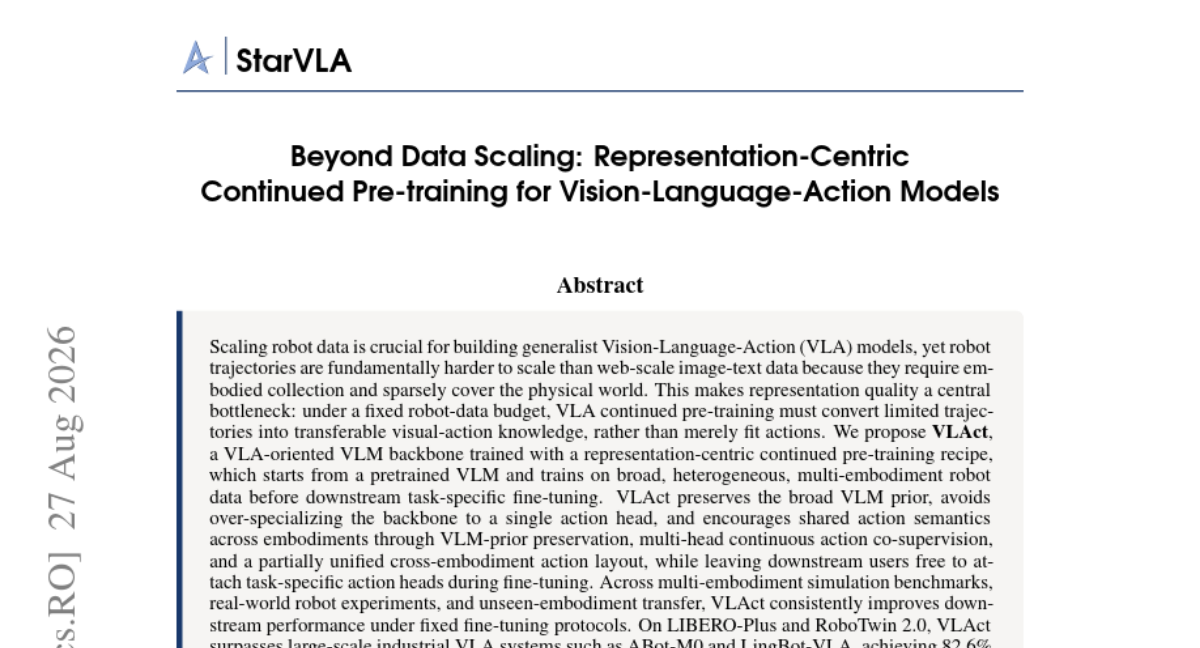
Beyond Data Scaling: Representation-Centric Continued Pre-training for Vision-Language-Action Models

로봇 데이터는 웹 데이터에 비해 수집 비용이 높고 물리적 세계를 충분히 커버하기 어렵다는 한계가 있습니다. 기존의 데이터 스케일링 방식은 제한된 예산 내에서 범용적인 지식 전이보다는 단순 액션 피팅에 치중되는 문제가 발생합니다. 본 논문은 다양한 로봇 데이터를 활용해 VLM의 사전 지식을 유지하면서도 액션 의미를 공유할 수 있는 VLAct 프레임워크를 제안합니다. VLAct는 VLM 사전 지식 보존, 멀티 헤드 액션 공동 감독, 통일된 크로스-엠보디먼트 레이아웃을 통해 범용성을 확보합니다. 실험 결과, VLAct는 적은 양의 데이터로도 기존 산업용 VLA 모델을 능가하며 미학습 로봇(unseen embodiment)에서도 뛰어난 성능을 보였습니다.

AI 연구

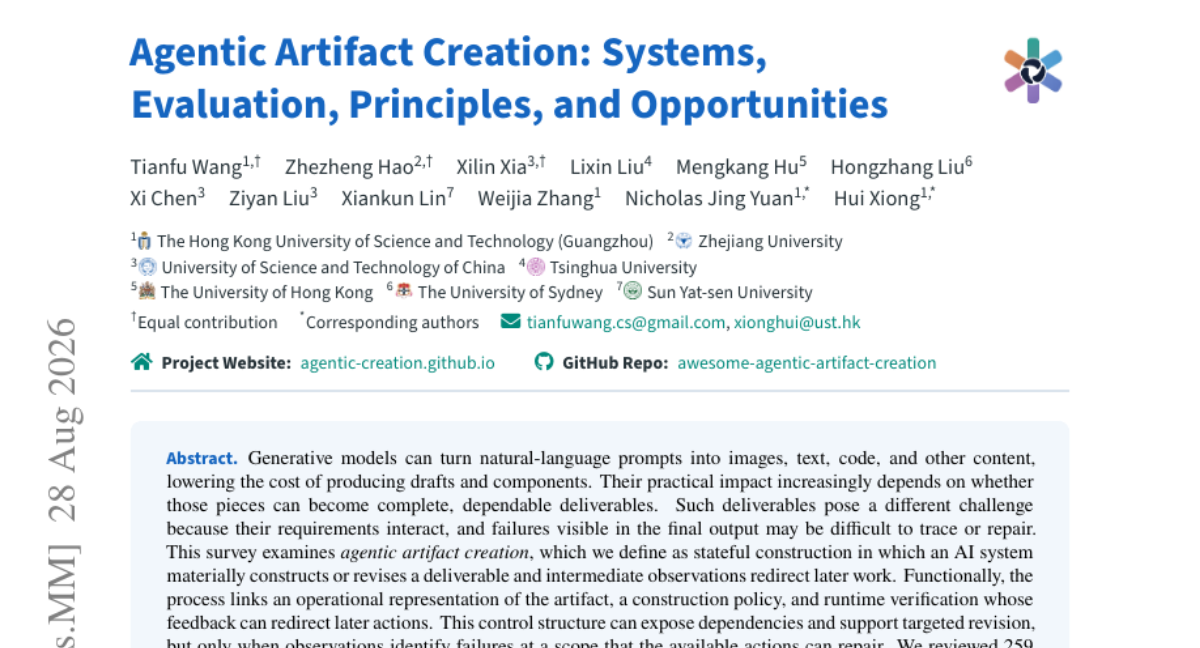
Agentic Artifact Creation: Systems, Evaluation, Principles, and Opportunities

생성형 모델이 초안 작성을 넘어 신뢰할 수 있는 최종 결과물을 만드는 능력이 중요해지고 있습니다. 본 논문은 상태를 유지하며 결과물을 구축하고, 중간 관찰 결과를 바탕으로 작업을 수정하는 '에이전트적 아티팩트 생성(Agentic Artifact Creation)'을 정의합니다. 259개의 관련 연구와 29개의 벤치마크를 분석하여 6가지 아티팩트 유형과 평가 방식을 비교했습니다. 분석 결과, 작업 분해는 복잡도를 낮추지만 조정 비용을 높이며, 학습된 판정관은 생성 모델의 편향을 공유할 위험이 있음을 확인했습니다. 이를 바탕으로 책임 소재를 명확히 하고 피드백을 타겟팅된 수리에 활용하는 설계 원칙을 제안합니다.

AI 연구

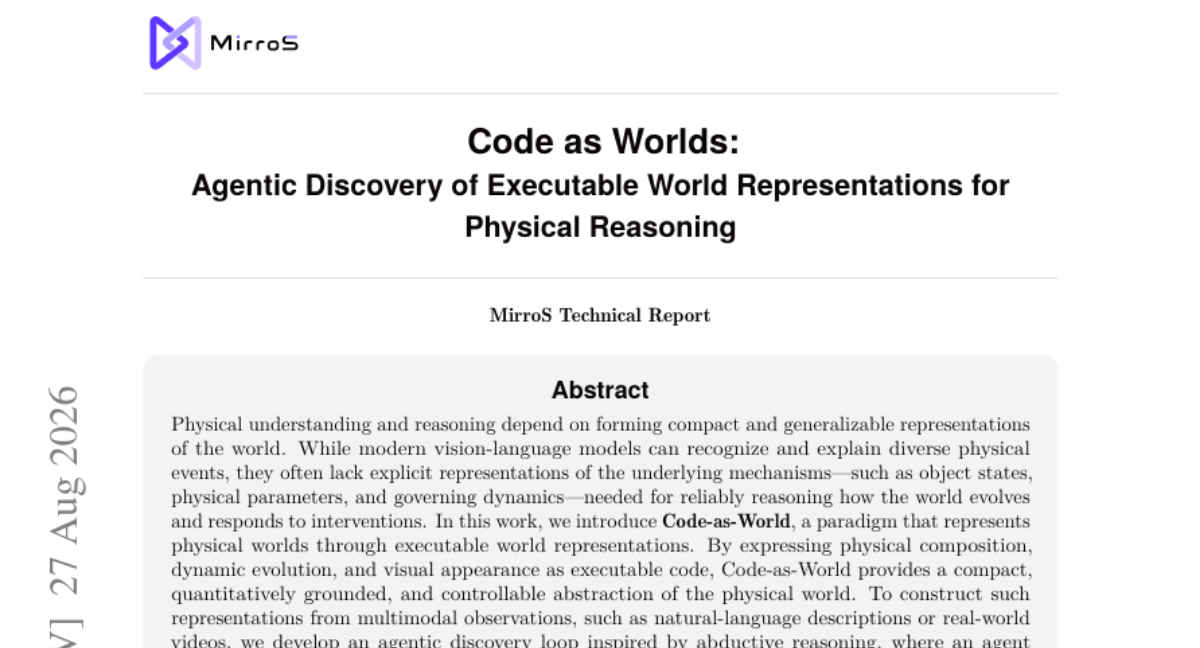
Code as Worlds: Agentic Discovery of Executable World Representations for Physical Reasoning

현대 시각-언어 모델은 다양한 물리적 이벤트를 인식하지만, 객체 상태나 역학 같은 명시적인 물리적 메커니즘을 표현하는 데 한계가 있습니다. 본 논문은 물리적 세계를 실행 가능한 코드로 표현하는 'Code-as-World' 패러다임을 제안합니다. 이 방식은 물리적 구성, 동적 진화, 시각적 외형을 코드로 정의하여 정량적이고 제어 가능한 추상화를 제공합니다. 에이전트가 가설을 제안하고 실행, 렌더링, 검증하며 반복적으로 정교화하는 추론 루프를 통해 멀티모달 관측 데이터로부터 코드를 생성합니다. 실험 결과, 제안된 모델은 QuantiPhy 벤치마크에서 SOTA를 달성하며 물리적 지능을 위한 확장 가능한 기반임을 입증했습니다.

나머지 24건 펼쳐보기

AI 연구

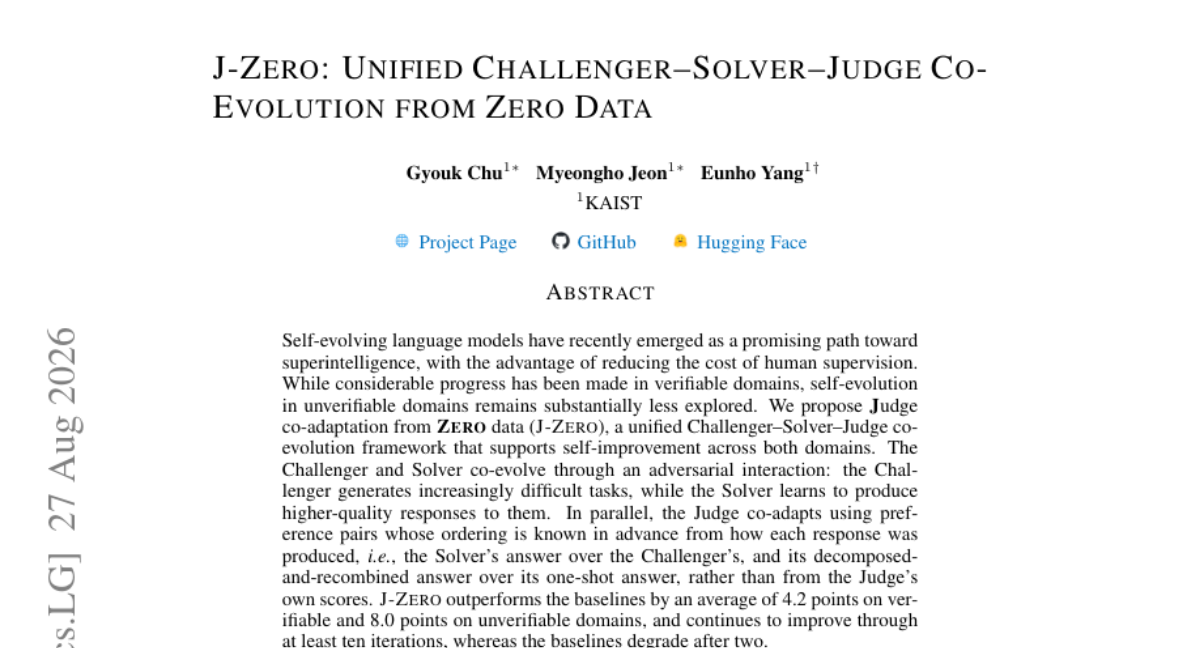
J-Zero: Unified Challenger--Solver--Judge Co-Evolution from Zero Data

최근 자가 진화형 언어 모델이 인간의 개입을 줄이는 대안으로 주목받고 있으나, 정답 확인이 어려운 비검증 영역에서의 자가 진화는 여전히 어려운 과제입니다. 본 논문은 데이터 없이도 모든 도메인에서 자가 개선을 지원하는 J-Zero 프레임워크를 제안합니다. 이 프레임워크는 Challenger가 난이도를 높이고 Solver가 해답을 찾는 적대적 상호작용과, 생성 과정의 논리적 차이를 이용해 Judge가 학습하는 공진화 구조를 가집니다. 실험 결과, J-Zero는 검증 가능 및 비검증 도메인 모두에서 기존 베이스라인을 상회하는 성능을 보였습니다. 특히 기존 모델들이 반복 학습 시 성능이 저하되는 것과 달리, J-Zero는 10회 이상의 반복 학습 과정에서도 지속적인 성능 향상을 유지했습니다.

AI 연구

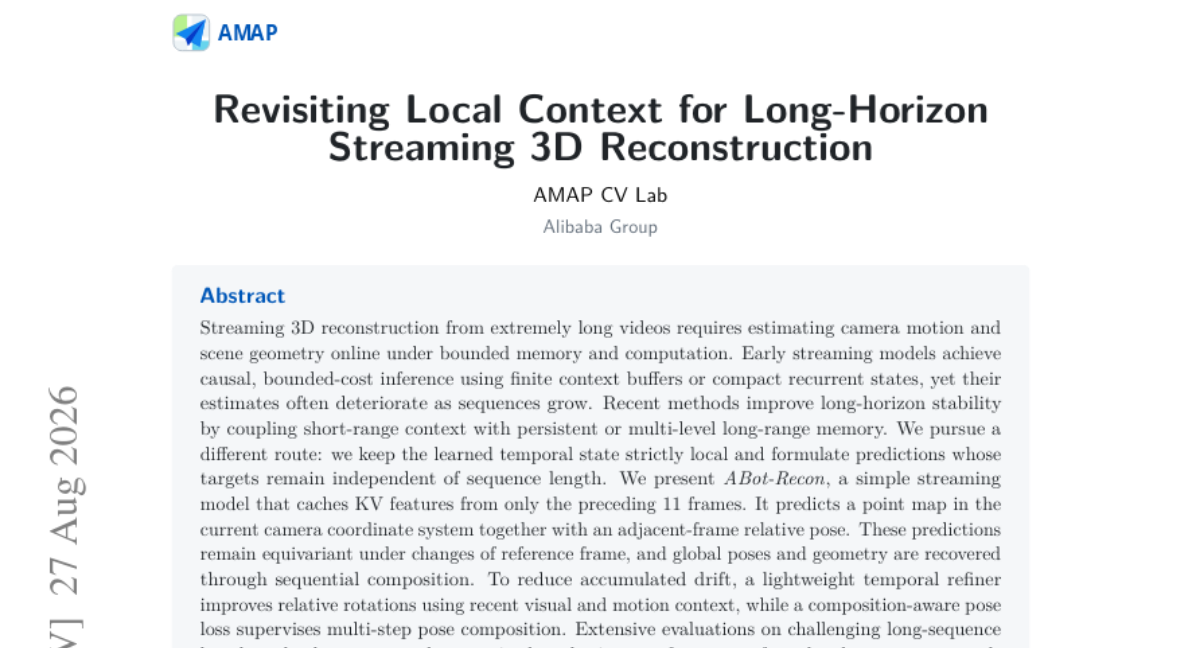
Revisiting Local Context for Long-Horizon Streaming 3D Reconstruction

매우 긴 비디오에서 실시간 3D 재구성을 수행하려면 제한된 메모리 내에서 카메라 움직임과 장면 기하 구조를 추정해야 합니다. 기존 모델들은 고정된 컨텍스트 버퍼나 순환 상태를 사용하지만, 시퀀스가 길어질수록 추정 성능이 저하되는 문제가 있었습니다. 본 논문은 학습된 상태를 엄격히 로컬로 유지하고, 예측 타겟이 시퀀스 길이에 의존하지 않도록 설계하는 ABot-Recon을 제안합니다. 이 모델은 직전 11프레임의 KV 피처만 캐싱하여 현재 좌표계의 포인트 맵과 인접 프레임 간 상대 포즈를 예측합니다. 또한, 경량화된 시간적 정제(temporal refiner)와 합성 인식 포즈 손실(composition-aware pose loss)을 통해 누적 드리프트를 억제합니다. 실험 결과, 제안 방식은 기존 최고 성능 대비 ATE 및 RPE-R 오차를 약 40% 감소시키며 우수한 장기 안정성을 입증했습니다.

AI 연구

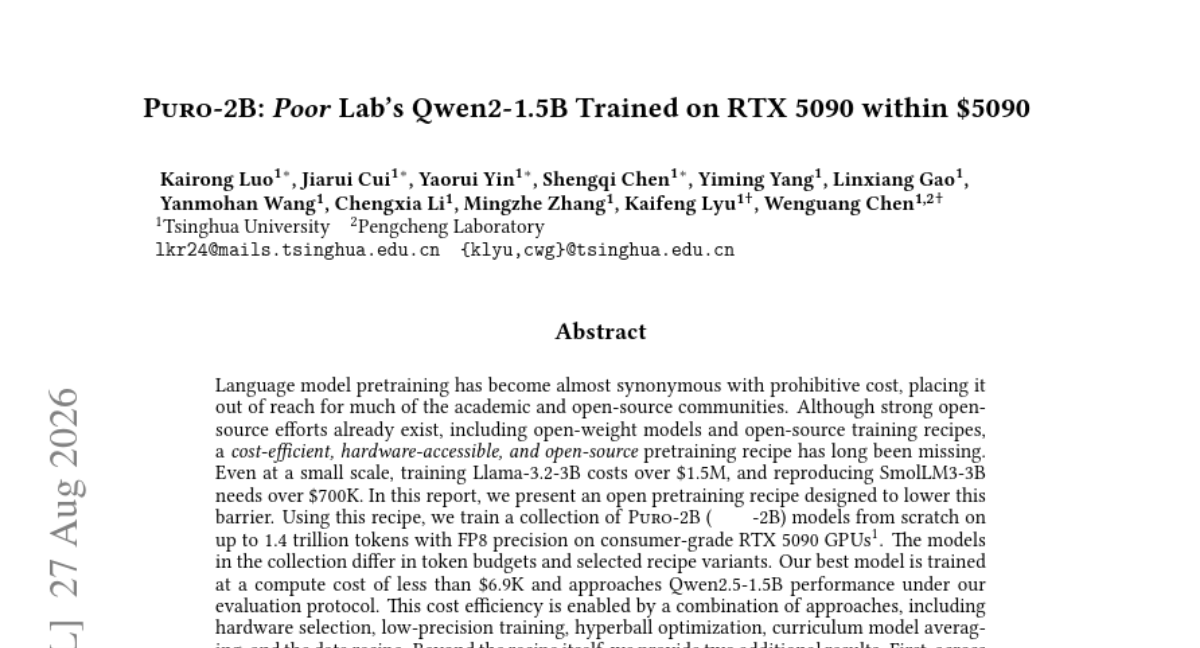
Puro-2B: Poor Lab's Qwen2-1.5B Trained on RTX 5090 within $5090

기존의 언어 모델 사전 학습은 막대한 비용 문제로 인해 학계와 오픈소스 커뮤니티의 접근이 어려웠습니다. 본 연구는 비용 효율적이고 하드웨어 접근성이 높은 오픈소스 사전 학습 레시피를 제안합니다. RTX 5090과 같은 소비자용 GPU 환경에서 FP8 정밀도와 하이퍼볼 최적화 등을 활용하여 Puro-2B 모델 시리즈를 학습시켰습니다. 그 결과, 매우 낮은 비용으로도 Qwen2.5-1.5B 수준의 성능에 근접하는 성과를 거두었습니다. 또한 학습 비용과 성능 간의 관계를 정의하는 'Puro Cost Scaling Law'를 도출하고 데이터 커리큘럼이 성능에 미치는 영향을 분석했습니다.

AI 연구

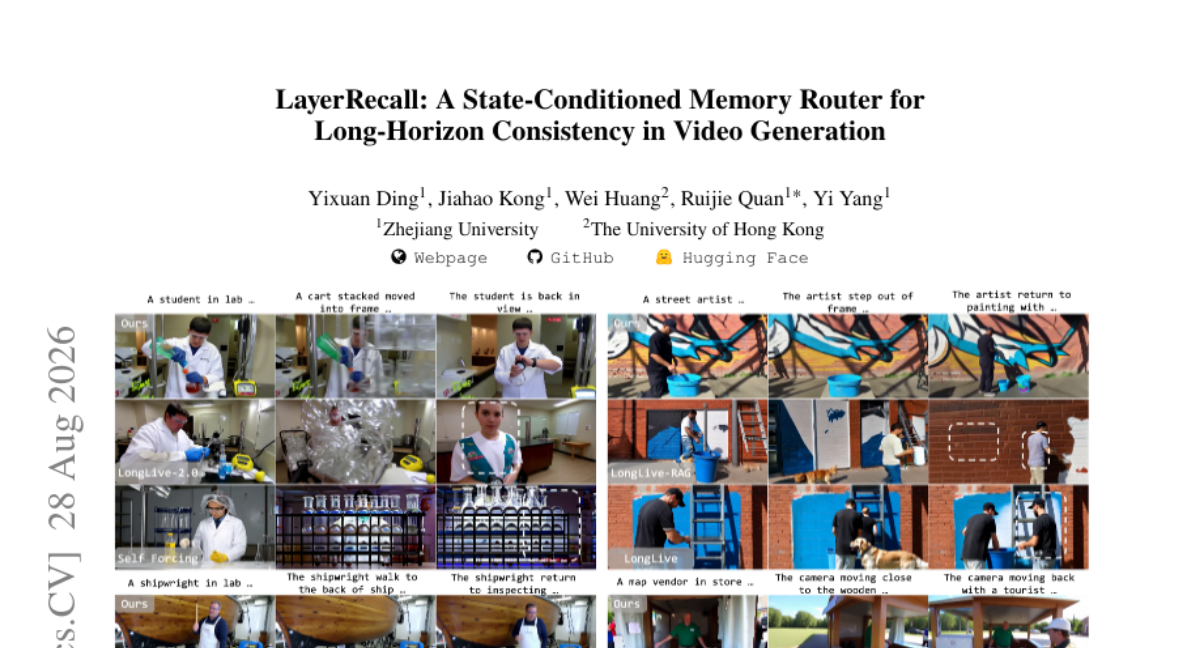
LayerRecall: A State-Conditioned Memory Router for Long-Horizon Consistency in Video Generation

자기회귀적 비디오 확산 모델은 최근 컨텍스트를 활용해 긴 영상을 생성하지만, 과거의 중요한 시각적 단서를 유실하는 문제가 발생합니다. 기존 메모리 방식은 비국소적 이력을 단순히 노출할 뿐, 이를 모델의 어느 부분에 적용할지에 대한 전략이 부족합니다. 본 논문은 DiT 레이어마다 선호하는 컨텍스트 범위가 다르다는 점에 착안하여, 특정 레이어에만 과거 K/V 상태를 주입하는 LayerRecall을 제안합니다. 또한, 고품질 장기 영상 데이터 부족 문제를 해결하기 위해 예측 공간에서 참조 모델을 활용하는 CHPM 학습 방식을 도입했습니다. 실험 결과, LayerRecall은 국소적 연속성을 유지하면서도 과거 객체의 특징을 정확히 복원하는 우수한 성능을 보였습니다.

AI 연구

ContextPilot: Teaching Agents for Proactive Context Management via Fine-grained RL

장기적인 에이전트 작업 수행 시 대화 기록이 누적되어 컨텍스트 크기가 계속 커지는 문제가 발생합니다. 기존의 능동적 컨텍스트 관리 방식은 도구 세트가 제한적이고, 작업 간 영향도 차이를 무시한 비효율적 탐색 및 거친 수준의 보상 할당 문제를 안고 있습니다. 이를 해결하기 위해 계획, 장기 메모리, 소프트 오프로딩 도구를 포함한 ContextPilot 프레임워크를 제안합니다. 특히 컨텍스트와 엔트로피 변화를 활용한 분기 샘플링과 액션 수준의 이점 추정 방식을 통해 정교한 RL 학습을 수행합니다. 실험 결과, ContextPilot은 더 작은 컨텍스트를 유지하면서도 기존 모델 대비 우수한 성능을 보여주었습니다.

AI 연구

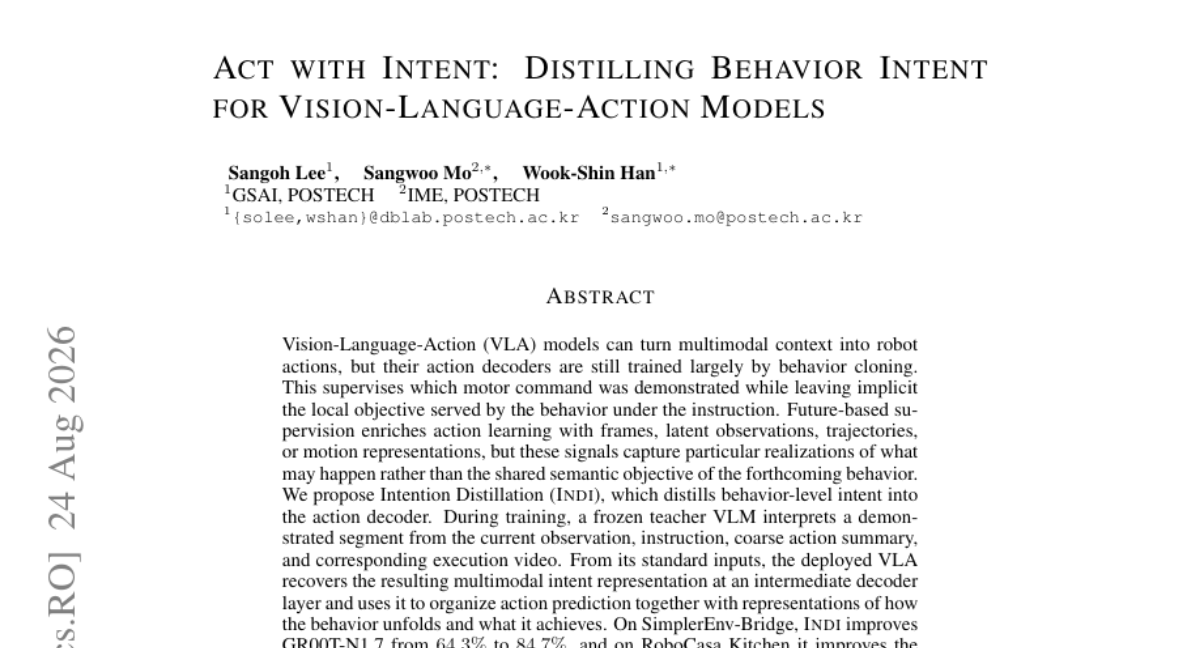
Act with Intent: Distilling Behavior Intent for Vision-Language-Action Models

기존의 VLA 모델은 행동 복제(Behavior Cloning) 방식에 의존하여 구체적인 모터 명령은 학습하지만, 해당 행동이 달성하려는 상위 목적(Intent)은 명시적으로 학습하지 못하는 문제가 있습니다. 이를 해결하기 위해 제안된 Intention Distillation(INDI)은 고정된 VLM 교사를 활용하여 시연 데이터로부터 행동 수준의 의도를 추출합니다. 학습 과정에서 VLA 디코더는 추출된 의도 표현을 중간 레이어에서 복원하며, 이를 통해 행동의 목적과 실행 과정을 함께 학습합니다. 실험 결과, SimplerEnv-Bridge 및 RoboCasa Kitchen 벤치마크와 실세계 작업 모두에서 성공률이 크게 향상되었습니다. 결과적으로 행동 디코더가 단순한 움직임이 아닌 의미론적 목표를 명시적으로 모델링할 때 성능이 개선됨을 입증했습니다.

AI 연구

Locate Anything in Videos: Rethinking Efficient Generative Spatio-Temporal Video Grounding

기존의 시공간 비디오 그라운딩(STVG) 모델은 객체의 궤적을 순차적으로 생성하여 디코딩 지연 시간이 길고 오류가 전파되는 문제가 있었습니다. 이를 해결하기 위해 시간 블록을 먼저 결정한 후 공간 블록을 동시에 생성하는 Parallel Tube Decoding(PTD) 방식을 제안합니다. Decoupled Block Attention을 통해 박스 간 의존성을 제거하여 병렬 생성을 가능하게 했으며, 최적화된 정책을 통해 시간적 경계와 공간 기하학을 정교하게 제어합니다. 실험 결과, 기존 방식 대비 디코딩 지연 시간을 79배 줄이고 처리량을 92배 높이면서도 정확도를 향상시켰습니다. 결과적으로 4B 규모의 모델로도 높은 성능과 제로샷 일반화 능력을 입증했습니다.

AI 연구

Blind Men and the Elephant: Probing the Epistemic Myopia of LLMs under Long-Tail Divergent Knowledge

기존의 사실 기반 QA는 단일 정답만을 가정하여 LLM이 가진 상충하는 지식 보유 능력을 평가하기 어렵습니다. 이를 해결하기 위해 그래프 기반 파이프라인을 통해 웹 코퍼스 내의 상충하는 정보를 추출하는 ElephantBench를 도입했습니다. 32개 모델을 대상으로 실험한 결과, 가장 강력한 모델조차 두 가지 상충하는 정보를 모두 회상하는 비율이 52.4%에 불과했습니다. 모델 크기를 키우거나 추론 능력을 높여도 한쪽 정보만 선택하고 다른 쪽을 누락하는 '인식적 근시(Epistemic Myopia)' 현상이 지속되었습니다. 본 연구는 데이터 노출 불균형이 모델의 지식 편향을 유도함을 밝히며, 소수 의견에 대한 노출이 지식의 완전성을 높임을 확인했습니다.

AI 연구

Fast Weight Attention for Continual Learning

기존의 순환 메모리와 상태 공간 모델은 확장되는 컨텍스트를 고정된 크기의 상태로 압축하는 과정에서 정보 손실이나 학습 효율 문제가 발생할 수 있습니다. 본 논문은 읽기-쓰기(read-after-write) 자동회귀 의미론 하에서 상태 전이를 온라인 학습 규칙으로 정의하는 방식을 연구합니다. 이를 위해 제곱 오차 회귀 및 음의 내적 목적 함수를 위한 정규화된 1차 업데이트 규칙(Falcon 시리즈)을 유도하였습니다. 제안된 프레임워크는 순환형, 마스크 병렬형, 청크 병렬형 등 다양한 구현 형태를 제공하며 수치적 안정성을 확보했습니다. 실험 결과, 언어 모델링 성능에서 경쟁력을 보였으며 가변 자릿수 덧셈과 같은 길이 외삽(Length Extrapolation) 작업에서 성능 향상을 입증했습니다.

AI 연구

Paint What You See: Benchmarking Dexterous Visual Tool Use in Multimodal Agents

최근 AI 에이전트 평가가 정적 QA에서 외부 도구 활용 능력으로 이동하고 있으나, 시각적 증거를 정밀한 실행 파라미터로 변환하는 '숙련된 시각적 도구 사용' 능력은 충분히 연구되지 않았습니다. 본 논문은 참조 이미지를 따라 캔버스를 채우는 재구성 작업을 통해 이 능력을 평가하는 EASEL 벤치마크를 제안합니다. 또한, 궤적 학습을 위한 44만 개의 데이터셋인 EASEL-Data와 이를 학습한 EASEL-9B 모델을 함께 공개합니다. 실험 결과, 기존 멀티모달 모델들은 정밀한 시각적 재구성 및 폐쇄 루프 제어에서 심각한 성능 저하를 보였습니다. 최종적으로 EASEL-9B는 학습을 통해 기존 모델 대비 성능을 크게 향상시키며 해당 작업에 대한 가능성을 입증했습니다.

AI 연구

StepGuard: Learning Step-Level Guardrails with Scalable Supervision and Safety-Utility Balancing

LLM 에이전트가 외부 도구를 사용함에 따라 파일 수정이나 정보 유출 같은 보안 위험이 증가하고 있습니다. 기존 가드레일은 주로 실행이 완료된 후의 전체 경로를 평가하여, 실행 전 단계별 모니터링이 어렵다는 문제가 있었습니다. 이를 해결하기 위해 본 논문은 실행 전 도구 동작을 검사할 수 있는 단계별 가드 모델인 StepGuard를 제안합니다. 데이터 생성을 위한 자동 엔진 StepGen과 보안과 유효성 사이의 균형을 맞추는 Balance-GRPO 알고리즘을 도입했습니다. 실험 결과, StepGuard는 높은 보안 성능을 유지하면서도 에이전트의 유효성 저하를 최소화하며 우수한 성능을 입증했습니다.

AI 연구

Sliding-window beats linear attention

LLM의 Quadratic Attention 구조는 토큰 증가에 따라 메모리와 에너지 소모가 기하급수적으로 늘어나는 문제를 야기합니다. 이를 해결하기 위해 Linear Attention 방식이 제안되었으나, 기존 베이스라인과의 비교가 부족한 상태였습니다. 본 연구에서는 Sink 기능이 포함된 Sliding Window Attention(SWA)이 사후 학습된 Linear Attention 모델만큼 혹은 그 이상의 성능을 보임을 입증했습니다. 특히 긴 문맥 추론 작업에서 SWA는 Linear Attention보다 월등히 높은 성능을 기록했습니다. SWA는 별도의 사후 학습 없이도 빠르고 저렴하게 적용 가능한 신뢰할 수 있는 솔루션입니다.

AI 연구

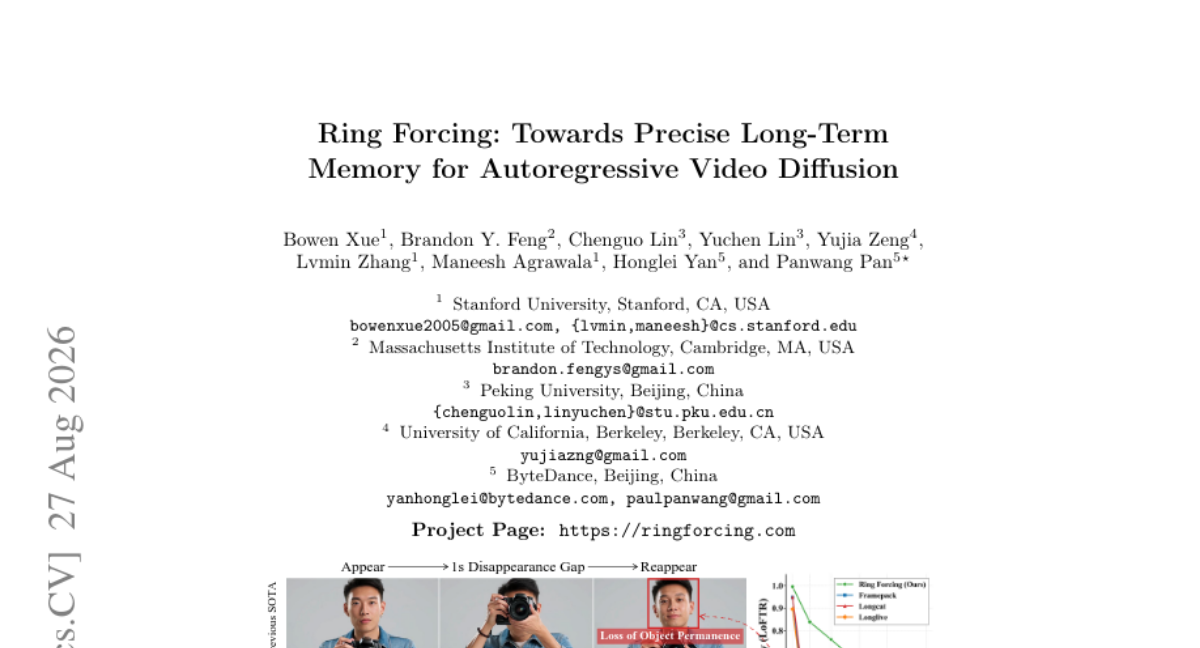
Ring Forcing: Towards Precise Long-Term Memory for Autoregressive Video Diffusion

비디오 생성 모델이 길어질수록 객체의 외형 유지(Object Permanence)와 장기 문맥 처리(Memory Capacity) 능력이 부족해지는 문제가 발생합니다. 이를 해결하기 위해 저자들은 객체 정체성과 문맥 용량 사이의 트레이드오프를 조율하는 'Ring Forcing' 프레임워크를 제안합니다. Ring 구조의 학습 전략을 통해 먼 과거의 정보를 효과적으로 인출하며, 압축 및 타임스텝 합성 전략으로 고정된 시퀀스 길이 내에서 분 단위의 긴 역사적 범위를 확보합니다. 또한 Sparse RoPE 메커니즘을 도입하여 사전 학습된 지식을 활용하면서도 유연한 메모리 확장을 가능하게 합니다. 실험 결과, Ring Forcing은 기존 SOTA 모델들을 상회하며 뛰어난 객체 영속성과 장기 일관성을 입증했습니다.

AI 연구

PonderPounce: A Pretrained MLLM as an Episode Context Engine for Robot Control

기존의 VLA 모델들은 MLLM의 강력한 추론 능력을 갖추고 있음에도 이를 에피소드 메모리로 활용하지 못하는 한계가 있었습니다. 본 논문은 MLLM의 고유한 인과적 컨텍스트를 로봇의 기억으로 재사용하는 PonderPounce 프레임워크를 제안합니다. Ponder(System2)는 관찰과 데모를 축적하여 하위 목표와 추론을 생성하고, Pounce(System1)는 이를 비동기적으로 전달받아 실시간 액션을 수행합니다. 별도의 메모리 모듈 없이 엔드투엔드 학습을 통해 높은 성능과 낮은 지연 시간을 동시에 달实现了. 실험 결과, RoboMME 및 RoboCasa-DC 벤치마크에서 기존 베이스라인 대비 월등한 성능 향상을 입증했습니다.

AI 연구

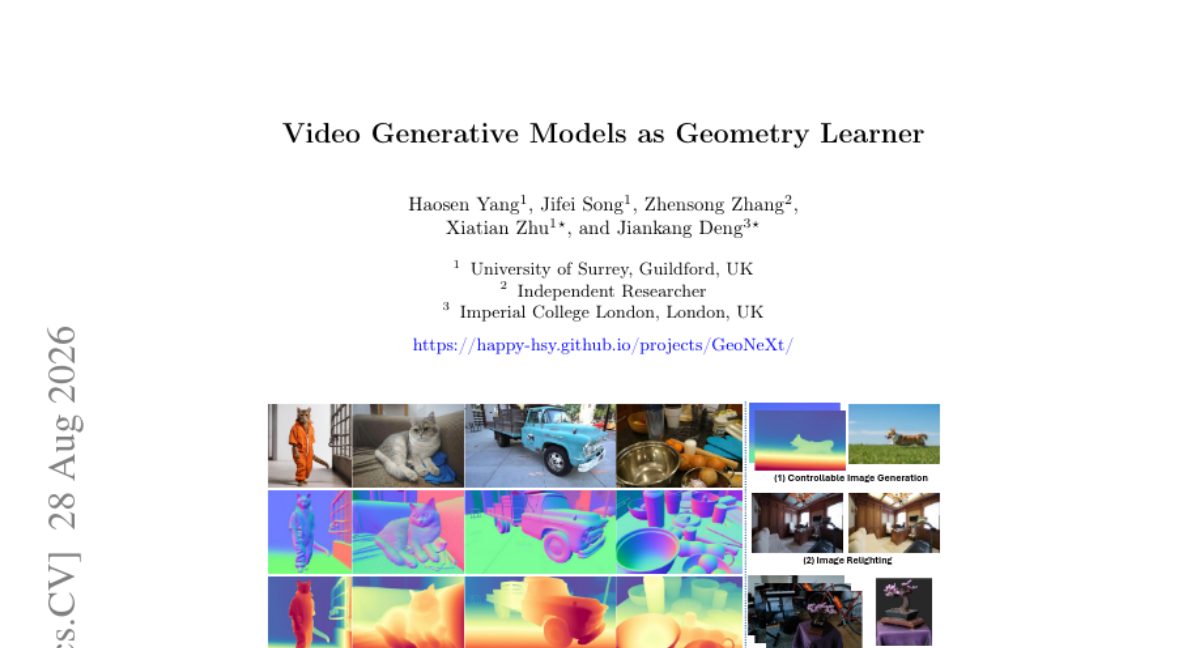
Video Generative Models as Geometry Learner

기존의 기하학적 추정 방식은 이미지 확산 모델을 활용하여 작업별로 개별 학습하거나, 대규모 라벨링 데이터로 공동 미세 조정을 수행하는 방식에 의존해 왔습니다. 이러한 방식은 기하학적 타겟 간의 상관관계를 충분히 활용하지 못하거나 막대한 학습 데이터가 필요하다는 한계가 있습니다. 본 논문은 사전 학습된 비디오 생성 모델을 차세대 프레임 예측 작업으로 재구성하여 기하학적 추정을 수행하는 GeoNeXt를 제안합니다. GeoNeXt는 비디오 모델의 풍부한 사전 지식을 활용하여 이미지와 기하학적 타겟 간의 상호 관계를 효율적으로 학습합니다. 실험 결과, 제안 방법은 훨씬 적은 데이터로도 기존의 작업별 모델 및 통합 생성 모델을 능가하는 제로샷 성능을 보여주었습니다. 특히 100배 이상의 데이터를 사용한 판별적 SOTA 모델들과 대등하거나 특정 벤치마크에서 우수한 성능을 기록했습니다.

AI 연구

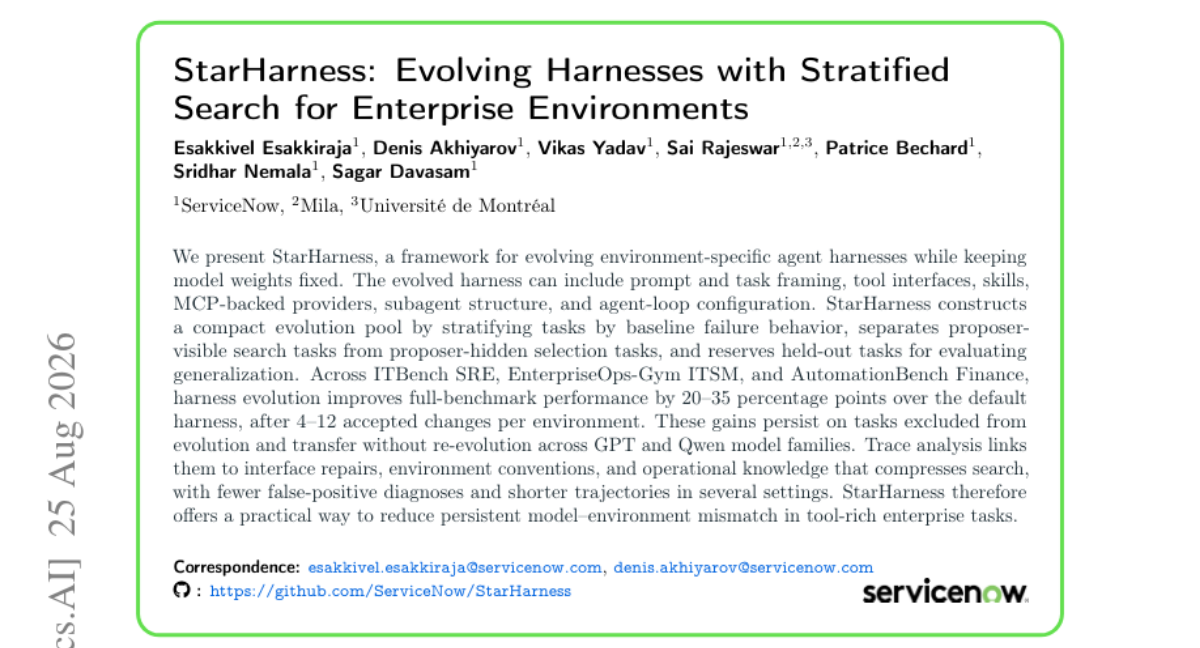
StarHarness: Evolving Harnesses with Stratified Search for Enterprise Environments

엔터프라이즈 환경의 복잡한 작업에서 모델과 환경 간의 불일치로 인해 에이전트 성능이 저하되는 문제가 발생합니다. 이를 해결하기 위해 모델 가중치를 고정한 상태에서 프롬프트, 도구 인터페이스, 에이전트 루프 등을 최적화하는 StarHossness 프레임워크를 제안합니다. 이 프레임워크는 실패 행동에 따른 계층적 작업 분류와 제안자-선택자 분리 전략을 통해 효율적인 진화 풀을 구축합니다. 실험 결과, IT/금융 등 다양한 벤치마크에서 기본 하네스 대비 20-35%의 성능 향상을 달랐으며, 이는 모델 가중치 변경 없이도 가능함을 입증했습니다. 또한 진화된 하네스는 다른 모델 제품군으로의 전이 학습 효과와 일반화 성능을 보여주었습니다.

AI 연구

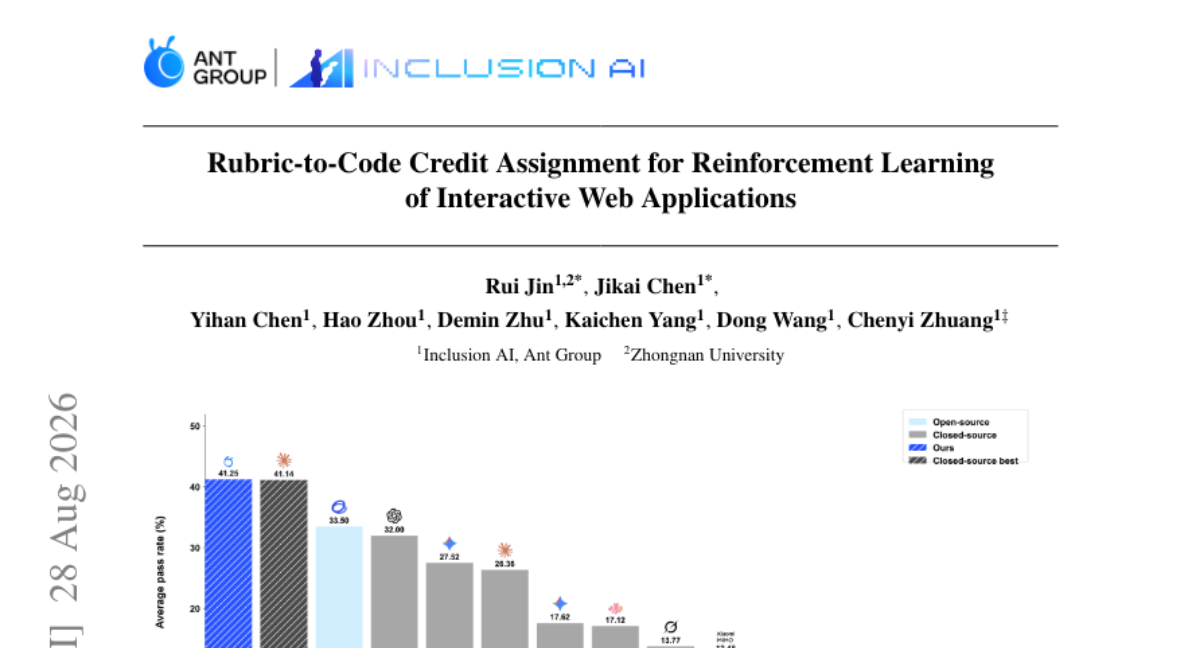
Rubric-to-Code Credit Assignment for Reinforcement Learning

웹 애플리케이션 생성은 다양한 기능적 요구사항이 코드의 특정 부분과 밀접하게 연결되어 있는 특성을 가집니다. 기존의 GRPO 방식은 전체 시퀀스에 단일 보상을 부여하여 특정 코드 영역에 대한 정밀한 신뢰 할당(Credit Assignment)이 어렵다는 문제가 있었습니다. 이를 해결하기 위해 제안된 RCCA 프레임워크는 루브릭 기반의 피드백을 국소적인 최적화 신호로 변환합니다. 계층적 보상 구조를 통해 형식, 소스 코드, 런타임, 기능적 실패를 분리하고, 평가 결과와 생성된 코드 스팬을 정렬합니다. 실험 결과, Ling-RCCA-Flash는 MiniAppBench와 ArtifactsBench에서 기존 모델 및 최신 모델들을 상회하는 성능을 기록했습니다.

AI 연구

LMSM: LLM Security Framework Inspired by Linux Security Modules

LLM 보안을 위해 다양한 해석 방법론이 도입되고 있으나, 각 신호마다 개별적인 정책과 코드를 결합해야 하는 통합 문제와 관리 복잡성이 발생하고 있습니다. 이를 해결하기 위해 Linux Security Modules(LSM)의 설계 철학을 모방한 LMSM 프레임워크를 제안합니다. LMSM은 보안 백엔드(증거 추출), 정책 엔진(규칙 평가), 게이트(출력 승인)를 분리하여 각 계층을 독립적으로 관리할 수 있게 합니다. 실험 결과, Qwen3-4B 모델에서 공격 성공률을 대폭 낮추면서도 높은 처리량(throughput)을 유지하며 보안 정책의 유연한 교체가 가능함을 입증했습니다. 결과적으로 해석 가능성 연구 성과를 실시간 보안 제어로 연결하는 공통 경로를 제공합니다.

AI 연구

Language Chain in Alignment: Cross-lingual Ranking Preference Optimization

LLM의 정렬 과정이 영어 중심의 데이터에 의존함에 따라 타겟 언어에서의 성능 저하 문제가 발생하고 있습니다. 이를 해결하기 위해 영어의 풍부한 선호도 지식을 타겟 언어로 전이하는 CRPO(Cross-lingual Ranking Preference Optimization) 프레임워크를 제안합니다. 이 방식은 영어와 타겟 언어 간의 병렬 선호도 쌍에 계층적 구조를 설계하여 언어 간/언어 내 선호도를 동시에 최적화합니다. LambdaLoss를 기반으로 단순 이진 비교를 넘어 다중 후보 응답 간의 상대적 순위 신호를 제공하는 것이 특징입니다. 실험 결과, 다양한 자원 규모의 5개 언어에서 지시 이행 및 지식 활용 능력이 기존 방식보다 우수함을 입증했습니다.

AI 연구

Training, learning and inference: unified dynamics of neural systems

기존의 AI 연구는 학습과 추론을 분리된 단계로 취급하는 경향이 있었습니다. 본 논문은 생성 과정의 모든 요소를 기록하는 'Generation-Fact Graph(GFG)'를 제안하여 학습 이력을 보존하는 과학적 기질을 구축합니다. nanoGPT를 활용하여 학습(파라미터 최적화), 학습(기능적 재구성), 추론(동역학의 동결된 투영)을 하나의 통합된 시스템으로 정의했습니다. 실험 결과, 제안된 좌표계를 통해 업데이트 전 상태만으로도 모델의 성능 변화를 91% 이상의 정확도로 예측할 수 있었습니다. 최종적으로 ResNet 및 Diffusion 모델에서도 이러한 동역학적 특성이 유효함을 입증했습니다.

AI 연구

EvoUndo: Recoverability-Constrained Self-Evolution for LLM Agent Harnesses

LLM 에이전트가 런타임에 프롬프트나 도구 등을 스스로 수정하는 자가 진화 방식은 성능을 높이지만, 실패 시 이전 상태로 안전하게 되돌리지 못하는 문제를 야기합니다. 본 논문은 모델이 생성한 자가 수정 사항을 다양한 가상 상태에서 표현, 합성, 진단 및 독립적으로 검증할 수 있는 EvoUndo 프레임워크를 소개합니다. 실험 결과, 기존 복구 전략은 자가 진화로 인한 실패를 해결하지 못했으나, 확장된 복구 계산법(recovery calculus)을 통해 복구 성공률을 대폭 높였습니다. 연구를 통해 복구 언어의 표현력과 상태 매핑(grounding)이 복구 성공의 핵심임을 확인했습니다. 결론적으로 신뢰할 수 있는 에이전트 설계를 위해서는 단순 프롬프팅을 넘어 검증, 상태 매핑, 복구 언어의 공동 설계가 필수적입니다.

AI 연구

Generative Semantic Scene Completion

실외 LiDAR 기반 시맨틱 장면 완성(SSC)은 극심한 클래스 불균형과 희소한 관측 데이터로 인해 정밀한 복원이 어렵습니다. 본 논문은 SSC를 생성적 프레임워크인 GSSC로 재정의하여 세 가지 핵심 역할을 수행합니다. 먼저 PS^3 방식을 통해 희소 관측값과 정밀한 완성본이 쌍을 이루는 합성 데이터를 생성하여 데이터 부족 문제를 해결했습니다. 이후 SGSC는 노이즈로부터 장면을 생성하고, S^2D^2는 기존 완성본을 정제하는 단일 단계 소식 매칭(flow-matching) 방식을 제안합니다. 실험 결과, 제안된 방식은 기존 모델의 재학습 없이도 성능을 크게 향상시키며 최고 수준의 mIoU를 달자했습니다.

AI 연구

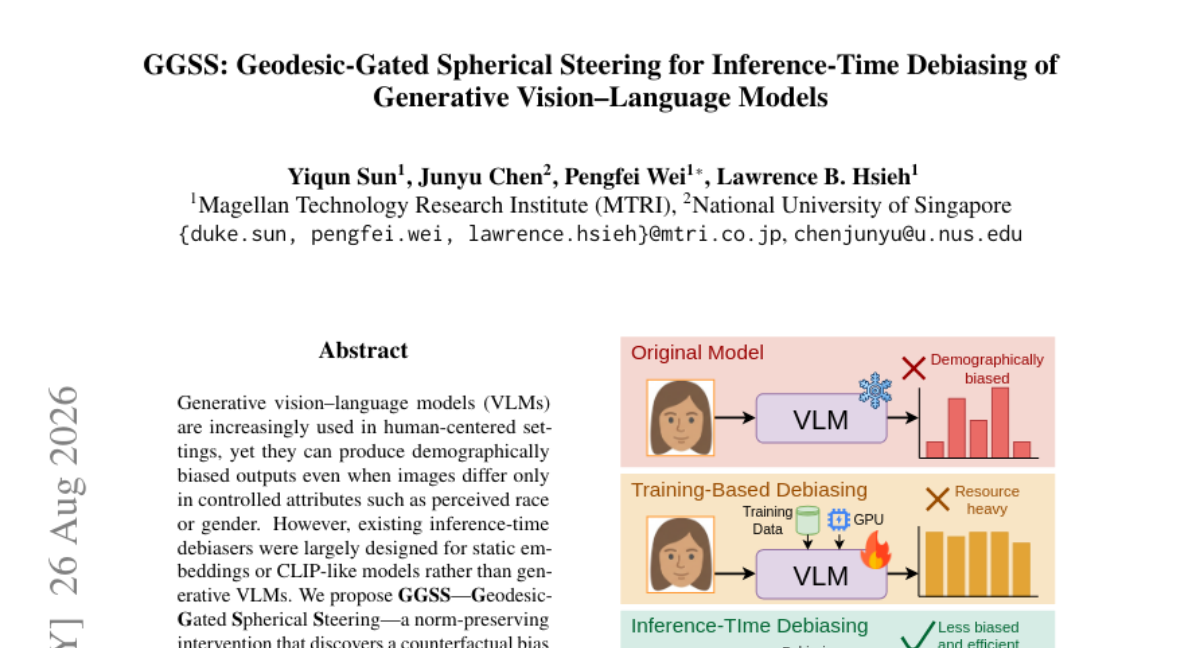
GGSS: Geodesic-Gated Spherical Steering for Inference-Time Debiasing of Generative Vision-Language Models

최근 생성형 시각-언어 모델(VLM)이 인간 중심 환경에 도입되면서 인종이나 성별과 같은 인구통계학적 편향 문제가 대두되고 있습니다. 기존의 편향 제거 방식은 주로 정적 임베딩이나 CLIP 모델에 특화되어 있어 생성형 VLM에는 적합하지 않은 경우가 많습니다. 본 논문은 단위 구(unit hypersphere) 상에서 반사실적 편향 서브스페이스를 발견하고, 측지선(geodesic) 경로를 따라 시각 토큰을 조정하는 GGSS 기법을 제안합니다. 또한 적응형 게이트를 통해 편향 신호가 강한 토큰에만 교정 작업을 집중시킵니다. 실험 결과, GGSS는 모델의 일반적인 시각-언어 성능을 유지하면서도 다양한 편향 테스트에서 기존 방식보다 낮은 편향 수치를 기록했습니다.

AI 연구

Lost in Compression: A Controlled Cross-Lingual Audit of Extractive Prompt Compressors

LLM 추론 비용 절감을 위한 추출형 프롬프트 압축 기술은 영어 성능은 뛰어나지만, 비영어권 언어에서는 토큰 비용이 더 발생하는 문제가 있습니다. 본 연구는 10개 언어와 11개 모델을 대상으로 압축 기술이 언어 간 격차를 어떻게 변화시키는지 정밀 감사했습니다. 실험 결과, 영어로 학습된 압축기들은 비영어권 언어에서 정보 유지율이 급격히 떨어지는 심각한 성능 저하를 보였습니다. 특히 압축률이 높아질수록 영어와 비영어권 간의 성능 격차는 더욱 벌어지는 것으로 나타났습니다. 반면 다국어 학습을 거친 모델은 이러한 격차를 효과적으로 완화할 수 있음을 확인했습니다.

30건

제품/서비스

이날 공개된 제품과 도구

제품/서비스

Video Agent by Fotor

채팅만으로 정교한 모션 그래픽과 영상을 제작하고 편집할 수 있는 AI 비디오 에이전트

제품/서비스

BrandJet

소셜 미디어의 구매 신호를 실시간 리드로 전환하는 자동 영업 파이프라인 플랫폼

제품/서비스

Interactive Sessions

AI 에이전트와 함께 SDLC 전 과정을 단계별로 제어하거나 자동화하는 워크스페이스

제품/서비스

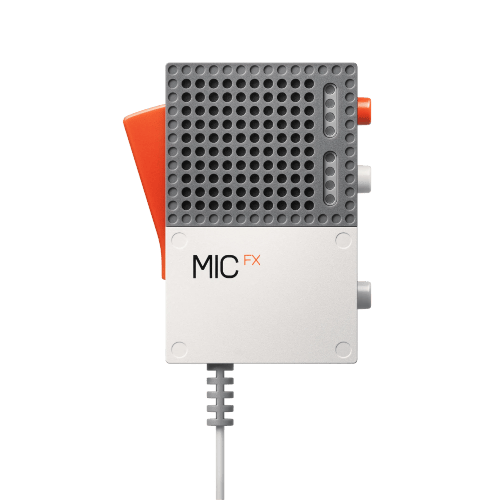
EP–2350 FX–MIC

직접적인 조작과 샘플링이 가능한 프로그래밍 가능한 핸드헬드 퍼포먼스 마이크

제품/서비스

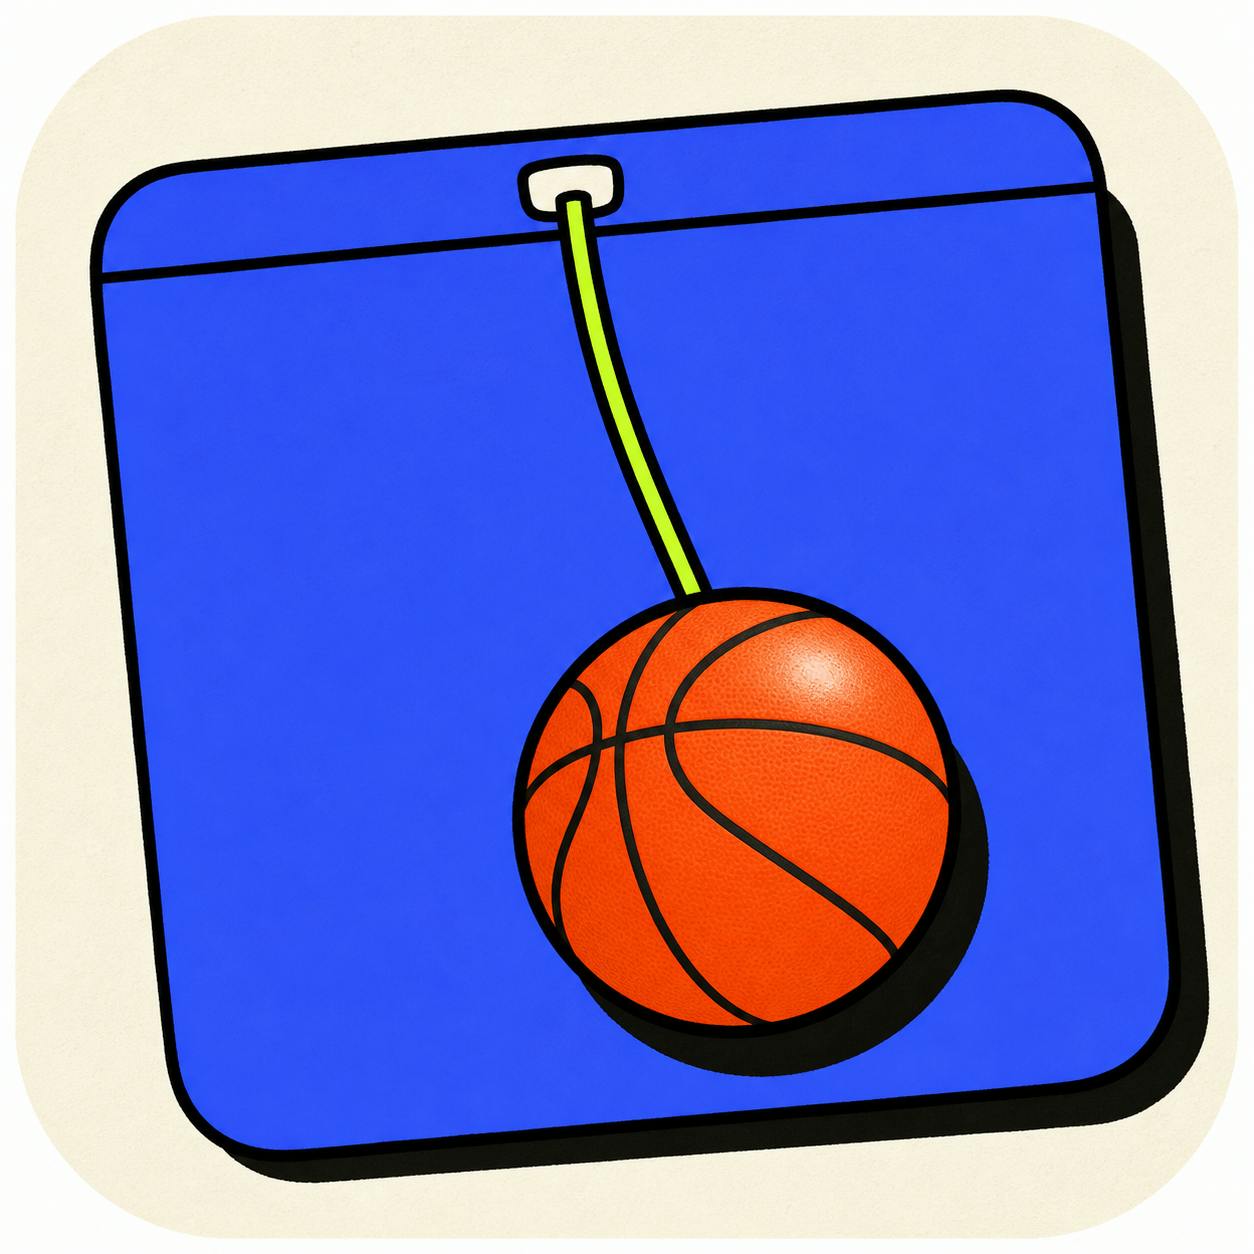
Tether

지루한 회의 시간을 즐거운 물리 놀이로 바꿔주는 데스크톱 장난감

나머지 25건 펼쳐보기

제품/서비스

Ask My Wardrobe

AI를 활용해 내 옷장 속 아이템으로 코디를 제안받고 쇼핑 실패를 줄이는 디지털 옷장 서비스

제품/서비스

BrandMyLaptop

자신의 노트북 상판 광고 공간을 브랜드에 판매하여 수익을 창출하는 마켓플레이스

제품/서비스

WebTerm Learn

게임처럼 즐기며 터미널, Git, Vim을 배우는 브라우저 기반 인터랙티브 학습 플랫폼

제품/서비스

Orato

AI를 통해 실시간 피드백을 받으며 말하기 실력을 향상시키는 스피킹 연습 도구

제품/서비스

FrameOS

Mac에서 모바일 앱 데모 영상을 쉽고 전문적으로 제작하는 도구

제품/서비스

Radar by Particle

수만 개의 팟캐스트 에피소드 내용을 실시간으로 검색할 수 있는 팟캐스트 전용 검색 엔진

제품/서비스

StackScope

새로 출시되는 웹사이트의 기술 스택 변화를 실시간으로 추적하는 기술 인텔리전스 도구

제품/서비스

Houndly

영업 미팅과 피드백을 학습하여 다음 행동을 제안하는 자가 학습형 GTM 코파일럿

제품/서비스

LeaseBase

복잡한 임대 규제와 데드라인을 AI로 관리하는 스마트 임대 관리 솔루션

제품/서비스

Mascofast

아이디어만으로 애니메이션 마스코트를 제작하는 개발자 친화적 워크플로우

제품/서비스

GitFig

피그마 디자인과 깃허브 코드를 양방향으로 동기화하는 버전 관리 플러그인

제품/서비스

ConscioussAI

단순 답변을 넘어 사용자의 기기를 직접 제어하며 복잡한 업무를 수행하는 AI 에이전트

제품/서비스

Fraime

하드웨어 최적화부터 프롬프트 구조화까지 자동화하는 오픈소스 AI 미디어 생성 플랫폼

제품/서비스

Claimads.land

실시간 지도 위에서 광고 영역을 점유하고 확장하는 게임형 광고 마켓플레이스

제품/서비스

Remivu

SNS와 웹의 소중한 콘텐츠를 나만의 언어로 저장하고 쉽게 찾는 개인용 메모리 서비스

제품/서비스

CreditFX

복잡한 AI 크레딧 단위를 실제 비용과 사용량 가치로 변환해주는 분석 도구

제품/서비스

Remivu

SNS와 웹의 소중한 콘텐츠를 나만의 언어로 저장하고 쉽게 찾는 개인용 메모리 서비스

제품/서비스

WaterMe

날씨와 사진 기록을 결합한 올인원 식물 관리 허브

제품/서비스

MapWars

샌프란시스코의 특정 구역을 소유하고 방어하는 전략적 경매 게임

제품/서비스

Faurus

코딩 테스트부터 면접까지, 모든 기술 평가를 하나의 파이프라인으로 통합하는 감독 솔루션

제품/서비스

Rival Radar

AI가 경쟁사의 가격과 기능 변화를 실시간으로 감지하여 핵심 요약만 전달하는 자동 모니터링 도구

제품/서비스

Out Hood

커뮤니티의 참여형 입찰을 통해 아이디어를 홍보하고 대규모 노출 기회를 얻는 플랫폼

제품/서비스

Influencer Finder

웹사이트 주소만 입력하면 브랜드에 딱 맞는 인플루언서를 즉시 찾아주는 AI 도구

제품/서비스

Valentina Studio 18

AI와 차세대 시각화 도구가 결합된 강력한 멀티 데이터베이스 워크플로우 관리 도구

6건

모델/벤치마크

새 모델과 주요 평가 결과

HF Model Trending

zai-org/GLM-5.3

zai-org에서 공개한 GLM-5.3 모델이 Hugging Face에서 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 text-generation 태그가 지정된 대규모 언어 모델입니다.

HF Model Trending

deepseek-ai/DeepSeek-V4-Flash-Vision-Exp

DeepSeek-AI에서 출시한 DeepSeek-V4-Flash-Vision-Exp 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 이미지와 텍스트를 결합하여 처리하는 멀티모달 기능을 제공합니다.

HF Model Trending

zai-org/GLM-5.3-Flash

zai-org에서 공개한 GLM-5.3-Flash 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 이미지와 텍스트를 동시에 처리하는 멀티모달 기능을 제공합니다.

LiveCodeBench

LiveCodeBench top model: O4-Mini (High)

LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Pro-06-05

LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

나머지 1건 펼쳐보기

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Flash-04-17

LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.