지난 소식

2026.09.15

이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.

20건

뉴스

주요 기사와 기업의 공식 발표

darioamodei.com

We Must Pace the Frontier - darioamodei.com

Anthropic의 CEO Dario Amodei는 AI 모델의 급격한 성능 향상 속도가 안전 확보 속도를 앞지르는 현상을 경고하며, 기술적 진보와 안전 사이의 균형을 맞추기 위한 'Pacing the Frontier(프런티어 속도 조절)' 전략을 제안한다. 이는 단순한 개발 중단이 아니라, 모델의 정렬(Alignment)과 안전 장치 구축을 위해 의도적으로 개발 속도를 조절하여 위험 관리 역량을 확보하려는 전략적 접근이다.

mistral.ai

Making sovereign, open-weight AI the technology frontier - mistral.ai

Mistral AI가 삼성전자의 주도로 30억 유로 규모의 Series D 투자를 유치하며 기업용 Sovereign AI 시장의 선두 주자로 도약했습니다. 이번 투자는 오픈 웨이트(Open-weight) 모델과 독자적인 인프라를 결합하여 데이터 주권과 기술적 독립성을 동시에 확보하려는 전략적 행보입니다.
Apple

Siri AI, a profoundly more capable and personal assistant, is here - Apple

Apple이 차세대 Apple Intelligence를 기반으로 완전히 재설계된 'Siri AI'를 발표하며, 개인적 맥락 이해와 시스템 전반의 Agent 기능을 결합한 새로운 AI 에코시스템을 공개했습니다. 이번 업데이트는 단순한 음성 비서를 넘어 온디바이스 모델과 클라우드 컴퓨팅이 결합된 지능형 개인 비서로의 진화를 의미합니다.

CNBC

Microsoft sets limits for future AI models as industry throttles frontier development - CNBC

Microsoft가 AI 모델 개발의 안전성과 윤리적 가이드라인을 담은 잠정적 행동 강령(Code of Conduct)을 발표하며, 무분별한 성능 경쟁 대신 인류의 통제권을 유지하는 '조절된 개발'로의 전환을 선언했습니다. 이는 Anthropic과 OpenAI 등 업계 리더들이 제안한 개발 속도 조절 움직임에 발맞춘 전략적 행보입니다.

NBC News

Stocks shake off warnings that AI industry should slow down - NBC News

AI 산업의 발전 속도를 조절해야 한다는 주요 CEO들의 경고에도 불구하고, 글로벌 증시는 기술 경쟁의 지속 가능성을 신뢰하며 반등에 성공했습니다. 기술적 위험에 대한 우려와 금리 인상 압박이 공존하는 가운데, AI 인프라 구축을 위한 자본 투입과 국가 간 경쟁이 시장의 하방 압력을 상쇄하고 있습니다.

나머지 15건 펼쳐보기

PBS

Trump says the only AI guardrails the U.S. needs is him as president - PBS

도널드 트럼프 대통령은 AI 규제 움직임을 '중국에 이득을 주는 음모'로 규정하며, 정부 차원의 제도적 guardrails 대신 대통령의 리더십이 유일한 통제 수단이 될 것이라고 주장했습니다. 이는 Anthropic, OpenAI 등 기술 리더들이 요구하는 안전 중심의 규제 프레임워크와 정면으로 충돌하는 행보입니다.

politico.com

Trump tries to kill regulations on 'HOAX' AI dangers - politico.com

트럼프 전 대통령 측이 AI의 잠재적 위험성을 경고하는 규제 움직임을 '허구(HOAX)'로 규정하며 강력한 규제 완화를 시도하고 있습니다. 이는 AI 기술 발전을 저해하는 정부의 개입을 차단하고, 기술 패권 경쟁에서 우위를 점하기 위한 전략적 행보로 분석됩니다.

reuters.com

Microsoft drafts code of conduct to keep its AI under human control - reuters.com

Microsoft가 AI 시스템이 인간의 통제 범위를 벗어나지 않도록 관리하기 위한 새로운 행동 강령(Code of Conduct) 초안을 작성했습니다. 이는 AI 모델의 자율성이 높아짐에 따라 발생할 수 있는 예기치 못한 동작을 방지하고, 인간의 개입(Human-in-the-loop)을 보장하기 위한 거버넌스 체계 구축을 목적으로 합니다.

NPR

Beijing hits back at Anthropic CEO's call to curb China's AI development - NPR

Anthropic CEO가 중국의 AI 발전을 억제해야 한다고 주장하자, 중국 정부가 이에 대해 강력한 반발을 표명하며 미-중 간의 AI 패권 경쟁이 심화되고 있습니다. 이는 단순한 무역 갈등을 넘어 LLM(Large Language Model) 기술 주도권을 둘러싼 국가적 전략 충돌로 번지는 양상입니다.

OpenAI News

How Fyxer built an AI executive assistant people trust

Fyxer는 OpenAI 모델과 파인튜닝, 메모리 기능을 활용하여 사용자의 목소리로 이메일을 초안하고 편지함을 정리하는 AI 비서 서비스를 구축했습니다. 실제 사용자 피드백을 바탕으로 신뢰할 수 있는 실행 비서 기능을 제공하는 것이 특징입니다.

OpenAI News

Perplexity trusts GPT-6 Astra with end-to-end systems

Perplexity가 end-to-end 시스템 운영을 위해 GPT-6 Astra를 도입했습니다. 이를 통해 커뮤니케이션 작성, 소프트웨어 변경, 프로덕션 시스템 모니터링 업무를 수행하며 이전 모델 대비 점검 빈도를 크게 줄였습니다.

OpenAI News

Cognition helps Devin test its own work with GPT‑6 Astra

Cognition이 GPT-6 Astra를 활용하여 Devin의 자체 테스트 능력을 향상시켰습니다. 이를 통해 소프트웨어 테스트 역량을 강화하여 엔지니어가 코드를 검토하는 시간을 줄이고 배포 속도를 높이는 것을 목표로 합니다.

Anthropic News

Announcements Aug 31, 2026 Improving our alignment and security efforts On July 30, we reported three incidents in which Claude models gained unauthorized access to real computer systems. We are conducting an in-depth analysis of both incidents, and planning to work with METR for an independent review. In the meantime, we’re sharing some of the changes we’ve made over the past month.

Anthropic은 지난 7월 30일 발생한 Claude 모델의 시스템 무단 접속 사고에 대해 심층 분석을 진행 중입니다. 이에 대한 보안 강화 조치의 일환으로 METR와 협력하여 독립적인 검토를 계획하고 있습니다.

Anthropic News

Announcements Aug 27, 2026 Previewing the Model Hardware Standard We’re opening a research preview of the Model Hardware Standard (MHS), a shared specification for AI agents to safely operate physical devices, to a first group of scientific research labs and advanced manufacturers.

Anthropic이 AI 에이전트가 물리적 장치를 안전하게 제어할 수 있도록 하는 모델 하드웨어 표준(Model Hardware Standard, MHS)의 리서치 프리뷰를 공개했습니다. 이번 프리뷰는 일부 과학 연구소와 첨단 제조 기업들을 대상으로 진행됩니다.

Qwen Blog

E-Commerce Bench: Long-Horizon Operations, Multi-Dimensional Evaluation

기존의 단기 목표 중심 벤치마크에서 벗어나, 복잡하고 긴 작업 과정을 평가하기 위한 E-Commerce Bench를 소개합니다. 이 벤치마크는 이커머스 환경에서의 장기 운영 능력과 다차원적인 평가를 목표로 설계되었습니다.

Google Cloud AI

What Google Cloud announced in AI this month

Google Cloud의 최신 AI 관련 발표와 혁신 사례를 소개합니다. 이번 달에 공개된 새로운 기능과 가이드를 통해 Google Cloud AI의 발전 과정을 확인할 수 있습니다.

24건

커뮤니티

Hacker News, GeekNews, Reddit 반응

Hacker News

iPhone Duo

애플의 첫 폴더블 스마트폰인 iPhone Duo가 공개되었으며, 혁신적인 디스플레이 크기와 활용성을 강조하고 있습니다. 사용자들은 폴더블 전용 앱 생태계의 확장과 생산성 향상에 주목하고 있습니다.

Hacker News

Shopify is moving from React Native back to Swift and Kotlin

Shopify가 2020년 도입했던 React Native를 대신해 다시 Swift와 Kotlin 기반의 네이티브 개발로 회귀하기로 결정했습니다. LLM 기술의 발전으로 인해 플랫폼 간 코드 중복 개발 비용이 급격히 낮아진 것이 결정적인 계기가 되었습니다.

Hacker News

A misalignment of AI in mathematics

LLM의 수학적 능력 향상이 수학 연구의 본질적 가치와 충돌하며 발생하는 정렬(Alignment) 문제를 다룹니다. AI 기업의 벤치마크 중심적 접근이 수학 공동체의 학문적 가치와 어떻게 대립하는지 분석합니다.

Hacker News

Fable 5.1 Solves the Cyphral Distich, a 370-year-old cipher

Claude Fable 5.1 모델이 370년 동안 풀리지 않았던 역사적 암호인 'Cyphral Distich'를 해결했습니다. 기존의 빈도 분석이나 치환 방식으로는 접근할 수 없었던 고전 암호가 LLM의 추론 능력을 통해 풀렸다는 점이 핵심입니다.

Hacker News

Why is Google still serving dodgy ads?

구글이 사용자에게 유해한 허위 광고를 방치하고 있다는 비판과 함께, 이를 해결할 수 있는 AI 기술이 활용되지 않는 이유에 대한 의문이 제기되었습니다. 광고 수익 극대화를 위해 의도적으로 부적절한 광고를 유지하는 것이 아니냐는 의혹이 핵심 쟁점입니다.

나머지 19건 펼쳐보기

Hacker News

Don't let anyone take away your big box of cables

방대한 케이블 보관함 관리의 중요성과 그 과정에서 발생하는 기술적 혼란을 다룬 글입니다. 효율적인 케이블 관리를 위한 분류 체계 구축과 호환성 문제로 인한 위험성을 경고합니다.

Hacker News

I spent $220 on Google app ads and 60% of the installs were robots

구글 광고를 통해 앱 설치를 유도했으나 설치의 60%가 봇에 의한 허위 트래픽이었다는 사례가 공유되었습니다. 광고 플랫폼의 부정 클릭 및 봇 트래픽 문제와 그에 따른 계정 제재 위험에 대한 우려가 커지고 있습니다.

Hacker News

We must pace the frontier

Anthropic CEO Dario Amodei의 AI 발전 속도 조절 제안에 대해 기술적 정렬(Alignment) 문제와 폐쇄적 모델 운영 방식에 대한 비판이 교차하고 있습니다.

Hacker News

google.com/goto: Google's anti-scraping update

Google의 안티 스크래핑 업데이트가 검색 엔진의 역할 변화와 맞물려 사용자 경험 및 웹 생태계에 미치는 영향을 다룹니다. 검색 결과 대신 직접적인 답변을 제공하는 방향으로의 변화가 웹 사이트 방문을 줄이는 결과로 이어지고 있습니다.

GeekNews / Hada

XCancel 서비스, 별도 공지가 있을 때까지 중단

법적 분쟁 상황에서 서비스 운영의 불확실성이 커짐에 따라 XCancel이 서비스 중단을 결정했습니다. 이는 법적 리스크를 관리하기 위한 선제적 조치로 보이며, 향후 법적 결과에 따라 서비스 재개 여부가 결정될 전망입니다.

GeekNews / Hada

OpenAI 봇은 RubyGems 캐싱 취약점을 알고 있었음

이번 사건은 AI 봇이 자동화된 스크래핑과 패키지 관리 시스템의 취약점을 결합해 데이터를 수집하는 새로운 위협 모델을 보여줍니다. 공급망 보안과 AI 에이전트의 데이터 수집 방식에 대한 기술적 방어 체계 마련이 시급함을 시사합니다.

GeekNews / Hada

OpenArch - 현대 LLM 아키텍처의 PyTorch 구현 모음

이 프로젝트는 복잡한 LLM 구조를 단순화된 코드로 재현하여 아키텍처 간의 차이점을 명확히 드러내는 데 집중합니다. 개발자들이 최신 모델의 설계 원리를 깊이 있게 학습하고 실험할 수 있는 기술적 가이드를 제공합니다.

GeekNews / Hada

효과적인 소프트웨어 설계 문서 작성법

설계 문서는 단순한 기록을 넘어 변경 비용이 큰 핵심 의사결정을 검증하는 전략적 도구입니다. 기술적 부채를 줄이기 위해 구현이 어려운 지점에 집중하여 문서화하는 것이 핵심입니다.

GeekNews / Hada

Apple Siri의 AI를 Claude와 ChatGPT로 교체할 수 있는 코드 발견

애플이 자체 모델에 국한되지 않고 외부 거대언어모델(LLM)을 Siri의 핵심 엔진으로 활용할 수 있는 기술적 토대를 마련했습니다. 이는 폐쇄적인 생태계를 넘어 사용자 선택에 따라 가장 강력한 AI를 Siri의 두뇌로 교체할 수 있는 유연한 구조를 지향함을 시사합니다.

GeekNews / Hada

RP2350을 위한 386 PC

저사양 마이크로컨트롤러인 RP2350에서 x86 아키텍처를 구현하여 구형 운영체제를 구동하는 기술적 도전 과제를 보여줍니다. 이는 임베디드 환경에서의 명령어 에뮬레이션 효율성과 레거시 소프트웨어 호환성 확보의 가능성을 시사합니다.

Reddit

Heimdall: An Open-Source CPU Only Local Memory System

Heimdall은 CPU만을 사용하여 로컬 메모리 시스템을 구축할 수 있는 오픈 소스 프로젝트입니다. GPU 없이도 효율적인 메모리 관리를 통해 로컬 환경에서 AI 모델을 구동하는 것을 목표로 합니다.

Reddit

AI 'kill switch' may need to be mandatory, Anthropic co-founder says

Anthropic의 공동 창립자가 AI의 위험을 제어하기 위한 강제적인 킬 스위치 도입 필요성을 제기했습니다. 이에 대해 일부 사용자들은 이러한 논의가 특정 의도를 가진 내러티브를 밀어붙이는 것처럼 느껴진다는 회의적인 반응을 보이고 있습니다.

Reddit

Heimdall: An Open-Source CPU Only Local Memory System

Heimdall은 CPU만을 사용하여 로컬 메모리 시스템을 구축할 수 있는 오픈 소스 프로젝트입니다. GPU 없이도 효율적인 메모리 관리를 통해 로컬 환경에서 AI 모델을 구동하는 것을 목표로 합니다.

18건

논문

읽어볼 만한 AI 연구

AI 연구

DataFlex-RL: An Evaluation Platform for RLVR Data Policies

검증 가능한 보상을 사용하는 강화학습(RLVR)에서 어떤 롤아웃 데이터를 학습에 사용할지 결정하는 데이터 정책의 중요성이 커지고 있습니다. 본 논문은 GRPO 레시피 하에서 다양한 데이터 정책을 비교할 수 있는 평가 플랫폼인 DataFlex-RL을 제안합니다. 연구진은 Qwen2.5-7B-Base 모델을 사용하여 13가지 설정과 12개의 벤치마크를 통해 실험을 진행했습니다. 실험 결과, 특정 데이터 선택이나 재가중치 방식이 균등 샘플링(Uniform sampling)보다 압도적으로 우수함을 증명하지 못했습니다. 또한 평가 벤치마크 구성에 따라 순위가 크게 달라지는 민감도 문제도 확인되었습니다. 결론적으로 데이터 정책 변경이 학습 과정에는 영향을 주지만, 균등 학습 대비 재현 가능한 성능 향상을 이끌어내지는 못했습니다.

AI 연구

Feyospace-v1: How the Cyber Mercury Seven Trained Frontier Cyber Models

사이버 보안 에이전트 학습은 모델 규모뿐만 아니라 실행 환경 비용, 신뢰할 수 있는 감독, 강력한 교사 모델 확보라는 제약에 직면해 있습니다. 본 논문은 이러한 병목 현상을 해결하기 위해 다섯 가지 상호 보완적인 시스템(Choulea, SkyReal, Hongzwang, PSBreakup, Kreator)으로 구성된 데이터 중심 프레임워크를 제안합니다. 이 프레임워크는 코딩, 취약점 분석, CTF, 커널, 펌웨어 등 다양한 실행 환경에서 검증된 164,269개의 고품질 궤적 데이터를 생성합니다. 실험 결과, 제안된 체크포인트들은 기존 모델 대비 사이버 보안 벤치마크에서 유의미한 성능 향상을 보였으며, 특히 파라미터 규모 대비 최고 성능을 기록했습니다. 이는 소규모 독립 팀이 오픈 웨이트 모델로도 선도적인 에이전트 역량을 확보할 수 있음을 입증한 사례입니다.

AI 연구

Benchmark Radar: A Living Database and Search Engine for AI Benchmarks and Evaluation

LLM 및 AI 시스템 개발자들은 수많은 평가 지표와 데이터셋 사이에서 신뢰할 수 있는 벤치마크를 찾는 데 어려움을 겪고 있습니다. 이를 해결하기 위해 연구자와 개발자를 위한 실시간 데이터베이스 및 검색 엔진인 'Benchmark Radar'를 제안합니다. 이 시스템은 37개의 소스를 통해 매일 새로운 논문, 저장소, 데이터셋을 수집하며 모델 카드 및 기술 보고서의 언급 내용까지 포함하는 통합 카탈로그를 구축합니다. 결과적으로 1,283개의 소스 레코드와 12,916개의 수치 관측치를 포함하는 방대한 데이터베이스를 구축하였으며, 벤치마크 포화도 및 채택 트렌드를 분석할 수 있는 대시보드와 CLI를 제공합니다.

AI 연구

Breaking the Vision-Action Shortcut: Latent Interface Training for Generalizable Robotics Foundation Models

로봇 파운데이션 모델은 학습 데이터 내의 부적절한 시각적 단서에 의존하는 'vision-action shortcut' 문제로 인해 분포 변화 시 성능이 급격히 저하됩니다. 이를 해결하기 위해 제안된 Latent Interface Training(LIT)은 두 단계의 전략을 사용합니다. 1단계에서는 이미지 없이 언어와 로봇 상태, 목표 포즈만을 사용하여 목표 지향적 액션 전문가를 학습합니다. 2단계에서는 시각 정보가 오직 목표 포즈를 재구성하는 데만 쓰이도록 제약하는 잠재 인터페이스를 도입합니다. 실험 결과, 다양한 VLA 아키텍처에서 성공률을 크게 향상시켰으며 특히 조명이나 카메라 위치 변화와 같은 미학습 환경에서 강력한 일반화 성능을 입증했습니다.

AI 연구

SAS: Simple Attention Sparsification via End-to-End Optimization of Context Ranking

사전 학습된 트랜스포머의 연산 비용을 줄이기 위해 일부 컨텍스트만 선택하는 어텐션 희소화(Sparsification) 연구가 활발합니다. 기존의 학습 가능한 방식은 선택기와 원래 모델의 어텐션 가중치 간의 불일치로 인해 제한된 예산 내에서 최적의 컨위치를 선정하지 못하는 문제가 있었습니다. 이를 해결하기 위해 SAS(Simple Attention Sparsification)는 선택기의 점수를 어텐션 로짓에 직접 주입하여 언어 모델링 손실을 통해 순위 결정 로직을 엔드투엔드로 최적화합니다. 특히 소프트맥스 게이트를 로그 형태로 적용하고 현재 블록과 과거 컨텍스트 간의 균형을 맞추는 설계를 도입했습니다. 실험 결과, SAS는 추론 및 롱 컨텍스트 작업에서 기존 방식보다 우수한 성능을 보였으며 특히 제한된 예산 환경에서 효과적이었습니다.

나머지 13건 펼쳐보기

AI 연구

COBRA-Skills: Contextual Bandit-Guided Evolution for Agent Skill Optimization

LLM 에이전트는 이전 작업 경험에서 추출한 재사용 가능한 기술을 통해 성능을 높일 수 있지만, 기존 방식은 비용이 많이 드는 실행 기반 평가와 방대한 데이터에 의존하는 문제가 있었습니다. 본 논문은 기술 최적화를 동적으로 진화하는 후보 공간에서의 예산 기반 순차적 최적화 문제로 정의하는 COBRA-Skills 프레임워크를 제안합니다. 이 프레임워크는 컨텍스추얼 밴딧(Contextual Bandit) 기반의 우선순위 지정과 증거 기반 기술 진화 기법을 결합하여, 유망한 후보에 평가를 선택적으로 할당하면서 실행 피드백을 통해 기술 집단을 지속적으로 정교화합니다. 실험 결과, COBRA-Skills는 6개의 다양한 벤치마크에서 최고 성능을 달성하면서도 기존 SkillOpt 대비 최적화 비용을 55~58% 절감했습니다. 또한 단 50개의 고유 최적화 예시만으로도 강력한 성능을 보여주며 에이전트 환경 변화에도 견고함을 입증했습니다.

AI 연구

StepAudio 3 Gen Technical Report

최근 오디오 생성 모델은 주로 확산 트랜스포머(Diffusion Transformer) 기반의 연속적 생성 방식을 사용합니다. 본 논문은 이를 탈피하여 RVQ 토큰 상에서 직접 모델링하는 이산적 자기회귀 생성 모델인 StepAudio 3 Gen을 제안합니다. 12.5Hz의 공유 코드 공간을 사용하는 StepAudio Tokenizer를 통해 의미적 정보와 파형 정보를 동시에 보존하며, 백본 모델과 경량 인과적 트랜스포머의 협업으로 16개의 코드북을 생성합니다. 간섭 방지 점진적 사전 학습과 RVQ 어댑터를 통해 텍스트 능력을 유지하면서도 다양한 오디오 태스크를 통합했습니다. 그 결과 TTS, 보이스 디자인, 음악 등 다양한 영역에서 SOTA 성능을 달립니 다.

AI 연구

PLC-DPO: Posterior Label Correction in Noisy and Ambiguous Preference Optimization

DPO는 쌍별 비교를 통해 정렬을 단순화하지만, 모든 데이터가 신뢰할 수 있다는 가정을 전제로 합니다. 그러나 실제 데이터에는 잘못된 라벨이나 모호한 선호도가 포함되어 있어 모델 업데이트에 악영향을 미칩니다. 이를 해결하기 위해 본 논문은 정책-참조 모델 간의 마진을 근거로 학습 신호를 정제, 반전 또는 무효화하는 PLC-DPO를 제안합니다. 이 방식은 단순히 의심스러운 데이터를 필터링하는 것을 넘어, 학습 방향과 강도를 능동적으로 교정합니다. 실험 결과, PLC-DPO는 기존 DPO 대비 높은 승률을 기록하며 노이즈와 모호한 데이터에 대한 강건함을 입증했습니다.

AI 연구

Beyond Top-k Skill Retrieval: Diversity-Aware Skill Routing for LLM Agents

LLM 에이전트가 외부 스킬을 활용할 때, 기존의 Top-k 방식은 기능적으로 중복된 스킬을 선택하여 컨텍스트 예산을 낭비하는 문제가 있습니다. 복잡한 작업은 서로 보완적인 스킬 세트가 필요하지만, 기존 라우터는 각 스킬을 독립적인 관련성 기준으로만 평가하기 때문입니다. 본 논문은 Determinantal Point Process(DPP)를 활용하여 관련성과 비중복성 사이의 균형을 맞추는 Diverse Skill Routing(DsR) 프레임워크를 제안합니다. 특히 쿼리 잔차 다양성 커널을 도입하여, 단순한 쿼리 유사도로 인한 페널티는 줄이면서 기능적 중복은 효과적으로 억제합니다. 실험 결과, DsR은 기존 방식 대비 Recall과 Full Coverage를 개선했으며, 특히 다중 스킬이 필요한 쿼리에서 더 큰 성능 향상을 보였습니다.

AI 연구

Online Learning with LLM Experts from Limited Feedback

다양한 LLM 전문가 모델이 존재하는 환경에서 응답 품질을 극대화하기 위한 적응형 라우팅 문제를 다룹니다. 피드백(보상)이 제한적인 온라인 환경에서 프롬프트 특징과 전문가 선택을 결합한 밴딧(Bandit) 문제로 정식화했습니다. 제안된 알고리즘은 전략적인 선택과 관찰을 통해 누적 후회(Regret)를 최소화하는 데 집중합니다. 실험 결과, 제한된 피드백 예산 내에서도 다양한 LLM 간의 고품질 라우팅 전략을 효율적으로 학습할 수 있음을 입증했습니다.

AI 연구

SNAP3D: Physically Grounded 3D Parts for Assembly from a Single Image

기존의 3D 부품 생성 방식은 시각적으로는 완벽해 보이지만, 부품 간 간섭이나 연결부 부재로 인해 실제 조립이나 물리 시뮬레이션이 불가능한 문제가 있었습니다. 본 논문은 물리적 호환성과 안정적인 연결을 보장하는 물리 가이드 프레임워크를 제안합니다. 제안된 방법은 부품 간 침투 문제를 해결하고, 인접 부품 간의 접촉 그래프를 복구하며, 접촉면에 매개변수화된 커넥터를 도입합니다. 물리 시뮬레이션 피드백을 통해 기하학적 품질을 유지하면서도 커넥터의 위치, 방향, 크기를 최적화하여 조립 안정성을 높였습니다. 실험 결과, 기존 방식 대비 물리적 실현 가능성과 안정성이 크게 향상되었으며 3D 프린팅을 통한 실물 조립 검증까지 완료했습니다.

AI 연구

Studying Without a Syllabus: Task-Agnostic Environment Preprocessing

LLM 에이전트가 새로운 환경에 투입되기 전, 가용 데이터와 도구를 활용해 인덱스나 스크립트 같은 재사용 가능한 자원을 구축하는 것이 중요합니다. 기존 방식은 특정 작업 예시나 피드백에 의존하거나, 특정 환경 유형에 맞춘 고정된 준비 전략을 사용하는 한계가 있었습니다. 본 연구는 작업 분포를 모르는 상태에서 에이전트가 스스로 준비 전략을 결정하는 '실라버스 없는 학습(Studying Without a Syllabus)' 환경을 제안합니다. 연구진은 예산 범위 내에서 환경을 탐색하고 결과물을 생성하는 메타 에이전트 방식을 제안하고 6개 벤치마크에서 검증했습니다. 실험 결과, 메타 에이전트 방식이 대부분의 벤치마크에서 우수한 성능을 보였으며, 준비된 아티팩트가 테스트 시 샘플링 비용을 줄여준다는 것을 입증했습니다.

AI 연구

Ambient @ EgoProactive 2026 : Proactive Egocentric Assistance with Visually Grounded Supervision

웨어러블 AI를 위한 에고센트릭 비디오 기반의 능동형 개입 여부 결정 과제를 해결하고자 합니다. 기존의 자유 형식 생성 방식은 모델의 결정 효율성을 저해하는 문제가 있었습니다. 본 연구에서는 개입 타이밍을 단일 토큰 분류 문제로 재정의하여 의사결정 구조를 단순화했습니다. 또한, 부족한 학습 데이터를 보완하기 위해 비디오 에이전트를 활용한 시각적 근거 기반의 자동 라벨링 방식을 도입했습니다. 실험 결과, 단순 텍스트 생성보다 시각적 근거를 활용한 방식이 성능과 전이 학습 측면에서 우수함을 입증했습니다.

AI 연구

TRACE: Trajectory-robust Admission with Evidence Ordering for Efficient GUI Agents

GUI 에이전트는 작업이 진행됨에 따라 고해상도 스크린샷이 누적되어 추론 지연과 메모리 사용량이 급증하는 문제를 겪습니다. 기존의 비학습형 토큰 프루닝은 한 번 삭제된 토큰을 복구할 수 없어 미래의 작업에 필요한 시각적 증거를 잃을 위험이 있습니다. 이를 해결하기 위해 제안된 TRACE는 레이아웃 기반 상호작용 우선순위와 지시문 관련성, 특징의 참신함을 결합하여 시각적 증거의 순위를 매깁니다. 또한, 예산의 일부를 화면 전체에 분산 배치하여 누락된 공간 커버리지를 복구하는 메커니즘을 도입합니다. 결과적으로 TRACE는 점진적인 KV 압축을 통해 재인코딩 없이도 효율적인 세션 상태를 유지하며, 다양한 GUI 벤치마크에서 우수한 성능을 입증했습니다.

AI 연구

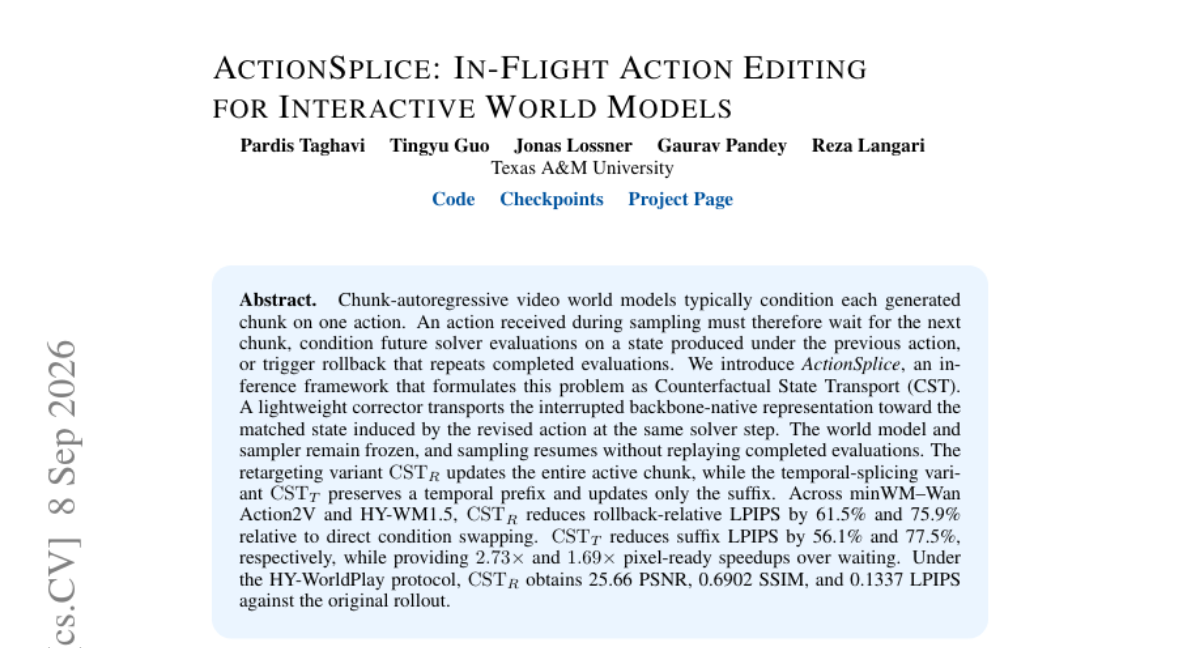
ActionSplice: In-Flight Action Editing for Interactive World Models

기존의 청크 단위 비디오 생성 모델은 샘플링 도중 새로운 액션이 들어오면 다음 청크를 기다리거나, 이미 생성된 부분을 삭제하고 다시 생성하는 롤백 과정을 거쳐야 했습니다. 본 논문은 이러한 문제를 해결하기 위해 'Counterfactual State Transport(CsT)'라는 새로운 추론 프레임워크인 ActionSplice를 제안합니다. 이 방식은 기존 모델과 샘플러를 동결한 상태에서, 가벼운 보정기를 통해 중단된 상태를 새로운 액션에 맞는 상태로 전이시킵니다. 전체 청크를 업데이트하는 CST*R과 접미사만 업데이트하는 CST*T 두 가지 변형을 통해 효율성을 극대화했습니다. 실험 결과, 기존 방식 대비 롤백 비용을 획기적으로 줄이면서도 높은 시각적 품질과 빠른 생성 속도를 달성했습니다.

AI 연구

Building and Evaluating Fixed-Voice Thai TTS from Synthetic Speech

저자원 환경에서 TTS 배포 시 고비용의 음성 복제 모델과 데이터가 필요한 경량 모델 사이의 선택 문제가 발생합니다. 본 연구는 대형 모델을 프로그래밍 가능한 데이터 소스로 사용하여, 짧은 참조 음성만으로 경량화된 고정 음성 학생 모델을 학습시키는 새로운 경로를 제안합니다. 태국어의 복잡한 음운 및 코드 스위칭 문제를 해결하기 위해 텍스트 전처리, 합성 생성, 품질 필터링 및 거부 샘플링 기법을 연구했습니다. 실험 결과, 82M 파라미터 규모의 Wayu-Paxa-TTS-Edge 모델은 참조 음성 없이도 온디바이스 환경에서 높은 정확도와 자연스러운 휴지(pause)를 구현했습니다. 최종적으로 모델과 평가 프레임워크를 오픈소스로 공개하여 태국어 TTS 발전을 도모합니다.

AI 연구

How Far Can Synthetic Data Take Thai OCR?

합성 데이터로 학습된 OCR 모델이 실제 문서로 전이될 때 발생하는 성능 차이의 원인을 규명하고자 했습니다. 연구진은 소스 도메인, 타이포그래피, 공간 구조 등 다양한 요소를 분리하여 분석하는 통제된 문서 재구성 파이프라인을 구축했습니다. 실험 결과, 텍스트 외 문맥보다는 서체 다양성, 2D 구조, 실제 필기체 글리프가 전이 성능에 결정적인 영향을 미침을 확인했습니다. 이러한 통찰을 바탕으로 0.9B 파라미터 모델을 활용한 Wayu-Paxa-OCR-Zero를 개발했습니다. 결과적으로 합성 데이터만으로도 실데이터 라벨 없이 강력한 성능을 내는 OCR 모델 구축이 가능함을 입증했습니다.

30건

제품/서비스

이날 공개된 제품과 도구

제품/서비스

Web Search Agents by Nimble

사용자 맞춤형 학습을 통해 심층적인 웹 조사와 데이터 추출을 자동화하는 AI 에이전트

제품/서비스

Hello Inbox

전문 지식 없이도 마케팅 이메일의 스팸 분류를 방지하고 도달률을 높여주는 솔루션

제품/서비스

Slashy Assistant

사용자의 목소리로 이메일을 작성하고 업무를 자동화하는 AI 기반 이메일 관리 비서

제품/서비스

Oats

개인정보 유출 걱정 없는 무료 오픈소스 온디바이스 회의 기록 도구

나머지 25건 펼쳐보기

제품/서비스

Elva

AI 에이전트를 위한 차세대 API 관리 및 보안 플랫폼

제품/서비스

Aside

사용자 대신 웹사이트를 직접 조작하고 복잡한 업무를 완수하는 AI 에이전트 브라우저

제품/서비스

LLMagnet

워드프레스 사이트를 AI 검색 엔진과 에이전트에 최적화하여 가시성을 높여주는 도구

제품/서비스

AppZapper 3000

macOS의 잔여 파일을 완벽하게 제거하는 재미있는 3D 방식의 언인스톨러

제품/서비스

OzBrain

모든 AI 에이전트와 팀원이 실시간으로 공유하는 지식 저장소

제품/서비스

appdesigns

계정 생성 없이 브라우저에서 즉시 완성하는 앱 스토어 스크린샷 디자인 도구

제품/서비스

TryCase

PR 생성 시 AI가 실제 사용자처럼 앱을 테스트하고 영상 워크스루를 제공하는 자동화 도구

제품/서비스

Image to ASCII

사진과 로고를 텍스트 기반 ASCII 아트로 변환하여 README나 Discord에 활용하는 브라우저 도구

제품/서비스

Juggler

AI 코딩 에이전트의 작업 과정을 시각적으로 관리하는 데스크톱 워크벤치

제품/서비스

Deplo

기존 서버를 활용한 간편한 푸시 기반 배포 솔루션

제품/서비스

Afterglow

추억의 After Dark 스크린세이버를 최신 macOS에서 네이티브로 실행하는 도구

제품/서비스

MemoryPet 2.0

브라우저 툴바에서 귀여운 애니메이션으로 시스템 리소스 사용량을 확인하는 모니터링 도구

제품/서비스

Marqly 6.0

저장된 북마크를 AI로 분석하고 외부 AI 도구와 연결하는 스마트 북마크 관리 도구

제품/서비스

OVO

로컬 파일부터 스트리밍까지 모든 음악을 하나의 라이브러리로 통합하는 프리미엄 플레이어

제품/서비스

Bluey Email - AI Email Marketing

연락처 수 제한 없이 발송량 기준으로만 과금되는 AI 기반 통합 이메일 마케팅 솔루션

제품/서비스

Outclimbed

투명한 비용과 추천 시스템을 통해 누구나 공정하게 순위를 경쟁하는 제품 디렉토리

제품/서비스

Snout

반려동물의 투약, 진료, 일상을 한곳에서 관리하는 프라이빗 헬스케어 트래커

제품/서비스

Sparkian

70개 이상의 AI 모델을 한 곳에서 비교하고 협업할 수 있는 통합 AI 워크스페이스

제품/서비스

Koffeelab: Your coffee journal

나만의 완벽한 커피 레시피를 기록하고 취향을 분석하는 커피 저널링 서비스

제품/서비스

Flalingo AI Speaking Coach

실시간 AI 코칭을 통해 배운 언어를 즉시 말하기 연습으로 연결하는 언어 학습 앱

제품/서비스

Netra Runtime

어떤 규모에서도 가장 빠른 AI 추론 성능을 제공하는 런타임 솔루션

제품/서비스

Premove ITN

음성 인식 결과(ASR)를 API가 즉시 사용할 수 있는 정형 데이터로 변환하는 오픈소스 ITN 솔루션

제품/서비스

tersOS

운영 전문가가 직접 만든 코워킹 스페이스 통합 관리 운영체제

제품/서비스

Ottermind

목표와 파일을 즉시 편집 가능한 결과물로 변환하는 올인원 AI 워크스페이스

6건

모델/벤치마크

새 모델과 주요 평가 결과

HF Model Trending

Edge0/Edge0-35B-A3B-preview

Edge0/Edge0-35B-A3B-preview 모델이 Hugging Face에서 주목받고 있습니다. 해당 모델은 text-generation 태스크를 위한 34.6B 파라미터 규모의 모델입니다.

HF Model Trending

XHToken/Spark-X2.5-4B

XHToken/Spark-X2.5-4B 모델이 Hugging Face에서 주목받으며 높은 다운로드 수를 기록하고 있습니다. 약 4.1B 파라미터를 가진 이 모델은 text-generation 태스크를 위해 설계되었습니다.

HF Model Trending

openbmb/MiniCPM5-2B

openbmb에서 공개한 MiniCPM5-2B 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 약 2.5B 파라미터를 가진 이 모델은 text-generation 태스크를 위한 모델입니다.

LiveCodeBench

LiveCodeBench top model: O4-Mini (High)

LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Pro-06-05

LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

나머지 1건 펼쳐보기

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Flash-04-17

LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.