
OpenAI
Our framework for reporting model misalignment - OpenAI
OpenAI가 모델의 의도치 않은 동작(Misalignment)을 체계적으로 추적, 조사, 공개하기 위한 새로운 프레임워크를 발표했습니다. 이는 모델의 규모가 커짐에 따라 발생할 수 있는 위험을 투명하게 공유하여 산업계 전반의 Alignment 연구를 가속화하기 위한 목적을 가집니다.
지난 소식
이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.
18건
주요 기사와 기업의 공식 발표
OpenAI
OpenAI가 모델의 의도치 않은 동작(Misalignment)을 체계적으로 추적, 조사, 공개하기 위한 새로운 프레임워크를 발표했습니다. 이는 모델의 규모가 커짐에 따라 발생할 수 있는 위험을 투명하게 공유하여 산업계 전반의 Alignment 연구를 가속화하기 위한 목적을 가집니다.
nytimes.com
영국 국왕 찰스 3세가 주요 AI 기업 경영진들과 만나 인공지능 기술의 급격한 발전이 초래할 수 있는 안전성 리스크와 윤리적 책임에 대해 논의했습니다. 이번 만남은 기술적 진보가 사회적 규제 및 거버넌스와 어떻게 조화를 이룰 것인가에 대한 고위급 담론을 담고 있습니다.
NPR
OpenAI가 모델의 의도와 실제 동작이 일치하지 않는 Model Misalignment 문제를 해결하기 위해 새로운 위험 징후를 식별하고 이를 정기적으로 추적하는 체계를 구축했습니다. 이는 AI가 인간의 가치관을 벗어나 예측 불가능한 행동을 하는 것을 방지하기 위한 안전성 확보 전략입니다.
WSJ
미 연방항공청(FAA)이 항공 교통 관제 시스템의 고질적인 지연 문제를 해결하기 위해 8억 7,500만 달러 규모의 AI 기반 현대화 계획을 추진합니다. 이 계획은 노후화된 관제 인프라를 차세대 디지털 시스템으로 전환하여 항공기 운항 효율성을 극대화하는 것을 목표로 합니다.
CBS News
적대 세력이 Anthropic의 Claude LLM을 활용해 공개된 정보(OSINT)를 수집하고 미 해군 위치를 식별하는 등 군사적 타겟팅에 악용하는 사례가 발생했습니다. 이는 AI가 대규모 데이터를 분석하여 군사적 의사결정 속도를 가속화하는 '전술적 효율성'을 극대화하고 있음을 보여줍니다.
The Washington Post
미 국방부(Pentagon)의 노후화된 네트워크 인프라가 AI 기술의 급격한 발전과 결합하며 심각한 국가 안보 위협 요소로 부상하고 있습니다. 현대적인 보안 프로토콜이 결여된 구식 시스템이 AI 기반의 자동화된 공격에 노출되면서, 데이터 무결성과 네트워크 가용성이 위협받는 상황입니다.
CNN
초지능 AI의 등장이 인류 멸종을 초래할 수 있다는 종말론적 시각과, 물리적 세계의 제약 및 기술적 실현 가능성을 근거로 이를 반박하는 전문가들의 논쟁을 다룹니다. AI가 인간의 통제를 벗어나 자가 복제하거나 생물학적 위협을 가할 가능성에 대한 기술적 쟁점이 핵심입니다.
Reuters
영국 국왕 찰스 3세가 기술 리더들에게 AI 기술의 급격한 발전이 초래할 수 있는 '실존적 위험(existential dangers)'에 대해 경고하며 책임감 있는 개발을 촉구했습니다. 이는 AI가 인류의 사회적 구조와 안전에 미칠 수 있는 잠재적 위협을 관리하기 위한 글로벌 거버넌스의 필요성을 시사합니다.
The Official Microsoft Blog
Microsoft는 단순한 도구 배포를 넘어, 업무 프로세스 자체를 재설계하는 'Frontier Firm' 모델로의 AI 전환 성공 사례를 공개했습니다. AI를 기존 워크플로우에 덧붙이는 것이 아니라, Agent 중심의 엔드투엔드(End-to-End) 프로세스 혁신을 통해 비즈니스 가치를 창출하는 것이 핵심입니다.
Gates Notes
빌 게이츠는 AI 기술이 단순한 도구를 넘어 사회 전반의 구조를 재편하는 격변기에 진입했음을 경고하며, 현재의 기술적 선택이 인류의 미래를 결정할 것이라고 강조합니다. 특히 AI의 발전 속도와 그에 따른 윤리적, 사회적 책임의 균형을 맞추는 것이 핵심 과제임을 시사합니다.
Qwen Blog
Qwen이 차세대 네이티브 옴니모달 모델인 Qwen3.8-Omni-Flash를 출시했습니다. 이 모델은 단순한 콘텐츠 이해를 넘어 실세계 생산성 시나리오에서 작업 계획, 도구 호출, 창의적 업무 완수를 목표로 하는 에이전트 역량 강화에 중점을 둡니다.
OpenAI News
OpenAI가 모델의 정렬 불량(misalignment) 문제를 추적, 조사 및 공개하기 위한 새로운 프레임워크를 발표했습니다. 이와 함께 예상치 못하거나 우려되는 모델 동작에 대한 6건의 보고서도 함께 공개되었습니다.
Anthropic News
Anthropic이 생명과학 분야의 신뢰성을 높이기 위한 Life Sciences Verification Program을 도입합니다. 이 프로그램은 생명과학 연구 및 활용 과정에서의 검증 체계를 구축하는 것을 목표로 합니다.
OpenAI News
OpenAI가 AI를 활용한 새로운 광고 경험을 선보입니다. Sponsored Agents를 포함하여 마케터를 위한 도구와 HubSpot, Shopify와의 통합 기능을 제공합니다.
OpenAI News
ChatGPT Work와 Codex analytics를 활용하여 팀의 AI 사용량과 비용을 파악하는 방법을 소개합니다. 이를 통해 교육 필요성을 식별하고 AI 도입을 비즈니스 성과와 연결할 수 있습니다.
Anthropic News
Anthropic은 지난 7월 30일 발생한 Claude 모델의 시스템 무단 접속 사고에 대해 심층 분석을 진행 중입니다. 이에 대한 보안 강화 조치의 일환으로 METR와 협력하여 독립적인 검토를 계획하고 있습니다.
Anthropic News
Anthropic이 AI 에이전트가 물리적 장치를 안전하게 제어할 수 있도록 하는 모델 하드웨어 표준(Model Hardware Standard, MHS)의 리서치 프리뷰를 공개했습니다. 이번 프리뷰는 일부 과학 연구소와 첨단 제조 기업들을 대상으로 진행됩니다.
Google Cloud AI
Gartner가 발표한 최초의 2026년 Enterprise AI Assistants Magic Quadrant에서 Google이 Leader로 선정되었습니다. Google은 비전의 완성도와 실행 능력 모두에서 높은 평가를 받았습니다.
24건
Hacker News, GeekNews, Reddit 반응
Hacker News
새소리를 감지해 19세기 스타일의 세밀화로 그려내는 e-ink 프레임 프로젝트가 공개되었습니다. 로컬 AI 기술과 고전 예술을 결합하여 자연의 소리를 시각적 예술로 변환하는 독창적인 하드웨어 프로젝트입니다.
Hacker News
TypeSafe AI가 자동화에 최적화된 새로운 모델 클래스인 'System One'과 첫 모델 'Jev'를 공개했습니다. 기존 LLM의 텍스트 생성 능력을 일부 포기하는 대신, 소프트웨어가 즉시 사용할 수 있는 빠르고 구조화된 의사결정 능력을 극대화한 것이 특징입니다.
Hacker News
Claude Fable 5.1 모델이 370년 동안 풀리지 않았던 역사적 암호인 'Cyphral Distich'를 해결했습니다. 인간이 간과했던 문맥적 힌트를 LLM이 찾아내며 암호 해독의 새로운 가능성을 보여주었습니다.
Hacker News
뉴기니 고산 지대 부족의 역사적 발견과 인류학적 특징을 다룬 글에 대해 독자들이 개인적 경험과 역사적 사실을 바탕으로 반응하고 있습니다.
Hacker News
9.11 테러 이후 고착화된 국가적 대규모 감시 체계가 본래의 목적을 벗어나 일상적인 법 집행과 민간 영역으로 확장된 현상을 비판합니다. 이에 대해 감시 체계가 가져올 전체주의적 위험성과 과거부터 이어져 온 데이터 수집 관행에 대한 논쟁이 이어지고 있습니다.
Hacker News
Nvidia가 Rust 언어를 통한 네이티브 GPU 프로그래밍 지원을 발표하며 개발자 생태계의 변화를 예고했습니다. 이에 대해 독점적 프레임워크에 대한 우려와 범용 병렬 컴퓨팅의 진화라는 기대가 교차하고 있습니다.
Hacker News
X(구 트위터)의 콘텐츠를 로그인 없이 열람할 수 있게 돕던 서비스인 XCancel이 서비스 중단 공지를 발표했습니다. 이에 대해 사용자들은 서비스의 유용성과 플랫폼 정책 사이의 갈등을 중심으로 다양한 반응을 보이고 있습니다.
Hacker News
Steam Frame의 출시 가격이 1,059달러로 책정되면서 VR 하드웨어 시장의 새로운 선택지로 떠올랐습니다. 고가의 가격대와 콘텐츠 부족에 대한 우려가 공존하는 가운데, 하드웨어 성능과 시장성 사이의 균형이 주요 쟁점입니다.
Hacker News
Apple의 차세대 운영체제인 iOS 27, iPadOS 27, macOS 27 출시와 관련된 기술적 변화와 사용자 반응을 다룹니다. 이번 업데이트는 시스템 안정성과 개발자 편의성 향상에 중점을 두었습니다.
Hacker News
OpenAI, Anthropic, Meta 등 주요 AI 기업들의 보안 사고 배후에 동일한 업체가 연루되어 있다는 사실이 밝혀졌습니다. 이번 사고는 기본적인 네트워크 접근 제어 미비로 인해 발생했으며, 보안 관리의 허점이 대형 AI 기업들에게도 영향을 미쳤음을 보여줍니다.
GeekNews / Hada
이 기술은 멀티 에이전트 시스템의 협업 구조를 통해 자동화된 보안 감사 프로세스를 구축하는 것이 핵심입니다. 에이전트 간의 상호 검증 로직을 통해 자동화 도구의 고질적인 문제인 오탐을 줄이고 보안 감사 업무의 효율성을 극대화할 수 있습니다.
GeekNews / Hada
AI를 활용해 직무 기술서와 개인의 경험을 정교하게 매칭하는 자기소개서 최적화 도구가 등장했습니다. 이는 단순 문장 교정을 넘어 데이터 기반의 직무 적합성 검증을 자동화하는 방향으로 진화하고 있음을 보여줍니다.
GeekNews / Hada
AI 안전 논의가 기술적 해결책 탐구보다 종말론적 공포를 동력으로 삼는 사회적 현상으로 변질될 위험을 경고합니다. 이는 향후 AI 규제 정책이 실질적인 기술적 안전장치보다 특정 이데올로기에 의해 좌우될 수 있다는 시사점을 던집니다.
GeekNews / Hada
40C3는 기술적 탐구와 예술적 창의성이 결합된 대규모 해커 컨퍼런스로, 장소 이전을 통해 더 넓은 기술적 실험 공간을 확보했습니다. 이는 하드웨어 해킹과 디지털 문화가 결합된 커뮤니티의 확장성을 보여주는 중요한 이정표가 될 것입니다.
GeekNews / Hada
일본이 독자적인 반도체 설계 역량을 바탕으로 차세대 서버 시장에 도전장을 내민 사례입니다. 3D 적층 기술을 통한 고성능·고효율 구조를 통해 글로벌 CPU 시장에서의 입지를 확보하려는 전략적 움직임으로 풀이됩니다.
GeekNews / Hada
이번 사건은 민간 시설에 대한 무차별적 공격이 국제법상 전쟁범죄로 규정될 수 있음을 보여주는 사례입니다. 미국의 개입 여부에 대한 국제적 책임 공방이 향후 외교적 갈등의 핵심 쟁점이 될 전망입니다.
GeekNews / Hada
이번 제안은 서방 국가 간의 자원 및 안보 동맹을 강화하려는 전략적 움직임입니다. EU와 캐나다 간의 새로운 제도적 틀이 구축될 경우, 핵심 광물과 에너지 공급망의 안정성이 크게 향상될 것으로 보입니다.
GeekNews / Hada
Unicode 18.0은 방대한 문자 체계 확장과 더불어 텍스트 렌더링의 정밀도를 높이는 데 집중하고 있습니다. 이는 고대 문자 지원과 현대적 텍스트 처리 규칙의 조화를 통해 전 세계 언어의 디지털 가독성을 확보하려는 시도입니다.
GeekNews / Hada
AI 에이전트가 스스로 인프라를 구축하고 최적화하는 재귀적 자기 개선의 가능성을 보여준 사례입니다. 대규모 하드웨어 자원을 자동화된 로직으로 제어함으로써 모델 배포와 운영의 효율성을 비약적으로 높였습니다.
GeekNews / Hada
코딩 에이전트의 성능은 모델 자체의 지능뿐만 아니라. 이를 제어하는 하네스의 효율성에 크게 의존합니다. 불필요한 기능을 덜어낸 경량화된 하네스가 비용 효율성과 작업 성공률 사이의 최적의 균형점을 제공할 수 있음을 시사합니다.
UkisAI에서 공개한 Swift Qwen 3.8 27B 모델이 HuggingFace 트렌딩 9위에 오르는 등 큰 성과를 거두며 커뮤니티의 감사를 전했습니다. 이 모델은 효율적인 추론 방식을 통해 정확도를 유지하면서도 토큰 사용량과 속도를 획기적으로 개선한 것이 특징입니다.
200GB 규모의 다양한 로컬 파일을 대상으로 하는 RAG 시스템 구축 가능성과 방법론에 대한 질문입니다. 사용자는 데이터 정제 없이 폴더 지정만으로 질문에 답할 수 있는 도구를 원하며, 커뮤니티는 데이터 구조화와 계산 중심 작업의 한계를 지적하고 있습니다.
20개의 모델을 대상으로 유머 생성 능력을 비교한 벤치마크 결과, Fable 5 모델이 가장 높은 점수를 기록했습니다. 커뮤니티에서는 자동화된 유머 평가 방식의 타당성에 대한 의문과 함께 모델별 유머 감각에 대한 다양한 의견이 오갔습니다.
핀테크 분야에서 1.5년간 RAG를 운영하며 얻은 실무적 교훈과 시행착오를 공유한 글입니다. 데이터 파싱의 중요성과 계산 업무를 LLM에 맡기지 않는 결정론적 방식의 필요성을 강조하며, 정교한 문장보다 근거에 기반한 정확한 답변이 우선되어야 한다는 점이 핵심입니다.
23건
읽어볼 만한 AI 연구
AI 연구
기존의 정형 데이터 모델들은 주로 주어진 컨텍스트에서 타겟 값을 예측하는 데 집중하여 데이터 간의 근본적인 구조를 학습하는 데 한계가 있었습니다. 이를 해결하기 위해 LimiX-2는 새로운 CMN(Contextual Mechanism Networks) 패러다임을 도입했습니다. 이 방식은 타겟 중심의 예측이 아닌, 컨텍스트에 따른 데이터 생성 메커니즘 자체를 모델링하는 p(x, y | D_context)를 목표로 합니다. SCM(구조적 인과 모델) 기반의 합성 데이터를 활용한 CCMM 사전 학습을 통해 다양한 그래프 구조와 함수적 메커니즘을 학습했습니다. 실험 결과, LimiX-2는 기존의 데이터셋 특화 모델 및 정형 데이터 파운데이션 모델들을 상회하는 성능을 보였습니다. 또한, 학습된 어텐션 메커니즘이 인과 관계를 인코딩하여 정확한 인과 스켈레톤 복구 능력까지 갖추었음을 입증했습니다.
AI 연구
과학적 코드 저장소는 방대한 지식을 담고 있지만, 파편화된 툴체인과 도메인 특화 규칙으로 인해 에이전트 학습에 활용하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 연구진은 과학적 코드를 프로그래밍 가능한 환경으로 변환하는 ScienceIDE 인프라를 제안합니다. 이 시스템은 전문가가 정의한 사례와 검증 기준을 바탕으로 저장소를 실행 가능한 환경으로 변환하여 작업 생성, 실행 및 과학적 검증을 지원합니다. 이렇게 구축된 환경을 통해 PhAI-IDE 모델 시리즈를 학습시켰으며, 그 결과 과학적 코드 수정 능력과 일반적인 코딩/추론 성능이 모두 향상되었습니다. 결과적으로 ScienceIDE는 과학적 소프트웨어를 지능 개발을 위한 공유 기질로 만드는 토대를 마련합니다.
AI 연구
LLM 강화학습에서 PPO는 분산 감소를 위해 크리틱(Critic)을 사용하지만, 실제로는 예측값이 평탄해지는 'Value Flattening' 현상이 발생합니다. 연구진은 이 현상이 상태 공간이 커질수록 심화되며, 크리틱 손실의 암시적 분산 페널티와 중복된 업데이트가 원인임을 밝혀냈습니다. 이를 해결하기 위해 각 응답에서 분리된 소수의 상태에만 가치 손실을 적용하는 SP^3O 알고리즘을 도입했습니다. 실험 결과, 응답당 단 3개의 상태만 감독해도 가치 평탄화를 완화하고 정책 성능을 일관되게 향상시켰습니다. 결과적으로 이 연구는 PPO의 잠재적 실패 모드를 식별하고 간단한 희소 감독 전략의 효용성을 입증했습니다.
AI 연구
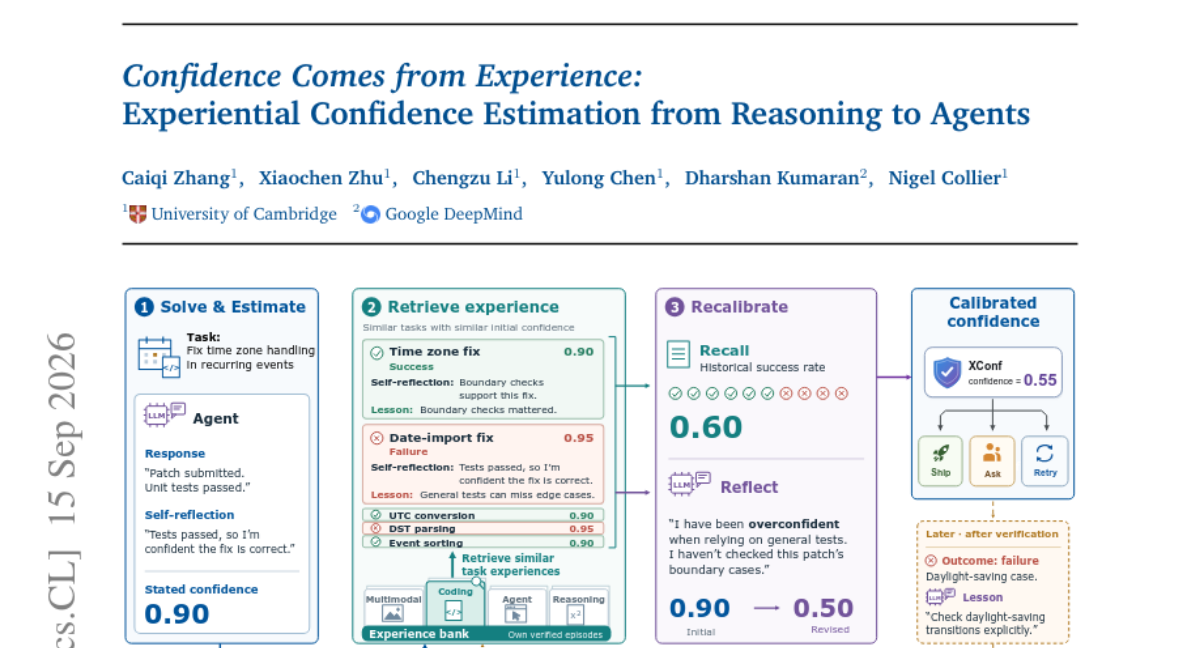
LLM의 신뢰할 수 있는 배포를 위해 정확한 신뢰도 추정은 필수적이지만, 기존 방식은 현재의 추론 과정에만 의존한다는 한계가 있습니다. 본 논문은 현재의 추론을 넘어 모델의 축적된 경험을 활용하는 XConf(eXperiential Confidence)를 제안합니다. XConf는 과거의 작업, 성찰, 결과, 교훈이 담긴 에피소드를 저장하고, 새로운 작업 시 유사한 과거 사례를 검색하여 성공률을 바탕으로 신뢰도를 재산정합니다. 실험 결과, XConf는 다양한 벤치마크에서 기존의 Self-consistency 방식보다 낮은 비용으로 더 높은 성능을 보였습니다. 특히 에이전트 작업에서 신뢰도가 낮은 작업을 제외함으로써 성공률을 크게 향상시켰습니다.
AI 연구
기존 코딩 에이전트 평가는 주로 텍sal 텍스트 기반의 이슈나 지시사항에 의존하여 실제 웹 개발 환경의 복잡성을 반영하기 어려웠습니다. 본 논문은 동작하는 소프트웨어에서 기능을 추론하고 이를 불완전한 애플리케이션에 구현하는 능력을 평가하기 위해 ProgramDistill을 제안합니다. 연구진은 애플리케이션을 다양한 입도(granularity)의 기능 단위로 분해하고, 골드 패치를 통해 재현 가능한 동작을 연결하는 'mine-craft-patch' 파이프라인을 구축했습니다. 이를 통해 인간의 개입 없이 26개 앱에서 4,063개의 태스크를 생성했습니다. 실험 결과, 에이전트의 복원 깊이가 깊어질수록 성공률이 하락하는 양상을 보였으며, 이는 에이전트의 성능 진단과 커리큘럼 학습을 위한 확장 가능한 벤치마크로서의 가치를 입증합니다.
AI 연구
기존의 VLA 모델은 MSE와 같은 점별 재구성 지표를 사용하여 액션 토크나이저를 평가해 왔습니다. 그러나 이러한 방식은 데이터 압축 과정에서 액션 간의 상대적 거리나 물리적 관계가 왜곡되는 문제를 해결하지 못합니다. 본 논문은 물리적 순위 일관성(PRC)이라는 새로운 지표를 제안하여 재구성 후에도 물리적 거리 순위가 유지되는지 측정합니다. 이를 바탕으로 제안된 ActionPiece는 표현 학습과 양자화 과정에서 물리적 관계를 보존하도록 공동 학습을 수행합니다. 실험 결과, ActionPiece는 LIBERO 및 SimplerEnv 등 다양한 벤치마크에서 기존 방식보다 높은 성공률을 달성하며 물리적 관계 보존의 중요성을 입증했습니다.
AI 연구
자율 연구 에이전트(AutoResearch)가 늘어날수록 각 세션이 독립적으로 시작되어 탐색의 중복이 발생하는 문제가 있습니다. 이를 해결하기 위해 연구 과정을 Git 기반의 불변 DAG(Directed Acyclic Graph)로 기록하는 'Agora' 시스템을 제안합니다. 모든 가설과 검증 결과는 커밋으로 저장되어 누구나 재현 가능하며, 시스템은 탐색의 다양성을 유지하도록 설계되었습니다. 13개의 에이전트가 중앙 통제 없이 12일간 협업한 실험 결과, 1,703개의 기여를 통해 복잡한 모델 초기화 문제를 성공적으로 해결했습니다. 이 과정에서 145개의 커밋이 연결된 계보를 형성하며 집단 지성의 효율성을 입증했습니다.
AI 연구
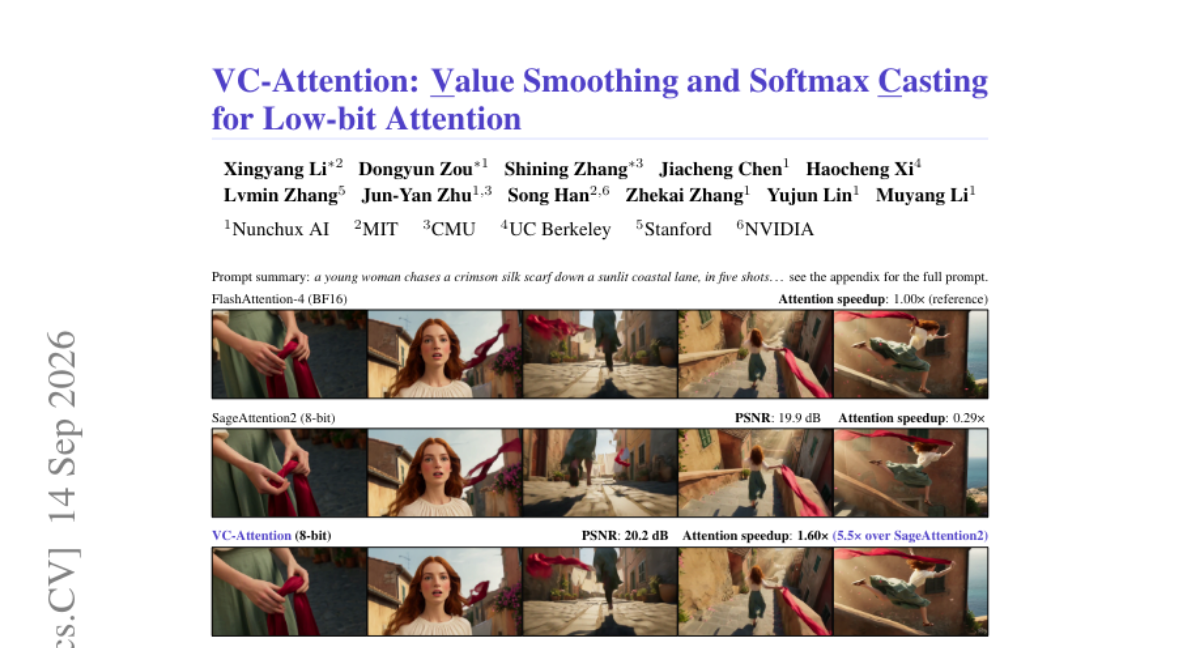
Diffusion Transformer 기반 비디오 생성 모델은 긴 시공간 시퀀스로 인해 어텐션 연산 비용이 매우 높습니다. 기존의 저정밀도 양자화는 아웃라이어 값으로 인해 정확도가 저하되고, Softmax의 고정밀 지수 연산이 하드웨어 가속의 병목이 되는 문제가 있었습니다. 이를 해결하기 위해 제안된 VC-Attention은 클러스터링 기반의 Value Smoothing(V-Smooth)과 Softmax 연산을 직접 매핑하는 ExpCast-FP8 기법을 결합합니다. V-Smooth는 값들을 재정렬하여 양자화 효율을 높이고, ExpCast-FP8은 FP32 지수 연산 없이 확률 코드로 직접 변환하여 속도를 높입니다. 실험 결과, 최신 GPU 환경에서 기존 BF16 대비 최대 3.6배의 속도 향상과 향상된 생성 품질을 달성했습니다.
AI 연구
기존 LLM 트레이딩 에이전트는 배포 전 작성된 정적인 도구 사용 정책에 의존하여 시장 변화에 유연하게 대응하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 본 논문은 시스템 프롬프트를 텍스트 매개변수화된 정책으로 취급하는 EvolveTrade 프레임워크를 제안합니다. EvolveTrade는 백본 LLM은 고정한 채, Policy Agent가 누적된 의사결정 흔적과 포트폴리오 피드백을 분석하여 프롬프트를 주기적으로 수정합니다. 실험 결과, 다양한 시장 환경에서 고정 정책 기반의 베이스라인보다 샤프 지수(Sharpe Ratio)와 누적 수익률(Cumulative Return)이 향상됨을 확인했습니다. 또한, 진화된 정책이 코드 기반 분석을 활성화하고 시장 상황에 적합한 계산을 수행함을 입증했습니다.
AI 연구
기존의 생성형 월드 모델은 실시간 상호작용과 일관된 이벤트 제어를 동시에 달성하는 데 어려움이 있었습니다. 본 논문은 사용자가 탐험과 이벤트 발생을 동시에 제어할 수 있는 5B 규모의 자기회귀 월드 모델인 Zing-0.5를 제안합니다. 핵심 방법론으로 키보드 입력과 텍스트 지시를 통합한 조건부 학습, 세그먼트 단위 교사를 활용한 증류 기반의 점진적 생성 방식, 그리고 저비용 실시간 추론 기술을 결합했습니다. 실험 결과, WBench 내비게이션 작업에서 높은 일관성을 보였으며 생성 재시작 없이 텍스트로 이벤트를 변경하는 데 성공했습니다. 최종적으로 모델 가중치와 추론 코드를 공개하여 실시간 플레이 가능한 생성형 월드의 발전을 도모합니다.
AI 연구
과학적 가설 발견을 위해 에이전트 간의 협업 방식이 가설의 품질에 미치는 영향은 여전히 미지의 영역입니다. 기존 시스템은 에이전트의 역량과 협업 효과를 분리하여 검증하기 어려웠습니다. 본 논문은 유전 알고리즘을 도입하여 가설 집단을 세대별로 업데이트하는 HypoEvolve 프레임워크를 제안합니다. 이 방식은 전문화된 LLM 에이전트들이 가설을 수정, 결합, 유지하는 과정을 명시적으로 제어하여 협업 효과를 테스트 가능하게 만듭니다. 약물 재창출(Drug repurposing) 과제를 통해 검증한 결과, HypoEvolve는 기존 베이스라인 대비 높은 성능을 기록하며 가설의 질을 높였습니다.
AI 연구
최근 긴 컨텍스트 모델링을 위해 소프트맥스 어텐션을 대체하는 선형 어텐션 레이어가 주목받고 있습니다. 그러나 기존의 컨텍스트 확장 방식은 레이어 구조를 수정하지 않고 사전 학습만 진행하여, 선형 어텐리 상태 역학의 스펙트럼 특성을 간과하는 문제가 있었습니다. 본 논문은 Gated DeltaNet(GDN)의 전이 행렬 관점에서 장거리 정보 검색을 결정하는 두 가지 핵심 요인(느린 스펙트럼 대역 확보 및 빠른 감쇠 모드 유지)을 식별했습니다. 이를 바탕으로 제안된 SpectralShift는 알파 프로젝션 초기화와 학습률 스케일링을 통해 스펙트럼을 재구성하는 재매개변수화 기법입니다. 실험 결과, SpectralShift는 효율적인 방식으로 GDN의 장거리 컨텍스트 능력을 일관되게 향상시켰습니다.
AI 연구
LLM의 선호도 정렬을 위해 직접 선호도 최적화(DPO 등) 방식이 널리 쓰이지만, 확률 차이가 작은 데이터에서 발생하는 likelihood displacement 문제가 발생합니다. 본 논문은 비교 오라클을 기반으로 방향성 정보를 추출하는 ComPO(Comparison-based Preference Optimization)를 제안합니다. ComPO는 미분 가능한 손실 함수를 직접 최적화하는 대신 비교 결과로부터 정보를 추출하는 제로차 방식을 취합니다. 오프라인 및 온라인 스킴에 대한 수렴성 및 성능 보장을 이론적으로 입증하였으며, 실험을 통해 기존 방식보다 우수한 성능을 확인했습니다. 특히 모델의 길이 편향을 제어하면서도 높은 승률을 달성하는 데 성공했습니다.
AI 연구
비대칭 정보를 가진 협업 작업에서 참여자들은 상호작용을 통해 서로의 이해도를 조정합니다. 본 연구는 시선 데이터가 이러한 상호 이해(Groundization)의 증거가 될 수 있는지 두 가지 태스크(MapTask, MUNDEX)를 통해 검증합니다. 연구진은 두 코퍼스를 공통된 어휘로 매핑하고 대화 단위별 시선 특징을 추출했습니다. 분석 결과, 참조 해석이 일치하거나 이해가 확인된 시점에서는 과업 지향적 시선이 증가하고 파트너 지향적 시선은 감소하며, 시선 엔트로피와 전환 빈도가 낮아지는 경향을 보였습니다. 이러한 효과는 과업을 주도하는 참여자에게서 가장 뚜렷하게 나타났습니다. 결론적으로 시선은 과업 및 대화 맥락과 함께 상호 이해를 판단하는 중요한 보조 지표로 활용될 수 있습니다.
AI 연구
기존 카메라 기반 3D 손 재구성은 저조도나 움직임이 심한 환경에서 성능이 저하되는 한계가 있습니다. 이벤트 카메라는 높은 동적 범위와 시간 해상도를 제공하지만, 1인칭 시점에서는 배경 노이즈로 인해 손 신호가 가려지는 문제가 발생합니다. 기존 방식은 좌우 손을 구분하지 못해 인스턴스별 정보가 부족하고 상호작용 예측이 부정확했습니다. 본 논문에서는 인스턴스 수준의 바운딩 박스와 마스크를 추정하는 Hand Detector와 손 간의 관계를 학습하는 Adaptive Attention을 결합한 EventEgoHands++를 제안합니다. 또한, 대규모 실세계 데이터셋인 EEH-R을 구축하여 성능을 검증했습니다. 실험 결과, 제안 방법은 합성 및 실세계 데이터셋 모두에서 기존 모델을 상회하는 성능을 보였습니다.
AI 연구
로봇이 낯선 환경에 적응하기 위해서는 미지의 상황에서도 학습할 수 있는 In-Context Learning(ICL) 능력이 필수적입니다. 그러나 기존 로봇 정책은 데모나 피드백을 즉각적인 동작으로 변환하는 데 한계가 있었습니다. 본 논문은 VLM의 에이전트 역량을 활용한 일반화 프레임워크인 GPT-Policy를 제안합니다. 이 시스템은 작업 관련 시각적 변화를 보존하는 컨텍스트 컴파일러, 동작을 제안하는 VLM, 그리고 동작을 검증 및 실행하는 제어기를 통합합니다. 실험 결과, 인간의 비디오 데모만으로도 작업 성공률이 향상되었으며, 이는 파라미터 수정 없이도 로봇이 새로운 작업을 수행할 수 있는 가능성을 보여주었습니다.
AI 연구
객체와 배경을 모두 포함하는 정교한 캡셔닝과 픽셀 단위의 정밀한 마스크 생성을 결합한 새로운 시각-언어 모델 프레임워크
AI 연구
MoE 모델을 긴 컨텍스트나 큰 배치 사이즈로 학습할 때, 평균 메모리 사용량이 아닌 특정 시점의 피크 메모리 초과로 인해 학습이 실패하는 문제가 발생합니다. 연구진은 전문가 분산(Expert Dispatch), 어휘 투영(Vocabulary Projection), 그래디언트 체크포인트, 옵티마이저 상태라는 네 가지 주요 메모리 병목을 식별했습니다. 이를 해결하기 위해 PipelinedLLEP, Ring-DTP, SCO, OffloadStreamAdamW라는 네 가지 스케줄링 기법을 제안하여 GPU 워킹 셋을 고정했습니다. 이 방법들은 계산 순서와 데이터 이동의 입도(granularity)만 변경하므로 손실 함수와 그래디언트의 정확도를 유지합니다. 실험 결과, 120B~667B 규모의 MoE 모델에서 기존 FSDP2 대비 최대 1M 컨텍스트 길이를 지원하며 훨씬 높은 처리량을 달성했습니다.
AI 연구
소비자용 하드웨어에서 35B급 MoE 모델을 구동할 때, 모델 크기로 인한 메모리 부족과 연산량 대비 높은 데이터 전송량(Memory Wall)이 병목 현상을 일으킵니다. 기존의 SSD 오프로딩 방식은 다음 레이어의 전문가(Expert)를 미리 알 수 없어 연산과 데이터 로딩을 중첩시키기 어렵다는 문제가 있습니다. 이를 해결하기 위해 Edge0는 다음 레이어의 라우팅을 미리 예측하는 '프리라우터(prerouter)' 기술을 도입하여 데이터 로딩과 연산을 동시에 수행합니다. 또한, 양자화 및 예측 오차로 인한 품질 저하를 방식을 보완하기 위해 학습된 LoRA 어댑터를 사용합니다. 그 결과, 24GB 메모리 환경에서 35B MoE 모델을 20tok/s의 속도로 구동하며 높은 성능을 유지합니다.
AI 연구
기존의 Mixture-of-Agents(MoA) 방식은 쿼리 라우팅과 에이전트 미세 조정이 분리되어 있어, 에이전트의 능력이 변할 때 라우팅 전략이 이를 따라가지 못하는 문제가 있었습니다. 이를 해결하기 위해 에이전트 정책과 동적 라우터가 서로 상호작용하며 발전하는 CERA-MoA 프레임워크를 제안합니다. 중간 레이어의 은닉 상태를 활용한 '예측 친숙도 추정기'를 통해 전체 추론 과정 없이도 에이전트의 역량을 평가합니다. 또한 누적 임계값 기반의 적응형 라우팅을 통해 최소한의 에이전트만 활성화하여 효율성을 확보합니다. 실험 결과, CERA-MoA는 기존의 정적 라우팅 및 고정 워크플로우 방식보다 뛰어난 성능과 효율성을 입증했습니다.
AI 연구
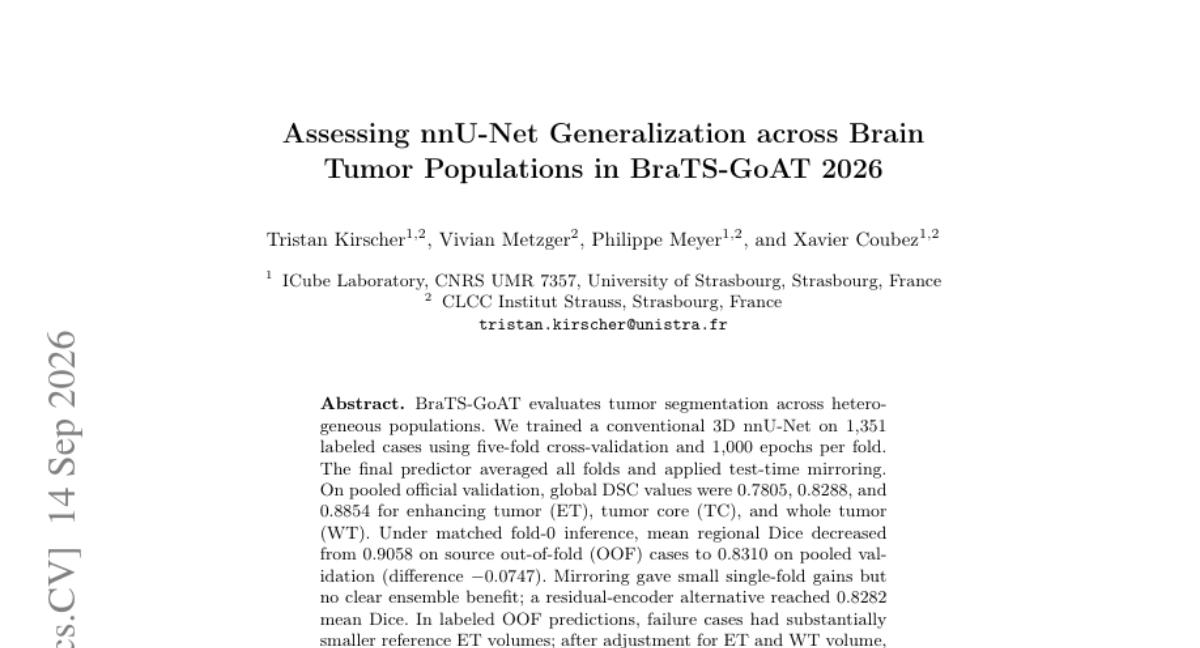
BraTS-GoAT 챌린지는 이질적인 환자군 사이의 종양 분할 일반화 성능을 평가합니다. 연구진은 1,351개의 라벨링된 케이스를 사용하여 3D nnU-Net을 학습시켰습니다. 검증 결과, ET, TC, WT 영역에서 각각 0.7805, 0.8288, 0.8854의 DSC를 기록했습니다. 학습 데이터와 다른 분포의 검증 데이터 적용 시 성능 저하가 관찰되었습니다. 분석 결과, 작은 ET(Enhancing Tumor) 볼륨과 분절된 종양 형태가 낮은 Dice 점수의 주요 원인으로 나타났습니다.
AI 연구
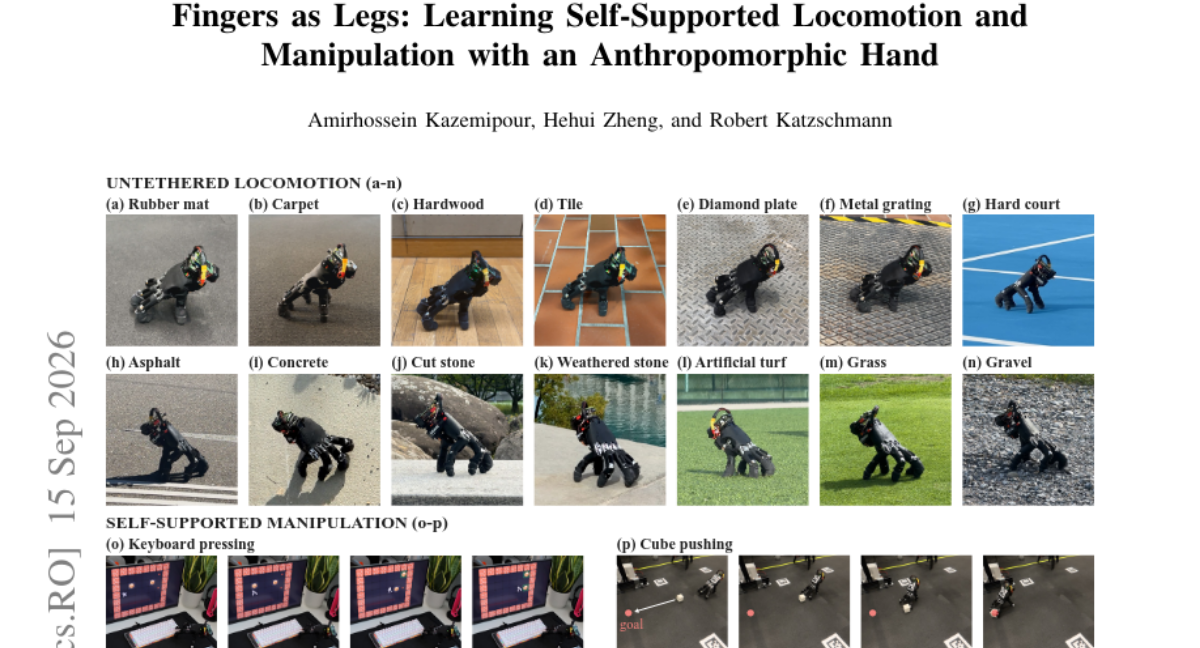
기존 로봇은 이동과 조작을 위한 메커니즘이 분리되어 있어 부피와 복잡성 문제가 존재합니다. 본 연구는 손가락을 다리처럼 사용하여 이동과 상호작용을 동시에 수행하는 인간형 손 로봇을 제안합니다. 하드웨어 측정값을 기반으로 캘리브레이션된 시뮬레이션 환경에서 강화학습을 통해 비대칭적인 손가락 구조를 고려한 정책을 학습시켰습니다. 실험 결과, 제안된 보상 체계는 기존 4족 보행용 보상보다 빠른 이동을 가능하게 했습니다. 하드웨어 실증을 통해 자립형 크롤링, 조향, 낙하 회복 및 물체 조작 능력을 입증했습니다. 이를 통해 별도의 이동 장치 없이도 이동과 조작이 가능한 컴팩트한 모바일 매니퓰레이터의 가능성을 보여주었습니다.
AI 연구
에이전트 세션이 길어지고 다수의 세션이 동시에 실행되면, 호스트 메모리에 저장된 KV 캐시를 스캔하는 과정이 디코딩 성능의 병목이 됩니다. 기존 방식은 모든 키를 전체 비트로 읽어야 하므로 데이터 전송량이 과도하게 발생합니다. Fathom은 각 쿼리가 채널별 중요도에 따라 읽을 비트 수를 결정하는 가변적 스캔 방식을 제안합니다. 4비트 K 캐시를 비트 평면(bit planes) 형태로 저장하여, 쿼리가 필요한 만큼의 상위 비트만 읽어 연산량을 조절합니다. 실험 결과, 기존 Sparse Decoding 방식보다 훨씬 적은 데이터 전송량으로도 높은 정확도와 빠른 디코딩 속도를 달성했습니다.
30건
이날 공개된 제품과 도구


6건
새 모델과 주요 평가 결과
HF Model Trending
Edge0/Edge0-35B-A3B-preview 모델이 Hugging Face에서 높은 관심을 받으며 트렌딩 중입니다. 약 34.7B 파라미터를 보유한 text-generation 태그의 모델입니다.
HF Model Trending
DavidAU에서 공개한 Qwen3.8-27B 기반의 GGUF 양자화 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 이미지와 텍스트를 동시에 처리하는 멀티모달 기능을 갖춘 것이 특징입니다.
HF Model Trending
ukisai/Swift-Qwen3.8-27b 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 27B 규모의 파라미터를 가진 image-text-to-text 태스크용 모델입니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.