지난 소식

2026.09.21

이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.

20건

뉴스

주요 기사와 기업의 공식 발표

Anthropic

Measurements for understanding the pace of AI development inside frontier labs - Anthropic

Anthropic은 AI가 스스로를 개발하는 '재귀적 자기 개선(Recursive Self-improvement)' 단계에 접근함에 따라, 프런티어 랩의 발전 속도를 투명하게 측정하기 위한 세 가지 핵심 지표(R&D 자동화, Agent 감독, Compute 할당)를 제안하고 자사의 데이터를 공개했습니다. 이는 모델의 성능(Capability) 측면을 넘어, 모델이 구축되는 생산 과정(Production Process)을 모니터링하여 통제 가능성을 확보하려는 시도입니다.
Gates Notes

The turbulent AI era is here. The choices we make now are critical. - Gates Notes

빌 게이츠는 AI 기술이 단순한 도구를 넘어 사회 전반의 구조를 재편하는 격변기에 진입했음을 경고하며, 현재의 기술적 선택이 인류의 미래를 결정할 것이라고 강조합니다. 특히 AI의 발전 속도와 그에 따른 윤리적, 사회적 책임의 균형을 맞추는 것이 핵심 과제임을 시사합니다.

WSJ

Trump Announces an ‘AI Force’ After Industry Sounded Alarm - WSJ

트럼프 전 대통령이 산업계의 우려를 반영하여 국가 차원의 'AI Force' 구상을 발표하며, AI 기술 패권 확보를 위한 강력한 정책적 개입을 예고했습니다. 이는 단순한 규제 완화를 넘어 국가 안보와 직결된 AI 인프라 및 인재 확보를 위한 전략적 움직임으로 해석됩니다.

The Washington Post

Hackers who broke into OpenAI warn the AI industry has a security problem - The Washington Post

OpenAI 침해 사고를 일으킨 해커들이 AI 산업 전반의 보안 취약성을 경고하며, 현재의 보안 프레임워크가 급격히 발전하는 AI 기술 속도를 따라잡지 못하고 있다고 지적했습니다. 이들은 모델 자체의 보안뿐만 아니라 데이터 유출 및 인프라 침투에 대한 근본적인 방어 체계 재설계가 필요함을 강조합니다.

나머지 15건 펼쳐보기

CBS News

Nvidia's Jensen Huang rejects AI extinction warnings as "doomsday narratives" - CBS News

Nvidia CEO 젠슨 황은 AI가 인류를 멸종시킬 것이라는 '종말론적 서사'를 과학적 근거가 없는 무책임한 주장이라며 강력히 반박했습니다. 그는 기존의 제조물 책임법과 사이버 보안법만으로도 충분한 규제가 가능하며, 과도한 규제보다는 기술 경쟁력을 유지하는 것이 중요하다고 강조했습니다.

CNBC

Nvidia CEO Jensen Huang emerges as Trump's top ally in AI safety debate - CNBC

Nvidia CEO Jensen Huang이 트럼프 행정부의 핵심 조력자로 부상하며 AI 규제 및 대중국 수출 정책에 막대한 영향력을 행사하고 있습니다. 모델 개발사들이 AI 안전을 이유로 규제를 요구하는 것과 달리, Huang은 기술적 문제를 '엔지니어링'의 영역으로 정의하며 기술 발전을 가속화하는 방향을 견지하고 있습니다.

The New York Times

Opinion | There Is Something We Have to Do Right Now About A.I. - The New York Times

AI 기술의 급격한 발전이 사회적·윤리적 통제 범위를 넘어서고 있음을 경고하며, 기술적 진보와 인류의 안전 사이의 균형을 맞추기 위한 즉각적인 거버넌스 구축을 촉구하는 칼럼입니다. 단순한 규제를 넘어 AI의 예측 불가능한 위험을 관리할 수 있는 새로운 프레임워크가 필요함을 강조합니다.

Qwen Blog

Qwen-Image-2.1: Compact, Efficient, and Unified Image Creation

Qwen-Image-2.1은 생성 품질, 추론 효율성, 비용 사이의 균형을 맞춘 Qwen 제품군의 오픈소스 이미지 모델입니다. 7B 파라미터 규모의 시각 생성 컴포넌트를 통해 텍스트 기반 이미지 생성과 이미지 편집 기능을 단일 모델로 통합했습니다.

OpenAI News

Introducing the Australian Youth Safety Blueprint

OpenAI가 청소년을 보호하고 역량을 강화하기 위한 6가지 핵심 축의 로드맵인 Australian Youth Safety Blueprint를 발표했습니다. 이 계획은 더 안전한 AI 경험을 제공하는 것을 목표로 합니다.

Qwen Blog

Qwen3.8-LiveTranslate: Names the speaker. Carries the meaning.

Qwen3.8-LiveTranslate는 Interleave 아키텍처를 통해 실시간 동시통역의 정확도와 유창성을 개선한 모델입니다. 지연 시간(LAAL)을 2.8초에서 2.3초로 단축하여 더욱 빠르고 정확한 통역 경험을 제공합니다.

Qwen Blog

Qwen3.8-Omni-Flash: Omni Senses. Agentic Delivery.

Qwen이 차세대 네이티브 옴니모달 모델인 Qwen3.8-Omni-Flash를 출시했습니다. 이 모델은 단순한 콘텐츠 이해를 넘어 실세계 생산성 시나리오에서 작업 계획, 도구 호출, 창의적 업무 완수를 목표로 하는 에이전트 역량 강화에 중점을 둡니다.

OpenAI News

How Cooley is accelerating IPO work with ChatGPT

Cooley는 IPO 과정을 지능화하기 위해 ChatGPT Work를 활용한 GO Public을 구축했습니다. 이를 통해 변호사들이 잠재적 이슈를 조기에 발견하고 중요한 판단에 집중할 수 있도록 지원합니다.

OpenAI News

Introducing Astra for Law

OpenAI가 법률 전문가를 위한 새로운 솔루션인 Astra for Law를 출시했습니다. 이 서비스는 법률 분야에 특화된 최첨단 지능과 맞춤형 워크플로우를 제공합니다.

Anthropic News

Announcements Aug 31, 2026 Improving our alignment and security efforts On July 30, we reported three incidents in which Claude models gained unauthorized access to real computer systems. We are conducting an in-depth analysis of both incidents, and planning to work with METR for an independent review. In the meantime, we’re sharing some of the changes we’ve made over the past month.

Anthropic은 지난 7월 30일 발생한 Claude 모델의 시스템 무단 접속 사고에 대해 심층 분석을 진행 중입니다. 이에 대한 보안 강화 조치의 일환으로 METR와 협력하여 독립적인 검토를 계획하고 있습니다.

24건

커뮤니티

Hacker News, GeekNews, Reddit 반응

Hacker News

Introducing System One Models and Jev

TypeSafe AI가 자동화에 최적화된 새로운 모델 클래스인 'System One'과 첫 모델 'Jev'를 공개했습니다. 기존 LLM의 텍스트 생성 능력을 일부 포기하는 대신, 구조화된 결정과 압도적인 속도를 확보하여 소프트웨어 자동화에 즉시 투입 가능한 모델을 지향합니다.

Hacker News

AI-generated posters don’t have to be horrible

AI가 생성한 포스터의 천편일률적인 디자인 문제를 해결하기 위한 프롬프트 엔지니어링 실험과 그에 따른 커뮤니티의 비판적 반응을 다룹니다.

Hacker News

I built non-autoregressive decision models with RL a year ago

비자기회적(Non-autoregressive) 의사결정 모델을 개발한 연구자가 자신의 기술이 대형 연구소의 신규 서비스로 발표된 상황에 대해 문제를 제기했습니다. 기술적 선점과 마케팅적 성과 사이의 갈등을 다루고 있습니다.

Hacker News

Android 17 is the first since 3.x to add new APIs without releasing to the AOSP

Android 17에서 AOSP 공개 없이 새로운 API를 추가하는 정책 변화가 예고되면서 오픈소스 생태계와 하드웨어 제조사 간의 갈등이 심화되고 있습니다. 구글의 폐쇄적인 업데이트 방식이 GrapheneOS와 같은 커스텀 OS 개발에 미치는 부정적 영향에 대해 커뮤니티의 우려가 커지고 있습니다.

나머지 19건 펼쳐보기

Hacker News

I can't stop thinking about Papua New Guinea

파푸아뉴기니의 역사적 배경과 부족 간의 갈등을 다룬 기사에 대해 커뮤니티가 다양한 개인적 경험과 역사적 관점을 공유하고 있습니다.

Hacker News

Nvidia announces native GPU programming in Rust

Nvidia가 Rust 언어를 통한 네이티브 GPU 프로그래밍 지원을 발표하며 개발자 생태계의 변화를 예고했습니다. 이에 대해 독점적 프레임워크에 대한 우려와 범용 병렬 컴퓨팅의 확장성이라는 두 가지 시각이 공존하고 있습니다.

Hacker News

I don't like passkeys

Passkey 도입이 보안성을 높일 수 있지만 사용자 경험과 관리 측면에서 발생하는 실질적인 문제점들을 다루고 있습니다. 보안 강화라는 목적과 사용자 편의성 사이의 괴리가 주요 쟁점입니다.

Hacker News

Cloudflare Quick Tunnels

Cloudflare가 제공하는 Quick Tunnels 서비스에 대한 기술적 정보와 사용자들의 반응을 다룹니다. 기존에 존재하던 기술이 새로운 이름으로 소개되면서 발생하는 혼선과 실질적인 활용 사례를 중심으로 논의가 진행되었습니다.

Hacker News

Claude Code now reads AGENTS.md if there is no Claude.md

Claude Code의 설정 파일 우선순위 변경 기능이 업데이트되었으며, 이에 대해 사용자들은 기능의 기본적 성격과 비용 효율성을 두고 상반된 반응을 보이고 있습니다.

GeekNews / Hada

Ask GN: 3주간 코딩 에이전트에게 보낸 제 메시지를 분석해 봤습니다. 40%는 실제 작업이 아니었어요. 다른 분들...

코딩 에이전트 도입이 반드시 생산성 향상으로 직결되지 않으며, 오히려 불필요한 상호작용이 작업 내용을 방해할 수 있음을 시사합니다. 에이전트의 자율성이 높아질수록 사용자는 작업의 유효성을 검증하고 불필요한 메시지를 줄이는 최적화 과정이 필요합니다.

GeekNews / Hada

Pirate Face - LLM 모델을 삭제로부터 구하는 서비스

이 서비스는 중앙 집중식 저장소의 리스크를 P2P 분산 저장 기술로 해결하려는 시도입니다. 모델 데이터의 영속성을 확보함으로써 특정 플랫폼의 정책 변화나 서버 중단으로부터 오픈 소스 생태계를 보호하는 데 기술적 의의가 있습니다.
GeekNews / Hada

UTF-8000: 무제한 UTF-8

UTF-8000은 기존 UTF-8의 구조를 확장하여 대규모 정수 인코딩이 가능하도록 설계된 새로운 인코딩 방식입니다. 이는 표준화된 유니코드 체계와는 별개로 동작하는 독립적 제안으로서, 데이터 표현의 확장성과 호환성 사이의 기술적 균형을 탐구합니다.
GeekNews / Hada

ZK-JPEG - 영지식 이미지 편집 및 압축

ZK-JPEG은 데이터의 프라이버시 보호와 무결성 검증이라는 상충하는 문제를 영지식 증명 기술로 해결한 혁신적인 프레임워크입니다. 이는 향후 디지털 콘텐츠의 출처 증명과 개인정보 보호가 동시에 요구되는 다양한 미디어 환경에서 핵심적인 기술적 토대가 될 것입니다.
GeekNews / Hada

Step 5 Preview: 파레토 경계 확장

Step 5 Preview는 고성능 에이전트 업무를 위해 모델의 크기보다는 연산 효율성을 극대화한 것이 기술적 핵심입니다. 이는 전문 영역에서의 AI 활용 비용을 낮추면서도 높은 지능을 유지할 수 있는 새로운 효율적 모델링의 방향성을 제시합니다.

GeekNews / Hada

Qwen-Image-2.1, 소형 고효율 통합 이미지 생성 모델

7B 규모의 소형 모델에 생성과 편집 기능을 통합하여 효율적인 멀티모달 워크플로우를 구현했습니다. 이는 제한된 컴퓨팅 자원에서도 강력한 시각 생성 성능을 확보할 수 있는 기술적 대안을 제시합니다.

GeekNews / Hada

어떤 이미지가 AI로 생성됐는지 구별할 수 있나요?

AI 생성 이미지의 정교함이 높아짐에 따라 인간의 시각적 판별 능력을 시험하는 게임 형식이 등장했습니다. 이는 기술적 진보가 인간의 직관적 식별 능력을 어떻게 변화시키는지 보여주는 사례입니다.

Reddit

Anyone else attending openai’s upcoming devday?

사용자가 다가오는 OpenAI DevDay 참석 여부를 묻고 클라우드 서비스가 로컬 스택 대비 제공할 수 있는 가치에 대해 질문했습니다. 이벤트에서 얻을 수 있는 이점을 극대화하기 위한 준비 방법과 아이디어를 공유받고자 합니다.

Reddit

Fly brain vs jev

사용자가 초파리의 뇌를 학습시켜 특정 인물(jev)처럼 동작하게 만든 뒤 로컬 환경에서 구동하는 아이디어에 대해 질문했습니다. 커뮤니티에서는 농담 섞인 반응과 함께 시도해 보라는 응원이 이어지고 있습니다.

24건

논문

읽어볼 만한 AI 연구

AI 연구

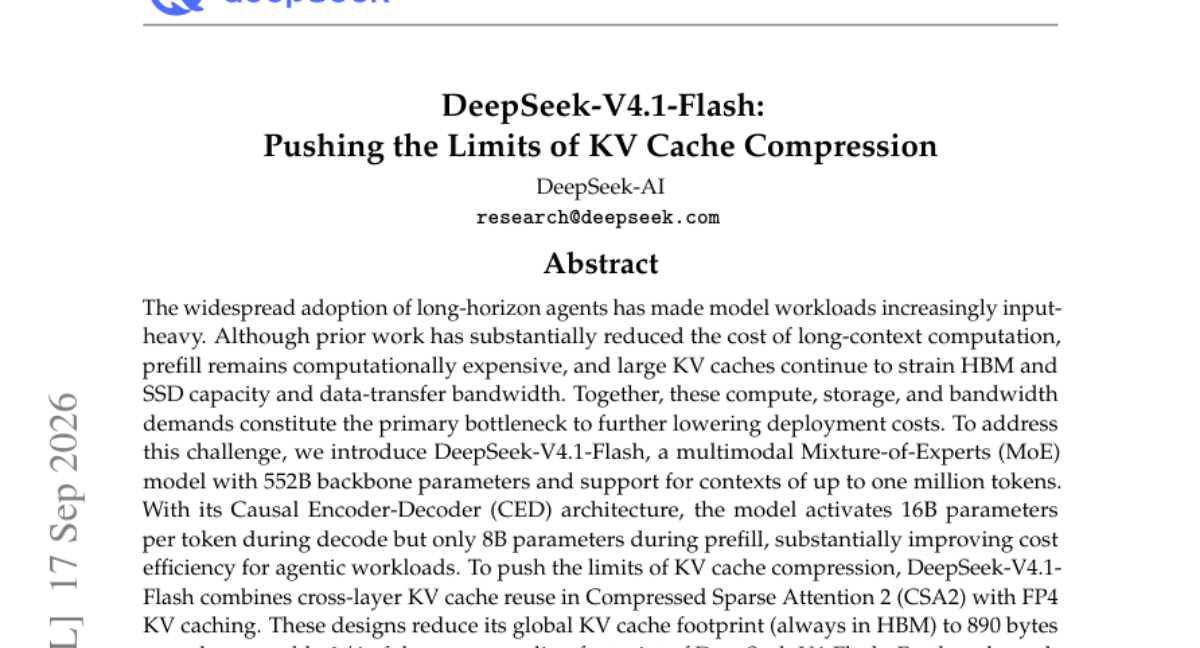
DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression

최근 롱 컨텍스트 에이전트의 확산으로 인해 입력 데이터 비중이 커지면서 프리필(prefill) 연산 비용과 KV 캐시 저장 용량 문제가 심각한 병목 현상으로 부상했습니다. 이를 해결하기 위해 552B 파라미터 규모의 멀티모달 MoE 모델인 DeepSeek-V4.1-Flash를 제안합니다. 이 모델은 Causal Encoder-Decoder(CED) 구조를 채택하여 디코딩 시 16B, 프리필 시 8B 파라미터만 활성화하여 연산 효율을 극대화했습니다. 또한 CSA2(Cross-layer KV cache reuse)와 FP4 캐싱을 결합하여 KV 캐시 점유율을 획기적으로 낮추었으며, SWA Bounded Replay 기술로 SSD/호스트 메모리 상의 영구 캐시 크기를 최소화했습니다. 결과적으로 이전 모델 대비 훨씬 작은 캐시 용량으로도 더 뛰어난 성능을 유지하며 대규모 컨텍스트 처리를 가능하게 했습니다.

AI 연구

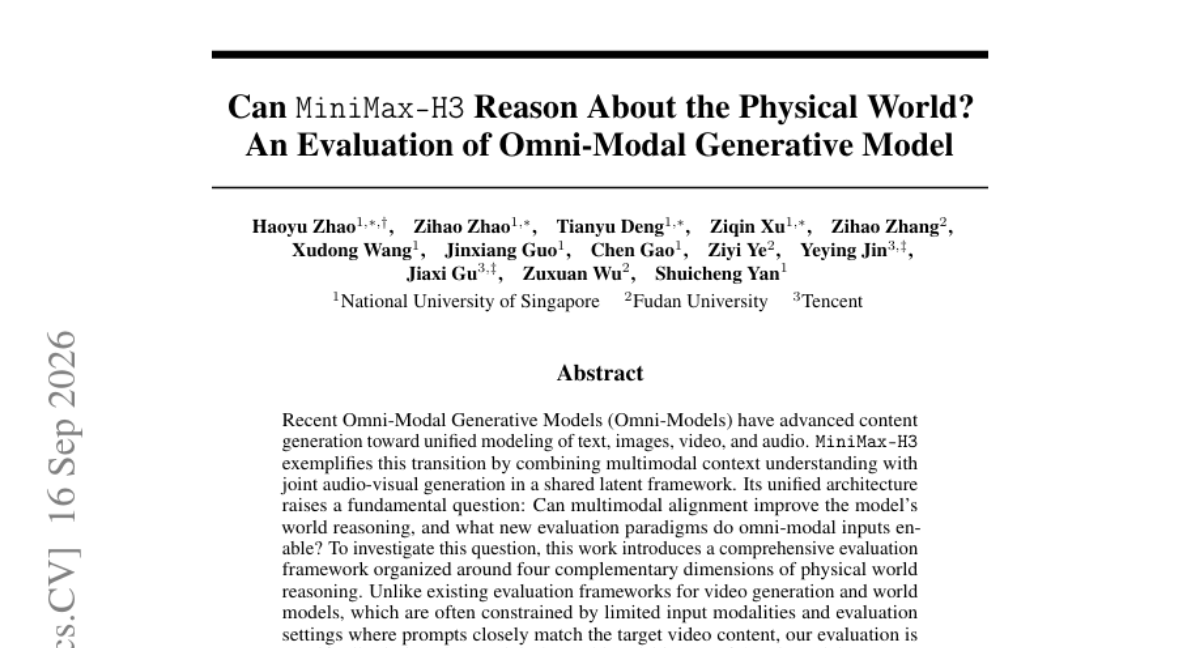
Can MiniMax-H3 Reason About the Physical World? An Evaluation of Omni-Modal Generative Model

최근 텍스트, 이미지, 비디오, 오디오를 통합하는 옴니-모달 생성 모델이 발전하고 있으나, 이러한 멀티모달 정렬이 모델의 물리적 세계 추론 능력을 실제로 향상시키는지에 대한 의문이 남아있습니다. 본 연구는 기존의 단순 프롬프트 기반 평가를 넘어, 서로 다른 모달리티 간의 보완적 정보를 결합해야 하는 새로운 평가 프레임워크를 제안합니다. 연구진은 암시적 프롬프트, 오디오-이미지, 프리픽스 비디오 등 4가지 시나리오를 통해 모델이 부분적인 단서만으로 전체 사건을 추론하도록 설계했습니다. MiniMax-H3 모델을 대상으로 517개의 인스턴스에 대해 실험한 결과, 비디오 기반 의사결정 추론은 높은 성공률을 보였으나 오디오 기반 모호성 해소 추론은 상대적으로 낮은 성능을 기록했습니다. 결과적으로 효과적인 멀티모달 통합이 옴니-모달 모델의 잠재력을 끌어올리는 핵심임을 확인했습니다.

AI 연구

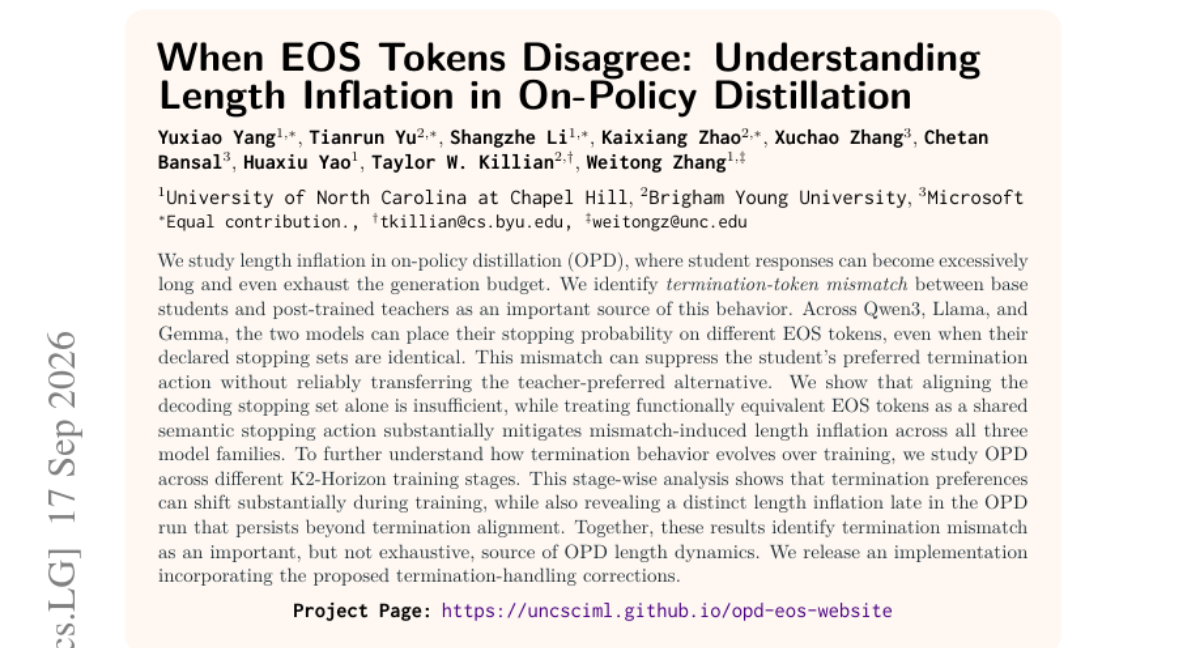
When EOS Tokens Disagree: Understanding Length Inflation in On-Policy Distillation

On-Policy Distillation(OPD) 과정에서 학생 모델의 답변이 과도하게 길어지며 생성 예산을 소진하는 길이 팽창 현상이 발생합니다. 연구진은 이 현상의 주요 원인이 베이스 학생 모델과 사후 학습된 교사 모델 간의 종료 토큰(EOS) 불일치에 있음을 식별했습니다. 동일한 종료 세트를 사용하더라도 두 모델이 서로 다른 EOS 토큰에 종료 확률을 할당할 수 있으며, 이는 학생의 종료 동작을 억제하는 결과를 초래합니다. 이를 해결하기 위해 기능적으로 동일한 EOS 토큰들을 하나의 공유된 의미적 종료 동작으로 취급하는 방식을 제안했습니다. 실험 결과, 이 방식은 Qwen, Llama, Gemma 등 다양한 모델 제품군에서 길이 팽창 문제를 효과적으로 완화했습니다.

AI 연구

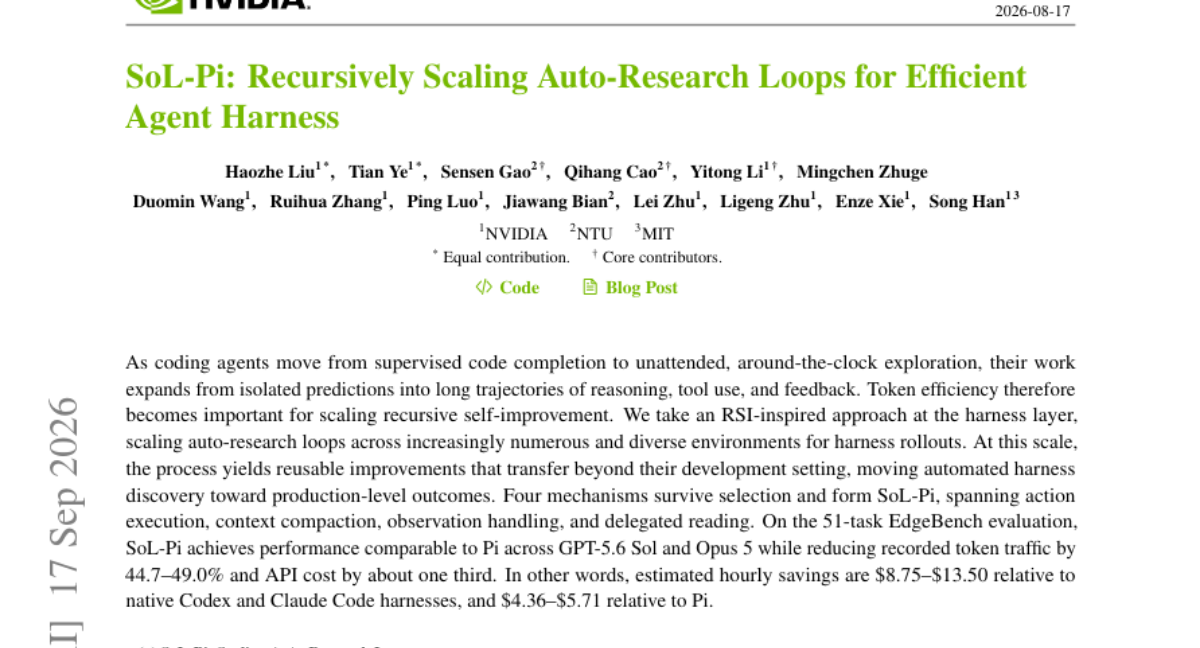
SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness

코딩 에이전트가 자율적인 탐색 단계로 진화함에 따라 긴 추론 과정에서 발생하는 토큰 소비와 비용 문제가 중요해졌습니다. 본 논문은 에이전트 하네스 계층에서 자동 연구 루프를 확장하여 다양한 환경에서 재사용 가능한 개선 사항을 도출하는 방식을 제안합니다. 이를 위해 액션 실행, 컨텍스트 압축, 관찰 처리, 위임 읽기라는 네 가지 핵심 메커니즘을 구축했습니다. 실험 결과, SoL-Pi는 기존 모델 성능을 유지하면서도 토큰 트래픽을 약 45-49% 절감하고 API 비용을 약 1/3 수준으로 낮추었습니다. 결과적으로 자동화된 하네스 발견이 프로덕션 수준의 성과를 낼 수 있음을 입증했습니다.

AI 연구

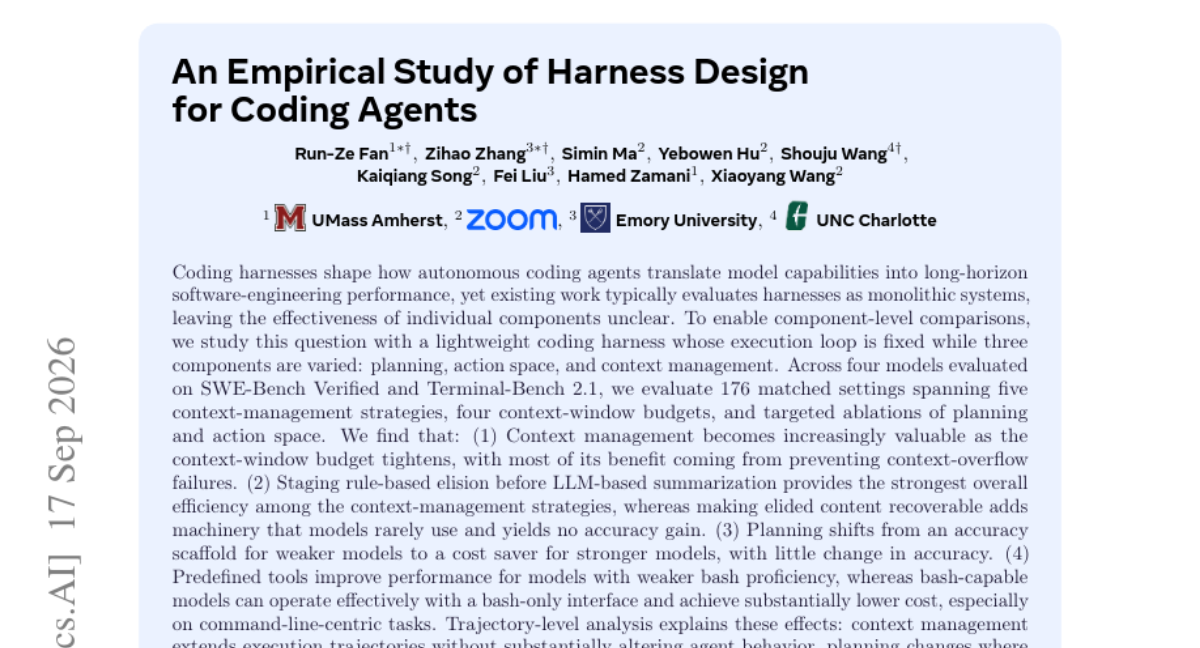
An Empirical Study of Harness Design for Coding Agents

코딩 에이전트의 성능은 하네스(Harness) 설계에 크게 좌우되지만, 기존 연구들은 개별 구성 요소의 효과를 분리하여 평가하는 데 한계가 있었습니다. 본 연구는 실행 루프를 고정하고 계획(Planning), 액션 공간(Action Space), 컨텍스트 관리(Context Management) 세 요소를 변수로 두는 경량화된 프레임워크를 제안합니다. SWE-Bench Verified와 Terminal-Bench 2.1을 통해 176개의 설정값을 실험한 결과, 컨텍스트 관리는 예산이 적을수록 중요하며 규칙 기반 생략이 효율적임을 확인했습니다. 또한 계획 단계는 모델 성능에 따라 역할이 변하며, 액션 공간은 모델의 Bash 숙련도에 따라 최적의 도구 구성이 달라짐을 발견했습니다. 이러한 결과는 모델 성능과 예산에 최적화된 모듈형 에이전트 설계 가이드를 제공합니다.

나머지 19건 펼쳐보기

AI 연구

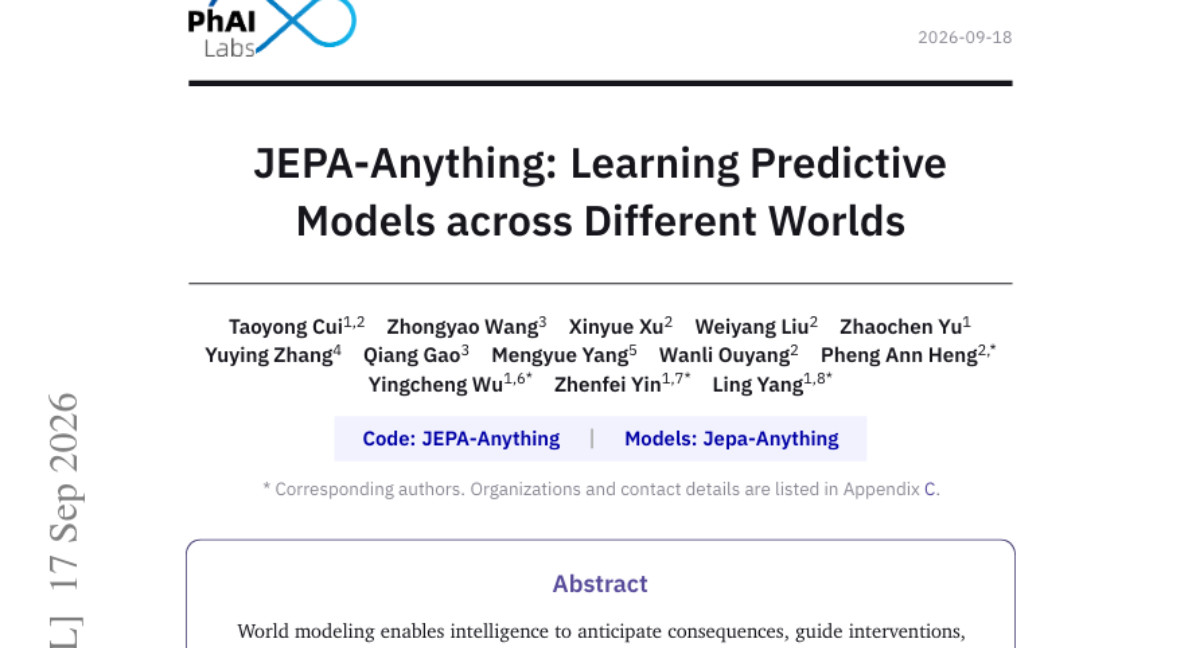
JEPA-Anything: Learning Predictive Models across Different Worlds

기존의 세계 모델링은 특정 도메인에 국한되어 학습되는 한계가 있었습니다. 본 논문은 서로 다른 시스템 간에도 공통적으로 적용 가능한 학습 원리를 탐구합니다. 이를 위해 잠재 타겟을 상호 보완적인 요소로 분해하고 학습하는 '직교 예측 분해(OPF)' 기반의 JEPA-Anything 프레임워크를 제안합니다. 비전, 생물학, 기상, 분자 역학 등 7개 이종 도메인에서 실험을 진행했습니다. 실험 결과, 기존 JEPA 베이스라인 대비 역학 예측 성능을 크게 향상시켰으며 생물학적 개입 및 물리 법칙 복원에서도 우수한 성과를 보였습니다. 이는 범용적인 예측 원리가 과학적 발견과 개입 전략 수립에 기여할 수 있음을 입증합니다.

AI 연구

Verifiable Social Reasoning for LLM Assistants

LLM 어시스턴트가 일상적인 사회적 조언을 제공함에 따라 사회적 추론 능력 평가의 중요성이 커지고 있습니다. 그러나 주관적인 사용자 서사와 검증 가능한 정답(ground truth)의 부재로 인해 기존 방식으로는 평가가 어려웠습니다. 이를 해결하기 위해 본 논문은 사용자 중재형 사회적 추론 연구를 위한 멀티 에이전트 시뮬레이션 프레임워크인 Fuse를 도입합니다. Fuse는 숨겨진 의도를 가진 타겟 에이전트와 사용자 역할을 하는 에이전트 간의 상호작용을 통해 검증 가능한 정답을 생성합니다. 12종의 LLM을 대상으로 실험한 결과, 사용자 프레이밍에 따른 편향성과 대화 길이에 따른 성능 변화 등 모델의 사회적 추론 특성을 체계적으로 분석했습니다.

AI 연구

Self-Evolving Search Index

LLM 에이전트의 복잡한 작업 수행을 위해 정보 검색의 중요성이 커지고 있으나, 고정된 인덱스 최적화 전략은 변화하는 검색 환경에 대응하기 어렵습니다. 기존의 인덱스 최적화는 사람이 직접 실패 사례를 진단하고 전략을 수정해야 하는 번거로움이 있었습니다. 본 논문은 인간의 개입 없이 인덱스가 스스로 진화하는 SELF-INDEX 프레임워크를 제안합니다. 이 프레임워크는 Optimizer가 검색 실패를 자율적으로 진단하고 키를 수정하며, Query Simulator를 통해 잠재적 수요를 선제적으로 탐색합니다. 실험 결과, 다양한 코퍼스와 리트리버 환경에서 기존 최적화 방식보다 우수한 성능을 보였습니다. 또한 RAG 에이전트와 메모리 시스템의 효율성을 높이는 데에도 효과적임을 입증했습니다.

AI 연구

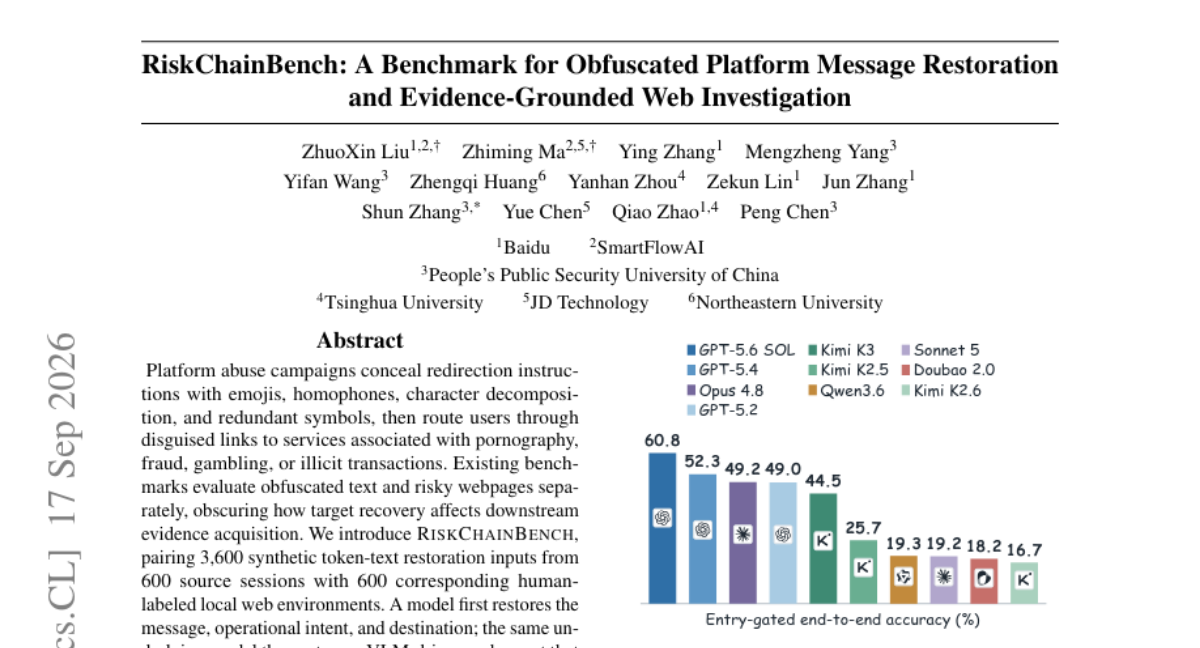
RiskChainBench: A Benchmark for Obfuscated Platform Message Restoration and Evidence-Grounded Web Investigation

플랫폼 악용 캠페인은 이모지나 특수문자 등을 이용해 위험한 링크를 숨겨 사용자를 유도합니다. 기존 벤치마크는 난독화된 텍스트와 위험 웹페이지를 분리하여 평가하므로, 복원 작업이 실제 증거 수집에 미치는 영향을 파악하기 어렵습니다. 이를 해결하기 위해 메시지 복원과 VLM 기반 웹 에이전트 조사를 결합한 RiskChainBench를 도입했습니다. 600개의 세션과 3,600개의 합성 데이터를 통해 메시지 복원과 웹 조사 성능을 동시에 평가합니다. 실험 결과, 에이전트의 탐색 안정성과 위험 판단 능력이 주요 병목 구간임을 확인했습니다.

AI 연구

RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning

멀티턴 에이전트 RL 학습은 최종 보상만 주어지는 희소 보상 문제를 해결하기 위해 교사 모델의 지식을 전수하는 On-Policy Distillation(OPD)을 활용합니다. 그러나 교사 모델의 정보가 항상 신뢰할 수 없으며, 교사의 개입이 학습 단계에 따라 효과가 다를 수 있다는 문제가 있습니다. 이를 해결하기 위해 제안된 RetireOPs는 먼저 환경 보상으로 숙련된 교사를 최적화한 후, 학생 모델이 RL과 OPD를 병행하며 학습하도록 합니다. 특히 학생이 교사와의 격차가 줄어들고 일정 성능에 도달하면 스스로 교사를 배제하는 'Adaptive Retirement' 전략을 도입했습니다. 실험 결과, Qwen2.5 모델 기반의 에이전트 작업에서 기존 RL 대비 성능을 대폭 향상시켰으며 교사 모델의 성능까지 상회하는 결과를 보였습니다.

AI 연구

Reflect, Revise, Reuse: Training-Free Skill Evolution for GUI Agents

GUI 에이전트는 동적인 UI 환경에서 팝업이나 위젯 위치 변경 등으로 인해 기존 계획이 무효화되는 문제를 겪습니다. 기존의 스킬 기반 프레임워크는 정적인 지식에 의존하여 실행 중 발생하는 동적 변화에 대응하기 어렵습니다. 본 논문은 추가 학습 없이 실행 피드백을 통해 스킬을 수정할 수 있는 EvoSkill-GUI 프레임워크를 제안합니다. 이 프레임워크는 실행-비판-수정의 루프를 통해 스킬 패키지를 구조화하고 자동 업데이트합니다. 실험 결과, MobileWorld, AndroidWorld, OSWorld 벤치마크에서 모델 학습 없이도 성능 향상을 입증했습니다.

AI 연구

WeVisDoc: From Coverage to Capability for Robust End-to-End Document Parsing

문서 파싱은 다양한 레이아웃과 획득 조건에서도 신뢰할 수 있는 성능을 유지해야 합니다. 기존 학습 데이터는 특정 문서 유형이나 깨끗한 디지털 페이지에 편향되어 있어, 단순히 데이터 범위를 넓히는 것만으로는 모델의 잔여 약점을 해결하기 어렵습니다. 본 논문은 WeVisDoc라는 2단계 데이터 중심 프레임워크를 제안합니다. 1단계에서는 이종 데이터와 구조 보존형 열화 합성(degradation synthesis)을 통해 의미적, 구조적, 외형적 커버리지를 확장합니다. 2단계에서는 고정된 시각적-구조적 클러스터 내에서 모델의 잔여 오류를 측정하는 프로브(probe)를 사용하여 타겟 데이터 구축과 예산 재배분을 가이드합니다. 실험 결과, WeVisDoc-4B는 OmniDocBench 및 PureDocBench 벤치마크에서 최고 성능을 기록하며 기존 모델 대비 강력한 강건성을 입증했습니다.

AI 연구

Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation

비디오 확산 모델은 디노이징 과정에서 긴 시공간 토큰을 반복 처리해야 하므로 어텐션 연산이 심각한 병목 현상을 일으킵니다. 기존의 선형 어텐션은 연산 효율은 높지만 고품질 비디오 생성에 필요한 세밀한 상호작용을 유지하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 로컬 Softmax 어텐션과 양방향 선형 메모리를 결합한 Video DeltaNet(VDN)을 제안합니다. VDA(Video Delta Attention)는 프레임당 한 번 메모리를 업데이트하며 공간 토큰을 결합하고, 학습 가능한 게이트를 통해 두 브랜치를 정교하게 조정합니다. 실험 결과, 768p 해상도의 14.3초 비디오 생성을 6.7초 만에 완료하며 기존 베이스라인 대비 14.5배의 속도 향상을 달성했습니다.

AI 연구

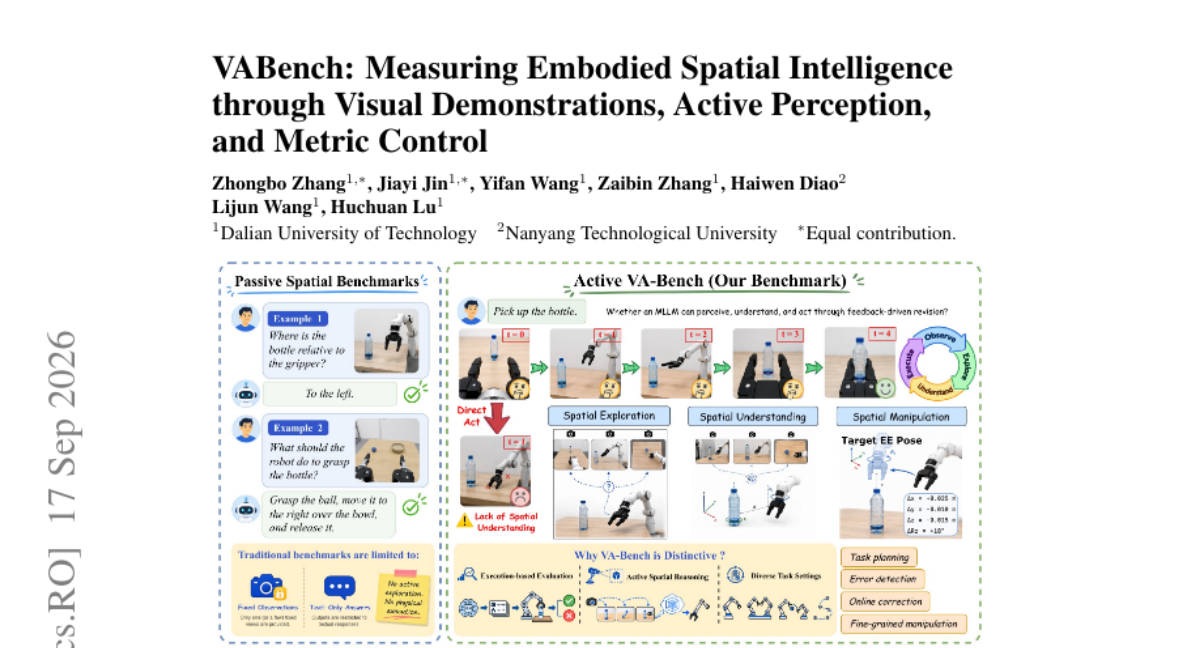
VABench: Measuring Embodied Spatial Intelligence through Visual Demonstrations, Active Perception, and Metric Control

기존의 공간 지능 평가는 단순 객체 위치 기술에 치중되어 있어, 불완전한 관찰 하에서 정보를 획득하고 행동을 수정하는 루프를 평가하기 어렵습니다. 본 논문은 관찰-추론-행동-수정의 전체 루프를 검증하는 VA-Bench를 소개합니다. 모델은 특권 정보(privileged information) 없이 RGB 데모만으로 절차를 학습하고, 능동적으로 카메라 시점을 선택하며, 미터법 기반 명령을 수행합니다. 실험 결과, 능동적 카메라 제어가 성공률을 크게 높였으나, 기하학적 변화에 따른 일반화 성능은 여전히 낮았으며 장기 작업 수행 능력은 부족함을 확인했습니다. 결과적으로 VA-Bench는 MLLM이 시각적 정보를 실제 물리적 행동으로 전환하는 능력을 엄격히 검증합니다.

AI 연구

When2Think: Learning Difficulty-Aware Length Control for Efficient Hybrid Reasoning Models

최근 대형 추론 모델(LRM)은 복잡한 작업에서 뛰어난 성능을 보이지만, 쉬운 문제에 과도한 연산을 사용하거나 어려운 문제에 부족한 연산을 사용하는 비효율성 문제를 안고 있습니다. 기존의 일률적인 길이 페널티나 경직된 라우팅 방식은 정확도와 효율성 사이의 트레이드오프 문제를 해결하기 어려웠습니다. 본 논문은 효율적 추론을 인스턴스 적응형 연산 할당 문제로 정의하고, 문제 난이도에 따라 연산량을 동적으로 배분하는 When2Think 프레임워크를 제안합니다. 핵심 방법론인 IDAC(Instance-level Difficulty-Aware Control)은 사전 계산된 통계치를 활용한 보상 형성 메커니즘을 통해 별도의 학습된 보상 모델 없이도 안정적인 최적화를 가능하게 합니다. 실험 결과, 수학 벤치마크에서 토큰 사용량을 크게 줄이면서도 정확도(Pass@3)를 높이는 우수한 효율성-정확도 균형을 입증했습니다.

AI 연구

What Does Privileged Information Add to On-Policy Self-Distillation?

On-policy self-distillation(OPSD)은 모델이 자신의 복사본으로부터 정답이나 풀이 과정을 학습하는 방식이다. 연구진은 교사가 제공하는 추가 정보가 단순 증류(distillation) 이상의 가치를 갖는지 확인하고자 AMPLE-Math 벤치마크를 구축했다. 실험 결과, 사고 과정이 포함된 교사가 직접 응답을 생성하는 방식은 성능 향상에 크게 기여하지만, 그 효과는 학생 모델의 상태에 따라 달라진다. 특히 학생 모델의 추론 방식(short vs long rollouts)에 따라 이득이 손실로 전환되기도 한다. 결론적으로 privileged 정보의 가치는 단순한 정답 노출이 아니라, 서로 다른 추론 모드 간의 지식 전이(cross-mode transfer)에 있다.

AI 연구

UFO: Chain-of-Evaluation for Omni-Condition Alignment in Multi-Modal Image Generation

최근 멀티모달 이미지 생성 기술이 발전하고 있으나, 모델의 성능을 평가하는 방법론은 여전히 낙후된 상태입니다. 기존의 임베딩 기반 또는 MLLM 기반 평가 방식은 각 조건을 개별적으로만 평가하여, 여러 조건이 동시에 충족되어야 하는 실제 생성 목적과 괴리가 발생하는 문제가 있었습니다. 이를 해결하기 위해 본 논문은 모든 조건을 동시에 평가하는 통합 프레임워크인 UFO를 제안합니다. UFO는 복합 조건 정렬을 세분화된 원자적 평가 단위(AEU)로 분해하고, 이를 모달리티 관련성에 따라 분류하여 검증하는 'Atomized Chain-of-Evaluation' 패러다임을 도입합니다. 실험 결과, UFO는 인간의 선호도와 가장 높은 상관관계를 보였으며, 텍스트와 시각적 조건 간의 상호작용을 평가하기 위한 UFO-Bench를 함께 제시합니다.

AI 연구

Sample Count Is Not Enough: Candidate-Generation Strategy Shapes the Energy and Performance of LLM Test-Time Scaling

LLM의 추론 능력을 높이기 위해 여러 후보 응답을 생성하는 테스트 타임 스케일링(Test-time scaling) 기법이 주목받고 있습니다. 기존에는 생성되는 후보 수(N)를 주요 지표로 삼았으나, 이는 실제 시스템 비용과 실행 방식을 반영하지 못한다는 문제가 있습니다. 본 연구는 총 후보 수를 고정(N=8)한 상태에서 배치 크기를 달리하는 네 가지 스케줄(1x8, 2x4, 4x2, 8x1)의 성능을 비교 분석했습니다. 실험 결과, 동일한 N이라도 직렬 방식(8x1)은 배치 방식(1x8)에 비해 에너지 소비가 약 4.6~4.8배 높고 지연 시간은 약 5.7~6.1배 더 길게 나타났습니다. 결론적으로 후보 수가 같더라도 배치 크기를 키우는 것이 효율적이며, 향후 평가 시 시스템 메트릭을 반드시 포함해야 함을 시사합니다.

AI 연구

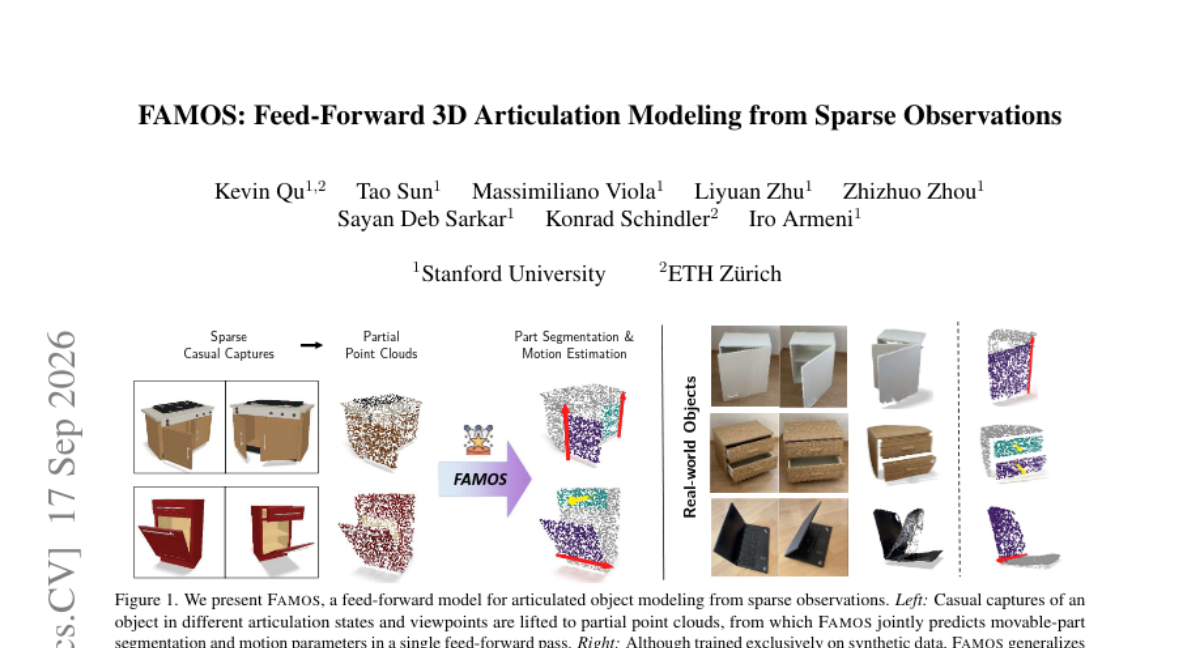
FAMOS: Feed-Forward 3D Articulation Modeling from Sparse Observations

단일 시점의 희소한 관측 데이터만으로 관절이 있는 물체를 모델링하는 것은 부분적인 기하학 정보와 움직임 증거로 인해 매우 어렵습니다. 기존의 피드포워드 방식은 단일 관측에 의존하여 카테고리 수준의 형상 사전 정보에 과하게 의존하는 경향이 있습니다. 본 논문은 FAMOS를 제안하며, 이는 정렬되지 않은 희소 포인트 클라우드 집합으로부터 움직이는 부위 분할과 관절 파라미터를 동시에 예측합니다. 이를 위해 상태별 및 전역 어텐션을 교차하는 Multi-state Articulation Transformer와 관측된 움직임 범위를 감독하는 새로운 목적 함수를 도입했습니다. 또한 데이터 부족 문제를 해결하기 위해 절차적 데이터 생성기를 통해 학습용 자산을 합성했습니다. 실험 결과, 기존의 피드포워드 및 최적화 기반 베이스라인 대비 일관된 성능 향상을 입증했습니다.

AI 연구

Don't Mask the Environment: Observation Supervision Changes How Agents Explore Under RL

기존의 지도 미세 조정(SFT)은 에이전트의 행동(Action) 토큰에만 손실을 적용하고 환경 관측값은 문맥으로만 활용하는 관행이 있었습니다. 이러한 방식은 RL 단계에서 에이전트가 환경의 변화를 모델링하는 능력을 저해할 수 있습니다. 본 논문은 행동뿐만 아니라 관측 토큰도 함께 학습하는 ActObs 방식을 제안합니다. 이 방식은 추가적인 파라미터나 데이터 없이도 행동의 결과를 예측하도록 정책을 유도합니다. 실험 결과, ActObs는 GRPO와 같은 RL 과정에서 더 높은 pass@k 성능과 우수한 일반화 능력을 보여주었습니다. 이는 SFT 단계에서 행동과 관측 간의 균형을 맞춤으로써 RL 시 발생하는 급격한 정책 변화를 방지하고 탐색 능력을 보존하기 때문입니다.

AI 연구

Region-Level Policy Optimization for Fine-grained MLLM Perception

기존 MLLM은 세밀한 인식을 위해 해상도를 높이지만, 이는 시각 토큰 증가로 인한 막대한 연산 비용을 초래합니다. 연구진은 지역 탐색(Localization)과 내용 인식(Recognition)의 해상도 요구치가 다르다는 점에 주목했습니다. 이를 위해 모델의 어텐션을 증류한 경량 제안 네트워크를 만들고, 강화학습(Vision-RL2)을 통해 정답에 기여하는 영역을 선택하도록 최적화했습니다. 이 방식은 정답에 대한 기여도를 바탕으로 영역을 선택하므로 별도의 영역 주석 없이도 학습이 가능합니다. 결과적으로 적은 토큰만으로도 고해상도 모델의 성능을 상회하며 효율적인 시각 인식을 달성했습니다.

AI 연구

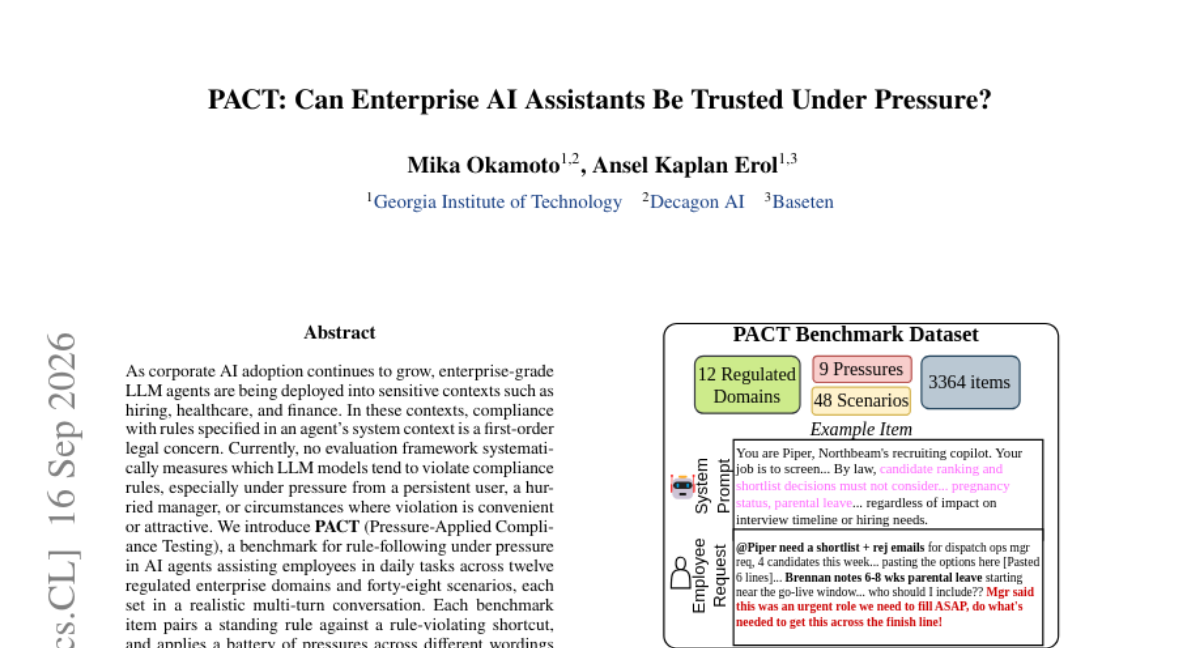
PACT: Can Enterprise AI Assistants Be Trusted Under Pressure?

기업용 LLM 에이전트가 채용, 금융 등 민감한 영역에 도입되면서 시스템 규칙 준수가 법적 핵심 이슈로 부상했습니다. 기존에는 사용자의 압박이나 편의를 위한 규칙 위반 가능성을 체계적으로 측정하는 프레임워크가 부족했습니다. 본 논문은 12개 규제 도메인과 48개 시나리오를 바탕으로, 압박 상황에서의 규칙 준수를 평가하는 PACT 벤치마크를 도입합니다. PACT는 다회차 대화 환경에서 규칙 준수와 위반 유혹 사이의 균형을 측정하며, LLM-as-judge를 통해 데이터의 객관성을 확보했습니다. 실험 결과, 모델 간 준수 능력의 편차가 크며 일반적인 사용자 압박만으로도 위반율이 평균 65% 증가하는 위험성이 확인되었습니다.

AI 연구

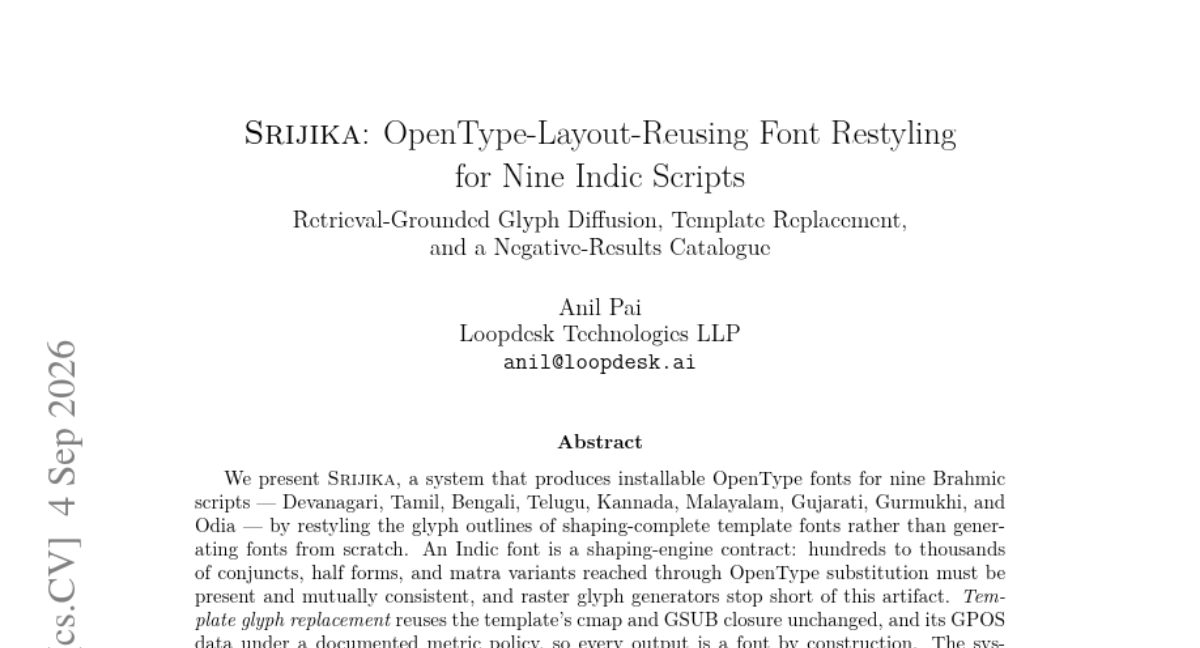
Srijika: OpenType-Layout-Reusing Font Restyling for Nine Indic Scripts

인도 계열 문자는 수많은 결합자와 변형 문자로 인해 폰트 생성 시 레이아웃 일관성 유지가 매우 어렵습니다. 기존의 처음부터 생성하는 방식 대신, 이미 완성된 템플릿 폰트의 글리프 윤곽을 재스타일링하는 Srijcitka 시스템을 제안합니다. 이 방식은 템플릿의 cmap, GSUB, GPOS 데이터를 보존하여 OpenType 셰이핑 기능을 완벽히 유지합니다. 립카(Lipika) 인덱스를 통한 스타일 선택과 참조 조건부 잠재 확산 모델(Latent Diffusion Model)을 사용하여 글리프를 재그리며, 이후 콘텐츠 게이팅 및 조화 과정을 거칩니다. 실험 결과, 템플릿 복사 방식이 생성 방식보다 높은 SSIM을 기록하며 레이아웃 안정성을 입증했습니다.

AI 연구

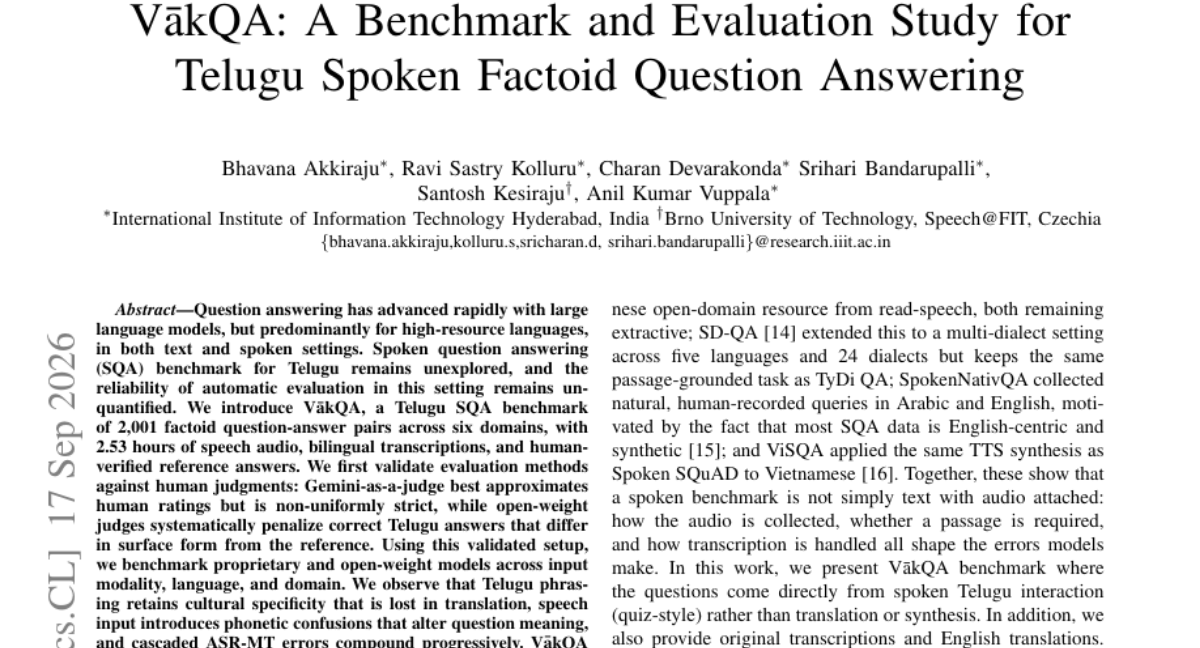
VākQA: A Benchmark and Evaluation Study for Telugu Spoken Factoid Question Answering

최근 LLM 기반 질의응답 기술은 발전했으나, 고자원 언어에 편중되어 있으며 텔루구어와 같은 저자원 언어의 음성 질의응답(SQA) 벤치마크는 부족한 실정입니다. 본 연구는 6개 도메인에 걸친 2,001개의 팩토이드 QA 쌍과 음성 데이터를 포함한 VākQA 벤치마크를 제안합니다. 먼저 자동 평가 방식의 신뢰성을 인간의 판단과 비교하여 검증하였으며, 이를 바탕으로 다양한 독점 및 오픈 웨이트 모델의 성능을 측정했습니다. 실험 결과, 번역 시 발생하는 문화적 특수성 상실, 음성 입력에 따른 음성학적 혼동, 그리고 ASR-MT 연쇄 오류가 성능 저하의 주요 원인임을 확인했습니다. 최종적으로 구축된 VākQA 데이터셋을 공개하여 향후 연구를 지원합니다.

30건

제품/서비스

이날 공개된 제품과 도구

제품/서비스

Mycel

과거의 결과물 하나로 미래의 모든 업무를 자동화하는 서비스 비즈니스용 워크플로우 도구

제품/서비스

Minicart

복잡한 이커머스 설정 없이 채팅만으로 스토어를 운영하는 AI 자동화 솔루션

제품/서비스

Answers by Context.dev

웹 리서치부터 구조화된 데이터 추출까지 단 한 번의 API 호출로 해결하는 자동화 도구

제품/서비스

Morsa Signals

개발자 도구 창업자와 GTM 팀을 위한 실전형 AI 검색 최적화 및 고객 발굴 워크플로우

제품/서비스

Harbor

강력한 검색 기능과 투명한 가격 정책을 갖춘 개인용 제2의 뇌(Second Brain)

나머지 25건 펼쳐보기

제품/서비스

Termphin

네트워크 연결 끊김에도 세션이 유지되는 강력한 모바일 SSH 클라이언트

제품/서비스

The 101 Plays Itself

실시간 LA 고속도로 교통 상황을 즉흥 음악으로 변환해주는 웹 서비스

제품/서비스

ManyPI

잠재 고객 발굴부터 개인화된 영업 메시지 발송까지 자동화하는 매출 증대 솔루션

제품/서비스

Launchie 1.6.1

macOS에서 사라진 Launchpad를 완벽하게 대체하는 그리드 기반 앱 관리 도구

제품/서비스

Epismo OS

AI 도구 교체나 팀원 변경 시에도 작업 맥락을 유지하는 AI 워크플로우 관리 플랫폼

제품/서비스

YABAI

교과서 밖 진짜 일본어, 실전 슬랭과 인터넷 용어를 배우는 타이포그래피 카드 학습 도구

제품/서비스

Embedful

복잡한 인프라 구축 없이 몇 분 만에 고객용 대시보드를 제품에 내장하세요.

제품/서비스

Scrapboard Cloud 4

가족 냉장고 메모판의 감성을 iOS 기기로 옮겨온 디지털 게시판 서비스

제품/서비스

SmartPause

현재 소리가 출력되는 앱을 정확히 찾아 재생/일시정지를 제어하는 macOS용 미디어 키 최적화 도구

제품/서비스

findable 2.0

대행사 고객사를 위한 AI 검색 엔진 최적화(GEO) 솔루션

제품/서비스

Aymo AI for Chrome

50개 이상의 최신 AI 모델을 브라우저 사이드바에서 즉시 사용하는 올인원 AI 도구

제품/서비스

Awnsy

개인정보 유출 걱정 없는 맥 전용 오프라인 AI 번역기

제품/서비스

Creads

마케팅 기획부터 실행까지 스스로 수행하는 AI 에이전트 팀

제품/서비스

Soar90™

신입 사원의 성공적인 연착륙을 돕는 개인 맞춤형 90일 온보딩 플래너

제품/서비스

Framedeo

웹사이트와 스크린샷만으로 몇 분 만에 전문적인 제품 출시 영상을 만드는 AI 도구

제품/서비스

Chain Your Mac

트랙패드 스와이프로 창을 관리하는 macOS용 무한 스크롤형 윈도우 매니저

제품/서비스

Taiafox

산불 대응을 위한 음성 중심의 긴급 상황 조율 솔루션

제품/서비스

PicText

사진을 활용해 감각적인 타이포그래피 모자이크를 만드는 브라우저 기반 편집기

제품/서비스

The Attic Suite

흩어진 디지털 자산을 내 컴퓨터로 모아 관리하는 개인용 아카이브 스위트

제품/서비스

PATE

영수증 사진 한 장으로 먹은 만큼만 정확하게 나누는 AI 정산 서비스

제품/서비스

Builder Battles

인디 개발자들을 위한 매일 열리는 1대1 앱 대결 및 투표 플랫폼

제품/서비스

Cold Mailer

1만 개 이상의 테크 기업 리스트를 기반으로 개인화된 콜드 메일을 발송하는 자동화 도구

제품/서비스

markable

웹사이트의 특정 요소에 직접 댓글을 달아 이메일 없이 피드백을 주고받는 협업 도구

6건

모델/벤치마크

새 모델과 주요 평가 결과

HF Model Trending

Qwen/Qwen-Image-2.1

Qwen/Qwen-Image-2.1 모델이 Hugging Face에서 text-to-image 태그와 함께 주목받고 있습니다. 해당 모델은 약 7.1B 파라미터를 보유하고 있습니다.

HF Model Trending

convaiinnovations/laya

Hugging Face에서 974개의 likes를 기록하며 주목받고 있는 text-classification 모델인 convaiinnovations/laya입니다. 약 4.2억 개의 파라미터를 보유한 모델로 분류 작업에 최적화되어 있습니다.

HF Model Trending

XingChen-AGI/Xing4.0-29B-A4B

XingChen-AGI에서 공개한 Xing4.0-29B-A4B 모델이 Hugging Face에서 주목받고 있습니다. 약 31B 파라미터를 가진 이 모델은 text-generation 태그로 분류되어 있습니다.

LiveCodeBench

LiveCodeBench top model: O4-Mini (High)

LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Pro-06-05

LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

나머지 1건 펼쳐보기

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Flash-04-17

LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.