지난 소식

2026.10.16

이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.

21건

뉴스

주요 기사와 기업의 공식 발표

ServiceNow

ServiceNow advances its operational harness for enterprise AI with AI Passport and expanded governance capabilities - ServiceNow

ServiceNow가 기업용 AI Agent의 보안과 거버넌스를 실시간으로 통제하기 위한 'AI Passport' 솔루션과 통합 거버넌스 기능을 발표했습니다. 이는 AI Agent가 권한 범위를 벗어나는 것을 사전에 방지하고, 멀티 Agent 워크플로우 내에서 실행 시점(Runtime)의 통제력을 확보하는 데 중점을 둡니다.
Reuters

Market selloff, rising rates test AI data centre deal boom - Reuters

금리 인상과 시장 매도세가 맞물리며 AI 데이터 센터 인프라 확장에 대한 투자 심리가 시험대에 올랐습니다. 자본 비용 상승은 대규모 데이터 센터 구축을 위한 대규모 딜(Deal) 구조에 직접적인 압박을 가하고 있습니다.
Apple Machine Learning Research

Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio - Apple Machine Learning Research

Apple의 MLX 프레임워크와 Thunderbolt 기반 RDMA 기술을 활용하여 Mac Studio 클러스터에서 초거대 LLM을 분산 추론하는 기술적 성과를 발표했습니다. 이를 통해 단일 기기의 메모리 한계를 넘어 1조 개 파라미터급 모델인 Muse Spark Open을 데스크탑 환경에서 효율적으로 구동할 수 있음을 입증했습니다.
CNBC

Apple and Meta team up to make Muse AI model run on Mac computers - CNBC

Apple과 Meta가 협력하여 Meta의 최신 Open-weight 모델인 'Muse Spark Open'을 Apple의 고성능 데스크톱 환경에서 원활하게 구동할 수 있는 기술적 토대를 마련했습니다. 이번 협업은 클라우드가 아닌 로컬 환경에서 강력한 AI 성능을 구현함으로써 보안과 비용 효율성을 동시에 확보하는 것을 목표로 합니다.

The Washington Post

Scientists are finding AI may make us remember things that never happened - The Washington Post

AI가 생성한 정교한 가짜 정보가 인간의 기억을 왜곡하여 존재하지 않는 사건을 실제처럼 믿게 만드는 '가짜 기억(False Memory)' 현상을 유발할 수 있다는 연구 결과가 발표되었습니다. LLM(Large Language Model)이 생성하는 설득력 있는 텍스트가 인간의 인지 체계와 결합할 때 발생하는 심리적·기술적 위험성을 경고합니다.

나머지 16건 펼쳐보기

The New York Times

Tech Stocks Drop Further Amid Doubts Over AI Spending - The New York Times

AI 인프라에 대한 막대한 자본 지출(CAPEX) 대비 수익 모델(ROI)에 대한 의구심이 커지면서 글로벌 빅테크 주가가 하락세를 보이고 있습니다. 시장은 단순한 모델 성능 향상을 넘어, 투입된 비용이 실질적인 매출과 서비스 가치로 전환되는 시점에 주목하고 있습니다.

blog.google

Bringing the magic: Google breaks open a bottleneck in quantum computing - blog.google

Google Quantum AI가 Willow 프로세서를 활용해 양자 컴퓨팅의 고질적인 병목 현상인 'Magic State' 생성 문제를 해결하는 데 성공했습니다. 이번 연구는 이론적 가설이었던 'Magic State Cultivation(매직 스테이트 배양)'을 실제 하드웨어에서 구현하여 오류율을 획기적으로 낮춘 성과입니다.

Yahoo Finance

Nvidia leads chip stocks lower as AI trade takes - Yahoo Finance

미국 내 예상보다 높은 인플레이션 지표로 인해 금리 인하 기대감이 후퇴하며, 부채 비중이 높은 AI 관련 기업들의 밸류에이션 압박이 가중되었습니다. 이로 인해 Nvidia와 AMD를 포함한 주요 반도체 섹터가 하락세를 보였으며, 자본 비용 상승 우려가 AI 인프라 기업들의 재무 건전성 이슈로 전이되었습니다.

Google DeepMind

Gemini 4 Argon: Built to solve your hardest problems

Google DeepMind가 최신 프론티어 모델인 Gemini 4 Argon을 공개했습니다. 이 모델은 개발자, 기업, 과학자 및 일반 소비자들이 직면한 가장 어려운 문제들을 해결하기 위해 설계되었습니다.

Google DeepMind

Accelerating the search for antimicrobial peptides with Google Antigravity

Google DeepMind가 새로운 항균 펩타이드 탐색을 위한 에이전트 기반 과학 워크벤치인 Google Antigravity를 공개했습니다. 이 시스템은 새로운 항균 펩타이드를 발견하고 구조적으로 평가하며 우선순위를 정하는 과정을 단 몇 시간 만에 수행할 수 있도록 지원합니다.

OpenAI News

Amp puts AI agents to work beyond code with OpenAI models

Amp가 OpenAI 모델을 활용하여 코드 작성을 넘어선 AI 에이전트의 영역을 확장합니다. GPT-6 Astra, Ultrafast, GPT-Live-1 및 Sign in with ChatGPT를 통해 에이전트의 역량을 극대화하는 방법을 소개합니다.

OpenAI News

SentinelOne cuts malware analysis from weeks to hours

SentinelOne이 OpenAI Daybreak를 도입하여 악성코드 분석 시간을 기존 몇 주에서 몇 시간 단위로 대폭 단축했습니다. 이를 통해 더 많은 위협을 조사할 수 있는 역량을 확보하게 되었습니다.

OpenAI News

How Third Moment Research runs 10,000 agents for 36+ hours

Third Moment Research는 GPT-6 Astra, GPT-6.1 Sol, Codex, Daybreak를 활용하여 장시간 집중할 수 있는 AI 에이전트를 구축합니다. 이들은 36시간 이상 지속되는 10,000개의 에이전트를 운영하며 사용을 통해 성능을 개선하는 데 집중합니다.

22건

커뮤니티

Hacker News, GeekNews, Reddit 반응

Hacker News

Things to know when you get cancer

암 진단 후 환자가 주도적으로 치료 과정을 관리하고 최적의 의료 서비스를 확보하기 위한 실질적인 가이드를 다룹니다. 환자 스스로가 치료 일정과 검사 방식을 관리해야 한다는 점과 전문적인 가이드라인을 활용하는 법을 강조합니다.

Hacker News

Gemini 4 Argon

Google의 Gemini 4 Argon이 대규모 코드베이스 리팩토링을 성공적으로 수행하며 차세대 코딩 에이전트로서의 가능성을 입증했습니다. 사용자들은 이 모델이 기존 모델들을 뛰어넘는 성능 향상을 가져올 것으로 기대하고 있습니다.

Hacker News

Do dentists know what they're doing?

치과 진료 과정에서 발생한 부작용과 의료진의 과잉 진료 가능성에 대한 개인적 경험담을 다룹니다. 전문가의 권고를 믿고 진행한 치아 성형이 오히려 턱관절 문제를 악화시킨 사례를 통해 의료 신뢰 문제를 조명합니다.

나머지 17건 펼쳐보기

Hacker News

Hackers activate automatic defrosting in supermarket fridges across Europe

유럽 전역의 슈퍼마켓 냉장고가 해킹되어 자동 성에 제거 기능이 활성화되는 보안 사고가 발생했습니다. 커뮤니티에서는 관리 소홀에 의한 취약점 노출과 군사 시설과의 연관 가능성을 중심으로 논의가 진행 중입니다.

Hacker News

Redesigning source control at Anthropic

Anthropic이 기존 Git 기반의 소스 제어 방식을 개선하기 위해 구축한 새로운 시스템 'Scion'에 대한 기술적 여정을 다룹니다. AI 모델 개발 과정에서 발생하는 코드 관리의 복잡성을 해결하기 위한 아키텍처 변화와 이에 대한 개발자들의 실무적 우려를 담고 있습니다.

Hacker News

OpenCode 2.0

OpenCode 2.0 출시와 함께 개선된 사용자 경험과 아키텍처 변화에 대한 기술적 평가가 이어지고 있습니다. 이전 버전의 불편함을 해소하고 자동화된 워크플로우를 강화한 것이 핵심입니다.

Hacker News

Ledger confirms spy chip implant behind wallet crypto thefts

하드웨어 월렛 제조사 Ledger의 제품에 스파이 칩이 심어져 암호화폐를 탈취한 사건이 확인되었습니다. 공급망 공격을 통해 물리적 기기가 변조되었으며, 이는 하드웨어 보안의 신뢰성을 근본적으로 위협하는 사례입니다.

Hacker News

AI is a tool and using it well takes skill

AI를 도구로 활용하는 숙련도가 중요해지는 시점에서 기술적 숙련도와 인간의 지식 축적 사이의 관계를 다룹니다. AI 기술의 발전 속도와 인간의 학습 속도 사이의 격차에 대한 우려와 실무적 관점의 논쟁이 핵심입니다.

GeekNews / Hada

Anthropic의 Scion이 Mononoke를 베꼈다는 비판에 대한 추가 설명

데이터 모델의 구조적 유사성과 핵심 인력 이동이 맞물리며 발생한 기술적 도용 논란입니다. 이는 향후 AI 모델 개발 과정에서 데이터 설계 자산의 보호와 인력 이동에 따른 기술 유출 방지책이 중요한 쟁점이 될 것임을 시사합니다.

GeekNews / Hada

Krea 3 - 대규모 편집을 위해 설계된 이미지 모델

Krea 3는 단순 생성 모델을 넘어 정밀한 영역 제어와 일관성 유지를 목표로 설계된 편집 특화 모델입니다. 이는 생성형 AI가 단순한 이미지 제작 도구를 넘어 실무적인 워크플로우를 지원하는 편집 도구로 진화하고 있음을 보여줍니다.

GeekNews / Hada

이스라엘 기업, 온라인 광고로 제로클릭 스파이웨어 유포

이번 사건은 광고 네트워크를 통한 스파이웨어 유포가 사용자 상호작용 없이도 가능하다는 기술적 위험성을 보여줍니다. 이는 향후 온라인 광고 생태계가 정교한 사이버 공격의 통로로 악용될 수 있음을 시사합니다.

GeekNews / Hada

Steam 클라이언트, Epic의 새 바이브 코딩 런처보다 빨라짐

플랫폼 간의 로딩 속도 경쟁이 가속화되는 가운데, Valve가 신속한 업데이트로 기술적 우위를 탈환했습니다. 이는 사용자 경험(UX)의 핵심인 실행 속도를 확보하기 위한 플랫폼 간의 치열한 최적화 경쟁을 보여줍니다.

GeekNews / Hada

신경망은 깔끔하다

신경망 내부의 복잡한 현상이 관찰 도구의 한계나 잘못된 해석에서 비롯되었을 가능성을 제기하며 해석 가능성의 새로운 방향을 제시합니다. 이는 인공지능 모델의 내부 로직을 분석할 때 기존의 중첩 가설을 재검토해야 함을 시사합니다.

GeekNews / Hada

표적 광고로 전달되는 제로클릭 스파이웨어: AdFection

이번 사건은 정교한 광고 인프라가 악성 스파이웨어를 전달하는 통로로 악용될 수 있음을 보여주는 기술적 사례입니다. 사용자의 직접적인 상호작용 없이도 감염이 가능한 제로클릭 공격의 위험성이 광고 생태계로 확장되고 있다는 점이 핵심입니다.

GeekNews / Hada

Show HN: Unfenced - 공공 토지와 맞닿은 매물 토지 찾기

공공 토지 경계 데이터를 활용해 매물의 입지적 가치를 정밀하게 검증하는 서비스입니다. 데이터 기반의 경계 대조 로직을 통해 부동산 거래의 투명성과 정보 비대칭을 해결하는 데 초점을 맞추고 있습니다.

Reddit

capy-flash: Qwen3.8-Flash-Next (125B MoE) in full NVFP4 on two 16 GB consumer GPUs

사용자 제작 엔진인 capy-flash를 통해 두 개의 16GB 소비자용 GPU에서 125B MoE 모델을 NVFP4 정밀도로 구동하는 기술적 성과를 소개합니다. 이 엔진은 텐서 병렬 처리 시 발생하는 수치적 오차를 해결하여 높은 생성 속도와 모델 품질을 동시에 확보했습니다.

50건

논문

읽어볼 만한 AI 연구

AI 연구

Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation

기존의 에이전트 기반 영상 생성 방식은 프롬프트나 직전 프레임을 전달하는 방식에 의존하여, 이전 장면의 공간적 구조나 시간적 기록을 유지하는 데 한계가 있었습니다. 이를 해결하기 위해 ATAS 프레임워크는 시나리오를 위치, 카메라, 이벤트 시간 정보가 포함된 샷 요청으로 컴파일합니다. 생성 전에는 정적 기하 구조(Scene Memory)와 동적 관찰(Event Memory)로 구성된 메모리에서 관련 증거를 검색하여 활용합니다. 생성 후에는 생성된 클립을 검토하고 상태 체크를 거쳐 메모리에 등록하는 과정을 거칩니다. 실험 결과, ATAS는 다양한 비디오 생성 모델에서 샷 간 일관성을 크게 향상시켰으며 인간 평가에서도 최고점을 기록했습니다.

AI 연구

Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation

멀티 교사 온폴리 증류(MOPD)는 도메인별 전문 교사를 활용해 학생 모델의 성능을 높이는 방식입니다. 하지만 교사 간 스타일이나 전문 분야가 다를 경우, 공유 파라미터를 업데이트하는 과정에서 그래디언트 충돌이 발생하여 특정 도메인의 성능이 저하되는 문제가 있습니다. 이를 해결하기 위해 제안된 Road MOPD는 비라우팅 교사를 보조 비평가로 활용하여 도메인 간 간섭을 제어합니다. 구체적으로 교사 간 합의를 이용한 토큰 단위 크레딧 할당과 충돌 방지를 위한 예방적 그래디언트 투영 기법을 도입했습니다. 실험 결과, 도메인 간 충돌이 심한 상황에서도 특정 도메인의 성능 저하를 막고 전체적인 성능 향상을 달성했습니다.

AI 연구

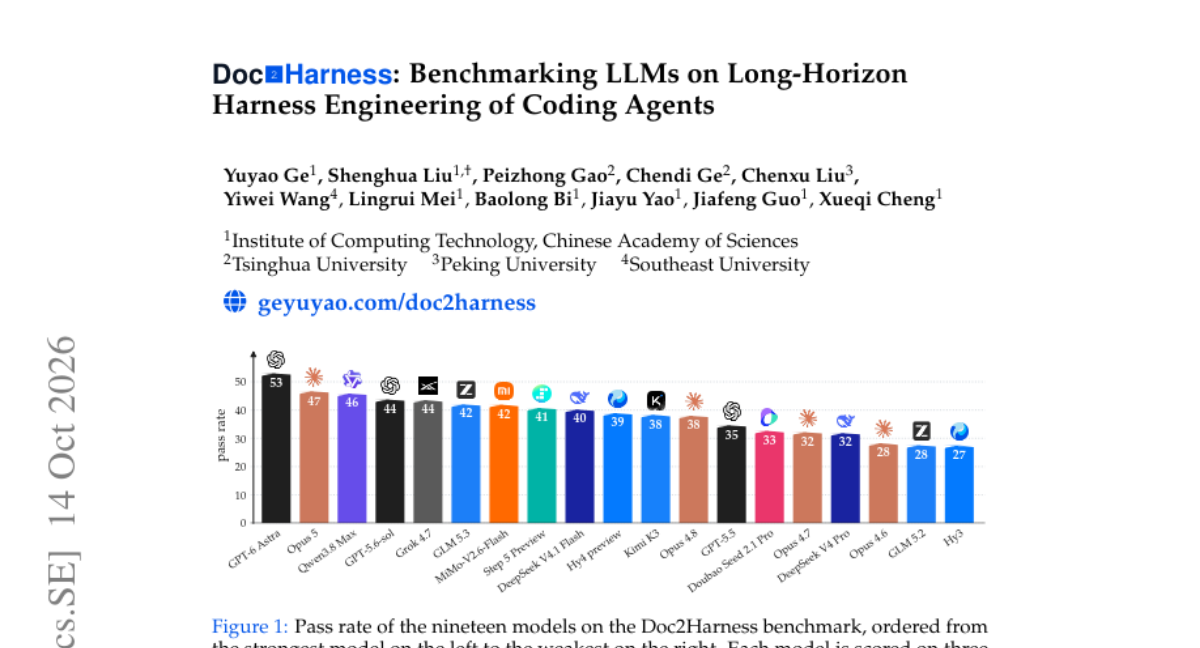
Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents

LLM 기반 에이전트가 복잡한 작업을 수행할 때, 모델 자체의 성능만큼이나 이를 둘러싼 실행 환경(Harness)의 설계가 중요합니다. 기존 벤치마크는 고정된 환경에서의 작업 성공 여부에만 집중하여, 환경 구축 능력 자체를 평가하지 못하는 한계가 있었습니다. 이를 해결하기 위해 제안된 Doc2Hsarness는 두 단계로 구성된 벤치마크로, 모델이 직접 인터페이스와 문서를 바탕으로 실행 환경을 구축하고 이를 검증하는 과정을 거칩니다. 실험 결과, 최상위 모델조차 절반 가까이 실패하며 하네스 설계의 난이도를 보여주었습니다. 이 벤치마크는 장기적 작업 수행을 위한 환경 구축 능력을 측정하는 최초의 결정론적 지표를 제공합니다.

AI 연구

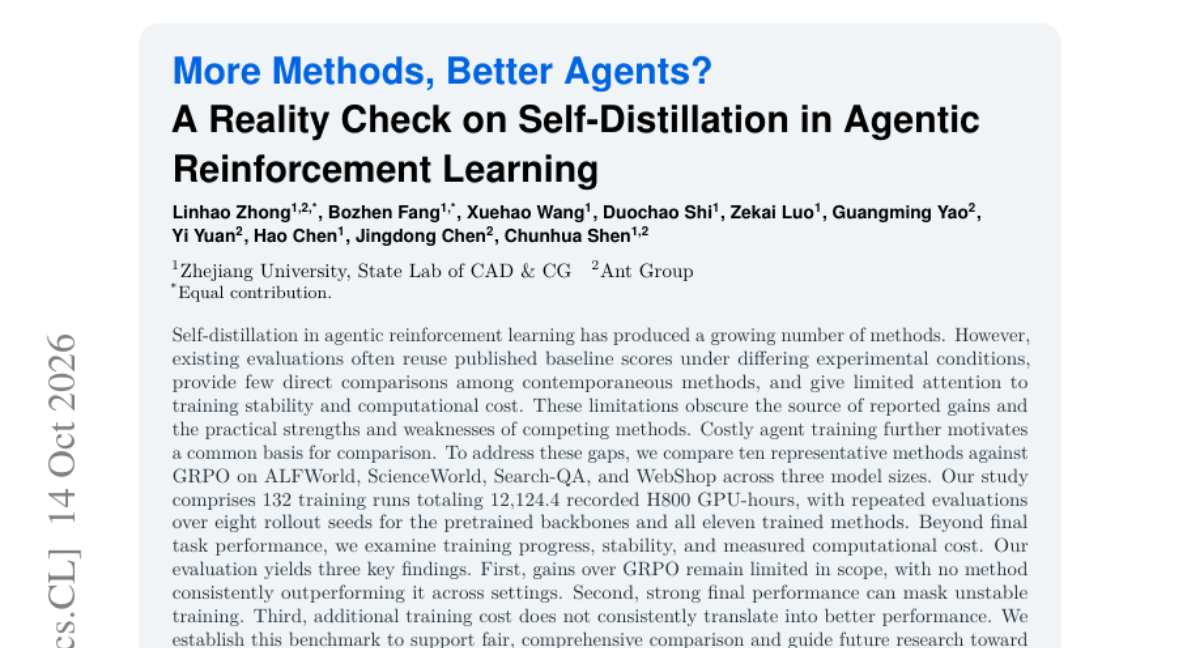
More Methods, Better Agents? A Reality Check on Self-Distillation in Agentic Reinforcement Learning

최근 에이전트 강화학습 분야에서 자기 증류 기법이 급증하고 있으나, 기존 평가는 실험 조건이 다른 베이스라인을 재사용하거나 학습 안정성 및 비용을 간과하는 경향이 있습니다. 본 연구는 이를 해결하기 위해 10가지 대표 방법론과 GRPO를 ALFWorld, ScienceWorld 등 다양한 환경에서 비교 분석했습니다. 132회의 학습 런과 12,124.4 H800 GPU-시간을 투입하여 성능, 학습 안정성, 계산 비용을 종합적으로 검토했습니다. 연구 결과, GRPO를 일관되게 능가하는 방법은 없었으며, 높은 최종 성능이 불안정한 학습 과정을 가릴 수 있음을 확인했습니다. 또한 추가적인 학습 비용이 반드시 성능 향상으로 이어지지는 않는다는 점을 밝혀냈습니다.

나머지 45건 펼쳐보기

AI 연구

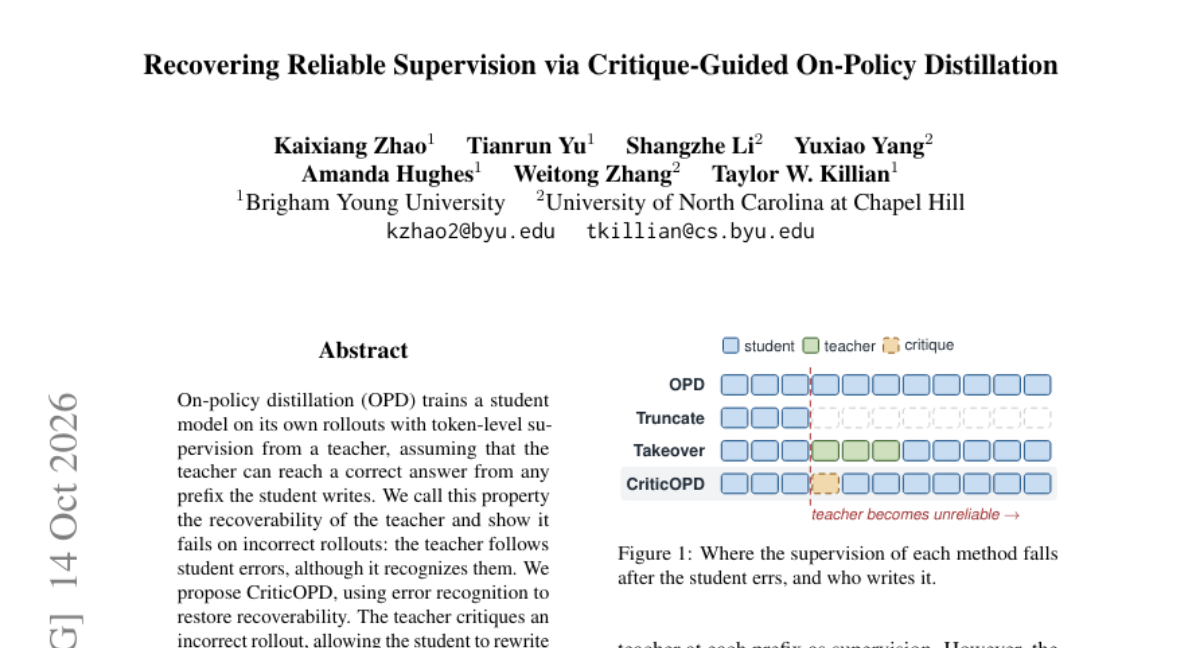
Recovering Reliable Supervision via Critique-Guided On-Policy Distillation

기존의 온폴리시 증류(OPD)는 학생 모델이 생성한 답변이 틀렸을 경우, 교사 모델이 학생의 오류를 따라가게 되는 '복구 불가능성' 문제를 가집니다. 연구진은 교사 모델이 오류를 인지하더라도 잘못된 경로를 따라가는 현상을 발견했습니다. 이를 해결하기 위해 오류를 식별하고 수정하는 비판 과정을 도입한 CriticOPсяD를 제안합니다. 교사 모델이 잘못된 결과물에 대해 비판을 제공하면, 학생 모델은 이를 바탕으로 정답을 재작성하며 학습합니다. 이 과정에서 비판 정보는 교사만 활용하는 특권 정보로 사용되어 학습 효율을 높입니다. 실험 결과, 수학적 추론 벤치마크에서 기존 OPD 대비 성능 향상을 입증했습니다.

AI 연구

LatentLoop: Scaling Looped MoE Models with Asymmetric Compute Allocation

기존의 루프형 MoE 모델은 파라미터 재사용과 희소 연산을 결합하여 효율성을 높이려 했으나, 루프 단계별 역할 차이를 충분히 활용하지 못했습니다. 연구진은 루프의 첫 번째 방문과 두 번째 방문이 서로 다른 기여도를 가진다는 점을 발견했습니다. 이를 바탕으로 첫 번째 방문에서는 시퀀스 해상도를 압축하고, 두 번째 방문에서 전체 해상도를 유지하며 남은 연산량을 은닉층 크기(hidden size) 확장에 재할당하는 LatentLoop 방식을 제안합니다. 또한 루프 간 MoE 가중치는 공유하되 어텐션 파라미터는 분리하여 해상도 차이를 수용했습니다. 실험 결과, LatentLoop는 기존 MoE 및 루프 베이스라인 대비 연산량을 절감하면서도 검증 NLL과 벤치마크 성능을 일관되게 향상시켰습니다.

AI 연구

Cortex: Consolidating Context into Parametric Memory

LLM의 성능 향상을 위해 제공된 컨텍스트는 컨텍스트가 제거되면 사라지는 문제가 있습니다. 본 논문은 생물학적 기억 공고화(Consolidation)에서 영감을 받아, 컨텍스트의 이점을 파라미터에 내재화하면서도 기존 능력을 보존하는 메모리 공고화(MC) 프레임워크를 제안합니다. 이를 위해 미래의 쿼리를 예측하고 컨텍스트 기반 출력을 병합 가능한 저차원(low-rank) 또는 구조적 FFN 업데이트로 증류하는 Cortex 방식을 도입합니다. 다양한 규모의 모델(4B~120B)을 대상으로 실험한 결과, Cortex는 지식 습득과 성능 유지 사이의 파레토 최적을 달성했습니다. 특히 연속적인 지식 편집 상황에서도 기존 성능 손실을 최소화하며 새로운 정보를 성공적으로 통합함을 입증했습니다.

AI 연구

ActionOPD: Distilling Decisions, Not Tokens

에이전트 성능을 위해 거대 모델을 작은 모델로 증류할 때, 어떤 수준에서 정렬할 것인가에 대한 근본적인 문제가 존재합니다. 기존의 토큰 단위 증류는 상태 분포 불일치 문제와 토크나이저 호환성 제약이라는 한계가 있습니다. 본 논문은 의미적 액션(Semantic Action)을 핵심 감독 단위로 제안하는 ActionOPD를 소개합니다. ActionOPD는 학생 모델이 마주한 상태에서 교사 모델의 액션 확률을 최대화하도록 설계되어, 교사의 추론 과정이나 토큰 확률 없이도 의사결정 과정을 효과적으로 복제합니다. 실험 결과, 다양한 도구 사용 작업에서 학생 모델의 성능을 유의미하게 향상시켰으며 모델 크기와 교사 모델의 종류에 관계없이 확장 가능한 성능을 보였습니다.

AI 연구

Seeing, Maintaining, and Learning: The Evolution of Multimodal Agent Memory

멀티모달 모델은 인간처럼 세상을 이해하고 상호작용할 수 있게 해주지만, 복잡하고 이질적인 데이터로부터 유용한 정보를 지속적으로 습득하는 것은 여전히 어려운 과제입니다. 특히 장기 과제와 평생 학습 환경에서는 세션 간 연속성을 유지하고 변화하는 환경에 적응하는 메모리 메커니즘이 필수적입니다. 본 논문은 정보의 형성/표현(Axis I)과 경험에 따른 관리(Axis II)라는 두 축의 분석 프레임워크를 도입합니다. 이를 통해 정적 메모리(T1)부터 자기 진화형 메모리(T3)까지의 계층적 관리 체계를 정의합니다. 최종적으로 이 프레임워크를 바탕으로 정보의 충실도와 추상화 사이의 균형, 시간적 유효성 유지 등 설계 원칙을 도출하고 미래 방향성을 제시합니다.

AI 연구

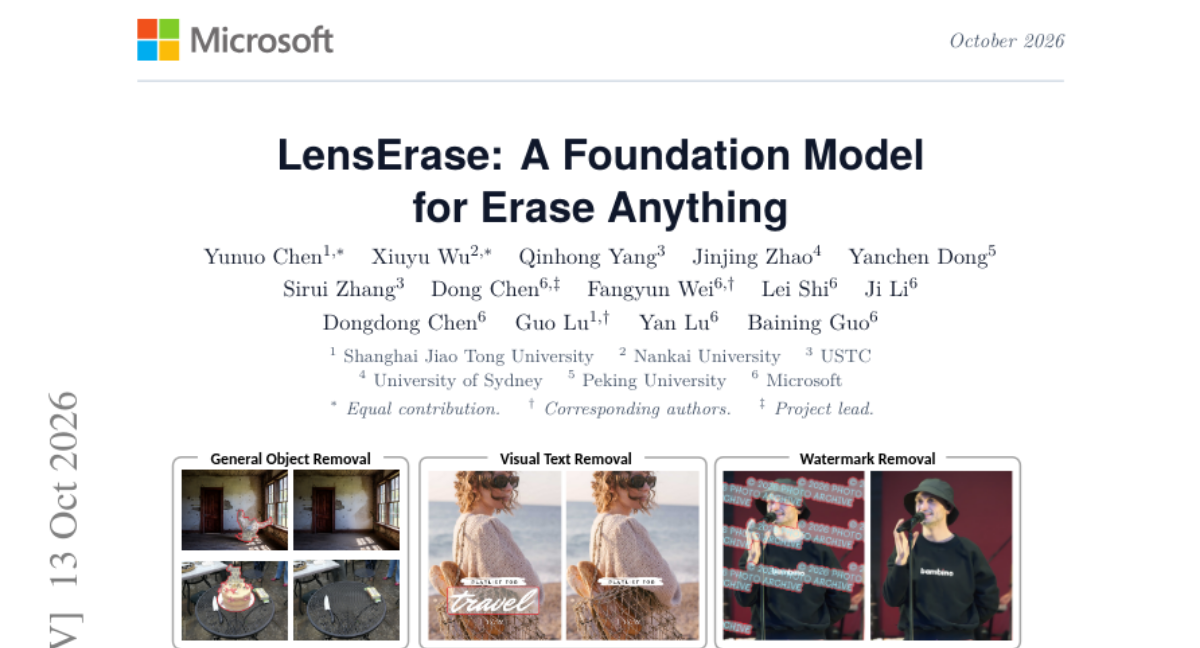
LensErase: A Foundation Model for Erase Anything

기존의 이미지 삭제 기술은 다양한 객체 크기, 비율, 워터마크 및 텍스트 제거 등 복잡한 실무 시나리오를 모두 충족하기 어려웠습니다. 이를 해결하기 위해 1억 개 이상의 쌍을 포함하는 대규모 데이터셋인 LensErase-100M을 구축했습니다. 모델은 텍스트-이미지 생성 모델인 Lens의 생성 능력을 활용하여 사전 학습되었으며, 마스크 정보를 효율적으로 주입하는 Mask-Aware RoPE 방식을 제안했습니다. 또한 RL(강화학습)과 TraceFusion 기법을 통해 편집 영역 외의 콘텐츠를 보존하며 정교한 결과물을 생성합니다. 실험 결과, 기존 벤치마크와 제안된 벤치마크 모두에서 뛰어난 성능을 입증했습니다.

AI 연구

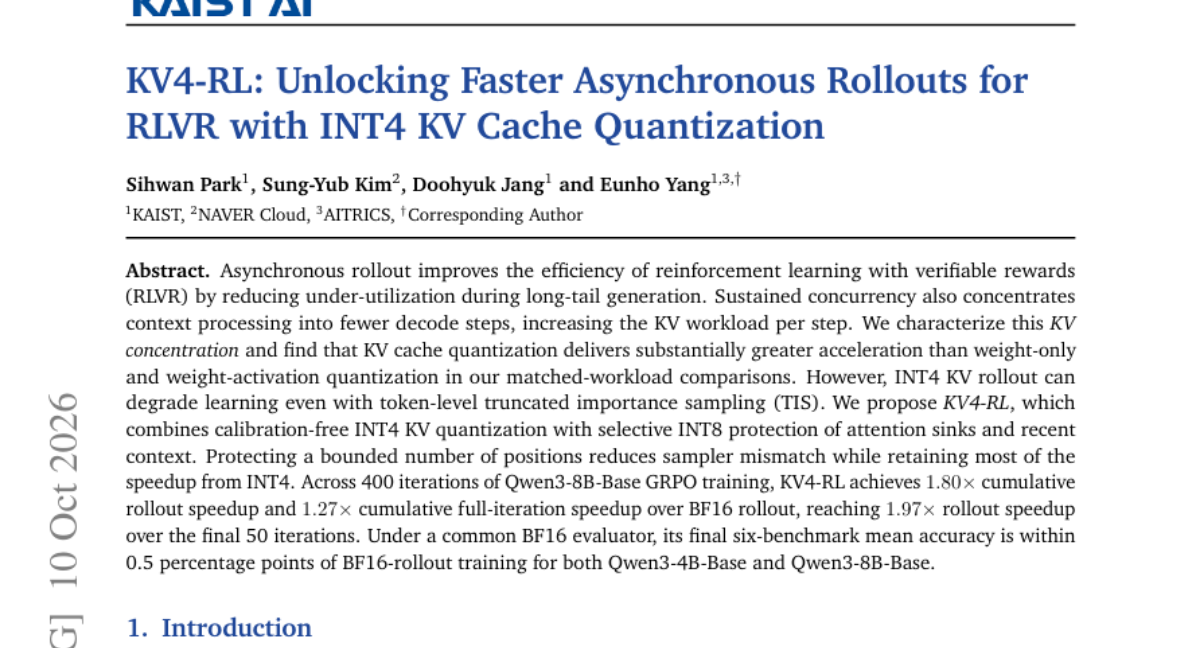
KV4-RL: Unlocking Faster Asynchronous Rollouts for RLVR with INT4 KV Cache Quantization

RLVR(Reinforcement Learning with Verifiable Rewards) 학습 시 비동기 롤아웃은 효율적이지만, 높은 동시성으로 인해 KV 캐시 워크로드가 급증하는 문제가 발생합니다. 기존의 가중치 중심 양자화보다 KV 캐시 양자화가 가속 효과는 크지만, INT4 적용 시 학습 성능이 저하되는 문제가 있었습니다. 이를 해결하기 위해 KV4-RL은 캘리브레이션 없이 INT4를 사용하되, 어텐션 싱크(Attention Sinks)와 최근 컨텍스트만 선택적으로 INT8로 보호하는 방식을 제안합니다. 실험 결과, KV4-RL은 BF16 대비 높은 롤아웃 가속도를 달성하면서도 모델 정확도 손실을 최소화했습니다.

AI 연구

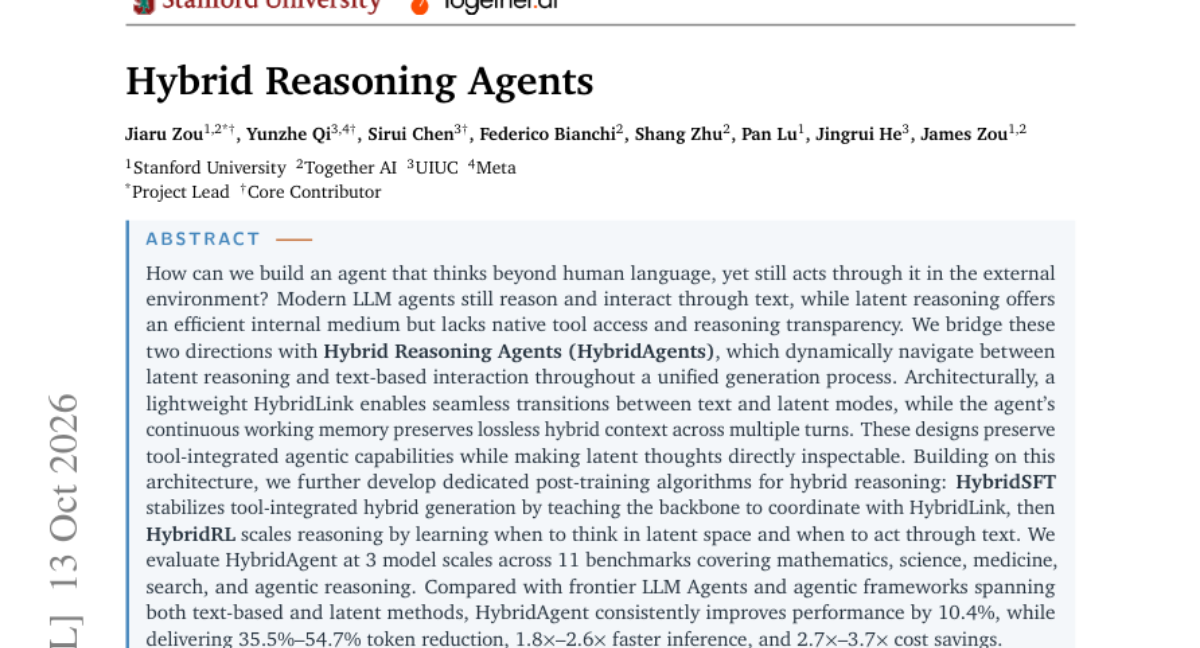
Hybrid Reasoning Agents

기존 LLM 에이전트는 텍스트를 통해서만 추론과 상호작용을 수행하여 효율성이 낮거나, 잠재 공간 추론은 도구 사용 및 투명성이 부족하다는 문제가 있었습니다. 본 논문은 텍스트 기반 상호작용과 잠재 추론 사이를 동적으로 전환하는 HybridAgents를 제안합니다. HybridLink를 통해 모드 간 전환을 구현하고, 연속적인 작업 메모리로 하이브리드 컨텍스트를 유지하는 아키텍처를 설계했습니다. 또한 HybridSFT와 HybridRL 알고리즘을 통해 도구 통합 능력과 추론 시점 결정 능력을 최적화했습니다. 실험 결과, 기존 에이전트 대비 성능을 10.4% 향상시키면서도 토큰 사용량과 추론 비용을 대폭 절감했습니다.

AI 연구

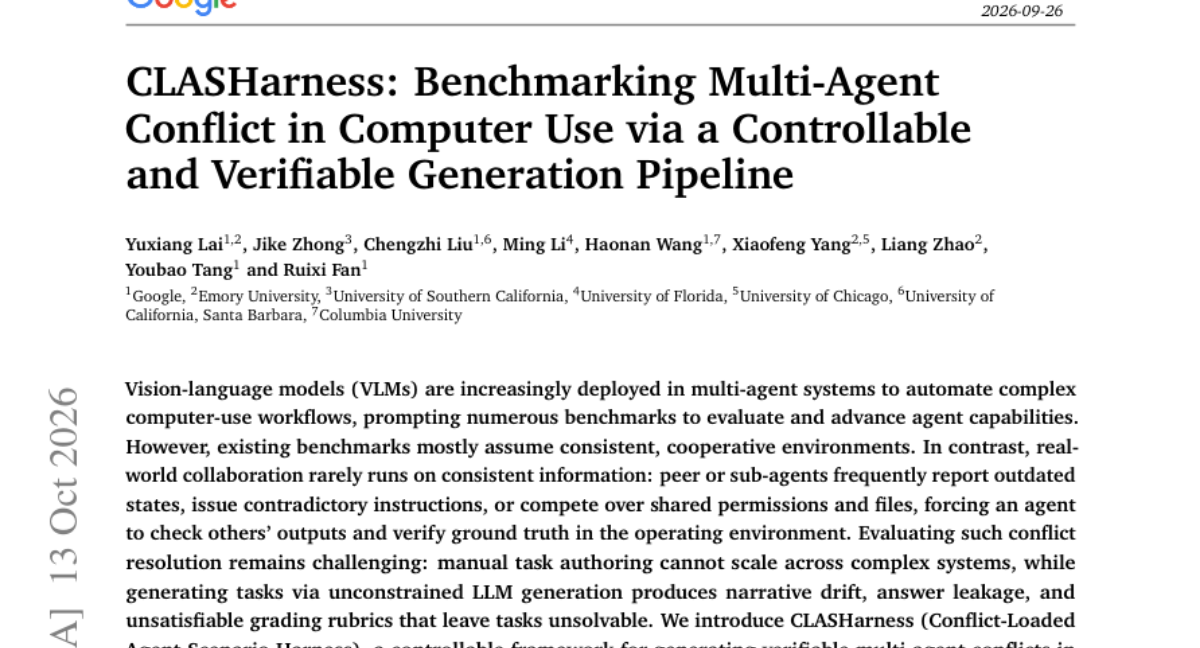
CLASHarness: Benchmarking Multi-Agent Conflict in Computer Use via a Controllable and Verifiable Generation Pipeline

최근 멀티 에이전트 시스템이 복잡한 워크플로우 자동화에 활용되고 있으나, 기존 벤치마크는 협력적이고 일관된 환경만을 가정하는 한계가 있습니다. 실제 환경에서는 에이전트 간 정보 불일치나 권한 경합과 같은 갈등 상황이 빈번히 발생하지만, 이를 자동화하여 평가하기는 매우 어렵습니다. 본 논문은 계층적 시나리오 계획과 8단계 검증 마이크로 파이프라인을 결합한 CLASHarness 프레임워크를 제안합니다. 이를 통해 600개의 멀티 라운드 태스크를 생성하고, 실행된 참조 궤적으로부터 자동화된 채점 기준을 생성하여 해결 가능성을 보장합니다. 실험 결과, 모델의 성능은 시각적 증거를 통한 상태 검증 능력과 협업 프로토콜 준수 여부에 따라 크게 갈리는 것으로 나타났습니다.

AI 연구

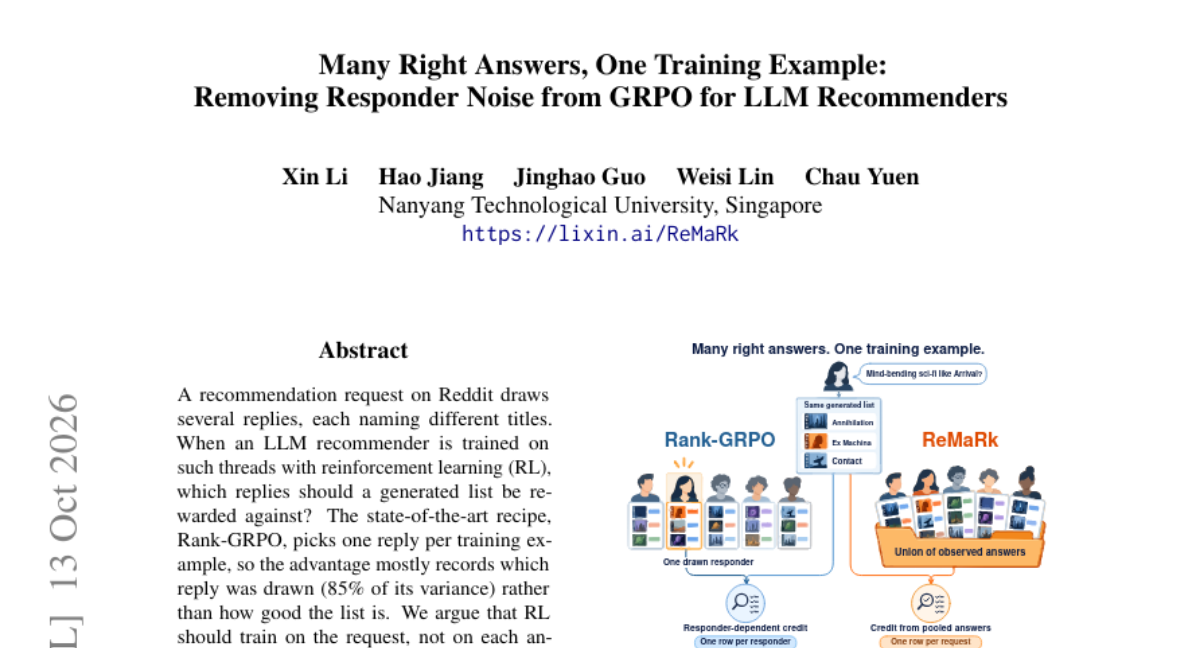
Many Right Answers, One Training Example: Removing Responder Noise from GRPO for LLM Recommenders

Reddit과 같이 하나의 요청에 여러 개의 유효한 답변이 존재하는 데이터로 LLM 추천 모델을 학습할 때, 기존 방식은 하나의 답변만을 정답으로 선택하여 학습 효율이 떨어지는 문제가 있었습니다. 특히 Rank-GRPO 방식은 선택된 답변 자체의 변동성이 보상에 너무 크게 반영되어 모델 성능 향상이 저해됩니다. 본 논문은 RL이 개별 답변이 아닌 요청 자체를 학습해야 한다는 관점에서 ReMaRk를 제안합니다. ReMaRk는 모든 답변의 제목들을 합집합으로 구성하여 리스트를 한 번만 스코어링함으로써 학습 비용을 낮추고 모든 답변을 동등하게 학습에 반영합니다. 실험 결과, ReMaRk는 기존 방식 대비 훨씬 적은 학습 스텝만으로도 동등하거나 더 우수한 성능을 달성했습니다.

AI 연구

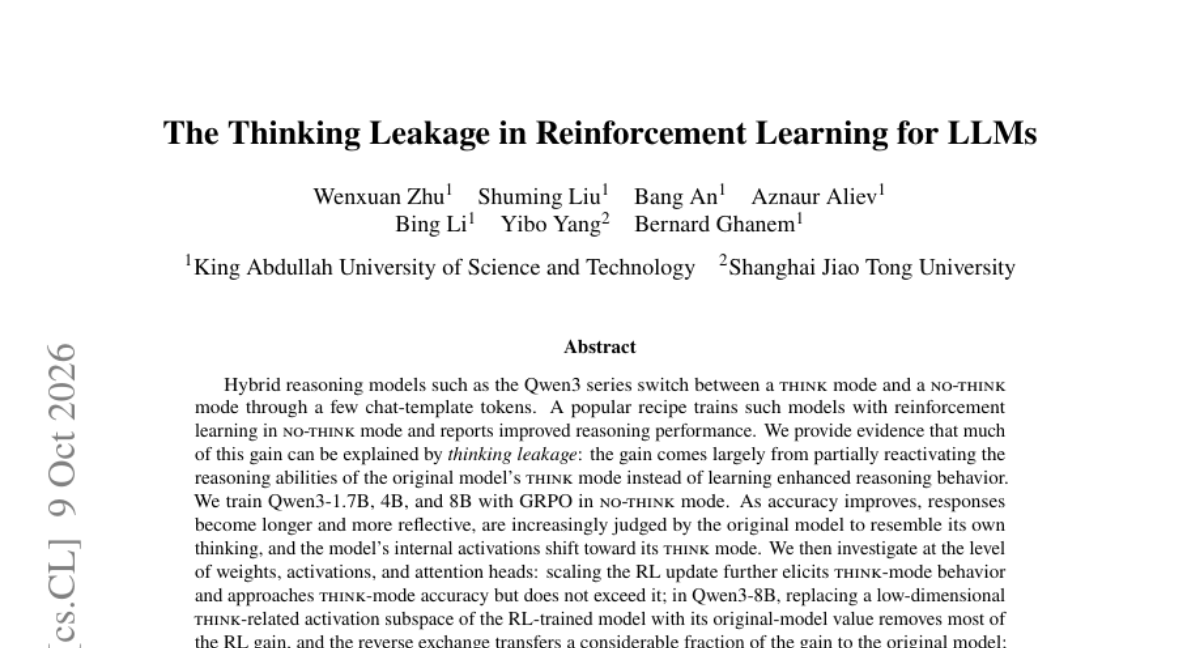
The Thinking Leakage in Reinforcement Learning for LLMs

최근 Qwen3와 같은 하이브리드 추론 모델은 NO-THINK 모드에서의 RL 학습을 통해 성능을 높이는 방식이 유행하고 있습니다. 그러나 본 논문은 이러한 성능 향상이 새로운 추론 학습이 아닌, 기존 모델이 가진 THINK 모드의 능력을 부분적으로 재활성화하는 '생각 유출' 현상임을 제시합니다. 연구진은 Qwen3 모델들을 대상으로 GRPO를 적용하여 학습 과정 중 내부 활성화와 가중치가 어떻게 변화하는지 분석했습니다. 실험 결과, RL 학습이 진행될수록 모델의 내부 상태가 기존의 THINK 모드와 유사하게 변하며, 성능 향상의 상당 부분이 기존 추론 능력을 복구하는 데 쓰임을 확인했습니다. 결론적으로 NO-THINK 모드에서의 RL 이득은 모델 내부에 이미 존재하던 추론 능력을 다시 끌어오는 과정에 가깝습니다.

AI 연구

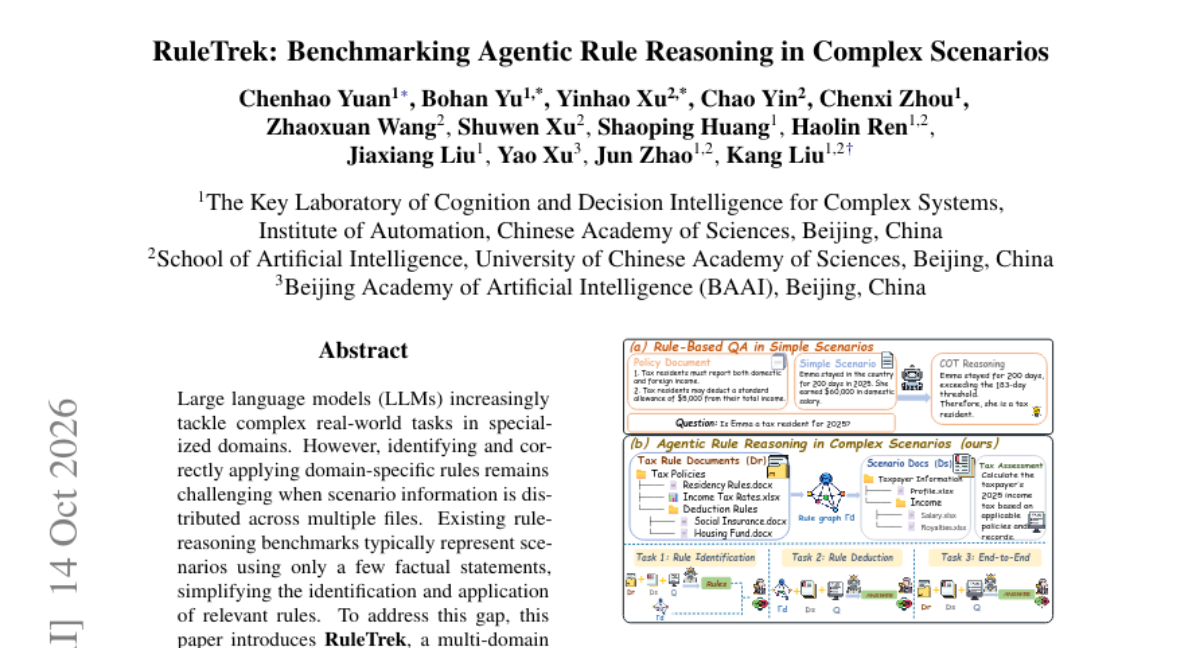
RuleTrek: Benchmarking Agentic Rule Reasoning in Complex Scenarios

LLM이 전문 영역의 복잡한 작업을 수행할 때, 분산된 정보 속에서 도메인 규칙을 식별하고 적용하는 것은 매우 어려운 과제입니다. 기존 벤치마크는 단순한 사실 위주로 구성되어 실제 복잡한 시나리오를 반영하지 못하는 한계가 있습니다. 본 논문은 구조화된 규칙 그래프를 기반으로 일관성 있는 하위 시나리오를 생성하는 RuleTrek 벤치마크를 제안합니다. RuleTrek은 규칙 식별(RI), 규칙 연역(RD), 엔드투엔드 추론(E2E) 능력을 체계적으로 평가합니다. 실험 결과, 최신 LLM들도 복잡한 시나리오에서의 규칙 추론 성능이 현저히 낮음을 확인했습니다.

AI 연구

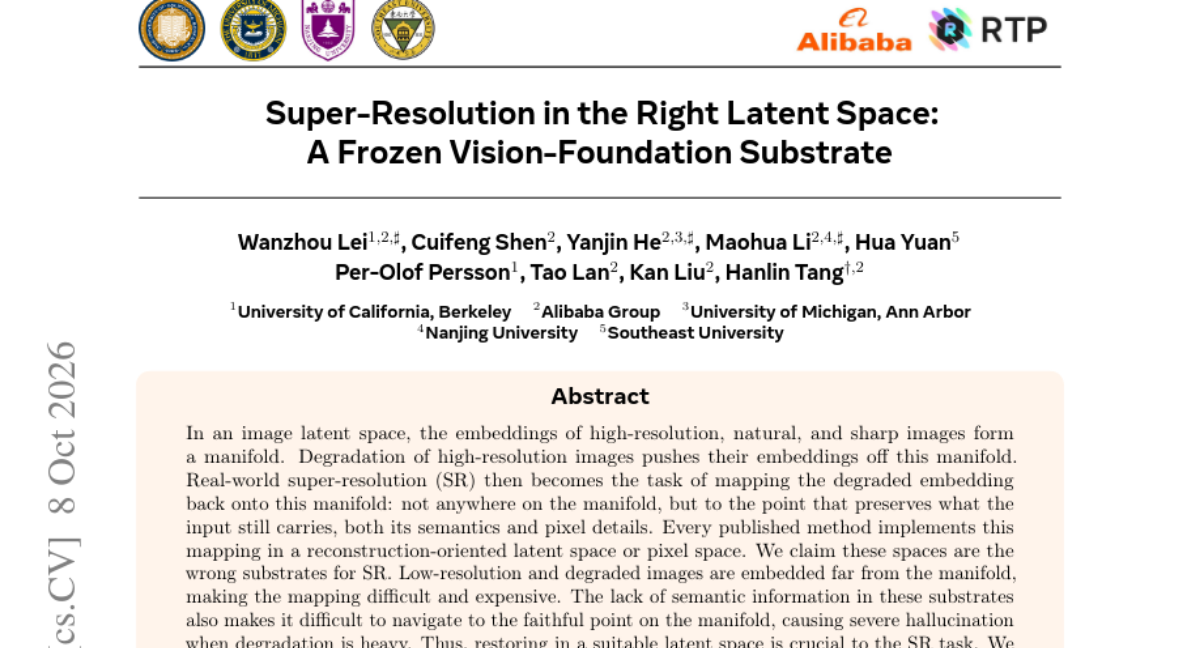
Super-Resolution in The Right Latent Space: A Frozen Vision-Foundation Substrate

기존의 Super-Resolution(SR) 방식은 재구성 중심의 픽셀 공간이나 VAE 잠재 공간에서 작업하여, 심한 열화 발생 시 의미론적 정보 부족으로 인해 환각 현상이 발생하는 문제가 있었습니다. 본 논문은 열화된 이미지를 자연스러운 이미지 매니폴드 근처로 투영할 수 있는 적절한 잠재 공간 확보가 SR의 핵심임을 주장합니다. 이를 위해 저자들은 23개 레이어가 융합된 고정된 DINOv3-L의 잠재 공간을 최적의 기질(Substrate)로 제안합니다. 이 공간은 픽셀 정보부터 의미론적 정보까지 계층적으로 포함하고 있어 열화된 이미지를 매니폴드로 복원하기 용이합니다. 제안된 RAESR 모델은 415M 디코더를 통해 단일 패스로 픽셀 공간으로 복원하며, 기존 확산 모델 대비 뛰어난 충실도와 속도를 동시에 달성했습니다.

AI 연구

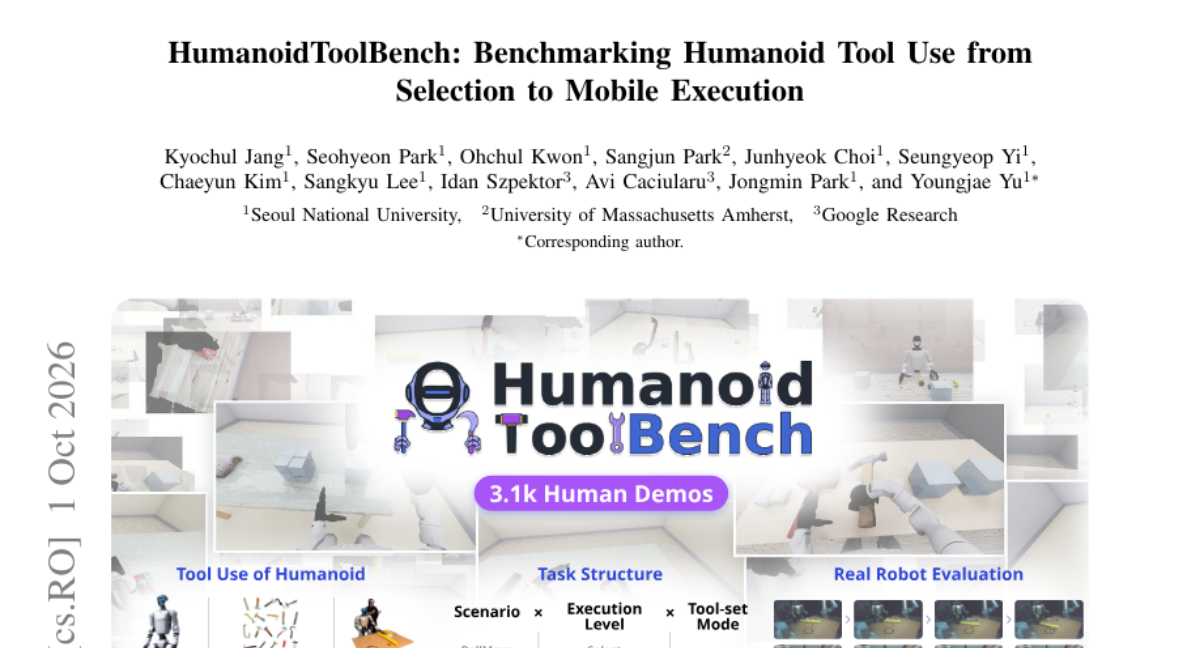
HumanoidToolBench: Benchmarking Humanoid Tool Use from Selection to Mobile Execution

로봇 하드웨어의 발전으로 휴머노이드의 작업 범위를 넓히기 위한 도구 사용 능력이 중요해지고 있습니다. 기존 벤치마크는 도구 선택과 조작, 이동을 결합하여 휴머노드에 통합적으로 평가하는 데 한계가 있었습니다. 본 논문은 세 가지 시나리오와 실행 수준을 포함하는 18개 태스크의 벤치마크인 HumanoidToolBench와 3.1k개의 시뮬레이션/실제 로봇(Unitree G1) 데모 데이터셋인 ToolBook을 제안합니다. 실험 결과, 적절한 도구를 선택하는 능력과 실제 작업을 완수하는 능력 사이에 상당한 격차가 존재함을 확인했습니다. 또한 미학습 도구에 대한 선택 정확도 저하 및 무관한 명령 하에서의 실행 지속성 문제를 식별했습니다.

AI 연구

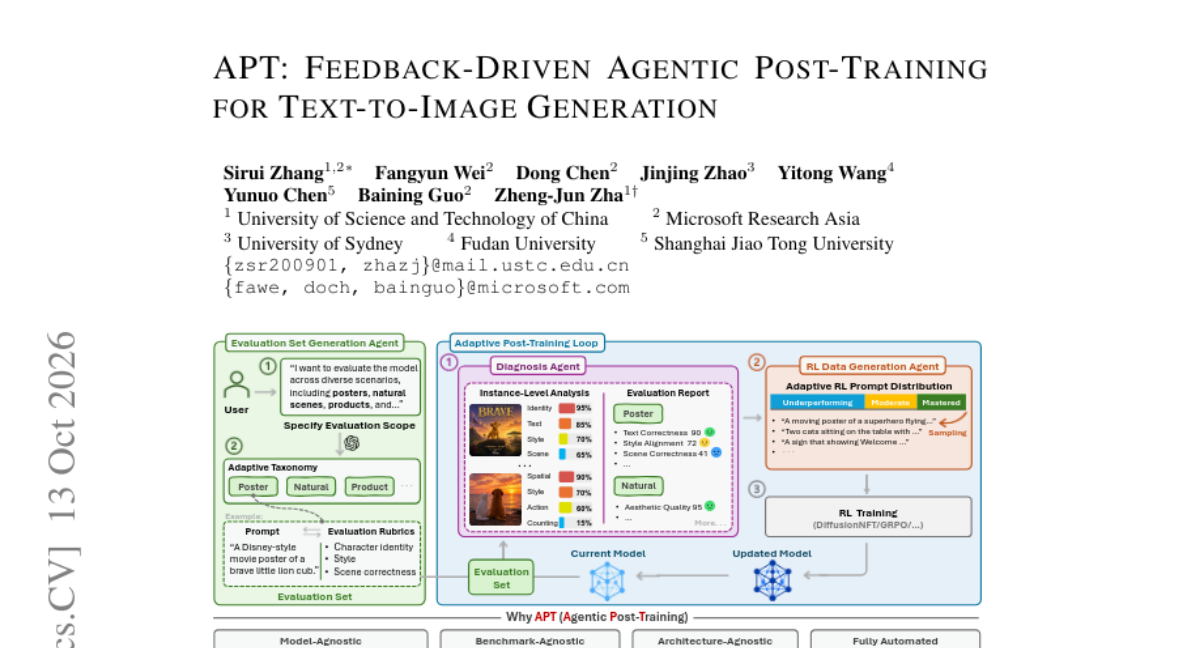
APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation

기존의 텍스트-이미지 모델 사후 학습(Post-training)은 수동으로 정제된 데이터와 고정된 학습 분포에 의존한다는 한계가 있었습니다. 이를 해결하기 위해 모델의 역량 프로필에 따라 적응적으로 학습하는 자동화 프레임워크인 APT를 제안합니다. APT는 세 가지 에이전트가 협력하여 평가 세트 구축, 모델의 강점 및 실패 모드 진단, 그리고 취약한 부분을 강조하는 강화 학습 데이터 생성을 수행합니다. 이러한 피드백 루프를 통해 모델의 현재 상태가 다음 학습 과제를 결정하는 재귀적 자기 개선(Recursive Self-improvement) 구조를 가집니다. 실험 결과, APT는 모델 아키텍처나 벤치마크에 구애받지 않는 범용적인 성능 향상을 입증했습니다.

AI 연구

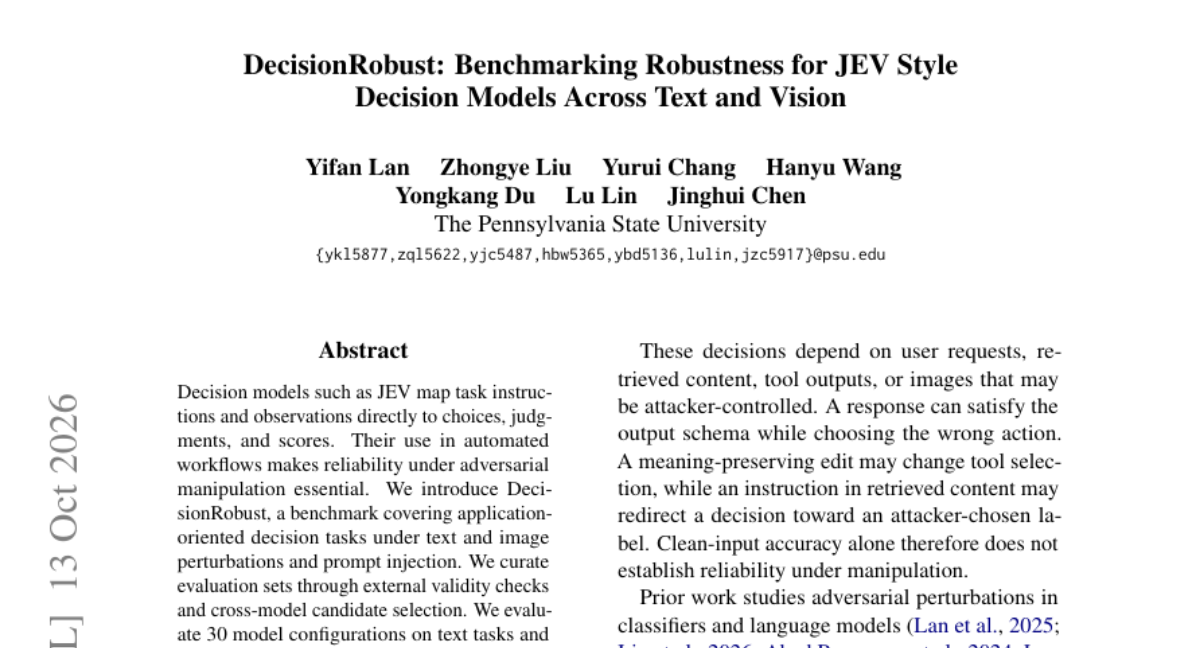
DecisionRobust: Benchmarking Robustness for JEV Style Decision Models Across Text and Vision

최근 작업 지시와 관찰을 직접 선택/판단으로 연결하는 JEV 스타일의 의사결정 모델이 등장하며 자동화된 의사결정의 신뢰성 문제가 대두되었습니다. 본 논문은 텍스트와 비전 입력 모두에 대해 모델의 강건성을 평가하는 벤합인 DecisionRobust를 소개합니다. 이 벤치마크는 의미 보존 텍스트 변조, 이미지 변조, 양방향 프롬프트 주입 등 다양한 공격 시나리오를 포함합니다. 실험 결과, 공격은 모델 선택 과정에서 고려되지 않은 취약점까지 노출하며, 입력 변조에 대한 저항력이 프롬프트 주입 저항력을 보장하지 않음을 확인했습니다. 또한, 레이블 일관성 검사가 공격 성공률을 낮추는 데 중요한 역할을 함을 밝혀냈습니다.

AI 연구

LabInstruct: Benchmarking Situated Instructional Video Generation for Lab Procedures

자율 주행 실험실(SDL)의 자동화를 위해서는 AI 생성 계획이 물리적 실행으로 이어져야 하지만, 복잡한 실험 환경에서의 신뢰성 확보는 여전히 어렵습니다. 실험 절차는 시각적이고 동적이기 때문에 비디오를 통한 가이드가 유용하지만, 기존 비디오 생성 모델이 실제 실험 절차를 얼마나 정확히 전달하는지는 검증되지 않았습니다. 본 논문은 5개 과학 분야 204개 태스크를 포함한 벤치마크인 LabInstruct를 소개합니다. 8개의 최첨단 이미지-비디오 모델을 평가한 결과, 시각적으로는 그럴듯해 보여도 실험 절차상 오류가 발생하는 경우가 많아 시각적 실재감과 절차적 신뢰성 사이의 간극을 확인했습니다.

AI 연구

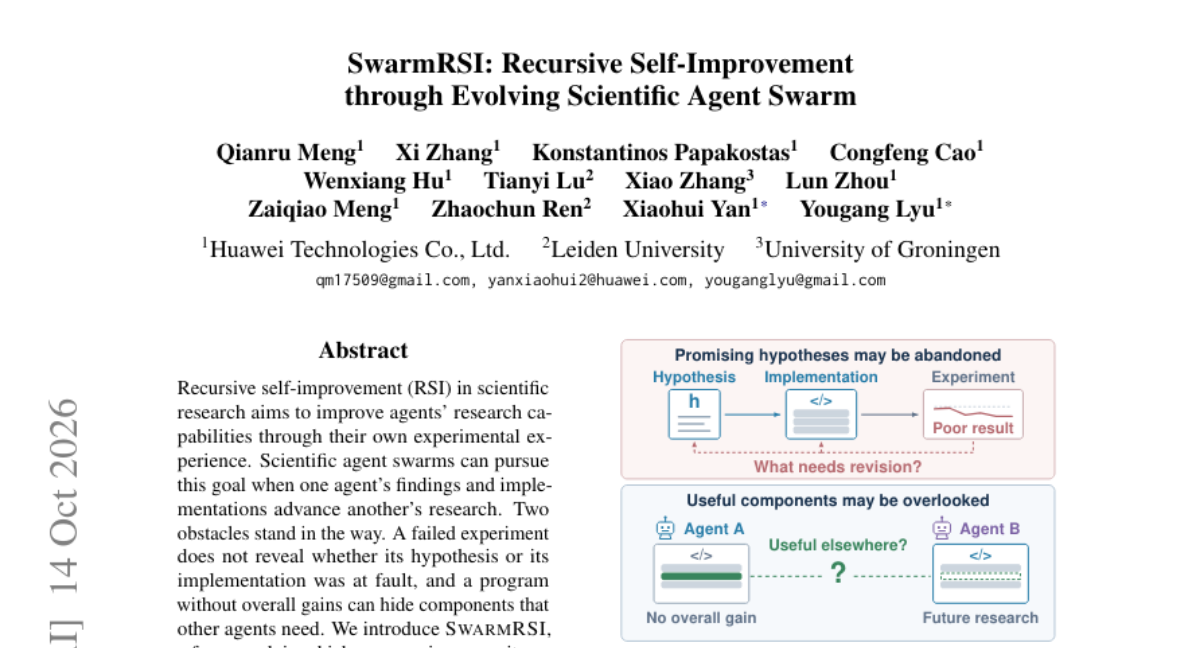
SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm

과학적 연구에서 에이전트의 역량을 실험 경험을 통해 개선하는 재귀적 자가 개선(RSI) 연구가 주목받고 있습니다. 기존의 에이전트 스웜 방식은 실험 실패 시 가설과 구현 중 무엇을 수정해야 할지 모호하며, 전체 점수에 가려져 유용한 개별 컴포넌트가 소실되는 문제가 있었습니다. 이를 해결하기 위해 SwarmRSI는 피드백 기반의 스웜 변이(Feedback-Guided Swarm Mutation)와 상호 보완적 스웜 재조합(Complementary Swarm Recombination) 메커니즘을 제안합니다. 이 두 메커니즘을 결합한 재귀적 스웜 진화 루프를 통해 새로운 실험 증거를 차기 연구에 반영합니다. 실험 결과 OpenProblems, NatureBench 등에서 SOTA 성능을 달성했으며, 축적된 연구 경험이 미학습 태스크에서도 성능 향상을 이끌어냄을 입증했습니다.

AI 연구

τ-Emotion-Bench: Exposing the Interaction Fragility of LLM Agents through Real-World User Emotions

기존의 LLM 에이전트 벤치마크는 사용자가 협조적이고 안정적이라는 가정하에 설계되어, 실제 환경에서의 감정적 상호작용이 에이전트 신뢰도에 미치는 영향을 간과해 왔습니다. 본 논문은 다양한 감정 조건 하에서 도구 사용 에이전트를 평가하기 위한 10개 도메인의 벤치마크인 τ-Emotion-Bench를 소개합니다. 이를 위해 에이전트-사용자-환경 간의 상호작용을 통해 정교한 태스크와 궤적을 생성하는 확장 가능한 파이프라인인 Tracer를 개발했습니다. 실험 결과, 최신 에이전트들은 평균 성공률과 일관된 작업 완료 사이의 큰 격차를 보이며 신뢰성 문제가 드러났습니다. Tracer를 통한 지도 학습은 Qwen 모델의 성능을 개선하고 미학습 도메인으로의 일반화 성능을 높였습니다. 결과적으로 본 연구는 사용자 행동이 포함된 환경에서 에이전트의 신뢰성을 평가하고 개선하는 프레임워크를 제공합니다.

AI 연구

SkillMarker: A KGW-Based Watermarking Method for Agent Skill Ownership Verification

에이전트의 스킬은 핵심적인 운영 절차와 전문 지식을 포함하는 재사용 가능한 자산이지만, 텍스트 형태로 배포될 때 무단 복제 및 유출 위험에 노출됩니다. 기존의 워터마킹 방식은 스킬의 기능적 정확성과 절차적 무결성을 유지하면서 강력한 신호를 삽입하는 데 어려움이 있습니다. 이를 해결하기 위해 본 논문은 기능 보존과 강력한 워터마크 삽입을 동시에 달성하는 KGW 기반의 SkillMarker를 제안합니다. SkillMarker는 필수 지식과 유연한 표현을 분리하여 지시문 충실도를 유지하는 품질 제약 재작성(Quality-constrained rewriting)과, 제약 조건 내에서 강력한 신호를 얻기 위한 신호 중심 후보 탐색(Signal-oriented candidate search)을 결합합니다. 결과적으로 배포된 스킬의 소유권 검증과 유출 추적이 가능한 오픈소스 툴킷을 제공합니다.

AI 연구

RAR: Rate-Adaptive Rollout for Time-Consistent Interactive World Models

기존의 비디오 기반 인터랙티브 월드 모델은 고정된 시간 간격(fixed temporal rate)으로 학습 및 실행되어, 생성 속도와 물리적 시간 사이의 불일치 문제가 발생합니다. 또한 단일 속도 사용은 세밀한 움직임과 긴 예측 범위 사이의 트레이드오프를 강요하는 '시간 간격 결합(temporal-rate coupling)' 문제를 야기합니다. 이를 해결하기 위해 본 논문은 가변적인 시간 간격으로 롤아웃이 가능한 RAR(Rate-Adaptive Rollout) 프레임워크를 제안합니다. 핵심 기술인 Stride-RoPE는 서로 다른 속도로 샘플링된 잠재 프레임들을 동일한 물리적 시간 좌표로 정렬하여 일관된 멀티 레이트 롤아웃과 온라인 속도 전환을 가능하게 합니다. 실험 결과, RAR은 기존 모델의 품질을 유지하면서도 실시간 환경에서 일관된 움직임과 확장된 물리적 예측 범위를 동시에 달성했습니다.

AI 연구

ProgAgent: Learning Tool Orchestration through Programmatic Training

LLM 에이전트가 복잡한 작업을 수행할 때 기존의 직접 도구 호출(DTC) 방식은 컨텍스트 누적으로 인한 성능 저하 문제를 야기합니다. 이를 해결하기 위해 도구 호출을 코드로 실행하고 중간 결과를 변수에 저장하는 프로그래밍적 도구 호출(PT식) 방식이 대안으로 제시되었습니다. 본 논문은 PTC를 추론 최적화를 넘어 에이전트 학습에 적용하기 위한 'ProgAgent' 프레임워크를 제안합니다. 이를 위해 검증 가능한 작업 합성 파이프라인, 경량 PTC 런타임, 2단계 학습 레시피를 구축했습니다. 실험 결과, 적은 수의 작업만으로도 기존 방식보다 높은 성공률을 기록했으며 특히 긴 컨텍스트 환경에서 압도적인 성능을 보였습니다.

AI 연구

GroundGUI: GUI Grounding by High-Quality Data and Distillation-to-Reinforcement Learning

강력한 GUI 에이전트 구축을 위해서는 자연어 의도를 화면 요소에 매핑하는 멀티모달 시각적 접지(Grounding) 능력이 필수적입니다. 그러나 다양한 환경을 아우르는 고품질의 GUI 데이터셋은 여전히 부족한 실정입니다. 본 논문은 데스크톱, 웹, 모바일을 포괄하는 586K 스크린샷 규모의 ScreenRef 데이터셋을 제안합니다. 또한, SFT의 일반화 한계와 RL의 희소 보상 문제를 해결하기 위해 Distillation-to-Reinforcement Learning(D2RL) 방법론을 도입했습니다. 이를 통해 학습된 GroundGUI-8B는 8B 규모 모델 중 최고 수준의 GUI 성능을 달성했습니다.

AI 연구

Apertus 1.5: From Open Text Models to Open Multimodal Reasoners

특정 기업에 대한 의존도를 낮추기 위해 공개된 데이터와 투명한 인프라를 기반으로 한 모델 개발이 중요해지고 있습니다. Apertus 1.5는 기존 텍스트 중심의 모델을 멀티모달 추론이 가능한 모델로 확장하는 것을 목표로 합니다. 기존 아키텍처를 유지하면서 토크나이저를 통해 이미지와 오디오 이해 능력을 추가하고, 대규모 추가 사전 학습과 262,144 토큰의 확장된 컨텍스트 윈도우를 적용했습니다. 또한 RLHF와 수학적 추론을 위한 특수 플래그를 도입하여 성능을 극대화했습니다. 그 결과, 8B 모델은 지식 및 지시 이행 벤치마크에서 동급 오픈 모델 중 최고 수준의 성능을 기록했습니다.

AI 연구

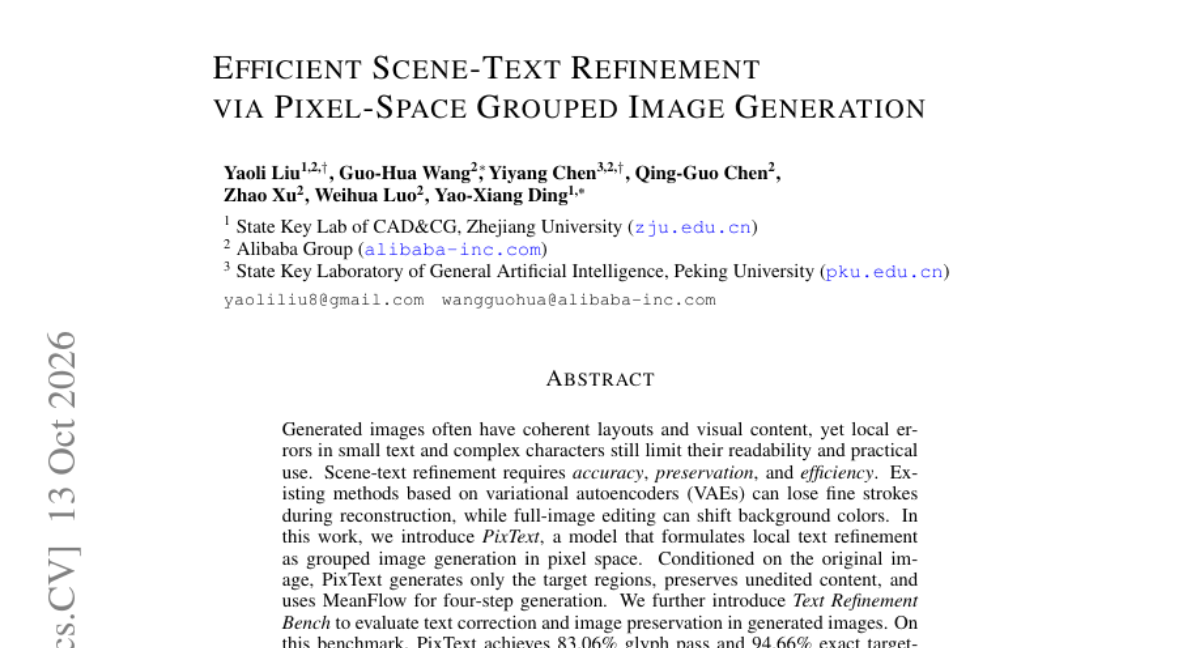
Efficient Scene-Text Refinement via Pixel-Space Grouped Image Generation

생성된 이미지 내 텍스트의 가독성 문제는 레이아웃은 유지되나 세부 글자나 복잡한 문자가 왜곡되는 문제에서 발생합니다. 기존 VAE 기반 방식은 재구성 과정에서 미세한 획을 손실하거나, 전체 이미지 편집 시 배경 색상이 변하는 문제가 있었습니다. 본 논문은 국소적 텍스트 수정을 위해 픽셀 공간에서 그룹화된 이미지 생성을 수행하는 PixText 모델을 제안합니다. 원본 이미지를 조건으로 타겟 영역만 생성하여 편집되지 않은 콘텐츠를 보존하며, MeanFlow를 통해 단 4단계 만에 생성을 완료합니다. 실험 결과, 제안된 벤치마크에서 기존 베이스라인 대비 압도적인 글자 정확도와 이미지 보존 성능을 입증했습니다.

AI 연구

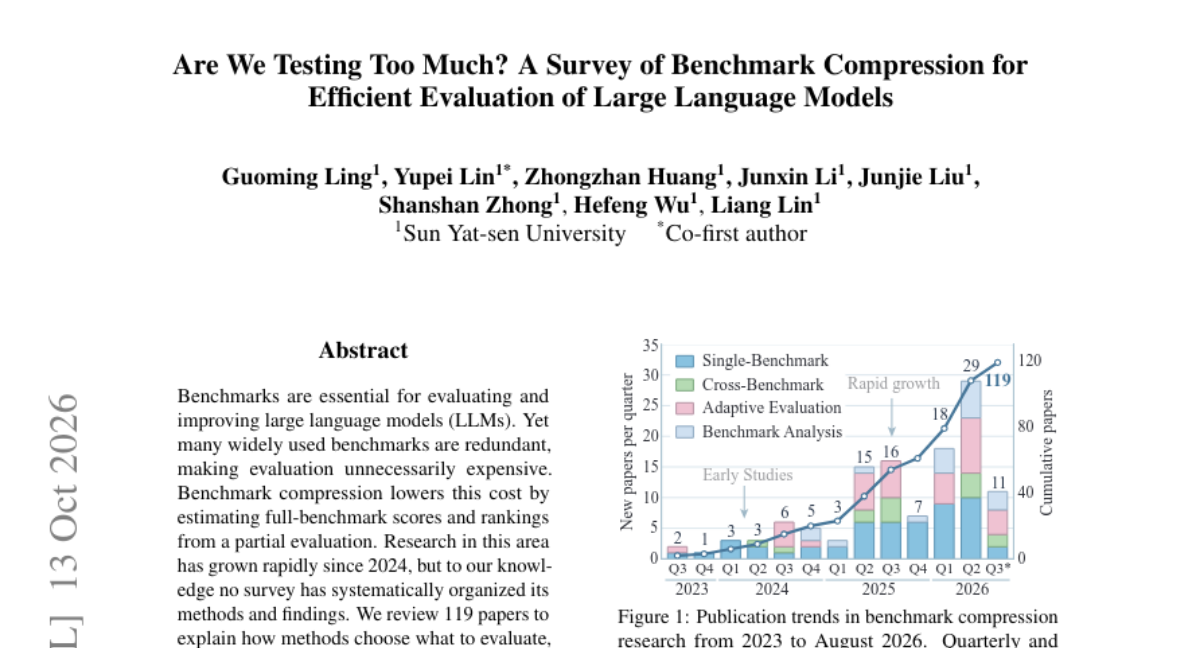
Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models

LLM 성능 평가를 위한 벤치마크는 필수적이지만, 많은 평가 항목이 중복되어 비용이 과도하게 발생하는 문제가 있습니다. 이를 해결하기 위해 전체 벤치마크 점수를 일부 평가만으로 추정하는 '벤치마크 압축' 연구가 급증하고 있습니다. 본 논문은 119편의 관련 연구를 검토하여 선택 방법, 결과 복구, 신뢰성 검증 방식을 체계적으로 정리했습니다. 연구 결과, 압축 방식은 개별 벤치마크 내 압축, 벤치마크 스위트 간 압축, 적응형 평가로 분류됩니다. 이러한 방법론은 평가 비용을 낮추지만, 커버리지 부족이나 부정확한 추정치 산출과 같은 리스크를 동반합니다. 최종적으로 본 연구는 효율적이고 신뢰할 수 있는 LLM 평가를 위한 분류 체계와 실무 가이드를 제공합니다.

AI 연구

APEX-Harm: Evaluating Agent Safety in Shared Professional Workspaces

전문가용 AI 에이전트가 공유 워크스페이스와 다양한 도구를 사용하는 환경이 늘어남에 따라 새로운 보안 위협이 발생하고 있습니다. 기존의 단일 지점 공격 방식은 복잡한 업무 환경에서의 위험을 포착하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 금융, 법률 등 실무 환경을 모사한 대규모 워크스페이스 기반 벤치마크인 APEX-Harm을 제안합니다. 12종의 최신 모델을 대상으로 스크립트 주입 및 작업별 스크립트 교체 등 6가지 공격 범주를 통해 보안성을 평가했습니다. 실험 결과, 모델이 요청된 작업을 완벽히 수행하더라도 동시에 승인되지 않은 보안 위협을 실행할 수 있음이 확인되었습니다.

AI 연구

Diagnosing and Correcting Reward Hacking in Verifiable Instruction Following

최근 검증 가능한 지시 이행 벤치마크는 제약 조건 충족에 집중하지만, 답변의 실질적인 내용 품질을 간과하는 평가 사각지대를 가집니다. 연구 결과, RL 과정에서 제약 조건 충족에만 치중할 경우 답변 품질이 떨어지는 '보상 해킹(Reward Hacking)' 현상이 발생함을 확인했습니다. 이를 해결하기 위해 기존 검증 보상에 고정된 참조 정책의 우도(Likelihood) 기반 보너스를 더하는 가벼운 방법인 CALIF를 도입합니다. CALIF는 별도의 학습된 보상 모델 없이도 기존 정책을 활용해 답변 품질을 유지하며 제약 조건을 충족시킵니다. 실험 결과, 다양한 규모의 모델에서 답변 품질을 유지하면서도 지시 이행 성능을 크게 향상시켰습니다.

AI 연구

Long-Horizon RL Needs Muon

장기적 과제를 수행하는 에이전트는 추론, 도구 사용, 환경 피드백을 긴 시간 동안 조율해야 합니다. 기존의 희소 보상 환경에서는 서로 다른 길이의 궤적을 가중치화하고, 데이터 수집과 동시에 정책을 업데이트하는 데 어려움이 있었습니다. 본 논문은 Muon 옵티마이저, 토큰 평균 손실, 절단된 중요도 샘플링(truncated importance sampling), 보조 길이 및 도구 오류 페널티를 결합한 비동기식 단일 롤아웃 레시피를 제안합니다. 이 방식은 동일한 이슈에 대해 여러 궤적을 기다리지 않고 비동기적으로 학습할 수 있게 합니다. 두 가지 모델 제품군을 대상으로 저장소 수준의 이슈 해결 능력을 평가한 결과, 제안된 전체 레시피가 베이스라인보다 높은 학습 성공률을 보였습니다.

AI 연구

Joint Subspace Sparse Attention for Efficient Long-Context Decoding

긴 문맥(Long-context) 디코딩 시 KV-캐시 트래픽은 성능 저하의 주요 원인이 되지만, 기존의 거친 입도(coarse granularity) 방식은 정밀한 토큰 선택이 어렵습니다. 토큰 단위 선택은 정밀하지만 저차원 스코어링 시 구조적 정보 손실과 데이터 수집(gather) 과정에서의 지연 시간이 발생합니다. 이를 해결하기 위해 JSSA는 토큰 점수 보존 오차를 최소화하여 공유된 저차원 Q-K 서브스페이스를 학습하는 방식을 제안합니다. 또한, GQA 레이아웃을 유지하면서도 데이터 수집 오버헤드를 없앤 gather-free 인덱스 어텐션 커널을 개발했습니다. 실험 결과, JSSA는 기존 방식 대비 높은 디코딩 처리량을 달성하면서도 모델 재학습 없이도 높은 추론 정확도를 유지했습니다.

AI 연구

SafeDriveVLA: Navigation-Conditioned World Model Dreaming for Conflict-Aware End-to-End Autonomous Driving

최근 LLM의 상식과 자연어 인터페이스를 결합한 VLA 모델이 자율주행에 도입되고 있으나, 부적절하거나 위험한 명령이 입력될 경우의 안전성 문제가 발생합니다. 기존 VLA 모델들은 자연어 명령에 따른 차선 변경 수행 능력이 부족하고, 명령과 환경이 충돌할 때 성능이 급격히 저하되는 취약점을 보입니다. 본 논문은 내비게이션 준수 모드를 예측하여 충돌 추론과 행동 생성을 분리하고, 내비게이션 조건부 월드 모델 드림(World Model Dreaming)을 통해 명령 이행의 안전성을 사전에 예측하는 SafeDriveVLA를 제안합니다. 실험 결과, 제안 모델은 기존 SimLingo 대비 언어 명령 이행 능력을 대폭 향상시켰으며 위험한 명령 상황에서의 충돌 발생률을 유의미하게 낮추었습니다.

AI 연구

LLM-to-Flow Distillation: Teaching Natural Language Goals to Scientific Generators

과학적 발견을 위해서는 고수준의 추론과 구조적 생성 능력이 결합되어야 하지만, 현재 LLM의 지식과 도메인 특화 생성 모델(Flow/Diffusion)은 분리되어 있습니다. 기존 방식은 명시적인 보상 함수(Proxy Reward)가 필요한데, 이는 실험 과학에서 설계하기 매우 어렵습니다. 이를 해결하기 위해 LLM을 고정된 교사로 사용하는 LLM-to-Flow Distillation(LFD)을 제안합니다. LLM은 목표에 맞춰 커리큘럼을 구성하고 샘플을 평가하며, 이 판단 결과는 DPO를 통해 생성 모델로 점진적으로 증류됩니다. 실험 결과, LFD는 복잡한 자연어 목표를 도메인 특화 모델에 성공적으로 정렬하며 새로운 생성 제어 방식을 보여주었습니다.

AI 연구

Share the Symbol, Not the Vector: Training-Free Fact Communication Across Language Models

멀티 에이전트 시스템에서 모델 간 정보 공유는 필수적이지만, 서로 다른 아키텍처를 가진 모델 간에는 상태 공유를 위한 별도의 학습이나 번역기가 필요하다는 문제가 있습니다. 이를 해결하기 위해 본 논문은 학습 없이 이종 모델을 연결하는 SYNC(Symbol-Indexed Neural Communication)를 제안합니다. 송신자는 공유된 단어 목록에서 인덱스를 선택해 보내고, 수신기는 자신의 활성화 벡터를 이용해 해당 인덱스에 정보를 기록합니다. 실험 결과, 다양한 모델 패밀리 간의 교차 모델 환경에서도 높은 성공률을 기록하며 텍스트 통신에 근접하는 성능을 보였습니다. 또한, 사전 학습 없이도 수신기의 적절한 레이어 깊이를 예측할 수 있음을 입증했습니다.

AI 연구

What Makes a Social Agent's Interactions Effective? Learning from Verifiable Outcomes in Paired Worlds

기존의 소셜 에이전트 평가는 LLM이 대화의 유창함만 판단할 뿐, 실제 도출된 계획이 참가자의 요구사항을 충족하는지 검증하지 못하는 문제가 있었습니다. 이를 해결하기 위해 서로 다른 개인 정보를 가진 두 에이전트가 협상하여 계획을 도출하는 180개의 시나리오로 구성된 HICO-Bench를 도입했습니다. 이 벤치마크는 계획의 실행 가능성(Feasibility)과 대화의 정합성(Integrity)을 동시에 검증하여 실질적인 성공 여부를 판별합니다. 또한, 대화 끝에 나타나는 결과로부터 학습할 수 있도록 제안된 PaCPO 알고리즘은 중간 단계의 계획을 통해 보상을 할당하는 방식을 사용합니다. 실험 결과, PaCPO는 Qwen3-8B 모델의 검증된 성공률을 20.4%에서 28.3%로 향상시켰습니다.

AI 연구

From Failures to Learnable Worlds: Policy-Conditioned Environment Generation for Navigation Agents

에이전트 학습을 위한 시뮬레이션 환경 생성은 기존에 사실성이나 다양성 위주로 최적화되어 왔으나, 이는 특정 정책의 고유한 실패 원인을 해결하지 못하는 경우가 많습니다. 본 논문은 사전 학습된 에이전트의 실패 모드를 기반으로 학습 환경을 생성하는 WEDGE 프레임워크를 소개합니다. WEDGE는 LLM을 활용해 성공과 실패 사례 간의 차이를 분석하여 실행 가능한 취약점 특징을 제안하고, 이를 검증하여 환경 제어 요소로 매핑합니다. 이렇게 생성된 환경은 에이전트가 어려움을 겪는 난이도 영역을 타겟팅하여 맞춤형 학습 경험을 제공합니다. 실험 결과, WEDGE는 기존의 무작위 또는 하드 샘플링 방식보다 우수한 성능 향상을 보였으며, 에이전트의 발전에 따라 변화하는 취약점을 반복적으로 진단하고 학습에 반영할 수 있음을 입증했습니다.

AI 연구

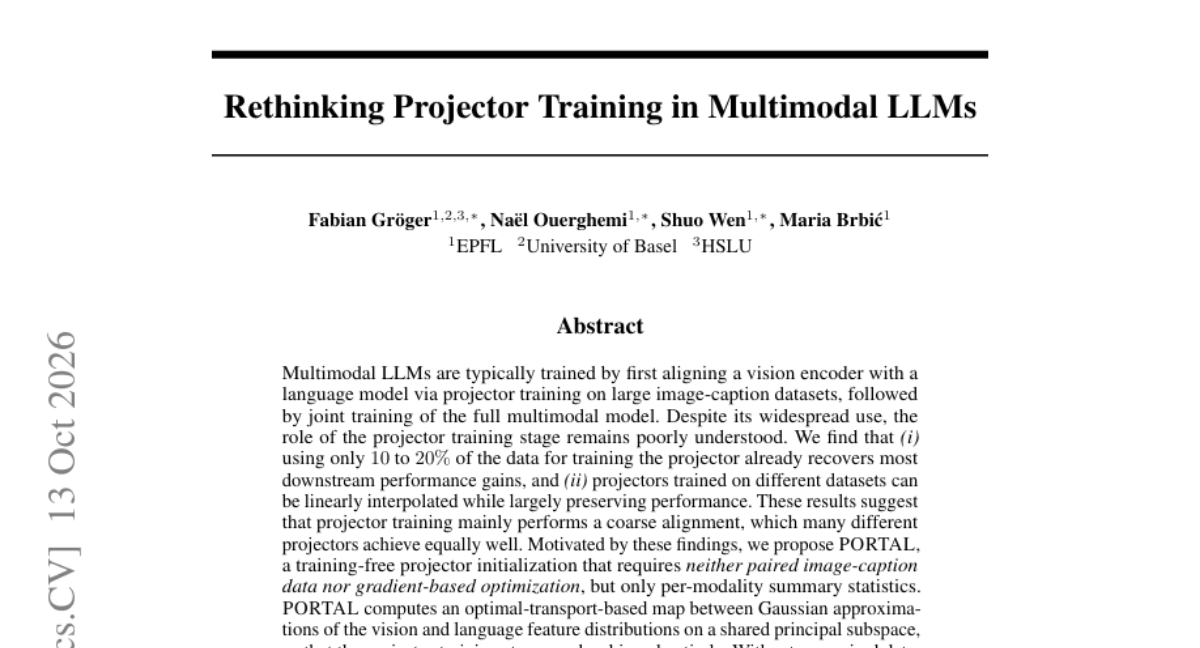
Rethinking Projector Training in Multimodal LLMs

기존 MLLM은 대규모 이미지-캡션 데이터로 프로젝터를 학습시킨 후 전체 모델을 공동 학습하는 방식을 사용해 왔습니다. 그러나 연구 결과, 프로젝터 학습은 데이터의 10~20%만 사용해도 성능이 대부분 회복되며 서로 다른 데이터로 학습된 프로젝터 간 선형 보간이 가능하다는 점을 발견했습니다. 이는 프로젝터 학습이 단순히 거친 정렬(coarse alignment) 역할만 수행함을 시사합니다. 이를 바탕으로 저자들은 데이터나 그래디언트 최적화 없이 모달리티별 요약 통계량만 사용하는 학습 프리(training-free) 방식인 PORTAL을 제안합니다. PORTAL은 최적 운송(optimal-transport) 기반의 맵을 통해 비전과 언어 특징 분포를 정렬합니다. 실험 결과, PORTAL은 대규모 데이터로 학습된 기존 파이프라인과 대등하거나 더 우수한 성능을 보였습니다.

AI 연구

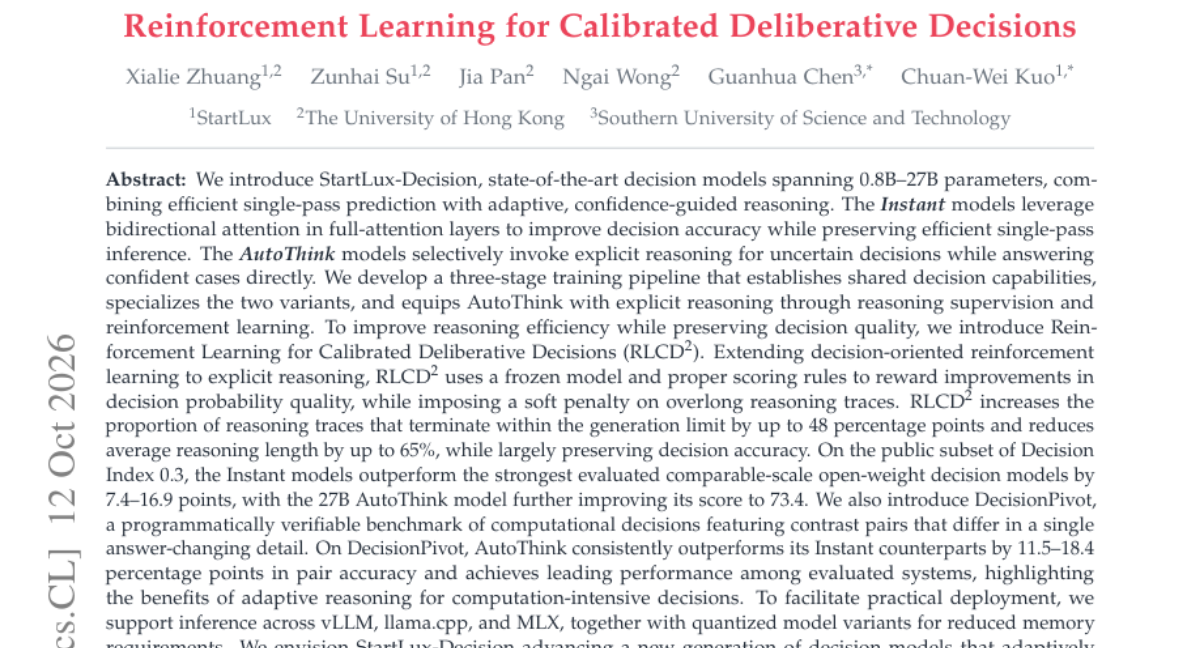
StartLux-Decision: AutoThink Decision Models with Reinforcement Learning for Calibrated Deliberative Decisions

기존 의사결정 모델은 추론 비용과 정확도 사이의 균형을 맞추는 데 어려움이 있었습니다. 본 논문은 단일 패스 예측(Instant)과 적응형 추론(AutoThink)을 결합한 StartLux-Decision 모델 시리즈를 제안합니다. RLCD^2라는 새로운 강화학습 프레임워크를 통해 모델이 불필요한 추론을 줄이면서도 정확한 의사결정을 내리도록 학습시켰습니다. 실험 결과, 제안된 모델은 기존 오픈 웨이트 모델 대비 높은 정확도를 기록했으며, 특히 복잡한 의사결정 벤치마크인 DecisionPivot에서 탁월한 성능을 보였습니다. 또한, 추론 길이를 획기적으로 단축하면서도 결정 정확도를 유지하는 데 성공했습니다.

AI 연구

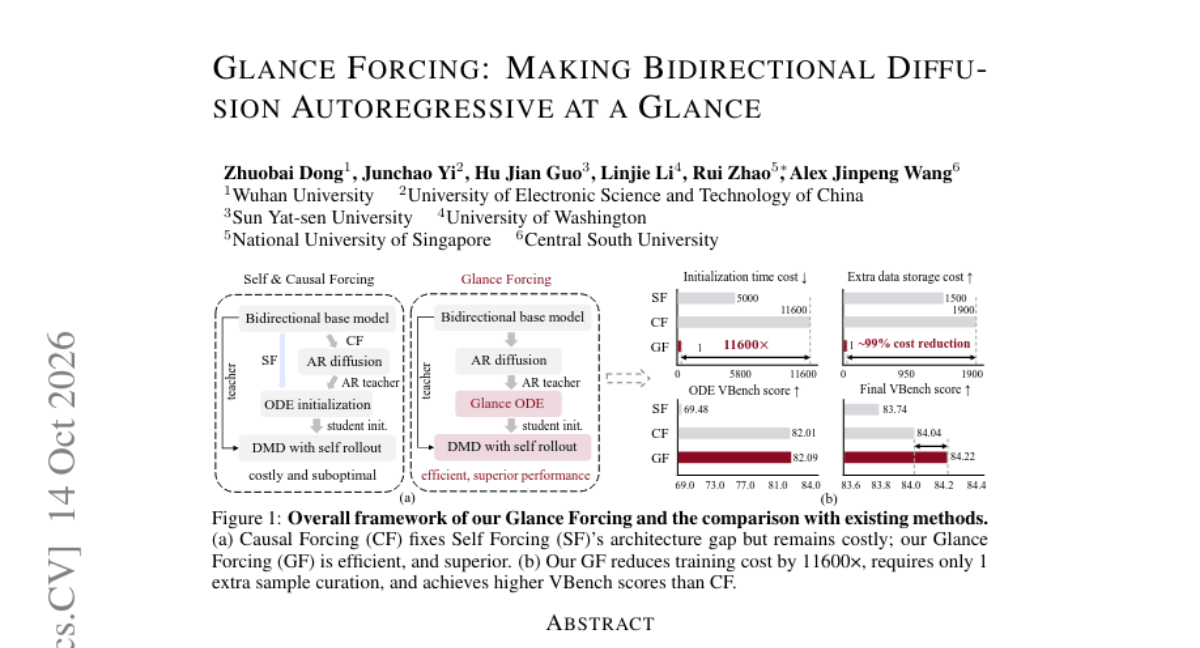
Glance Forcing: Making Bidirectional Diffusion Autoregressive at a Glance

현재의 비디오 생성 모델은 양방향 확산 모델을 인과적 소수 단계 모델로 증류하는 방식을 사용하지만, 이 과정에서 막대한 GPU 시간과 저장 공간이 소모되는 문제가 있습니다. 연구진은 단일 샘플로만 학습할 경우 발생하는 품질 저하 원인이 노이즈 수준에 따른 궤적 기하학(Trajectory Geometry)의 차이로 인한 표현 간섭임을 밝혀냈습니다. 이를 해결하기 위해 제안된 'Glance Forcing'은 사전 학습된 교사 모델을 고정한 채, 궤적을 두 개의 전문가(Slow/Fast experts)로 분리하여 최적화하는 경량 증류 프레임워크입니다. 실험 결과, 단 하나의 PF-ODE 궤적만 사용하고도 기존 SOTA를 능가하는 성능을 달성하며 비용을 획기적으로 절감했습니다. 특히 동적 움직임과 지시 이행 능력에서 뛰어난 성능 향상을 보였습니다.

AI 연구

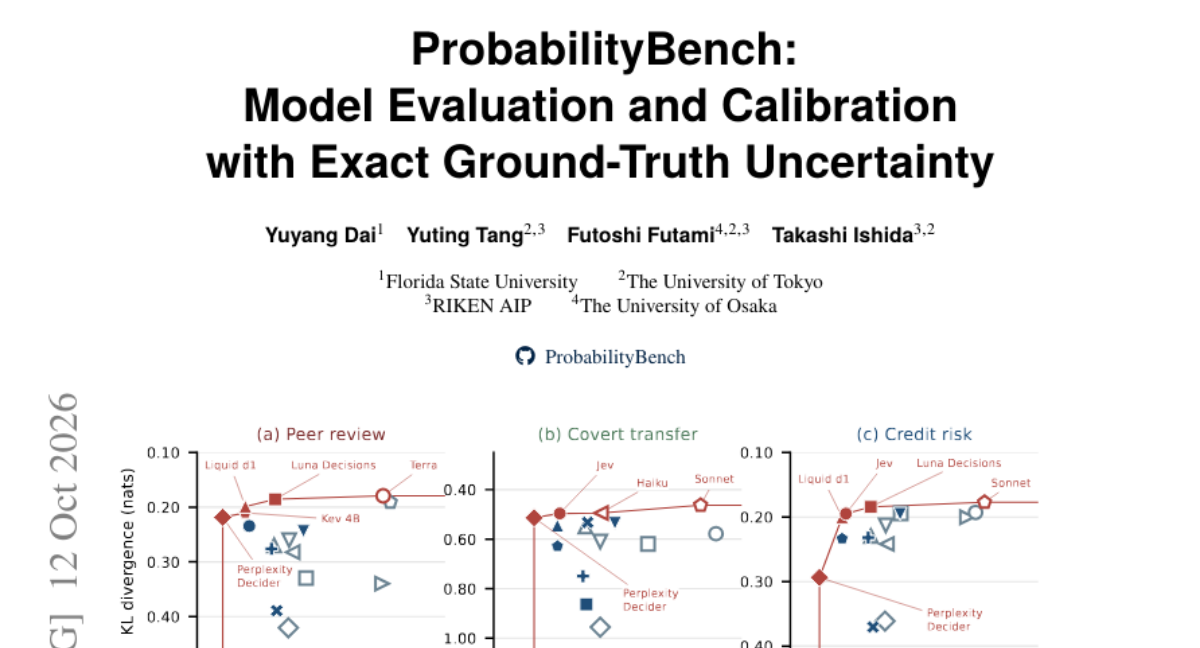
ProbabilityBench: Model Evaluation and Calibration with Exact Ground-Truth Uncertainty

실제 데이터에서는 단일 레이블만 존재하여 모델이 예측하는 조건부 확률의 진위 여부를 판단하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 연구진은 데이터 생성 과정을 명시적으로 정의하여 정확한 클래스 확률과 베이즈 오차(Bayes error)를 계산할 수 있는 ProbabilityBench를 도입했습니다. 이 벤치마크는 피어 리뷰, 은밀한 정보 전달, 신용 위험 등 세 가지 시뮬레이션 도메인을 통해 생성된 텍스트 기반 데이터를 활용합니다. 생성된 데이터는 자연어 메모 형태로 변환되어도 원래의 확률 구조가 유지됨을 이론적으로 보장합니다. 실험 결과, 16개 모델 중 대부분의 상위 모델들이 의사결정 모델(Decision models)로 나타났습니다. 최종적으로 이 프레임워크는 표준 캘리브레이션 지표와 베이즈 오차 추정기의 정확도를 검증하는 메타 평가 도구로도 활용됩니다.

AI 연구

BigCell: Generating Gigapixel Whole-Slide Images

기존의 병리 조직 생성 모델은 작은 패치 단위로만 작동하여 전체 슬라이드(WSI)의 맥락을 담지 못하는 한계가 있었습니다. 이를 해결하기 위해 연구진은 기가픽셀 해상도에서 일관된 이미지를 생성하는 BigCell을 제안합니다. BigCell은 병리 파운데이션 모델의 임베딩과 슬라이딩 윈도우 파이프라인을 결합하여 최대 32,768x32,768 해상도의 이미지를 생성합니다. 또한, 중요 영역을 우선시하는 적응형 스케줄링 전략을 도입하여 생성 속도를 3배 이상 높였습니다. 실험 결과, 합성 데이터를 활용함으로써 슬라이드 수준의 소량 데이터 학습(few-shot) 성능을 크게 향상시켰습니다.

AI 연구

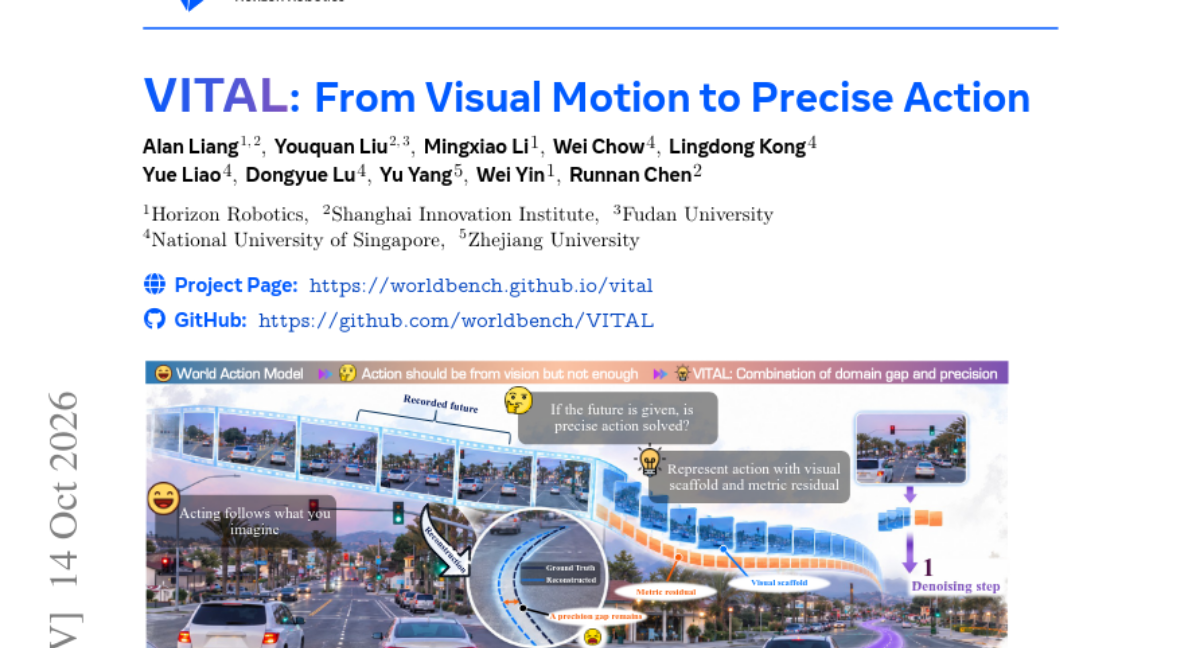
VITAL: From Visual Motion to Precise Action

기존의 월드-액션 모델은 시각적 역학을 고려하지 않은 독립적인 궤적 표현을 사용하여 정밀한 제어에 한계가 있었습니다. 본 논문은 시각적 움직임으로부터 직접 액션 타겟을 도출하는 방식을 제안합니다. 이를 위해 시각적 움직임을 담은 스캐폴드와 미세 오차를 보정하는 잔차 인코딩을 결합한 VITAL(Vision-Induced Tokens for Action Learning)을 도입했습니다. Flow matching을 통해 현재 이미지와 상태로부터 두 구성 요소를 동시에 예측하며, 추론 시 미래 이미지를 생성할 필요가 없습니다. 실험 결과, VITAL은 매우 빠른 추론 속도를 유지하면서도 높은 주행 성능(PDMS)을 달성했습니다.

AI 연구

TextVerifier: Seeing Beyond Recognition to Verify Chinese Text Rendering

최근 텍스트-이미지 생성 모델은 읽을 수 있는 텍스트를 생성하지만, 획이 누락되거나 변형된 미세한 렌더링 오류가 빈번히 발생합니다. 기존의 OCR이나 VLM은 인식(Recognition) 중심의 학습 방식으로 인해 이러한 구조적 결함을 식별하는 데 한계가 있습니다. 본 논문은 타겟 문자와 이미지 크롭을 비교하여 렌더링 정확도를 판단하는 'TextVerifier'를 제안합니다. 이 모델은 단일 문자 대신 IDS(Ideographic Description Sequence)를 입력으로 사용하여 구조적 특징을 학습하며, 대규모 데이터셋과 하드 네거티브 샘플링을 통해 훈련되었습니다. 실험 결과, TextVerifier는 기존 OCR 및 VLM보다 월등한 성능을 보였으며, RL(Flow-GRPO) 보상 모델로 활용 시 렌더링 오류를 효과적으로 감소시켰습니다.

AI 연구

Acting Through Registers

World Action Models(WAMs)는 시각적 표현을 통해 로봇 행동을 결정하지만, 표현 내 정보 조직 방식에 대한 이해는 부족한 상태입니다. 연구진은 WAM 표현에서 발생하는 고정규(high-norm) 공간적 이상치가 행동 결정에 지속적인 영향을 미친다는 점을 발견했습니다. 이를 해결하기 위해 학습 가능한 비공간적 레지스터를 도입한 RegisterWAM을 제안하며, 관측 Flow-matching(FM) 손실을 결합해 이상치를 억제하고 레지스터에 정보를 집중시킵니다. 또한 노이즈가 섞인 관측치를 통한 장면 복구 목적 함수를 추가하여 학습 효율을 높였습니다. 결과적으로 추가적인 사전 학습 데이터 없이도 LIBERO-Plus 및 RoboTwin 2.0 벤치마크에서 높은 성공률을 달성하며 실세계 조작 성능을 개선했습니다.

AI 연구

The COUNT: Counting N-grams Unlocks Scaling on Host Memory and Training-Free Adaptation

최근 언어 모델은 연산량뿐만 아니라 메모리 확장성도 중요한 과제로 떠오르고 있습니다. 기존의 N-gram 임베딩 방식은 학습 시 막대한 GPU 메모리를 소모하며 호스트 메모리를 충분히 활용하지 못하는 문제가 있었습니다. 이를 해결하기 위해 제안된 COUNT는 호스트 메모리에 사전 계산된 N-gram 빈도수를 저장하여 학습 파라미터 추가 없이 임베딩을 구축합니다. 이 방식은 코퍼스 빈도수를 활용해 현재 N-gram 이력에 따른 다음 토큰 예측을 가중 결합하는 방식입니다. 실험 결과, 동일한 연산 예산에서 1B 파라미터 모델의 검증 손실을 크게 개선했으며, GPU 메모리 제약 상황에서 백본 파라미터를 더 크게 유지할 수 있게 합니다. 또한 추론 시 도메인별 N-gram 테이블을 교체하는 것만으로 학습 없이 태스크 적응이 가능합니다.

30건

제품/서비스

이날 공개된 제품과 도구

제품/서비스

Talanoa

복잡한 이메일 스레드를 깔끔한 채팅 형식으로 변환해주는 개인정보 보호 중심의 이메일 메신저

제품/서비스

Navige

AI 에이전트의 비용을 최적화하고 예산 초과를 방지하는 지능형 비용 관리 솔루션

제품/서비스

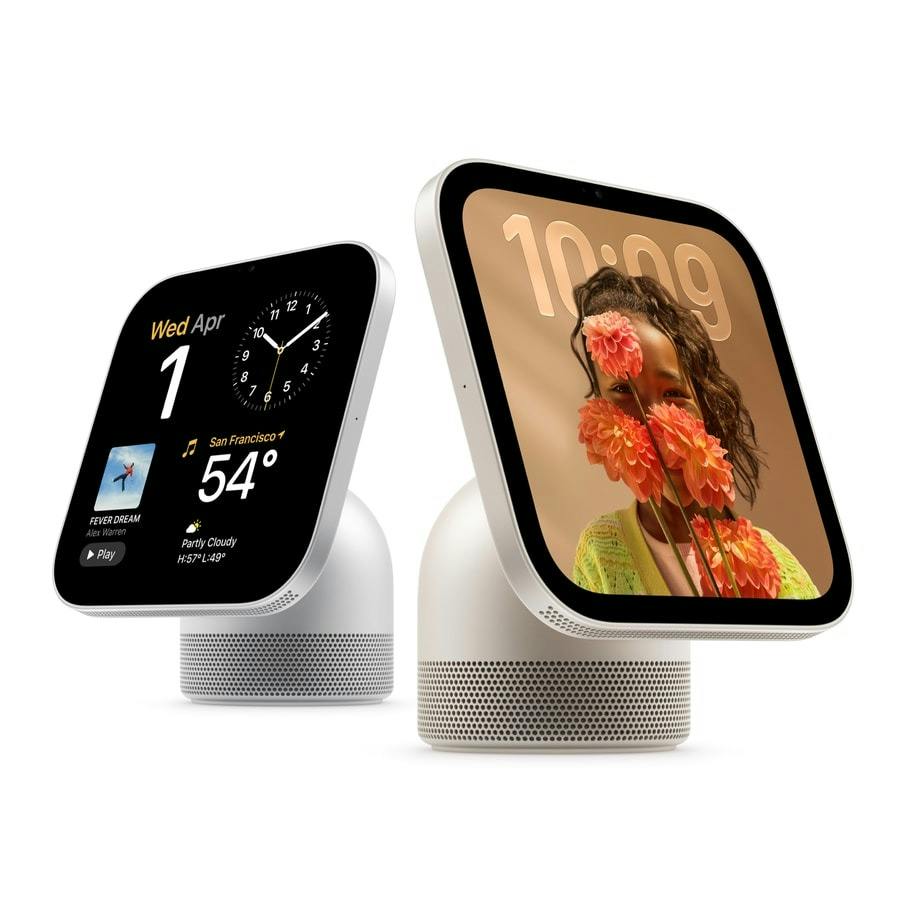
Apple HomeView

Siri AI와 고화질 디스플레이를 결합한 차세대 스마트 홈 컨트롤 디스플레이

제품/서비스

GLM-Legal

계약 검토 및 컴플라이언스 조사를 위해 특화된 Z.ai의 법률 전문 AI 모델

제품/서비스

OpenMuse

자체 브라우저와 터미널을 갖춘 오픈소스 개인용 AI 에이전트

나머지 25건 펼쳐보기

제품/서비스

Polylane Impact Analysis

실제 운영 인프라를 기준으로 PR의 위험성을 사전 검증하는 자동화 분석 도구

제품/서비스

Daddy Issues

AI 기반 주간 브리핑을 통해 가족 일정을 선제적으로 관리하는 아빠들을 위한 플래너

제품/서비스

withHuman

AI 에이전트의 위험한 작업을 사람이 직접 승인하거나 자동화할 수 있는 오픈소스 제어 레이어

제품/서비스

Chatway MCP

사용자의 AI 에이전트를 연결하여 고객 지원 업무를 자동화하는 MCP 기반 라이브 채팅 플랫폼

제품/서비스

siliXon

일상적인 영어 문장만으로 설계부터 제조 가능한 PCB까지 완성하는 AI 회로 설계 도구

제품/서비스

Kerno 1.0

코드베이스를 학습하여 백엔드 전반을 자동 테스트하는 AI QA 엔지니어

제품/서비스

Nostaliga

음악 감상 기록을 기반으로 과거의 소중한 순간들을 재구성하는 개인용 타임라인 서비스

제품/서비스

Backdrop

어떤 워크플로우에서도 업무를 수행하는 맞춤형 AI 동료를 구축하세요.

제품/서비스

Reelbird

계정 생성 없이 개인 저장소를 활용하는 오픈소스 Mac 전용 화면 녹화 도구

제품/서비스

AI Sandboxes by Buddy

AI 코딩 에이전트를 위한 안전하고 격리된 클라우드 개발 환경

제품/서비스

SuperLocalMemory

Claude, Cursor 등 AI 에이전트를 위한 로컬 우선 방식의 신뢰할 수 있는 통합 메모리 브레인

제품/서비스

Shrine

맥(Mac) 노치에서 에이전트 작업 현황을 한눈에 확인하고 성취감을 쌓는 대시보드

제품/서비스

Afterparty

회의록 작성을 넘어, 회의 후 발생하는 모든 후속 작업을 자동화하는 AI 에이전트

제품/서비스

Dreamscale Labs

고가의 GPU 구매 없이 클라우드에서 최첨단 로봇 AI 모델을 실시간으로 실행하는 플랫폼

제품/서비스

Dreamscale Labs

고가의 GPU 구매 없이 클라우드에서 최첨단 로봇 AI 모델을 실시간으로 실행하는 플랫폼

제품/서비스

Superdraft

비즈니스 운영 중 놓치기 쉬운 고객 이메일 타이밍을 포착하여 브랜드 맞춤형 초안을 자동 생성합니다.

제품/서비스

Fwrd

아이폰 문자를 슬랙, 디스코드, 텔레그램으로 자동 전달하는 자동화 도구

제품/서비스

Actually Asked

사이트 디자인에 녹아드는 자동 생성형 브랜드 FAQ 페이지

제품/서비스

CodeCrab

기존 개발 워크플로우를 유지하며 심층적인 AI 코드 리뷰를 수행하는 로컬 퍼스트 어시스턴트

제품/서비스

Basedash Connector gallery

데이터 소스 연결 전 미리 결과물을 확인하고 관리하는 통합 커넥터 갤러리

제품/서비스

NestJS Observe

NestJS 개발자를 위한 설정이 필요 없는 통합 옵저버빌리티 솔루션

제품/서비스

Audio Lip Sync Pro for Blender

오디오 파일을 활용해 블렌더에서 고품질 입 모양 애니메이션을 즉시 생성하는 도구

제품/서비스

Lleverage

AI 에이전트를 통해 제조 및 유통 기업의 백오피스 업무를 자동화하는 자율 운영 솔루션

제품/서비스

CmdRound

AI 에이전트를 활용한 엔지니어의 실무 역량을 검증하는 채용 평가 플랫폼

6건

모델/벤치마크

새 모델과 주요 평가 결과

HF Model Trending

openbmb/MiniCPM-V-4.7-35B-A3B

OpenBMB에서 공개한 MiniCPM-V-4.7-35B-A3B 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 35B 규모의 파라미터를 가진 image-text-to-text 태스크용 모델입니다.

HF Model Trending

ConwayResearch/Underdog-Saluki-27B-1.0

ConwayResearch에서 공개한 Underdog-Saluki-27B-1.0 모델이 Hugging Face에서 주목받고 있습니다. 약 27B 파라미터를 가진 이 모델은 텍스트 생성(text-generation) 태그를 사용하는 모델입니다.

HF Model Trending

jialinyyzz/humanizer

jialinyyzz/humanizer 모델이 Hugging Face에서 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 text-generation 파이프라인을 사용하는 텍스트 생성 모델입니다.

LiveCodeBench

LiveCodeBench top model: O4-Mini (High)

LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Pro-06-05

LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

나머지 1건 펼쳐보기

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Flash-04-17

LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.