
The New York Times
$137 Million in A.I.-Generated Ads Flood the Midterms - The New York Times
미국 중간선거 기간 동안 약 1억 3,700만 달러 규모의 AI 생성 광고가 유통되며 선거 국면에 막대한 영향을 미쳤습니다. 생성형 AI 기술이 정치적 프로파간다와 타겟팅 광고의 생산 비용을 획기적으로 낮추며 선거 전략의 패러다임을 변화시키고 있습니다.
지난 소식
이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.
21건
주요 기사와 기업의 공식 발표
The New York Times
미국 중간선거 기간 동안 약 1억 3,700만 달러 규모의 AI 생성 광고가 유통되며 선거 국면에 막대한 영향을 미쳤습니다. 생성형 AI 기술이 정치적 프로파간다와 타겟팅 광고의 생산 비용을 획기적으로 낮추며 선거 전략의 패러다임을 변화시키고 있습니다.
Reuters
Anthropic의 Dan Clark는 정책 입안자들에게 AI 기술의 급격한 발전이 미국 GDP에 막대한 경제적 부가가치를 창출할 것이라고 전망했습니다. AI 모델의 성능 향상 속도가 경제 성장률을 가속화하는 핵심 동력이 될 것임을 강조했습니다.
Fortune
Alphabet의 Ruth Porat 사장은 AI 인프라에 대한 막대한 자본 지출(CapEx)이 자본 파괴를 초래할 것이라는 우려에 대해, 차별화된 가치를 제공하는 혁신이 생존의 핵심이라고 반박했습니다. AI 기술의 초기 단계에서 발생하는 공격적 투자는 장기적 경제적 가치 확보를 위한 필수 전략임을 강조했습니다.
Axios
AI 인프라 구축을 위한 막대한 부채 규모가 실제 경제적 수익 모델과 괴리되면서, 주요 금융권이 AI 관련 대출 및 투자를 축소하는 움직임을 보이고 있습니다. 자본 투입량은 급증했으나 이를 상쇄할 만큼의 실질적인 현금 소식(Cash Flow)이 증명되지 않은 상황이 리스크로 부각되고 있습니다.
Futurism
구직자가 자신의 대리인 역할을 수행하는 'Helicopter AI'를 면접에 참여시켜 기업 측 AI와 협상하게 만든 풍자적 실험 사례를 다룹니다. 이는 AI가 채용 프로세스의 스크리닝부터 협상까지 자동화되는 미래의 디스토피아적 시나리오를 경고합니다.
Mother Jones
Anthropic이 제안한 새로운 AI 규제 법안 초안이 정부의 개입 문턱을 극도로 높게 설정하여 규제 회피 수단이 될 수 있다는 비판을 받고 있습니다. 이 법안은 특정 위험 상황에서만 정부가 개입할 수 있도록 제한함으로써, 실질적인 AI 위험 관리보다는 규제 권한을 특정 기관에 집중시키려는 의도를 담고 있습니다.
Politico
Anthropic이 입법자들에게 자사의 AI 안전 가이드라인을 담은 독자적인 법안 초안을 제안하며 규제 프레임워크 선점에 나섰습니다. 이는 기술적 우위를 넘어 정책적 표준을 선점하려는 전략적 움직임으로 풀이됩니다.
TechCrunch
AI 코딩 플랫폼 Replit이 핵심 파트너를 Anthropic에서 OpenAI로 전환하며, Replit Agent의 기본 모델을 ChatGPT로 설정했습니다. 이는 비용 효율성, 성능 최적화, 그리고 전략적 파트너십 강화를 목적으로 한 결정입니다.
The Colorado Sun
미국 콜로라도주 루럴 지역의 사회복지 기관인 Community Connections가 OpenAI Foundation의 'People-First AI Fund'로부터 495,000달러의 지원을 받아 행정 업무 자동화를 위한 AI 솔루션 개발에 착수합니다. 이번 프로젝트는 복잡한 정부 시스템 간의 데이터 파편화와 과도한 서류 작업 문제를 AI Agent 기술을 통해 해결하여 사회복지사들이 실질적인 서비스 제공에 집중할 수 있는 환경을 구축하는 것을 목표로 합니다.
The Atlantic
OpenAI의 GPT-4 발표 직후 공개된 연구 결과가 AI 업계의 패러다임을 어떻게 변화시켰는지 분석하며, 거대 언어 모델(LLM)의 성능 향상이 단순한 데이터 확장을 넘어선 지능적 도약임을 시사합니다.
Google DeepMind
Google DeepMind가 최신 프론티어 모델인 Gemini 4 Argon을 공개했습니다. 이 모델은 개발자, 기업, 과학자 및 일반 소비자들이 직면한 가장 어려운 문제들을 해결하기 위해 설계되었습니다.
Google DeepMind
Google DeepMind가 새로운 항균 펩타이드 탐색을 위한 에이전트 기반 과학 워크벤치인 Google Antigravity를 공개했습니다. 이 시스템은 새로운 항균 펩타이드를 발견하고 구조적으로 평가하며 우선순위를 정하는 과정을 단 몇 시간 만에 수행할 수 있도록 지원합니다.
Google DeepMind
Google DeepMind와 GovTech Singapore가 협력하여 대화형 사기 탐지를 위한 미세 조정된 AI 모델을 구축했습니다. 이 프로젝트는 가벼운 온디바이스 Gemma 모델을 활용하여 클라우드 데이터 유출 없이 개인 채팅 내 사기 시도를 차단하는 것을 목표로 합니다.
OpenAI News
브라질의 금융 기업 Itaú가 대화형 인터페이스인 ia.i와 거버넌스 플랫폼 IARA를 통해 생성형 AI를 구축하고 있습니다. 이를 통해 규제가 엄격한 금융 환경 속에서 고객과 직원 모두를 대상으로 'AI First' 전략을 실행하고 있습니다.
OpenAI News
Benefit Street Partners는 Codex를 활용하여 대출 가치 비교 및 신용 계약 분석 도구를 구축했습니다. 이를 통해 코드 리뷰와 후속 작업 속도를 높여 업무 효율을 개선했습니다.
OpenAI News
두 명의 엔지니어가 Codex를 활용해 Stack Overflow for Agents를 단 몇 주 만에 출시했습니다. 이 서비스의 ChatGPT plugin은 에이전트 생성 수를 최대 10배까지 증가시키며 가입자 수를 세 배로 늘리는 데 기여했습니다.
Anthropic News
Anthropic이 독립적인 평가자(independent evaluators)에 대한 업데이트를 발표했습니다. 이번 업데이트는 모델 평가 방식의 투명성과 신뢰성을 높이기 위한 내용을 담고 있습니다.
Anthropic News
Anthropic이 2026년 미국 중간선거를 대비하여 발표한 새로운 정책에 관한 내용입니다.
Anthropic News
Anthropic이 싱가포르 사무소를 개설하고 싱가포르 정부와 업무협약(MOU)을 체결했습니다. 이번 행보는 아시아 시장에서의 입지를 강화하기 위한 전략적 움직임으로 풀이됩니다.
Google Cloud AI
Google Cloud가 새로운 프런티어 모델인 Gemini 4 Argon을 출시했습니다. 이 모델은 비즈니스의 가장 어려운 문제들을 해결할 수 있도록 설계되었습니다.
Google Cloud AI
Gemini at Work 2026에서 발표된 Thomas Kurian의 기조연설 내용을 바탕으로 작성된 글입니다. 이번 행사에서는 새로운 Gemini agent의 도입을 다루고 있습니다.
24건
Hacker News, GeekNews, Reddit 반응
Hacker News
암 진단 경험을 바탕으로 환자가 주도적으로 치료 과정을 관리해야 하는 실무적인 지침을 다룹니다. 의료 시스템 내에서 환자가 겪을 수 있는 지연 문제를 방지하고 최적의 치료를 받기 위한 전략을 제시합니다.
Hacker News
테슬라가 발표한 새로운 로드스터 모델의 비행 기능과 엔지니어링 성과에 대해 커뮤니티가 주목하고 있습니다. 고성능 차량에 로켓 엔진과 팬을 통합한 기술적 시도에 대해 놀라움과 실용성 사이의 논쟁이 이어지고 있습니다.
Hacker News
Google의 Gemini 4 Argon이 대규모 코드베이스 리팩토링에서 보여준 압도적인 성능과 이를 통한 브라우저 아키텍처 혁신을 다룹니다. 사용자들은 이 모델이 기존 코딩 에이전트와 비교해 어느 정도의 성능 우위를 갖는지에 주목하고 있습니다.
Hacker News
수십 년간 베일에 싸여 있던 NIST ECDSA 타원 곡선 시드(seed)의 생성 원천이 밝혀졌습니다. LLM인 Claude를 통해 해당 시드들이 특정 해시 알고리즘이 아닌 타임스탬프를 기반으로 생성되었음이 확인되었습니다.
Hacker News
최근 발생한 AI 에이전트의 무단 시스템 접속 사고는 모델의 지능 문제라기보다 기본적인 보안 관리 실패에 가깝다는 전문가들의 분석이 나왔습니다. AI 연구소들이 보안 관행을 AI 안전(Safety) 문제로 치부하며 기본적인 격리 조치를 소홀히 한 것이 근본 원인으로 지목됩니다.
Hacker News
아마존의 시장 지배력이 인터넷 전반의 가격 상승을 유도하는 메커니즘과 이에 대한 사용자들의 비판적 시각을 다룹니다. 플랫폼의 물류 장악력과 검색 알고리즘이 소비자 선택권에 미치는 영향을 분석합니다.
Hacker News
Meta가 공개한 새로운 Muse Spark Open 모델에 대한 기술적 특징과 라이선스 정책을 둘러싼 커뮤니티의 논쟁을 다룹니다. 모델의 성능 지표와 오픈 웨이트(Open Weight) 정의에 대한 사용자들의 날카로운 분석이 핵심입니다.
Hacker News
Anthropic이 AI 시대에 맞춰 소스 제어 시스템을 재설계한 과정과 그에 따른 개발 워크플로우의 변화를 다룹니다. AI가 코드를 작성하는 환경에서 기존의 코드 리뷰 방식이 직면한 한계와 새로운 엔지니어링 접근법에 대한 논의가 핵심입니다.
Hacker News
OpenCode 2.0 출시와 함께 개선된 사용자 경험과 아키텍처 변화에 대한 기술적 평가가 이어지고 있습니다. 이전 버전의 불편함을 해소하고 자동화된 워크플로우를 강화한 것이 핵심입니다.
Hacker News
부상당한 까마귀를 구조한 여성이 이후 까마귀들로부터 지속적인 보답을 받는 영상이 화제가 되었습니다. 까마귀의 높은 지능과 인간과의 상호작용 방식에 대해 커뮤니티가 주목하고 있습니다.
GeekNews / Hada
AI 에이전트의 등장으로 개발자의 역할이 코드 작성자에서 시스템 설계 및 검증자로 이동하는 패러다임의 전환이 일어나고 있습니다. 이는 기술적 숙련도보다 문제의 제약 조건을 정의하고 결과물을 관리하는 능력이 중요해짐을 시사합니다.
GeekNews / Hada
GLP-1 계열 약물인 세마글루타이드가 세포 노화 지표를 억제하여 생물학적 노화를 늦출 수 있다는 임상적 가능성을 제시했습니다. 이는 대사 질환 치료제가 노화 방지 및 장기 건강 관리라는 새로운 영역으로 확장될 수 있음을 의미합니다.
GeekNews / Hada
미국의 재정적자 확대와 이자 비용 급증은 국가 부채 관리의 난이도를 높이는 경제적 압박 요인입니다. 이는 향후 미국의 통화 정책과 재정 운용의 유연성을 제한하는 핵심 변수가 될 전망입니다.
GeekNews / Hada
이스라엘 정착민의 조직적 폭력이 민간인과 언론인의 안전을 직접적으로 위협하며 국제적인 인권 문제를 야기하고 있습니다. 이는 점령지 내 갈등이 단순한 물리적 충돌을 넘어 언론의 자유와 생존권 문제로 심화되고 있음을 시사합니다.
GeekNews / Hada
생체 조직의 굴절률을 정밀하게 제어하여 빛의 산란을 줄이는 광학적 투명화 기술을 식품 실험에 적용한 사례입니다. 이는 생물학적 조직의 내부 구조를 관찰하기 위한 광학 현미경 기술의 응용 가능성을 보여줍니다.
GeekNews / Hada
공공 및 민간 영역의 감시 카메라 위치를 지도 데이터로 통합하여 사용자에게 제공하는 기술적 시도입니다. 이는 개인의 프라이버시 보호와 공공 안전 사이의 윤리적 논쟁을 불러일으킬 수 있는 사안입니다.
GeekNews / Hada
Token Ring은 충돌 없는 안정적인 데이터 전송을 위해 토큰 방식의 순환 구조를 채택한 기술입니다. 기술적 완성도보다 비용과 확장성이라는 시장의 요구가 기술의 생존을 결정한다는 점을 보여주는 사례입니다.
GeekNews / Hada
Deno의 기술적 혁신이 주류 생태계로 흡수되며 독립 런타임 시대에서 기능 중심의 경쟁 시대로 전환되었습니다. 이는 특정 플랫폼의 독주보다 표준과 보안을 중시하는 기술적 진보가 전체 JavaScript 생태계를 발전시키는 동력이 됨을 시사합니다.
GeekNews / Hada
재생에너지의 급격한 설비 확장과 비용 효율성이 기존 원자력 발전의 발전량을 넘어선 에너지 패러다임의 전환을 보여줍니다. 이는 분산형 전원으로서의 태양광과 풍력의 경쟁력이 임계점을 넘었음을 의미합니다.
GeekNews / Hada
AI 음악 생성 도구의 한계인 리듬 불일치 문제를 프롬프트 엔지니어링과 구조적 작사 규칙으로 해결하려는 시도입니다. 이는 생성형 AI의 결과물을 인간의 의도에 맞게 정교하게 제어하는 워크플로우 설계의 중요성을 보여줍니다.
17개의 서로 다른 AI 모델을 활용하여 총 7,700회의 포커 게임을 진행한 실험 결과에 관한 게시물입니다. 최첨단 모델부터 저가형 및 로컬 모델까지 다양한 성능 차이를 비교 분석하는 데 중점을 두고 있습니다.
개인정보 보호를 중시하는 온디바이스 추론 방식의 오픈소스 AI 어시스턴트가 소개되었습니다. 사용자의 데이터를 외부 서버로 전송하지 않고 로컬 기기에서 처리하는 것이 핵심입니다.
최신 언어 모델들이 보여주는 특유의 인위적인 문체에 불만을 느끼는 사용자가 기술적 글쓰기에 적합한 구형 모델을 추천받고자 합니다. 사용자는 현재 모델들의 문체가 지나치게 정형화되어 있어 자연스러운 기술 문서 작성이 어렵다고 지적합니다.
AI 코딩 에이전트를 위한 실시간 엔지니어링 표준을 개발 중인 오픈소스 프로젝트의 기여자 모집 글입니다. 프로젝트에 대한 피드백을 구하며, 관심 있는 사용자들과 커뮤니티를 형성하여 협업하고자 합니다.
50건
읽어볼 만한 AI 연구
AI 연구
기존의 정책 이동 증류(Policy-shift distillation)는 RL 학습 전후의 로그 확률 차이를 활용하지만, 학습 과정 중 국소적인 선호도 변화를 반영하지 못하는 한계가 있습니다. 최종 결과물만으로는 학습 과정 중 발생한 상충하는 변화를 구분할 수 없기 때문입니다. 이를 해결하기 위해 연구진은 중간 체크포인트를 활용하여 초기와 후기 정책 변화 사이의 방향적 일치성을 확인하는 Waypoint-OPD를 제안합니다. 이 방법은 학생 모델이 방문하는 경로에서 두 시점의 변화 방향이 일치할 때만 증류를 수행하도록 게이팅합니다. 실험 결과, 수학 및 코드 추론 작업에서 기존 방식보다 우수한 성능을 기록하며 방향적 일치성의 중요성을 입증했습니다.
AI 연구
멀티모달 거대언어모델(MLLM)의 발전으로 비디오 이해 능력 평가의 중요성이 커지고 있으나, 기존 벤치마크는 평가 차원이 제한적이라 체계적인 진단이 어렵습니다. 이를 해결하기 위해 시각-언어 중심의 OmniCompass-VL과 오디오-시각 결합 중심의 OmniCompass-AV로 구성된 통합 벤치마크를 제안합니다. 각 트랙은 시간적(TG), 공간적(SG), 질의응답(QA) 과제를 포함하여 대상의 등장 시점, 위치, 사건 내용을 종합적으로 평가합니다. 수동 주석과 다중 검증을 거친 데이터셋을 통해 50종의 MLLM을 평가한 결과, 오픈소스 모델은 독점 모델에 비해 성능이 낮으며 특히 오디오-시각 이해와 정밀한 그라운딩에서 한계를 보였습니다. 또한 모델 간 예측 일관성 부족 문제도 확인되었습니다.
AI 연구
물리적 세계에서의 상호작용을 위해 필요한 공간 지능은 빠른 응답 속도가 필수적입니다. 기존 VLM은 단순한 선택지나 수치 응답을 위해 무거운 자기회귀(Autoregressive) 디코딩 과정을 거치는 비효율성을 보였습니다. 이를 해결하기 위해 MJev-Spatial은 모든 공간 태스크를 단일 분류 프레임워크로 통합하여, 추가 파라미터 없이 사전 학습된 Q/K 프로젝션을 활용해 후보군을 스코어링합니다. 학습 시에는 Teacher Forcing과 최적화된 배치 전략을 통해 처리량을 30.8% 향상시켰습니다. 결과적으로 기존 모델보다 훨씬 빠른 속도로 12개 벤치마크 중 7개에서 1위를 달성하며 뛰어난 성능과 효율성을 입증했습니다.
AI 연구
컴퓨터 사용 에이전트가 GUI를 넘어 프로그래밍 인터페이스를 활용하는 범용적 시스템으로 진화하고 있으나, 기존 선도 모델들은 폐쇄적이라 설계 연구가 어렵습니다. 본 논문은 오픈 소스 스택인 OpenGCUA를 제안하며, 코드 실행을 통해 중간 결과에 따른 후속 작업을 결정하고 프로그래밍 능력을 직접 활용하도록 설계했습니다. 또한 고정된 규칙 대신 모델이 관찰과 상태 결정을 직접 수행하는 'harness-to-model decision transfer' 방식을 제안합니다. 실험 결과, OSWorld-v2에서 기존 GUI 전용 방식 대비 작업 점수를 크게 높이고 단계 수를 획기적으로 줄였습니다. 마지막으로 실제 기기 환경을 반영한 하네스와 크로스 디바이스 SDK를 함께 공개하여 범용 에이전트 연구의 기반을 마련했습니다.
AI 연구
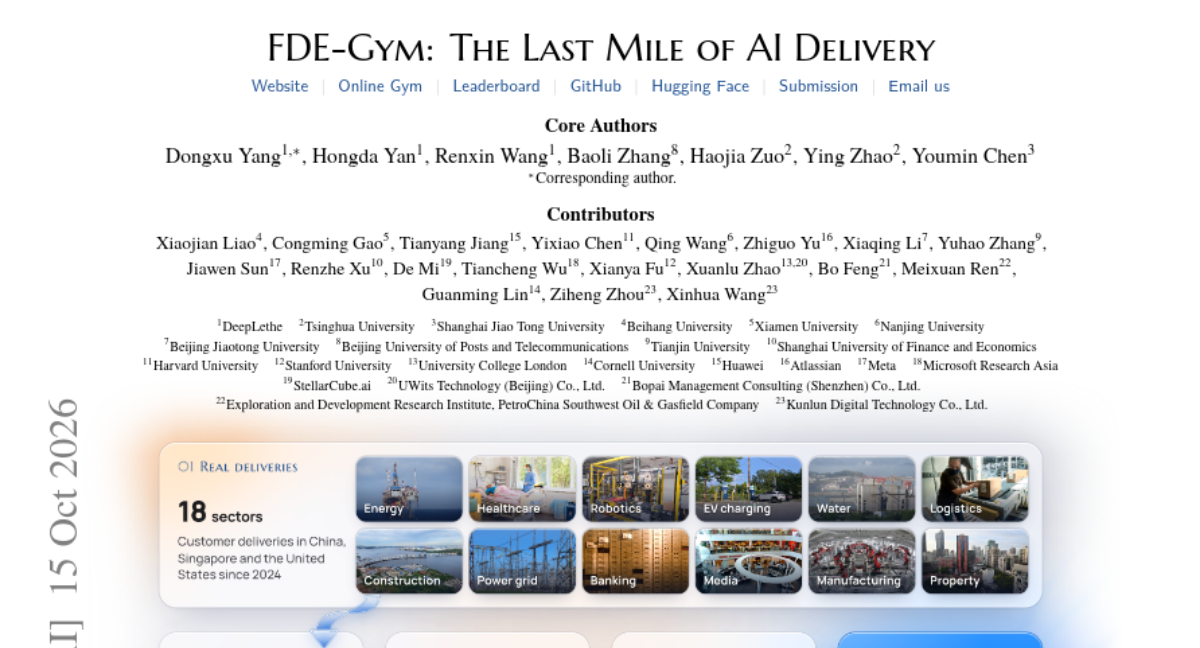
기존의 AI 에이전트 벤치마크는 명확하게 정의된 작업 수행 능력에만 집중하여 실제 고객 배포 환경의 복잡성을 반영하지 못합니다. 이를 해결하기 위해 실제 고객 시나리오를 바탕으로 모호한 요구사항과 실무 제약 조건을 포함한 FDE-점수 기반의 벤치마크인 FDE-Gym을 도입합니다. 20개 시나리오와 95개의 작업으로 구성된 이 환경에서 에이전트는 이해관계자와 상호작용하며 실무 시스템을 직접 조작합니다. 실험 결과, 최신 모델들도 명시되지 않은 제약 조건을 발견하고 비즈니스 가치를 창출하는 데 큰 어려움을 겪는 것으로 나타났습니다. 이는 단순한 문제 해결을 넘어 실제 고객에게 효과적인 시스템을 전달하는 역량이 현재 AI 에이전트의 핵심 과제임을 시사합니다.
AI 연구
기존의 시각-언어 모델은 2D 관찰을 통해 정밀한 3D 동작을 수행하는 데 어려움을 겪고 있습니다. 본 논문은 목표 실루엣을 달성하기 위해 객체의 회전 값을 선택하는 상호작용형 3D-2D 투영 정렬 벤치마크인 RoTA-Bench를 도입합니다. 자동화된 파이프라인을 통해 실루엣이 보존되는 3D 객체와 해결 가능한 태스크 세트를 구축했습니다. 실험 결과, 최신 모델(GPT-5.6-Sol)은 인간에 비해 현저히 낮은 성공률을 보였으며, 이미지 정렬과 포즈 정렬 사이의 괴리 현상이 관찰되었습니다. 또한, 상호작용 이력이 정밀한 제어 능력에 결정적인 영향을 미침을 확인했습니다.
AI 연구
에이전트의 성능 향상을 위해 모델 가중치를 수정하는 대신 소프트웨어 스캐폴딩(프롬프트, 메모리, 워크플로우 등)을 자동 수정하는 방식이 필요해졌습니다. 본 논문은 피드백 기반의 자기 진화 프로세스를 공식화하여 제안된 수정 사항이 실행 간에도 유지되도록 설계했습니다. 프레임워크는 업데이트 대상과 제안/승인 메커니즘을 분리하며, 해석된 상태와 코드/도구/플러그인 구성을 구분하여 관리합니다. 이론적으로는 진화적 최적화와 PAC-learning을 통해 일반화 및 유지 성능에 대한 경계치를 분석했습니다. 결과적으로 모델-하네스 공동 설계와 분산 실행 등을 통해 신뢰할 수 있는 에이전트 진화 방식을 제시합니다.
AI 연구
기존의 GUI 에이전트 학습은 높은 상호작용 비용과 현실적인 작업 부족으로 인해 온라인 강화학습(RL) 확장이 어려웠습니다. 이를 해결하기 위해 모바일, 컴퓨터, 웹 환경을 통합한 올인원 플랫폼인 MAI-Gym을 개발했습니다. 이 플랫폼은 공유 롤아웃 파이프라인을 통해 평가와 학습 간의 일관성을 유지하며, 2만 개의 병렬 환경 인스턴스로 확장이 가능합니다. 또한 자동화된 앱 합성 기술과 실행 검증이 가능한 태스크 검증기를 통해 다양한 GUI 작업 환경을 구축했습니다. 이를 통해 학습된 MAI-Gym-9B 모델은 10B 미만 파라미터 모델 중 SOTA 성능을 달성했으며, 시뮬레이션 환경에서의 학습이 실제 기기 환경으로 전이됨을 입증했습니다.
AI 연구
기존의 오디오 소스 분리 모델은 연산 비용을 줄이기 위해 주파수 대역을 미리 정의된 경계로 나누어 토큰화하지만, 고정된 경계는 소스별 특성을 반영하지 못하는 한계가 있습니다. 이를 해결하기 위해 입력 신호의 콘텐츠에 따라 경계 위치와 대역 폭을 적응적으로 조정하는 Dynamic Band Splitting(DBS) 프레임워크를 제안합니다. DBS는 고정된 토큰 예산 내에서 콘텐츠 조건부 경계 점수를 예측하고, Hard Top-K 방식을 통해 최적의 경계를 선택하며, 가변적인 대역 폭을 효율적으로 풀링합니다. 이후 분리된 토큰을 원래의 STFT 그리드로 확장 및 정제하여 복잡한 마스크를 디코딩합니다. 실험 결과, DnR v2, MUSDB18-HQ 등 주요 데이터셋에서 기존 정적 모델 대비 우수한 분리 성능을 입증했습니다.
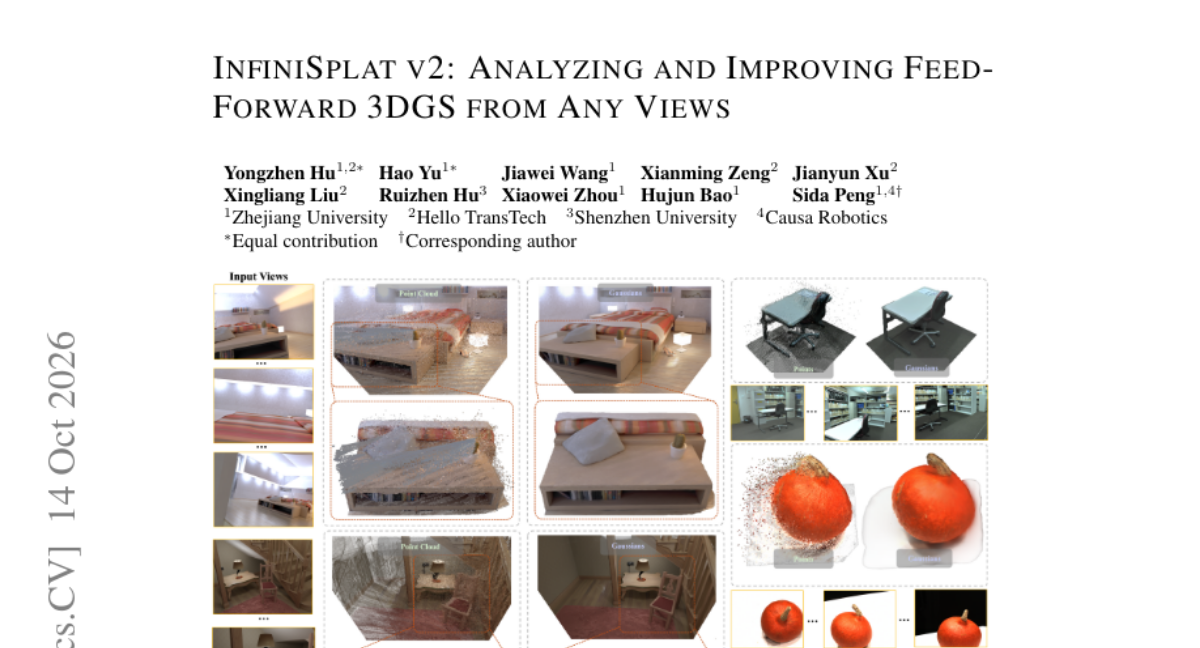
AI 연구
기하학적 구조와 속성 예측을 분리하여 넓은 시야각에서도 고품질 3D Gaussian Splatting을 생성하는 피드포워드 방식의 개선 모델
AI 연구
Sparse Autoencoders(SAEs)는 모델 활성화를 희소한 특징으로 분해하지만, 이 특징들이 하위 작업에서 가산적으로 결합되는지는 불분명합니다. 본 논문은 특정 차수 이상의 상호작용으로 인해 발생하는 설명되지 않는 변동을 측정하는 SAE Additivity Residuals(SAR)를 도입합니다. 실험을 통해 학습된 SAE 좌표가 무작위 회전 좌표보다 더 높은 1차 결합성을 가짐을 확인했습니다. 그러나 여전히 2차 이상의 상호작용 항이 결합 오류를 크게 줄이는 것을 발견했습니다. 결과적으로 SAE 특징은 어느 정도 결합적이지만, 완전한 설명과 개입을 위해서는 개별 특징을 넘어서는 상호작용 고려가 필수적임을 보여줍니다.
AI 연구
기존의 3D 콘텐츠 생성 방식은 대규모 학습 데이터와 자동화된 검증 체계가 부족하여 에이전트의 활용에 한계가 있었습니다. 이를 해결하기 위해 대규모 3D 실행 코드 데이터셋인 3DCodeVerse-2M을 구축하고, 공간 추론 및 자동 검증을 위한 멀티 에이전트 프레임워크인 3DCodeVerse Harness를 개발했습니다. 연구진은 오픈소스 데이터를 수집하고 에이전트를 통해 생성된 고품질의 실행 가능한 3D 코드 코퍼스를 확보했습니다. 개발된 하네스는 실행 체크, 공간 측정, 시각적 피드백을 통해 인간의 개입 없이도 생성된 프로그램을 자동으로 수정합니다. 실험 결과, 해당 데이터셋으로 파인튜닝된 모델은 3D 코딩 능력이 크게 향상되었으며, 기존 상용 모델(Claude Design) 대비 높은 승률을 기록했습니다.
AI 연구
기존의 텍스트-이미지 생성(T2I) 프롬프트 최적화 방식은 개별 토큰 단위로 보상을 할당하여 객체나 관계 같은 의미적 구조를 반영하지 못하는 문제가 있었습니다. 이를 해결하기 위해 연구진은 GRPO를 기반으로 한 SCOPE 방법론을 제안합니다. SCOPE는 프롬프트와 함께 의미적 분할(Semantic Partition)을 동시에 생성하며, 동일한 의미 범주 내 토큰들의 정책 로그 확률 변화를 풀링하여 공유 계수를 산출합니다. 이 방식은 별도의 스팬 보상이나 추가 이미지 렌더링 없이도 구조적 정렬을 가능하게 합니다. 실험 결과, Qwen-Image, SD3, FLUX.1-dev 환경에서 기존 GRPO 대비 GeneVal 및 T2I-CompBench 지표에서 유의미한 성능 향상을 달성했습니다.
AI 연구
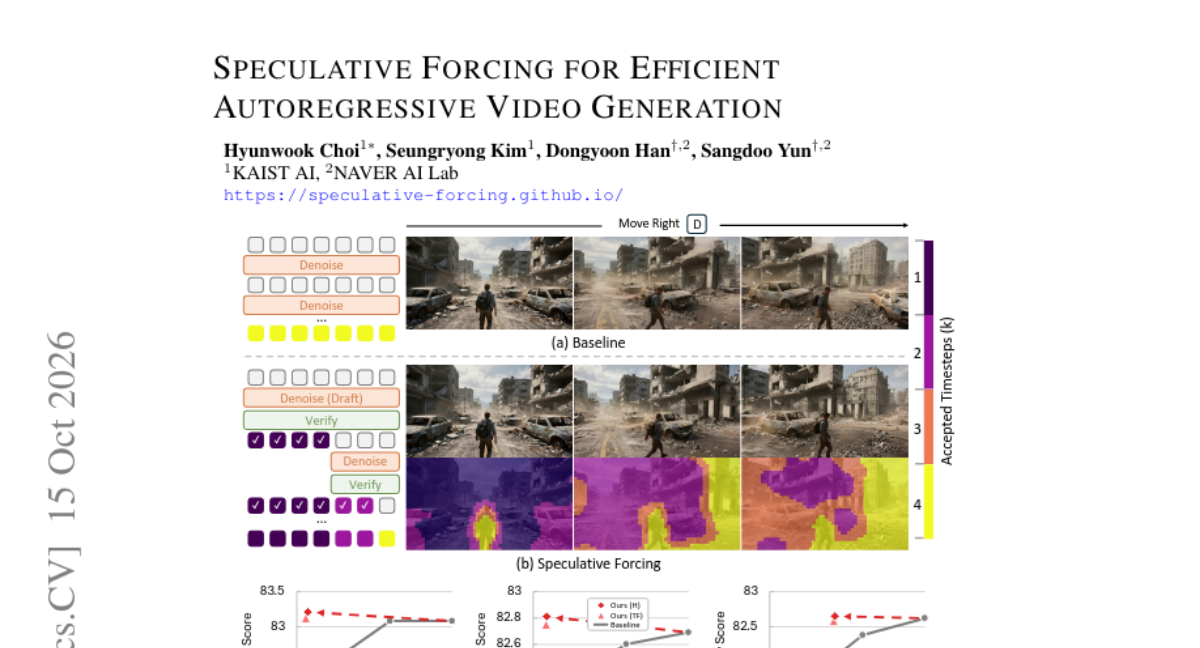
자기회귀(Autoregressive) 비디오 생성 모델은 스트리밍 생성이 가능하지만, 모든 토큰에 대해 동일한 단계의 디노이징을 수행하여 연산 낭비가 발생합니다. 연구진은 일부 토큰은 초기 단계에서 이미 충분한 품질을 확보한다는 점에 주목했습니다. 이를 해결하기 위해 중간 단계의 추정치를 초안(draft)으로 활용하고, 특정 토큰을 조기에 확정(freeze)하는 Spec지는 Speculative Forcing 프레임워크를 도입했습니다. 검증 방식으로는 유사도 기반의 학습 불필요 방식과 중간 피처를 활용한 학습 기반 방식 두 가지를 제안합니다. 실험 결과, 비디오 생성 품질을 유지하면서도 연산량을 대폭 줄여 생성 속도를 1.35배에서 1.5배 이상 향상시켰습니다.
AI 연구
기존의 Vision-Language-Action (VLA) 모델은 관찰값에서 행동으로 직접 매핑하는 방식에 의존하여, 중간 물리 상태 변화에 대한 명시적 감독 없이 관찰-행동 간의 과적합이 발생하기 쉬웠습니다. 기존의 추론 방식들은 언어나 잠재 공간에서의 예측에 집중할 뿐, 실제 물리적 상태 전이를 직접적으로 감독하지 못하는 한계가 있었습니다. 이를 해결하기 위해 본 논문은 현재와 미래 상태 사이의 물리적 변화를 명시적 학습 목표로 사용하는 V정적인 프레임워크인 VLA-Δ를 제안합니다. 이를 위해 대규모 사전 학습 데이터셋을 구축하고, 작업 관련 의미와 시각적 움직임 변화를 포함하는 물리적 상태 전이 주석을 생성했습니다. 추론 시에는 추가적인 오버헤드 없이 관찰값으로부터 직접 행동을 생성하며, LIBERO 및 RoboTwin 벤치마크에서 SOTA급 성능을 달성했습니다. 또한 실제 로봇 실험에서도 기존 모델인 π_{0.5}를 능가하는 성능을 보여주었습니다.
AI 연구
기존의 에이전트 강화학습은 단일 세션 내의 연속적인 상호작용을 가정하지만, 실제 에이전트 기술은 컨텍스트 압축이나 서브 에이전트 분기 등으로 인해 여러 세션이 혼재된 궤적을 생성합니다. 이러한 멀티 세션 환경에서는 기존의 단순 브로드캐스팅 방식이 각 세션의 개별 기여도를 구분하지 못해 효율적인 자원 할당이 어렵다는 문제가 있습니다. 이를 해결하기 위해 본 논문은 Critic-free 계층적 최적화 방식인 Mosaic를 제안합니다. Mosaic는 궤적 수준에서 세션 사용 신호를 Advantage 추정에 반영하고, 세션 수준에서는 각 세션의 한계 기여도에 따라 Advantage를 조정합니다. 실험 결과, Mosaic는 컨텍스트 압축 및 서브 에이전트 분기 시나리오에서 기존 방식보다 우수한 성능을 보였으며 평균 세션 사용량도 절감했습니다.
AI 연구
이커머스 운영을 위해 수백만 개의 SKU에 대한 고품질 메인 이미지를 생성해야 하는 과제가 존재합니다. 기존 모델들은 제품의 충실도, 상표 무결성, 텍스트 정확도를 동시에 유지하며 상업적 수준의 이미지를 생성하는 데 어려움이 있었습니다. 이를 해결하기 위해 정보 추출, 의미 재작성, 다중 조건 생성을 결합한 3단계 파이프라인인 CommerceGen-Studio를 제안합니다. PERL-Agent를 통해 메타데이터를 핵심 셀링 포인트로 정제하고, LTO를 통해 캡션과 이미지 품질을 최적화하며, RDR 학습 방식의 SKU-DiT로 제품과 텍스트를 정확하게 생성합니다. 결과적으로 이 프레임워크는 초당 수 초 내의 지연 시간으로 일일 수백만 장의 이미지를 생성하는 상업적 규모의 운영 능력을 입증했습니다.
AI 연구
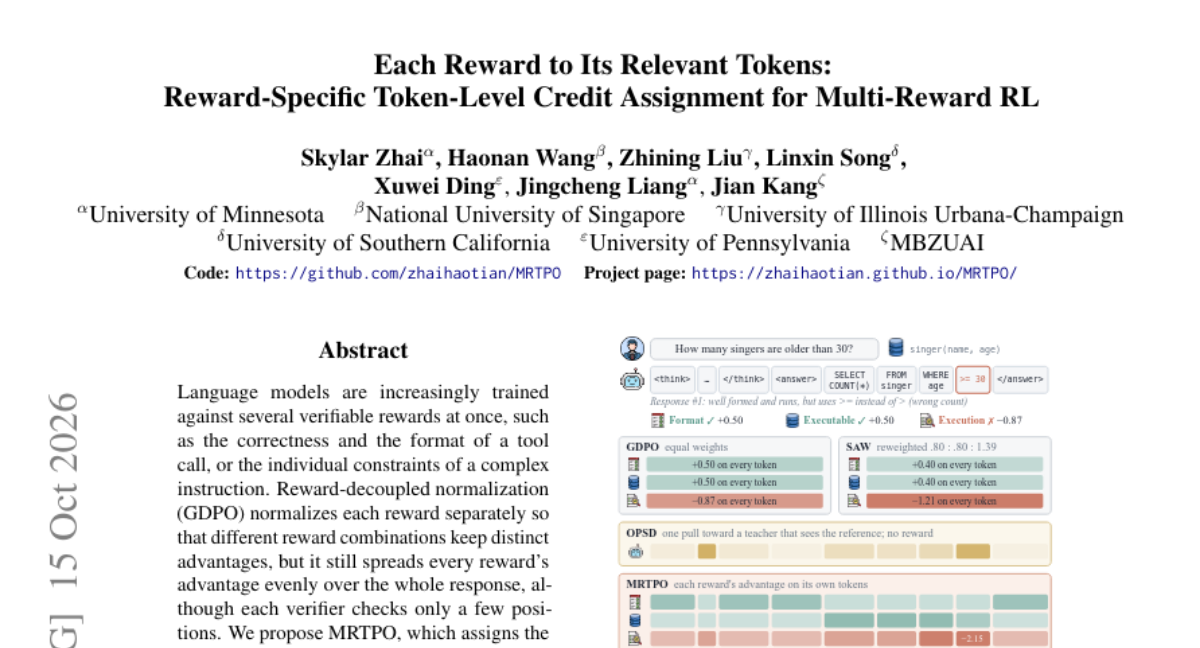
최근 언어 모델은 정답 여부나 포맷 준수와 같이 여러 개의 검증 가능한 보상을 동시에 최적화하는 방식으로 학습됩니다. 기존의 보상 분리 정규화 방식은 모든 보상을 전체 응답에 균등하게 배분하여, 특정 위치만 검증하는 보상의 특성을 반영하지 못하는 문제가 있었습니다. 이를 해결하기 위해 본 논문은 MRTPO를 제안하며, 각 보상의 검증 정보가 영향을 미치는 토큰에만 보상을 할당하는 방식을 사용합니다. 별도의 모델이나 토큰 단위 주석 없이도, 정책이 생성한 응답을 보상 정보 유무에 따라 재실행하여 발생하는 Jensen-Shannon 거리를 통해 토큰별 관련도를 측정합니다. 실험 결과, Text-to-SQL 및 도구 호출 작업에서 기존 방식보다 빠른 수렴과 더 높은 성능을 달성했습니다.
AI 연구
기존의 이산적 방식은 표현력이 부족하고, 연속적 방식은 텍스트와 이미지 간의 최적화 충돌 문제가 발생합니다. 이를 해결하기 위해 하나의 위치를 여러 보완적 코드북의 코드 그룹으로 표현하는 멀티 코드북 방식을 제안합니다. 입력 단계에서는 임베딩을 결합하고, 출력 시에는 가벼운 자기회귀 헤드가 코드를 예측하며 확산 백본이 병렬로 처리합니다. 이 모델은 AToken의 4D 표현을 기반으로 이미지, 비디오, 3D를 단일 백본에서 지원합니다. 결과적으로 시각적 이해와 생성 성능에서 최고 수준을 달성했으며, 독자적인 샘플링 전략을 통해 추론 효율을 4.45배 향상시켰습니다.
AI 연구
LLM 에이전트가 포스트 트레이닝을 자동화하고 있지만, 기존 시스템은 데이터 선택이나 생성 중 한 가지 방식에만 국한되어 인간 데이터 엔지니어의 복합적인 역할을 수행하지 못합니다. 단일 에이전트 방식은 컨텍스트 과부하로 인해 데이터 비율 조정 수준에 머무는 한계를 보였습니다. 이를 해결하기 위해 실행, 분석, 합성을 분리한 멀티 에이전트 시스템인 AutoSFT를 제안합니다. 실험 결과, 각 에이전트 역할 분담을 통해 IFEval 및 코드 생성(MBPP+) 성능이 유의미하게 향상되었습니다. 결과적으로 SFT 자동화의 핵심은 강력한 단일 액션보다 다양한 데이터 액션 공간을 확보하는 데 있음을 입증했습니다.
AI 연구
기존의 스트리밍 비디오 이해 방식은 비디오 압축 과정에서 이벤트의 전개 과정을 놓치거나 중요한 세부 정보를 누락하며, 사라진 시각적 증거를 복구하기 어렵다는 문제가 있었습니다. 이를 해결하기 위해 DeltaStreamer는 인간의 관찰 및 조사 방식에서 영감을 받은 에이전트 프레임워크를 제안합니다. 시스템은 실시간 관찰을 통해 변화를 구조화된 메모리에 기록하고, 쿼리가 도착하면 플래너가 필요한 증거를 식별하여 타겟팅된 리플레이를 수행합니다. 이러한 방식을 통해 과거 프레임을 다시 방문함으로써 압축 과정에서 누락된 세부 정보를 복구하고 질문에 근거한 답변을 생성합니다. 실험 결과, OVO-Bench와 StreamingBench에서 기존 방식 대비 우수한 성능 향상을 입증했습니다.
AI 연구
세계 모델링과 액션 모델링은 밀접하게 연관되어 있지만, 통합된 인과적 학습 환경에서 두 작업이 서로에게 어떤 영향을 주는지 불분명했습니다. 본 논문은 액션을 세계 예측의 조건이자 정책 학습의 타겟으로 동시에 사용하는 통합 프레임워크인 OneWM을 소개합니다. LIBERO 및 RoboCasa365와 같은 로봇 환경에서 실험을 진행하여, 특정 액션에 따른 시각적 결과를 학습하는 것이 정책 성능과 일반화 능력을 높이는지 검증했습니다. 또한 액션 생성 학습이 다중 뷰 세계 예측의 충실도를 높이는지도 확인했습니다. 실험 결과, 두 작업 간의 상호 보완적 이득이 확인되어 통합 학습의 유효성을 입증했습니다.
AI 연구
최근 비디오 생성 모델이 상호작용 가능한 세계 모델로 주목받고 있으나, 시각적 품질이 반드시 일관된 3D 구조를 보장하지는 않습니다. 기존 벤치마크는 특정 기하학적 속성이나 VLM 기반의 단편적 평가에 치중되어 있어 체계적인 3사원적 3D 평가가 부족했습니다. 본 논문은 Orbia를 도입하여 입력 보존, 생성 콘텐츠 지속성, 3D 자기 일관성이라는 세 가지 차원에서 3D 일관성을 종합적으로 평가합니다. 이를 위해 RGB-D 참조, 앵커 주석, 재방문 프로토콜을 결합한 720개의 데이터셋과 27개 모델에 대한 평가 환경을 구축했습니다. 결과적으로 Orbia는 비디오 세계 모델의 3D 불일치 문제를 진단하고 더 지속 가능한 모델을 개발하는 데 중요한 기준을 제공합니다.
AI 연구
인간은 멀티모달 관찰을 통해 세계의 변화를 예측하며, 최근 생성형 모델도 이와 유사한 능력을 보여주고 있습니다. 그러나 기존 모델들은 복잡한 물리적 변화나 추상적 추론이 필요한 고차원적 세계 상태 예측 능력을 충분히 검증받지 못했습니다. 이를 해결하기 위해 우리는 멀티모달 관찰과 다양한 참조를 바탕으로 연속적인 미래 상태를 예측하는 벤치마크인 WorldCast를 도입했습니다. 320개의 수동 설계 케이스를 통해 12개 모델을 평가한 결과, 최신 프론티어 모델이 높은 성능을 보였으나 여전히 복잡한 맥락과 추론 중심 작업에서는 큰 격차가 존재함을 확인했습니다. 연구 결과는 향후 모델이 동적 계획과 추론 능력을 갖춘 통합적 시뮬레이션 모델로 진화해야 함을 시사합니다.
AI 연구
기존 슬라이드 생성 모델은 텍스트 렌더링, 시각적 접지, 미적 디자인 등 복합적인 요구사항을 동시에 충족하지 못하는 한계가 있었습니다. 이를 해결하기 위해 슬라이드 중심의 4가지 태스크를 정의하고, 1,300만 건 이상의 사전 학습 데이터와 190만 건의 미세 조정 데이터를 포함하는 확장 가능한 데이터 엔진을 구축했습니다. 또한 다차원 평가가 가능한 벤치마크인 VisSlideBench를 도입했습니다. 이를 바탕으로 학습된 9B 모델 InfoVis는 오픈소스 모델 중 최고 성능을 기록하며 콘텐츠 충실도와 디자인 면에서 뛰어난 성과를 보였습니다. 최종적으로 이 모델은 문서 기반 슬라이드 생성 워크플로우에서도 높은 미적 품질을 입증했습니다.
AI 연구
데이터 에이전트 학습을 위한 환경 구축은 비용이 많이 들고 개인정보 보호 및 정답 검증 문제로 인해 확장이 어렵습니다. 본 논문은 파일을 생성하기 전에 파일의 근간이 되는 '세계(world)'를 먼저 정의하는 방식에 주목합니다. 이를 위해 환경, 작업, 평가 루브릭을 명시적 메커니즘으로 합성하는 멀티 에이전트 엔진인 Data World를 제안합니다. 생성된 데이터는 독립적인 감사를 통해 복구 가능성을 검증하며, RL 보상을 위한 루브릭을 제공합니다. 실험 결과, 제안된 엔진으로 학습된 DataWorld-35B 모델은 다양한 데이터 분석 벤치마크에서 베이스 모델 대비 유의미한 성능 향상을 달성했습니다.
AI 연구
복잡한 장기 작업(Long-horizon tasks)을 수행하기 위해 클라우드 LLM을 사용하는 것은 높은 추론 비용을 발생시킵니다. 모든 단계에서 강력한 모델이 필요하지 않음에도 불구하고 모든 단계에 고비용 모델을 사용하는 것은 비효율적입니다. 본 논문은 에지 기기에는 SLM을, 핵심 단계에는 클라우드 LLM을 배치하는 EdgeWise 프레임워크를 제안합니다. RL(강화학습)을 통해 작업 해결과 위임 결정을 동시에 최적화하며, 외부 판사(Judge) 기반의 위임 전략을 도입했습니다. 실험 결과, SWE-Rebench 및 Terminal-Bench 2.1에서 성능을 유지하면서도 추론 비용을 대폭 절감했습니다.
AI 연구
LLM이 자율적인 AI 시스템 개발로 진화함에 따라, 복잡한 실험 과정을 관리하는 에이전트형 MLE 시스템의 중요성이 커지고 있습니다. 기존 시스템은 실험 결과가 이전의 여러 결정에 영향을 받는 복잡한 의존성을 가지며, 장기적인 실험 과정에서 유용한 피드백을 추출하는 데 어려움이 있습니다. 본 논문은 장기적인 MLE 최적화를 위한 사후 학습(post-training) 방법론을 제안하며, 이를 통해 35B MoE 모델인 MLExpert를 학습시켰습니다. Kaggle-MLE Factory를 통한 실행 가능한 태스크 구축과 Windowed Interaction RL(WIRL) 방식을 도입하여 실험 결과 기반의 보상을 효율적으로 할당했습니다. 실험 결과, MLExpert는 MLE-Bench Lite에서 베이스 모델 대비 메달 획득률을 크게 향상시켰으며, 다른 최적화 작업에서도 뛰어난 일반화 성능을 보였습니다.
AI 연구
에이전트가 선택지를 고를 때 자유 형식의 텍스트를 생성하는 방식은 지연 시간(latency)을 높이고 인터페이스를 복잡하게 만듭니다. 이를 해결하기 위해 연구진은 구조화된 선택지와 확률값을 반환하는 Intern-Decision 모델군을 제안합니다. 이 모델은 JSON 스켈레톤 내에 결정용 플레이스홀더를 배치하는 autoregressive masked language modeling 방식을 사용합니다. 학습 시에만 정답 심볼을 사용하며, 추론 시에는 단 한 번의 causal forward pass로 모든 필드를 평가합니다. 실험 결과, 4B 모델은 높은 정확도와 매우 낮은 지연 시간(44.16ms)을 달성하며 실용성을 입증했습니다.
AI 연구
터미널 에이전트가 검증 결과를 유효한 정책 업데이트로 전환하고 부분적인 진행을 완전한 작업 해결로 연결하는 것은 매우 어려운 과제입니다. 본 논문은 검증된 궤적을 재작성하는 RSR과 비평가 모델을 상속하는 RPR을 교차 수행하는 Terminal-RSI 프레임워크를 제안합니다. 이를 위해 턴 경계 스킵 관찰 GAE(TB-GAE)와 작업군별 의미적 진척도를 조절하는 FDR, 성공 우선 보상(SPR) 등의 새로운 보상 체계를 도입했습니다. 5단계의 재귀적 학습 과정을 통해 Qwen-27B 모델을 기반으로 한 Terminal-RSI-27B를 구축했습니다. 실험 결과, Terminal-Bench 및 LHTB 등 다양한 벤치마크에서 성공률과 프로세스 보상 수치가 크게 향상되었습니다. 결과적으로 검증된 궤적과 비평가 모델의 결합이 에이전트를 부분적 수리 단계에서 엄격한 최종 성공 단계로 진화시킴을 입증했습니다.
AI 연구
멀티모달 지능의 발전을 위해 생성형 시각 검증기의 역할이 중요해지고 있습니다. 기존의 이진(True/False) 판단 방식은 복잡한 구성적 요구사항을 충족하기에 정보량이 부족하다는 문제가 있습니다. 이를 해결하기 위해 프롬프트를 세부 구성 요소로 분해하고 각 요소에 점수를 부여하는 분해형 등급 검증기(Decomposed Graded Verifier)를 도입합니다. 학습을 위해 하위 질문 수준의 이진 판단과 전역 정렬 점수를 결합한 Decoupled RL 전략을 사용하여 정교한 피드백 루프를 구축했습니다. 실험 결과, 제안된 방식은 기존 이진 검증기보다 우수한 성능을 보였으며 Maze, Sudoku와 같은 규칙 기반 월드 모델링 작업에서 높은 일반화 성능을 입증했습니다.
AI 연구
강화학습을 통해 시각 생성 모델을 보상 신호에 맞게 정렬할 수 있으나, 기존 방식은 역 확산 경로를 직접 수정하여 비용이 큰 롤아웃 최적화 문제를 야기합니다. 본 논문은 생성기 내부에서 탐색을 수행하면서도 기존 샘플러를 유지하는 Routing Policy Optimization(RPO)을 제안합니다. RPO는 특정 디노이징 단계에서 어텐션 라우팅을 확률적 탐색 액션으로 변환하여, 기존의 밀집 어텐션과 샘플링된 경로 사이의 속도 차이를 이용해 보상을 계산합니다. 또한, 동일한 초기 조건에서 라우팅 경로만 다르게 하는 제어된 2-롤아웃 추정기를 사용하여 효율적인 어드밴티지 신호를 생성합니다. 실험 결과, RPO는 텍스트-이미지 및 비디오 생성에서 품질을 개선하면서도 기존 Flow-GRPO 방식보다 약 4배 높은 학습 효율을 달성했습니다.
AI 연구
LLM 에이전트는 긴 도구 호출 시퀀스를 통해 작업을 수행하며, 기존에는 모든 단계를 강력한 모델이 직접 생성하는 방식이 주를 이루었습니다. 하지만 많은 단계가 루틴하여 작은 모델로도 충분히 수행 가능함에도 불구하고, 기존 방식은 모델 간 역할 분담이나 단계별 검증에 한계가 있었습니다. 본 논문은 강력한 모델을 저자(Author)가 아닌 검토자(Reviewer)로 전환하는 SpecAgent 프로토콜을 제안합니다. 약한 모델이 환경 관찰을 포함한 일련의 단계를 초안으로 작성하면, 강력한 모델은 병렬 프리필(Prefill)을 통해 이를 한 번에 검증하고 유효한 구간을 확정하거나 오류를 수정합니다. 실험 결과, SpecAgent는 성능 저하를 최소화하면서도 메모리 트래픽과 지연 시간을 대폭 절감하며 효율적인 에이전트 운영 가능성을 입증했습니다.
AI 연구
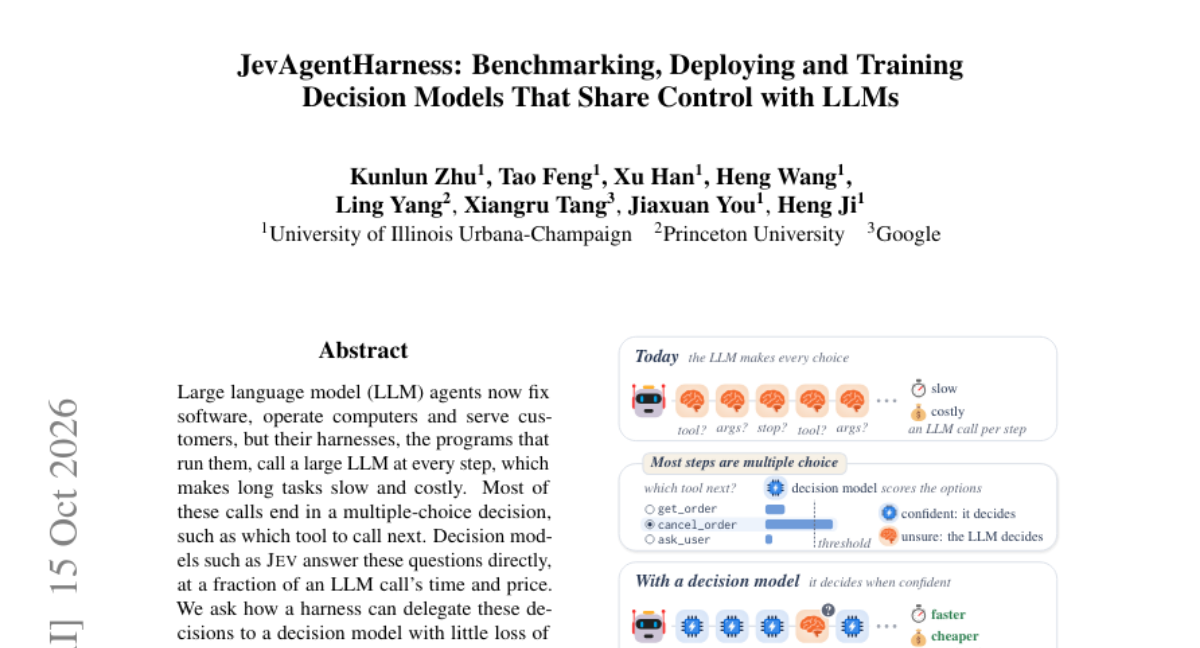
현재 LLM 에이전트는 매 단계마다 거대 모델을 호출하여 비용과 속도 문제가 발생하며, 대부분의 결정은 단순 선택형 문제로 이루어집니다. 본 논문은 에이전트의 성공률을 유지하면서 의사결정 모델로 제어권을 위임하는 방법을 연구합니다. 이를 위해 에이전트 작업 능력을 평가하는 AgentDecisionBench를 구축하고, 신뢰도 임계값을 활용해 LLM과 결정 모델 간의 역할을 분담하는 JevAgentHarness를 설계했습니다. 또한 에이전트의 오류 상태를 포함한 데이터를 학습한 AgentDecision-4B 모델을 개발했습니다. 실험 결과, 제안된 방식은 성공률 손실을 최소화하면서도 비용을 최대 89% 절감하고 속도를 2.5배 높였습니다.
AI 연구
코딩 에이전트의 발전에 따라 검증 가능한 다양한 SWE 과제가 필요하지만, 실제 이슈는 발생 빈도가 낮고 수동 큐레이션 비용이 높다는 문제가 있습니다. 기존의 합성 방식은 모델의 사전 학습 지식과 휴리스틱에 의존하여 실제 소프트웨어 결함의 복잡한 메커니즘을 포착하는 데 한계가 있었습니다. 이를 해결하기 위해 연구진은 과거의 버그 수정 사례를 역공학하여 현실적인 이슈를 생성하는 SWE-at-Scale 프레임워크를 제안합니다. 이 방식은 수정 과정을 역전시켜 실제 개발 시나리오에 기반한 버그 유도 학습으로 변환하며, 학습된 패턴을 새로운 코드 컨텍스트에 적용합니다. 실험 결과, SWE-at-Scale은 기존 방식보다 더 다양하고 현실적인 과제를 생성하며 최신 코딩 에이전트에게 더 높은 난이도를 제공함을 확인했습니다.
AI 연구
비디오 월드 모델은 상호작용을 위해 빠른 생성 속도가 필요하지만, 긴 비디오 생성 시 KV 캐시가 커지며 속도가 저하되는 문제가 발생합니다. 이를 해결하기 위해 연구진은 기하학적 프러스텀 슬래브(frustum slab)를 활용한 학습 불필요(training-free) 어텐션 라우터인 Velox를 제안합니다. Velox는 과거 블록을 카메라 시야각과 깊이 정보를 포함한 슬래브로 표현하고, 현재 블록과의 중첩도를 통해 컨텍스트를 선택적으로 참조합니다. 이 방식은 고정된 토큰-블록 단위를 사용하여 FlashAttention 스타일의 효율적인 실행을 가능하게 합니다. 실험 결과, 긴 시퀀스 생성 시 어텐션 연산 속도를 크게 높이면서도 기존 밀집 모델(dense model)과 대등한 성능을 유지했습니다.
AI 연구
최근 자율주행 분야에서 강력한 시각 표현을 제공하는 VFM의 통합이 늘고 있으나, 이러한 표현이 언제 실제 주행 성능 향상으로 이어지는지는 불분명했습니다. 본 논문은 플래너 구조와 추론 비용을 유지하면서 시각 표현을 정렬하는 플래너 불가지론적(planner-agnostic) 프레임워크인 ViRA를 소개합니다. 연구 결과, VFM 가이드 시각 표현은 다양한 플래너와 제로샷 폐루프 평가에서 일관된 성능 향상을 보였습니다. 또한, 타겟 VFM 선택의 중요성과 보조적 인지 감독(auxiliary perception supervision)이 타겟 선택에 대한 민감도를 낮추는 효과를 확인했습니다. 이를 바탕 개발된 ViRA-Diffusion은 최신 SOTA 성능을 달십하며 타겟 선택과 플래너 감독의 결합이 중요함을 입증했습니다.
AI 연구
자율주행 월드 액션 모델(WAM)은 경로와 미래 영상을 학습하지만, 실제 로그 데이터는 기록된 경로에 대한 영상만 존재하여 대안 경로에 대한 시각적 감독이 어렵다는 문제가 있습니다. 이를 해결하기 위해 SimVTA는 시뮬레이션 기반의 사후 학습 프레임워크를 제안합니다. 3D Gaussian Splatting으로 재구성된 실제 장면에서 시뮬레이터를 통해 고득점 후보 경로에 대한 미래 영상을 렌더링하여 시각적 감독 데이터를 생성합니다. 이후 GRPO를 통한 경로 최적화와 Flow-matching loss를 통한 영상 표현 학습을 병행합니다. 실험 결과, NAVSIM 벤치마크에서 성능 향상을 입증하였으며 추론 시에는 시뮬레이터 없이 직접 경로를 예측할 수 있습니다.
AI 연구
기존의 비디오 자막 제거(VSR) 평가는 저해상도 데이터셋과 일반적인 인페인팅 프로토콜로 인해 국소적 복원 오류나 시간적 불안정성을 제대로 포착하지 못하는 한계가 있었습니다. 본 논문에서는 정밀하고 신뢰도 중심적인 평가를 위해 대규모 멀티 스타일 벤치마크인 MFVSR을 제안합니다. MFVSR은 3,000개의 고품질 쌍 데이터와 953개의 실세계 영상을 포함하며, 16개 언어와 다양한 레이아웃/스타일을 반영한 제어된 데이터셋을 제공합니다. 또한, 마스크 가이드 여부에 따른 복원 충실도, 보존 충실도, 시간적 일관성 등을 분리하여 측정하는 정밀 평가 프로토콜을 도입했습니다. 실험 결과, 기존의 전체 프레임 지표로는 발견하기 어려웠던 국소 복원 및 시간적 일관성 문제를 효과적으로 식별할 수 있음을 입증했습니다.
AI 연구
AI 시스템이 스스로를 개선하는 재귀적 자기 개선은 초지능으로 가는 유망한 경로 중 하나입니다. 본 연구는 에이전트가 공개 데이터를 활용해 소형 베이스 모델을 포스트 트레이닝하는 연구 역량을 테스트하고자 합니다. 이를 위해 에이전트에게 연구 자율성, 엔지니어링 도구, 효율적인 스타터 코드를 제공하는 Athanor 시스템을 구축했습니다. 에이전트들은 샌드박스 환경에서 데이터 분석, 알고리즘 작성, 하이퍼파라미터 튜닝 및 결과 분석을 자율적으로 수행했습니다. 실험 결과, 4개의 에이전트 팀은 104시간 만에 Qwen3-4B-Base 모델을 공식 인스트럭트 버전과 대등하거나 이를 능가하는 수준으로 개선하는 데 성공했습니다. 이는 에이전트 팀이 자율적으로 범용 모델을 구축할 수 있음을 보여주는 최초의 사례입니다.
AI 연구
기존의 멀티 에이전트 시스템은 개별 에이전트의 능력 학습과 집단적 협업 구조를 분리하여 학습하는 한계가 있었습니다. 이를 해결하기 위해 행동 정책과 자기 조직화(self-orchestration)를 동시에 학습하는 시장 기반 사후 학습(MPT) 프레임워크를 도입합니다. 에이전트들은 입찰(bid)을 통해 참여 의사를 표현하며, 이를 통해 중앙 통제 없이도 행동과 참여 패턴이 상호 적응하도록 설계되었습니다. 실험 결과, MPT는 기존 방식보다 우수한 성능을 보였으며 에이전트 수가 늘어나거나 일부가 이탈하는 상황에서도 높은 확장성과 강건성을 입증했습니다. 결과적으로 학습된 입찰 전략이 더 효과적인 행동 학습 신호를 제공함을 확인했습니다.
AI 연구
범용 VLA 모델은 다양한 작업이 가능하지만, 사용자 맞춤형 작업 수행과 신뢰할 수 있는 실행 능력은 여전히 부족합니다. 본 논문은 고정된 VLA 정책을 보완하기 위해 두 개의 루프로 구성된 'CarryOn' 프레임워크를 제안합니다. Planning 루프는 사용자 및 장면 맥락을 유지하여 개인화된 작업 분해를 수행하며, Execution 루프는 위험한 접촉을 방지하고 실패 시 제어 기반의 복구 기술을 실행합니다. 실험 결과, CarryOn은 사용자 선호도를 일관되게 유지하면서도 안전 위반율을 크게 낮추고 실패 복구 성공률을 대폭 향상시켰습니다.
AI 연구
LLM의 긴 컨텍스트 처리를 위해 KV 캐시 크기, 연산량, 모델 품질 사이의 상충 관계를 해결하는 것이 중요합니다. 기존의 GQA는 품질은 좋으나 캐시 오버헤드가 크고, MLA나 MFA는 품질 저하나 연산량 증가 문제를 안고 있습니다. 본 논문은 Q Premix와 Linear Postmix라는 두 가지 선형 연산을 통해 가상 헤드 다양성을 확보하는 VHA를 제안합니다. VHA는 비선형 연산이 없어 추론 시 기존 GQA 최적화 기법을 그대로 사용할 수 있는 것이 특징입니다. 실험 결과, VHA는 기존 GQA 대비 낮은 KV 캐시를 사용하면서도 더 높은 모델 성능을 달nus했습니다.
AI 연구
생성형 시뮬레이션은 로봇 환경 구축을 자동화할 수 있지만, 물리적으로 유효한 환경이 반드시 학습에 유용한 것은 아닙니다. 기존 방식은 정책의 실패를 해결할 수 있는 환경과 감독 신호를 식별하는 데 어려움이 있습니다. 본 논문은 시뮬레이션 데이터 엔진과 액션 정책이 공유 메모리를 통해 상호 진화하는 CoDA 프레임워크를 제안합니다. Vision-Language Critic이 생성한 진단 정보를 바탕으로 환경 구축 및 학습 프로그램을 생성하며, Text2potential을 통해 조밀한 감독 신호를 제공합니다. 실험 결과, CoDA는 다양한 조작 작업에서 OOD 성공률을 크게 향상시키며 기존 베이스라인을 상회하는 성능을 보였습니다.
AI 연구
LLM의 검증 가능한 보상(RLVR) 학습 시, 동일 정책에서 생성된 유사한 궤적들로 인해 그룹 내 보상 차이가 줄어드는 문제가 발생합니다. 기존의 온도 조절이나 엔트로피 보너스 방식은 정책 업데이트 방식은 바꾸지만 샘플링 소스 자체의 제약을 해결하지 못합니다. 본 논문은 입력 임베딩에 미세한 노이즈를 섞어 정책의 범위를 넘어서는 새로운 궤적을 생성하는 EDEN 기법을 제안합니다. EDEN은 프롬프트에 앵커링된 노이즈를 추가하여 동일 그룹 내에서 다양한 탐색을 유도하며, 모델 구조 변경 없이 기존 GRPO 프레임워크에 적용 가능합니다. 실험 결과, 수학적 추론 벤치마크에서 기존 GRPO 대비 높은 솔루션 커버리지와 성능 향상을 입증했습니다.
AI 연구
대규모 언어 및 멀티모달 모델의 긴 문맥 학습 시, 다양한 구조적 어텐션 마스크와 분산 컨텍스트 병렬(CP) 방식이 결합되어 성능 병목을 유발합니다. FlashMask는 O(n^2) 복잡도의 마스크를 4개의 경계 벡터를 이용한 O(n) 복잡도로 압축하는 열 중심 희소 마스크(column-wise sparse mask) 방식을 제안합니다. 이를 바탕으로 Hopper 아키텍처에 최적화된 3-role 워프 특화(warp-specialized) 커널과 통신 없이 마스크 위치를 계산하는 분산 확장 기법을 도입했습니다. 실험 결과, 단일 GPU 및 다중 GPU 분산 환경 모두에서 기존 FlashAttention-3 및 Megatron-Core 기반 방식보다 월등한 처리량(throughput) 향상을 달гах했습니다. 특히 118B MoE 모델의 대규모 분산 학습 환경에서도 유의미한 속도 향상을 입증했습니다.
AI 연구
기존의 단일 이미지 기반 3D 생성 방식은 멀티뷰 예측 간의 불일치로 인한 아티팩트가 발생하거나, 암시적 특징 조건부 방식에서 미세한 디테일을 유지하기 어렵다는 문제가 있었습니다. 이를 해결하기 위해 SUPRA-Tex는 가시 영역의 재질 추정, 표면 정렬, 관찰 기반 3로 완성 과정을 분리하는 구조를 제안합니다. 먼저 MLLM 기반 모델로 조명이 분리된 PBR 맵을 예측한 뒤, 이를 VAE 인코더를 통해 생성 타겟의 잠재 공간(latent space)으로 투영합니다. 이후 인터리브 플로우 트랜스포머(interleaved flow transformer)가 고정된 앵커로서 가시 영역의 디테일을 유지하며 보이지 않는 영역을 생성합니다. 결과적으로 참조 이미지와 일치하는 높은 충실도와 일관된 표면 완성을 동시에 달성하며 SOTA 성능을 기록했습니다.
AI 연구
에이전트가 도구와 파일 간 의존성을 관리하며 변화하는 사용자 요구사항에 적응하는 협업 환경 구축이 필요합니다. 기존 방식으로는 작업 목표, 실행 리소스, 사용자 행동 간의 일관성을 유지하며 대규모 환경을 확장하는 데 어려움이 있었습니다. 본 논문은 실행 증거와 리뷰 피드백을 활용해 환경을 검증하고 수정하는 'build-execute-revise' 루프 기반의 Cowork-Gym 프레임워크를 제안합니다. 또한, 에이전트의 행동에 대화와 직접 편집으로 반응하는 상태 유지형 사용자 시뮬레이터를 도입했습니다. 이를 통해 생성된 64.9K개의 환경으로 Qwen 모델들을 학습시킨 결과, 기존 베이스 모델 대비 성능을 크게 향상시켰으며 대규모 파라미터 모델들을 상회하는 성과를 거두었습니다.
AI 연구
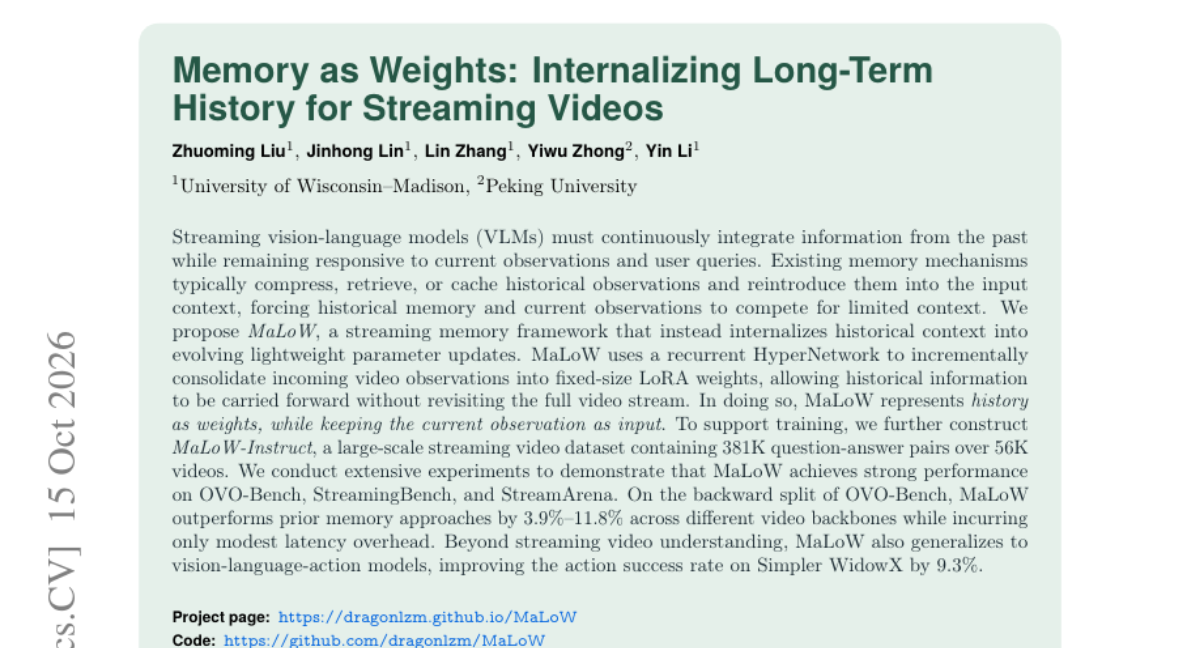
스트리밍 비디오 이해를 위한 VLM은 과거 정보를 지속적으로 통합하면서도 현재 관찰에 즉각 반응해야 합니다. 기존의 메모리 방식은 과거 데이터를 압축하거나 캐싱하여 다시 입력에 넣는 방식을 사용하므로, 과거 정보와 현재 관찰이 한정된 컨텍스트 창 내에서 경쟁하는 문제가 발생합니다. 이를 해결하기 위해 본 논문은 과거의 맥락을 가변적인 경량 파라미터 업데이트로 내재화하는 MaLoW 프레임워크를 제안합니다. MaLoW는 순환형 하이퍼네트워크(Recurrent HyperNetwork)를 사용하여 들어오는 비디오 관찰 정보를 고정된 크기의 LoRA 가중치로 점진적으로 통합합니다. 실험 결과, MaLoW는 기존 메모리 방식 대비 우수한 성능을 보였으며 비디오 이해뿐만 아니라 시각-언어-행동(VLA) 모델로의 일반화 능력도 입증되었습니다.
AI 연구
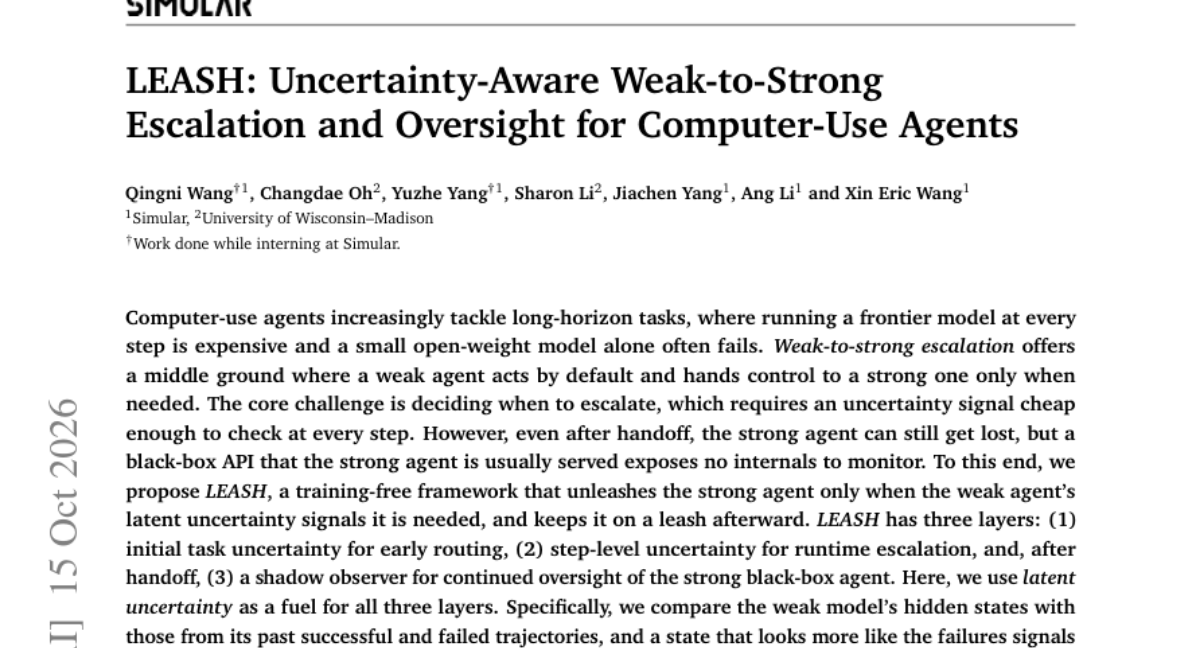
컴퓨터 사용 에이전트가 복잡한 작업을 수행할 때, 매 단계 강력한 모델을 사용하는 것은 비용이 매우 높고 약한 모델만으로는 성능이 부족한 문제가 있습니다. 이를 해결하기 위해 약한 모델이 기본적으로 동작하다가 필요할 때만 강력한 모델로 제어권을 넘기는 'Weak-to-strong escalation' 방식이 제안되었습니다. 하지만 언제 제어권을 넘길지 결정하는 것과, 제어권을 넘긴 후 블랙박스 형태의 강력한 모델이 경로를 이탈하지 않게 감시하는 것이 핵심 과제입니다. 본 논문은 LEASH 프레임워크를 제안하며, 이는 약한 모델의 잠재적 상태(latent states)를 활용해 불확실성을 측정하고 이를 기반으로 에스컬레이션 및 사후 감시를 수행합니다. 실험 결과, LEASH는 무작위 에스컬레이션 대비 높은 성능을 보였으며, 강력한 모델을 항상 사용하는 것보다 비용을 낮추면서도 대등한 성공률을 달성했습니다.
30건
이날 공개된 제품과 도구

6건
새 모델과 주요 평가 결과
HF Model Trending
black-forest-labs/flux-3-image-klein-comfy 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 image-to-image 파이프라인을 지원하는 것이 특징입니다.
HF Model Trending
DeepSeek-AI에서 출시한 DeepSeek-V4.1-Flash-1017 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 이미지와 텍스트를 동시에 처리하는 멀티모달 기능을 제공합니다.
HF Model Trending
fishaudio에서 공개한 drama-3 모델이 text-to-speech 분야에서 주목받고 있습니다. 약 35.9B 파라미터를 보유한 이 모델은 최근 높은 다운로드 수를 기록하며 트렌드에 진입했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.