논문
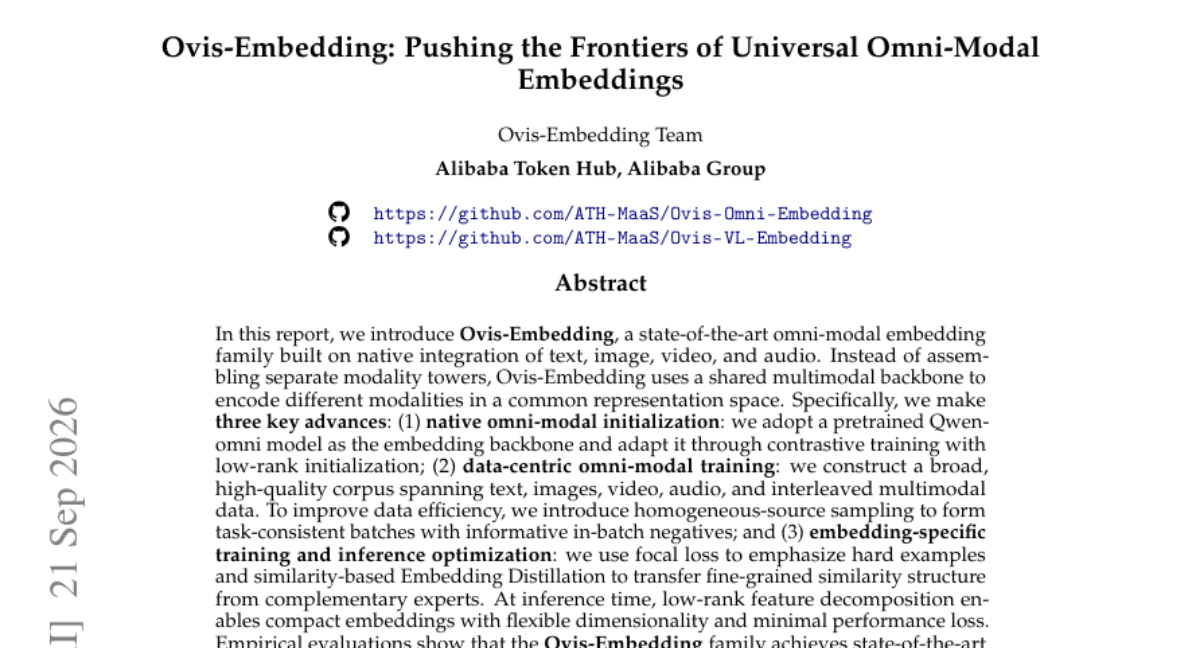
Ovis-Embedding: Pushing the Frontiers of Universal Omni-Modal Embeddings
텍스트, 이미지, 비디오, 오디오를 하나의 공통 공간에서 처리하는 통합 옴니-모달 임베딩 모델 개발
논문이 다루는 내용
기존의 임베딩 방식은 각 모달리티별로 별도의 타워를 구축하여 모달리티 간 파편화 문제가 발생했습니다. 이를 해결하기 위해 텍스트, 이미지, 비디오, 오디오를 네이티브하게 통합하는 Ovis-Embedding을 제안합니다. Qwen-omni 모델을 백본으로 사용하여 공통 표현 공간을 학습하고, 고품질의 옴니-모달 데이터셋과 효율적인 샘플링 전략을 도입했습니다. 또한, 임베딩 증류(Distillation)와 저차원 분해 기법을 통해 성능과 효율성을 동시에 확보했습니다. 실험 결과, 다양한 옴니-모달 벤치마크에서 SOTA 성능을 달성하며 범용 검색 모델로서의 가능성을 입증했습니다.
핵심 결과
-
Qwen-omni 백본 기반의 네이티브 옴니-모달 초기화 및 대조 학습
-
데이터 효율성을 극대화하는 동질 소스 샘플링 및 고품질 멀티모달 코퍼스 구축
-
임베딩 증류(Distillation)와 저차원 분해를 통한 효율적인 추론 및 차원 제어
실무에서 볼 만한 점
단일 모델로 텍스트뿐만 아니라 이미지, 영상, 음성 간의 복합적인 검색(Any-to-Any)을 구현할 수 있어 멀티모달 RAG 시스템 구축에 매우 유용합니다.
읽을 때 확인할 점
-
제공된 저차원 분해 기법을 활용한 임베딩 차원 축소 성능 테스트
-
다양한 모달리티가 혼합된 데이터셋에서의 검색 정확도 검증
-
기존 개별 모달리티 모델 대비 통합 모델의 연산 효율성 비교