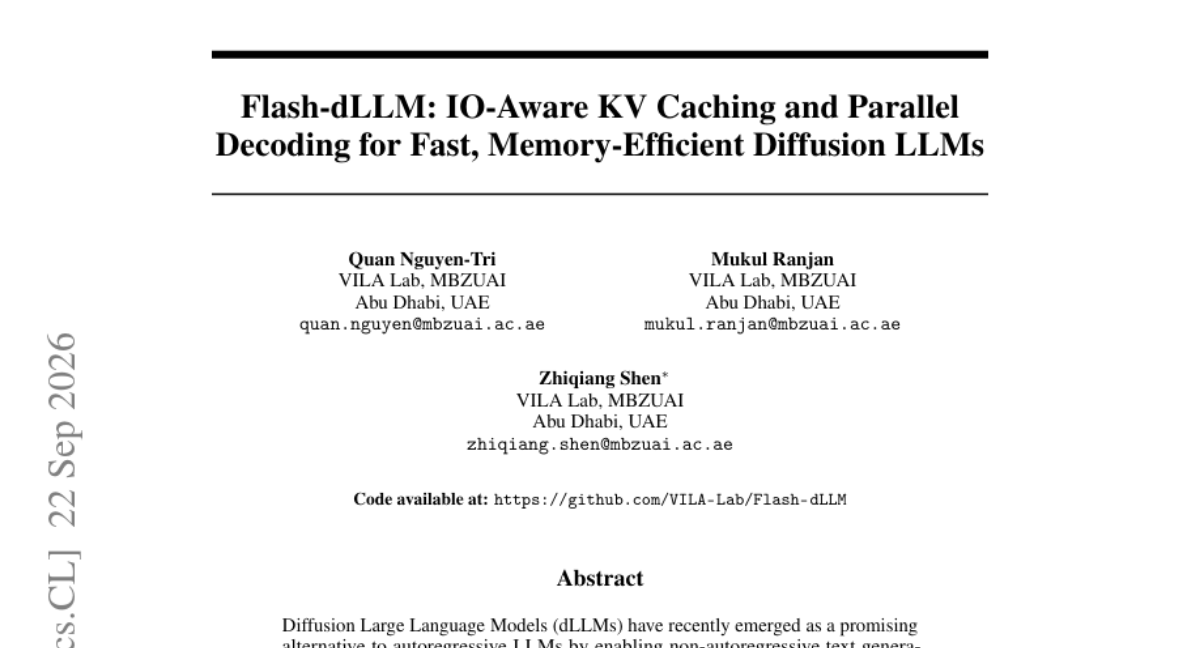
Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs
I/O 최적화된 KV 캐싱과 병렬 디코딩을 결합하여 Diffusion LLM의 추론 속도와 메모리 효율을 극대화한 프레임워크
논문이 다루는 내용
최근 비자기회귀(non-autoregressive) 생성이 가능한 Diffusion LLM이 주목받고 있으나, 비효율적인 추론 방식이 실무 도입의 걸림돌이 되고 있습니다. 기존 가속 방식은 KV 캐싱과 병렬 디코딩을 개별적으로 다루어, 두 기법 결합 시 발생하는 I/O 병목 문제를 해결하지 못했습니다. 본 논문은 Flash-dLLM을 제안하여 GPU 메모리 I/O를 최적화하는 융합형 KV-캐시 커널을 도입했습니다. 또한 별도의 모델 없이 dLLM 자체가 Drafter와 Verifier 역할을 수행하는 효율적인 디코딩 전략을 설계했습니다. 실험 결과, 수학적 추론 및 코드 생성 벤치마크에서 기존 SOTA 대비 압도적인 속도 향상과 메모리 효율성을 입증했습니다.
핵심 결과
-
I/O 병목을 해결하는 융합형(Fused) KV-cache 커널 설계
-
추가 모델 없이 dLLM을 활용하는 Draft-and-Verify 디코딩 전략
-
메모리 이동 최소화를 통한 대규모 배치 및 긴 시퀀스 확장성 확보
실무에서 볼 만한 점
비자기회귀 모델의 고질적인 문제인 추론 속도와 메모리 문제를 동시에 해결하여, 실시간 텍스트 생성 서비스의 비용 절감과 성능 향상을 가능하게 합니다.
읽을 때 확인할 점
-
기존 Elastic-Cache 등 SOTA 가속 기법과의 추론 속도 비교 실험
-
다양한 배치 사이즈 및 시퀀스 길이에 따른 메모리 점유율 변화 측정
-
코드 생성 및 수학적 추론 작업에서의 생성 품질(Quality) 유지 여부 검증