
논문
PanoVLN: Towards Effective Panoramic Vision-and-Language Navigation
파노라마 시야를 활용해 더 넓은 맥락을 파악하고 효율적인 경로 계획을 수행하는 차세대 시각-언어 내비게이션(VLN) 프레임워크
논문이 다루는 내용
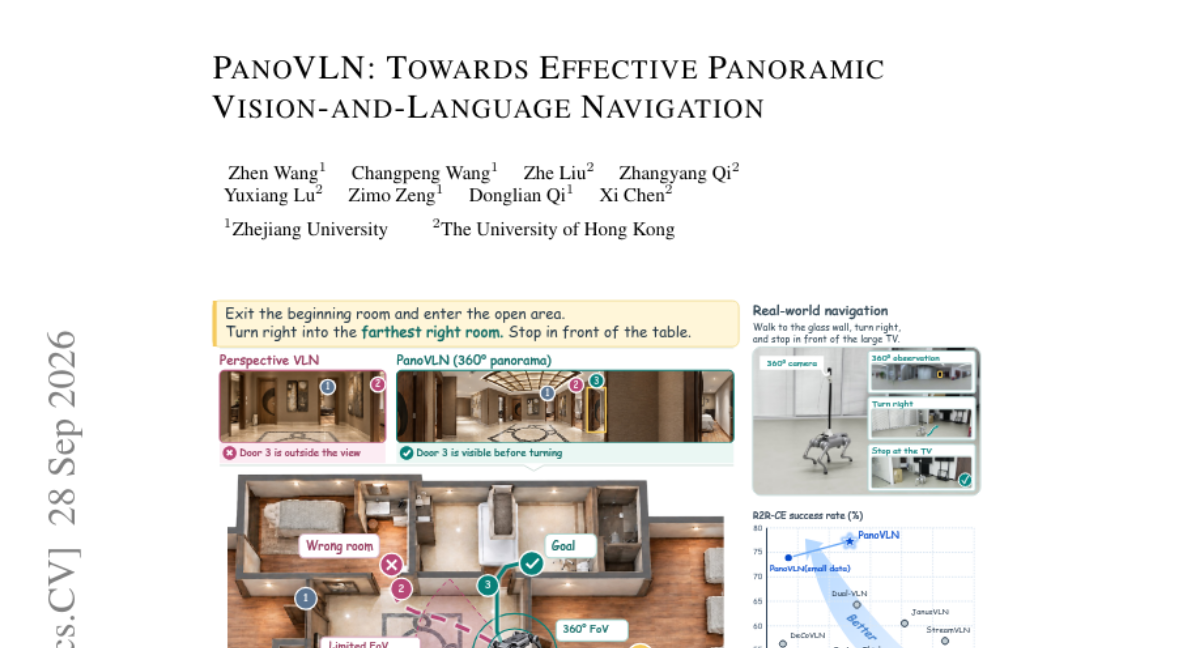
기존의 시각-언어 내비게이션(VLN)은 주로 제한된 시야의 원근 이미지를 사용하여 탐색을 수행해 왔습니다. 본 연구는 더 넓은 시각적 맥락을 제공하는 파노라마 관찰을 활용하는 PanoVLN을 제안합니다. 단순히 이미지를 교체하는 것만으로는 성능 향상에 한계가 있음을 발견하고, 액션 예측, 학습 감독, 시각적 표현 방식을 개선했습니다. 구체적으로 신뢰도 기반 실행(CGE) 전략, 분기점이 많은 학습 경로 구성, 그리고 기하학적 특징을 결합한 시각 표현 방식을 도입했습니다. 실험 결과, 기존 SOTA를 크게 상회하는 성공률을 기록했으며 로봇 실물 실험에서도 더 빠르고 효율적인 이동을 입증했습니다.
핵심 결과
-
신뢰도 기반 실행(CGE) 전략을 통한 장기적 액션 계획 및 효율적 이동
-
경로 선택 능력을 높이기 위한 분기점이 빈번한 특수 학습 데이터셋 구축
-
추가 토큰 없이 RGB 파노라마의 의미적·기하학적 특징을 결합한 시각 표현
실무에서 볼 만한 점
로봇이나 자율 주행 에이전트 개발 시, 넓은 시야를 가진 카메라를 활용해 탐색 횟수를 줄이고 경로 계획의 효율성을 높이는 데 직접적인 영감을 제공합니다.
읽을 때 확인할 점
-
기존의 단일 시야(Perspective) 기반 에이전트에 파노라마 데이터 적용 시 성능 변화 비교
-
CGE 전략과 같은 신뢰도 기반 액션 실행 로직을 기존 RL/IL 모델에 이식
-
시각적 특징 추출 시 기하학적 정보(Depth/Layout) 결합 방식 실험