
논문
Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It
사전 학습된 트랜스포머의 잠재력을 끌어올리기 위해 아주 작은 LoRA 레이어만 추가하여 문맥 추론 능력을 극대화하는 방법론
논문이 다루는 내용
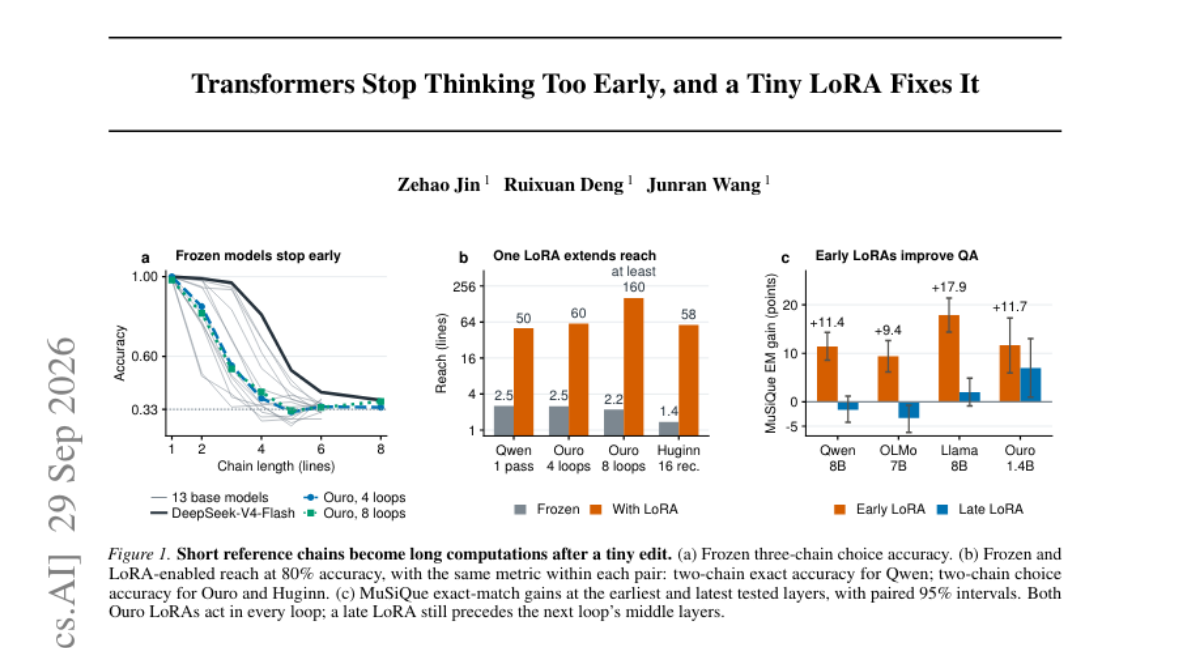
사전 학습된 트랜스포머 모델들은 모델의 깊이에 비해 문맥 내 참조를 따라가는 추론 능력을 충분히 활용하지 못하는 경향이 있습니다. 연구진은 모델의 가중치를 동결한 채 특정 초기 레이어에 아주 작은 rank-8 LoRA를 추가하는 방식을 제안했습니다. 실험 결과, Qwen3-8B 모델은 24라인의 복잡한 추론 작업에서 정확도가 15.5%에서 99%로 비약적으로 상승했습니다. 이 LoRA는 레이어 간 정보를 전달하는 '릴레이' 역할을 수행하며 모델이 더 긴 문맥을 처리할 수 있게 합니다. 결과적으로 아주 작은 파라미터 수정만으로도 모델의 기본 성능을 크게 개선할 수 있음을 입증했습니다.
핵심 결과
-
사전 학습된 모델의 깊이 활용 부족 문제를 해결하기 위해 특정 레이어에 작은 LoRA를 삽입
-
LoRA가 레이어 간 정보 전달(Relay)을 유도하여 문맥 참조 범위를 확장
-
모델 전체를 재학습하지 않고도 복잡한 추론 작업의 정확도를 극적으로 향상
실무에서 볼 만한 점
모델 전체를 파인튜닝하는 대신, 특정 레이어에 아주 작은 LoRA만 삽입함으로써 적은 비용으로 추론 능력을 비약적으로 높일 수 있는 실용적인 전략을 제시합니다.
읽을 때 확인할 점
-
특정 레이어에 rank가 낮은 LoRA를 삽립하여 문맥 추론 성능 변화 관찰하기
-
모델의 어느 레이어가 추론 릴레이에 가장 효과적인지 위치별 실험 수행
-
긴 문맥 추론이 필요한 태스크에 대해 LoRA 기반의 레이어 확장 실험