
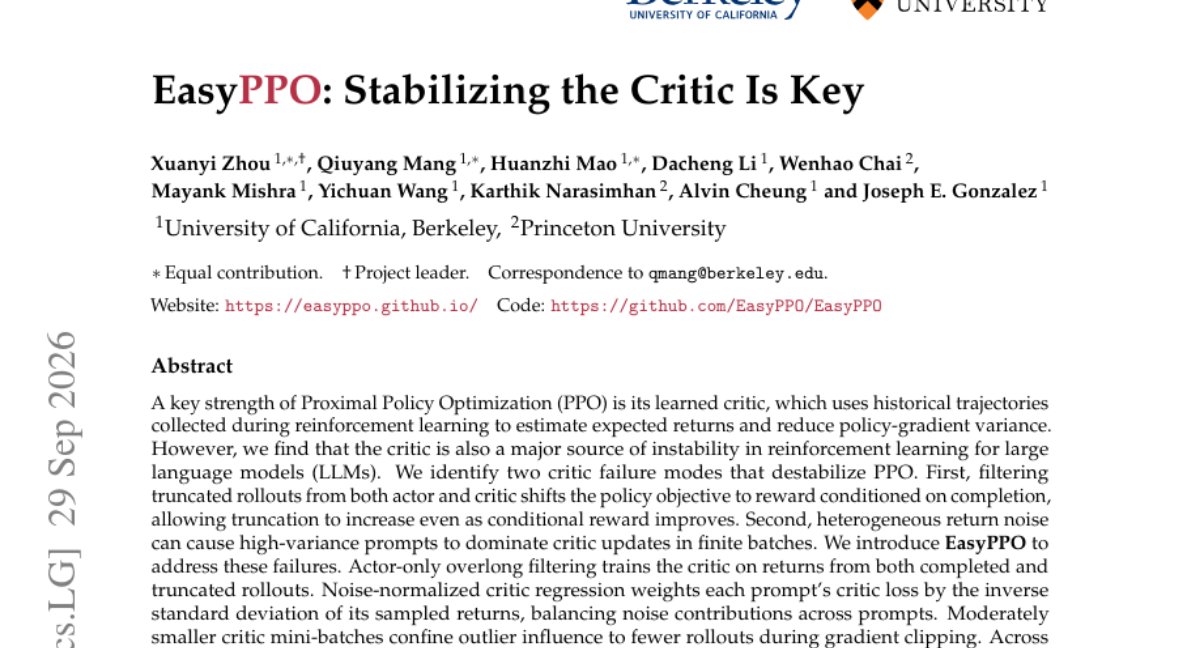
EasyPPO: Stabilizing the Critic Is Key
LLM 강화학습의 불안정성을 유발하는 Critic 문제를 해결하여 학습 안정성과 성능을 동시에 높인 EasyPPO 방법론
논문이 다루는 내용
LLM의 PPO 학습에서 Critic은 분산을 줄이는 핵심 역할을 하지만, 동시에 학습 불안정의 주요 원인이 되기도 합니다. 연구진은 Truncated Rollout(중단된 데이터)이 보상 목표를 왜곡하는 문제와 프롬프트별 이질적인 리턴 노이즈가 Critic 업데이트를 방해하는 두 가지 실패 모드를 식별했습니다. 이를 해결하기 위해 Actor-only overlong filtering과 Noise-normalized critic regression을 도입한 EasyPPO를 제안합니다. 또한 적절한 크기의 Critic mini-batch를 사용하여 이상치 영향을 제어했습니다. 실험 결과, EasyPPO는 코딩, 수학적 추론, 멀티턴 검색 등 다양한 태스크에서 기존 PPO 대비 높은 성능과 안정성을 입증했습니다.
핵심 결과
-
Truncated Rollout 필터링을 통해 Actor와 Critic 간의 보상 불일치 문제 해결
-
Noise-normalized critic regression을 도입하여 프롬프트 간 리턴 노이즈 불균형 해소
-
적절한 크기의 Critic mini-batch를 통해 이상치(outlier)가 전체 학습에 미치는 영향 최소화
실무에서 볼 만한 점
LLM의 RLHF/PPO 학습 시 발생하는 성능 급락(collapse)이나 학습 불안정 문제를 해결할 수 있는 실질적인 기법을 제공합니다.
읽을 때 확인할 점
-
기존 PPO 학습 파이프라인에 Noise-normalized loss 적용 테스트
-
학습 데이터 중 중단된(truncated) 샘플의 처리 방식 변경 실험
-
Critic mini-batch 크기 변화에 따른 학습 안정성 비교