
논문
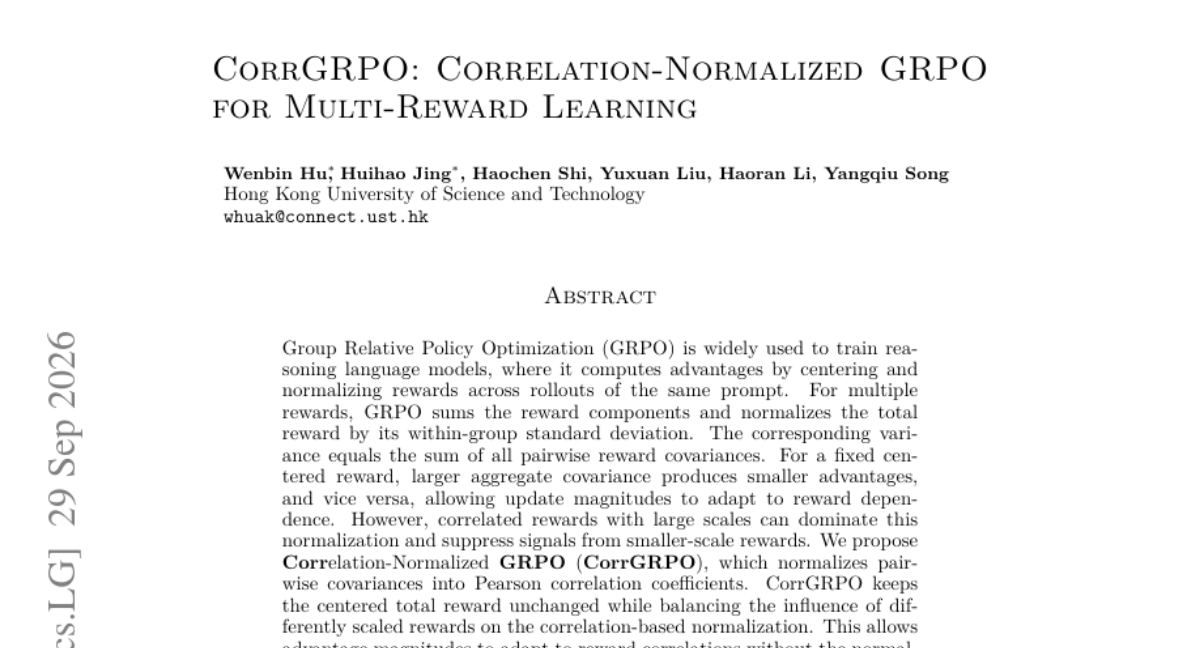
CorrGRPO: Correlation-Normalized GRPO for Multi-Reward Learning
다중 보상 학습 시 스케일 차이로 인한 특정 보상 편향 문제를 해결하여 모델 성능을 균형 있게 개선하는 CorrGRPO 기법 제안
논문이 다루는 내용
최근 추론 모델 학습에 사용되는 GRPO는 여러 보상 성분을 합산하여 정규화하는 방식을 사용합니다. 그러나 보상 간 상관관계가 높고 스케일 차이가 클 경우, 특정 보상이 전체 정규화 과정을 지배하여 다른 보상 신호를 억제하는 문제가 발생합니다. 이를 해결하기 위해 공분산을 피어슨 상관계수로 변환하여 정규화하는 CorrGRPO를 제안합니다. 이 방식은 총 보상 값은 유지하면서도 서로 다른 스케일을 가진 보상들이 균형 있게 반영되도록 합니다. 코드 생성, 도구 호출, 에이전트 보안 등 다양한 태스크에서 실험한 결과, 기존 GRPO 대비 성능 향상을 확인했습니다.
핵심 결과
-
공분산 기반 정규화에서 발생하는 스케일 불균형 문제 식별
-
공분산을 피어슨 상관계수로 변환하여 보상 간 영향력을 균형 있게 조절하는 CorrGRPO 제안
-
코드 생성, 도구 호출, 에이전트 보안 등 다중 보상 환경에서 성능 검증
실무에서 볼 만한 점
여러 개의 보상 함수(Reward Function)를 동시에 사용하는 에이전트나 코드 생성 모델 학습 시, 특정 보상이 너무 커서 학습이 망가지는 현상을 방지할 수 있습니다.
읽을 때 확인할 점
-
기존 GRPO 기반 학습 코드에 상관계수 기반 정규화 로직 적용 테스트
-
보상 함수 간 스케일 차이가 극심한 데이터셋에서 성능 비교 실험
-
다중 목적 최적화(Multi-objective optimization) 환경에서의 수렴 속도 확인