
논문
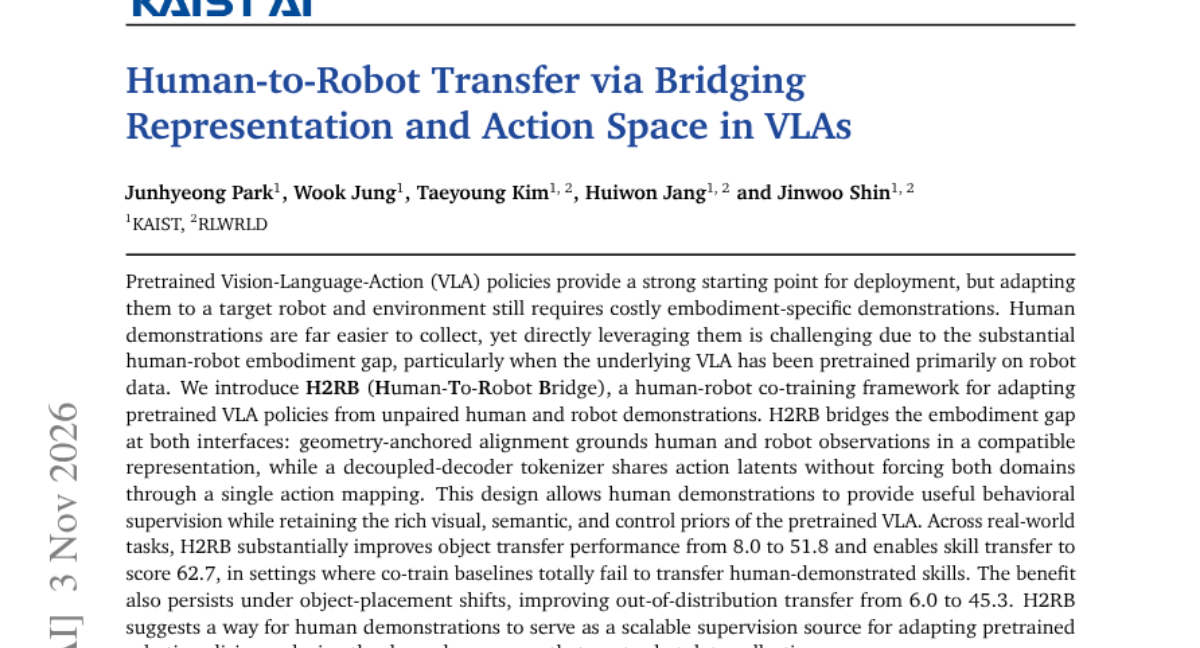
Human-to-Robot Transfer via Bridging Representation and Action Space in VLAs
비정형 인간 데모를 활용해 사전 학습된 VLA 모델을 로봇에 효율적으로 이식하는 인간-로봇 공동 학습 프레임워크 제안
논문이 다루는 내용
사전 학습된 VLA 정책은 강력한 시작점이지만, 특정 로봇 환경에 맞추기 위해 비용이 많이 드는 로봇 전용 데모가 필요합니다. 인간의 데모는 수집이 쉽지만, 로봇과의 신체적 차이(embodiment gap)로 인해 직접 활용하기 어렵습니다. 본 논문은 비정형 인간 및 로봇 데모를 활용하는 H2RB(Human-To-Robot Bridge) 프레임워크를 제안합니다. 이 방식은 기하학적 정렬을 통해 관찰 공간을 맞추고, 디코더를 분리하여 행동 잠재 공간을 공유함으로써 신체 차이를 극복합니다. 실험 결과, H2RB는 객체 전이 및 스킬 전이 성능을 대폭 향상시켰으며, 물체 배치 변화와 같은 OOD 상황에서도 강건한 성능을 보였습니다.
핵심 결과
-
H2RB: 비정형 인간/로봇 데모를 활용하는 인간-로봇 공동 학습 프레임워크
-
Geometry-anchored alignment: 기하학적 정렬을 통한 관찰 공간의 일치
-
Decoupled-decoder tokenizer: 행동 매핑의 강제 없이 행동 잠재 공간을 공유하는 구조
실무에서 볼 만한 점
로봇 전용 데이터 수집 비용을 줄이면서 인간의 풍부한 행동 데이터를 VLA 모델 학습에 직접 활용할 수 있는 경로를 제시합니다.
읽을 때 확인할 점
-
기존 VLA 모델에 H2RB의 분리된 디코더 구조 적용 테스트
-
인간 영상 데이터셋을 활용한 로봇 정책 미세 조정 실험
-
다양한 로봇 하드웨어 간의 기하학적 정렬 알고리즘 검증