
LiveFoley: Dynamic Real-Time Video-to-Audio Generation for Immersive Interactive Worlds
지연 시간을 최소화하면서도 오프라인 모델 수준의 정교한 오디오-비주얼 정렬과 음질을 구현한 실시간 스트리밍 V2A 생성 프레임워크
논문이 다루는 내용
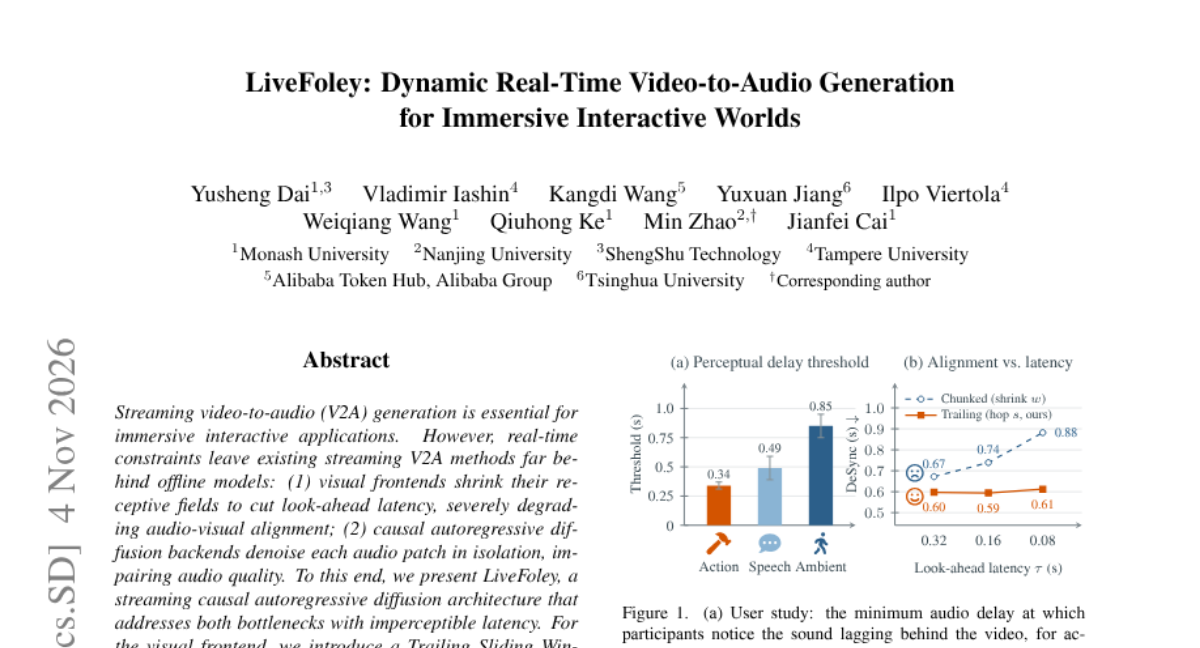
몰입형 상호작용 애플리케이션을 위해 실시간 비디오-to-오디오(V2A) 생성 기술이 필수적이지만, 기존 방식은 낮은 지연 시간을 위해 수용 영역을 줄이면서 오디오-비주얼 정렬이 깨지거나 오디오 품질이 저하되는 문제가 있었습니다. 이를 해결하기 위해 LiveFoley는 스트리밍 인과적 자기회귀 확산(causal autoregressive diffusion) 아키텍처를 제안합니다. 비주얼 프론트엔드에는 재학습 없이 비인과적 인코더를 스트리밍 모듈로 변환하는 Trailing Sliding Window와 가변적 지연 시간을 조절하는 Unified Varhop Framework를 도입했습니다. 오디오 백엔드에서는 과거 문맥을 활용하는 History LocDiT와 미래 정보를 근사적으로 반영하는 Future-Warmup LocDiT를 통해 생성 품질을 높였습니다. 실험 결과, LiveFoley는 오프라인 모델 수준의 정렬 성능을 유지하면서도 실시간 스트리밍 환경에서 압도적인 생성 품질을 입증했습니다.
핵심 결과
-
Trailing Sliding Window: 재학습 없이 기존 인코더를 스트리밍용으로 변환하여 정밀한 오디오-비주얼 정렬 유지
-
Unified Varhop Framework: 지연 시간과 연산 예산에 따라 홉 사이즈(hop size)를 조절 가능한 유연한 구조
-
LocDiT(History/Future-Warmup): 과거 문맥 활용 및 미래 조건 근사를 통해 실시간 환경에서도 고품질 오디오 생성
실무에서 볼 만한 점
게임, VR/AR 등 실시간 상호작용이 중요한 환경에서 지연 시간 문제를 해결하며 고품질 사운드를 생성할 수 있는 실무적 가이드라인을 제공합니다.
읽을 때 확인할 점
-
제시된 Trailing Sliding Window 기법을 기존 비디오 인코더에 적용하여 지연 시간 변화 관찰
-
다양한 하드웨어 사양에 따른 Unified Varhop Framework의 지연 시간 vs 품질 트레이드오프 테스트
-
LocDiT의 과거/미래 윈도우 크기 변화에 따른 오디오 품질 및 정렬 정확도 비교 실험