
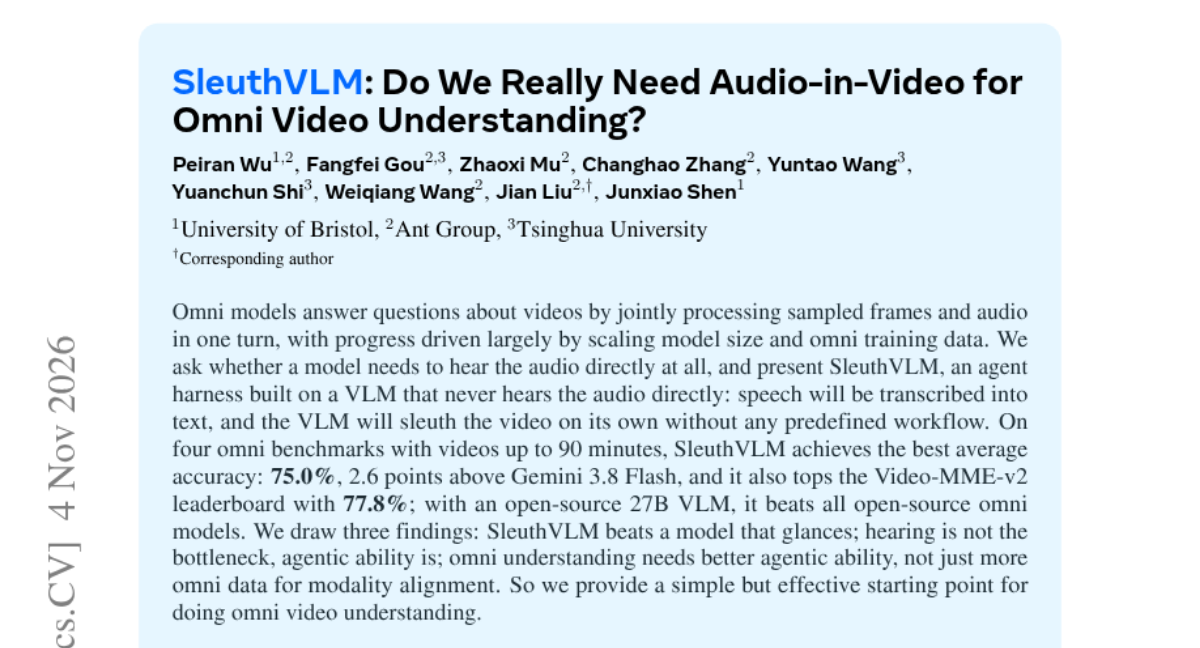
SleuthVLM: Do We Really Need Audio-in-Video for Omni Video Understanding?
오디오 직접 입력 대신 텍스트 변환과 에이전트 능력을 결합하여 비디오 이해 성능을 극대화한 SleuthVLM 제안
논문이 다루는 내용
최근 비디오 이해 모델은 프레임과 오디오를 동시에 처리하는 멀티모달 학습을 통해 발전해 왔습니다. 하지만 오디오를 직접 듣는 것이 비디오 이해의 핵심인지에 대한 의문이 제기되었습니다. 본 논문은 오디오를 직접 듣지 않고 음성을 텍스트로 변환하여 처리하는 에이전트 방식인 SleuthVLM을 제안합니다. 실험 결과, SleuthVLM은 긴 영상(최대 90분)을 포함한 주요 벤치마크에서 Gemini 1.5 Flash를 포함한 기존 모델들을 상회하는 성능을 기록했습니다. 연구 결과, 비디오 이해의 병목은 모달리티 정렬이 아닌 에이전트로서의 추론 능력에 있음이 밝혀졌습니다.
핵심 결과
-
오디오 직접 입력 없이 텍text 기반의 에이전트 워크플로우를 통한 비디오 이해 구현
-
Video-MME-v2 등 주요 벤치마크에서 최상위 성능 달성 및 오픈소스 모델 중 최고 성능 기록
-
비디오 이해의 핵심 동력이 모달리티 정렬(Alignment)보다 에이전트적 추론 능력에 있음을 입증
실무에서 볼 만한 점
멀티모달 모델의 크기를 키우는 것보다, 텍스트화된 정보를 활용하는 에이전트 설계가 효율적인 비디오 분석 솔루션의 핵심이 될 수 있음을 시사합니다.
읽을 때 확인할 점
-
ASR(음성 인식) 결과물을 VLM의 컨텍스트로 주입하는 에이전트 파이프라인 구축 실험
-
비디오 프레임 추출과 텍스트 정보 간의 상호 참조(Cross-referencing) 로직 최적화
-
장기 비디오(Long-form video) 처리를 위한 에이전트의 메모리 관리 전략 테스트