
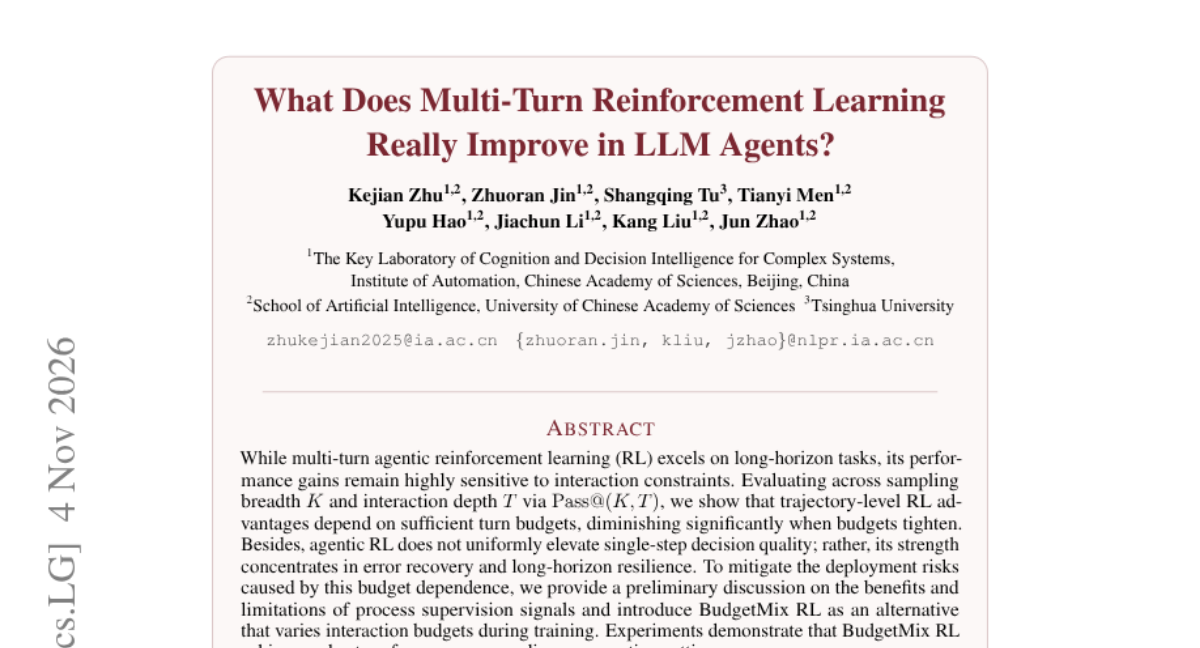
What Does Multi-Turn Reinforcement Learning Really Improve in LLM Agents?
멀티턴 RL의 성능 향상은 상호작용 예산(Turn Budget)에 민게하게 의존하며, 이를 해결하기 위해 학습 시 예산을 가변적으로 적용하는 BudgetMix RL을 제안합니다.
논문이 다루는 내용
LLM 에이전트의 멀티턴 RL은 장기 과제에서 우수한 성능을 보이지만, 상호작용 제약 조건에 따른 성능 변화에 대한 분석은 부족했습니다. 본 연구는 샘플링 너비(K)와 상호작용 깊이(T)를 기준으로 RL의 이점이 예산 제약에 따라 어떻게 변하는지 분석했습니다. 실험 결과, RL의 이점은 충분한 턴 예산이 확보될 때 나타나며, 단일 단계 의사결정 품질보다는 오류 복구 및 장기 회복력에 집중됨을 확인했습니다. 이를 해결하기 위해 학습 과정에서 상호작용 예산을 다양하게 변화시키는 BudgetMix RL을 제안합니다. 실험을 통해 BudgetMix RL이 다양한 실행 환경에서 강건한 성능을 달성함을 입증했습니다.
핵심 결과
-
멀티턴 RL의 성능 향상은 가용 가능한 상호작용 턴(Turn Budget)에 매우 민감하게 의존함
-
에이전트 RL은 단일 단계 결정 품질 향상보다는 오류 복구 및 장기적 회복력 강화에 기여함
-
BudgetMix RL은 학습 시 예산을 가변적으로 적용하여 다양한 실행 환경에 대한 강건성을 확보함
실무에서 볼 만한 점
에이전트 개발 시 단순히 RL을 적용하는 것을 넘어, 실제 배포 환경의 상호작용 제약(Turn Budget)을 고려한 학습 전략이 필수적임을 시사합니다.
읽을 때 확인할 점
-
에이전트 성능 평가 시 단일 성공률뿐만 아니라 상호작용 턴 수(T)에 따른 성능 변화를 반드시 측정할 것
-
학습 시 고정된 턴 수가 아닌 가변적인 예산을 적용하는 스케줄링 전략을 실험해 볼 것
-
에이전트의 '오류 복구 능력'을 별도의 지표로 관리하여 RL의 효과를 검증할 것