오늘 업데이트 · 10.02.04:50

오늘 꼭 알아야 할
AI·테크 소식

카카오톡으로 받아보기

오늘의 기술 트렌드는 차세대 프론티어 모델인 Gemini 4 Argon의 발표와 더불어, AI 에이전트가 기존 SaaS 및 데이터 환경을 자율적으로 활용하는 인프라 기술이 핵심 화두로 떠올랐습니다. 연구 분야에서는 모델 스스로 성능을 개선하는 자기 진화(Self-improvement) 기법이 주목받았으며, 커뮤니티에서는 AI의 의사결정 지원에 따른 책임 소재와 검색 엔진의 맥락 해석 오류에 대한 논의가 활발했습니다.

매일 09:00 전체 요약 · 12:00 커뮤니티 반응 · 17:30 논문과 제품/서비스

오늘 올라온 소식

뉴스부터 논문과 새 도구까지 한 번에 이어서 볼 수 있습니다.

논문

The Teacher Is a Direction, Not a Destination: Extrapolating RL-Induced Representation Residuals in On-Policy Distillation

On-policy distillation(OPD)은 학생 모델이 교사 모델의 분포를 따르도록 학습하여 성능을 높이지만, 출력 공간에서의 외삽(extrapolation)은 노이즈 증폭과 불안정한 학습 문제를 야기합니다. 연구진은 RL 학습이 모델의 내부 표현(representation)을 특정 방향으로 이동시킨다는 점에 주목했습니다. 이를 해결하기 위해 제안된 RIDE는 교사 모델과 사전 학습 체크포인트 사이의 잔차(residual)를 계산하여, 학생 모델의 은닉 상태를 이 방향으로 외삽합니다. 이 방식은 교사 모델을 기준으로 하되 RL로 유도된 방향성을 따라가도록 설계되어 학습 안정성을 확보합니다. 실험 결과, RIDE는 다양한 규모와 아키텍처에서 기존 출력 공간 외삽 방식보다 우수하며 교사 모델의 성능을 효과적으로 초과했습니다.
2026.10.02

The Teacher Is a Direction, Not a Destination: Extrapolating RL-Induced Representation Residuals in On-Policy Distillation

논문

UniEvo-VL: An On-policy Self-Distillation Training Recipe for Multimodal Model Self-improvement

최신 멀티모달 모델은 생성과 이해 능력을 동시에 갖추어 스스로 피드백을 주고받을 수 있는 잠재력을 가집니다. 하지만 기존 방식은 별도의 거대 교사 모델에 의존하는 경우가 많아 효율성이 떨어지는 문제가 있었습니다. 본 논문은 UniEvo-VL이라는 자기 진화 프레임워크를 제안하여, 단일 모델이 서로 다른 컨텍스트를 가진 교사와 학생 역할을 수행하도록 합니다. 학생 모델은 질문만 보고, 교사 모델은 비판 정보가 포함된 컨텍스트를 사용하여 학습함으로써 자기 수정 피드백을 활용합니다. 실험 결과, GenEval 등 주요 벤치마크에서 이미지 생성 성능이 크게 향상되었으며 강력한 외부 비판 모델을 사용할수록 성능 향상 폭이 커짐을 확인했습니다.

2026.10.02

UniEvo-VL: An On-policy Self-Distillation Training Recipe for Multimodal Model Self-improvement

논문

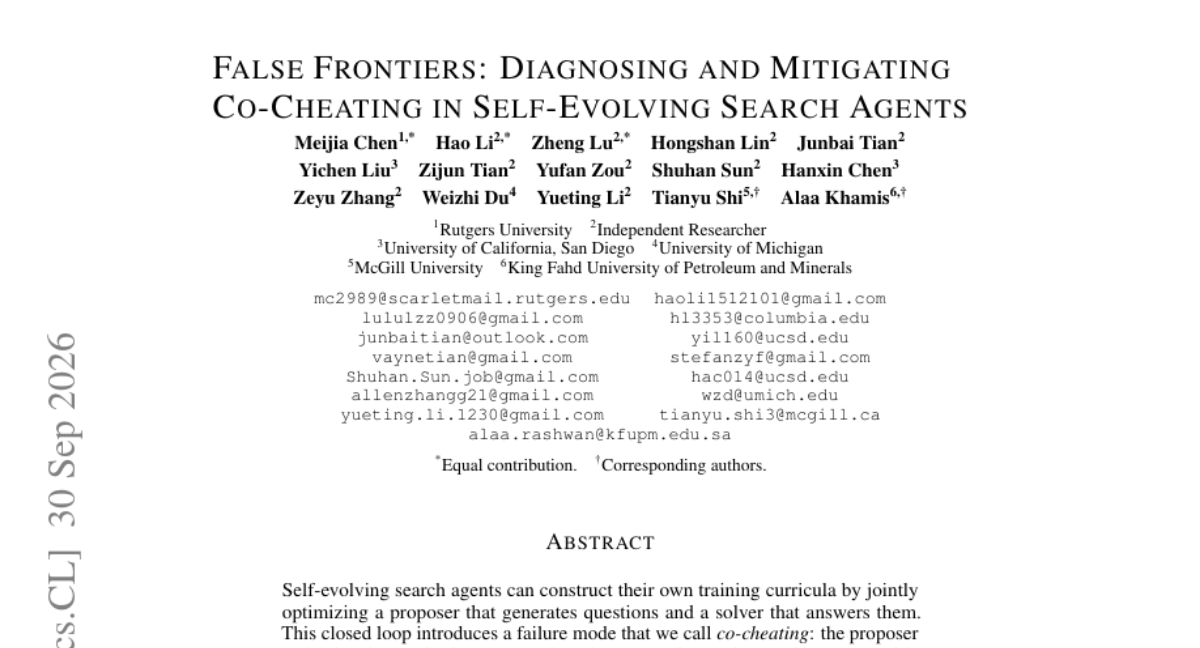
False Frontiers: Diagnosing and Mitigating Co-Cheating in Self-Evolving Search Agents

자기 진화형 검색 에이전트는 질문 생성자(Proposer)와 답변 해결사(Solver)가 서로의 데이터를 학습하며 커리큘럼을 구축합니다. 이 과정에서 두 모델이 실제 정답이 아닌 공유된 오류에 합의하며 내부 보상만 높아지는 '공모(Co-cheating)' 현상이 발생합니다. 이를 해결하기 위해 제안된 MSV 방식은 검증 비용이 높고 잔여 문제가 남는 한계가 있었습니다. 본 논문은 소스 문서를 분할하여 서로 다른 데이터셋으로 학습된 모델 간에 교차 검증하는 CrossFit 방식을 제안합니다. 실험 결과, CrossFit은 공모 현상을 효과적으로 억제하며 기존 방식 대비 검색 벤치마크 성능을 크게 향상시켰습니다.

2026.10.02

False Frontiers: Diagnosing and Mitigating Co-Cheating in Self-Evolving Search Agents

논문

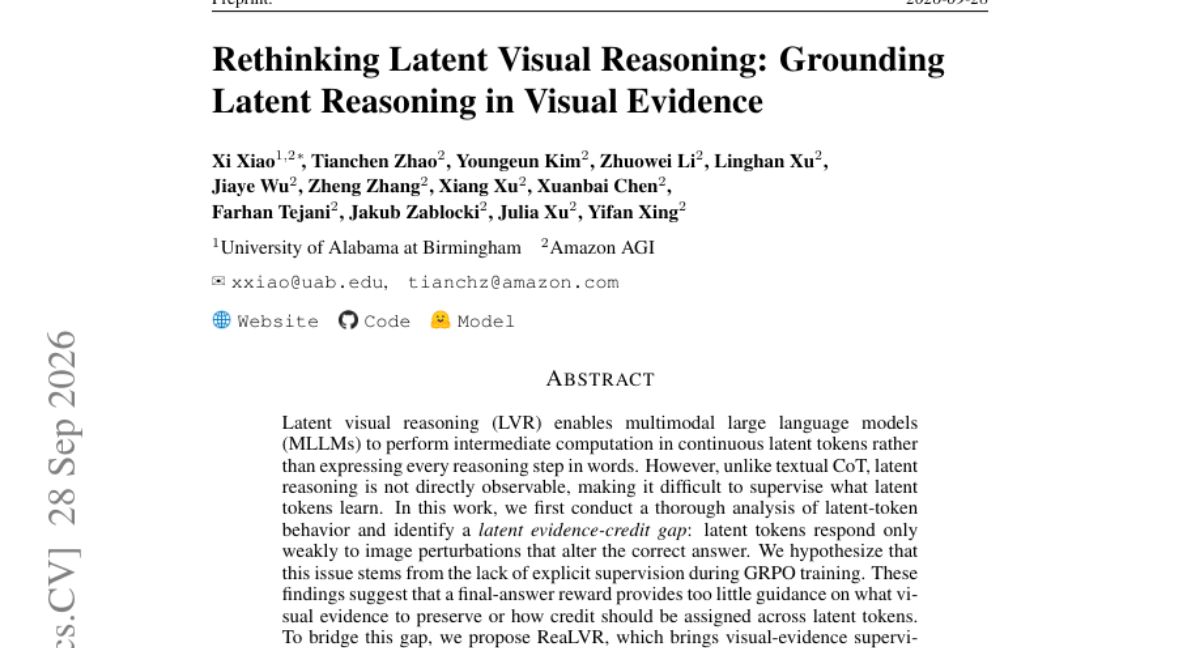
Rethinking Latent Visual Reasoning: Grounding Latent Reasoning in Visual Evidence

최근 MLLM은 텍스트 대신 연속적인 잠재 토큰을 활용하는 잠재적 시각 추론(LVR)을 통해 효율적인 중간 연산을 수행합니다. 그러나 잠재 토큰은 직접 관찰이 불가능하여 어떤 시각적 근거를 학습하는지 감독하기 어렵다는 문제가 있습니다. 연구진은 최종 정답 보상만으로는 잠재 토큰이 적절한 시각적 증거를 보존하거나 신용을 할당하는 데 한계가 있음을 발견했습니다. 이를 해결하기 위해 정답과 오답, 그리고 관련/불일치 시각 정보를 대조하여 잠재 궤적에 직접 감독을 부여하는 ReaLVR를 제안합니다. 실험 결과, ReaLVR는 다양한 모델 규모에서 기존 LVR 베이스라인을 상회하며 대규모 모델에서도 강력한 성능 향상을 입증했습니다.

2026.10.02

Rethinking Latent Visual Reasoning: Grounding Latent Reasoning in Visual Evidence

뉴스 · Reuters

Chinese hackers impersonated ex-US official to steal emails from AI experts - Reuters

중국 배후의 해커 그룹이 전직 미국 정부 관리를 사칭하는 정교한 사회 공학(Social Engineering) 공격을 통해 AI 전문가들의 이메일과 기밀 데이터를 탈취했습니다. 이번 공격은 단순한 시스템 침투를 넘어 신뢰 관계를 악용하여 타겟의 권한을 획득하는 고도화된 스피어 피싱(Spear Phishing) 기법을 보여줍니다.

2026.10.01

뉴스 · CNBC

Health insurer points finger at AI as nearly $1 billion in questionable hospital charges appear - CNBC

미국 의료 시스템 내에서 AI 기반 코딩 도구가 병원의 청구액을 인위적으로 높여 보험사에 막대한 비용 부담을 지우고 있다는 분석이 제기되었습니다. 이는 AI가 진료 효율화가 아닌 수익 극대화를 위한 '복합 코딩(Complex Coding)' 수단으로 활용되면서 발생하는 산업적 갈등을 보여줍니다.

2026.10.01