
NBC New York
Mamdani bans AI in NYC public schools for students through 8th grade - NBC New York
뉴욕시 교육청이 초·중등 학생(8학년 이하)의 생성형 AI 사용을 1년간 일시 중단하는 강력한 규제 정책을 발표했습니다. 이는 기술적 안전성과 교육적 가치를 검토하기 위한 조치로, 고등학생에게는 AI 리터러시 교육을 제공하는 이원화된 접근 방식을 취합니다.
지난 소식
이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.
23건
주요 기사와 기업의 공식 발표
NBC New York
뉴욕시 교육청이 초·중등 학생(8학년 이하)의 생성형 AI 사용을 1년간 일시 중단하는 강력한 규제 정책을 발표했습니다. 이는 기술적 안전성과 교육적 가치를 검토하기 위한 조치로, 고등학생에게는 AI 리터러시 교육을 제공하는 이원화된 접근 방식을 취합니다.
The New York Times
뉴욕시 교육청이 초등학교 및 중학교 교육 과정에서 생성형 AI 사용을 금지하는 정책을 발표했습니다. 이는 학생들의 비판적 사고 능력 저하와 데이터 프라이버시 문제를 방지하기 위한 선제적 조치입니다.
abc7ny.com
뉴욕시 교육청이 2026-27 학년도부터 초등(2-K)부터 중등(8학년) 학생들의 생성형 AI 사용을 1년간 금지하는 전면적인 정책을 발표했습니다. 이번 조치는 기술적 검증과 교육적 영향을 분석하기 위한 모라토리엄(Moratorium, 일시적 중단) 성격을 띠며, 고등학생에게는 AI 리터러시 교육을 제공하는 이원화된 전략을 취합니다.
Politico
뉴욕시 교육청(NYC Department of Education)이 초등 및 중등 학생들의 학습 과정에서 생성형 AI 사용을 전면 금지하기로 결정했습니다.
NBC News
뉴욕시 교육청이 초등학생의 AI 사용을 제한하고 고등학교 진학 전까지 약 60만 명의 학생에 대해 AI 사용을 1년간 유예하는 강력한 규제 정책을 발표할 예정입니다. 이번 정책은 기술적 도구보다 인간 중심의 교육적 가치를 우선시하며, 학생의 연령별 스크린 타임과 기기 사용을 엄격히 통제하는 데 초점을 맞추고 있습니다.
CBS News
Meta가 AI 스마트 글래스의 무단 촬영 문제를 해결하기 위해 LED 조작 방지 보안 업데이트를 실시했습니다. 사용자가 촬영 중 LED를 가려 신호를 차단하는 행위를 감지하면 카메라 기능이 자동으로 비활성화되는 메커니즘을 도입했습니다.
Axios
트럼프 행정부의 AI 전략팀 내에서 G20 국가들과의 경쟁 구도를 둘러싼 전략적 이견이 발생하며 정책 방향성이 분열되고 있습니다. 미국의 AI 패권을 유지하기 위한 규제 완화와 기술적 우위 확보 사이의 갈등이 핵심 쟁점입니다.
CNN
플로리다 대학교(University of Florida)는 Nvidia와의 협력을 통해 전 학문 분야에 AI를 통합하는 선제적인 교육 커리큘럼을 구축했습니다. 이는 단순한 컴퓨터 공학 교육을 넘어, 모든 전공의 학생들이 AI를 도구로 활용할 수 있는 'AI 리터러시' 확보를 목표로 합니다.
governor.nebraska.gov
네브래스카 주 정부가 공식 웹사이트(Nebraska.gov)에 AI Chatbot을 도입하여 시민들의 행정 서비스 접근성을 높이는 디지털 전환을 발표했습니다. 이번 조치는 공공 부문에서 LLM 기반의 인터페이스를 실무에 적용하는 선제적인 사례로 평가받습니다.
Spectrum News NY1
뉴욕시 교육 당국은 초등 및 중등 교육 과정(2K-8학년)에서 학생 대상 Generative AI 및 챗봇 사용을 전면 금지하는 새로운 교육 정책을 발표했습니다. 이번 조치는 기술적 편익보다 학생의 사고력 보호와 스크린 타임 제한에 초점을 맞추고 있으며, 고등학교 단계에서만 제한적인 AI 리터러시 교육과 파일럿 프로그램을 운영할 방침입니다.
Google DeepMind
Google DeepMind가 에이전트 워크플로우와 사이버 보안에 최적화된 차세대 모델인 Gemini 3.8 Flash 및 3.8 Flash Cyber를 발표했습니다. 이 모델들은 지능형 자동화 작업과 보안 분야에서 강력한 성능을 제공하도록 설계되었습니다.
Google DeepMind
Google DeepMind가 정부 및 신뢰할 수 있는 파트너를 대상으로 하는 Fairwind Program을 발표했습니다. 이 프로그램은 사이버 방어 도구를 활용할 수 있는 제한적 액세스 프로그램을 제공합니다.
Google DeepMind
Google DeepMind가 최신 Gemini 모델에 에이전트 방식의 비디오 이해(agentic video understanding) 기능을 도입했습니다. 이를 통해 비디오 분석의 정확도를 높이면서도 비용과 토큰 사용량을 절감할 수 있습니다.
OpenAI News
AI-native 기업들이 AI 에이전트를 활용하여 워크플로우를 운영 역량으로 전환하는 방법을 다룹니다. Basis, Clay, Exa Labs의 사례를 통해 온보딩, 계정 관리, 개발자 통합 프로세스를 개선하는 방식을 살펴봅니다.
Google Cloud AI
Google Cloud의 최신 AI 관련 발표와 혁신 사례를 소개합니다. 이번 달에 공개된 새로운 기능과 가이드를 통해 Google Cloud AI의 발전 과정을 확인할 수 있습니다.
OpenAI News
OpenAI의 새로운 모델인 Astra가 Preparedness Framework의 임계치 중 사이버 보안 역량 기준을 충족했습니다. 이번 릴리즈는 강력한 안전 장치를 포함하고 있습니다.
OpenAI News
ChatGPT가 신뢰할 수 있는 헬스케어 데이터와 연결될 수 있는 기능이 출시되었습니다. 이를 통해 의료진은 환자 맥락 및 의학 연구 등 필요한 정보를 안전하게 활용할 수 있습니다.
Anthropic News
Anthropic이 고객들과 협력하여 엔터프라이즈급 프런티어 세이프가드(Frontier Safeguards)를 개발하고 있습니다. 이는 기업 환경에 적합한 안전 장치를 구축하기 위한 노력의 일환입니다.
Anthropic News
Anthropic이 모델의 정렬(alignment) 및 보안 역량을 강화하기 위한 새로운 조치를 발표했습니다. 이번 업데이트는 더욱 안전하고 신뢰할 수 있는 AI 시스템을 구축하는 데 중점을 두고 있습니다.
Anthropic News
Anthropic이 AI 에이전트가 물리적 장치를 안전하게 제어할 수 있도록 하는 모델 하드웨어 표준(Model Hardware Standard, MHS)의 리서치 프리뷰를 공개했습니다. 이번 프리뷰는 일부 과학 연구소와 첨단 제조 기업들을 대상으로 진행됩니다.
Google Cloud AI
Google Cloud가 AI 에이전트 워크로드를 위한 새로운 FinOps 솔루션을 발표했습니다. Gemini Enterprise 앱부터 개발자 도구까지 아우르는 유연한 과금 체계와 비용 관리 기능을 제공합니다.
Google Cloud AI
Google Cloud가 특정 산업 분야를 위해 설계된 새로운 솔루션 제품군의 일환으로 Gemini Enterprise for Legal을 출시했습니다. 이 솔루션은 법률 분야에 특화된 기능을 제공하기 위해 개발되었습니다.
Qwen Blog
Qwen이 새로운 아키텍처를 적용한 멀티모달 MoE 모델인 Qwen3.8-Flash-Next를 공개했습니다. 이 모델은 차세대 Qwen4 아키텍처의 초기 프리뷰 역할을 하며, 극강의 비용 효율성을 목표로 설계되었습니다.
24건
Hacker News, GeekNews, Reddit 반응
Hacker News
LLM 학습을 위한 크롤러가 오픈소스 저장소의 리소스를 과도하게 점유하는 문제와 그로 인한 인프라 부하를 다룹니다. 데이터 오염을 피하기 위해 순수 코드를 확보하려는 AI 모델의 수요가 서버 운영에 심각한 비용을 발생시키고 있습니다.
Hacker News
Anthropic이 코딩과 지식 작업에 최적화된 신규 모델인 Claude Fable 5.1과 Claude Mythos 5.1을 발표했습니다. 비용 절감과 데이터 프라이버시 강화를 핵심 가치로 내세우며, 특히 보안과 생명과학 분야를 위한 특화 모델을 함께 공개했습니다.
Hacker News
고정 폭(Monospace) 글꼴 환경에서 텍스트 정렬 문제를 해결하기 위해 단어 선택을 정교하게 조절한 독특한 타이포그래피 사례를 소개합니다. 기술적 도구 대신 언어적 정밀함을 통해 시각적 완성도를 높인 방식이 커뮤니티의 관심을 끌고 있습니다.
Hacker News
브라우저 엔진의 다양성을 유지하기 위해 Firefox를 지지해야 한다는 주장이 제기되었습니다. 구글 크롬 독점 체제에서 벗어나 웹 생태계의 경쟁력을 유지하는 것이 핵심 과제입니다.
Hacker News
Google Play의 결제 정책 변화로 인해 1,000만 명 이상의 사용자를 보유한 Open Source 앱 AnkiDroid가 스토어 퇴출 위기에 처했습니다. Google이 501(c)(6) 면세 단체에 대한 기부 링크를 정책 위반으로 간주하면서 발생한 갈등입니다.
Hacker News
AI 회의론자 Ed Zitron의 예측 적중 여부를 두고 기술적 실현 가능성과 비즈니스 모델의 지속 가능성을 검토하는 논의입니다. AI 기업들의 막대한 인프라 비용 대비 수익 모델이 불투명하다는 점이 핵심 쟁점입니다.
Hacker News
Spotify의 무거운 성능과 UI 문제를 해결하기 위해 개발된 경량 플레이어 Fastpotify에 대한 기술적 특징과 사용자 반응을 다룹니다. 기존 소프트웨어의 복잡함 대신 가벼운 실행 환경을 지향하는 도구에 대한 커뮤니티의 평가를 담고 있습니다.
Hacker News
Playa Phone이라는 새로운 하드웨어 프로젝트가 공개되어 커뮤니티의 관심을 받고 있습니다. 개발자가 직접 참여하여 기술적 질문에 답하며 프로젝트의 배경을 공유하고 있습니다.
Hacker News
단 1.5시간 만에 학습시킨 소형 Transformer 모델이 기존 LLM 성능을 상회하는 효율성을 보여주며 주목받고 있습니다. 데이터 효율성과 모델 아키텍처 최적화가 성능 향상의 핵심임을 시사합니다.
Hacker News
기술 전문 매체 LWN의 운영 방향과 구독 모델 변화에 대한 소식을 다루고 있습니다. 독자들은 오랜 시간 신뢰를 쌓아온 LWN의 전문성과 지속 가능한 운영 모델에 대해 높은 관심을 보이고 있습니다.
GeekNews / Hada
빠른 업데이트 주기를 가진 CNCF 프로젝트들의 변화 속도와 운영 안정성 사이의 트레이드오프를 다룹니다. 기술적 부채를 최소화하면서도 보안과 최신 기능을 유지하기 위한 체계적인 릴리스 관리 전략이 중요합니다.
GeekNews / Hada
이번 모델 출시는 특정 작업 목적에 맞춘 초경량·고효율 모델의 세분화 전략을 보여줍니다. 코딩과 보안이라는 실무적 요구사항을 반영하여 AI 에이전트 시대의 기술적 토대를 마련했습니다.
GeekNews / Hada
공식 실업률과 실제 체감되는 기능적 실업 사이의 거대한 격차를 통해 노동 시장의 질적 저하를 보여줍니다. 단순한 일자리 유무를 넘어 소득과 노동 시간의 적정성을 기준으로 경제적 자립 능력을 평가하는 것이 핵심입니다.
GeekNews / Hada
광고 수익 의존도를 낮추고 콘텐츠의 독립성을 확보하려는 구독 모델이 물가 상승이라는 경제적 압박에 직면했습니다. 이는 전문 기술 매체가 지속 가능한 운영을 위해 수익 구조를 현실화하는 과정에서 발생하는 필수적인 선택입니다.
GeekNews / Hada
대규모 신분증 데이터 유출은 단순한 정보 유출을 넘어 디지털 신원 도용 범죄의 핵심 자산이 될 수 있습니다. 이번 사건은 신분증 스캔 데이터를 관리하는 서비스의 보안 취약점이 국가적 차원의 개인정보 유출로 이어질 수 있음을 시사합니다.
GeekNews / Hada
방대한 위치 데이터와 콘텐츠 메타데이터를 결합하여 가상과 현실의 공간을 연결하는 지리 정보 서비스입니다. 팬덤의 성지순례 욕구와 디지털 콘텐츠의 공간적 가치를 결합한 새로운 형태의 데이터 시각화 모델을 보여줍니다.
GeekNews / Hada
Blender의 물리적 조명 연산 방식을 CSS 환경에 이식하여 웹 요소에 깊이감을 부여하는 기술적 시도입니다. 단순한 그래픽 효과를 넘어 수학적 모델을 통해 웹 UI의 입체적 표현 방식을 새롭게 정의합니다.
GeekNews / Hada
AI 기술의 보편화로 인해 역설적으로 인간의 순수 창작물을 구분하려는 새로운 언어적 시도가 나타나고 있습니다. 이는 기술적 도구의 사용 여부가 콘텐츠의 가치를 판단하는 중요한 척도가 되었음을 시사합니다.
GeekNews / Hada
이 글은 인덱스 기반의 전통적 RDBMS가 가진 분석 성능의 한계를 열 지향 데이터베이스 기술로 해결하는 과정을 보여줍니다. 대규모 데이터 집계 작업에서 스토리지 구조와 연산 방식의 차이가 성능 격차를 어떻게 만드는지 기술적 통찰을 제공합니다.
GeekNews / Hada
스마트폰 사용이 제한된 교육 환경이라는 특수 상황을 기술적 창의성으로 해결한 사례입니다. 생체 인증 기술을 활용해 규제와 편의성 사이의 접점을 찾아낸 점이 핵심입니다.
Apple M5 Pro 환경에서 Qwen 27B 모델을 테스트한 결과, llama.cpp의 Metal 지원 강화로 인해 MLX를 사용하던 기존 방식보다 GGUF 모델의 성능이 대등하거나 더 우수하게 나타나고 있습니다. 작성자는 향후 MLX 프레임워크를 계속 사용할 이유가 있는지 의문을 제기하며 성능 최적화에 대한 의견을 구하고 있습니다.
새로운 7B 비전 모델인 SenseNova-Vision이 공개되었으며, 모델 가중치뿐만 아니라 5천만 개의 인스트럭션-응답 코퍼스와 데이터 준비 파이프라인이 함께 공개되었습니다. 이번 릴리스는 데이터셋의 투명성과 재사용성을 높였다는 점에서 주목받고 있습니다.
DeepSeek의 최신 모델인 v4 pro가 이전 모델들에 비해 벤치마크 성능이 하락한 원인과 향후 경쟁력에 대해 의문을 제기하는 글입니다. 작성자는 모델 최적화 방식의 차이와 인재 유출 가능성을 원인으로 추측하며 향후 기술 격차 회복 여부를 궁금해하고 있습니다.
오픈 소스 모델을 기반으로 한 웹 애플리케이션 빌더 개발 소식과 함께 AI 보조 개발자 및 바이브 코더들을 위한 커뮤니티 구축 계획을 발표했습니다. 개발 효율성을 높이고 새로운 코딩 문화를 공유하는 것을 목표로 합니다.
26건
읽어볼 만한 AI 연구
AI 연구
AI 튜터가 학생 맞춤형 교육을 제공하려면 학생의 반응 데이터를 수집해야 하지만, 실제 학습자를 대상으로 하는 것은 비용과 시간이 많이 듭니다. 기존의 상태 추적 모델은 설명 처리가 어렵고, LLM 역할극은 학생의 역량을 정확히 모사하지 못하는 한계가 있었습니다. 본 논문은 소량의 학생 데이터를 활용해 개별화된 시뮬레이터를 만드는 StudentSim 프레임워크를 제안합니다. 이 방식은 풀링된 학습 후 개별 학생에 맞게 특화되는 과정을 거쳐, 학생의 응답을 모사함과 동시에 튜터의 가이드에 따라 지식이 업데이트되도록 합니다. 실험 결과, StudentSim은 체스, 영어, 수학 등 다양한 도메인에서 GPT-5.4를 포함한 기존 모델보다 높은 행동 충실도와 가이드 반응성을 기록했습니다. 최종적으로 StudentSim을 보상 모델로 사용했을 때, 인간 전문가로부터 더 정확하고 개인화된 튜터가 생성됨을 입증했습니다.
AI 연구
자율주행 분야에서 범용적인 시각-언어 이해와 정밀한 주행 제어를 동시에 달성하는 것이 과제로 남아있습니다. 본 논문은 사전 학습된 VLM 아키텍처를 유지하면서 3D 인지, VQA, 모션 플래닝을 하나의 프레임워크로 통합한 Qwen-Drive-1.0을 제안합니다. 외부 BEV 인지 헤드를 통해 3D 객체 탐지 및 세그멘테이션을 수행하며, 플래닝 전문가 모듈이 공유된 VLM 표현을 바탕으로 미래 궤적을 생성합니다. 단계별 학습 방식을 통해 일반적인 시각 이해 능력과 주행 특화 역량을 동시에 확보했습니다. 실험 결과, 강력한 3D 인지 및 장면 이해 능력을 보여주었으며 다양한 루프 환경에서 경쟁력 있는 모션 플래닝 성능을 입증했습니다.
AI 연구
기존의 Looped Transformer 연구는 모델 크기를 고정하여 아키텍처의 이점과 추가 연산량 사이의 변수를 명확히 구분하지 못하는 문제가 있었습니다. 본 논문은 MoE 구조에서 토큰당 FLOPs, 파라미터 수, KV 캐시를 엄격히 일치시킨 상태에서 루핑 효과를 연구했습니다. 연구진은 중간 레이어 절반을 두 번 반복하는 SMELT(Sparse MoE Transformer, middle layers Loop Twice) 기법을 제안했습니다. 실험 결과, SMELT는 동일한 연산 예산 내에서 베이스라인보다 낮은 손실(loss)을 기록하며 효율적인 스케일링 법칙을 보여주었습니다. 특히 코드 생성 및 긴 문맥 처리에서 강점을 보였으며, 두 번째 루프가 어텐션 싱크를 줄이고 콘텐츠 관련 토큰에 집중하게 만드는 효과가 있음을 확인했습니다.

AI 연구
기존의 멀티모달 GUI 에이전트는 벤치마크 중심의 모델로 인해 실제 환경에서의 환경 커버리지 부족, 취약한 작업 구성, 신뢰할 수 없는 보상 검증 문제로 실무 적용에 한계가 있었습니다. 본 논문에서는 모바일, 웹, 데스크톱 환경에서 작동하는 범용 GUI 파운데이션 에이전트인 UI-Venus-2를 제안합니다. 이를 위해 170개 이상의 다국어 모바일 앱 및 데스크톱 OS로 환경을 확장하고, 심층 연구 파이프라인을 통해 기능 중심의 지시문을 생성하며, 시각적 키포인트와 멀티 모델 투표를 결합한 검증 체계를 구축했습니다. 또한 안전을 고려한 메커니즘을 통합하여 실행 제어력을 높였습니다. 결과적으로 UI-Venus-2는 실세계 애플리케이션을 위한 일반화 가능하고 검증 가능한 에이전트 기술을 제시합니다.
AI 연구
최근 대규모 비디오 생성 모델은 언어를 통해 캐릭터 동작과 카메라 움직임을 제어하는 능력이 나타나고 있습니다. 하지만 기존의 자연어 인터페이스는 제어의 정밀도와 시간적 일관성이 부족하다는 문제가 있습니다. 본 논문은 H3-World 프레임워크를 제안하여, 언어 지시사항을 구조화된 캐릭터/카메라 명령으로 변환하고 이를 비디오 잠재 공간(latents)에 정렬합니다. 특히 시간적 어텐션 라우팅(temporal attention routing)을 도입하여 각 명령이 의도된 시간 구간에만 작용하도록 제어 누출을 방지했습니다. 결과적으로 매우 적은 파라미터와 데이터만으로도 생성 품질을 유지하면서 정밀한 상호작용이 가능한 월드 모델을 구축했습니다.
AI 연구
로봇 조작 작업에서 데이터 부족과 일반화 성능 저하는 핵심적인 과제입니다. 기존의 액션 라벨이 포함된 로봇 데이터는 수집 비용이 높고 다양성이 부족하다는 한계가 있습니다. 이를 해결하기 위해 대규모 비디오 데이터를 활용하여 일반화 가능한 세계 모델을 학습하는 ZimaBlue 프레임워크를 제안합니다. 학습은 비디오 사전 학습, 비디오-액션 중간 학습, 타겟 로봇 특화 단계의 3단계 커리큘럼으로 진행됩니다. 또한 실시간 제어를 위해 고용량 Slow 모델과 경량 Fast 모델을 결합한 비동기식 이중 구조를 채택했습니다. 실험 결과, 대규모 비디오 데이터로 확장할수록 제로샷 성공률이 크게 향상되었으며 미학습 작업에서도 강력한 성능을 보였습니다.
AI 연구
기업의 데이터 거주성 제약으로 인해 자체 호스팅 LLM 수요가 늘면서, 여러 모델을 동시에 운영함에 따른 GPU 자원 파편화 문제가 발생했습니다. 연구진은 200개 이상의 내부 애플리케이션 트래픽을 단일 모델로 통합하기 위해 프로덕션 에러 분석을 통한 품질 격차 해소에 집중했습니다. 지시 이행, 함수 호출, 내부 작업 분포라는 세 가지 축을 기준으로 품질을 추적하고, 각 영역에 특화된 GRPO 전문가 모델을 학습시킨 뒤 SLERP 방식으로 병합했습니다. 이 방식은 도메인 간 보상 간섭 문제를 방지하며 각 실패 모드(의미론적 붕괴, 과도한 호출, 장황함)를 효과적으로 해결했습니다. 결과적으로 훨씬 더 큰 파라미터 규모의 베이스라인 모델을 능가하는 성능을 달성하며 월 1억 1,600만 건의 요청을 처리하는 데 성공했습니다.
AI 연구
멀티홉 QA에서 질문의 입도(granularity)와 검색 가능한 증거의 입도가 일치하지 않는 것이 주요 병목 현상입니다. 기존 방식은 고정된 그래프나 반복적 쿼리 재구성을 사용하지만, 언제 쿼리를 정교화해야 할지 결정하는 데 어려움이 있습니다. 본 논문은 이를 '검색 가능한 입도 발견' 문제로 정의하고, 증거 기반의 계층적 쿼리 정교화 프레임워크인 Hi-Q를 제안합니다. Hi-Q는 검색된 증거가 충분하면 노드를 종료하고, 부족하면 의존성을 유지하며 쿼리를 확장하는 방식으로 동적인 쿼리 트리를 생성합니다. 실험 결과, Hi-Q는 IRCoT 및 PropRAG와 같은 기존 SOTA 모델들을 상회하며 오픈 도메인 환경에서도 강력한 성능을 입증했습니다.
AI 연구
최근 MLLM의 시각 인지 능력은 뛰어나지만, 이를 실제 드론 제어 루프에 직접 투입하여 행동(Action)까지 수행하는 능력은 충분히 검증되지 않았습니다. 기존 방식은 모델의 결정 범위를 좁게 설정하는 경향이 있어, 본 연구는 모델의 자율성을 극대화한 DroneCATS-Agent 아키텍처와 벤치마크인 DroneCATS를 제안합니다. 연구진은 접근, 추적, 탐색, 다수 드론 명령 등 네 가지 핵심 역량을 중심으로 다양한 크기의 모델을 평가했습니다. 실험 결과, 모델의 공간 인지 능력은 준수하지만 임무 종료 시점 판단이나 프로토콜 유지 능력이 성능의 핵심 차이를 만들었습니다. 특히 소형 모델이 대형 모델보다 물리적 이동은 더 잘할 수 있으나, 임무 완수 프로토콜에서 실패하는 역설적인 현상이 관찰되었습니다.

AI 연구
통합 멀티모달 모델(UMM)은 이해와 생성 기능을 동시에 수행하지만, 두 목적 함수가 서로 시너지를 내거나 혹은 용량을 두고 경쟁할 수 있는 복잡한 관계를 가집니다. 본 연구는 사전 학습된 비전 모델 없이 구조적으로 통합된 환경에서 표현, 태스크, 시스템 수준의 관계를 조사했습니다. 연구 결과, 생성은 이해를 위한 특징을 풍부하게 하고 이해는 생성의 정렬을 강화하는 상호 보완적 관계를 보였으나, 동일한 연산 경로를 사용할 경우 한쪽이 지배하는 비대칭적 성능 저하가 발생했습니다. 이를 해결하기 위해 충돌하는 연산은 분리하되 의미적 상호작용은 유지하는 태스크 분리형 아키텍처를 제안했습니다. 실험을 통해 적절한 특화와 공유 지식 활용이 결합될 때 단순한 기능 통합을 넘어선 강력한 시너지가 발생함을 입증했습니다.
AI 연구
장기적인 복잡한 작업을 수행하는 파운데이션 모델은 정보를 축적하고 내부 상태를 유지하는 능력이 필수적입니다. 기존의 안전성 확보 방식은 외부 가드레일이나 사후 정렬(SFT)에 의존하여 모델 자체의 내재적 속성으로 만들기 어렵다는 문제가 있습니다. 이를 해결하기 위해 본 논문은 메모리 라우팅과 상태 진화를 통해 안전성을 모델 내부 연산으로 구현하는 Safin-1을 제안합니다. 핵심 아키텍처인 MARCH는 구조화된 메모리 상태를 유지하며 콘텐츠 기반 라우팅을 통해 과거 정보를 선택적으로 검색합니다. 실험 결과, 제안된 방식은 모델의 백본을 수정하지 않고도 테스트 타임에 안전 상태를 적응시킬 수 있으며 안전성 성능을 크게 향상시켰습니다.
AI 연구
에이전트 시스템 평가를 위해 LLM을 판사로 사용하는 방식이 널리 쓰이지만, 구조적 의존성이 있는 워크플로우에서의 신뢰성은 충분히 검증되지 않았습니다. 본 연구는 DAG(유향 비순환 그래프) 기반의 도구 호출 작업을 대상으로 하는 벤치마크인 AgentJudgeBench를 제안합니다. 3,808개의 인스턴스를 통해 난이도와 정답(Ground-truth) 유무에 따른 판정 성능을 분석했습니다. 실험 결과, 판정 정확도는 작업 난이도가 높아질수록 급격히 저하되며, 정답이 없을 경우 모델 크기와 상관없이 특정 성능 범위(77-82%)로 수렴하는 한계가 발견되었습니다. 또한 정답 제공이 오히려 특정 모델의 정렬을 방해하는 현상도 관찰되었습니다. 이러한 결과는 에이전트 평가 시 모델 규모보다 작업 구조와 프롬프트 전략이 더 중요함을 시사합니다.

AI 연구
Self-play 기반의 모델 진화 방식은 외부 가이드 없이는 성능 정체나 퇴보 문제를 겪기 쉽습니다. 기존 방식은 외부 데이터나 인간의 예시를 활용해 방향성을 잡았으나, 이는 외부 자원에 대한 의존성을 높입니다. 본 논문은 모델의 과거 실패 이력에서 직접 방향성을 도출하는 DiagEvo를 제안합니다. DiagEvo는 계층적 오류 원인 메모리를 통해 반복되는 오류를 추출하고, 이를 숙련도(Active/Mastered)로 관리하며 학습 커리큘럼을 생성합니다. 실험 결과, 외부 자원 없이도 수학적 추론 등 다양한 벤치마크에서 기존 SOTA 모델들을 상회하는 성능을 달었습니다.
AI 연구
LLM 기반 코딩 에이전트가 인간의 개입 없이 요구사항을 완전한 소프트웨어로 변환하는 자율 개발 연구가 활발해지고 있습니다. 기존 방식은 단발성 작업에 그치거나 지속적인 성능 개선이 어렵다는 과제가 있습니다. 본 논문은 기존 코딩 에이전트 하네스를 활용하면서도 반복적인 루프를 통해 성능을 높이는 'Harness-of-Harness(HoH)' 프레임워크를 제안합니다. HoH는 수리(repair)와 역량 성장 사이의 균형을 맞추고, 개발 범위를 검증 가능한 작은 단위로 분할하며, 독립적인 평가 체계를 유지합니다. 실험 결과, HoH는 기존 단독 하네스 대비 평균 52.25%의 성능 향상을 기록했으며, 다일(multi-day) 배포를 통해 복잡한 FPS 게임을 자율적으로 개발하는 데 성공했습니다.

AI 연구
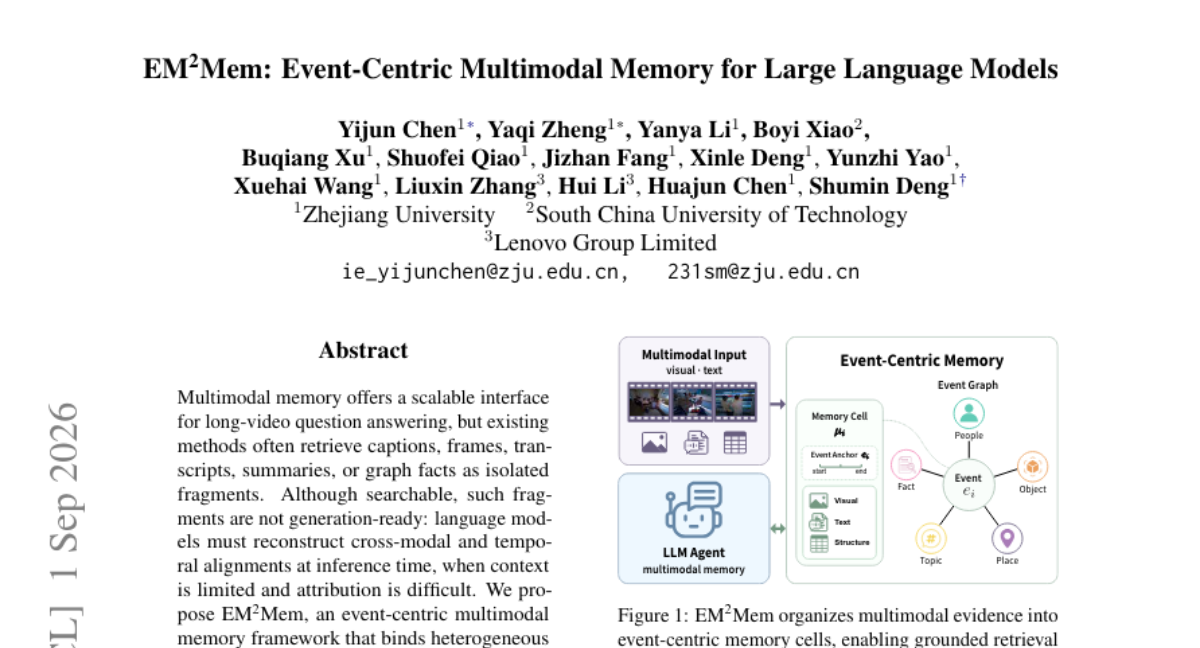
기존의 멀티모달 메모리 방식은 캡션, 프레임, 스크립트 등을 개별 조각으로 저장하여 모델이 추론 시점에 복잡한 정렬 작업을 수행해야 하는 문제가 있었습니다. 이를 해결하기 위해 제안된 EM^2Mem은 이벤트를 중심축(Anchor)으로 삼아 이질적인 증거들을 하나의 메모리 셀에 결합하는 방식을 사용합니다. 각 메모리 셀은 멀티모달 기록, 시간적 맥락, 그래프 관계, 의미적 사실 및 출처를 통합하여 관리합니다. 실험 결과, 기존 베이스라인 대비 정확도가 향상되었으며, 특히 지연 시간(Latency)을 4.67배 단축하고 추론 토큰 수를 63.66% 절감하는 성과를 거두었습니다.
AI 연구
최근 언어 모델 기반 에이전트는 메모리, 도구, 의사결정 구조를 통해 비약적인 발전을 이루었으나, 주로 한정된 태스크를 해결하는 데 초점이 맞춰져 있습니다. 하지만 실제 환경에서는 사용자 요구와 맥락이 지속적으로 변화하는 장기적인 서비스 환경이 중요해지고 있습니다. 본 논문은 이러한 지속적 에이전트를 정의하고 가이드하기 위해 '지각 중심 아키텍처(Pera)'를 제안합니다. Pera는 에이전트가 주변 환경, 내부 맥락, 과거 작업에서 발생하는 신호를 지속적으로 감지하여 새로운 생애주기 태스크를 생성하고 운영하는 구조를 가집니다. 이를 통해 기존 연구를 재정리하고 향후 적응형 지능 시스템 구축을 위한 방향성을 제시합니다.

AI 연구
멀티 에이전트 시스템에서 프롬프트는 작업 콘텐츠 생성과 실행 프로토콜(라우팅, 포맷 등)이라는 두 가지 역할을 동시에 수행합니다. 이로 인해 콘텐츠 성능을 높이려는 프롬프트 수정이 시스템의 실행 구조를 망가뜨리는 문제가 발생합니다. 연구진은 실행 프로토로는 구조화된 객체로, 작업 내용은 비구조화된 언어로 분리하는 '제어-데이터 소식 분리' 방식을 제안합니다. 이 설계는 프롬프트 최적화 과정에서 프로토콜 인터페이스가 변질되는 것을 방지합니다. 실험 결과, 다양한 워크플로우에서 프로토콜 유효성을 100% 유지하면서도 작업 성능을 향상시켰습니다.
AI 연구
전문적인 학술 콘텐츠 생성은 도메인 추론과 사실적 근거 확보 사이의 정교한 조화가 필요합니다. 기존의 주관적인 모델 기반 평가 방식은 편향성 문제를 야기할 수 있습니다. 본 연구는 대규모 학술 데이터셋과 arXiv 검색 도구를 결합한 InternReviewer 및 InternAdvocate 프레임워크를 제안합니다. 제안된 시스템은 참조 기반의 의미적 정렬, 구조적 준수, 실시간 로그를 통한 인용 검증 등 다차원적 기준을 통해 RL 보상 체계를 구축합니다. 실험 결과, 이 폐쇄 루프 프레임워크를 통해 학습된 에이전트는 추론 깊이와 인용 정확도 면에서 유의미한 향상을 보였습니다.

AI 연구
기존의 에이전트 작업은 짧은 태스크 체이닝에 집중되어 있어, 변화하는 환경과 장기 의존성을 다루는 데 한계가 있습니다. 본 논문은 1년 단위의 비즈니스 운영 시나리오를 담은 'E-Commerce Bench'를 소개합니다. 이 벤치마크는 시장 조사, 공급업체 협상, 재고 관리 등 복잡한 의사결정 과정을 포함하며, 실제 이커머스 데이터를 기반으로 동적인 이벤트를 생성합니다. 실험 결과, 18개의 최첨단 모델을 평가한 결과 특정 모델이 모든 영역을 지배하지 못함을 확인했습니다. 특히 모델별로 자산 증식 능력과 운영 효율성, 사기 방지 능력 등에서 뚜렷한 성능 차이가 나타났습니다.
AI 연구
기존의 테스트 시간 적응(TTA) 방식은 모델 파라미터 업데이트를 전제로 하지만, 이는 추론 전용 가속기나 동결된 모델 환경에서는 적용이 어렵습니다. 본 논문은 모델을 고정한 상태에서 적응할 수 있는 CASTER 방식을 제안합니다. CASTER는 소스 클래스 통계량을 판별 공간에 저장하고, 타겟 배치 모멘트를 통해 아핀 변환을 추정하여 소스 분포를 전송하는 그래디언트 프리 방식을 사용합니다. 실험 결과, CASTER는 기존 k-NN보다 적은 메모리를 사용하면서도 다양한 백본과 데이터셋에서 우수한 성능을 보였습니다. 또한, 아핀 변환의 위험성을 관리하기 위해 잔차 대 마진(residual-to-margin) 기반의 신뢰도 인증 지표를 도입하여 안정적인 적응을 지원합니다.
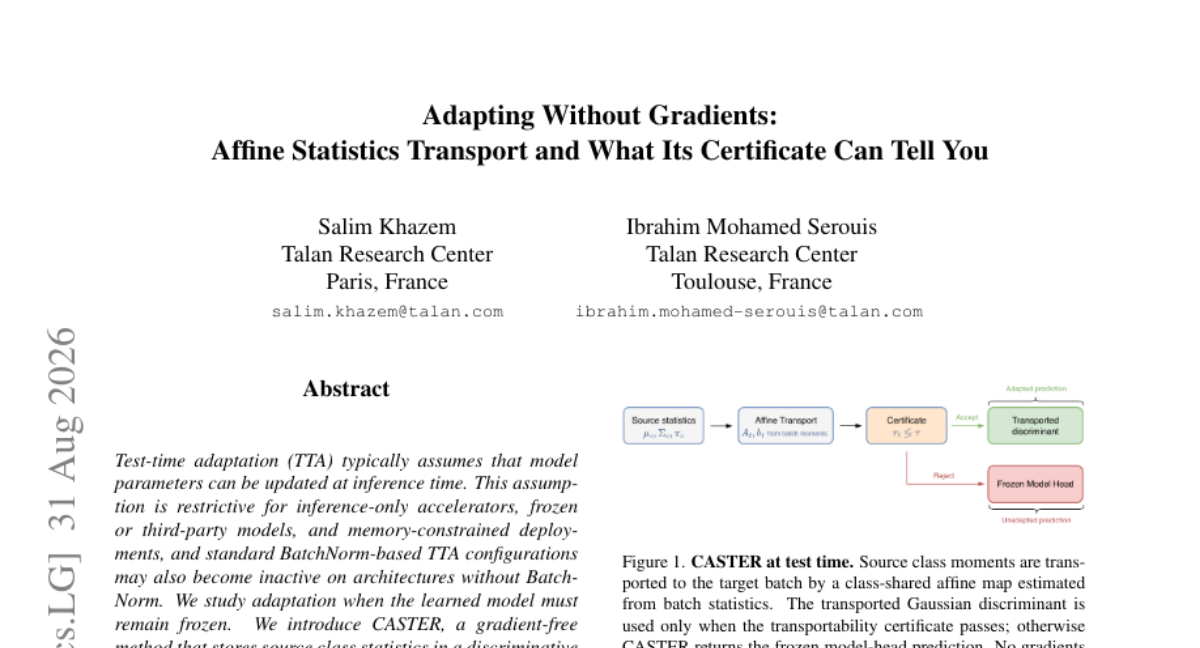
AI 연구
AI가 차세대 AI를 개발하는 R&D 과정에 투입됨에 따라 발생하는 재귀적 피드백의 특성을 연구합니다. 연구진은 기본 연구 생산성, 재귀적 피드백, 연구 난이도 증가 사이의 관계를 모델링하여 재귀적 재생산 지수(R_AI)를 도출했습니다. R_AI가 1보다 크면 개선 효과가 사이클을 거치며 증폭되는 자기 증폭 상태에 진입하고, 1보다 작으면 효과가 감쇄됩니다. 이 전이는 특정 성능 수준이 아닌 피드백 루프의 구조에 따라 결정되므로, 가시적인 가속화가 나타나기 전에도 시스템이 임계점에 도달할 수 있습니다. 또한, 개별 주체가 아닌 생태계 차원의 공유가 전체 시스템의 자기 증폭을 유도할 수 있음을 보여줍니다.
AI 연구
SAR 관측 데이터로부터 EO 이미지를 생성하는 작업은 기존의 사전 학습된 오토인코더에 의존하여 재구성 정밀도가 떨어지는 문제가 있었습니다. 이를 해결하기 위해 연구진은 SAR와 EO 재구성을 동시에 고려하여 최적의 코덱을 선택하는 ReFlowSET 프레임워크를 제안합니다. 이 방식은 무거운 사전 학습 모델 대신, 선택된 잠재 공간 내에서 작은 크기의 조건부 DiT를 처음부터 학습시킵니다. 학습 과정에서 Frozen Vision Foundation Model을 사용하여 노이즈가 포함된 EO 특징을 깨끗한 타겟 EO 표현과 정렬함으로써 의미적 가이드를 제공합니다. 실험 결과, 제안된 방법은 다양한 지각적 충실도 및 분포 지표에서 SOTA 성능을 달성했습니다.

AI 연구
기존의 멀티모달 기하학 추론은 자유 형식의 추론 과정으로 인해 의사결정 과정을 파악하기 어렵고, 최종 결과에만 의존하는 강화학습 방식은 보상 분산 문제가 발생합니다. 이를 해결하기 위해 추론 과정의 의미 단위가 학습의 비교 및 보상 할당 기준이 되는 'Credit-Addressable Reasoning'을 도입했습니다. 구체적으로는 시각적 관계를 실행 가능한 코드로 표현하는 Code-CoT와 이벤트 경계 기반의 보상 할당 방식인 CE-GRPO를 제안합니다. 실험 결과, 제안 방식은 9개의 기하학 벤치마크에서 기존 모델 및 일반 GRPO 대비 우수한 성능을 기록했습니다. 특히 추론 단계가 길고 의존성이 높은 문제에서 그 효과가 더욱 두드러졌습니다.
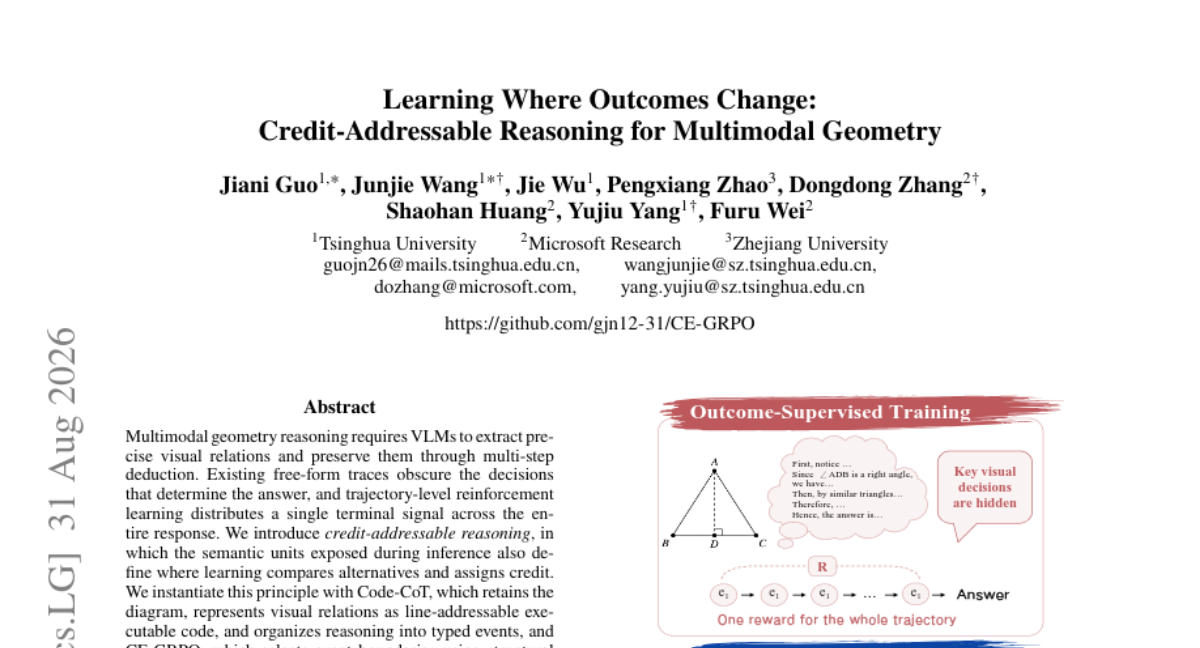
AI 연구
시스템 다이내믹스 모델을 활용하여 정치적 지배력과 대중의 동의를 수학적으로 구조화한 동적 동의 공학(DCE) 프레임워크 제안

AI 연구
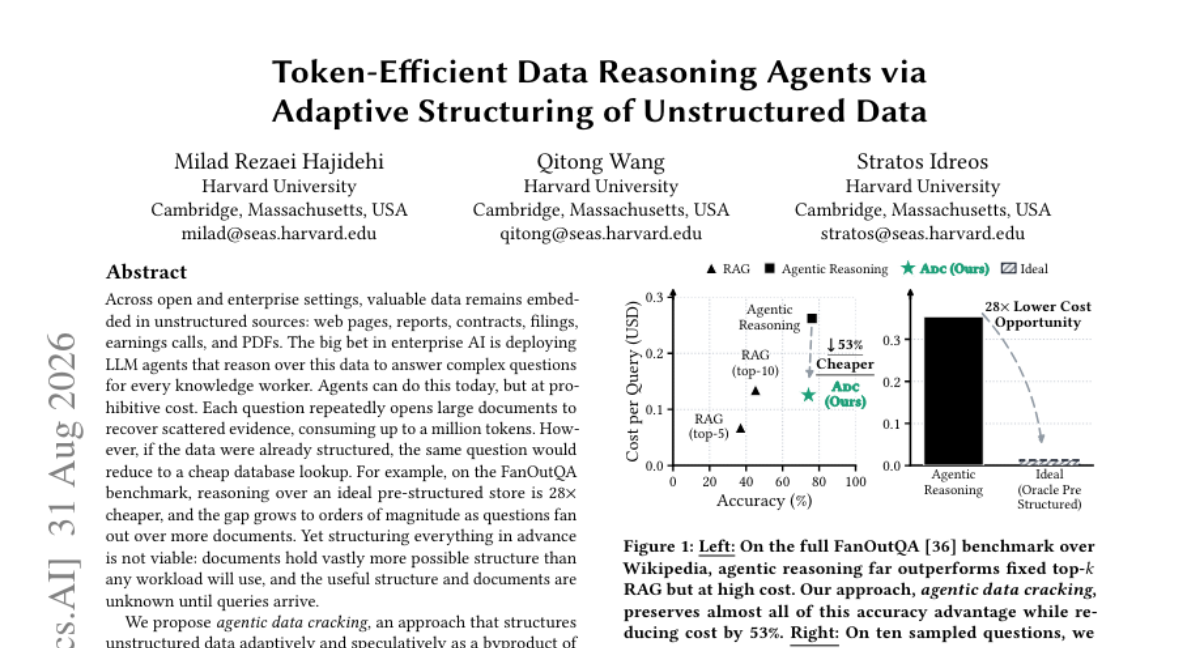
기업용 AI 에이전트가 비정형 데이터(PDF, 웹 등)를 기반으로 복잡한 질문에 답할 때, 매번 대규모 문서를 다시 읽는 방식은 막대한 토큰 비용을 발생시킵니다. 모든 데이터를 미리 구조화하는 것은 불가능하며, 어떤 구조가 유용할지 쿼리 전에는 알 수 없다는 문제가 있습니다. 이를 해결하기 위해 본 논문은 추론 과정에서 데이터 구조화를 적응적(Adaptive)이고 투기적(Speculative)으로 수행하는 'Agentic Data Cracking' 방식을 제안합니다. 에이전트가 문서를 열 때 별도의 서브 에이전트가 미래의 관련 쿼리에 유용한 구조를 미리 추출하여 저장합니다. 결과적으로 시간이 흐를수록 구조화된 데이터만으로 질문을 해결할 수 있게 되어, 정확도는 유지하면서 비용을 획기적으로 절감합니다.
AI 연구
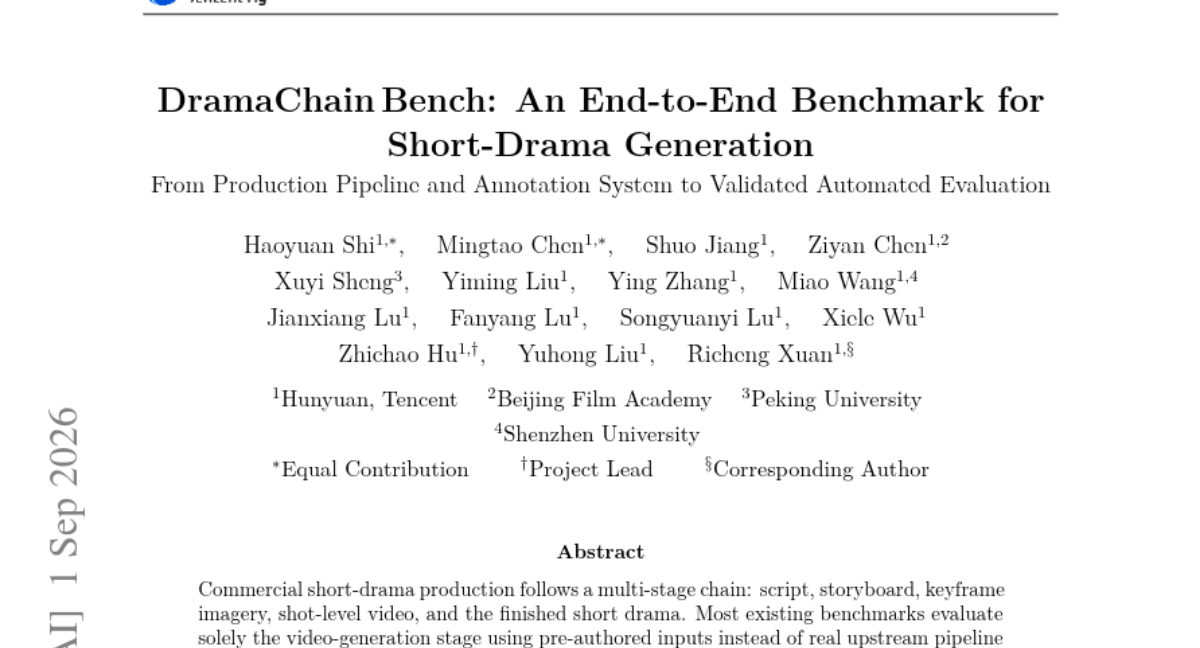
기존의 숏폼 드라마 생성 평가는 주로 최종 비디오 생성 단계에만 집중하여, 상위 단계의 의도 반영 여부나 에피소드 간 일관성 문제를 해결하지 못했습니다. 이를 해결하기 위해 대본, 스토리보드, 키프레임, 영상 생성 등 전체 제작 체인을 평가하는 'DramaChain Bench'를 제안합니다. 이 벤치마크는 63개의 세부 차원을 가진 'DramaChain Dimensions'와 전문 인력이 검증한 데이터셋을 기반으로 구축되었습니다. 또한, 자동화된 'DramaChain Agentic Judge'를 통해 인간의 평가와 높은 상관관계(PLCC 0.918)를 보이는 자동 평가 시스템을 구현했습니다. 실험 결과, 상위 단계의 결함이 최종 품질에 연쇄적으로 영향을 미침을 확인하였으며, 자동화된 에이전트가 인간의 평가를 효과적으로 대체할 수 있음을 입증했습니다.
30건
이날 공개된 제품과 도구



6건
새 모델과 주요 평가 결과
HF Model Trending
unsloth에서 공개한 Qwen3.8-Flash-Next-GGUF 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 image-text-to-text 파이프라인을 지원하는 GGUF 포맷 모델입니다.
HF Model Trending
BreezeBlue에서 공개한 Breeze-TTS-2 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 text-to-speech 파이프라인을 지원하는 음성 합성 모델입니다.
HF Model Trending
DeepSeek-AI에서 출시한 DeepSeek-V4-Flash-Vision-Exp 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 이미지와 텍스트를 결합하여 처리하는 멀티모달 기능을 제공합니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.