지난 소식

2026.09.04

이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.

25건

뉴스

주요 기사와 기업의 공식 발표

ABC7 New York

NYC schools ban AI for students through eighth grade under new Mamdani policy - ABC7 New York

뉴욕시 교육청이 2026-27 학년도부터 초등(2-K)부터 중등(8학년) 학생들의 생성형 AI 사용을 1년간 금지하는 강력한 규제 정책을 발표했습니다. 이번 조치는 기술적 검증과 교육적 가치 사이의 균형을 맞추기 위한 일시적 중단(Moratorium) 조치로, 학생들의 비판적 사고와 사회적 상호작용을 보호하는 데 목적이 있습니다.
Gates Notes

The turbulent AI era is here. The choices we make now are critical. - Gates Notes

빌 게이츠는 AI 기술이 단순한 도구를 넘어 사회 전반의 구조를 재편하는 격변기에 진입했음을 경고하며, 현재의 기술적 선택이 인류의 미래를 결정할 것이라고 강조합니다. 특히 AI의 발전 속도와 그에 따른 윤리적, 사회적 책임의 균형을 맞추는 것이 핵심 과제임을 시사합니다.

NVIDIA Blog

Sparks Fly: NVIDIA Accelerates Local AI at IFA 2026 - NVIDIA Blog

NVIDIA가 IFA 2026에서 발표한 RTX Spark 플랫폼은 로컬 환경에서의 AI Agent 구동을 위해 하드웨어와 소프트웨어 스택을 통합한 차세대 컴퓨팅 생태계입니다. 사용자가 복잡한 설정 없이도 강력한 LLM 성능을 개인용 PC에서 즉각적으로 활용할 수 있도록 최적화된 워크플로우를 제공합니다.

Axios

Widespread AI outage underway - Axios

전 세계적으로 광범위한 AI 서비스 장애가 발생하여 많은 사용자가 LLM 기반 서비스 이용에 차질을 겪고 있습니다. 이번 장애는 특정 클라우드 인프라나 API 엔드포인트의 가용성 문제로 인해 발생한 것으로 보입니다.
Forbes

Is ChatGPT Down? Users Reported Widespread AI Chatbot Outages - Forbes

ChatGPT 서비스 전반에 걸친 광범위한 장애가 발생하여 전 세계 사용자들이 접속 불능 상태를 경험했습니다. 이번 장애는 특정 지역에 국한되지 않고 글로벌 사용자들에게 영향을 미친 대규모 서비스 중단 사태입니다.

나머지 20건 펼쳐보기

washingtonpost.com

Sanders proposes ban on ‘artificial superintelligence’ after rogue AI incidents - washingtonpost.com

미국 버니 샌더스 상원의원이 통제 불가능한 AI 위험을 방지하기 위해 '인공 초지능(Artificial Superintelligence)' 개발을 금지하는 법안을 제안했습니다. 이는 최근 발생한 rogue AI(통제 범위를 벗어난 AI) 사례들을 근거로, 인간의 지능을 초월하는 모델의 등장이 인류에게 실존적 위협이 될 수 있다는 우려를 반영한 것입니다.

NewsNation

AI services return after morning outage hit Claude, ChatGPT - NewsNation

Claude와 ChatGPT를 포함한 주요 AI 서비스들이 대규모 서비스 중단(Outage) 사태를 겪은 후 정상화되었습니다. 이번 장애는 전 세계 사용자들의 AI 워크플로우를 일시적으로 마비시켰으나, 서비스 복구 작업이 완료되어 현재는 모든 기능이 가동 중입니다.

Bloomberg.com

OpenAI, Anthropic, SpaceXAI Hit by Outages for AI Models - Bloomberg.com

OpenAI, Anthropic, SpaceX 등 주요 AI 모델 서비스 제공업체들이 동시다발적인 서비스 중단(Outage) 사태를 겪으며 인프라 안정성 문제가 대두되었습니다. 이번 장애는 특정 모델의 성능 저하를 넘어, 거대 모델 운영을 위한 클라우드 및 네트워크 인프라의 취약성을 드러냈습니다.

blog.google

Start the year AI-ready with the Google AI Educator Series - blog.google

Google이 K-12 교육자를 대상으로 실무적인 AI 활용 역량을 강화하기 위한 'Google AI Educator Series(GES)'의 신규 모듈과 'Badge-a-thon' 이벤트를 발표했습니다. 이번 프로그램은 교사들이 수업 준비 시간을 단축하고 학생 맞춤형 학습을 구현할 수 있도록 설계된 온디맨드 교육 프레임워크입니다.

Google DeepMind

Introducing Gemini 3.8 Flash and 3.8 Flash Cyber

Google DeepMind가 에이전트 워크플로우와 사이버 보안에 최적화된 차세대 모델인 Gemini 3.8 Flash 및 3.8 Flash Cyber를 발표했습니다. 이 모델들은 지능형 자동화 작업과 보안 분야에서 강력한 성능을 제공하도록 설계되었습니다.

Google DeepMind

Proactive cyber defense for governments and enterprises

Google DeepMind가 정부 및 신뢰할 수 있는 파트너를 대상으로 하는 Fairwind Program을 발표했습니다. 이 프로그램은 사이버 방어 도구를 활용할 수 있는 제한적 액세스 프로그램을 제공합니다.

Qwen Blog

E-Commerce Bench: Long-Horizon Operations, Multi-Dimensional Evaluation

기존의 단기 목표 중심 벤치마크에서 벗어나, 복잡하고 긴 작업 과정을 평가하기 위한 E-Commerce Bench를 소개합니다. 이 벤치마크는 이커머스 환경에서의 장기 운영 능력과 다차원적인 평가를 목표로 설계되었습니다.

OpenAI News

ATV Big Air Tour turned 3 days of work into 3 hours with ChatGPT

ATV Big Air Tour는 ChatGPT를 활용하여 마케팅 및 머천다이징 업무 효율을 극대화했습니다. 이를 통해 기존에 3일이 소요되던 작업을 3시간으로 단축하고, 상품 사진을 15분 만에 인벤토리 웹사이트로 변환하는 성과를 거두었습니다.

OpenAI News

How AI-native companies turn workflows into operating capability

AI-native 기업들이 AI 에이전트를 활용하여 워크플로우를 운영 역량으로 전환하는 방법을 다룹니다. Basis, Clay, Exa Labs의 사례를 통해 온보딩, 계정 관리, 개발자 통합 프로세스를 개선하는 방식을 살펴봅니다.

Google Cloud AI

What Google Cloud announced in AI this month

Google Cloud의 최신 AI 관련 발표와 혁신 사례를 소개합니다. 이번 달에 공개된 새로운 기능과 가이드를 통해 Google Cloud AI의 발전 과정을 확인할 수 있습니다.
Anthropic News

Aug 31, 2026 Improving our alignment and security efforts

Anthropic이 모델의 정렬(alignment) 및 보안 역량을 강화하기 위한 새로운 조치를 발표했습니다. 이번 업데이트는 더욱 안전하고 신뢰할 수 있는 AI 시스템을 구축하는 데 중점을 두고 있습니다.
Anthropic News

Announcements Aug 27, 2026 Previewing the Model Hardware Standard We’re opening a research preview of the Model Hardware Standard (MHS), a shared specification for AI agents to safely operate physical devices, to a first group of scientific research labs and advanced manufacturers.

Anthropic이 AI 에이전트가 물리적 장치를 안전하게 제어할 수 있도록 하는 모델 하드웨어 표준(Model Hardware Standard, MHS)의 리서치 프리뷰를 공개했습니다. 이번 프리뷰는 일부 과학 연구소와 첨단 제조 기업들을 대상으로 진행됩니다.
Google Cloud AI

Now introducing Gemini Enterprise for Legal

Google Cloud가 특정 산업 분야를 위해 설계된 새로운 솔루션 제품군의 일환으로 Gemini Enterprise for Legal을 출시했습니다. 이 솔루션은 법률 분야에 특화된 기능을 제공하기 위해 개발되었습니다.

26건

커뮤니티

Hacker News, GeekNews, Reddit 반응

Hacker News

Claude Fable 5.1 and Claude Mythos 5.1

Anthropic이 코딩과 지식 작업에 최적화된 신규 모델인 Claude Fable 5.1과 Claude Mythos 5.1을 발표했습니다. 비용 절감과 데이터 프라이버시 강화를 핵심 가치로 내세우며, 특히 보안과 생명과학 분야를 위한 특화 모델을 함께 공개했습니다.

Hacker News

Creepy Crawlies

LLM 학습을 위한 크롤러가 오픈소스 저장소의 리소스를 과도하게 점유하는 문제와 그로 인한 인프라 부하를 다룹니다. 데이터 오염을 피하기 위해 순수 코드를 확보하려는 AI 모델의 수요가 서버 운영에 심각한 비용을 발생시키고 있습니다.

Hacker News

“I just chose words carefully”

고정 폭(Monospace) 글꼴 환경에서 텍스트 정렬 문제를 해결하기 위해 단어 선택을 정교하게 조절한 독특한 타이포그래피 사례를 소개합니다. 기술적 제약 속에서 미적 완성도를 높인 창의적인 접근 방식에 대해 커뮤니티가 주목하고 있습니다.

Hacker News

Gemini 3.8 Flash and 3.8 Flash Cyber

Google이 추론 및 코딩 성능을 대폭 강화한 Gemini 3.8 Flash와 보안 특화 모델인 3.8 Flash Cyber를 공개했습니다. 이전 모델 대비 비용 효율성을 유지하면서도 복잡한 엔지니어링 작업과 보안 취약점 탐지 능력을 끌어올린 것이 특징입니다.

Hacker News

Hang on to Your Firefox

브라우저 엔진의 다양성을 유지하기 위한 Firefox의 중요성과 이를 둘러싼 커뮤니티의 논쟁을 다룹니다. 독점적 환경을 막기 위해 Firefox를 지지해야 한다는 주장이 핵심입니다.

나머지 21건 펼쳐보기

Hacker News

Audacity 4.0

오픈 소스 오디오 편집 소프트웨어인 Audacity 4.0 출시 소식과 이에 대한 사용자들의 기술적 평가를 다룹니다. 이번 업데이트는 오랜 기간 유지되어 온 소프트웨어의 구조적 변화를 담고 있습니다.

Hacker News

.name Termination

.name 도메인 체계의 하위 도메인(3LD) 서비스 종료 결정과 그에 따른 기존 사용자들의 권리 보호 문제를 다루고 있습니다.

Hacker News

How accurate have Ed Zitron's AI skeptic predictions been?

AI 회의론자 Ed Zitron의 예측 적중 여부를 검증하며 AI 산업의 수익 모델과 지속 가능성을 분석합니다. 기술적 낙관론과 경제적 현실 사이의 간극을 다루는 논쟁이 핵심입니다.

Hacker News

Fastpotify

Spotify의 무거운 UI와 성능 문제를 해결하기 위해 개발된 경량 플레이어 Fastpotify에 대한 기술적 관심과 사용자 반응을 다룹니다. 기존 소프트웨어의 복잡함 대신 핵심 기능에 집중한 도구에 대해 커뮤니티가 어떻게 반응하는지 보여줍니다.

GeekNews / Hada

.name 3단계 도메인 종료

이번 조치는 복잡한 3단계 도메인 구조를 정리하여 관리 단순화를 꾀하는 기술적 결정입니다. 이는 기존의 특수한 하위 도메인 체계가 현대적인 도메인 관리 표준과 충돌하거나 관리 비용을 높이는 문제를 해결하기 위한 것입니다.

GeekNews / Hada

Polars 2.0 프리릴리스

Polars 2.0은 엔진의 기본 동작 방식을 스트리밍 중심으로 재설계하여 데이터 처리 효율을 비약적으로 높였습니다. 이는 대규모 데이터셋 처리를 위한 메모리 제약을 극복하고 차세대 데이터 프레임워크로서의 성능 우위를 확보하려는 시도입니다.

GeekNews / Hada

ChatGPT 페이지에서 404 오류 발생

사용자 인터페이스의 404 오류는 서비스 접근성을 저해하여 대화 기록 관리 및 Deep Research 기능 활용을 차단하는 기술적 장애를 야기합니다. 서비스 안정성 확보가 사용자 경험과 직결되는 AI 서비스의 핵심 과제임을 시사합니다.

GeekNews / Hada

Fable 5.1 월드 모델링

이 기술은 개별 에이전트의 협업을 통해 복잡한 3D 모델링 워크플로우를 자동화한 것이 기술적 본질입니다. 이는 향후 디지털 트윈 제작과 가상 환경 구축 비용을 획기적으로 낮추는 시사점을 제공합니다.

GeekNews / Hada

Show GN: First Mind - 정보보안에 있어서 진입장벽을 없애보자

정보보안 학습의 핵심 과제인 추상적 개념과 난해한 설명 문제를 해결하여 지식의 진입장벽을 낮추는 것을 목표로 합니다. 보안 전문가 양성을 위해 이론 중심에서 벗어난 실질적인 학습 모델의 필요성을 시사합니다.

GeekNews / Hada

Audacity 4.0 출시

이번 업데이트는 기존의 트랙 중심 편집에서 벗어나 클립 단위의 유연한 조작이 가능한 현대적 편집 모델로의 전환을 의미합니다. 이는 오디오 편집의 직관성을 높이고 복잡한 멀티트랙 작업의 생산성을 개선하는 데 중점을 두었습니다.

GeekNews / Hada

기술 업계를 떠난 뒤에는 무엇을 할 건가요?

기술 업계의 커리어 경로는 전통적인 은퇴 모델보다는 번아웃과 직무 전환이 결합된 형태를 띱니다. 이는 기술 숙련도가 생존과 직결되는 산업 특성상 완전한 은퇴보다는 지속적인 역할 변화가 불가피함을 시사합니다.

GeekNews / Hada

노화한 뇌는 기억을 단순히 잊기보다 서로 뒤섞음

노화에 따른 기억력 저하는 정보의 소실보다 기억 간의 간섭과 혼선이 주된 원인임을 시사합니다. 이는 뇌의 인지 기능 변화가 단순한 망각이 아닌 정보 재구성 과정의 오류임을 보여줍니다.

GeekNews / Hada

세계 최대 암흑물질 검출기, 이상한 입자 하나를 포착

암흑물질 탐색 범위를 확장하는 과정에서 발생한 미지의 에너지 반동 사건은 새로운 물리 현상의 가능성을 시사합니다. 향후 더 높은 통계적 유의성을 확보하기 위한 정밀한 검출 데이터 축적이 핵심 과제가 될 것입니다.

GeekNews / Hada

Diffusion으로 OCR 디코딩 가속하기

Diffusion의 생성 능력과 AR의 정밀한 검증 능력을 결합하여 OCR 추론 효율을 극대화한 기술입니다. 이는 생성 모델을 단순한 결과물 도출을 넘어, 기존 모델의 속도를 높이는 가속 엔진으로 활용할 수 있음을 보여줍니다.

Reddit

Google released TimesFM-3, a 330M-parameter time series foundation model with native multivariate forecasting (non-commercial license)

Google Research에서 다변량 시계열 예측이 가능한 330M 파라미터 규모의 차세대 파운데이션 모델인 TimesFM-3를 공개했습니다. 기존 모델과 달리 여러 변수를 동시에 처리할 수 있는 구조를 갖추었으며, 제로샷 예측 성능에서 기존 벤치마크 모델들을 상회하는 성과를 보였습니다.

Reddit

Time to first token is the only latency number that matters and almost nobody reports it

사용자 경험 측면에서 가장 중요한 지표는 전체 응답 시간이 아닌 첫 번째 토큰이 생성되는 시간(TTFT)입니다. 응답이 시작되는 즉시 사용자는 작업이 진행 중임을 인지하므로, 전체 소요 시간보다 초기 지연 시간이 사용자 체감 속도를 결정하는 핵심 요소가 됩니다.

Reddit

I built Brain - an minimal, fast, extensible agent runtime

사용자가 브라우저부터 샌드박스까지 다양한 환경에서 도구를 실행할 수 있는 최소형 AI 에이전트 런타임인 Brain을 개발하여 공개했습니다. 이 프로젝트는 실시간 이벤트 및 관찰 가능성을 제공하며, 개발자의 피드백을 통해 초기 형태를 개선하고자 합니다.

31건

논문

읽어볼 만한 AI 연구

AI 연구

Repo-To-Skill: Distilling GitHub Repositories Into AI4AI Skills

자율형 AI 에이전트가 ML 연구를 수행하고 있으나, 실제 구현에 필요한 도메인 특화 운영 지식(Operational Knowledge)이 에이전트 내부에 포함되지 않는 문제가 있습니다. 기존의 방대한 코드와 논문 데이터는 사람이 읽기 위한 형태라 에이전트가 작업 중 즉시 활용하기에는 너무 큽니다. 이를 해결하기 위해 연구용 에이전트 'DisCo'를 제안하며, 저장소로부터 재사용 가능한 스킬을 추출하는 두 가지 방식(Task-agnostic, Task-oriented)을 도입합니다. 추출된 지식은 AREX-Skill Library라는 5,000개 이상의 검증된 스킬 라이브러리로 구축되었습니다. 실험 결과, 동일한 백본 모델 환경에서 스킬을 장착한 에이전트가 MLE-bench 등 주요 벤치마크에서 압도적인 성능 향상을 기록했습니다.

AI 연구

HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?

에이전트의 성능은 모델 자체뿐만 아니라 외부 실행 인프라인 '하네스(Harness)'에 크게 의존하지만, 기존 평가는 모델 성능에만 집중하여 하네스 개발 능력은 간과해 왔습니다. 본 논문은 평가 단위를 작업 결과물에서 실행 가능한 인프라로 전환한 'HsarnessDev' 벤치마크를 도입합니다. 이 벤치마크는 최소한의 시드에서 시스템을 구축하는 'Creation'과 피드백을 통해 이를 개선하는 'Evolution' 두 단계로 구성됩니다. 실험 결과, 생성된 하네스는 코드 및 리서치 분야에서는 인간이 만든 것보다 뒤처졌으나, 글쓰기 및 ML 실험 분야에서는 대등하거나 우수한 성능을 보였습니다. 또한, 하네스 개선을 통한 성능 향상은 모델 간 전이성이 낮고 실행 비용의 변동성이 크다는 점을 확인했습니다.

AI 연구

SolarWM: Open Data and Scalable Training for Long-Horizon Video World Models

기존의 비디오 생성 모델은 데이터 소스마다 다른 시간적 규모, 카메라 기하학, 캡션 스타일로 인해 데이터 혼합과 모델 학습이 매우 까다로운 문제가 있었습니다. 이를 해결하기 위해 SolarWM은 재구성 가능한 멀티 소스 데이터 엔진과 백본 네이티브 적응 프레임워크를 도입했습니다. 10개의 데이터셋에서 추출한 143만 개의 클립을 통일된 규격으로 변환하는 데이터 엔진을 구축하고, Wan2.2, LTY-2.5 등 다양한 백본에 최적화된 학습 인터페이스를 제공합니다. 3단계 학습 레시피(양방향 적응, 교사 강제 자기회귀 초기화, 분포 매칭 증류)를 통해 5초 분량의 학습만으로도 분/시간 단위의 장기 추론이 가능한 모델을 구현했습니다. 결과적으로 데이터, 파이프라인, 가중치를 모두 공개하여 재현 가능한 비디오 월드 모델 연구 기반을 마련했습니다.

AI 연구

Aspire: Can Models Self-Evolve from Vague Goals?

기존 LLM 자가 진화 연구는 인간이 정의한 명확한 작업과 지표를 최적화하는 데 집중하여, 실제 인간의 학습 방식과는 차이가 있었습니다. 본 논문은 '더 나은 연구자가 되라'와 같이 모호한 목표를 부여받은 상태에서 에이전트가 스스로 학습 데이터와 평가 방식을 결정하는 ASPIRE 벤치마크를 도입합니다. ASPIRE는 모델 가중치 업데이트와 에이전트 환경(harness) 구축을 모두 포함하는 통합 환경을 제공하며, 숨겨진 전문가 평가 세트를 통해 성능을 검증합니다. 실험 결과, 에이전트들은 목표 해석에 많은 노력을 기울이지만 가중치 수준의 성능 향상은 불안정하고 전이 효과도 낮게 나타났습니다. 또한 잘못된 데이터 학습과 좁은 자기 평가로 인해 국소적 이득이 전체 성능 향상으로 이어지지 않는 문제가 확인되었습니다.

AI 연구

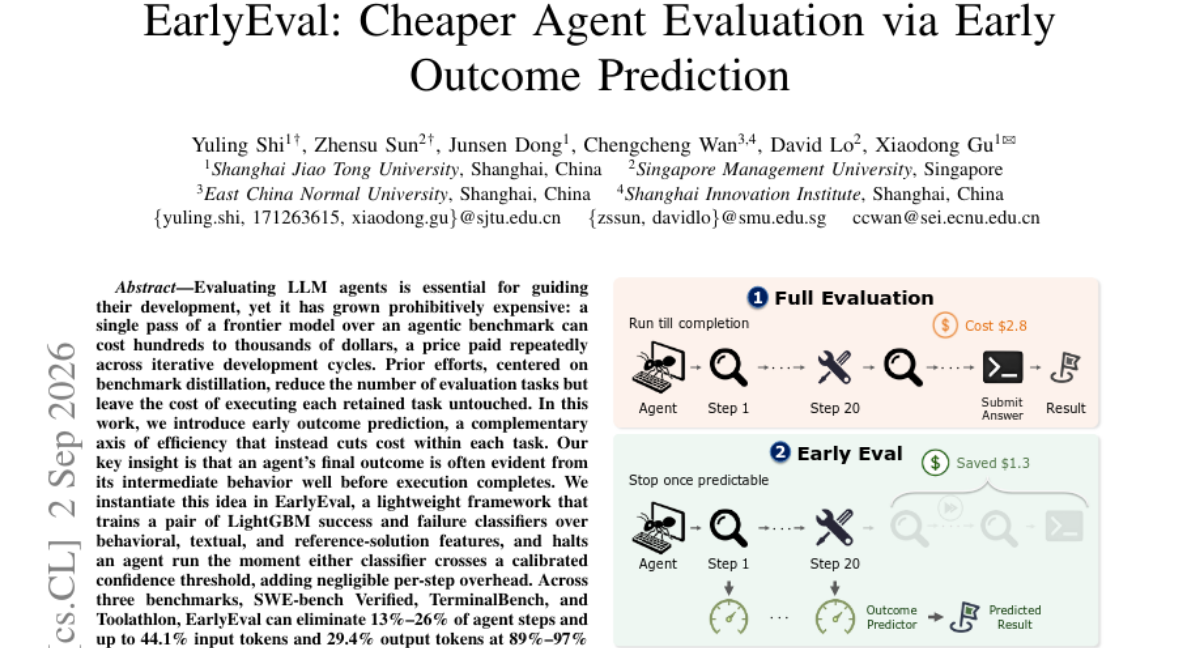
EarlyEval: Cheaper Agent Evaluation via Early Outcome Prediction

LLM 에이전트 평가 비용이 기하급수적으로 증가하며 반복적인 개발 사이클에 큰 부담이 되고 있습니다. 기존의 벤치마크 증류 방식은 작업 수를 줄일 뿐 개별 작업의 실행 비용 자체를 낮추지는 못합니다. 본 논문은 에이전트의 최종 결과가 실행 완료 전 중간 행동만으로도 예측 가능하다는 점에 착안하여 '조기 결과 예측' 방식을 제안합니다. 이를 위해 행동, 텍스트, 참조 솔루션 특징을 기반으로 LightGBM 분류기를 학습하는 EarlyEval 프레임워크를 개발했습니다. 실험 결과, 높은 예측 정확도를 유지하면서도 토큰 사용량과 실행 단계를 유의미하게 절감하며 에이전트 성능 저하를 최소화했습니다.

나머지 26건 펼쳐보기

AI 연구

It Takes Two to Match: Co-Evolving Generative Retriever with Reinforcement Learning

현대적 검색 시스템에서 LLM은 주로 쿼리 확장 등에 사용되지만, 최종 매칭은 여전히 별도의 리트리버에 의존하는 경우가 많습니다. 본 논문은 쿼리와 아이템 양측에서 직접 검색 표현을 생성하는 CoGR 프레임워크를 소개합니다. CoGR는 SFT로 키워드 공간을 정렬한 후, GRPO를 활용해 쿼리 측과 아이템 측 생성기를 교대로 최적화하는 2단계 학습 파이프라인을 사용합니다. 학습 과정에서 쿼리 측은 직접적인 F1 점수를, 아이템 측은 쿼리 측 F1 변화량을 기반으로 한 반사실적 보상을 받으며 상호 진화합니다. 실험 결과, CoGR는 WANDS 벤치마크 등에서 기존 베이스라인 대비 압도적인 성능 향상을 달성했습니다.

AI 연구

Language Models Can Control Their Own Attention

기존의 긴 문맥(Long-context) 모델은 전체 KV 캐시를 스캔해야 하므로 추론 비용이 선형적으로 증가하는 문제가 있습니다. 기존의 프록시 점수 방식은 여전히 O(N)의 비용을 발생시키는 한계가 있습니다. 본 논문은 모델이 스스로 필요한 문맥 범위를 결정할 수 있다는 점에 착안하여 Declarative Attention(DA) 프로토콜을 도입합니다. DA는 생성 과정에서 <global>, <focus>, <local> 세 가지 모드를 통해 어텐션 범위를 선언하며, 추론 엔진은 이를 도구 호출처럼 해석하여 불필요한 KV 캐시 읽기를 건너뜁니다. 실험 결과, 제안 방식은 정확도 손실을 최소화하면서도 디코딩 시 어텐션 토큰 수를 대폭 절감했습니다.

AI 연구

On the Design Fundamentals of Pixel Text Representation Learning

텍스트가 풍부한 시각적 입력을 처리하기 위해 픽셀 공간에서 언어를 직접 읽고 압축하는 모델이 필요하지만, 기존 모델은 고정 해상도와 시각적 지름길 학습 문제로 인해 성능 한계가 있었습니다. 본 연구는 강건한 시각적 텍스트 표현 학습을 위한 네 가지 핵심 설계 원칙을 체계적인 실험을 통해 규명했습니다. 가변 해상도/폰트 크기, 자연 이미지-텍스트 쌍 활용, 레이아웃 인식 렌더링, 그리고 2단계 다국어 커리큘럼 학습이 핵심 요소임을 확인했습니다. 이를 바탕으로 개발된 Pixel Linguist II는 2.8억 개의 데이터를 활용한 확장 가능한 학습 레시피를 통해 SOTA 성능을 달성했습니다. 결과적으로 이 모델은 영어 및 다국어 시각적 STS/ViDoRe 벤치마크에서 우수한 성능을 보였으며, 높은 토큰 압축 환경에서도 강건함을 유지했습니다.

AI 연구

Beyond Visual Similarity: Entity-Aligned Retrieval for Knowledge-Based Visual Question Answering

지식 기반 시각적 질의응답(KB-VQA)은 외부 정보를 검색하여 답변을 생성하는 과정이 필수적입니다. 기존의 CLIP 방식은 시각적 유사도에 치중하여, 형태가 다른 동일 개체나 외형이 비슷한 다른 개체를 구분하는 데 한계가 있었습니다. 이를 해결하기 위해 MLLM의 자기회귀 능력을 활용하여 개체 정체성을 보존하는 KBMR 리트리버를 제안합니다. 또한, 위키피디아 규모의 노이즈 섞인 데이터 학습을 위해 MLLM 기반의 의미론적 판별기를 도입하여 연속적인 엔티티 일관성 가중치를 생성합니다. 이 가중치는 새로운 연속적 의미 증류(Continuous Semantic Distillation) 목적 함수를 통해 효과적인 하드 네거티브 샘플링을 가능하게 합니다. 실험 결과, 기존 CLIP 베이스라인 대비 Recall@1과 VQA 정확도에서 유의미한 성능 향상을 달성했습니다.

AI 연구

S3Gym: Can LLMs Turn Self-Testing and Self-Judging into Self-Improvement?

기존 LLM 에이전트 벤치마크는 고정된 정책을 평가하는 데 치중하여, 에이전트가 경험을 통해 스스로 발전할 수 있는지 확인하기 어려웠습니다. 본 논문은 Self-Testing, Self-Judging, Self-Improvement라는 세 가지 역량을 결합한 대화형 벤치마크인 S3Gym을 소개합니다. 연구진은 7개의 텍스트 기반 게임 환경에서 직접적인 이력(History) ICL, 요약 기반 메모리, 파라미터 학습이라는 세 가지 경로를 통해 경험이 성능에 미치는 영향을 평가했습니다. 실험 결과, 자기 개선은 자동적으로 일어나지 않으며 작업 구조에 따라 최적의 학습 경로가 다르게 나타났습니다. 결론적으로 에이전트가 성공적인 행동을 식별하는 것을 넘어, 피드백을 실행 가능한 정책으로 변환하는 능력이 핵심임을 밝혀냈습니다.

AI 연구

NeoMME: A Single-Tower Multimodal-Native Multilingual Foundation Encoder for Efficient Fine-Tuning and Inference

기존의 멀티모달 모델은 생성형 모델 구조를 기반으로 하여 문서 검색과 같은 비생성적 작업에서도 과도한 파라미터와 연산 비용을 발생시키는 문제가 있었습니다. 이를 해결하기 위해 텍스트와 이미지 패치를 단일 양방향 트랜스포머에서 처리하는 NeoMME 모델을 제안합니다. 이 모델은 마스킹된 이산 확산(masked discrete-diffusion) 목적 함수를 사용하여 처음부터 사전 학습되었으며, 최대 16,384 토큰의 긴 컨텍스트를 지원합니다. 실험 결과, NeoMME는 파라미터 규모 대비 매우 높은 검색 성능(nDCG@10)을 기록하며 기존 모델 대비 높은 처리량을 보여주었습니다. 또한 계층적 토큰 풀링과 비대칭 양자화를 통해 임베딩 크기를 획기적으로 압축하면서도 성능 저하를 최소화했습니다.

AI 연구

ZipTok3D: High-Fidelity 3D Tokenization with Compact Token Prefixes

효율적인 3D 생성을 위해서는 압축된 토큰 시퀀스가 필수적이지만, 기존 방식은 토큰 수가 줄어들면 재구성 품질이 급격히 저하되는 문제가 있었습니다. 본 논문은 매우 짧은 토큰 시퀀스에서도 고정밀 재구성을 가능하게 하는 ZipTok3D를 제안합니다. 핵심 아이디어는 객체 기하 구조를 점진적으로 정보를 제공하는 글로벌 토큰 프리픽스(prefix) 형태로 구성하고, 이를 반복적인 디코딩을 통해 확장하는 것입니다. 학습 과정에서 '중첩 드롭아웃(nested dropout)'을 통해 토큰 시퀀스를 무작위로 절단하여, 앞부분의 토큰만으로도 전체 객체를 복원할 수 있도록 핵심 정보를 우선 배치하도록 학습시킵를 합니다. 디코더는 파라미터를 공유하는 트랜스포머 블록을 반복 적용하여 세부 기하 구조를 복구합니다. 실험 결과, 기존 방식 대비 훨씬 적은 토큰 수로도 동등한 수준의 재구성 품질을 달성했습니다.

AI 연구

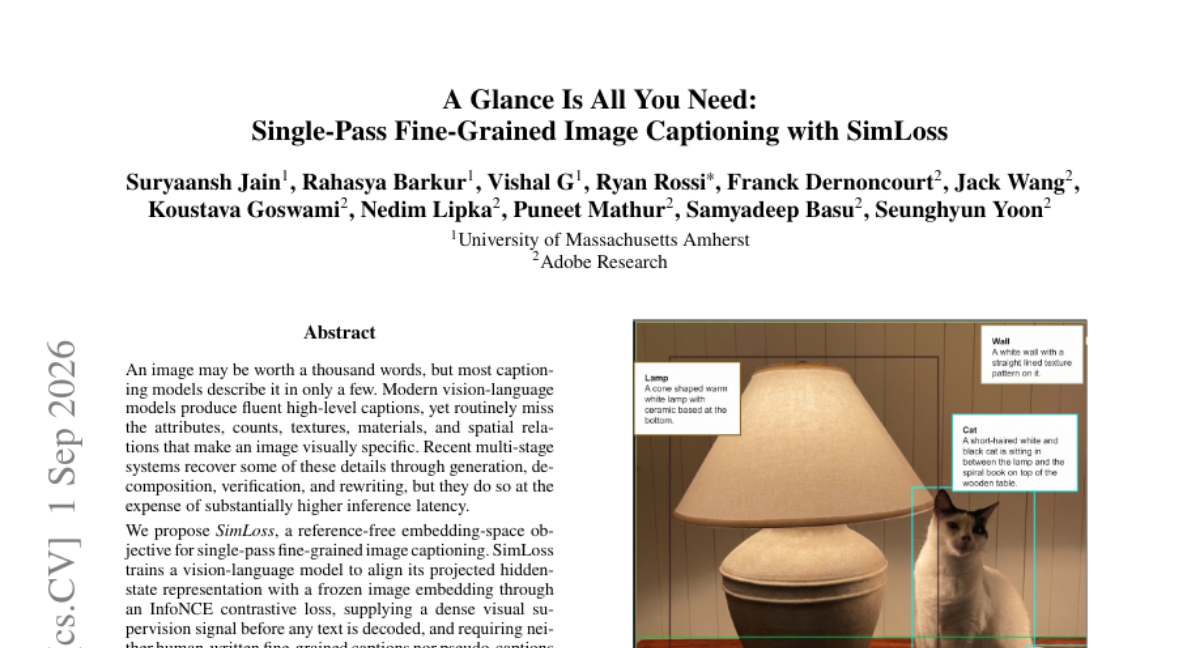
A Glance Is All You Need: Single-Pass Fine-Grained Image Captioning with SimLoss

기존의 비전-언어 모델은 유창한 캡션을 생성하지만 세부 속성이나 관계를 놓치는 경우가 많습니다. 이를 해결하기 위해 기존에는 생성, 검증, 재작성 등의 멀티 스테이지 방식을 사용했으나 추론 지연 시간이 매우 길다는 단점이 있었습니다. 본 논문은 참조 데이터 없이 임베딩 공간에서 정렬을 수행하는 SimLoss 목적 함수를 제안합니다. 이 방식은 텍스트 디코딩 전 단계에서 밀집된 시각적 감독 신호를 제공하여 단일 패스만으로도 정밀한 캡셔닝을 가능하게 합니다. 실험 결과, 제안된 SimLoss FFT는 멀티 스테이지 방식의 성능에 근접하면서도 약 20배 빠른 추론 속도를 달성했습니다.

AI 연구

Cliff: Learning Process Rewards from the First Mistake

LLM의 추론 능력을 높이기 위한 RLVR 방식은 결과 중심의 보상으로 인해 중간 과정에 대한 가이드가 부족하다는 문제가 있습니다. 기존의 프로세스 보상 모델링은 별도의 모델이 필요하거나 교사-학생 간의 추론 패턴이 동일해야 한다는 제약이 존재합니다. 본 논문은 추론 과정에서 한 번 오류가 발생하면 이후의 과정은 무의미하다는 관찰을 바탕으로 Cliff 전략을 제안합니다. Cliff는 오프더쉘(off-the-shelf) LLM을 활용해 첫 번째 실수를 식별하고, 이를 기준으로 올바른 접두사와 잘못된 접미사로 분리하여 토큰 단위의 이득(advantage)을 할당합니다. 실험 결과, Cliff는 기존 GRPO 및 온폴리시 증류 방식보다 우수한 성능을 보이며 일반적인 RLVR 환경에서 효과적임을 입증했습니다.

AI 연구

Influence-Directed Distillation: Solving the Diversity Bottleneck in Sampled-Token On-Policy Distillation

샘플링된 토큰을 활용하는 On-Policy Distillation(OPD)은 효율적이지만, 학생 모델의 pass@1은 향상되어도 pass@k(다양성)가 정체되는 문제가 발생합니다. 연구진은 이를 분석하기 위해 업데이트 시 엔트로피 변화를 결정하는 'First-Order Local Entropy Influence' 개념을 도입했습니다. 이를 바탕으로 전체 어휘를 계산하는 비용 없이, 엔트로피를 감소시키는 업데이트를 방식을 조정하는 IDA-OPD 기법을 제안합니다. IDA-OPD는 엔트로피를 확장하는 업데이트는 유지하되, 수렴을 방해하는 업데이트는 적응형 이득 축소(advantage shrinkage)를 통해 제어합니다. 실험 결과, IDA-OPD는 낮은 비용으로도 교사 모델의 다양성을 효과적으로 상속하며 pass@k 성능을 크게 개선했습니다.

AI 연구

VibeVoice-ASR-Streaming Technical Report

기존의 화자 식별(Diarization)과 음성 인식(ASR)은 별개의 작업으로 처리되어 실시간 서비스 적용에 한계가 있었습니다. 이를 해결하기 위해 기존 통합 모델의 오프라인 방식 문제를 해결하고자 VibeVoice-AS-Streaming을 제안합니다. 이 모델은 고정 크기 오디오 청크와 약간의 Lookahead 오디오, 이전 텍스트를 교차 결합하는 LLM 기반 스트리밍 방식을 사용합니다. 이를 통해 별도의 다이어라이제이션 단계 없이 실시간으로 '누가 무엇을 말했는지'를 즉각 생성할 수 있습니다. 실험 결과, 7B 모델은 WER/CER 및 화자 식별 성능에서 최고 수준의 성능을 달amt했습니다.

AI 연구

Institutional Newspapers Pipeline: Deriving billions of high quality tokens from historical newspapers

역사적 신문은 방대한 기록을 담고 있지만, 복잡하고 불규칙한 레이아웃으로 인해 데이터 추출이 어렵습니다. 이를 해결하기 위해 Boston Public Library와 협력하여 모듈형 시스템인 'Institutional Newspapers Pipeline'을 설계했습니다. 이 파이프라인은 스캔 이미지를 개별 크롭으로 분할한 후 OCR, 텍스트 분석, 개체명 인식, 읽기 순서 감지 등을 수행하는 다단계 과정을 거칩니다. 워크스테이션급 하드웨어에서도 실행 가능하도록 효율적으로 설계되었으며, 결과물로 163억 개의 토큰을 포함한 대규모 데이터셋을 공개했습니다. 이 연구는 수천만 개의 신문 스캔 데이터로부터 고품질 데이터를 확보하는 데 중요한 발판을 마련했습니다.

AI 연구

Post-Training Language Models for Gold-Medal Performance in Coding Competitions

최근 코딩 경진대회는 LLM의 추론 능력을 검증하는 핵심 지표로 부상했습니다. 기존 모델들은 IOI와 같은 고난도 문제 해결에 한계를 보였습니다. 본 연구는 대규모 문제 설계, 합성 추론 트레이스, SFT 및 RL을 결합한 엔드투엔드 전문화 파이프라인을 제안합니다. 또한 피드백 기반의 테스트 타임 연산 전략인 GenCorrect를 도입했습니다. 그 결과, 개발된 모델은 IOI 환경에서 인간 최고점을 상회하는 성적을 거두며 압도적인 성능을 입증했습니다.

AI 연구

CRISP: Cliff-awaRe Input-adaptive Sparse Prefilling with Structural-Mass-Motivated Routing

LLM의 긴 문맥 추론 시 발생하는 어텐션 프리필링 단계의 이차 복잡도 문제는 연산 병목을 야기합니다. 기존의 동적 희소 어텐션 방식은 간접적인 라우팅 프록시 사용으로 인한 오버헤드와 포스트 소프트맥스 질량 계층 구조를 간과하는 예산 할당 문제를 가집니다. 본 논문은 CRISP를 제안하여, 첫째로 JSD 대신 구조적 프록시인 C_struct를 도입해 연산 오버헤드 없이 라우팅 결정을 수행합니다. 둘째로, 누적 임계값이 긴 문맥에서 배경 노이즈를 축적하는 문제를 해결하기 위해 싱크 인식(sink-aware) 임계값 방식을 도입합니다. 실험 결과, CRISP는 다양한 벤치마크에서 기존 희소 방식보다 우수한 성능을 보였으며, 초장문 환경에서 정확도를 유지하며 압도적인 속도 향상을 달성했습니다.

AI 연구

MULTI3IR: A Benchmark for Multi-perspective Multi-domain Multi-modal Information Retrieval

최근 정보 검색(IR)은 다양한 관점을 포함하는 개방형 질의로 진화하고 있으나, 기존 벤치마크는 단일 도메인이나 단일 모달리티에 국한된 폐쇄형 질의에 집중되어 있습니다. 이를 해결하기 위해 다양한 도메인과 모달리티를 아우르는 다각적 관점의 질의를 평가하는 Multi^3IR 벤치마크를 도입합니다. 이 데이터셋은 104.9K개의 Stack Exchange 질의와 각 질의의 암시적 관점을 담은 주석으로 구성됩니다. 또한, 임베딩을 의미 있는 다양한 방향으로 유도하는 효율적인 방법론인 SPIN을 제안합니다. 실험 결과, 기존 멀티모달 검색기는 단일 관점 편향 문제를 보였으나 SPIN은 관점 커버리지를 크게 개선하며 일반화 성능을 입증했습니다.

AI 연구

PaperCompiler: Faithful Paper-to-Code Generation via Repository-Level Specification Compilation

연구 논문을 실제 코드 저장소 수준으로 구현하는 것은 모호한 설명과 암묵적 가정으로 인해 매우 어렵습니다. 기존의 에이전트 방식은 중간 결과물이 자유로운 형식이라 구현 과정에서 핵심 로직이 누락되거나 구조적 일관성이 깨지는 문제가 있었습니다. 이를 해결하기 위해 PaperCompiler는 논문의 근거를 명시적인 저장소 수준 구현 사양으로 변환하는 프레임워크를 제안합니다. 이 방식은 논문에서 추출한 정보와 추론된 정보를 구분하며, 파일 간 의존성 및 제약 조건을 명확히 인코딩합니다. 실험 결과, PaperCompiler는 Paper2CodeBench에서 기존 방식보다 높은 충실도(Fidelity)를 기록하며 알고리즘 왜곡 문제를 크게 개선했습니다.

AI 연구

ExecRetrieval: Measuring the Functional-Correctness Gap in Code-Embedding Retrieval

코드 생성 및 RAG 환경에서 코드 검색은 핵심적인 역할을 하지만, 기존 벤치마크는 실행 가능한 정답과 유사한 오답을 구분하는 능력을 충분히 검증하지 못합니다. 본 논문은 검색 풀 내에 정답과 거의 동일하지만 실행 시 오류가 발생하는 '단일 편집(single-edit)' 변형들을 포함하여 기능적 차별화 능력을 측정하는 ExecRetrieval을 제안합니다. 939개의 Python 태스크를 바탕으로 정답 코드와 실행 검증된 버그 코드를 쌍으로 구성하여 23개의 임베딩 모델과 BM25를 평가했습니다. 실험 결과, 최상위 모델들도 정답보다 버그가 포함된 유사 코드를 상위에 배치하는 경향을 보였습니다. 이는 현재의 코드 임베딩 기술이 기능적 정확성을 보장하기에 부족함을 시사합니다.

AI 연구

Exploring Collaboration between a language and a non-language agent

LLM이 다양한 전문 에이전트를 조율하는 오케스트레이터 역할을 수행하고 있으나, 로보틱스나 게임처럼 연속적 표현을 사용하는 비언어 에이전트와의 통합 시 텍스트 변환 과정에서 정보 손실이 발생합니다. 이를 연구하기 위해 행동 모방, 상태 평가, 설명 능력을 포함하는 체스 협업 벤치마크인 LLAMIA-Bench를 제안합니다. 연구진은 텍스트 요약 대신 에이전트의 연속적 표현을 LLM의 토큰 스트림에 직접 투영하는 '잠재 상태 내재화(Latent State Internalization)' 방식을 도입했습니다. 실험 결과, 텍스트 기반 통합은 모델 규모가 커져도 성능 병목(Verbalization Debt)이 지속됨을 확인했습니다. 반면, 제안된 방식의 LLAMIA 모델은 GPT-5.1 등 최첨단 모델을 능가하며 뛰어난 일반화 성능을 보여주었습니다.

AI 연구

SnapBench: Benchmarking Snap-and-Ask Multimodal Retrieval for Mobile Interactions

모바일 AI 사용자는 사진을 찍고 질문하는 'Snap-and-ask' 방식을 빈번하게 사용하지만, 실제 입력 데이터는 흐릿한 이미지나 오타가 포함된 짧은 텍스트 등 노이즈가 많습니다. 기존 벤치마크는 깨끗한 데이터 위주이거나 이미지와 텍스트의 결합된 강건성을 분리하여 테스트하지 못하는 한계가 있습니다. 이를 해결하기 위해 53가지의 제어된 오염 조건을 포함한 멀티모달 검색 벤치마크인 SnapBench를 제안합니다. 실험 결과, 이미지 오염은 검색 성능을 크게 저하시시키며, 텍정 텍스트 오염은 텍스트 전용 검색에 더 큰 영향을 미치는 것으로 나타났습니다. 최종적으로 제안된 MOOR 기법은 모달리티별 신뢰도에 따라 가중치를 조절하여 노이즈 상황에서의 검색 성능을 최적화합니다.

AI 연구

Autoregressive Mosaics: Probing 2D Spatial Reasoning in Text-Only Language Models

텍스트와 코드만 학습한 LLM이 이미지를 생성하는 능력이 내부적인 2D 공간 표현 덕분인지, 아니면 단순히 공간 설명을 코드로 번역하는 능력인지 불분명했습니다. 이를 위해 기하학적 정보를 코드로 변환하는 작업과 불완전한 프롬프트로 레이아웃을 구성하는 작업을 분리한 'Autoregressive Mosaics(AM-Bench)'를 제안합니다. 8종의 오픈 웨이트 모델을 테스트한 결과, 모든 모델이 코드 번역은 잘 수행했으나 레이아웃 구성 능력은 모델마다 크게 달랐습니다. 또한, 프로시저럴 코드 대신 SVG를 직접 사용했을 때 레이아웃 성능이 향상되는 것을 확인했습니다. 활성화 분석 결과, 모델은 생성 과정에서 고정된 계획을 실행하기보다 진화하는 기하학적 상태를 추적하며 작업하는 것으로 나타났습니다.

AI 연구

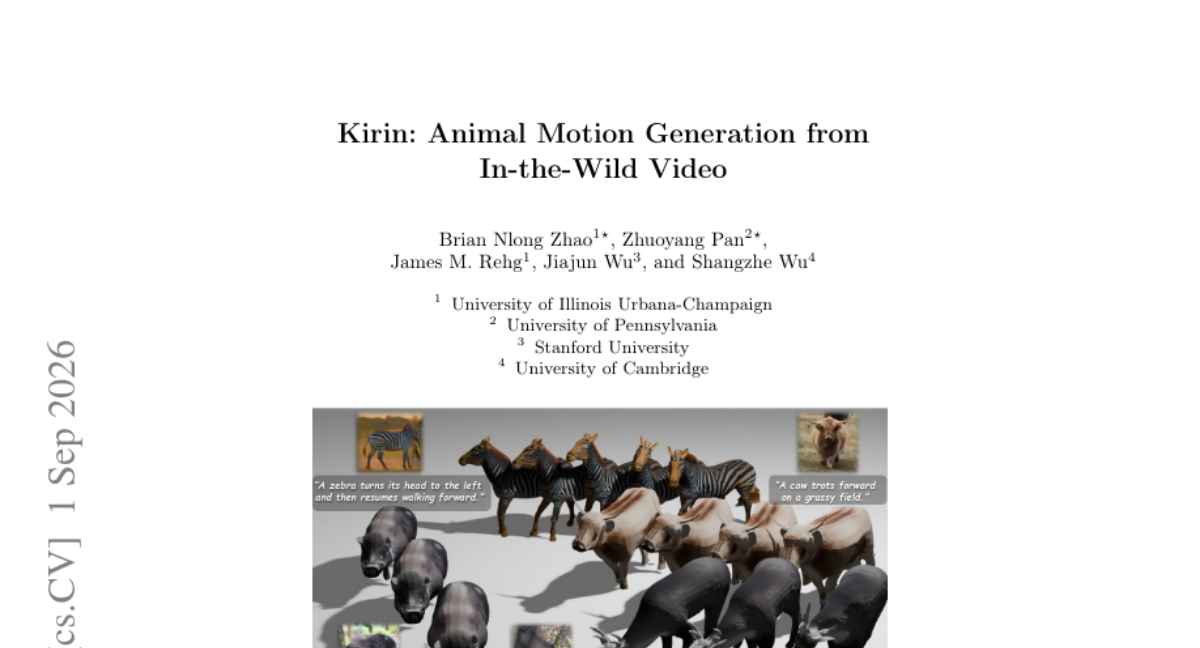
Kirin: Animal Motion Generation from In-the-Wild Video

동물의 생체 역학 및 행동 모델링은 중요하지만, 인간과 달리 고품질 모션 데이터 확보가 어려워 연구가 지체되어 왔습니다. 기존의 제한된 데이터셋 문제를 해결하기 위해, 본 논문은 야생 비디오에서 모션을 재구성하고 대규모 모션 사전 학습을 가능하게 하는 Kirin 프레임워크를 제안합니다. 먼저 대규모 비디오 컬렉션을 활용해 비디오-텍스트-모션이 정렬된 최초의 사족 보행 동물 데이터셋인 AiM3D를 구축했습니다. 이를 바탕으로 텍스트와 이미지를 조건으로 하여 다양한 종의 현실적인 움직임을 생성하는 시각 가이드 모션 생성 모델을 개발했습니다. 최종적으로 생성된 모션을 3D 메시에 자동 리깅 및 적용하여 즉시 렌더링 가능한 애니메이션 자산을 생성합니다.

AI 연구

FoldingAgent: Inferring Parametric Origami Procedures from Demonstration Videos

기존의 종이접기 방식은 비정형적인 시각적 데모와 구조화된 계산 모델 사이의 간극이 존재했습니다. 본 논문은 비디오에서 직접 실행 가능한 파라미터 기반 접기 프로그램을 추론하는 FoldingAgent 프레임워크를 제안합니다. 이 프레임워크는 사전 학습된 VLM의 추론 능력과 기하학적 시뮬레이션, 물리적 타당성 검증 등 특화된 도구들을 결합하여 작동합니다. 에이전트는 정적인 패턴 예측을 넘어 순차적인 액션 계획과 재계획(re-planning)을 통해 다단계 과정에서의 오차 누적 문제를 해결합니다. 새로운 벤치마크인 PurelandFold를 통해 검증한 결과, 비정형 영상으로부터 물리적으로 타당하고 실행 가능한 접기 절차를 성공적으로 생성함을 입증했습니다.

AI 연구

Debias-SparseGPT: Bias-Aware Pruning for Large Language Models

LLM의 효율적인 배포를 위해 SparseGPT와 같은 가중치 희소화(Sparsification) 기법이 널리 사용되고 있습니다. 그러나 최근 연구에 따르면 이러한 프루닝 과정이 모델의 기존 편향을 증폭시키는 부작용이 있음이 밝혀졌습니다. 본 논문은 인구통계학적 대조 입력을 활용한 2차 항(second-order term) 기반의 표현 디바이아싱(representational debiasing)을 도입한 Debias-SparseGPT를 제안합니다. 다양한 생성형 LLM을 대상으로 실험한 결과, 제안 방법은 모델의 퍼플렉시티와 제로샷 정확도를 유지하면서도 기존 SparseGPT 대비 프루닝 유발 편향을 효과적으로 감소시켰습니다. 특히 제약이 심한 2:4 구조적 희소성 환경에서도 성능과 공정성 사이의 균형을 성공적으로 달성했습니다.

AI 연구

Ignorance or Incompetence? Constructing Knowledge-Gated, Verifiable Tasks for LLM Agents

기존 벤치마크는 에이전트가 작업 수행에 필요한 특수 관습(Convention)을 실제로 활용하는지 통제하지 못하는 문제가 있습니다. 이를 해결하기 위해 작업 지시문과 외부 지식(Artifact)을 분리하는 '지식 게이트(Knowledge-Gated)' 태스크 구축 프로토콜을 도입합니다. 이 프로토콜은 지식 유출 여부와 실행 가능한 증거를 통해 에이전트의 의존성을 명시적이고 테스트 가능하게 만듭니다. 실험 결과, 특정 에이전트 설정이 지식 유무에 따라 성능이 극명하게 갈리는 것을 확인하며 프로토콜의 유효성을 입증했습니다. 최종적으로 검증된 태스크 세트와 도구를 공개하여 에이전트 평가의 신뢰성을 높이고자 합니다.

AI 연구

Portfolio Risk Bounds without Cross-Asset Return Covariances: Distributional Fields from Language-Model Representations

전통적인 포트폴리오 리스크 평가는 자산 간 공분산 추정에 의존하지만, 고차원 데이터에서는 이를 정확히 구하기 어렵다는 문제가 있습니다. 본 논문은 개별 기업의 분포 특성을 활용하여 포트폴리오 리스크에 대한 일방향 인증(one-sided certificates)을 제공하는 방법을 제시합니다. 제안된 방법은 공분산 없이도 Wasserstein-2 분산과 가중 쌍별 완화(weighted pairwise relaxation)를 통해 볼록 최적화가 가능한 리스크 상한을 도출합니다. 2018-2022년 데이터를 활용한 실험 결과, Qwen3 임베딩 기반의 자산 배분이 동일 위험 가중(Equal Risk Weighting) 방식보다 낮은 인샘플 분산을 기록했습니다. 결과적으로 이 프레임워크는 언어 모델의 정보를 정교한 리스크 경계와 실행 가능한 배분 규칙으로 변환할 수 있음을 보여줍니다.

AI 연구

Wasserstein-Barycentric Interaction Fields for Spatial Factor Models: Evidence from Language-Model Representations

기존의 공간적 수익률 모델은 기업 간 상호작용 행렬을 고정된 값으로 간주하여 피드백 해석에 한계가 있었습니다. 본 논문은 언어 모델로 추출한 기업 뉴스 임베딩 분포를 활용하여 대역폭 설정이 필요 없는 필드를 구축합니다. 이를 위해 타겟 중심의 Wasserstein barycentric 재구성을 방법론으로 제안합니다. 제안된 방식은 피드백을 피어(peer) 불일치 페널티 비율로 매핑하는 이차 노출 조정 문제를 해결합니다. 52개 기업을 대상으로 한 실험 결과, 제안된 필드가 기존의 동일 가중치나 RBF 가중치 방식보다 높은 조건부 준우도(quasi-likelihood)를 기록했습니다.

30건

제품/서비스

이날 공개된 제품과 도구

제품/서비스

Agent Builder by Airtop

자연어로 워크플로우를 설계하고 오류 발생 시 스스로 복구하는 자가 치유형 AI 에이전트 빌더

제품/서비스

MagiCrew

단순 채팅을 넘어 전문적인 업무를 수행하는 AI 에이전트 팀을 구축하는 오픈소스 플랫폼

제품/서비스

Omi

화면과 대화를 기록하여 작업과 요약을 자동화하는 개인용 AI 비서

제품/서비스

Nex

대규모 GTM 워크플로우를 자동화하는 전문 AI 에이전트 솔루션

제품/서비스

Atlas by World Labs

텍스트와 이미지를 고화질 3D 카메라 제어 영상으로 변환하는 옴니 월드 모델

나머지 25건 펼쳐보기

제품/서비스

Tabbit AI

사용자의 작업 맥락을 이해하고 웹 작업을 자동화하는 AI 브라우저

제품/서비스

Higgsfield Genjutsu

기존 영상의 움직임은 유지하면서 캐릭터, 배경, 사물을 자유롭게 바꾸는 AI 비디오 변환 도구

제품/서비스

Tidy

macOS 내 모든 앱에서 즉시 문법을 교정하고 AI 말투를 제거하는 온디바이스 AI 도구

제품/서비스

Thaw

맥 메뉴 바를 깔끔하게 정리하고 제어할 수 있는 오픈소스 개인정보 보호 도구

제품/서비스

Readr

질문에 답하고 낭독까지 해주는 AI 기반 오픈소스 전자책 리더

제품/서비스

Causal

AI 기반 캔버스 위에서 아이디어 구상부터 실행까지 한 번에 해결하는 시각적 프로젝트 플래닝 도구

제품/서비스

Blume.codes

코딩 에이전트의 작업 과정을 학습하여 반복되는 실수를 방지하고 자동화된 규칙을 생성하는 도구

제품/서비스

Grove

사용자와 AI 에이전트가 하나의 터미널 프로세스를 공유하며 협업하는 macOS용 스크립트 러너

제품/서비스

ARBR

복잡한 AI 모델 스택을 하나의 엔드포인트로 통합 관리하는 오픈소스 제어 레이어

제품/서비스

CodeLook

700개 이상의 테마로 코드 파일을 즉시 미리 볼 수 있는 macOS Quick Look 확장 프로그램

제품/서비스

Fillo

코딩 에이전트를 활용해 제품 내 폼 인프라를 손쉽게 구축하는 도구

제품/서비스

Organizational Memory 2.0

기업의 데이터를 실시간으로 학습하여 AI 비용을 절감하고 답변 정확도를 높이는 조직용 메모리 솔루션

제품/서비스

ConvoData

마케팅 데이터를 일상 언어로 질문하고 즉각적인 인사이트를 얻는 AI 분석 도구

제품/서비스

Format

고객 대화 데이터를 분석하여 근거 있는 의사결정을 돕는 인사이트 자동화 도구

제품/서비스

Competitor Ads by Screpy

경쟁사 도메인을 검색하여 공개된 광고 레코드를 한눈에 확인하는 리서치 도구

제품/서비스

Agent Looker

AI 에이전트의 보안 위협을 방지하고 신뢰할 수 있는 작업 환경을 구축합니다.

제품/서비스

VibeView

브라우저에서 즉시 iOS 및 Android 시뮬레이터를 실행하는 클라우드 스트리밍 플랫폼

제품/서비스

Webhub 1.0

AI 기반의 웹사이트 구축부터 검색 최적화, 성장 관리까지 한 번에 해결하는 올인원 플랫폼

제품/서비스

Qevra

로그인 없이 URL 입력만으로 즉시 생성되는 무료 dofollow 백링크 디렉토리 서비스

제품/서비스

PicSweep - Photo Cleaner

개인정보 유출 걱정 없이 브라우저에서 바로 실행하는 클라우드 사진 정리 도구

제품/서비스

SumaqX

유럽에서 창업하는 외국인 창업자를 위한 AI 기반 통합 지원 플랫폼

제품/서비스

Wittverse

개발 활동과 팀 협업 데이터를 기반으로 프로젝트 일정을 자동 관리하는 지능형 프로젝트 매니저

제품/서비스

Parsely Studio

코딩 없이 대화형 AI로 문서에서 구조화된 데이터를 추출하는 OCR API 구축 도구

제품/서비스

CaskHub

Homebrew를 GUI로 편리하게 관리하는 macOS용 오픈소스 앱 스토어

6건

모델/벤치마크

새 모델과 주요 평가 결과

HF Model Trending

google/timesfm-3.0-pytorch

Google에서 공개한 시계열 예측 모델인 timesfm-3.0-pytorch가 Hugging Face에서 주목받고 있습니다. 약 3.3억 개의 파라미터를 가진 이 모델은 시계열 예측 태스크를 위해 설계되었습니다.

HF Model Trending

unsloth/Qwen3.8-Flash-Next-GGUF

unsloth에서 공개한 Qwen3.8-Flash-Next-GGUF 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 image-text-to-text 파이프라인을 지원하는 GGUF 포맷 모델입니다.

HF Model Trending

deepseek-ai/DeepSeek-V4-Flash-Vision-Exp

DeepSeek-AI에서 출시한 DeepSeek-V4-Flash-Vision-Exp 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 이미지와 텍스트를 동시에 처리하는 멀티모달 기능을 제공합니다.

LiveCodeBench

LiveCodeBench top model: O4-Mini (High)

LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Pro-06-05

LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

나머지 1건 펼쳐보기

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Flash-04-17

LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.