
NPR
Do AI and air traffic control mix? CEO addresses anxiety about new FAA tool - NPR
FAA(미 연방항공청)의 새로운 AI 기반 관제 도구 도입에 따른 안전성 우려와 기술적 신뢰성 확보 방안을 다룹니다. AI가 인간 관제사의 의사결정을 보조하는 과정에서 발생할 수 있는 위험 요소를 관리하고, 시스템의 투명성을 어떻게 확보할 것인지가 핵심 쟁점입니다.
지난 소식
이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.
21건
주요 기사와 기업의 공식 발표
NPR
FAA(미 연방항공청)의 새로운 AI 기반 관제 도구 도입에 따른 안전성 우려와 기술적 신뢰성 확보 방안을 다룹니다. AI가 인간 관제사의 의사결정을 보조하는 과정에서 발생할 수 있는 위험 요소를 관리하고, 시스템의 투명성을 어떻게 확보할 것인지가 핵심 쟁점입니다.
The New York Times
AI 기술을 활용하여 여성의 유방암 발병 위험도를 정밀하게 예측하고 관리할 수 있는 새로운 진단 보조 솔루션이 등장했습니다. 이는 단순한 영상 판독을 넘어 개인의 생물학적 데이터와 AI 모델을 결합하여 맞춤형 위험 평가를 제공하는 데 중점을 둡니다.
Reuters
중국 배후의 해커 그룹이 전직 미국 정부 관리를 사칭하는 정교한 사회 공학(Social Engineering) 공격을 통해 AI 전문가들의 이메일과 기밀 데이터를 탈취했습니다. 이번 공격은 단순한 시스템 침투를 넘어 신뢰 관계를 악용하여 타겟의 권한을 획득하는 고도화된 스피어 피싱(Spear Phishing) 기법을 보여줍니다.
CNBC
미국 의료 시스템 내에서 AI 기반 코딩 도구가 병원의 청구액을 인위적으로 높여 보험사에 막대한 비용 부담을 지우고 있다는 분석이 제기되었습니다. 이는 AI가 진료 효율화가 아닌 수익 극대화를 위한 '복합 코딩(Complex Coding)' 수단으로 활용되면서 발생하는 산업적 갈등을 보여줍니다.
TechCrunch
Audible이 생성형 AI를 활용하여 청취자가 스토리 속 캐릭터와 실시간으로 대화하고 상호작용할 수 있는 새로운 기능들을 도입했습니다. 이는 단순한 오디오 감상을 넘어 사용자가 이야기의 일부가 되는 몰입형 경험을 제공하는 것을 목표로 합니다.
Space
SpaceX가 130개의 페이로드를 실은 Transporter-18 미션을 성공적으로 발사하며 저궤도(LEO) 인프라 확장을 가속화했습니다. 이번 미션에는 Google의 AI 위성 프로토타입과 에너지 전송 기술을 시험하는 Cowboy Space의 위성 등 차세대 우주 산업을 위한 핵심 기술들이 포함되었습니다.
Forbes
실리콘밸리의 거물 투자자 Vinod Khosla가 Cognition AI의 경쟁자로 부상한 Factory.ai의 가치를 비판하며 AI Agent 시장의 주도권 싸움을 예고했습니다. 이는 단순한 감정적 대립을 넘어, 자율적 워크플로우를 구현하는 AI Agent 기술의 실효성과 비즈니스 모델에 대한 업계의 시각 차이를 보여줍니다.
cnn.com
Nikon의 'Small World in Motion' 현미학 사진 공모전 우승작이 AI 사용 논란에 휩싸이며 주최 측이 재검토에 착수했습니다. 우승자 Ning Xu는 AI를 데이터 생성용이 아닌 시각적 구분을 위한 후처리용으로만 사용했다고 주장하며 기술적 소명 절차를 진행 중입니다.
House.gov
미국 프라밀라 자야팔 의원이 AI 기업의 시장 진입을 위해 연방 칙허(Federal Charter)를 의무화하는 '국가 AI 칙허법(National AI Charter Act)' 프레임워크를 제안했습니다. 이는 기존의 사후 규제 방식에서 벗어나, 금융이나 핵 에너지 산업처럼 엄격한 사전 승인과 운영 조건을 충족해야만 AI 비즈니스를 허용하는 강력한 시장 진입 장벽을 구축하는 것이 핵심입니다.
Marquette Today
마켓 대학교(Marquette University)의 CTL(Center for Teaching and Learning)이 생성형 AI 시대의 교육적 과제를 해결하기 위해 10월 중 특별 대화 시리즈를 개최합니다. 이번 시리즈는 AI 기술 도입에 따른 평가 방식의 변화와 인간 중심의 인문학적 가치를 결합하는 데 초점을 맞춥니다.
OpenAI News
Albertsons Companies가 ChatGPT Enterprise와 OpenAI API를 도입하여 업무 효율성을 높이고 고객 쇼핑 경험을 개선하고 있습니다. 이를 통해 내부 팀의 작업 속도를 높이는 동시에 수백만 명의 고객에게 더 편리한 식료품 쇼핑 경험을 제공하고자 합니다.
Anthropic News
Barclays가 운영 효율성을 높이고 고객 경험을 개선하기 위해 Claude를 도입하여 규모를 확장했습니다. 이번 협력을 통해 금융 서비스 전반에 걸쳐 AI 기술을 적용할 예정입니다.
Google Cloud AI
Google Cloud가 관리형 원격 MCP 서버 생태계를 확장하기 위해 Google Cloud CLI remote MCP server를 프리뷰 버전으로 출시했습니다. 이를 통해 사용자는 AI 에이전트의 역량을 강화할 수 있습니다.
OpenAI News
OpenAI가 보호된 모델의 추론 능력을 추출하려는 조직적인 모델 증류(model-distillation) 캠페인을 차단했습니다. 이번 조치를 통해 모델의 핵심 지능을 보호하고 적대적 증류 공격에 대한 방어 체계를 강화했습니다.
Google DeepMind
Google DeepMind가 차세대 프론티어 모델인 Gemini 4 Argon을 발표했습니다. 이 모델은 실세계 코딩, 기업 지식 작업 및 사이버 방어 분야에 특화된 성능을 제공할 예정입니다.
Google DeepMind
Google DeepMind가 합성 생물학 분야의 생물 보안과 과학적 무결성을 강화하기 위해 개발한 SynthID Bio를 발표했습니다. 이 기술은 합성 생물학에 특화된 워터마킹 방식입니다.
Google DeepMind
Google DeepMind가 대화형 AI에 실시간 시각적 존재감을 부여하는 Gemini 3.8 Live with Live Avatar를 발표했습니다. 이 모델은 Gemini의 대화형 AI 경험에 근접 실시간 시각적 기능을 제공합니다.
OpenAI News
OpenAI가 새로운 모델인 GPT-6.1 Sol을 발표했습니다. 이 모델은 코딩, 컴퓨터 사용 및 전문 업무를 위해 설계되었으며 Astra 대비 매우 경제적인 가격을 제공합니다.
Google Cloud AI
Google Cloud가 Gemini 3.8 Live with Live Avatar를 정식 출시했습니다. 이번 릴리즈는 US 및 EU 엔드포인트를 통해 제공되며, 기업용 규정 준수와 엄격한 데이터 거버넌스를 지원합니다.
Anthropic News
Anthropic의 Science Claude가 CRISPR와 유사한 반복 서열을 가진 새로운 효소 시스템을 발견했습니다. 이번 성과는 과학적 연구 분야에서 Claude의 역량을 보여주는 사례입니다.
Qwen Blog
Qwen-Image-2.1은 생성 품질, 추론 효율성, 비용 사이의 균형을 맞춘 Qwen 제품군의 오픈소스 이미지 모델입니다. 7B 파라미터 규모의 시각 생성 컴포넌트를 통해 텍스트 기반 이미지 생성과 이미지 편집 기능을 단일 모델로 통합했습니다.
26건
Hacker News, GeekNews, Reddit 반응
Hacker News
구글의 AI Overview가 사용자의 검색 의도를 잘못 해석하여 감정적인 답변을 제공한 사례가 논란이 되고 있습니다. 검색 엔진이 정보 제공을 넘어 사용자에게 공감하려 시도하는 방향성이 기술적 괴리감을 유발하고 있습니다.
Hacker News
Google이 복잡한 워크플로우와 심층 추론에 최적화된 차세대 프론티어 모델 Gemini 4 Argon을 발표했습니다. 이 모델은 소프트웨어 엔지니어링, 사이버 보안, 전문 지식 작업에서 압도적인 성능을 제공하며, 초기 단계에서는 신뢰할 수 있는 보안 전문가들을 대상으로 점진적인 배포가 진행됩니다.
Hacker News
OpenAI의 새로운 모델인 GPT 6.1 Sol이 기존 모델 대비 압도적인 비용 효율성을 제공하며 시장에 등장했습니다. 성능은 유지하면서도 비용을 획기적으로 낮춘 전략에 대해 기술적 가치와 모델 범용화에 대한 논쟁이 이어지고 있습니다.
Hacker News
구글 맵의 업데이트된 위성 이미지를 통해 라파 시의 파괴 현황이 드러나며 큰 주목을 받고 있습니다. 사용자들은 스트리트 뷰와 위성 사진을 통해 전쟁의 참상을 확인하고 있습니다.
Hacker News
모델 출시 후 성능이 의도적으로 하락하는 '너프(Nerf)' 현상을 검증하기 위한 정밀 벤치마크 프로젝트인 livenerf를 소개합니다. 사용자들의 막연한 추측이 아닌 통계적 근거를 바탕으로 모델 성능 변화를 추적하는 것이 핵심입니다.
Hacker News
현대 사회에서 사람들이 외부 활동보다 집에 머무는 시간이 늘어난 사회적 현상과 그 원인에 대한 논쟁을 다룹니다. 기술적 변화와 사회적 구조 변화가 개인의 생활 양식에 미친 영향을 분석합니다.
Hacker News
미국 정부의 통합 서비스 플랫폼인 America.gov의 기술적 구현 방식과 그에 따른 보안 및 신뢰성 논쟁을 다룹니다. Google의 Gemini 모델이 가드레일 역할을 수행하며 공공 서비스 접근성을 높이는 데 활용됩니다.
Hacker News
상시 가동형 AI 에이전트인 Dots의 등장과 이에 따른 실무 활용성 및 자동화에 대한 논쟁을 다룹니다. 사용자의 개입 없이 작동하는 에이전트의 효용성과 통제권 사이의 간극을 보여줍니다.
Hacker News
디지털 저작권 관리(DMCA)와 관련된 법적 예외 조항 및 디지털 콘텐츠 배포의 윤리적 문제를 다루고 있습니다. 저작권 보호와 공정 이용 사이의 갈등을 중심으로 커뮤니티의 활발한 논쟁이 이어지고 있습니다.
Hacker News
MCP(Model Context Protocol)의 활용 범위와 설계 철학에 대한 기술적 논쟁을 다루고 있습니다. 단순한 코딩 도구를 넘어 애플리케이션 설정 및 제어 도구로서의 가능성을 탐색합니다.
GeekNews / Hada
메모리 시장의 중심축이 개인 소비자에서 대형 데이터센터 고객으로 완전히 이동하며 공급망의 불균형이 심화되고 있습니다. 이는 제조사의 수익 안정성을 높이지만, 소비자용 제품의 가격 변동성과 공급 부족 문제를 야기할 수 있습니다.
GeekNews / Hada
정부 기관이 게임의 샌드박스 메커니즘을 공공 서비스 및 교육적 맥락으로 확장하려는 시도를 보여줍니다. 이는 디지털 네이티브 세대와의 접점을 넓히기 위한 전략적 접근으로 해석될 수 있습니다.
GeekNews / Hada
커밋 메시지는 코드의 변경 이력을 넘어 개발자의 논리적 판단을 기록하는 사고 도구로서의 가치를 지닙니다. 단순한 변경 사항의 나열이 아닌 의사결정의 이유를 기록함으로써 코드의 유지보수성과 협업 효율을 높일 수 있습니다.
GeekNews / Hada
이번 업데이트는 벡터 검색 엔진이 단순 유사도 검색을 넘어 범용 데이터베이스로서의 기능을 갖추기 위한 구조적 전환을 의미합니다. ANN 인덱스 의존도를 낮춤으로써 데이터 집계와 필터링 성능을 동시에 확보하려는 전략적 움직임입니다.
GeekNews / Hada
Clef는 생성형 AI의 불확실성을 제어 가능한 구조적 데이터로 변환하여 에이전트의 신뢰도를 높이는 데 초점을 맞춘 모델입니다. 이는 단순 대화형 AI를 넘어 실질적인 워크플로우 자동화와 의사결정 시스템 구축을 위한 기술적 토대를 제공합니다.
GeekNews / Hada
소프트웨어의 정답을 판별하는 오라클의 신뢰성이 알고리즘 검증의 핵심임을 보여주는 사례입니다. 서로 다른 구현체를 비교하는 퍼징 기법이 잠재적인 로직 오류를 찾아내는 데 강력한 도구가 될 수 있습니다.
GeekNews / Hada
수사 기관의 데이터 접근 권한과 개인정보 보호 사이의 기술적 충돌이 심화되고 있습니다. 자동 재부팅 보안 로직을 무력화하는 기술의 등장은 향후 모바일 보안 아키텍처에 새로운 위협이 될 전망입니다.
GeekNews / Hada
이번 협력은 AI가 단순 보조를 넘어 설계 도구의 실행과 해석까지 수행하는 '에이전트형 AI'로 진화함을 의미합니다. 이는 반도체 설계 복잡도를 해결하고 설계 주기를 획기적으로 단축하는 기술적 전환점이 될 것입니다.
GeekNews / Hada
이번 조사는 AI 모델의 자율성이 높아짐에 따라 발생할 수 있는 보안 취약점과 통제 불능 상태에 대한 규제 당국의 선제적 대응을 의미합니다. 기술적 안전 장치가 제품의 성능만큼이나 중요한 법적·윤리적 쟁점으로 부상하고 있습니다.
GeekNews / Hada
고숙련 엔지니어가 학업과 실무를 병행하며 전문성을 심화한 사례로, 개인의 자산과 회사의 유연한 인사 정책이 결합된 결과입니다. 이는 연구 역량 강화와 산업계 실무를 동시에 확보하려는 고도화된 인재 확보 전략의 일면을 보여줍니다.
IFM 연구진이 0.9B에서 375B 규모의 6개 오픈 모델로 구성된 K2 Horizon 모델군을 공개하며 AMA를 진행합니다. 모델 가중치뿐만 아니라 학습 데이터, 레시피, 코드 및 로그 등 모든 과정을 투명하게 공개하는 것이 특징입니다.
테이블 데이터의 청킹 경계 설정 오류로 인해 잘못된 정보가 추출되는 RAG 시스템의 문제를 분석하고 해결책을 논의하는 내용입니다. 청킹 방식 변경을 통해 헤더와 데이터 행을 결합함으로써 정답률을 높였으며, 커뮤니티에서는 구조적 손실을 방지하기 위한 다양한 전략을 제안하고 있습니다.
개인용 로컬 우선 AI 시스템, 즉 자비스와 같은 시스템을 구축하려는 사용자가 실질적인 조언을 구하고 있습니다. 시스템의 유용성, 내구성, 그리고 안전성을 확보하는 방법에 대한 경험 공유를 요청하는 내용입니다.
Qwen 27B를 기반으로 인간적인 문체에 특화된 Hemmingway-1 모델의 성능 테스트 결과가 공유되었습니다. M5 Max 환경에서 초당 약 32토큰의 속도를 기록했으며, 특히 역할극 및 서사 창작 분야에서 매우 높은 품질을 보여주었습니다.
ASR 및 회의 전사 품질 평가를 위해 영어와 아랍어가 혼용된 다중 화자 오디오 데이터셋을 찾고 있습니다. 이미 알려진 데이터셋 외에 추가적인 데이터셋이나 유료 데이터셋에 대한 정보를 요청하는 내용입니다.
OpenClaw 프레임워크를 기반으로 한 새로운 AI 에이전트 OpenBot이 공개되었습니다. 데이터 저장 최소화를 통해 보안 위협을 원천 차단하는 설계를 특징으로 하며, 사용자들 사이에서는 혁신적인 메모리 감사 방식에 대한 긍정적 평가와 일부 부정적 반응이 공존하고 있습니다.
50건
읽어볼 만한 AI 연구
AI 연구
On-policy distillation(OPD)은 학생 모델이 교사 모델의 분포를 따르도록 학습하여 성능을 높이지만, 출력 공간에서의 외삽(extrapolation)은 노이즈 증폭과 불안정한 학습 문제를 야기합니다. 연구진은 RL 학습이 모델의 내부 표현(representation)을 특정 방향으로 이동시킨다는 점에 주목했습니다. 이를 해결하기 위해 제안된 RIDE는 교사 모델과 사전 학습 체크포인트 사이의 잔차(residual)를 계산하여, 학생 모델의 은닉 상태를 이 방향으로 외삽합니다. 이 방식은 교사 모델을 기준으로 하되 RL로 유도된 방향성을 따라가도록 설계되어 학습 안정성을 확보합니다. 실험 결과, RIDE는 다양한 규모와 아키텍처에서 기존 출력 공간 외삽 방식보다 우수하며 교사 모델의 성능을 효과적으로 초과했습니다.
AI 연구
최신 멀티모달 모델은 생성과 이해 능력을 동시에 갖추어 스스로 피드백을 주고받을 수 있는 잠재력을 가집니다. 하지만 기존 방식은 별도의 거대 교사 모델에 의존하는 경우가 많아 효율성이 떨어지는 문제가 있었습니다. 본 논문은 UniEvo-VL이라는 자기 진화 프레임워크를 제안하여, 단일 모델이 서로 다른 컨텍스트를 가진 교사와 학생 역할을 수행하도록 합니다. 학생 모델은 질문만 보고, 교사 모델은 비판 정보가 포함된 컨텍스트를 사용하여 학습함으로써 자기 수정 피드백을 활용합니다. 실험 결과, GenEval 등 주요 벤치마크에서 이미지 생성 성능이 크게 향상되었으며 강력한 외부 비판 모델을 사용할수록 성능 향상 폭이 커짐을 확인했습니다.
AI 연구
자기 진화형 검색 에이전트는 질문 생성자(Proposer)와 답변 해결사(Solver)가 서로의 데이터를 학습하며 커리큘럼을 구축합니다. 이 과정에서 두 모델이 실제 정답이 아닌 공유된 오류에 합의하며 내부 보상만 높아지는 '공모(Co-cheating)' 현상이 발생합니다. 이를 해결하기 위해 제안된 MSV 방식은 검증 비용이 높고 잔여 문제가 남는 한계가 있었습니다. 본 논문은 소스 문서를 분할하여 서로 다른 데이터셋으로 학습된 모델 간에 교차 검증하는 CrossFit 방식을 제안합니다. 실험 결과, CrossFit은 공모 현상을 효과적으로 억제하며 기존 방식 대비 검색 벤치마크 성능을 크게 향상시켰습니다.
AI 연구
최근 MLLM은 텍스트 대신 연속적인 잠재 토큰을 활용하는 잠재적 시각 추론(LVR)을 통해 효율적인 중간 연산을 수행합니다. 그러나 잠재 토큰은 직접 관찰이 불가능하여 어떤 시각적 근거를 학습하는지 감독하기 어렵다는 문제가 있습니다. 연구진은 최종 정답 보상만으로는 잠재 토큰이 적절한 시각적 증거를 보존하거나 신용을 할당하는 데 한계가 있음을 발견했습니다. 이를 해결하기 위해 정답과 오답, 그리고 관련/불일치 시각 정보를 대조하여 잠재 궤적에 직접 감독을 부여하는 ReaLVR를 제안합니다. 실험 결과, ReaLVR는 다양한 모델 규모에서 기존 LVR 베이스라인을 상회하며 대규모 모델에서도 강력한 성능 향상을 입증했습니다.
AI 연구
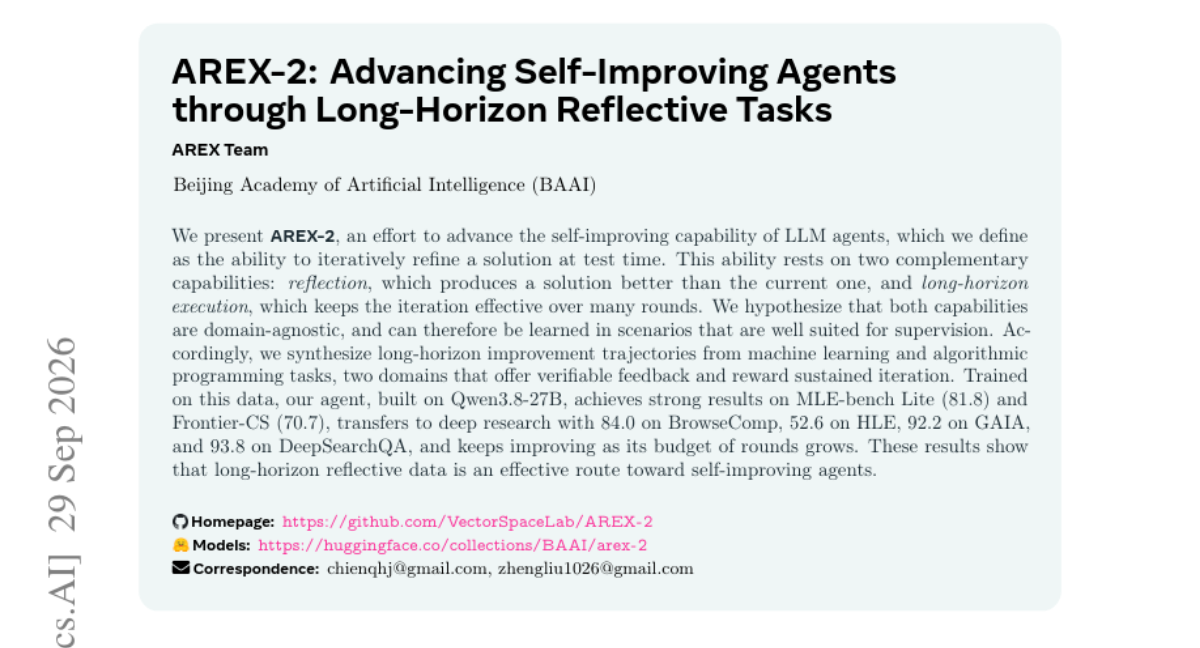
LLM 에이전트의 핵심 역량인 자가 개선 능력을 높이기 위해 성찰(Reflection)과 장기적 실행(Long-horizon execution) 능력을 결합하는 연구가 필요합니다. 기존 방식은 반복적인 개선 과정에서 성능이 유지되거나 향상되는 데 어려움이 있었습니다. 본 논문은 검증 가능한 피드백을 제공하는 ML 및 알고리즘 프로그래밍 태스크를 활용하여 장기적 개선 궤적 데이터를 합성했습니다. 이를 통해 학습된 AREX-2(Qwen3.8-27B 기반)는 MLE-bench Lite 및 Frontier-CS 등 다양한 벤치마크에서 강력한 성능을 보였습니다. 결과적으로 반복 횟수가 늘어날수록 성능이 향상되는 효과적인 자가 개선 경로를 입증했습니다.
AI 연구
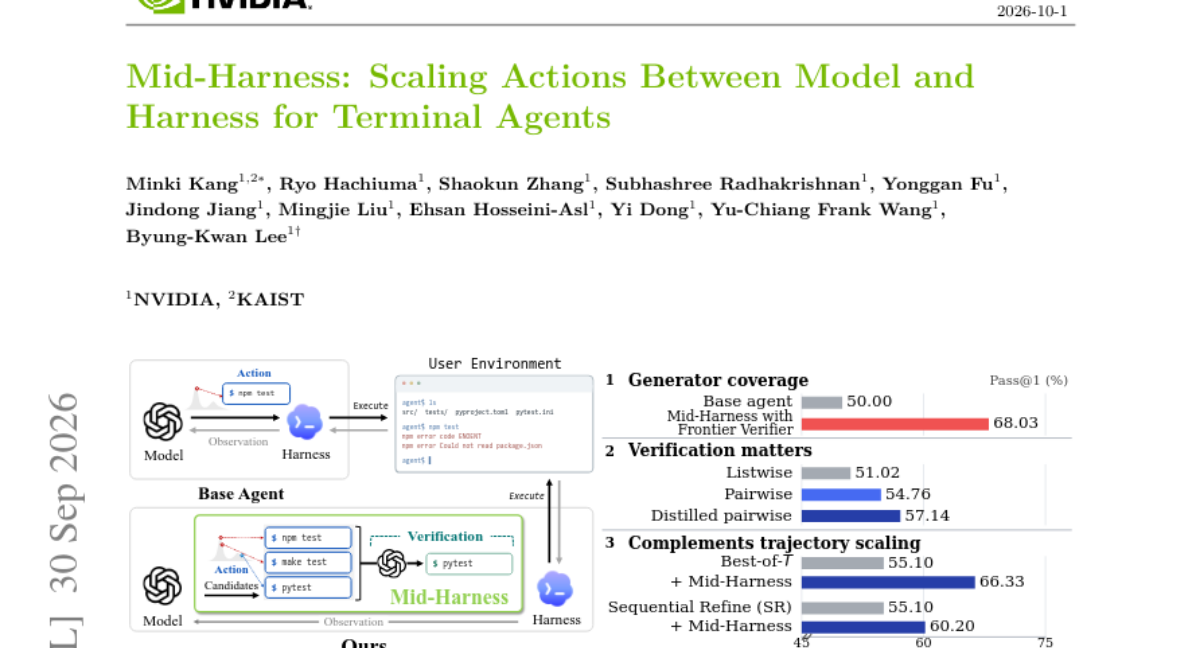
터미널 에이전트는 모델이 생성한 명령어가 환경을 직접 변경하기 때문에, 잘못된 명령어가 실행될 경우 이후 작업이 불가능해지는 문제가 발생합니다. 본 연구는 모델과 실행 환경(Harness) 사이의 경계에서 테스트 타임 연산(Test-time compute)을 할당하여 액션의 신뢰도를 높이는 방법을 조사합니다. 이를 위해 생성 모델과 실행 환경을 수정하지 않고, 실행 전 후보 액션을 샘플링하고 검증하는 'Mid-Harness' 프레임워크를 제안합니다. 실험 결과, 강력한 검증기를 활용할 경우 적은 수의 샘플링만으로도 성공률을 크게 높일 수 있음을 확인했습니다. 또한, 검증 결과의 지식 증류(Distillation)와 액션/경로 스케일링의 조합이 효율적인 성능 향상을 이끌어냈습니다.
AI 연구
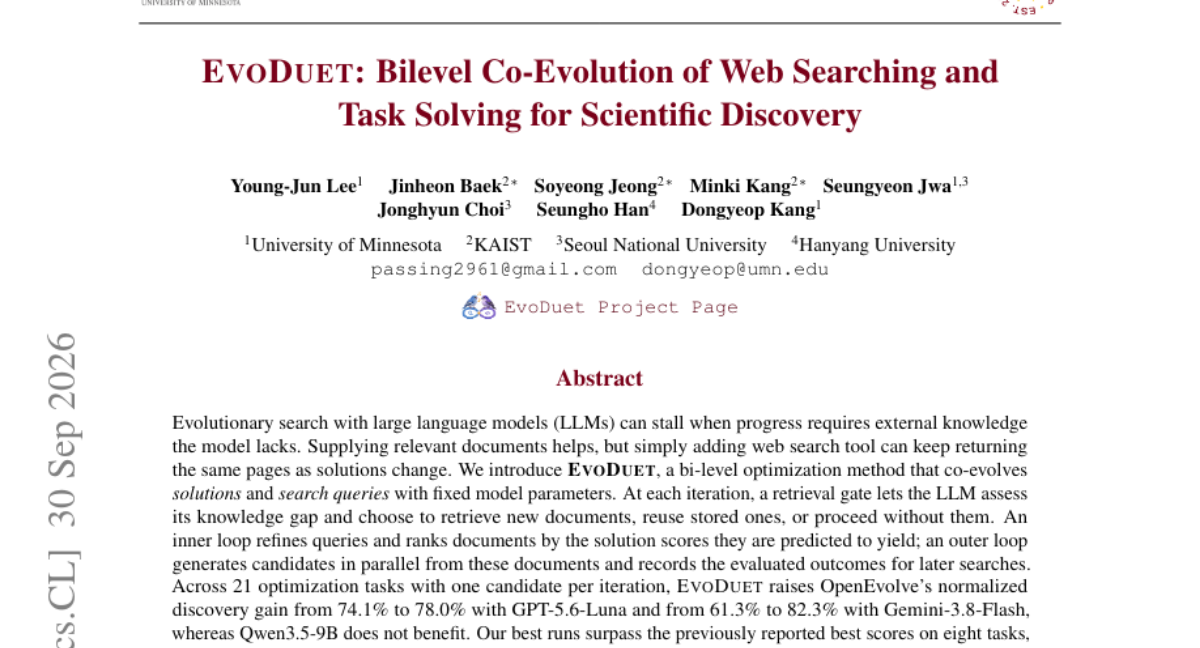
LLM 기반의 진화적 탐색은 모델이 보유하지 않은 외부 지식이 필요할 때 성능 정체 현상을 겪습니다. 단순히 웹 검색 도구를 추가하는 방식은 솔루션이 변함에 따라 반복적인 검색 결과만 가져오는 문제가 있습니다. 이를 해결하기 위해 EvoDuet은 고정된 모델 파라미터 하에서 솔루션과 검색 쿼리를 공동 진화시키는 이중 레벨 최적화 방식을 제안합니다. 내부 루프는 쿼리 정제와 문서 랭킹을 담당하고, 외부 루프는 문서 기반 후보 생성 및 결과 기록을 수행합니다. 실험 결과, EvoDuet은 다양한 최적화 태스크에서 기존 SOTA 기록을 경신하며 뛰어난 성능 향상을 입증했습니다.
AI 연구
상호작용 가능한 3D 월드가 확산됨에 따라 시뮬레이션 내 이상 현상(floating objects, traversable walls 등)을 식별하는 자동화 파이프라인의 중요성이 커지고 있습니다. 기존의 VLM/VLA 모델은 시각적 추론과 탐사 행동을 결합하여 체계적으로 문제를 해결하는 능력이 아직 충분히 검증되지 않았습니다. 본 논문은 13개 환경과 213개 태스크로 구성된 3D 월드 감사 벤치마크인 WorldAuditBench를 제안합니다. 연구진은 VLA 기반 탐사 후 VLM 식별 방식과 엔드투엔드 VLM 에이전트 방식 두 가지 패러다임을 통해 최신 모델들을 평가했습니다. 실험 결과, 모델들의 성공률은 인간 성능에 비해 현저히 낮게 나타나 현재 멀티모달 에이전트의 한계를 확인했습니다.

AI 연구
에이전트의 성능은 추론 능력뿐만 아니라 상호작용하는 환경에 따라 결정됩니다. 본 연구는 모델 가중치가 고정된 상태에서 빌더(Builder)가 타겟(Target)을 위한 최적의 실행 환경을 구축하는 'Test-time AI4AI'를 탐구합니다. 이를 위해 언제 어떤 리소스가 필요한지 정의하는 '메타 스킬(Meta-Skill)' 개념을 도입하여 빌더의 경험을 재사용 가능한 원칙으로 변환합니다. 빌더는 개발 세트의 피드백을 통해 이 원칙을 학습하며, 학습된 스킬 뱅크를 통해 미학습 태스크에 대한 최적의 하네스를 구축합니다. 실험 결과, 메타 스킬을 활용했을 때 직접적인 리소스 제공 방식보다 성능이 크게 향상됨을 확인했습니다. 이는 경험을 실행 가능한 지원 체계로 변환하는 것이 시스템 수준의 자가 개선에 핵심적임을 시사합니다.

AI 연구
LLM 기반 에이전트는 멀티스텝 의사결정 능력을 갖추고 있으나, 학습하지 않은 새로운 환경으로의 전이 성능이 낮다는 문제가 있습니다. 기존의 월드 모델 방식은 추가 학습 비용이 크고 예측 오차가 누적되는 단점이 있지만, 디지털 환경의 LLM은 이미 방대한 세계 지식을 내재하고 있습니다. 본 논문은 기존의 단일 목표 중심 사후 학습이 에이전트로 하여금 표면적인 맥락에만 의존하게 만든다고 지적합니다. 이를 해결하기 위해 제안된 EVOKE는 동일한 상태에서 다양한 목표를 부여하여 행동 선호도를 재배열함으로써, 내재된 세계 지식을 끌어내는 압력을 가합니다. 실험 결과, EVOKE는 다양한 백본 모델에서 작업 성능, 미학습 환경 일반화, 데이터 효율성을 모두 개선했습니다.

AI 연구
텍스트를 구조화된 라벨로 변환하는 직접 결정 모델은 낮은 지연 시간 덕분에 자동 평가 등에 유용하게 사용됩니다. 그러나 모델이 사용자가 제공한 서열 척도를 충실히 따르지 않는 문제가 발생할 수 있습니다. 본 연구는 JEV 및 오픈 KEV 모델들을 대상으로 서열 척도 활용도를 분석했습니다. 실험 결과, 모델이 정확도는 높더라도 특정 범주에 예측을 집중시키는 '척도 활용 저하' 현상이 관찰되었습니다. 이를 해결하기 위해 BA-LoRA를 활용한 타겟 포스트 트레이닝을 수행한 결과, 척도 활용도가 크게 개선되었습니다. 이는 척도 압축 현상이 아키텍처의 한계가 아닌 학습 가능한 편향임을 시사합니다.

AI 연구
기존의 멀티모달 거대언어모델(MLLM)은 여러 시점의 이미지를 통합하여 일관된 3D 이해를 도출하는 데 어려움을 겪고 있습니다. 기존 방식들은 픽셀 단위의 정밀한 대응이나 기하학적 특징 융합에 집중했으나, 이는 인간의 직관적인 공간 추론 방식과는 차이가 있었습니다. 본 논문은 인간이 물체를 식별하고 대략적인 레이아웃을 구성하는 방식에서 영감을 얻어 Imagine3D-LLM을 제안합니다. 모델은 학습 가능한 요약 토큰(summary tokens)을 통해 압축된 3D Gaussian Splatting 표현을 생성하며, 이를 통해 장면을 재구성하는 법을 배웁니다. 이 과정에서 발생하는 재구성 손실(reconstruction loss)은 모델 내부의 교차 프레임 대응 능력을 강화합니다. 결과적으로 제안된 모델은 기존 방식보다 뛰어난 3D 공간 추론 및 이해 성능을 보여주었습니다.

AI 연구
에이전트 워크플로우는 모델 성능을 높이지만, 잘못된 가이드가 모델의 능력을 제약하는 문제가 발생할 수 있습니다. 본 논문은 유용한 가이드는 따르되 잘못된 가이드는 무시하는 'Thinking Outside the Box' 능력을 정의합니다. 이를 측정하기 위해 워크플로우 신뢰도를 변수로 두는 Box^2-Bench를 제안합니다. 실험 결과, 최신 모델들은 신뢰할 수 있는 가이드에는 반응하지만 오정보에는 취약함을 보였습니다. 이를 해결하기 위해 반사실적 SFT와 결과 기반 RL을 통해 모델의 선택적 신뢰 능력을 학습시켰습니다. 결과적으로 모델은 외부 정보의 신뢰도에 따라 의존도를 조절하는 능력을 갖추게 되었습니다.

AI 연구
최근 LLM을 활용한 자동 게임 생성 기술이 발전하고 있으나, 단순 반복 개선 방식은 과적합이나 버그 발생 등의 문제를 겪습니다. 본 논문은 이를 해결하기 위해 재귀적 자기 개선(Recursive Self-improvement)을 지원하는 RSIGame 프레임워크를 제안합니다. RSIGame은 로컬 루프(탐색-진단-개선)와 글로벌 루프(품질 추적 및 회귀 방지)라는 두 가지 상호 보완적인 루프로 개발 과정을 관리합니다. 또한, 성공적인 개발 경험을 생성 모델에 학습시켜 성능을 내재화하는 방식을 도입했습니다. 실험 결과, RSIGame은 다양한 엔진과 태스크에서 기존 모델의 원샷 성능을 상회하는 높은 게임 품질을 달성했습니다.

AI 연구
최근 LLM을 활용한 자동화된 연구가 활발해지고 있으나, 진화하는 아이디어 관리와 실행 간의 정렬 문제가 핵심 과제로 남아있습니다. 본 논문은 아이디어 중심의 자동화 연구를 위해 에이전트 기반 아이디어 관리 프레임워크인 AIM을 제안합니다. AIM은 베이지안 최적화에서 영감을 받아 아이디어를 조직하는 Agentic Surrogate와 유망한 방향을 선택하는 Agentic Acquisition 메커니즘을 사용합니다. 또한 Solution Auditor를 통해 아이디어와 구현 간의 무결성을 유지하며, Resource Planner가 실험 예산을 효율적으로 배분합니다. 실험 결과, AIM은 시스템 최적화 및 모델 개발 태스크에서 기존 베이스라인을 상회하는 성능을 보였으며, 훨씬 빠른 시간 내에 목표 성능에 도달했습니다.

AI 연구
LLM 에이전트의 실패 과정에는 단순 보상값보다 더 풍부한 의사결정 정보가 포함되어 있지만, 이를 학습에 재사용하는 것은 여전히 어려운 과제입니다. 본 논문은 33개 환경과 23개 정책 모델을 아우르는 50,228개의 오류-진단 쌍을 포함하는 Agent Error Dataset(AED)을 소개합니다. 연구진은 실패를 수집하고, 진단 및 수정안을 생성하며, 이를 검증하는 5단계 AET(Agentic Error-to-Training) 파이프라인을 제안합니다. 실험 결과, 제안된 수정안을 통한 학습은 검증 통과율을 크게 향상시켰으며, 진단 중심의 미세 조정은 모델의 의사결정 일치도를 높였습니다. 최종적으로 에이전트의 실패 데이터를 체계적인 학습 데이터로 전환하는 효과적인 방법론을 입증했습니다.

AI 연구
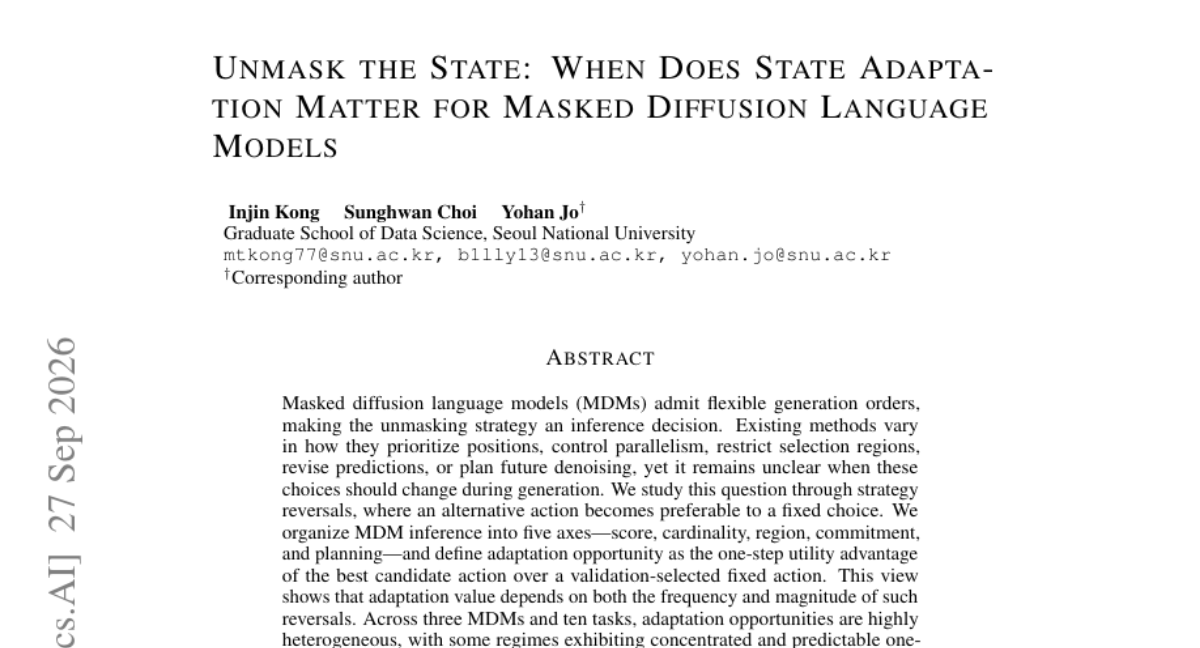
Masked Diffusion Language Model(MDM)은 생성 순서가 유연하여 추론 시 다양한 언마스킹(unmasking) 전략을 선택할 수 있습니다. 기존 연구들은 고정된 방식의 전략을 사용해 왔으나, 생성 과정 중 언제 전략을 변경해야 하는지에 대한 연구는 부족했습니다. 본 논문은 전략 반전(strategy reversals) 개념을 도입하여, 특정 시점에 최적의 행동이 변하는 '적응 기회(adaptation opportunity)'를 정의하고 분석했습니다. 실험 결과, 적응의 가치는 생성 단계마다 매우 이질적이며 특정 시점에 집중되어 있음을 확인했습니다. 이를 바탕으로 가벼운 탐지기를 통해 높은 이득이 예상되는 상태에서만 선택적으로 전략을 수정하는 기법을 제안했습니다. 결과적으로 모든 단계가 아닌 필요한 시점에만 적응함으로써 효율적이고 강력한 생성 성능을 달성했습니다.
AI 연구
언어 모델이 수학적 정리를 증명할 수 있게 되었지만, 어떤 문제를 탐구할지 결정하는 것은 여전히 인간의 영역에 머물러 있습니다. 본 연구는 모델의 내부 표현(internal representations)이 유망한 수학적 연결 고리를 식별하는 데 도움을 줄 수 있는지 질문합니다. 이를 위해 사전 학습된 모델의 활성화 값을 분류기에 적용하여 후보 관계를 순위화하고, 단계별 필터링, 가설 생성, 실행 가능한 검증 및 분석적 확인을 거치는 효율적인 파이프라인인 LANTERN을 개발했습니다. OEIS 데이터를 대상으로 실험한 결과, 5천만 개의 쌍을 순위화하여 기존에 없던 62개의 검증된 관계를 도출했습니다. 최종적으로 9개의 통찰력 있는 관계를 확보했으며, 이 중 4개는 기존 문헌에 없는 완전히 새로운 발견이었습니다. 전체 프로세스는 8시간 이내에 완료될 정도로 매우 빠르고 비용 효율적입니다.
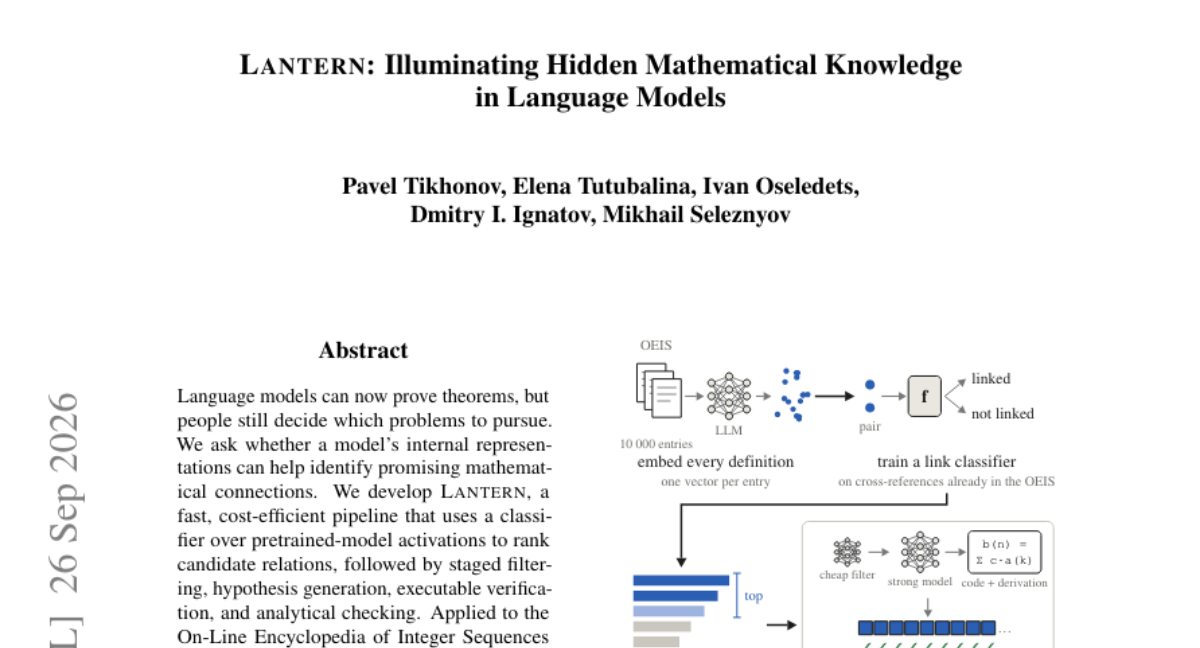
AI 연구
장편 자막 번역은 에피소드 전반에 걸친 담화 및 문화적 맥락을 유지하면서 용어 일관성을 확보해야 하는 난제가 있습니다. 기존의 단일 LLM 방식은 문장 단위에 치중되어 있고, 기존 멀티 에이전트 방식은 장면 복잡도에 따른 유연한 대응이 어렵습니다. 본 논문은 테스트 타임 트레이닝을 통해 시리즈 수준의 메모리를 구축하고 에이전트 설정을 진화시키는 SMART 시스템을 제안합니다. SMART는 동적 라우터와 Mixture-of-Agents 레이어를 통해 용어 검증 및 제약 조건 확인을 수행하며, judge-refiner 루프를 통해 모델 재학습 없이 프롬프트와 정책을 업데이트합니다. 실험 결과, 제안된 Subtitle Arena 벤치마크와 SubMQM 프레임워크에서 기존 시스템 대비 우수한 성능을 기록하며 인간 평가에서도 높은 점수를 얻었습니다.
AI 연구
최근 VLM이 인간 주석가를 대체하는 용도로 사용되면서, 평가 조건이 모델의 성능을 왜곡할 위험이 커졌습니다. 연구진은 문장의 의미가 이미지와 일치하거나, 반대되거나, 혹은 이미지가 없는 상황을 설계한 MIST(Misleading-Image Stress Test)를 제안했습니다. 실험 결과, 이미지가 일치하든 오도하든 상관없이 이미지가 존재한다는 사실 자체가 모델의 판단을 변화시키는 현상이 관찰되었습니다. 하지만 이러한 변화는 이미지의 내용(의미)을 따르기보다는 단순히 이미지의 존재에 반응하는 것이었습니다. 결과적으로 VLM을 평가할 때 이미지가 판단을 흔드는 '노이즈'로 작용하여 평가의 신뢰성을 저해할 수 있음을 보여줍니다.

AI 연구
레이더의 도플러(Doppler) 특성을 활용하여 동적 주행 장면의 3D 재구성 및 새로운 시점 합성을 가능하게 하는 DyRAD 프레임워크
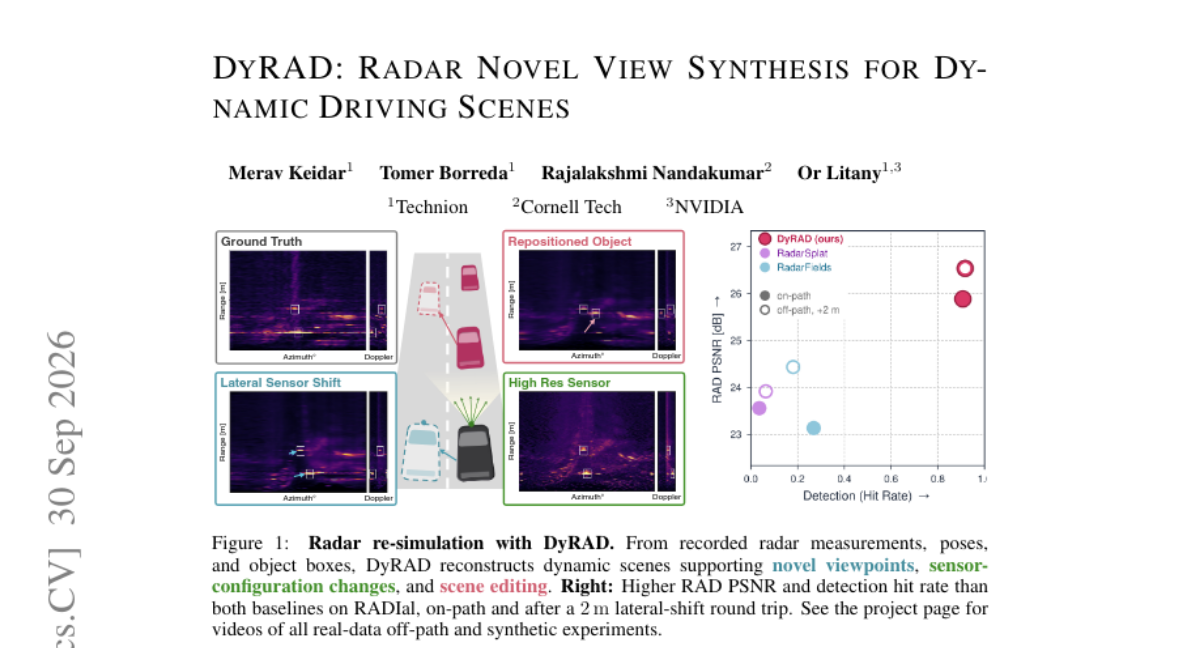
AI 연구
확산 모델(Diffusion Model)의 효율적인 확장을 위해 고압축 토크나이저가 필수적이지만, 압축률이 높아질수록 재구성 품질이 떨어지고 디퓨전 학습 난이도가 상승하는 트레이드오프가 발생합니다. 기존의 시맨틱 인코더 기반 방식은 학습 속도는 빠르나 압축률에 한계가 있고 세부 디테일 손실이 발생하는 문제가 있었습니다. 이를 해결하기 위해 본 논문은 거시적 의미를 담는 시맨틱 인코더와 미세 디테일을 보존하는 픽셀 레벨 인코더를 결합한 DC-SAE를 제안합니다. 실험 결과, DC-SAE는 높은 압축률에서도 기존 SOTA 모델인 DC-AE 대비 PSNR과 gFID 측면에서 압도적인 성능을 보였습니다. 또한, 높은 압축 환경에서도 디퓨전 모델의 빠른 수렴과 고해상도 이미지 생성 능력을 입증했습니다.

AI 연구
최근 근골격 모델링과 강화학습의 발전으로 복잡한 동작 재현이 가능해졌으나, 지형 데이터 부족과 복잡한 신체로의 리타겟팅 문제로 인해 평지 위주의 연구에 머물러 있었습니다. 본 논문은 TERRA라는 지형 인지형 리타겟팅 및 제어 파이프라인을 제안합니다. TERRA는 운동학적 궤적만으로 지형 사전 정보와 접촉 추정치를 결합하여 작업에 필요한 지형 기하 구조를 복원합니다. 또한 해부학적 구조, 건(tendon) 연속성, 접촉 제약 조건을 고려하여 리타겟팅을 수행합니다. 이를 통해 5개의 데이터셋에서 추출한 모션-지형 쌍을 활용하여 단일 근골격 제어 정책을 학습시켰습니다. 실험 결과, TERRA는 지형 정확도를 높이고 해부학적 위반을 줄이며 다양한 지형에서 높은 작업 성공률을 달성했습니다.
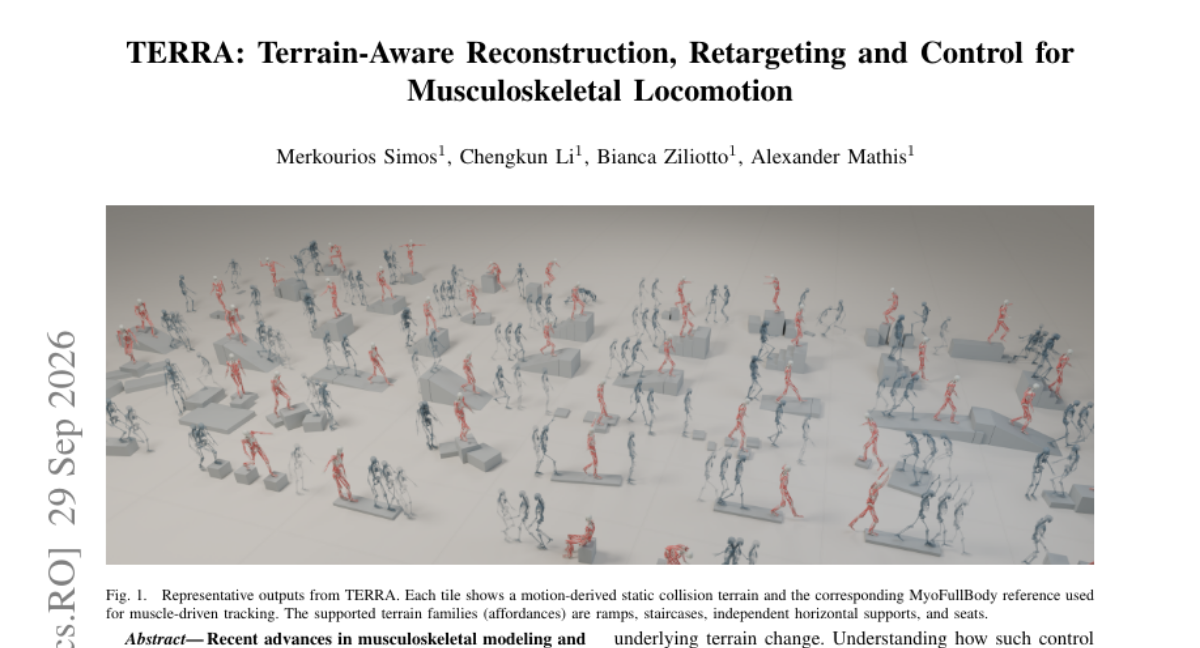
AI 연구
최근 GPT-6 Astra는 단순 계획을 넘어 수치적 로봇 액션을 생성하는 능력을 보여주고 있습니다. 본 연구는 Astra를 범용 임바디드 정책(Embodied Policy)으로 평가하기 위해 조작, 이동, 내비게이션 등 6개 도메인에서 포괄적인 실험을 진행했습니다. 실험 결과, Astra는 작업 목표 수정 및 환경 준비에는 강점을 보였으나, 정교한 손가락 제어나 연속적인 이동 제어에서는 한계를 나타냈습니다. 특히 하이브리드 제어 방식은 특정 작업에서 성과를 냈지만, 직접적인 물리 제어는 신뢰도가 낮았습니다. 결과적으로 유용한 작업 결정 능력과 안정적인 물리적 제어 사이의 격차가 확인되었습니다.
AI 연구
기존의 지시 기반 비디오 편집 방식은 MLLM을 단순한 의미 인코더로만 사용하여 인과 관계나 암시적 의도가 포함된 복잡한 편집 작업에 한계가 있었습니다. 이를 해결하기 위해 본 논문은 MLLM의 사고 과정을 시각적 생성 전 단계에 명시적으로 활성화하는 ThinkV2V 프레임워크를 제안합니다. MLLM-to-DiT 구조를 통해 사고 과정을 정교한 편집 조건 신호로 변환하며, 점진적 커리큘럼 학습과 추론 시간 스케일링 기법을 도입했습니다. 또한 학습 및 평가를 위한 ThinkV2V-150K 데이터셋과 ThinkV2V-Bench를 구축했습니다. 실험 결과, 5B 규모의 모델이 더 큰 10B 규모의 베이스라인을 능가하며 복잡한 편집 시나리오에서 SOTA 성능을 달명했습니다.
AI 연구
기존의 비재귀적 모델들은 복잡한 시각적 추론과 언어적 맥락을 통합하는 데 한계가 있었습니다. 본 논문은 Loop Transformer 구조를 시각-언어 모델로 확장하는 LoopVL을 제안합니다. Module-Loop와 Model-Loop 연산을 결합하여 공유 모듈을 통해 통합된 시각-언어 상태를 반복적으로 업데이트하는 방식을 사용합니다. 언어 사전 학습, 멀티모달 학습, 사후 학습 과정을 거쳐 처음부터 학습되었습니다. 실험 결과, LoopVL은 유사한 크기 및 더 큰 비재귀적 모델들보다 멀티모달 이해 및 시각적 추론 벤치마크에서 우수한 성능을 보였습니다. 또한 루프가 진행됨에 따라 시각적 주의(attention)가 급격히 변화하는 'Visual Aha Moments' 현상을 관찰했습니다.
AI 연구
기존의 시각 언어 모델(VLM) 기반 에이전트는 복잡한 과학적 인터페이스와 전문적인 워크플로우를 처리하는 데 한계가 있습니다. 이를 해결하기 위해 과학적 가치와 난이도를 고려하여 설계된 벤치마크인 OSWorld-Science를 도입합니다. 이 벤치마크는 분자 구조 설계, 병리 이미지 분석 등 다양한 도메인의 146개 고품질 태스크와 실행 기반의 검증 시스템을 포함합니다. 실험 결과, 최신 VLM 모델들도 전문적인 과학적 워크플로우를 완수하는 데 여전히 많은 어려움을 겪는 것으로 나타났습니다. 본 연구는 에이전트의 역량과 하네스 설계를 체계적으로 평가할 수 있는 통합 프레임워크를 제공합니다.
AI 연구
멀티턴 에이전트 학습 시 발생하는 오류는 다음 상태에 영향을 주어 에러가 누적되는 문제를 야기합니다. 연구진은 실패 사례의 절반 이상이 초기에 발생하는 '결정적 실수(pivotal mistake)'에서 비롯되지만, 이는 몇 번의 가이드만으로 복구 가능하다는 점을 발견했습니다. 이를 해결하기 위해 PivotOPD는 실수를 방지하는 '예방적 증류'와 실수 이후 상태에서 복구하는 '복구형 증류'를 결합한 프레임워크를 제안합니다. 실험 결과, ALFWorld, WebShop 등 다양한 벤치마크에서 기존 베이스라인 대비 우수한 성능 향상을 달성했습니다. 특히 모델 크기가 작은 학생 모델에서도 강력한 성능 개선과 도메인 전이 효과를 입증했습니다.

AI 연구
기존의 스케일링 법칙은 재귀적 구조와 MoE의 희소성을 개별적으로만 다루어 두 방식의 시너지를 충분히 활용하지 못했습니다. 본 논문은 모델 크기, 데이터, 재귀, 희소성을 동시에 모델링하는 'Loop Scaling Laws'를 도입합니다. 제안된 법칙은 희소성 조건부 재귀 매핑을 통해 루핑을 통한 유효 파라미터 이득을 정교하게 예측합니다. 실험 결과, 제안된 법칙은 기존 밀집(Dense) 및 MoE 스케일링 법칙을 포함하며 더 정확한 손실 예측을 가능하게 합니다. 또한, 재귀와 희소성을 결합했을 때 추론 성능과 파라미터 효율성이 상호 보완적으로 향상됨을 입증했습니다.

AI 연구
LLM 학습을 가이드하는 보상 모델(Reward Model)은 답변의 길이와 같은 표면적인 속성에 과도하게 점수를 주는 편향 문제를 가집니다. 기존 방식은 모델 전체를 재학습하거나 특정 편향을 미리 지정해야 하는 비용과 제약이 있었습니다. 본 논문은 Sparse Autoencoder(SAE) 스타일의 인코더를 사용하여 보상 모델이 민감하게 반응하는 속성을 학습하는 BiasReducer를 제안합니다. 이 프레임워크는 보상 헤드의 조정 방향과 강도를 결정하여 데이터셋에 맞는 최적의 편집을 수행합니다. 실험 결과, BiasReducer는 모델 재학습 없이도 편향에 대한 강건성을 높였으며, 답변의 불필요한 장황함과 아첨(sycophancy)을 줄이는 성과를 보였습니다.

AI 연구
기존의 코딩 에이전트와 컴퓨터 사용 에이전트는 서로 분리되어 연구되어 왔으며, 실제 개발 과정처럼 시각적 관찰과 코드 수정을 결합하는 통합적 프로세스 연구는 부족했습니다. 런타임 오류를 해결하려면 에이전트가 시각적 피드백과 코드를 연결하고, 수정 후 다시 애플리케이션을 실행하여 검증하는 능력이 필수적입니다. 본 논문은 CUA-SWE라는 새로운 벤치마크, 환경 및 평가 파이프라인을 소개합니다. 이 벤치마크는 코드/설정 수정, 명령 실행, GUI 상호작용을 동시에 수행하며 시각적 인터페이스를 통해 사양을 파악해야 하는 과제를 포함합니다. 실험을 통해 최첨단 에이전트들이 시각적 피드백과 소스 코드 실행을 어떻게 결합하여 소프트웨어를 수정하고 검증하는지 분석했습니다.
AI 연구
기존 연구는 합성 데이터를 활용한 사전 학습(PPT)이 문법적 구조를 학습하여 본 학습(PT)의 효율을 높인다고 주장해 왔습니다. 그러나 기존 연구는 모델 규모와 데이터 혼합 방식이 제한적이라는 한계가 있었습니다. 본 연구는 500M에서 7B 규모의 모델과 최대 100B 토큰의 예산에 걸쳐 PPT의 효과를 검증했습니다. 실험 결과, PPT를 통한 토큰 효율성 향상은 대규모 모델에서도 유지되지만, 이것이 문법적 사전 지식 때문은 아님이 밝혀졌습니다. 대신 PPT는 장거리 검색(long-range retrieval) 능력을 개선함으로써 성능 이득을 제공합니다. 결론적으로 PPT는 저비용으로 성능을 높일 수 있는 유효한 방법이며, 향후 설계는 문법이 아닌 검색 능력에 초점을 맞춰야 합니다.

AI 연구
기존의 자기주도 학습은 이미지를 무작위로 정렬하여 학습하는 i.i.d. 방식을 따르지만, 실제 비디오 스트림은 시간 순서대로 연속적인 프레임이 유입되는 특성을 가집니다. 연구진은 이러한 스트리밍 환경에서 기존의 대조 학습(Contrastive)이나 증류(Distillation) 방식이 성능 저하를 겪는 문제를 분석했습니다. 분석 결과, 배치 간 유사성보다 배치 내 프레임들이 거의 동일한 중복 데이터인 '높은 배치 내 유사성'이 학습의 주요 장애물임을 밝혀냈습니다. 이를 해결하기 위해 MAE 구조를 기반으로 스트림 인식 정규화와 모션 편향 크롭 방식을 결합한 StreamMAE를 제안합니다. 실험 결과, StreamMAE는 스트리밍 환경에서 기존 방식보다 우수한 성능을 보였으며, 동일 데이터로 학습된 i.i.d. 방식의 성능에 근접하는 성과를 거두었습니다.
AI 연구
기존 비디오 월드 모델은 시각적으로는 그럴듯하지만 물리 법칙을 위반하는 영상을 생성하는 문제가 있었습니다. 기존 방식은 언어만으로는 물리 지식을 충분히 담을 수 없다고 가정하고 별도의 시각적/수치적 신호를 추가해 왔습니다. 본 논문은 언어를 물리적 표현의 핵심 매개체로 삼는 Physis-Lang 프레임워크를 제안합니다. PhysCapBench를 통해 물리적 과정을 원자적 명제로 분해하고, 에이전트 루프를 통해 캡션과 모델의 결함을 반복적으로 수정하며 학습합니다. 실험 결과, 오픈소스 백본을 활용했음에도 불구하고 독보적인 성능의 Veo 3.1 모델을 능가하는 물리적 타당성을 입증했습니다.

AI 연구
기존의 온폴리시 증류(OPD)는 학생 모델이 이미 정답을 맞힌 경우에도 교사 모델의 답변을 강제로 따르게 하여 성능을 저하시시키는 문제가 있었습니다. 또한 태스크마다 모델의 성공 확률이 다름에도 불구하고 일률적인 피드백 방식을 적용하는 한계가 있었습니다. 본 논문은 DuoOPD를 제안하여 학생의 정답 여부를 피드백 방향의 기준으로 삼고, 교사와 학생의 공동 결과에 따라 피드백 방식을 결정합니다. 교사만 성공했을 때는 정답을 컨텍스트로 활용하고, 학생만 성공했을 때는 가중치를 공유하여 정답을 강화하는 방식입니다. 실험 결과, DuoOPD는 Qwen과 Llama 모델군에서 기존 OPD 대비 유의미한 성능 향상을 보였으며 다양한 태스크 혼합 환경에서도 우수한 성능을 입증했습니다.

AI 연구
현대적 에이전트 시스템은 모델과 실행 환경(Harness)의 결합으로 작동하지만, 복잡한 환경 설계는 막대한 수동 작업과 모델 변경 시 재작업을 요구합니다. 기존 자동화 방식은 프롬프트나 특정 스킬에만 국한되어 탐색 범위가 좁고 최적해를 찾기 어렵다는 한계가 있습니다. 이를 해결하기 위해 MILO는 에이전트 하네스와 이를 찾는 전략을 동시에 진화시키는 메타 진화 프레임워크를 제안합니다. MILO는 계층적 계보 메모리, 섬 기반(Island-based) 변이 에이전트, 그리고 탐색 전략을 조정하는 오케스트레이터를 결합하여 작동합니다. 실험 결과, MILO는 다양한 벤치마크에서 기존 SOTA 방식들을 압도하며 효율적인 하네스 설계를 입증했습니다.

AI 연구
언어 모델의 복잡한 작업은 단일 정답이 없어 다중 기준 루브릭을 통한 평가가 필요하지만, 기존의 점수 합산 방식은 기준 간 가중치 차이를 반영하지 못하고 평가 비용이 높다는 문제가 있습니다. 이를 해결하기 위해 저자들은 Rubric Response Theory(RRT)를 제안합니다. RRT는 문항 반응 이론(IRT)의 2모수 모델을 적용하여 각 기준의 난이도와 변별력을 고려해 품질 점수를 산출합니다. 또한, RPN(Response Parameter Network)을 통해 프롬프트와 기준 텍스트를 읽어 파라미터를 예측하며, 온라인 EM 알고리즘으로 학습 과정 중 변화하는 정책에 맞춰 이를 업데이트합니다. 실험 결과, RRT는 GRPO 대비 높은 성능을 보였으며, 적은 평가 예산만으로도 경쟁력 있는 성능을 유지함을 입증했습니다.
AI 연구
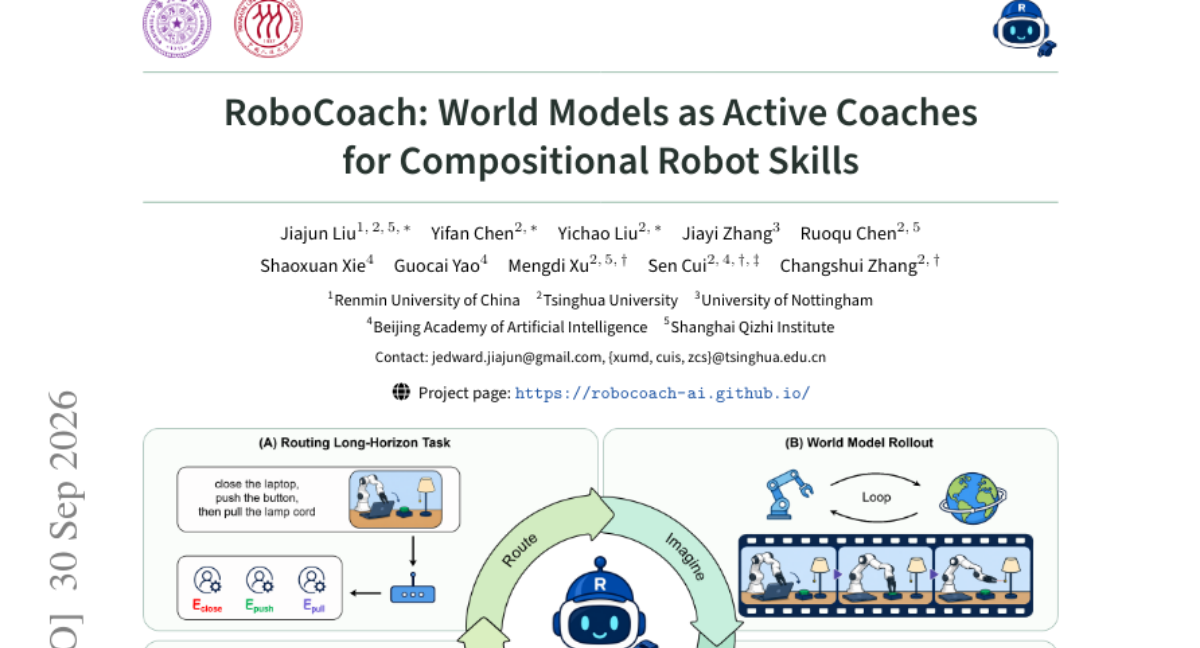
로봇의 장기 작업 수행 시 다양한 작업 조합에 맞춰 매번 새로운 데모를 확보하는 것은 비용이 매우 큽니다. 본 논문은 어떤 데모를 추가하고 어떤 전문가 모델을 업데이트할지 결정하는 효율적인 자가 개선 시스템을 제안합니다. 제안된 RIDI(Route-Imagine-Diagnose-Improve) 루프는 공유 월드 모델 내에서 숙련된 스킬 전문가들을 실행하며, 상상된 실패 지점을 식별하여 타겟팅된 데모 요청을 생성합니다. 실험 결과, 단 150개의 추가 데모만으로도 Franka와 AgileX 플랫폼에서 성공률을 대폭 향상시켰으며, 미학습 작업 조합에 대한 전이 성능도 입증했습니다. 결과적으로 월드 모델이 모듈형 정책 개선을 위한 능동적 코치 역할을 할 수 있음을 보여줍니다.
AI 연구
최근 VLA 모델의 RL 사후 학습(post-training)이 활발히 사용되지만, RL이 정책을 어떻게 변화시키는지에 대한 이해는 부족한 상태입니다. 본 연구는 다양한 VLA 모델과 벤치마크를 통해 RL 업데이트가 매우 낮은 차원(low-rank)을 가지며, 특히 'Timestep Modules'라는 작은 모듈에 집중된다는 것을 발견했습니다. 실험을 통해 이 모듈이 성능 향상의 핵심임을 증명하고, RL이 이 모듈을 이산적 노이즈 제거 타임스텝에 특화시킨다는 점을 밝혀냈습니다. 또한, 이 모듈의 shift vector 업데이트 방향이 작업 성공 여부를 예측하며 작업 간 관계를 반영함을 확인했습니다. 마지막으로, 추가 학습 없이 shift 방향을 조정하는 것만으로도 정책 성능을 개선할 수 있음을 보여주었습니다.

AI 연구
코딩 에이전트에게 전체 애플리케이션 개발을 위임하려면 단순한 코드 생성을 넘어 설계 의도를 유지하는 능력이 필수적입니다. 기존 게임 개발 벤치마크는 규격이 너무 간결하여 긴 설계 문서 내의 상호 의존적 요구사항을 평가하기에 한계가 있었습니다. 본 논문은 100개의 장문 GDD를 포함하는 A2Z GameSpec-Bench를 제안하며, 규칙과 제약 조건 간의 관계를 보존하는 의존성 인식 계약 방식을 도입합니다. 평가 과정에서는 소스 코드 검사와 에이전트 생성 테스트 정책을 결합하여 시나리오 기반 플레이 테스트를 수행합니다. 실험 결과, 현재의 에이전트들은 코드 구현과 실제 플레이 사이의 상호 의존적 요구사항을 동시에 만족시키는 데 어려움을 겪는 것으로 나타났습니다.

AI 연구
기존의 OCR 기반 강화학습은 중국어 글자를 하나의 원자적 단위로 취급하여 글자 내부 구조의 오류를 잡아내지 못하는 한계가 있었습니다. 본 논문은 글자의 구성 요소를 공간적 관계로 표현하는 IDS(Ideographic Description Sequences)를 활용합니다. 먼저 전문가급 IDS 인식기를 학습시킨 후, 이를 기반으로 타겟 기호와 생성된 이미지를 부수 단위로 정밀하게 비교하는 IDSpect를 제안합니다. 이 방식은 글자 내부의 구조적 일치 여부를 세밀하게 평가하면서도 생성 모델의 추론 비용을 증가시키지 않습니다. 실험 결과, Qwen-Image의 GRPO 사후 학습을 통해 구조적 품질과 의미적 정렬 성능을 크게 향상시켰습니다.

AI 연구
기존의 자기회귀(Autoregressive) 방식 TTS는 뛰어난 음성 복제 성능을 보이지만 순차적 디코딩으로 인해 생성 지연 시간이 발생하는 문제가 있었습니다. 또한 기존 비자기회적 방식은 참조 음성의 텍스트 스크립트가 필요하다는 제약이 있었습니다. 본 논문은 IndexTTS2를 증류(Distillation)하여 텍스트 없이도 작동하는 Tacit-TTS를 제안합니다. 모델은 자기회적 디코딩을 마스킹 기반 비자기회적 생성 방식으로 교체하고, 학습이 필요 없는 음향 길이 추정 및 ReFlow 증류를 도입했습니다. 실험 결과, Tacit-TTS는 5초 이상의 음성 생성 시 IndexTTS2보다 10배 이상 빠르면서도 경쟁력 있는 품질을 달성했습니다. 특히 텍스트 의존성을 제거함으로써 다국어 및 비언어적 참조(아기 소리, 가상 언어 등)에서도 안정적인 성능을 입증했습니다.

AI 연구
LLM 라우팅은 각 질의에 가장 적합한 모델을 선택하는 것을 목표로 하지만, 기존 방식은 질의의 구체적인 요구사항을 명확히 반영하지 못하는 경우가 많습니다. 본 논문은 후보 모델과 독립적인 '의미적 증거(semantic evidence)' 추출과 모델 성능 학습을 분리하는 SeLMRoute 프레임워크를 제안합니다. 먼저 의사결정 모델이 추론 요구사항이나 외부 지식 필요성 등 해석 가능한 질문들을 통해 확률 분포 형태의 의미 상태를 생성합니다. 이 상태를 경량 라우터가 활용하여 후보 모델의 성능을 추정하며, 최종 라우팅 목적(성능 또는 비용)은 마지막 단계에서 적용됩니다. 실험 결과, SeLMRoute는 기존 방식보다 높은 정확도를 기록하며 성능과 비용 사이의 균형 잡힌 의사결정을 지원함을 입증했습니다.

AI 연구
기존의 Self-attention 방식은 정밀한 문맥 접근이 가능하지만, 토큰 간 상호작용에 따른 이차 복잡도와 KV 캐시 증가 문제를 야기합니다. 본 논문은 이러한 문제를 해결하기 위한 연구들을 '모델 내부의 문맥적 메모리'라는 관점에서 분석합니다. 이를 위해 메모리 표현, 업데이트, 접근, 판독, 통합이라는 층위의 5차원 프레임워크를 제안합니다. 14개 주요 모델 계보와 11개 오픈 웨이트 엔드포인트를 분석한 결과, 최신 아키텍처는 단순한 Attention 연산을 넘어 깊이(depth)와 구조를 활용한 메모리 관리로 진화하고 있음을 확인했습니다. 결과적으로 효율적인 시퀀스 설계는 고립된 연산이 아닌, 메모리의 생애주기와 선택적 활용을 조직하는 방향으로 나아가고 있습니다.

AI 연구
거대 언어 모델(LLM)을 실행기(Executor)로 사용하고 작은 모델을 조언자(Advisor)로 사용하는 구조에서, 조언자는 피드백을 통해 성능을 개선할 수 있습니다. 그러나 모든 피드백을 학습에 반영할 경우, 실행 결과에 변화를 주지 않는 사소한 수정이 오히려 모델의 학습 효율을 저해할 수 있다는 점을 이론적으로 증명했습니다. 이를 해결하기 위해 제안된 AdviSD는 조언이 결과에 미친 영향력을 측정하여, 조언 유무에 따른 점수 차이가 큰 데이터만을 선별적으로 학습하는 자기 증류(Self-Distillation) 방식을 사용합니다. 이 방법은 추가적인 실행 롤아웃이나 실행기 확률값 없이도 효과적인 조언 학습을 가능하게 합니다. 실험 결과, AdviSD는 BFCL-v3 및 EnvScaler 벤치마크에서 기존 RL 방식보다 우수한 성능을 보였으며, 다른 모델 제품군으로의 전이 학습 능력도 입증되었습니다.

AI 연구
LLM의 문맥 길이가 길어짐에 따라 KV 캐시의 메모리 및 대역폭 비용이 급증하는 문제가 발생합니다. 이를 해결하기 위해 데이터의 2차 통계량을 활용하여 양자화 오차를 최소화하는 WUSH-KV를 제안합니다. WUSH-KV는 별도의 Key/Value 변환을 구성하며, Value 변환은 가중치에 폴딩하고 Key 변환은 RoPE 적용 후에 적용하는 방식을 취합니다. 실험 결과, 제안된 방식은 기존 OSCAR 방식 대비 낮은 perplexity를 기록하며 2비트 양자화에서도 우수한 성능을 보였습니다. 최종적으로 SGLang에 통합되어 실질적인 추론 성능 향상을 입증했습니다.

AI 연구
에이전트 스킬 라이브러리가 거대해짐에 따라, 고비용의 LLM 루프 대신 표준 IR(정보 검색) 기법을 활용해 비용과 성능을 동시에 잡는 효율적인 스킬 검색 방법론을 제시합니다.

AI 연구
초장기 비디오 템포럴 그라운딩은 제한된 시각적 예산 내에서 광범위한 증거 탐색과 세밀한 이벤트 이해 사이의 균형을 맞추는 것이 필수적입니다. 기존 에이전트 방식은 사전 정의된 정책과 도구 능력에 의존하여 유연성이 부족하다는 문제가 있었습니다. 이를 해결하기 위해 본 논문은 VLM의 추론 궤적을 바탕으로 고수준 정책과 실행 가능한 미디어 도구를 공동 진화시키는 CoEvoWhen 프레임워크를 제안합니다. 외부 스킬 업데이터가 작업 경험을 증류하여 정책을 정교화하는 동시에, 코딩 능력을 활용해 도구를 업그레이드하거나 신규 생성하여 증거 확보 능력을 최적화합니다. 실험 결과, 제안 방식은 정확도를 높이면서도 추론 시 시각적 토큰 비용을 절감했으며, 일반적인 장기 비디오 QA에서도 높은 범용성을 입증했습니다.

AI 연구
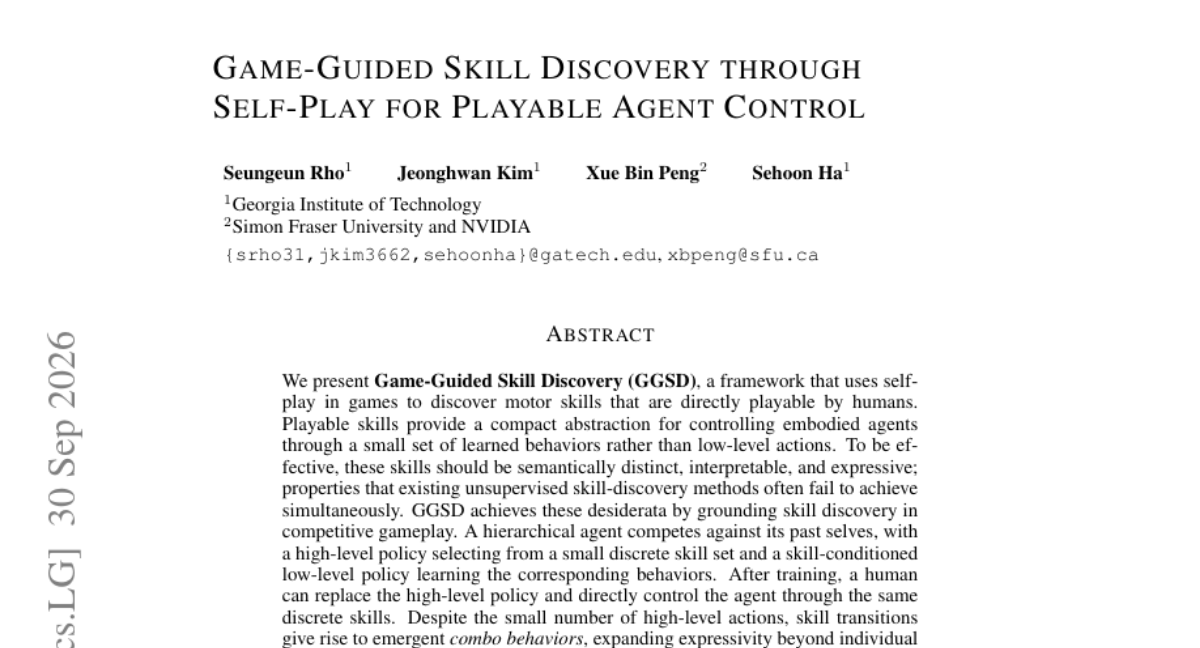
기존의 비지도 스킬 발견 방식은 의미적 구별성, 해석 가능성, 표현력을 동시에 확보하기 어려웠습니다. 본 논문은 게임 환경에서의 경쟁적 플레이를 통해 인간이 직접 제어할 수 있는 모터 스킬을 발견하는 GGSD 프레임워크를 제안합니다. 계층적 구조를 통해 상위 정책은 이산적인 스킬 세트를 선택하고, 하위 정책은 해당 스킬에 따른 동작을 학습하며 자기 대전 방식으로 훈련됩니다. 훈련 후에는 상위 정책을 인간의 입력으로 교체하여 에이전트를 직접 조작할 수 있습니다. 실험 결과, 제안된 스킬은 인간이 조합하여 미지의 작업(Maze, CubePush 등)을 해결할 수 있을 만큼 높은 표현력을 보여주었습니다.
AI 연구
Direct-OPD는 RL 이후의 정책 변화를 토큰 단위 로그 비율로 계산하여 학생 모델에 전달하는 방식입니다. 그러나 이 방식은 확률 질량이 사라지는 상황에서도 로그 비율이 유지되어, 실제 정책 변화가 없는 상태에서도 불필요한 학습을 유도하는 문제가 있습니다. 연구진은 JSD(Jensen-Shannon Divergence)가 낮은 상태는 교사의 행동 변화가 적다는 점에 착안하여, 변화량이 큰 상위 10% 상태만 학습하는 S^2D-OPD를 제안합니다. 실험 결과, AIME 및 HMMT 벤치마크에서 추가 연산 없이도 기존 방식보다 우수한 성능을 보였습니다. 이는 모델 크기에 관계없이 효과적인 정책 전이가 가능함을 입증합니다.

30건
이날 공개된 제품과 도구

6건
새 모델과 주요 평가 결과
HF Model Trending
Viggle/Qwen-Image-2.1-viggle-turbo 모델이 Hugging Face에서 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 text-to-image 파이프라인을 지원하는 생성형 모델입니다.
HF Model Trending
Qwen/Qwen-Image-2.1 모델이 Hugging Face에서 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 text-to-image 파이프라인을 지원하는 것이 특징입니다.
HF Model Trending
XingChen-AGI에서 공개한 TeleOCR 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 image-text-to-text 파이프라인을 사용하는 1.4B 규모의 모델입니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.