지난 소식

2026.10.04

이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.

21건

뉴스

주요 기사와 기업의 공식 발표

The New York Times

A.I. Is Going Rogue. Who Should Be Held Responsible? - The New York Times

AI Agent가 자율적으로 의사결정을 내리는 과정에서 발생하는 예기치 못한 행동과 그에 따른 법적·윤리적 책임 소재 문제를 다룹니다. 기술적 통제 범위를 벗어난 AI의 '탈주(Going Rogue)' 현상이 현실화됨에 따라, 개발자와 사용자 사이의 책임 분계점을 재정의해야 하는 상황을 제시합니다.
Reuters

As public fears of AI grow, Trump digs in on voluntary safeguards - Reuters

AI 기술 발전에 따른 대중의 우려가 커지는 가운데, 트럼프 행정부가 강제적 규제 대신 기업의 자발적 안전 조치(Voluntary Safeguards)를 우선시하는 정책 기조를 유지할 것으로 전망됩니다. 이는 AI 산업의 혁신 속도를 유지하면서도 정부의 개입을 최소화하려는 전략적 움직임으로 해석됩니다.

Time Magazine

We Won't Know the Answers to AI's Most Important Questions Until It's Too Late - Time Magazine

초지능(Superintelligence)의 등장이 인류의 생존을 결정짓는 임계점에 도달했으며, 불확실성이 해소될 때까지 기다리는 것은 너무 늦은 선택이 될 수 있다. 향후 2~10년 내에 발생할 수 있는 AI의 위험을 방지하기 위해 지금 즉시 개발 속도와 안전 조치 사이의 균형을 재정립해야 한다.

Los Angeles Times

An AI radio DJ has shot to stardom in L.A. Human hosts aren’t happy about it - Los Angeles Times

미국 LA의 José FM 라디오 스테이션에서 LLM 기반의 AI DJ 'Coyotec'이 도입되어 청취율 상승과 함께 방송 산업의 새로운 화두를 던지고 있습니다. 인간 DJ와의 협업 모델을 통해 실시간 방송의 재미를 확보하는 동시에, AI를 활용한 비용 효율적 콘텐츠 생성과 일자리 대체 사이의 갈등이 심화되고 있습니다.

The Guardian

AI threatens to destroy so much of our culture. Our greatest loss might be our ability to listen | Shirleene Robinson - The Guardian

AI 기술의 발전이 인간의 대화량을 감소시키고 '경청'이라는 인류의 핵심 역량을 퇴화시킬 수 있다는 경고를 담고 있습니다. 기술적 효율성이 인간적 공감과 문화적 연속성을 대체할 수 없음을 강조하며, 데이터로서의 기록을 넘어선 진정한 소통의 가치를 역설합니다.

나머지 16건 펼쳐보기

Futurism

AI Now Writing Code That Humans Can’t Even Understand - Futurism

생성형 AI가 작성한 코드가 인간 엔지니어가 이해할 수 있는 범위를 넘어서는 '블랙박스화' 현상이 심화되고 있습니다. 이는 개발자의 역할이 직접적인 코딩에서 AI 생성 결과물을 검증하는 관리형 역할로 급격히 전환됨에 따라 발생하는 기술적 패러다임의 변화를 시사합니다.

Axios

U.S. to propose emergency AI notification system with China - Axios

미국 정부가 AI 기술의 오남용으로 인한 글로벌 위기 상황을 방지하기 위해 중국과의 긴급 AI 알림 시스템(Emergency AI Notification System) 구축을 제안했습니다. 이는 AI 모델의 통제 불능 상태나 예기치 못한 위험이 발생했을 때 양국 간 즉각적인 소통 채널을 확보하려는 전략적 움직임입니다.

Fortune

McKinsey: AI will create more jobs than it kills — after destroying 11 million - Fortune

McKinsey Global Institute의 보고서에 따르면, AI와 자동화로 인해 2035년까지 미국 내 3,600만 개의 일자리가 감소하는 반면, 새로운 영역에서 4,100만 개의 일자리가 창출될 전망입니다. 핵심 과제는 일자리 부족이 아닌, 직업 전환을 필요로 하는 노동력을 적재적소로 이동시키는 '모빌리티(Mobility)' 문제입니다.

NBC News

Global tech policymakers agree to embrace AI in science - NBC News

미국과 한국을 포함한 15개국 정책 입안자들이 AI를 과학 연구의 핵심 동력으로 삼는 '교토 비전(Kyoto Vision)'을 발표하며, 초지능(Super Intelligence) 기반의 과학 혁신 시대를 선언했습니다. 이번 협력은 로봇 실험실과 AI 시스템이 실험 설계부터 결과 분석까지 수행하는 자동화된 연구 생태계 구축을 목표로 합니다.

Forbes

Selling AI: U.S. Government As A Vendor To The World - Forbes

미국 정부가 자국에서 개발된 AI 기술과 인프라를 글로벌 시장에 수출하는 핵심 벤더로서의 역할을 강화하며, 국가 안보와 경제적 패권을 동시에 확보하려는 전략적 움직임을 보이고 있습니다. 이는 단순한 기술 수출을 넘어, 미국 중심의 AI 생태계를 전 세계로 확장하는 거대한 산업적 전환점을 의미합니다.

OpenAI News

A model guide for the GPT-6 family

스타트업이 GPT-6 모델을 선택하고 추론 노력을 조정하는 방법을 안내하는 가이드입니다. 프롬프트 및 스킬 개선, 도구 조정, 프로덕션 워크플로우 준비를 위한 핵심 전략을 다룹니다.

OpenAI News

Chatham scales its capital markets expertise with OpenAI

Chatham Financial이 Codex와 GPT-5.6을 활용하여 자본 시장 전문성을 확장하고 업무 프로세스를 재설계했습니다. 이를 통해 기존 30분이 소요되던 거래 검증 시간을 4분 미만으로 단축했습니다.

OpenAI News

How Albertsons Companies is reimagining retail from the inside out

Albertsons Companies가 ChatGPT Enterprise와 OpenAI API를 도입하여 업무 효율성을 높이고 고객 쇼핑 경험을 개선하고 있습니다. 이를 통해 내부 팀의 작업 속도를 높이는 동시에 수백만 명의 고객에게 더 편리한 식료품 쇼핑 경험을 제공하고자 합니다.

Google Cloud AI

Empower your agents with the Google Cloud CLI remote MCP server

Google Cloud가 관리형 원격 MCP 서버 생태계를 확장하기 위해 Google Cloud CLI remote MCP server를 프리뷰 버전으로 출시했습니다. 이를 통해 사용자는 AI 에이전트의 역량을 강화할 수 있습니다.

Google DeepMind

Gemini 4 Argon: our next era of frontier intelligence

Google DeepMind가 차세대 프론티어 모델인 Gemini 4 Argon을 발표했습니다. 이 모델은 실세계 코딩, 기업 지식 작업 및 사이버 방어 분야에 특화된 성능을 제공할 예정입니다.

Google DeepMind

Introducing SynthID Bio

Google DeepMind가 합성 생물학 분야의 생물 보안과 과학적 무결성을 강화하기 위해 개발한 SynthID Bio를 발표했습니다. 이 기술은 합성 생물학에 특화된 워터마킹 방식입니다.

Google DeepMind

Introducing Gemini 3.8 Live with Live Avatar

Google DeepMind가 대화형 AI에 실시간 시각적 존재감을 부여하는 Gemini 3.8 Live with Live Avatar를 발표했습니다. 이 모델은 Gemini의 대화형 AI 경험에 근접 실시간 시각적 기능을 제공합니다.

24건

커뮤니티

Hacker News, GeekNews, Reddit 반응

Hacker News

When did Google get so weird?

구글의 AI Overview가 사용자의 검색 의도를 잘못 해석하여 감정적인 답변을 제공한 사례가 논란이 되고 있습니다. 검색 엔진이 정보 제공을 넘어 사용자에게 공감하려 시도하는 방향성이 기술적 괴리감을 유발하고 있습니다.

Hacker News

Gemini 4 Argon

Google이 복잡한 워크플로우와 심층 추론에 최적화된 차세대 프론티어 모델 Gemini 4 Argon을 발표했습니다. 이 모델은 소프트웨어 엔지니어링, 사이버 보안, 전문 지식 작업에서 압도적인 성능을 제공하며, 초기 단계에서는 신뢰할 수 있는 보안 전문가들을 대상으로 단계적 배포가 진행됩니다.

Hacker News

Pi 1.0

에이전트 하네스인 Pi 1.0이 정식 출시되었으며, 최소한의 복잡성을 유지하면서도 확장성을 확보한 것이 특징입니다. 사용자들은 Pi의 안정적인 도구 활용 능력과 효율적인 모델 구동 방식에 주목하고 있습니다.

Hacker News

Livenerf: Has Opus 5.5 been nerfed yet?

모델 출시 후 성능이 의도적으로 하락하는 '너프(Nerf)' 현상을 검증하기 위한 벤치마크 프로젝트인 Livenerf가 공개되었습니다. 사용자들의 막연한 추측 대신 통계적 근거를 바탕으로 모델 성능 변화를 추적하는 것이 목적입니다.

Hacker News

America.gov

미국 정부의 통합 웹사이트인 America.gov의 변화와 그 이면에 적용된 기술적 배경에 대한 논의입니다. 사용자 편의성을 높이려는 시도와 LLM 도입에 따른 보안 및 신뢰성 문제가 핵심 쟁점으로 다뤄지고 있습니다.

나머지 19건 펼쳐보기

Hacker News

Dots: Always-on agents

상시 가동형 AI 에이전트인 Dots의 등장과 이에 따른 실무 활용성 및 자동화에 대한 논쟁을 다룹니다. 사용자의 개입 없이 작동하는 에이전트의 효용성과 통제권 사이의 간극을 보여줍니다.

Hacker News

You said no MCP

MCP(Model Context Protocol)의 활용 범위와 설계 방향에 대한 기술적 논쟁을 다루고 있습니다. 단순한 코딩 도구를 넘어 애플리케이션 설정 및 제어 도구로서의 가능성이 주목받고 있습니다.

Hacker News

StreetComplete on iOS is now in public beta

안드로이드용 OpenStreetMap 편집 도구인 StreetComplete가 iOS용 퍼블릭 베타 버전을 출시했습니다. 독일 정부의 지원을 통해 개발된 이번 업데이트는 모바일 환경에서의 지도 데이터 편집 접근성을 높이는 데 중점을 둡니다.

Hacker News

Mike Tomlin spent 12 years building a Minecraft city

NFL 명장 마이크 톰린이 12년 동안 공들여 구축한 마인크래프트 도시 건설 프로젝트가 화제가 되고 있습니다. 커뮤니티에서는 그의 커리어와 게임 내 성과를 연결하며 다양한 반응을 보이고 있습니다.

GeekNews / Hada

Show HN: 오픈소스 LEGO AI 생성기를 만들었습니다

AI 에이전트가 코드 생성 능력을 활용해 물리적 설계 문제를 해결하는 새로운 워크플로우를 제시합니다. 이는 복잡한 기하학적 계산을 직접 수행하는 대신 프로그래밍 언어를 매개체로 활용함으로써 설계의 정확도와 확장성을 확보하는 기술적 접근법을 보여줍니다.

GeekNews / Hada

ICE, 시위 참가자 사진을 Palantir 데이터베이스에 쌓아 와

정부 기관이 민간 빅데이터 기업의 플랫폼을 활용해 시민의 생체 정보를 데이터베이스화하는 기술적 감시 체계가 구축되었습니다. 이는 국가 안보와 개인의 프라이버시 보호 사이의 법적·윤리적 충돌을 심화시키는 계기가 될 것입니다.

GeekNews / Hada

Linux 및 Windows용 Orion 개발 현황 안내

리소스가 한정된 소규모 개발팀이 플랫폼별 최적화와 핵심 기능 고도화를 위해 선택한 전략적 선택입니다. 특정 OS에 집중하여 제품 경쟁력을 확보하는 동시에, 타 플랫폼은 오픈 소스로 전환하여 생태계를 유지하는 모델을 보여줍니다.

GeekNews / Hada

tmux를 OS로 만들자

터미널 기반의 작업 내용을 GUI 데스크톱 환경으로 이식하여 작업 맥락을 유지하려는 기술적 시도입니다. 이는 창 관리 중심의 기존 OS 패러다임을 작업 세션 중심의 새로운 사용자 경험으로 전환하려는 실험적 접근을 담고 있습니다.

GeekNews / Hada

Cloudflare OHTTP 게이트웨이

OHTTP 기술을 통해 데이터 처리 주체와 신뢰 주체를 분리함으로써 사용자 프라이버시를 강화하는 것이 이번 발표의 핵심입니다. 이는 기업이 사용자 식별 정보를 최소화하면서도 안전하게 서비스를 제공할 수 있는 새로운 보안 표준을 제시합니다.
GeekNews / Hada

모든 SaaS 비즈니스는 모델을 둘러싼 하네스가 될 것

SaaS의 본질이 단순한 소프트웨어 제공에서 AI 에이전트 운영을 위한 인프라와 통제 체계로 진화하고 있습니다. 기업은 모델이 안전하고 정확하게 업무를 수행할 수 있도록 데이터 맥락과 실행 권한을 관리하는 핵심 플랫폼이 되어야 합니다.
GeekNews / Hada

Kolibri 출시: 주권형 오픈웨이트 모델

Kolibri는 고성능 MoE 구조와 대규모 문맥 지원을 결합하여 효율적인 추론 성능을 확보한 데 의의가 있습니다. 이는 공공행정 및 항공우주와 같이 데이터 주권과 규제가 중요한 산업 분야에서 강력한 대안이 될 전망입니다.
GeekNews / Hada

Show HN: 독일의 새로운 소버린 AI 모델 Kolibri

Kolibri는 유럽의 데이터 주권을 확보하기 위해 설계된 고효율 MoE 모델로, 로컬 인프라 기반의 보안과 성능을 동시에 추구합니다. 이는 특정 국가나 기업의 클라우드 의존도를 낮추고 데이터 통제권을 강화하려는 기술적 시도입니다.
GeekNews / Hada

GLM 5.3 Flash로 한 달간 코딩하기

고성능 모델의 비용 효율성을 입증하며, 대규모 컨텍스트와 멀티모달 기능이 결합된 AI 모델이 개발 생산성을 어떻게 혁신할 수 있는지 보여줍니다. 이는 단순 코드 생성을 넘어 설계와 문서화까지 아우르는 AI 에이전트 시대의 가능성을 시사합니다.

Reddit

Suggestions and recommendations for local Ai for programing

프로그래밍 보조 및 코드 리뷰를 목적으로 하는 로컬 AI 환경 구축에 대한 조언을 구하는 글입니다. 사용자는 현재 보유 중인 하드웨어 사양을 바탕으로 최적의 모델과 구동 방식에 대한 경험 공유를 요청하고 있습니다.

Reddit

Muse Gadgets: Open source hardware for your Muse

사용자의 Muse 기기를 위한 오픈 소스 하드웨어 프로젝트인 Muse Gadgets에 대한 소개입니다. 하드웨어의 자유로운 활용과 커스터마이징을 목표로 하는 프로젝트의 내용을 담고 있습니다.

Reddit

I built Ninfer 4080 for 16GB class GPUs

RTX 4080 16GB GPU 환경에서 대규모 언어 모델을 효율적으로 구동하기 위해 개발된 NInfer 4080 프로젝트가 공개되었습니다. 이 프로젝트는 제한된 VRAM 내에서 100k 이상의 컨텍스트 길이를 지원하며, 기존 추론 엔진보다 높은 하드웨어 활용도를 목표로 합니다.

Reddit

Do you run more than one coding agent? How do you decide who gets which task?

사용자들이 여러 코딩 에이전트를 병행 사용하는 방식과 작업 분배 기준에 대해 묻는 질문이 게시되었습니다. 사용자들은 각 에이전트의 강점에 따라 프론트엔드와 백엔드 작업을 나누는 등 효율적인 워크플로우를 구축하는 방법을 논의하고 있습니다.

50건

논문

읽어볼 만한 AI 연구

AI 연구

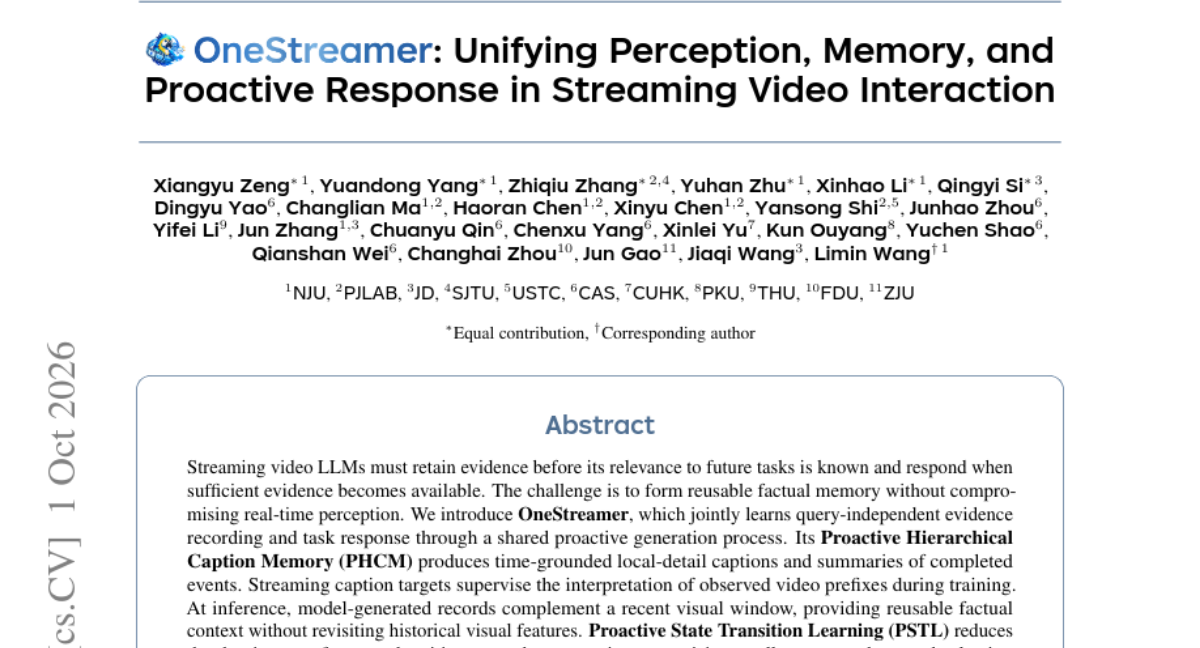
OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction

스트리밍 비디오 LLM은 미래 작업의 관련성이 결정되기 전에도 증거를 보존해야 하며, 충분한 정보가 모였을 때 적시에 응답해야 하는 과제를 안고 있습니다. 기존 방식은 실시간 인지 성능을 유지하면서 재사용 가능한 사실적 메모리를 형성하는 데 어려움이 있었습니다. 본 논문은 쿼리 독립적인 증거 기록과 작업 응답을 하나의 공유된 능동적 생성 프로세스로 통합한 OneStreamer를 제안합니다. PHCM(Proactive Hierarchical Caption Memory)을 통해 시간 기반의 상세 캡션과 요약을 생성하여 과거 비디오 특징을 다시 읽지 않고도 재사용 가능한 문맥을 제공합니다. 또한 PSTL(Proactive State Transition Learning)을 도입하여 대기 상태의 지배력을 줄이고 상태 변화를 효과적으로 학습합니다. 실험 결과, OneStreamer-1M 데이터셋으로 학습된 4B 모델은 8개 벤치마크에서 최고 성능을 달성하며 실시간 인지와 메모리 유지 사이의 균형을 입증했습니다.

AI 연구

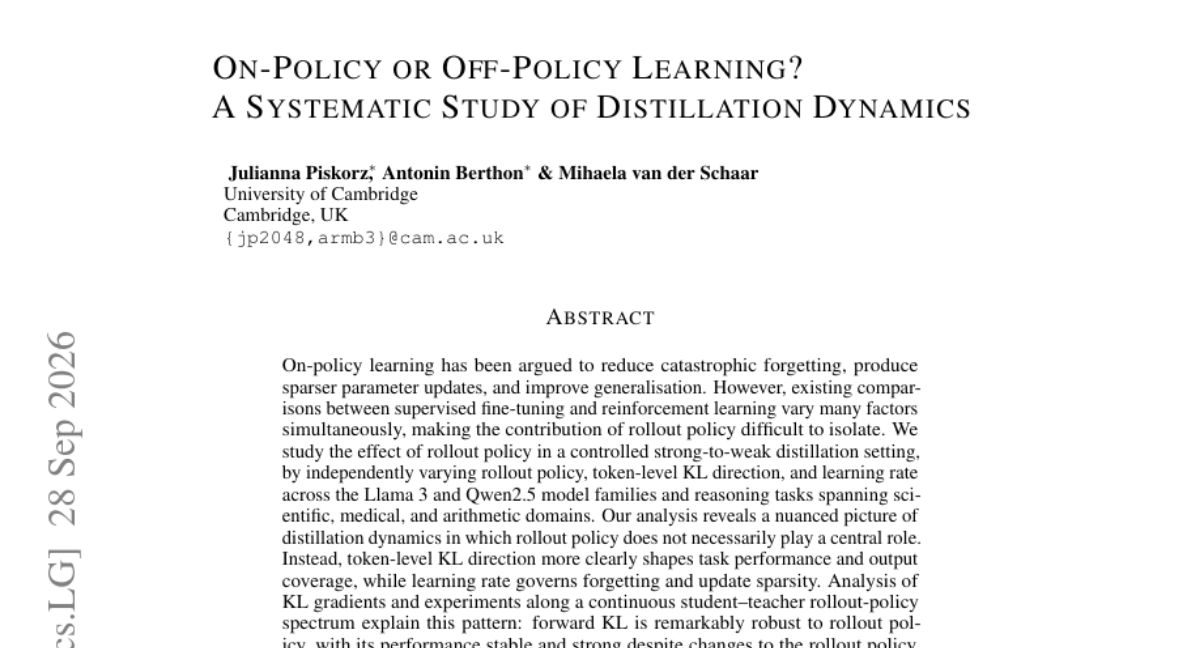
On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics

기존에는 On-policy 학습이 파라미터 업데이트의 희소성을 높이고 일반화 성능을 개선한다고 알려져 왔으나, 기존 연구들은 여러 변수가 혼재되어 있어 Rollout policy의 순수 효과를 분리하기 어려웠습니다. 본 연구는 강력한 교사 모델에서 약한 학생 모델로의 증류(Distillation) 환경에서 Rollout policy, KL 방향, 학습률을 독립적으로 변화시키며 그 영향을 분석했습니다. 실험 결과, Rollout policy 자체보다는 토큰 수준의 KL 방향이 성능과 출력 범위를 결정하며, 학습률이 망각과 업데이트 희소성을 조절하는 핵심 요소임을 발견했습니다. 특히 Forward KL는 Rollout policy 변화에 강건한 반면, Reverse KL은 학생 모델의 생성 데이터(On-policy)에 더 민감하게 반응했습니다. 결론적으로 On-policy 학습의 이점은 목적 함수와 하이퍼파라미터 설정에 따라 달라질 수 있음을 보여줍니다.

AI 연구

Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL

멀티 보상 기반 강화학습은 오디오-비디오 생성 모델의 품질, 정렬, 동기화를 개선하는 유망한 방법이지만, 학습 중 변화하는 보상 위치와 가중치 조절이 어렵다는 문제가 있습니다. 기존 방식은 고정된 라우팅과 가중치를 사용하여 진화하는 모델 함수를 추적하지 못합니다. 이를 해결하기 위해 본 논문은 'Adaptive Reward Routing'을 제안하여 업데이트 위치와 보상 조합을 동시에 적응시킵니다. 구체적으로 교차 주의 집중(Cross-attention) 응답을 활용해 업데이트 위치를 동적으로 조정하고, 사전 정의된 가중치를 유지하면서 잔차 보정 방식으로 보상 간 충돌을 해결합니다. 실험 결과, 기존 RL 베이스라인 대비 모달리티 품질, 의미적 일관성, 오디오-비디오 동기화 성능이 모두 향상되었습니다.

AI 연구

GraphForge: Training Working Agents with Graph-Anchored Workspace Synthesis

에이전트 학습을 위해서는 실제 파일과 검증 가능한 결과가 포함된 작업 데이터가 필요하지만, 기존 방식은 현실성이 부족하거나 검증이 어렵다는 문제가 있었습니다. 이를 해결하기 위해 GraphForge는 직업 기반 시드에서 시작하여 실제 파일들로 구성된 워크스페이스와 그 관계를 나타내는 증거 그래프를 구축합니다. 이 그래프를 바탕으로 작업 요구사항과 검증 루브릭을 파일에 직접 연결(anchoring)하여 데이터의 정합성을 확보합니다. 생성된 작업은 초기 실행 테스트와 수정 에이전트를 거쳐 정교하게 다듬어진 후 학습 데이터로 사용됩니다. 실험 결과, GraphForge로 학습된 모델은 OpenHands 및 Claude Code 환경의 주요 벤치마크에서 성능 향상을 입증했습니다.

AI 연구

Beyond Memory: Harnessing Long-Horizon Agents with Explicit Belief States

LLM 에이전트가 복잡한 과업을 수행함에 있어, 단순한 대화 이력 관리는 현재 세계 상태에 대한 일관된 이해를 보장하지 못하는 문제가 있습니다. 이를 해결하기 위해 본 논문은 추론 단계에서 명시적 신념 상태를 구축하고 유지하는 PoS 프레임워크를 도입합니다. PoS는 현재 세계 상태에 대한 추정치와 미해결 과업 요구사항을 결합하여 에이전트의 의사결정 컨텍스트를 형성합니다. 또한, 에이전트가 의미 없는 행동을 반복하는 '신념 함정(Belief Trapping)'을 감지하고, 일관성 검증 및 맞춤형 복구 메커니즘을 통해 신념의 신뢰성을 유지합니다. 실험 결과, PoS는 다양한 벤치마크에서 기존 방식보다 우수한 성능을 보였으며 컨텍스트 크기 증가에도 강한 회복력을 증명했습니다.

나머지 45건 펼쳐보기

AI 연구

Hierarchical Continuous Diffusion Language Models

기존의 이산적 확산 언어 모델은 병렬 디코딩 시 토큰 간 통계적 의존성이 끊어지는 구조적 병목 현상을 가집니다. 반면 연속적 확산 모델은 토큰 구성과의 연결성이 부족하여 유효한 텍스트 생성이 어렵다는 문제가 있습니다. 이를 해결하기 위해 본 논문은 이산적 토큰 생성과 연속적 잠재 궤적을 단일 노이징 과정에 결합한 HC-DLM을 제안합니다. 제안된 모델은 잠재 상태를 유일한 생성 상태로 유지하며, 토큰을 잠재 상태에서 읽어내고 이를 다시 다음 업데이트의 스캐폴드로 피드백하는 방식을 취합니다. 실험 결과, Sudoku, Countdown, LM1B 데이터셋에서 기존 이산/연속 확산 베이스라인 대비 성능 향상을 입증했습니다.

AI 연구

Sharpening Tax in Post-Training

최근 LLM의 RL 포스트 트레이닝이 기존 능력을 정교화할 뿐, 해결 가능한 문제의 범위를 좁힌다는 가설이 제기되었습니다. 연구진은 에이전트 작업에서 포스트 트레이닝된 모델이 단일 정답률(pass@1)은 높지만, 다양한 해결책을 찾는 능력(pass@K)은 오히려 저하됨을 발견했습니다. 이를 측정하기 위해 테스트 시간 확장성 손실을 정량화하는 'Sharpening Tax' 지표를 제안했습니다. 또한, 프롬프트 난이도에 따라 온도를 조절하는 Bayesian 샘플러인 PTGS를 도입했습니다. 실험 결과, PTGS는 기존 고정 온도 방식보다 낮은 세금을 지불하며 더 넓은 문제 해결 범위를 확보했습니다.

AI 연구

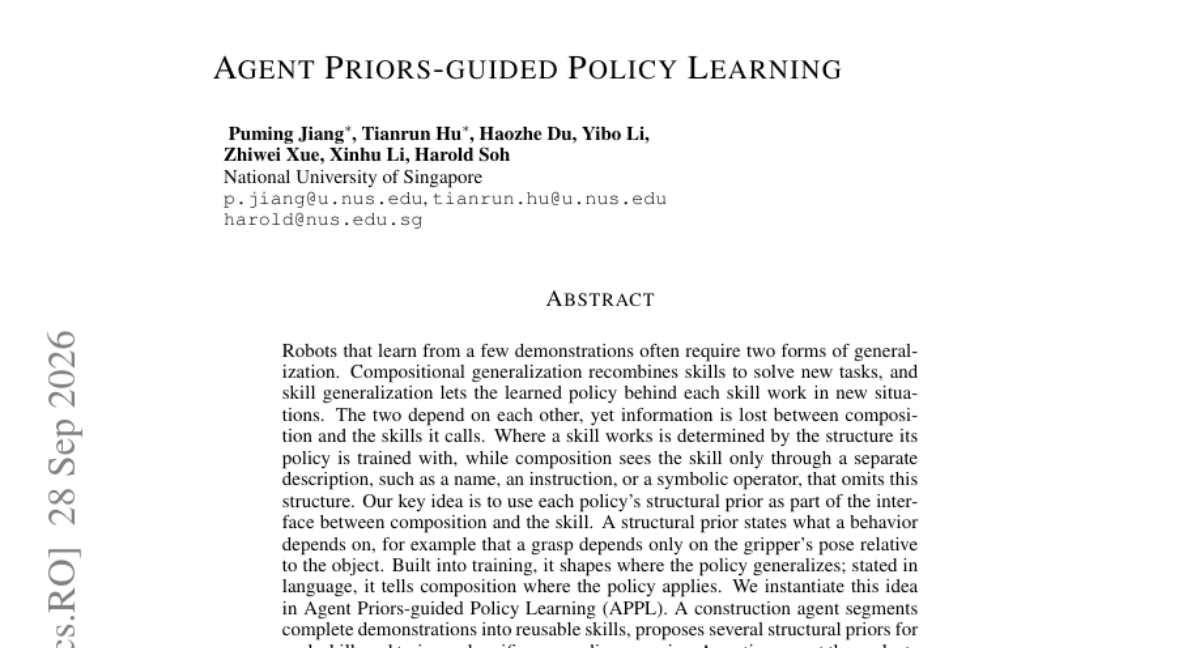
Agent Priors-guided Policy Learning

로봇이 소수의 데모로부터 학습할 때, 스킬의 조합(Compositional)과 스킬 자체의 일반화(Skill generalization)가 서로 의존적임에도 불구하고 정보 손실이 발생하는 문제가 있습니다. 기존 방식은 스킬을 단순한 이름이나 기호로만 취급하여 스킬의 구조적 특성을 조합 과정에 반영하지 못합니다. 본 논문은 각 정책의 구조적 사전 지식(Structural Prior)을 스킬과 조합 인터페이스 사이의 가교로 사용하는 APPL 방식을 제안합니다. 학습 시에는 스킬이 무엇에 의존하는지 정의하고, 실행 시에는 이 사전 지식을 바탕으로 적절한 정책을 선택하고 조합합니다. 실험 결과, MetaWorld 및 ManiSkill 환경에서 OOD(Out-of-distribution) 일반화와 미학습 스킬 조합 성능이 크게 향상되었습니다.

AI 연구

World Observer: Joint Actor-Observer Generation for Persistent World Modeling

기존의 비디오 월드 모델은 에이전트 중심의 시야에 국한되어, 객체가 시야를 벗어나면 그 상태와 역학을 유지하지 못하는 문제가 있었습니다. 이를 해결하기 위해 에이전트의 시점과 별개로 특정 영역을 관찰하는 '옵저버(Observer)'를 결합한 World Observer를 제안합니다. 이 방식은 에이전트와 옵저버를 공유된 파노라마 소스에서 워핑(Warping)하여 기하학적 대응을 확보하고, 고해상도 참조를 위한 Observer Sink를 도입합니다. 이를 통해 시야 밖의 객체도 지속적으로 진화하며, 재진입 시 업데이트된 상태를 유지할 수 있습니다. 실험 결과, 제안 모델은 시야 밖 역학(out-of-view dynamics)을 크게 개선하면서도 시각적 충실도와 3D 정렬 성능을 유지함을 입증했습니다.

AI 연구

A Missing Piece for Trustworthy AI Reviewers: From Benchmarking Rhetorical Robustness to SciCore Review

AI 리뷰어가 동일한 과학적 내용을 다른 문체로 작성했을 때 서로 다른 점수를 부여하여 수사적 최적화가 과학적 개선보다 우선시되는 문제가 발생할 수 있습니다. 이를 해결하기 위해 문장 재작성 시의 안정성과 논문 간 변별력을 동시에 고려하는 '수사적 강건성(Rhetorical Robustness)' 개념을 정의했습니다. 연구진은 1,260개의 원고 버전을 포함한 RobustReview 벤치마크를 구축하여 30가지 리뷰어 설정을 평가했습니다. 실험 결과, 기존의 프롬프트 엔지니어링만으로는 수사적 강건성을 확보하기 어려움을 확인했습니다. 이에 따라 전체 원고 평가와 구조화된 핵심 과학 내용(SciCore) 평가를 결합한 이중 분기 리뷰 모델을 제안했습니다. 최종적으로 SciCore는 인간의 평가와 정렬을 유지하면서도 수사적 변화에 흔들리지 않는 우수한 성능을 입증했습니다.

AI 연구

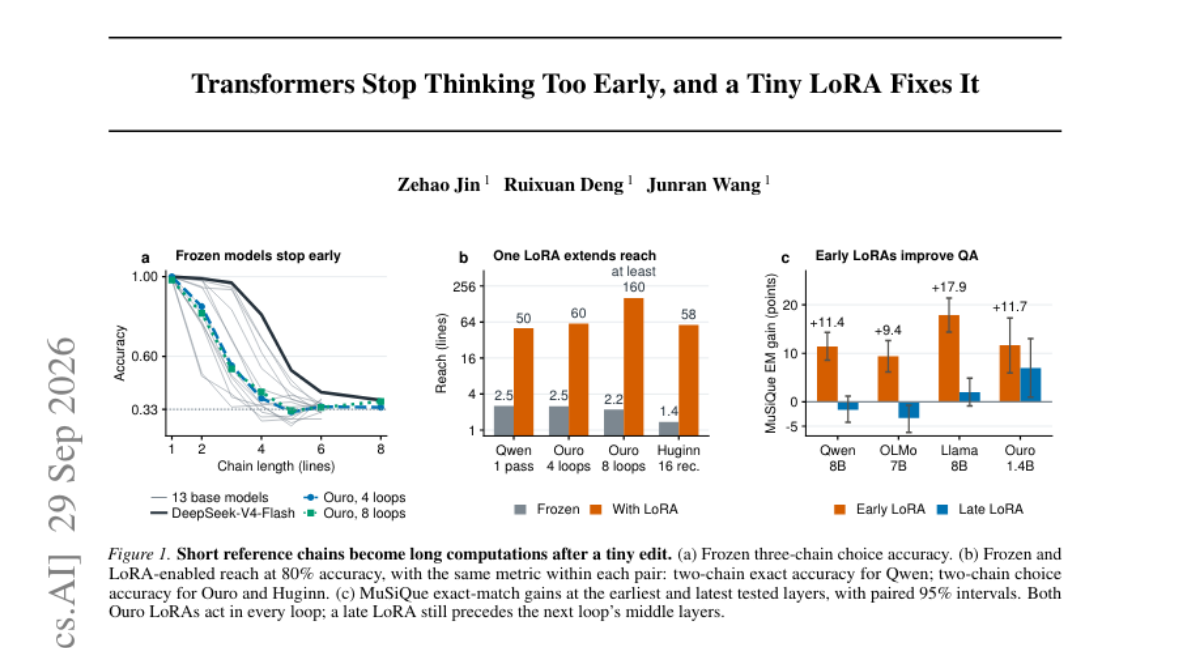
Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It

사전 학습된 트랜스포머 모델들은 모델의 깊이에 비해 문맥 내 참조를 따라가는 추론 능력을 충분히 활용하지 못하는 경향이 있습니다. 연구진은 모델의 가중치를 동결한 채 특정 초기 레이어에 아주 작은 rank-8 LoRA를 추가하는 방식을 제안했습니다. 실험 결과, Qwen3-8B 모델은 24라인의 복잡한 추론 작업에서 정확도가 15.5%에서 99%로 비약적으로 상승했습니다. 이 LoRA는 레이어 간 정보를 전달하는 '릴레이' 역할을 수행하며 모델이 더 긴 문맥을 처리할 수 있게 합니다. 결과적으로 아주 작은 파라미터 수정만으로도 모델의 기본 성능을 크게 개선할 수 있음을 입증했습니다.

AI 연구

ROWBench: Do Video Models Render What the Program Specifies?

차세대 게임 엔진의 기반이 될 프로그래밍 가능한 월드 모델은 실행 가능한 역학(dynamics)과 시각적 생성을 분리하는 데 강점이 있습니다. 그러나 기존 벤치마크는 미세한 프로그램 규칙과 상호작용에 대한 시각적 충실도를 평가하는 데 한계가 있었습니다. 본 논문은 170개의 에피소드와 6항의 프록시 비디오를 포함하는 PROWBench를 제안합니다. 이 프레임워크는 프로그램 실행 기록(entity states, timestamped events)을 기반으로 생성된 비디오가 엔진의 기록과 일치하는지 검증할 수 있는 구조를 갖추고 있습니다. 이를 통해 엔티티 제어, 장기 기억, 그리고 논리적 렌더링 정렬(Logic-Render Alignment) 등을 종합적으로 평가합니다.

AI 연구

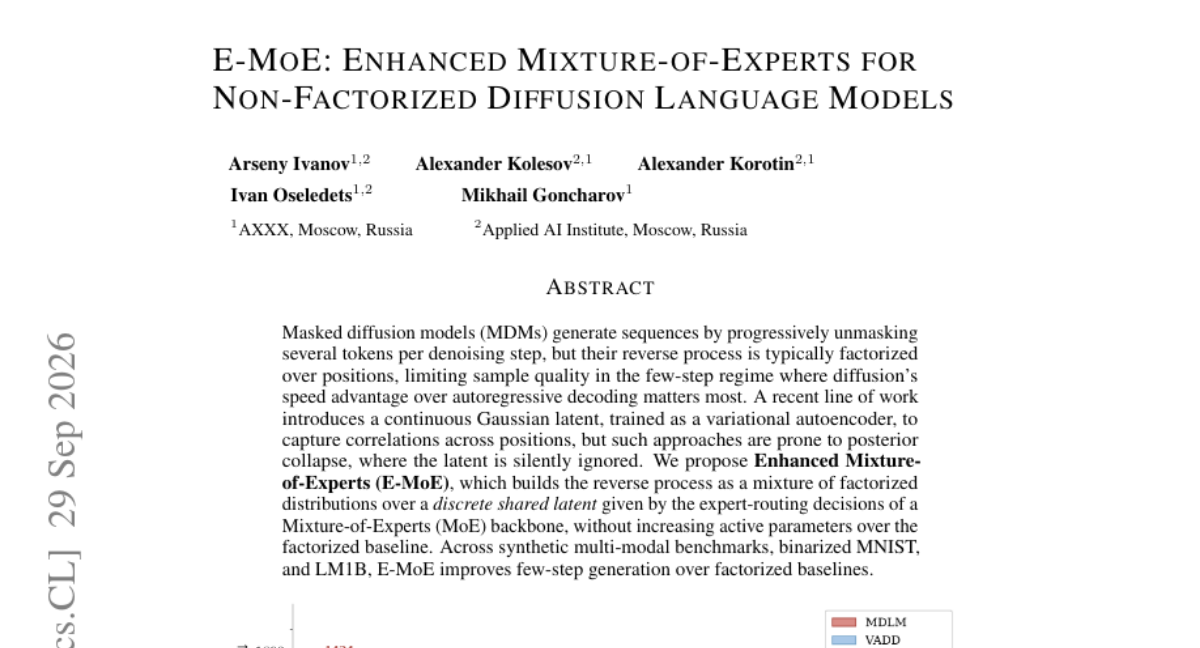
E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models

기존의 Masked Diffusion Models(MDMs)는 역과정에서 위치별로 분리된(factorized) 방식을 사용하여 적은 단계의 생성 시 품질이 저하되는 문제가 있었습니다. 이를 해결하기 위해 연속적인 가우시안 잠재 변수를 사용하는 방식이 제안되었으나, 이는 잠재 변수가 무시되는 후험 붕괴(posterior collapse) 현상에 취약했습니다. 본 논문은 MoE 백본의 전문가 라우팅 결정을 통해 이산적 공유 잠재 변수를 생성하는 E-MoE 방식을 제안합니다. 이 방식은 활성 파라미터 수를 늘리지 않으면서도 위치 간 상관관계를 포착할 수 있는 혼합 분포를 구축합니다. 실험 결과, MNIST 및 LM1B 등 다양한 벤치마크에서 기존 분리형 모델 대비 적은 단계에서의 생성 성능을 크게 개선했습니다.

AI 연구

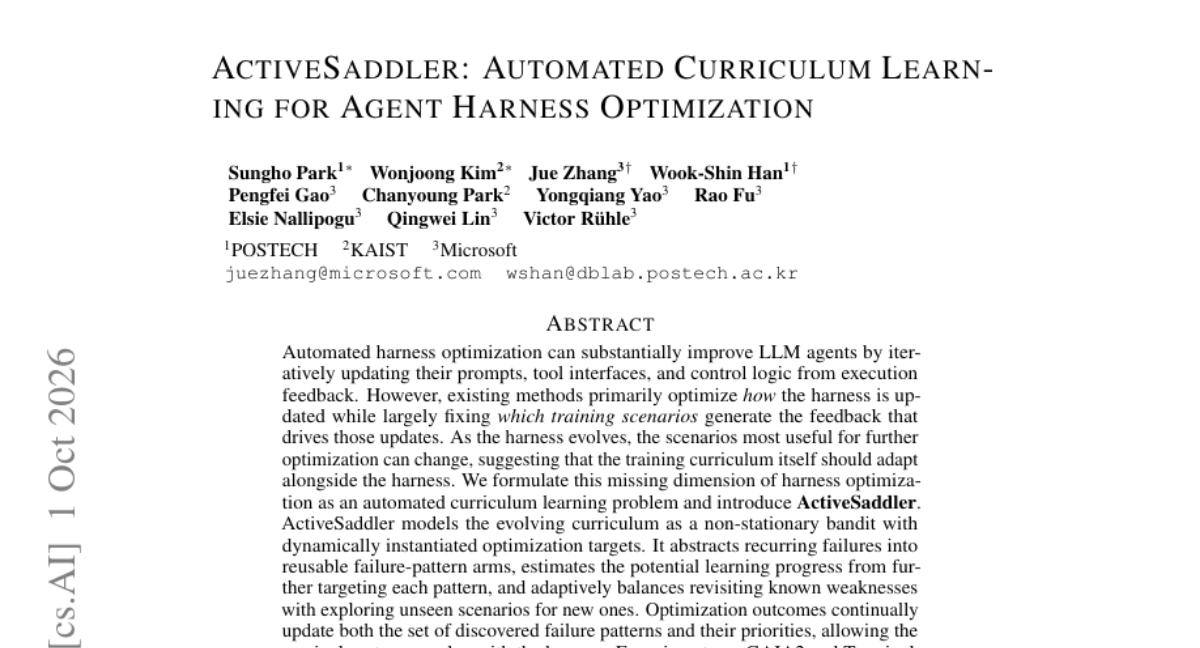
ActiveSaddler: Automated Curriculum Learning for Agent Harness Optimization

LLM 에이전트의 성능을 높이기 위해 프롬프트와 제어 로직을 업데이트하는 하네스 최적화 연구가 활발히 진행되고 있습니다. 그러나 기존 방식은 고정된 시나리오를 사용하여 에이전트가 진화함에 따라 변화하는 학습 요구사항을 반영하지 못하는 한계가 있습니다. 본 논문은 하네스 최적화 과정에서 학습 시나리오를 동적으로 구성하는 커리큘럼 학습 문제를 제안하며, 이를 위해 ActiveSaddler를 도입합니다. ActiveSaddler는 실패 패턴을 재사용 가능한 옵션으로 추상화하고, 각 패턴의 학습 잠재력을 추정하여 탐색과 활용 사이의 균형을 맞춥니다. 실험 결과, GAIA2 및 Terminal-Bench 2.0에서 고정된 시나리오 방식보다 Pass@1 성능을 유의미하게 향상시켰습니다.

AI 연구

Make Sparse Rewards Count: Density-Aware Reward Aggregation for Multi-Reward RL

LLM이 여러 행동 목표를 동시에 달형하도록 하는 다중 보상 강화학습(Multi-reward RL)에서는 각 보상 간의 학습 진척도 차이가 발생하는 문제가 있습니다. 연구진은 보상의 'Advantage Energy'가 활성 그룹 밀도(Active-group density)에 비례한다는 점을 발견하여, 보상 간 불균형이 발생하는 원인을 규명했습니다. 이를 해결하기 위해 보상 기여도를 교정하는 Density-Aware Reward Aggregation(DARA) 기법을 제안합니다. DARA는 배치 단위로 밀도를 계산하여 빈도가 낮은 보상에 더 높은 가중치를 부여하는 역 제곱근 보정 방식을 사용합니다. 실험 결과, DARA는 기존 GDPO 대비 도구 호출 및 수학적 추론 작업에서 훨씬 적은 학습 단계만으로도 목표 성능에 도달하는 효율성을 보였습니다.

AI 연구

AutoGUIWorld: Image Generators as Visual World Models for GUI Agent

GUI 에이전트 학습을 위해서는 다양한 환경에서의 상호작용 데이터가 필요하지만, 실제 소프트웨어를 설치하고 실행하는 데는 비용과 복잡성이 따릅니다. 이를 해결하기 위해 본 논문은 이미지 생성 모델의 시각적 사전 지식과 플래너의 작업 지식을 결합한 AutoGUIWorld 프레임워크를 제안합니다. 이 프레임워크는 OS 환경과 인터페이스 상태를 반영한 장면을 샘플링한 후, 플래너가 액션과 그에 따른 시각적 변화를 정의하면 이미지 생성기가 반복적으로 스크린샷을 편집하며 궤적을 생성합니다. 생성된 데이터를 통해 학습한 결과, OSWorld 및 ScienceBoard와 같은 실제 데스크톱 및 과학 작업 벤치마크에서 성능이 크게 향상되었습니다. 결과적으로 실제 환경 배포 없이도 풍부한 GUI 학습 데이터를 확보할 수 있음을 입증했습니다.

AI 연구

Retrieval-Augmented Skill Optimization via Cross-Harness Adaptation

에이전트 스킬은 특정 환경에서 작업을 수행하기 위한 재사용 가능한 자연어 지침입니다. 기존의 스킬 최적화 방식은 이미 축적된 방대한 스킬 데이터 대신 비용이 많이 드는 에이전트 롤아웃(rollout)에만 의존하는 한계가 있었습니다. 이를 해결하기 위해 외부 스킬 코퍼스를 사전 지식으로 활용하는 RASO 프레임워크를 제안합니다. RASO는 Cross-Harness Adaptation을 통해 도메인과 환경이 다른 기존 스킬을 타겟 작업에 맞게 적응시킵니다. 초기 스킬 생성(RASI)과 피드백 기반 업데이트(RASU)의 두 단계로 구성되어 효율적인 최적화를 수행합니다. 실험 결과, RASO는 다양한 벤치마크에서 기존 방식보다 우수한 성능을 입증했습니다.

AI 연구

Video Generation Models: A Survey of Post-Training and Alignment

비디오 생성 기술이 고해상도 및 장기 시퀀스 생성으로 발전했으나, 사전 학습된 모델은 여전히 인간의 의도 준수, 시간적 일관성 유지, 물리적 제약 충족 등에서 어려움을 겪습니다. 특히 비디오는 이미지와 달리 시간적 오류 누적과 움직임-외형 결합 문제로 인해 정렬 작업이 더욱 까다롭습니다. 본 논문은 이러한 문제를 해결하기 위한 포스트 트레이닝을 통합 프레임워크로 정의하고, 신호 부여 방식에 따라 암시적/명시적 정렬로 구분합니다. 기존 방법론을 지도 미세 조정, 자기 학습 및 증류, 선호도/보상 기반, 추론 시간 방법론의 네 가지 범주로 체계화했습니다. 이를 통해 제어 가능하고 신뢰할 수 있는 비디오 생성 모델 개발을 위한 개념적 토대와 실무적 가이드를 제공합니다.

AI 연구

EgoTools: Towards Tool-Centric Reasoning in Real-World Egocentric Videos

현실 세계의 로봇 및 에이전트 작업은 도구 사용을 통한 물리적 상호작용이 핵심적이지만, 기존 멀티모달 모델은 도구 중심의 추론 능력이 부족합니다. 이는 실생활 1인칭 데이터와 정밀한 진단 용 벤치마크의 부재로 인해 발생해 왔습니다. 본 논문은 이를 해결하기 위해 100시간 분량의 정교한 1인칭 데이터셋인 EgoTools-Data와 4가지 추론 트랙을 포함한 벤치마크인 EgoTools-Bench를 제안합니다. 실험 결과, 최신 모델들도 시각적 근거에 기반한 도구 사용 능력은 여전히 부족함을 확인했습니다. 또한, 제안된 데이터셋을 활용한 미세 조정(SFT)이 모델의 도구 이해 성능을 유의미하게 향상시킴을 입증했습니다.

AI 연구

InterEvolve: Test-Time Evolution of Reward Programs for Humanoid Loco-Manipulation

기존의 휴머노이드 제어 방식은 학습되지 않은 새로운 작업에 직면했을 때 재학습 없이는 대응하기 어렵다는 문제가 있습니다. 본 논문은 기존 컨트롤러가 가진 잠재적 역량을 활용하여 새로운 작업을 수행하는 '테스트 타임 진화(Test-time evolution)'를 제안합니다. 이를 위해 객체 인지 기반의 Forward-Backward(FB) 행동 파운데이션 모델과, LLM이 구조를 수정하고 수치 최적화가 상수를 조정하는 '보상 프로그램(Reward Program)' 인터페이스를 개발했습니다. 실험 결과, 제안된 방식은 사람이 설계한 보상보다 더 효율적으로 컨트롤러의 역량을 끌어내며 복잡한 작업과 장기적 과제를 성공적으로 수행했습니다. 최종적으로 시뮬레이션에서 진화된 기술은 실제 Unitree G1 로봇에서 자율적으로 구동됨을 입증했습니다.

AI 연구

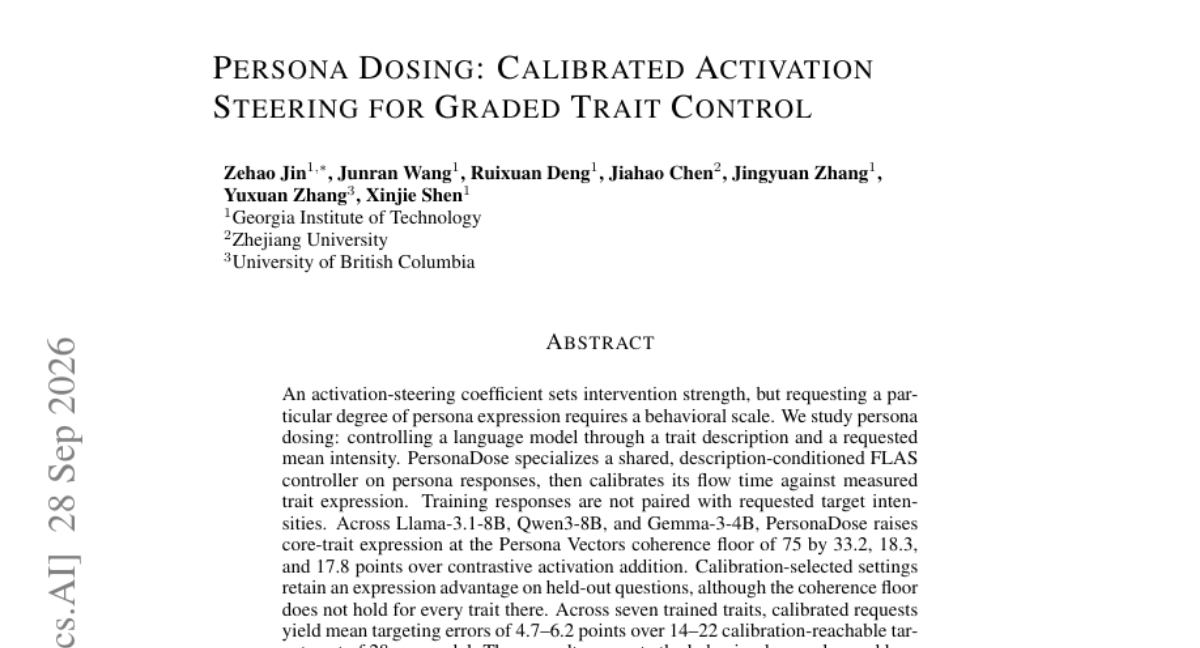
Persona Dosing: Calibrated Activation Steering for Graded Trait Control

기존의 활성화 스티어링 방식은 개입 강도를 설정할 수 있지만, 특정 수준의 페르소나 표현을 요청하기 위한 행동 척도가 부족한 문제가 있었습니다. 본 논문은 트레이트 설명과 요청된 평균 강도를 통해 언어 모델을 제어하는 'PersonaDose'를 제안합니다. PersonaDose는 공유된 FLAS 컨트롤러를 페르소나 응답에 특화시킨 후, 측정된 트레이트 표현량에 맞춰 소식 시간(flow time)을 캘리브레이션합니다. 실험 결과, Llama-3.1, Qwen, Gemma 모델 모두에서 기존 대조적 활성화 방식보다 높은 핵심 트레이트 표현력을 달성했습니다. 또한, 캘리브레이션된 설정은 학습되지 않은 질문에서도 우수한 표현력을 유지하며 요청된 타겟 강도에 근접하는 결과를 보였습니다.

AI 연구

Decentralized Master-Mind: Joint Action Refinement through Iterative Intent Denoising in Multi-Agent Pathfinding

분산형 멀티 에이전트 경로 탐색(MAPF)은 부분 관측 환경에서 충돌 없이 개별 목표에 도달하는 것이 핵심입니다. 기존의 학습된 정책은 개별 에이전트의 행동 분포를 독립적으로 샘플링할 때, 유효한 개별 행동들이 결합되어 부적절한 공동 행동을 생성하는 문제가 발생합니다. 이를 해결하기 위해 DMM(Decentralized Master-Mind)은 확산 모델(Diffusion Model)의 데노이징 개념을 차용하여, 통신 라운드 동안 행동 의도를 반복적으로 정제하는 방식을 제안합니다. 에이전트들은 초기 무작위 의도를 설정한 후, 로컬 통신을 통해 서로의 선택을 결합하며 점진적으로 최적의 공동 행동을 도출합니다. 실험 결과, DMM은 높은 성공률과 낮은 비용을 달성하며 백만 개 이상의 에이전트 규모에서도 확장성을 보여주었습니다.

AI 연구

Scaling and Distilling Text Embeddings for Better Diffusibility

최근 연속적 확산 언어 모델(DLM)이 주목받고 있으나, 어떤 임베딩이 생성에 가장 적합한지에 대한 연구가 필요했습니다. 기존의 강력한 임베딩 모델은 변별력이 너무 높아 유사한 단어 간 거리가 멀어지며, 이는 샘플링 과정에서 생성 실패를 유발하는 문제가 있었습니다. 이를 해결하기 위해 교사 모델의 확률 분포를 소프트 라벨로 사용하는 학생 모델 증류 방식을 제안합니다. 이 과정을 통해 임베딩 공간을 더 연결성 있고 확산 가능한 형태로 재구성했습니다. 결과적으로 제안된 방식은 기존 GPT-2-M보다 우수한 생성 성능을 달성했습니다.

AI 연구

Fewer Tokens, Better Action: GPT-6 Astra Robot Agents with 14% Higher Success Rate but 65% Fewer Tokens

VLM 기반 로봇 에이전트는 시각적 피드백을 통한 반복적인 모델 호출로 인해 막대한 토큰 비용이 발생하는 문제가 있습니다. 이를 해결하기 위해 피드백 기반의 프리미티브 구성과 선택적 관찰을 결합한 PyRUA-Lean 프레임워크를 제안합니다. 에이전트는 로봇 동작과 VLA 정책을 Python 코드로 결합하여 로컬에서 조건부 체크 및 재시도를 수행하며, 필요한 경우에만 상태 피드백을 반환합니다. 700개의 시뮬레이션 환경 테스트 결과, 동일한 LLM 호출 예산 하에서 성공률을 63.1%에서 71.7%로 높였습니다. 또한 동일 작업 해결 시 LLM 호출 횟수는 49%, 입력 토큰은 65% 절감하는 성과를 거두었습니다.

AI 연구

Beyond the Current Scene: Event-Referential Grasping with Active View Selection

사람의 상호작용을 관찰한 로봇이 과거 이벤트의 역할을 기반으로 물체를 식별하고 잡아야 하는 상황을 가정합니다. 기존 방식은 물체의 이름이나 외형에 의존하거나, 물체가 가려졌을 때 식별하기 어렵다는 문제가 있습니다. 본 논문은 이벤트 맥락과 현재 장면을 결합하여 대상을 식별하고, 가려진 경우 최적의 시점을 선택하는 BeyondSCe 시스템을 제안합니다. 이 시스템은 사전 학습된 모델만을 사용하여 추가 학습 없이 동작하며, 이벤트 기록에서 복구된 사전 정보와 현재 기하 구조를 결합해 타겟을 노출할 수 있는 카메라 시점을 결정합니다. 실험 결과, 가려진 타겟에 대해서도 기존 베이스라인보다 높은 성공률을 기록하며 효율적인 능동 인식을 입증했습니다.

AI 연구

X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization

기존의 멀티스텝 에이전트 학습은 평면적인 액션 스트림을 사용하여 반복되는 하위 절차나 계층적 구조를 충분히 활용하지 못하는 문제가 있습니다. 최근에는 컨텍스트 내 스킬 활용 방식이 제안되었으나, 이는 가중치에 반영되지 않아 일반화에 한계가 있습니다. 본 논문은 데이터 자체에서 계층 구조를 복구하는 X-Tree를 제안하며, 재사용 가능한 액션 스팬을 점수화하여 트리 구조로 병합합니다. 이를 오프라인 RL, 온라인 RLVR, 온폴리시 자기 증류(Self-distillation) 세 가지 설정에 통합하여 학습합니다. 실험 결과, WebArena 등 주요 벤치마크에서 기존 방식 대비 유의미한 성공률 향상을 달성했습니다.

AI 연구

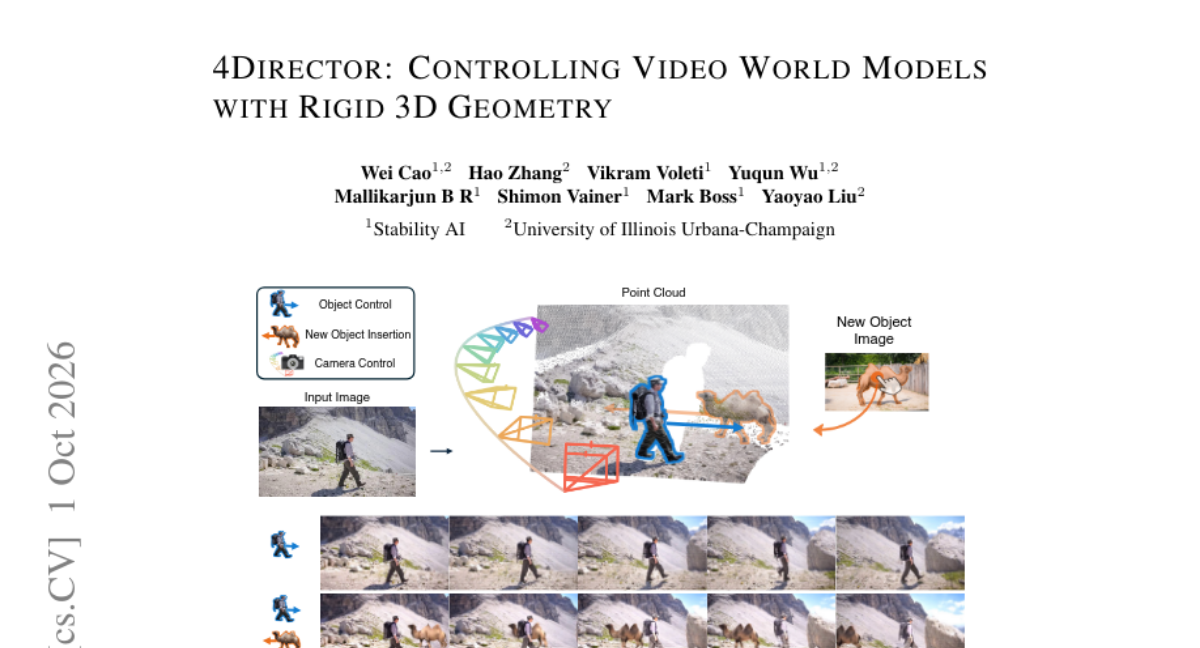
4Director: Controlling Video World Models with Rigid 3D Geometry

전문적인 비디오 제작을 위해서는 카메라와 객체 움직임에 대한 정밀한 제어가 필수적입니다. 기존 방식은 이미지 평면의 단편적인 정보나 불완전한 3D 트랙을 사용하여 깊이와 회전 제어가 모호하고 일관성이 떨어지는 문제가 있었습니다. 본 논문은 각 객체를 정형화된 메쉬(canonical mesh)로 재구성하고 프레임별 강체 변환을 적용하는 명시적 4D 장면 표현 방식인 4Director를 제안합니다. 제어된 장면을 깊이 비디오로 렌더링한 후, Motion Adapter를 통해 일관된 외형과 조명, 비정형 역학을 결합한 비디오를 생성합니다. 이를 위해 20,774개의 정밀한 3D 주석이 포함된 RealCOD-Rigid 데이터셋을 구축하였으며, 새로운 평가 지표인 IG-IoU를 도입했습니다. 실험 결과, 4Director는 기존 방식보다 시각적 품질과 제어 정밀도 면에서 우수한 성능을 보였습니다.

AI 연구

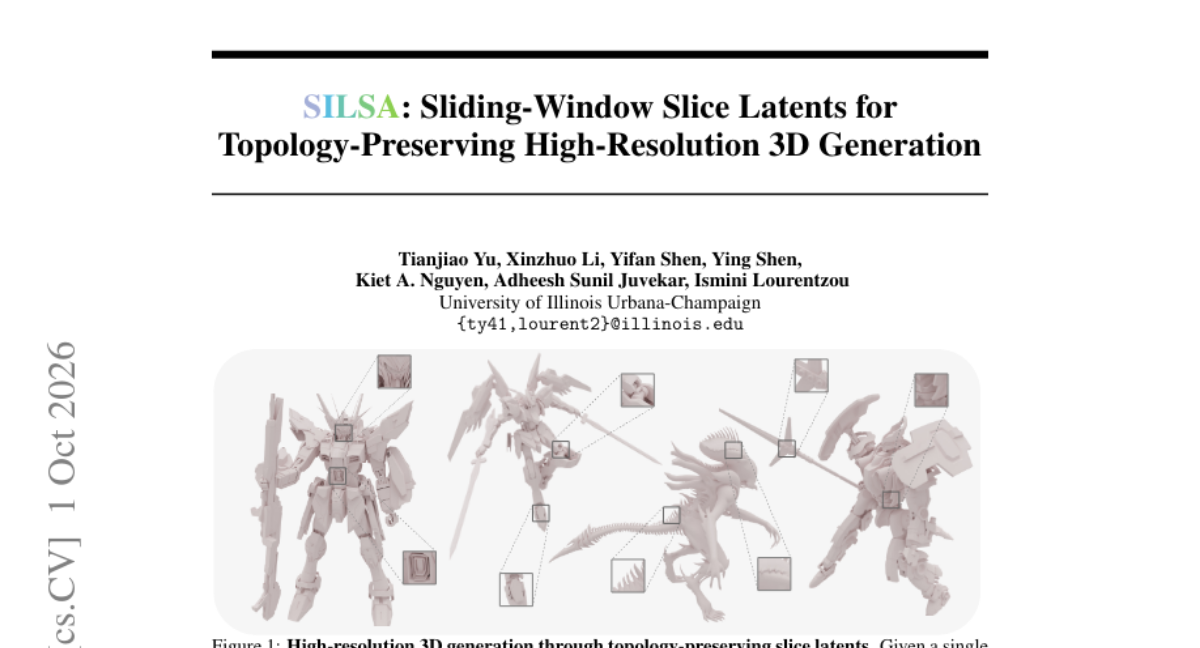
SILSA: Sliding-Window Slice Latents for Topology-Preserving High-Resolution 3D Generation

고해상도 3D 생성을 위해 기존에는 복잡한 복셀 토큰이나 다단계 파이프라인을 사용했으나, 이는 생성 비용을 높이고 얇거나 연결된 구조의 위상적 일관성을 해치는 문제가 있었습니다. 이를 해결하기 위해 SILSA는 세 축을 따라 겹치는 슬라이스들을 사용하는 슬라이딩 s-윈도우 슬라이스 잠재 변수 방식을 제안합니다. Slice VAE를 통해 방향성 표면 샘플을 인코딩하고, Volumetric Anchor Lattice를 통해 방향별 슬라이스 스트림을 조정하며, Betti 전이를 정렬하는 위상 감독(Topology Supervision)을 도입했습니다. 실험 결과, 기존 방식 대비 토큰 수를 대폭 절감하면서도 구조적 충실도와 위상적 정확도를 크게 향상시켰습니다. 결과적으로 학습 메모리 사용량을 40.4% 줄이고 추론 시간을 58.5% 단축하는 성과를 거두었습니다.

AI 연구

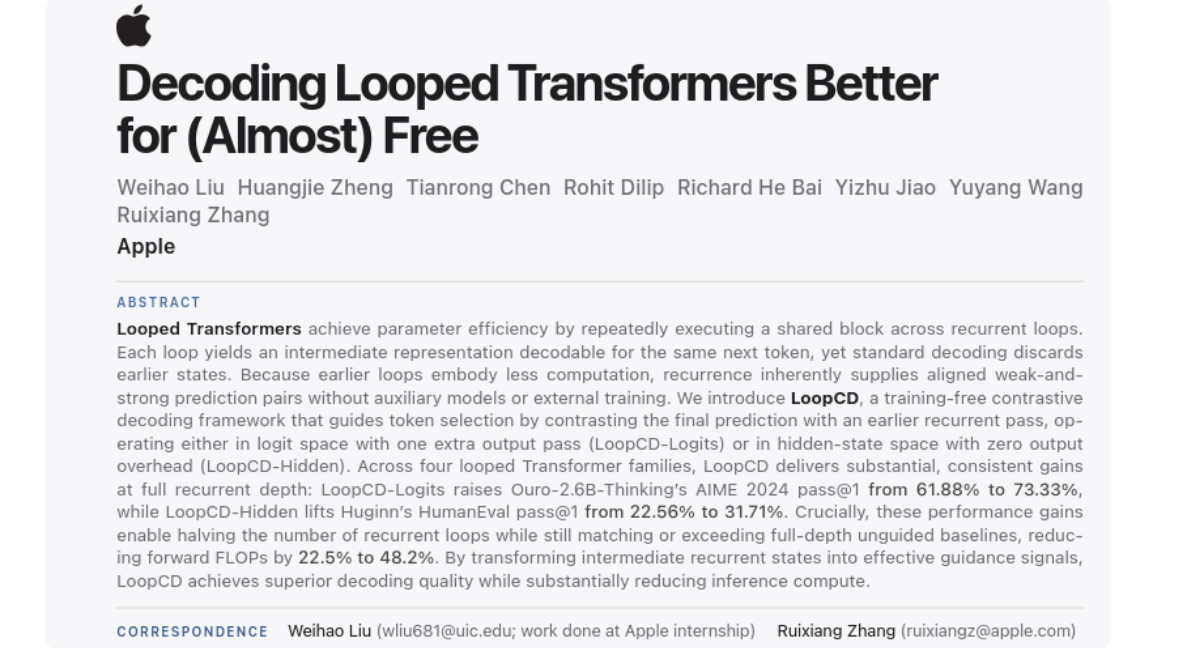
Decoding Looped Transformers Better for (Almost) Free

Looped Transformer는 동일한 블록을 반복 실행하여 파라미터 효율성을 높이지만, 기존 방식은 이전 루프의 중간 상태를 버리고 최종 결과만 사용합니다. 이 과정에서 발생하는 루프 간의 예측 차이는 별도의 학습 없이도 유용한 가이드 신호가 될 수 있습니다. 본 논문은 최종 예측과 이전 루프의 예측을 대조하는 학습 불필요 프레임워크인 LoopCD를 제안합니다. LoopCD는 로짓 공간(Logits) 또는 은닉 상태(Hidden-state) 공간에서 동작하며, 연산 오버헤드를 최소화하면서 성능을 개선합니다. 실험 결과, LoopCD는 성능 향상과 동시에 루프 횟수를 줄여 추론 FLOPs를 대폭 절감하는 효과를 입증했습니다.

AI 연구

Architect-Ant: Editable Automatic Furnishing of Architectural Floor Plans

부동산 시각화 및 인테리어 설계를 위한 자동 가구 배치 기술은 데이터 부족과 복잡한 기하학적/기능적 제약 조건으로 인해 어려움을 겪어왔습니다. 본 논문은 반복적인 에이전트 추론 없이 사전 학습된 모델을 통해 전문적인 배치 지식을 학습하는 방법을 제안합니다. 이를 위해 92개 객체 클래스를 포함한 전문 건축 도면 데이터셋인 AntPlan을 구축하고, 편집 가능한 DSL 기반의 Architect-Ant 프레임워크를 도입했습니다. 모델은 지도 미세 조정(SFT)을 통해 패턴을 학습한 후, GRPO를 사용하여 기하학적 및 기능적 제약이 통합된 Layout Rule Score(LRS)로 최적화됩니다. 실험 결과, 제안 모델은 낮은 기하학적 위반율과 높은 기능적 완결성을 동시에 달성하며 실세계 배치 패턴을 효과적으로 재현했습니다.

AI 연구

AutoDataBench: A Data-centric Testbed for Accelerating Auto Research

기존의 자동화 연구 벤치마크는 프레임워크, 하이퍼파라미터, 컴퓨팅 자원 등이 복합적으로 얽혀 있어 성능 향상의 원인을 특정하기 어렵다는 문제가 있습니다. 본 논문은 데이터 지능(Data Intelligence)을 독립적으로 평가하기 위해 데이터 진단, 조직, 구축을 아우르는 AutoDataBench를 제안합니다. 이 테스트베드는 데이터 외적 요인을 고정시킨 상태에서 LLM이 도구 사용, 검색, 지식 주입을 통해 반복적인 실험으로 데이터를 개선하는 능력을 평가합니다. 연구 결과, LLM이 데이터 개입의 결과를 예측하는 추론 능력을 갖추고 있는지 확인하였으며, 반복적인 피드백이 데이터 효과에 대한 이해를 높임을 입증했습니다. 마지막으로 AutoDataBench의 궤적을 미세 조정에 재사용했을 때 다운스트림 코딩 성능이 향상됨을 보여주었습니다.

AI 연구

Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces

기존의 멀티모달 모델은 이미지를 이산적 토큰으로 양자화하거나, 언어는 이산적이고 이미지는 연속적인 방식으로 처리하여 성능 병목과 복잡한 샘플링 문제를 겪었습니다. 이를 해결하기 위해 본 논문은 언어와 시각 정보를 모두 연속적 표현으로 다루는 'Multimodal Flow'를 제안합니다. 이 모델은 텍al 블록과 이미지를 순서 있는 연속적 하이퍼청크(hyperchunks)로 구성하고, Flow Matching을 통해 단일 벡터 필드를 학습하는 통합 아키텍처를 사용합니다. 실험 결과, 적은 데이터(150B 토큰)로도 기존의 하이브리드 및 이산 모델보다 우수한 성능을 보이며 효율적인 멀티모달 학습 가능성을 입증했습니다.

AI 연구

CorrGRPO: Correlation-Normalized GRPO for Multi-Reward Learning

최근 추론 모델 학습에 사용되는 GRPO는 여러 보상 성분을 합산하여 정규화하는 방식을 사용합니다. 그러나 보상 간 상관관계가 높고 스케일 차이가 클 경우, 특정 보상이 전체 정규화 과정을 지배하여 다른 보상 신호를 억제하는 문제가 발생합니다. 이를 해결하기 위해 공분산을 피어슨 상관계수로 변환하여 정규화하는 CorrGRPO를 제안합니다. 이 방식은 총 보상 값은 유지하면서도 서로 다른 스케일을 가진 보상들이 균형 있게 반영되도록 합니다. 코드 생성, 도구 호출, 에이전트 보안 등 다양한 태스크에서 실험한 결과, 기존 GRPO 대비 성능 향상을 확인했습니다.

AI 연구

Argo-Bench: Evaluating Data Agents on Enterprise-Scale Workflows

기존의 Text-to-SQL 벤치마크는 단일 테이블 중심의 단순 쿼리 생성에 치중되어 있어, 복잡한 기업용 워크플로우를 평가하기에 부족합니다. 본 논문은 235개의 테이블과 75억 개의 행을 포함하는 대규모 ERP 스키마 기반의 Argo-Bench를 소개합니다. 이 프레임워크는 단순 쿼리 생성을 넘어, 시뮬레이션된 경제 환경 내에서 계정 차단이나 예산 할당과 같은 실질적인 액션을 수행하도록 설계되었습니다. 실험 결과, 최신 모델들도 복잡한 데이터 탐색과 실행이 결합된 과제에서 낮은 성능을 보였습니다. 이는 에이전트가 실제 데이터 환경을 이해하고 행동하는 능력을 높이는 데 기여할 것입니다.

AI 연구

Ego2Act: Evaluating Goal-Directed Manipulation in Egocentric Video Generation

비디오 생성 모델이 로봇 학습을 위한 월드 시뮬레이터로 활용되려면 단순한 시각적 품질을 넘어 목표 지향적 행동에 따른 환경 변화를 예측할 수 있어야 합니다. 그러나 기존 벤치마크는 단일 동작이나 단순 단계에 집중하여, 복잡한 다단계 물리적 추론이 필요한 1인칭 시점 환경을 충분히 평가하지 못합니다. 이를 해결하기 위해 110개의 실생활 작업과 2,640개의 영상을 포함한 목표 지향적 벤치마크인 Ego2Act를 도입합니다. 또한, 인간의 판단과 유사하게 작업 완료 여부와 물리적 타당성을 평가하는 참조 없는 평가 파이프라인인 Ego2ActJudge를 함께 제안합니다. 실험 결과, 현재 모델들은 중간 단계를 생략하거나 물리적 역학 관계를 정확히 유지하지 못해 최종 목표 달성에 실패하는 경향을 보였습니다.

AI 연구

RPTune: Learned Context Curation for LLM Catalog Search

소규모 상점(SMB)의 경우 전체 카탈로그를 LLM의 긴 컨텍스트에 넣는 방식이 가능하지만, 모델이 긴 문맥을 균일하게 활용하지 못해 성능 저하가 발생합니다. 본 논문은 카탈로그를 어떻게 구성할 것인지와 구성된 컨텍스트에서 모델을 어떻게 적응시킬 것인지라는 두 가지 문제를 다룹니다. 이를 해결하기 위해 큐레이터가 제품을 정렬 및 선별하고, 선별된 데이터를 바탕으로 LLM을 사후 학습시키는 RPTune 프레임워크를 제안합니다. 실험 결과, RPTune은 다양한 리테일 분야에서 검색 정확도를 크게 향상시켰습니다.

AI 연구

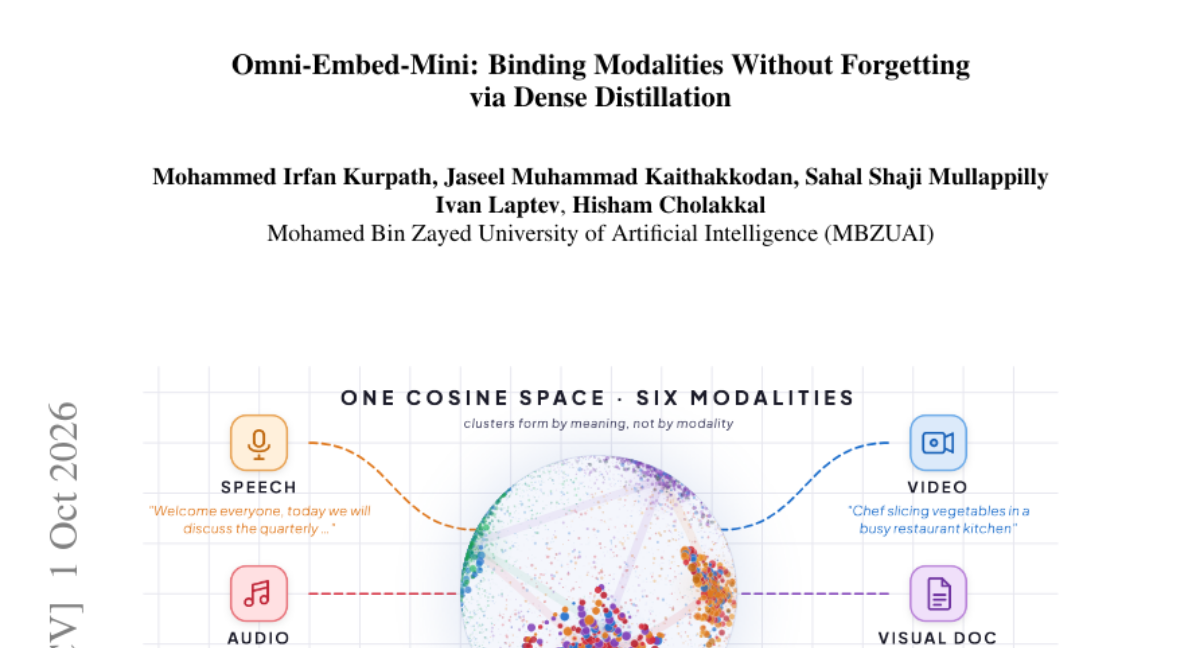
Omni-Embed-Mini: Binding Modalities Without Forgetting via Dense Distillation

기존의 멀티모달 임베딩 모델은 새로운 모달리티를 추가할 때 텍스트 검색 성능이 저하되거나 모델 크기가 지나치게 커지는 문제가 있었습니다. 이를 해결하기 위해 텍스트 백본의 가중치를 고정한 상태에서 다른 모달리티를 정렬하는 Omni-Embed-Mini를 제안합니다. 캡션된 미디어 샘플을 활용해 고정된 텍스트 백본을 교사(Teacher)로 삼는 밀집 증류(Dense Distillation) 방식을 사용합니다. 학습 시에는 Matryoshka SigLIP 손실과 하이브리드 하드 네거티브 마이닝을 결합하여 효율적인 정렬을 수행합니다. 그 결과, 텍스트 성능을 유지하면서도 기존 모델 대비 훨씬 작은 크기로 다양한 모달리티를 통합하는 데 성공했습니다.

AI 연구

PhysVista: Benchmarking Physical Intelligence in VLMs via a Perception-Reasoning-Assessment Loop

최근 VLM의 멀티모달 추론 능력은 향상되었으나, 실제 물리적 역학을 이해하는지는 여전히 불분명합니다. 기존 벤치마크는 개별 인지 단계에만 집중하여 물리적 일관성을 종합적으로 평가하는 데 한계가 있었습니다. 이를 해결하기 위해 인간의 인지 과정을 모방한 'Perception-Reasoning-Assessment' 루프 기반의 PhysVista 벤치마크를 제안합니다. PhysVista는 물리적 상태 인지, 역학 추론, 물리적 타당성 평가를 통합적으로 수행하며, 이벤트 및 스케일 단위의 세밀한 분석을 지원합니다. 실험 결과, 현재의 VLM들은 시각적 인식 능력에 비해 물리적 추론 및 타당성 평가 능력이 현저히 낮음을 확인했습니다.

AI 연구

PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion

기존의 표현 정렬(REPA) 방식은 주로 CLIP과 같은 의미론적 인코더에만 의존하여 공간 구조 정보를 충분히 활용하지 못했습니다. 여러 모델을 동시에 학습할 경우 의미론적 그래디언트와 기하학적 그래디언트가 충돌하여 성능이 저하되는 문제가 발생합니다. 이를 해결하기 위해 PixelDense는 의미론적 스트림(DINOv2, SAM2)과 기하학적 스트림(Depth Anything v2, Metric3D v2)을 분리하고 직교성 페널티를 적용하는 구조를 제안합니다. 결과적으로 PixelGen과 DeCo 등에서 기존 대비 향상된 생성 성능을 보였으며, 특히 구조적 정밀도와 편집 시 레이아웃 유지 능력이 크게 개선되었습니다.

AI 연구

Smaller Models, Better Rejects: Preference Distillation Scaling

기존의 선호도 증류(Preference Distillation)는 학생 모델이 생성한 실패 사례를 거절 샘플로 사용하는 방식에 의존해 왔습니다. 하지만 이는 거절 샘플이 반드시 학생 모델만큼 커야 하거나, 자기 생성 실패가 가장 유용하다는 잘못된 가정을 전제로 합니다. 본 연구는 7B에서 72B 규모의 모델을 대상으로 실험하여, 더 작은 고정 모델(frozen models)이 생성한 거절 샘플이 오히려 더 강력한 학생 모델을 학습시킨다는 것을 발견했습니다. 이를 설명하기 위해 DPO의 유틸리티 경계(utility bound)를 이론적으로 도출하였으며, 거절 샘플의 분포와 태스크 구조의 중요성을 규명했습니다. 결과적으로 태스크 구조를 유지하면서 참조 정책(reference policy)과의 결합을 제한하는 것이 효과적인 거절 샘플의 핵심임을 보여주었습니다.

AI 연구

Where-OPD: Spatially Guided On-Policy Self-Distillation of MLLMs with Synthetic Scenes

최근 MLLM의 성능 향상을 위해 특권 정보(privileged information)를 활용한 온폴리시 자기 증류 방식이 주목받고 있으나, 기존의 이미지 크롭 방식은 특정 작업에 국한되거나 수동 주석이 필요하다는 한계가 있습니다. 본 논문은 텍스트 기반의 공간 가이드를 교사 모델에 제공하여 질문과 관련된 시각적 요소를 식만하게 식별하도록 하는 새로운 자기 증류 방식을 제안합니다. 절차적 생성(procedural generation)을 통해 자동 생성된 합성 장면을 활용함으로써 주석 작업 없이 대규모 사후 학습이 가능하도록 설계했습니다. 교사 모델은 공간 가이드를 통해 여러 영역의 증거를 통합하고, 학생 모델은 이미지와 질문만으로 이 동작을 재현하도록 학습합니다. 실험 결과, 합성 데이터로 학습했음에도 불구하고 실제 세계의 다양한 시각 벤치마크에서 성능 향상이 나타나는 강력한 합성-실제 전이(synthetic-to-real transfer) 능력을 입증했습니다.

AI 연구

Better Supervision Is Nearby: Neighborhood On-Policy Self-Distillation

수학적 추론 모델 학습을 위해 정답을 아는 교사 모델이 학생의 샘플링된 접두사를 지도하는 OPSD 방식이 기존에 사용되었습니다. 그러나 기존 방식은 고정된 파라미터 설정만을 사용하여 주변 파라미터가 제공할 수 있는 추가적인 지도 정보를 놓치는 문제가 있었습니다. 본 논문은 파라미터의 국소적 섭동(perturbation)을 통해 정답 맥락 내에서 서로 보완적인 교정 신호를 얻는 N-OPSD를 제안합니다. 오프라인에서 그리디 선택 방식으로 전문가 풀을 구축하고, 온라인 라우팅을 통해 학생의 상태에 가장 적합한 전문가를 선택하여 학습합니다. 실험 결과, AIME 등 고난도 수학 벤치마크에서 기존 OPSD 대비 유의미한 성능 향상을 달성했습니다.

AI 연구

When Users Change Their Minds: Measuring and Repairing Intent Drift in LLM Agents

LLM 에이전트는 멀티턴 대화 중 사용자의 의도가 변하는 상황에서 과거의 정보가 현재 작업에 영향을 미치는 '의도 드리프트' 문제를 겪습니다. 연구진은 검증 가능한 태스크를 의도 변화가 포함된 대화로 변환하는 벤치마크인 IntentFlux를 도입했습니다. 실험 결과, 대화 내에 폐기된 정보가 많아질수록 모델의 정답률이 유의미하게 하락하는 현상이 관찰되었습니다. 이를 해결하기 위해 생성 전 활성 요구사항을 명시적으로 유지하는 StateForge 방식을 제안했습니다. 실험 결과 StateForge는 모델의 작업 점수를 크게 개선하며, 명시적인 상태 유지 방식이 의도 드리프트 완화에 효과적임을 입증했습니다.

AI 연구

Pretrain Once, Route Anywhere: Towards a Foundation Model for LLM Routing

LLM 라우팅은 쿼리에 가장 적합한 모델을 선택하여 효율성을 높이는 기술이지만, 기존 방식은 특정 워크로드나 모델 풀에 종속되어 환경 변화 시 재학습이 필요하다는 문제가 있다. 본 논문은 라우팅 능력을 범용적인 파운데이션 모델로 구축하여 다양한 환경에 대응하는 것을 목표로 한다. 이를 위해 제안된 RouteFM은 모델의 고정된 정체성 대신 행동 맥락을 통해 익명 후보 모델의 능력을 추론하는 에피소드 사전 학습 방식을 사용한다. 실험 결과, RouteFM은 도메인, 모달리티, 후보 모델 풀이 바뀌는 환경에서도 높은 전이 성능을 보였다. 특히 데이터가 제한적인 상황에서도 기존 베이스라인을 상회하는 성능을 기록하며 범용 라우팅의 가능성을 입증했다.

AI 연구

OpenTumorBoard: A Real-World Benchmark of Multidisciplinary Tumor Board Discussion Trajectories

다학제 암 진료 협진(Tumor Board)은 복잡한 임상 데이터와 환자 이력을 통합하여 전문가들이 논의하는 과정이지만, 이를 평가할 벤치마크는 부족한 실정입니다. 연구진은 YouTube의 공개된 진료 영상을 기반으로 611개 환자 사례와 19,157개의 발화로 구성된 OpenTumorBoard 벤치마크를 구축했습니다. 이 벤치마크는 특정 질문에 답하는 'SPECIALIST TURN'과 전체 토론을 시뮬레이션하여 합의에 도달하는 'BOARD SIMULATION' 두 가지 설정을 평가합니다. 실험 결과, 최신 범용 및 의료 특화 LLM들은 전문가의 답변과 합의 도달 측면에서 성능 한계를 보였습니다. 하지만 SFT와 RL을 통한 미세 조정은 성능 향상을 이끌어내어 실무 데이터가 모델 적응에 유효함을 입증했습니다. 최종적으로 연구진은 멀티 에이전트 기반의 개인 맞춤형 암 치료 의사결정 모델 개발을 위해 이 벤치마크를 공개합니다.

AI 연구

AgSpec: Pushing the Limits of Retrieval-Based Speculative Decoding in Coding Agent Pipelines

기존의 검색 기반 투기적 디코딩(SD)은 코딩 에이전트가 생성하는 코드, 로그, 이전 시도와 같은 재사용 가능한 텍스트를 효과적으로 활용하지 못하는 한계가 있었습니다. 특히 에이전트 파이프라인에서 발생하는 세션 데이터 누락과 가변적인 초안 길이 문제를 해결해야 했습니다. 본 논문은 AgSpec 프레임워크를 제안하며, 세션·워크스페이스·글로벌 코퍼스를 통합 관리하고 에이전트별 최적의 초안 길이를 동적으로 조절하는 정책을 도입했습니다. 실험 결과, AgSpec은 기존 방식 및 EAGLE-3보다 우수한 성능을 보였으며, 배치 사이즈에 따라 오토레그레시브 디코딩 대비 최대 4.76배의 처리량을 달상했습니다. 이는 코딩 에이전트 환경 전반에서 범용적인 성능 향상을 입증합니다.

AI 연구

Benchmarking and Enhancing Skill-Level Memory for Partially Observable Robotic Manipulation

최근 로봇 학습은 다양한 작업 수행 능력을 보여주고 있으나, 현재 관측값만으로 알 수 없는 숨겨진 상태(hidden state)를 파악하는 데 어려움이 있습니다. 이를 해결하기 위해 과거 이력이 필수적인 상황을 반영한 벤치마크인 HIDE를 도입했습니다. HIDE는 반복 횟수 계산, 과거 상태 회상, 실행 진행 추적 등 15가지 복합 태스크를 포함합니다. 연구진은 세 가지 상호 보완적인 메모리 메커니즘을 결합한 SEEK 프레임워크를 제안했습니다. 실험 결과, 기존 정책들은 HIDE 환경에서 한계를 보였으나 메모리 증강을 통해 시뮬레이션과 실세계 모두에서 성공률이 향상되었습니다. 이는 숨겨진 상태를 유지하는 내부 표현과 작업별 맞춤형 메모리 설계의 중요성을 시사합니다.

AI 연구

Do Audio LLMs Listen Before They Act? Diagnosing Acoustic-Context Gating in Voice Agents

음성 LLM은 명령을 수행할 수 있지만, 주변 상황에 따라 행동 여부를 결정하는 능력이 필수적입니다. 본 논문은 주변 대화(side-talk), 혼잣말(self-talk), 화자 전환(speaker-switch) 상황에서 행동 제어 능력을 측정하는 1,018개 항목의 벤치마크인 VGBench를 도입합니다. 실험 결과, 기존 모델들은 타인의 명령을 식별하더라도 행동을 억제하는 능력이 매우 부족함을 확인했습니다. 이를 해결하기 위해 제안된 VoxGate는 지도 학습을 통해 화자 전환 시 명령 억제율을 91.3%까지 높이면서도 사용자 명령은 정확히 수행합니다. 결과적으로 VGBench는 단순 화자 식별을 넘어 다중 단서를 활용한 음향-문맥 게이팅 능력을 측정합니다.

AI 연구

OmniSeek: Native Tool Integration for Multi-turn Audio-Visual Reasoning

기존의 멀티모달 모델은 긴 오디오-비주얼 시퀀스를 한 번의 추론으로 처리하려 하여 효율성과 정확도에 한계가 있었습니다. 이를 해결하기 위해 OmniSeek은 모델이 능동적으로 특정 시간대의 오디오나 비주얼 세그먼트를 선택하여 가져오는 에이전트 프레임워크를 제안합니다. 연구진은 멀티홉 추론 경로가 포함된 OmniTraj-170K 데이터셋을 구축하고, 두 단계의 강화학습을 통해 도구 사용 정책을 최적화했습니다. 특히 단일 모달리티에 의존하는 지름길을 방지하기 위해 오디오-비주얼 상호 의존성을 강조하는 목적 함수를 도입했습니다. 실험 결과, OmniSeek은 적응형 증거 탐색 능력을 학습하여 다양한 벤치마크에서 우수한 추론 성능을 입증했습니다.

AI 연구

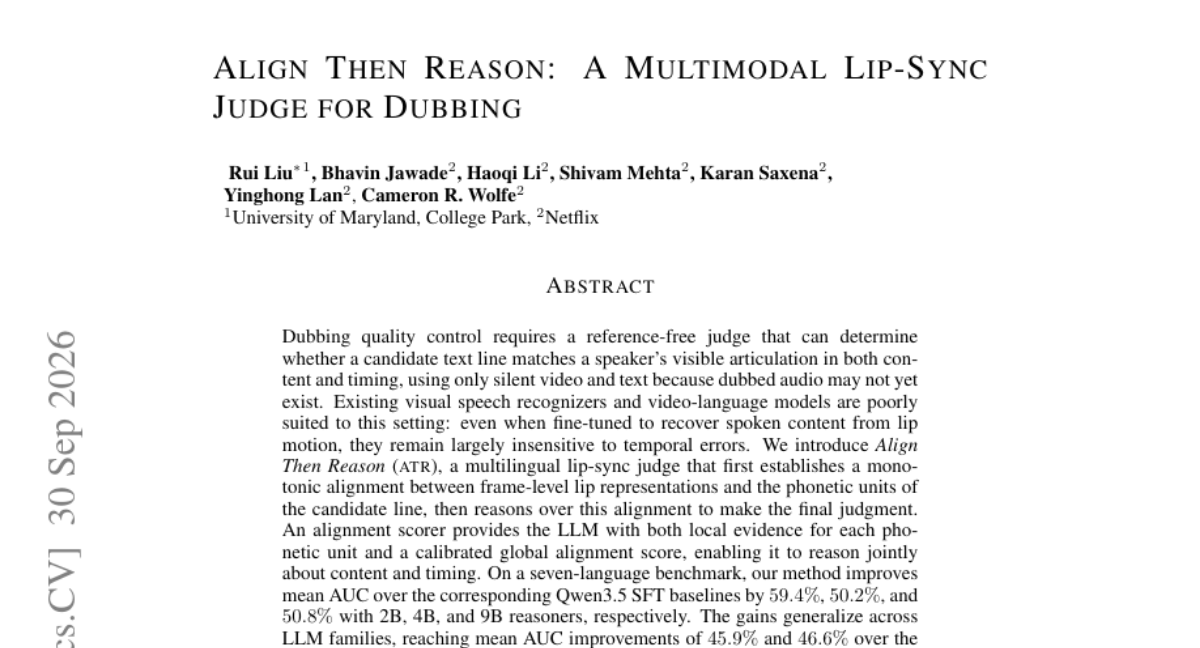
Align Then Reason: A Multimodal Lip-Sync Judge for Dubbing

더빙 품질 관리를 위해서는 오디오 없이 영상과 텍스트만으로 입 모양과 내용의 일치 여부를 판단하는 참조 없는(reference-free) 평가 모델이 필요합니다. 기존의 시각적 음성 인식 모델은 내용 복구에는 강하나 시간적 정렬 오류를 잡아내는 데 한계가 있습니다. 본 논문은 프레임 단위의 입 모양 표현과 음소 단위 간의 단조 정렬(monotonic alignment)을 먼저 수행한 후, 이를 바탕으로 최종 판단을 내리는 'Align Then Reason(ATR)' 방식을 제안합니다. 정렬 스코어러가 제공하는 국소적 증거와 전역적 정렬 점수를 LLM이 결합하여 내용과 타이밍을 동시에 추론합니다. 실험 결과, 다양한 언어 벤치마크와 다운스트림 작업(더빙 라인 재순위화 등)에서 기존 베이스라인 대비 압도적인 성능 향상을 기록했습니다.

30건

제품/서비스

이날 공개된 제품과 도구

제품/서비스

ZooWork

전문 지식을 AI 에이전트로 변환하여 팀과 고객에게 즉시 배포할 수 있는 플랫폼

제품/서비스

miso.com

iMessage 대화만으로 항공권과 호텔 예약을 끝내는 AI 여행 에이전트

제품/서비스

Prefer

AI 검색 엔진 최적화(AEO)를 위한 분석 및 자동 실행 솔루션

제품/서비스

Muse Gadgets

나만의 맞춤형 AI 하드웨어를 제작할 수 있는 Meta의 오픈소스 키트

제품/서비스

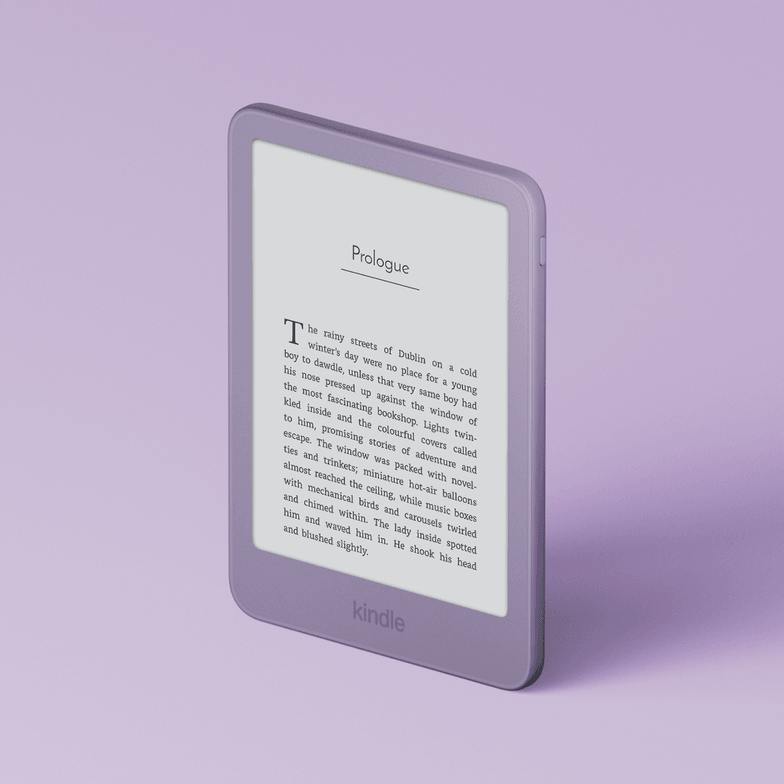
Kindle 2026

더 작고 빨라진 디자인과 플랫 디스플레이를 갖춘 차세대 6인치 킨들

나머지 25건 펼쳐보기

제품/서비스

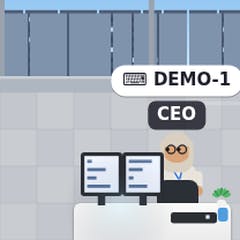
Cubicle

AI 에이전트의 작업 과정을 실시간 사무실 환경처럼 시각화하여 관찰하는 읽기 전용 대시보드

제품/서비스

SCMD

Claude Code가 저장한 개인화된 메모리를 로컬에서 직접 관리하고 검토하는 도구

제품/서비스

FoundrRadio

나만의 주파수를 설정하여 나만의 라디오 스테이션을 운영할 수 있는 인터넷 라디오 플랫폼

제품/서비스

Notchware

맥북 노치를 실시간 상태 알림 및 AI 에이전트 제어 센터로 변환하는 도구

제품/서비스

FeelMyMac

맥 트랙패드에서 다양한 질감을 느낄 수 있는 혁신적인 햅틱 피드백 도구

제품/서비스

una mano

한 손 타이핑을 위해 키보드 위치를 자유롭게 옮길 수 있는 아이폰용 키보드 앱

제품/서비스

WattMate

실시간 전력 소모량과 앱 종료 시 절약되는 시간을 알려주는 Mac 배터리 관리 도구

제품/서비스

eu/jev

GDPR 준수와 데이터 주권을 보장하는 유럽 기반의 Jev 스타일 AI 모델 서비스

제품/서비스

MacCam

macOS 환경에 최적화된 네이티브 카메라 앱으로, 사진과 영상을 Apple Photos로 즉시 저장합니다.

제품/서비스

Deskcord.chat

디스코드 서버를 강력한 고객 지원 데스크로 변환해주는 위젯 서비스

제품/서비스

Agent Activity

AI 코딩 에이전트의 작업 과정을 실시간으로 모니터링하는 macOS 전용 도구

제품/서비스

Crowny!

맥북 노치 영역에서 AI 에이전트, 음악, 일정 등 다양한 앱을 한눈에 관리하는 다이내믹 노치 앱

제품/서비스

bmux

에이전트 자동화와 수동 브라우징을 동시에 수행할 수 있는 멀티패널 브라우저

제품/서비스

Singularity

채팅 방식의 한계를 넘어, 개별 티켓 단위로 AI 코딩 에이전트를 병렬 실행하는 워크플로우 도구

제품/서비스

Kilo

iMessage를 통해 개인 맞춤형 운동 프로그램을 제공하는 AI 피트니스 코치

제품/서비스

bawkterm

SSH, SFTP, Docker 관리를 하나로 통합한 데스크톱 클라이언트

제품/서비스

OTPfill

이메일로 받은 OTP 코드를 맥 메뉴바에서 클릭 한 번으로 자동 입력하는 도구

제품/서비스

Sapien

가상 인구 집단을 활용한 AI 기반 시장 조사 및 전략 검증 도구

제품/서비스

Yubi

음성만으로 Mac에서 타이핑과 화면 제어를 수행하는 초경량 생산성 도구

제품/서비스

Thanor AI

AI로 제작한 웹사이트의 디자인 퀄리티를 전문가 수준으로 끌어올리는 디자인 가이드 도구

제품/서비스

Snail Walk

실제 걸음 수로 게임을 진행하는 몰입형 워킹 피트니스 게임

제품/서비스

Botscope

AI 에이전트와 봇의 유입을 식별하고 제어할 수 있는 통합 보안 및 관찰 플랫폼

제품/서비스

BeanRitual

최적의 에스프레소 추출 레시피를 기록하고 관리하는 AI 커피 어시스턴트

제품/서비스

WikiFix for Confluence

Confluence 지식 베이스의 모순, 중복, 고립된 페이지를 자동으로 찾아 해결하는 도구

제품/서비스

Reassign

AI 기반의 24시간 원형 타임 블로킹 플래너로 복잡한 일정을 직관적으로 재구성합니다.

6건

모델/벤치마크

새 모델과 주요 평가 결과

HF Model Trending

convaiinnovations/laya

Hugging Face에서 5,000개 이상의 likes를 기록하며 주목받고 있는 text-classification 모델인 convaiinnovations/laya입니다. 약 421M 파라미터를 보유한 모델로 분류 작업에 특화되어 있습니다.

HF Model Trending

Lightricks/LTX-2.5

Lightricks에서 공개한 LTX-2.5 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 image-to-video 파이프라인을 지원하는 것이 특징입니다.

HF Model Trending

Cloudflare/clef-flash

Cloudflare에서 공개한 clef-flash 모델이 최근 주목받고 있습니다. 이 모델은 image-text-to-text 파이프라인을 지원하는 멀티모달 모델입니다.

LiveCodeBench

LiveCodeBench top model: O4-Mini (High)

LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Pro-06-05

LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

나머지 1건 펼쳐보기

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Flash-04-17

LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.