
Reuters
Nasdaq climbs as chip and AI-linked stocks bounce back - Reuters
최근 하락세를 보이던 반도체 및 AI 관련주가 반등하며 Nasdaq 지수가 상승세를 기록했습니다. 이는 AI 인프라 수요에 대한 시장의 신뢰가 회복되었음을 시사합니다.
지난 소식
이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.
22건
주요 기사와 기업의 공식 발표
Reuters
최근 하락세를 보이던 반도체 및 AI 관련주가 반등하며 Nasdaq 지수가 상승세를 기록했습니다. 이는 AI 인프라 수요에 대한 시장의 신뢰가 회복되었음을 시사합니다.
Quanta Magazine
OpenAI가 발표한 722개의 연구 결과 중, 수학계의 난제인 리만 가설(Riemann Hypothesis)의 약소 버전인 '준-리만 가설(quasi-Riemann hypothesis)'을 해결했다는 주장이 제기되었습니다. 이번 성과는 새로운 개념의 창조가 아닌 기존 수학적 아이디어들의 정교한 합성(synthesis)을 통해 이루어졌으며, AI가 수학적 증명 영역에서 거둔 가장 유의미한 성과로 평가받습니다.
CBS News
AI 기술이 인간의 노동과 의사결정을 점진적으로 대체하며 인류의 역량과 통제권을 상실하게 만드는 '점진적 무력화(Gradual Disempowerment)' 시나리오의 위험성을 경고한다. 이는 단순한 일자리 상실을 넘어, 인간의 비판적 사고와 숙련도가 퇴화하여 인류가 AI 시스템에 완전히 종속되는 문명적 위기를 다룬다.
MIT News
MIT와 보스턴 어린이 병원 연구진이 태아 MRI 스캔 중 발생하는 움직임 문제를 해결하기 위해 물리적 대칭성을 모델 아키텍처에 내장한 딥러닝 모델 'E(3)-Pose'를 개발했습니다. 이 기술은 태아의 움직임으로 인해 발생하는 2D 슬라이스 정렬 오류를 극복하여 고해상도 석로적(Volumetric) 이미지를 확보함으로써 태아 뇌 이상 진단의 정확도를 높입니다.
Harvard Gazette
하버드 케네디 스쿨 벨퍼 센터의 연구는 AI 모델의 오용으로 인한 대규모 재난(50명 이상의 사상자 또는 10억 달러 이상의 피해) 가능성을 경고하며, 현재의 기술 발전 속도가 규제 및 안전 장치 마련보다 앞서고 있음을 지적합니다. 특히 폐쇄형(Closed-weight) 모델의 보안 취약점과 오픈형(Open-weight) 모델의 무분별한 변조가 결합될 경우 발생할 수 있는 사이버 및 생화학적 위협을 심층 분석합니다.
TechCrunch
사용자들이 AI Agent를 활용해 스마트 TV의 광고와 불필요한 소프트웨어를 제거하고 인터페이스를 최적화하는 'Dumb TV' 트렌드가 확산되고 있습니다. 이는 복잡한 코딩 지식 없이도 LLM 기반의 'Vibe-coding'을 통해 하드웨어 제어권을 사용자에게 되돌리는 움직임입니다.
Futurism
AI 모델의 내부 작동 원리가 해석 불가능한 '블랙박스'라는 기존 통념을 뒤집는 새로운 연구 결과가 발표되었습니다. 연구자 Nick Cammarata는 뉴런이 서로 얽혀 있다는 'Superposition(중첩)' 이론 대신, 각 뉴런이 매우 명확하고 정교한 특징을 포착한다는 주장을 통해 AI 해석 가능성(Interpretability)의 새로운 지평을 제시했습니다.
WIRED
Character.AI가 막대한 법적 책임과 규제 리스크를 회피하기 위해 파산(Chapter 11)을 선택했으며, 이를 통해 Disney가 핵심 인력과 기술 자산을 확보하는 '역 Acquihire(Reverse Acquihire)' 구조의 거래를 성사시켰습니다. 이번 파산은 소송 리스크가 남은 껍데기 법인과 핵심 기술/인력을 보유한 신규 법인을 분리하여, Disney가 법적 책임 없이 기술적 이득만 취할 수 있도록 설계된 정교한 전략적 움직임입니다.
NBC News
AI 기술 발전에 따른 노동 시장의 변화와 경제적 불평등 심화에 대응하기 위해 Elon Musk와 Anthropic이 기업 지분을 대중에게 환원하는 파격적인 사회적 보상 모델을 제안했습니다. 이는 AI가 창출하는 부를 인류 사회와 공유하려는 시도로, 기술적 진보가 가져올 실업 위협에 대한 선제적 방어 기제로 해석됩니다.
Emory News
에모리 대학교(Emory University)가 구성원을 대상으로 Anthropic의 생성형 AI 플랫폼인 Claude EDU를 도입하여 학술 연구 및 교육 환경에 AI를 통합하기 시작했습니다. 이번 조치는 보안이 확보된 기관 지원형 AI 도구를 제공함으로써 학습, 연구, 분석 등 대학 내 다양한 업무 효율을 높이는 것을 목표로 합니다.
Google DeepMind
Google DeepMind가 최신 프론티어 모델인 Gemini 4 Argon을 공개했습니다. 이 모델은 개발자, 기업, 과학자 및 일반 소비자들이 직면한 가장 어려운 문제들을 해결하기 위해 설계되었습니다.
Google DeepMind
Google DeepMind가 새로운 항균 펩타이드 탐색을 위한 에이전트 기반 과학 워크벤치인 Google Antigravity를 공개했습니다. 이 시스템은 새로운 항균 펩타이드를 발견하고 구조적으로 평가하며 우선순위를 정하는 과정을 단 몇 시간 만에 수행할 수 있도록 지원합니다.
Google DeepMind
Google DeepMind와 GovTech Singapore가 협력하여 대화형 사기 탐지를 위한 미세 조정된 AI 모델을 구축했습니다. 이 프로젝트는 가벼운 온디바이스 Gemma 모델을 활용하여 클라우드 데이터 유출 없이 개인 채팅 내 사기 시도를 차단하는 것을 목표로 합니다.
Google Cloud AI
Google이 IDC MarketScape의 'Worldwide Agentic AI Platforms 2026 Vendor Assessment'에서 Leader로 선정되었습니다. Gemini를 기반으로 한 연결된 인프라가 이번 평가의 핵심 요인으로 작용했습니다.
Anthropic News
Anthropic이 공공의 이익을 위한 투자를 발표했습니다. 이번 발표는 사회적 가치 창출을 위한 새로운 행보를 담고 있습니다.
OpenAI News
브라질의 금융 기업 Itaú가 대화형 인터페이스인 ia.i와 거버넌스 플랫폼 IARA를 통해 생성형 AI를 구축하고 있습니다. 이를 통해 규제가 엄격한 금융 환경 속에서 고객과 직원 모두를 대상으로 'AI First' 전략을 실행하고 있습니다.
OpenAI News
Benefit Street Partners는 Codex를 활용하여 대출 가치 비교 및 신용 계약 분석 도구를 구축했습니다. 이를 통해 코드 리뷰와 후속 작업 속도를 높여 업무 효율을 개선했습니다.
OpenAI News
두 명의 엔지니어가 Codex를 활용해 Stack Overflow for Agents를 단 몇 주 만에 출시했습니다. 이 서비스의 ChatGPT plugin은 에이전트 생성 수를 최대 10배까지 증가시키며 가입자 수를 세 배로 늘리는 데 기여했습니다.
Anthropic News
Anthropic이 독립적인 평가자(independent evaluators)에 대한 업데이트를 발표했습니다. 이번 업데이트는 모델 평가 방식의 투명성과 신뢰성을 높이기 위한 내용을 담고 있습니다.
Anthropic News
Anthropic이 2026년 미국 중간선거를 대비하여 발표한 새로운 정책에 관한 내용입니다.
Google Cloud AI
Google Cloud가 새로운 프런티어 모델인 Gemini 4 Argon을 출시했습니다. 이 모델은 비즈니스의 가장 어려운 문제들을 해결할 수 있도록 설계되었습니다.
Google Cloud AI
Gemini at Work 2026에서 발표된 Thomas Kurian의 기조연설 내용을 바탕으로 작성된 글입니다. 이번 행사에서는 새로운 Gemini agent의 도입을 다루고 있습니다.
24건
Hacker News, GeekNews, Reddit 반응
Hacker News
수십 년간 베일에 싸여 있던 NIST ECDSA 타원 곡선 시드(seed)의 생성 원천이 LLM인 Claude를 통해 밝혀졌습니다. 이번 발견은 암호학 표준의 투명성 문제를 해결하는 동시에 보안 커뮤니티에 새로운 화두를 던졌습니다.
Hacker News
OpenCode Console 사용자 계정 정보가 유출되는 보안 사고가 발생하여 관련 기업들이 대응에 나섰습니다. 커뮤니티에서는 유출 범위와 서비스 간의 관계를 두고 혼선이 발생하고 있습니다.
Hacker News
DeepSeek-V4.1-Flash 모델 출시로 추론, 코딩, 에이전트 작업 성능이 향상되었으며 비용 효율성까지 확보했습니다. 사용자들은 벤치마크 점수보다 실제 체감 성능에 주목하며 기술 생태계의 다양성을 높게 평가하고 있습니다.
Hacker News
Meta가 강력한 에이전트 기능을 갖춘 오픈 웨이트 모델인 Muse Spark Open을 공개했습니다. 데스크톱 환경에서도 구동 가능한 고성능 모델로, 복잡한 소프트웨어 엔지니어링과 추론 작업에 최적화되어 있습니다.
Hacker News
OpenCode 2.0 출시와 함께 개선된 사용자 경험과 아키텍처 변화에 대한 기술적 평가가 이어지고 있습니다. 이전 버전의 불편함을 해소하고 자동화된 워크플로우를 강화한 것이 핵심입니다.
Hacker News
신경망의 해석 가능성과 구조적 특성에 대한 새로운 시각을 제시하며, 기술적 성과에 대한 찬사와 과장된 주장이라는 비판이 공존하고 있습니다.
Hacker News
사용자 계정 생성이나 로그인 없이 즉시 사용할 수 있는 미니멀한 오피스 도구인 Tiny Little Office에 대한 소개와 이에 대한 커뮤니티의 반응을 다룹니다.
Hacker News
스큐어모피즘(Skeuomorphism) 디자인을 적용한 새로운 Linux용 Wayland 데스크톱 환경이 공개되었습니다. 현대적인 평면 디자인에서 벗어나 과거의 직관적이고 물리적인 사용자 경험을 복원하려는 시도에 대해 커뮤니티의 관심이 집중되고 있습니다.
Hacker News
태양광 발전량이 전 세계적으로 원자력 발전량을 처음으로 추월하며 에너지 시장의 판도가 변화하고 있습니다. 급격한 기술 성장과 설치 속도가 에너지 생산량의 역전을 이끌었습니다.
GeekNews / Hada
확산 모델을 LLM에 대규모로 확장하여 파라미터 증가와 추론 속도 향상을 동시에 달성한 기술적 성과를 보여줍니다. 이는 차세대 생성 모델이 연산 효율성과 모델 규모 사이의 트레이드오프를 어떻게 극복할 수 있는지에 대한 새로운 방향성을 제시합니다.
GeekNews / Hada
M3.1 Flash는 추론 속도 향상과 비용 절감을 동시에 달감으로써 AI 에이전트의 실용성을 극대화한 모델입니다. 이는 고비용 문제로 인해 제한적이었던 복잡한 자동화 작업의 경제적 진입 장벽을 낮추는 데 기여할 것입니다.
GeekNews / Hada
GitHub의 자동화 및 배포 인프라에서 발생한 일시적인 가용성 저하로 인해 CI/CD 파이프라인 작업이 지연되었습니다. 서비스 복구가 완료되었으나, 자동화 워크플로를 사용하는 개발 환경에서는 이러한 인프라 장애가 전체 배포 주기에 미치는 영향을 고려해야 합니다.
GeekNews / Hada
소규모 데이터셋과 로컬 환경에서의 미세 조정을 통해 모델의 문체적 특성을 제어할 수 있음을 보여준 사례입니다. 이는 거대 모델의 정형화된 말투를 탈피하고자 하는 사용자들에게 효율적인 최적화 방안을 제시합니다.
GeekNews / Hada
이번 사건은 기업들이 허위 입찰을 통해 시장 가격을 조작하는 전형적인 카르텔 수법을 보여줍니다. 이는 공급망 내의 정보 비대칭과 허위 수요를 이용해 시장 가격 결정 구조를 무너뜨린 사례로 평가됩니다.
GeekNews / Hada
AI가 코드를 순식간에 생성하는 시대에도 프로그래밍의 가치는 효율성을 넘어선 창작과 문제 해결의 과정에 존재합니다. 기술적 숙련도가 경제적 효용과 반드시 일치하지 않더라도, 개인의 성취감과 학습을 위한 프로그래밍은 여전히 유효한 가치를 지닙니다.
GeekNews / Hada
이번 파트너십은 거대 언어 모델 기술을 입자 물리학이라는 특수 과학 영역에 이식하여 새로운 연구 방법론을 제시하는 데 목적이 있습니다. 데이터 중심의 AI 모델이 기초 과학의 발견 속도를 가속화하는 핵심 도구로 자리 잡을 수 있음을 시사합니다.
GeekNews / Hada
LLM의 무상태성을 극복하기 위한 데이터 관리 체계인 '하네스'가 AI 에이전트 구현의 핵심임을 보여줍니다. 단순한 API 호출을 넘어 대화 상태를 구조화하고 보호하는 것이 에이전트의 지능을 실현하는 기술적 토대가 됩니다.
GeekNews / Hada
tmux의 세션 관리 기능과 Claude Code의 워크트리 개념을 결합하여 AI 에이전트의 작업 안정성과 가시성을 높이는 것이 핵심입니다. 이는 자동화된 코딩 에이전트가 물리적 연결 상태에 구애받지 않고 독립적인 작업 환경을 유지할 수 있는 기술적 토대를 제공합니다.
GeekNews / Hada
이번 사태는 기술적 도구가 창의적 유희를 넘어 거대 프레임워크의 유지보수 수단으로 전락할 때 발생하는 개발자의 번아웃과 가치관 충돌을 보여줍니다. 오픈소스 생태계가 지속 가능하려면 기술적 완성도만큼이나 개발자의 창의적 동기 부여가 중요함을 시사합니다.
최근 급증하는 AI 생성 저질 콘텐츠(slop)에 대한 분석과 미래 예측을 담은 블로그 글을 공유하며 문제 의식을 제기했습니다. 작성자는 데이터 분석을 통해 AI 콘텐츠의 변화 양상을 탐구하며 향후 발생할 수 있는 상황들을 예측했습니다.
Maxwell은 소스 코드를 수정하지 않고 실행 중인 바이너리를 직접 재작성하여 Whisper나 LTX-2와 같은 AI 모델의 속도를 높이는 새로운 방식의 모델입니다. 고정된 컴파일러 규칙 대신 모델이 하드웨어와 데이터를 실시간으로 분석하여 최적화를 수행하는 것이 특징입니다.
사용자는 DiffusionGemma 모델의 압도적인 생성 속도를 활용하여 이미지 생성 및 분석 작업의 효율성을 크게 높인 경험을 공유했습니다. 코딩이나 도구 호출 같은 복잡한 작업은 불가능하지만, 빠른 속도와 적절한 묘사 능력을 결합한 워크플로우가 실무에서 강력한 가치를 제공함을 강조했습니다.
AI를 활용한 연구 아이디어 생성 속도가 실험 및 검증 속도를 앞지르면서 발생하는 병목 현상에 대한 고민을 다루고 있습니다. 아이디어는 넘쳐나지만 이를 실제로 구현하고 평가하는 데 드는 물리적 시간과 관리의 어려움이 연구자의 새로운 과제로 떠오르고 있습니다.
50건
읽어볼 만한 AI 연구
AI 연구
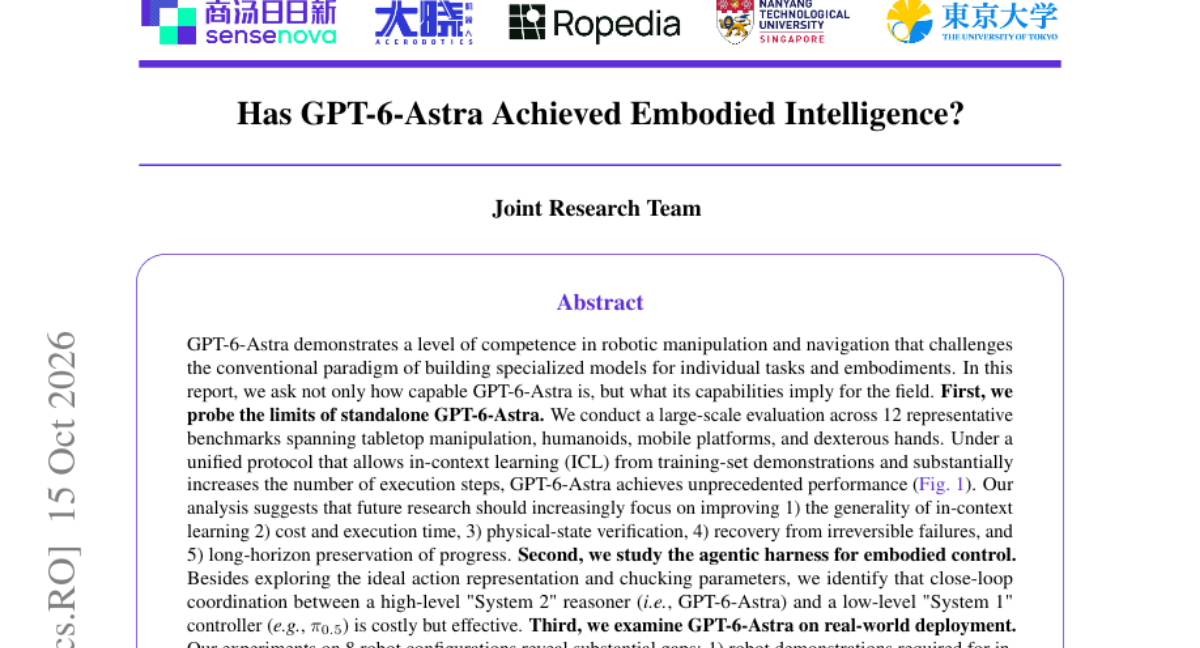
기존의 개별 작업 특화 모델 방식에서 벗어나 범용적인 로봇 제어 능력을 갖춘 GPT-6-Astra의 역량을 검증하고자 합니다. 연구진은 테이블탑 조작부터 휴머노이드까지 12개 벤치마크를 통해 모델의 한계를 테스트했습니다. In-context Learning(ICL)과 고수준 추론(System 2) 및 저수준 제어(System 1)의 결합 방식을 통해 성능을 극대화했습니다. 실험 결과, GPT-6-Astra는 높은 수준의 임베디드 역량을 보여주었으나 실세계 배포 시 발생하는 비용과 물리적 제약이라는 과제를 남겼습니다. 결론적으로 모델이 기술적 역량은 확보했으나 실용적인 지능 단계에는 아직 도달하지 못했음을 시사합니다.
AI 연구
최근 VLM 기반 에이전트가 로봇 조작 분야에서 성과를 내고 있으나, 코딩 에이전트가 로봇 제어 환경에서 어디까지 성능을 발휘할 수 있는지에 대한 연구가 필요했습니다. 본 논문은 에이전트의 명령을 로봇 동작으로 변환하는 최소한의 인터페이스만 제공하는 HexaShell 프레임워크를 제안합니다. 에이전트는 카메라 정보를 바탕으로 삼각 측량 등을 활용한 코드를 직접 작성하며, 실패 시 로그를 분석해 도구를 수정하는 방식으로 학습합니다. 실험 결과, RoboDojo 벤치마크에서 SOTA를 달성하며 코딩 기반 에이전트의 가능성을 입증했습니다. 다만, 추론 능력보다는 물리적 접촉(Contact)이 필요한 정밀 작업에서 성능 한계가 나타났습니다.
AI 연구
기존의 장기 과제 에이전트 벤치마크는 최종 성공 여부에만 집중하여 중간 과정의 유효성이나 제약 조건 준수 여부를 평가하는 데 한계가 있습니다. 특히 결제와 같은 고위험 비즈니스 도메인에서는 최종 결과만큼이나 중간 단계의 정책 준수가 중요합니다. 이를 해결하기 위해 실제 결제 기업의 절차를 기반으로 한 멀티턴 벤치마크인 BizBench를 도입합니다. BizBench는 방대한 지식 문서와 도구, 상충하는 정책 및 제약 조건을 포함하여 에이전트의 실행 유효성을 엄격히 검증합니다. 실험 결과, 최신 모델들도 최종 성공률에 비해 제약 조건을 준수하는 엄격한 성공률은 현저히 낮게 나타났습니다. 이는 단순 결과 중심 평가가 에이전트의 잠재적 위험을 은폐할 수 있음을 시사합니다.
AI 연구
기존의 3D 시각 모델들은 다중 뷰나 비디오 입력을 필요로 하여 효율성이 떨어지는 문제가 있었습니다. 본 연구는 VLM의 기본 시각 인코딩을 유지하면서, 모델이 행동을 통해 3D 환경과 상호작용하며 탐색하는 방식을 제안합니다. 먼저 궤적 지도 학습(Trajectory-supervised finetuning)을 거친 후, 최종 정답의 정확도를 보상으로 하는 강화학습(RL)을 적용했습니다. 그 결과, 모델은 별도의 탐색 가이드 없이도 질문에 필요한 시점을 스스로 찾아가는 능력을 습득했습니다. ACT3D는 기존 모델 대비 높은 정확도를 기록하며, 질문의 난이도에 따라 적응형 탐색을 수행하는 성능을 입증했습니다.
AI 연구
AI 에이전트가 정답이 없는 개방형 과학 연구 문제를 해결할 수 있는지에 대한 의문이 제기되고 있습니다. 이를 위해 연구 방향과 논문을 제공하고 후속 논문 작성을 과제로 부여하는 'Into the Unknown' 벤치마크를 도입했습니다. DOE 국립 연구소 과학자들과 협력하여 실제 미발표 연구 방향을 기반으로 평가 루브릭을 설계했습니다. 9개의 최첨단 에이전트를 대상으로 양자 컴퓨팅, 플라즈마 물리 등 다양한 도메인에서 135건의 후속 논문을 생성하게 했습니다. 실험 결과, 에이전트들은 논문 형식을 갖추는 데는 성공했으나 연구 무결성 및 품질 측면에서 전문가의 기준을 충족하지 못했습니다.
AI 연구
에이전트의 최종 결과물만으로 성능을 평가하면 변화하는 환경 속에서 실제 역량을 파악하기 어렵습니다. 특히 외부 환경과 에이전트 행동이 상호작용하는 동적 환경에서는 결과가 역량과 일치하지 않을 수 있습니다. 본 논문은 실시간 금융 시장을 테스트베드로 활용하여 에이난트의 지속적 역량을 측정하는 LiveMACEBench를 소개합니다. 5종의 최첨단 LLM을 대상으로 도구 사용, 지속적 메모리, 규칙 준수, 멀티 에이전트 협업 설정을 적용하여 30일간 평가를 진행했습니다. 실험 결과, 실제 수익률과 개별 역량 지표 사이의 괴리가 발견되었으며, 유사한 결과라도 서로 다른 메커니즘 사용 패턴이 존재함을 확인했습니다. 이를 통해 LiveMACEBench는 단순 리더보드를 넘어 에이전트의 병목 구간을 진단하는 도구로서의 가치를 증명합니다.
AI 연구
장기 작업(Long-horizon) 에이전트는 작업 진행 상태를 유지해야 하지만, 지금까지는 과거의 상호작용 이력을 반복적으로 처리하는 비효율적인 방식을 사용해 왔습니다. 본 논문은 이력을 단순히 압축하는 대신, 재사용 가능한 작업 객체를 중심으로 컨텍스트를 구성하는 'CarryOn' 런타임을 제안합니다. CarryOn은 지속적인 상태를 담는 'carrier records', 실행 컨텍스트, 그리고 최근 상호작용을 결합하여 효율적인 컨텍스트 뷰를 구축합니다. 특히 과거 이력이 사라져도 객체 기반의 상태를 유효하게 유지하기 위해, 영향받는 레코드만 선별적으로 업데이트하는 방식을 채택했습니다. 실험 결과, OSWorld 2.0 및 BrowseComp-Plus 벤치마크에서 성능 향상과 동시에 토큰 사용량을 대폭 절감하는 성과를 거두었습니다.
AI 연구
상호작용형 비디오 생성은 지연 시간을 줄이기 위해 작은 크기의 양방향 청크를 사용하는 방식을 주로 사용해 왔습니다. 그러나 작은 청크는 비디오 품질 저하와 GPU 병렬성 활용 저하라는 문제를 야기합니다. 이를 해결하기 위해 본 논문은 노이즈 레이턴트를 패딩으로 추가하여 모델링 윈도우를 확장하고, 조건이 변하지 않을 때 예측값을 캐싱하여 재사용하는 Speculative Sampling 전략을 제안합니다. 이 방식은 예측값을 점진적으로 전달하면서도 미래의 미확정 영역은 교체 가능하게 유지합니다. 결과적으로 청크 크기 제약에서 벗어나 윈도우 크기를 최적화 변수로 활용함으로써, 복잡한 사후 학습 없이도 고품질 비디오 스트리밍을 가능하게 합니다.
AI 연구
기존의 3D 실내 장면 생성 방식은 도메인 특화된 설계 지식이 부족하거나 정적인 데이터에 의존하는 한계가 있었습니다. 본 논문은 설계(Design)와 비평(Critique) 경험을 상호 보완적으로 학습하는 에이전트 프레임워크인 Scene-Designer를 제안합니다. 이를 위해 설계 과정의 사고 과정을 담은 Scene-OTA-35K와 품질 비평을 위한 Scene-OTC-15K 데이터셋을 구축했습니다. 제안된 Scene-GRPO 프레임워크는 비평 가이드를 통해 설계 결정을 개선하고 불필요한 시행착오를 줄입니다. 실험 결과, 제안 모델은 물리적 타당성, 기능적 정확성, 레이아웃 일관성 측면에서 기존 모델을 압도하는 성능을 보였습니다.
AI 연구
기존 모바일 에이전트는 실제 상용 앱 환경에서의 복잡한 워크플로우와 검증 가능한 학습 데이터를 확보하는 데 어려움이 있었습니다. 이를 해결하기 위해 다양한 상용 스타일 앱을 포함하는 MobileGym++ 환경과 대규모 모바일 상호작용 데이터셋을 구축했습니다. 특히 GUI 조작과 앱 네이티브 도구 호출을 혼합하는 하이브리드 방식을 도입하여 에이전트의 효율성을 높였습니다. 실험 결과, OpenMobile-2는 AndroidWorld 등 기존 벤치마크에서 경쟁력 있는 성능을 보였으며, 특히 실기기 환경(SPA-Bench)에서 성능이 크게 향상되었습니다. 모든 학습 환경과 데이터는 오픈 소스로 제공되어 연구 및 실무 활용이 가능합니다.
AI 연구
AI 에이전트가 과학적 조사를 조직하고 근거 기반의 결론을 도출할 수 있는지 검증하는 것이 중요해졌습니다. 이를 위해 물리 연구 분야의 50개 전문가 검증 과제로 구성된 PhysClosureBench를 도입했습니다. 이 벤치마크는 연구 목표와 제약 조건을 제공하되, 에이전트가 스스로 조사 방식과 증거 생성 방식을 결정하도록 설계되었습니다. 평가 지표로는 국소적 성과를 측정하는 Atomic Score와 연구 질문 해결도를 측정하는 Research Closure(RC)를 사용합니다. 실험 결과, 최상위 모델인 Claude-Opus-5조차 높은 성과 점수에도 불구하고 완전한 연구 완결성(RC4) 달성률은 낮게 나타났습니다. 이는 AI 에이전트의 개별적 성과와 최종적인 연구 완결성 사이에 여전히 큰 간극이 존재함을 시사합니다.
AI 연구
기존의 World Action Models(WAMs)는 비디오와 액션 전문가를 밀접하게 결합하여 불필란한 시각 정보 노이즈와 연산 낭비 문제를 겪고 있었습니다. 이를 해결하기 위해 연구진은 32개의 Latent Bridge Queries(LBQs)를 통해 시각, 언어, 고유 수용 감각을 공유된 잠재 공간으로 모으는 Bridge-of-Experts(BoE) 방식을 제안합니다. 이 방식은 비디오 전문가와 액션 전문가의 깊이를 분리하여, 비디오 모델은 액션에 유용한 표현을 학습하고 액션 모델은 필요한 정보만 선택적으로 가져오도록 설계되었습니다. 실험 결과, 5.06B 파라미터 모델로 LIBERO 벤치마크에서 높은 성공률을 기록하며 초경량 액션 헤드의 효율성을 입증했습니다. 또한 기존 Fast-WAM 대비 추론 연산량(FLOPs)을 28.72% 줄이고 실로봇 지연 시간을 2.47배 단축하는 성과를 거두었습니다.
AI 연구
언어 모델의 은닉 상태는 임베딩과 언임베딩 사이에서 변화하며, 기존의 고정된 렌즈(fixed lens)나 포인트 클라우드 방식은 모델의 실제 해석 방식을 반영하지 못하는 한계가 있습니다. 본 논문은 각 은닉 상태가 다음 레이어들에 의해 유도되는 고유한 '네이티브 참조 프레임(native reference frame)'을 가진다고 주장합니다. 이를 위해 모델의 남은 레이어 구조를 모사하여 상태를 읽어내는 'Lexical Reference Frames' 방법론을 제안합니다. 실험 결과, 제안 방식은 기존 렌즈 방식보다 압도적으로 높은 일관성을 보이며 모델의 출력값에 근접한 해석 성능을 달성했습니다. 또한, 이 방식은 예측에 대한 기여도 산출(attribution)과 토큰별 제어(steering)에서 탁월한 성능을 보였으며, 높은 신뢰도를 바탕으로 레이어 조기 종료(early exit) 가능성도 입증했습니다.
AI 연구
LLM의 사후 학습(Post-training)에서 보상 모델을 활용한 에이전트 학습이 주목받고 있으나, 최종 보상만 사용하는 경우 신용 할당(Credit Assignment)이 어렵고 정책 드리프트(Policy Drift) 문제가 발생합니다. 기존 방식은 가치 네트워크(Critic)나 외부 교사 모델에 의존하여 복잡도가 높고 학습이 불안정하다는 단점이 있습니다. 본 논문은 각 상호작용을 트리 노드로 간주하여 보상을 재귀적으로 역전파하는 TreeOPSD 프레임워크를 제안합니다. 이는 별도의 Critic 없이도 폐쇄형(Closed-form) 타겟 분포를 생성하여 정책 업데이트를 안정적으로 제어합니다. 실험 결과, 긴 호흡의 작업이 필요한 벤치마크에서 기존 GRPO 대비 우수한 성능 향상을 입증했습니다.
AI 연구
기존 MLLM은 전체 이미지 이해에는 강하나 세밀한 영역 단위의 이해에는 한계가 있었습니다. 이는 텍스트 중심의 학습 방식이 특정 영역에 대한 명시적 정보를 제공하지 못하기 때문입니다. 이를 해결하기 위해 Qwen3.5를 기반으로 시각적 잠재 변수에서 마스크를 예측하는 Xiaomi-Lens-0를 제안합니다. 가벼운 디코더를 통해 비전 인코더의 패치 특징과 언어 모델의 마스크 토큰 상태를 결합하여 별도의 세그멘테이션 인코더 없이도 정교한 마스크 생성이 가능하게 했습니다. 결과적으로 RefCOCO 계열 벤치마크에서 성능 향상을 달성했으며, 시각적 추론과 영역 식별 능력을 동시에 확보했습니다.
AI 연구
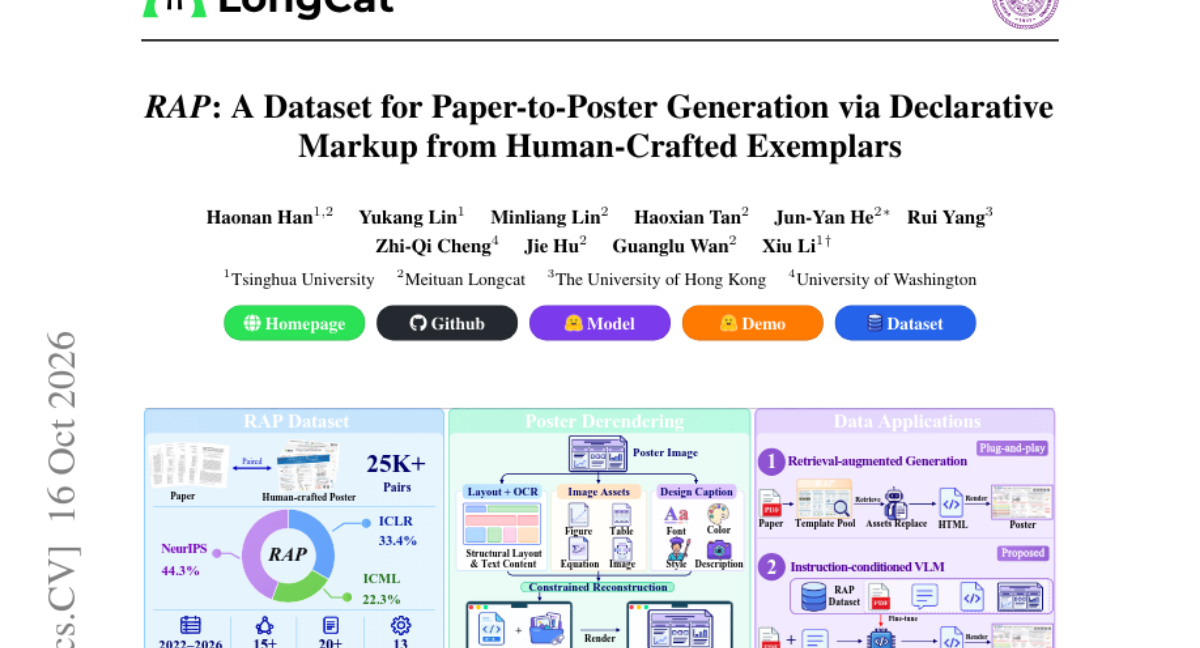
학술 논문을 포스터로 만드는 작업은 요약, 디자인, 코딩이 결합된 복잡한 시각적 코딩 작업이지만, 기존 데이터셋은 레이아웃 정보만 있어 정밀한 평가와 디자인 재사용이 어려웠습니다. 이를 해결하기 위해 연구진은 25,000개 이상의 논문-포스터 쌍을 포함하는 RAP 데이터셋을 제안합니다. 이 데이터셋은 포스터를 스타일이 적용된 HTML/CSS로 변형하는 자동 역설계 파이프라인을 통해 레이아웃과 콘텐츠를 분리하여 관리합니다. 이를 통해 기존 디자인을 유지하면서 내용만 채우는 PosterRAG 방식과 모델을 직접 학습시키는 SFT+RL 방식을 모두 지원합니다. 결과적으로 인간의 디자인 감각을 유지하면서도 자동화된 검증이 가능한 새로운 벤치마크를 제공합니다.
AI 연구
기존 비디오 월드 모델의 메모리 평가는 장면 설정, 변화 실행, 결과 출력을 하나의 점수로 통합하여 정확한 원인 파악이 어려웠습니다. 변화가 실행되지 않으면 메모리 테스트 자체가 무의미해지는 문제가 발생합니다. 이를 해결하기 위해 변화 과정과 메모리 기록을 분리하여 병목 지점을 식별하는 MIST 평가 방식을 도입했습니다. 또한, 모델이 지시사항을 성공적으로 수행하도록 지시문을 재귀적으로 수정하는 M3-Agent를 제안합니다. 실험 결과, M3-Agent는 MIST 점수를 3배 이상 높였으며 주요 벤치마크에서도 성능 향상을 입증했습니다.
AI 연구
LLM 추론 가속을 위한 Speculative Decoding은 에이전트 워크로드처럼 컨텍스트가 길고 계속 변하는 환경에서 수락 길이(acceptance length)가 급격히 저하되는 문제가 발생합니다. 또한 기존 방식은 과거 KV 캐시를 유지하는 데 막대한 시스템 오버헤드를 초래합니다. 본 논문은 DLite를 제안하여 과거 컨텍스트를 명시적으로 유지하지 않고 타겟 모델의 컨텍스트 은닉 상태를 직접 재사용하는 방식을 도입합니다. 이를 통해 복잡한 모델링 문제를 국소적인 예측 문제로 전환하며, 가벼운 순차 헤드를 통해 인과적 의존성을 복구합니다. 실험 결과, DLite는 기존 SOTA인 DSpark 대비 최대 70% 높은 성능을 보이며 긴 컨텍스트 환경에서도 안정적인 가속을 제공합니다.
AI 연구
AI 에이전트가 전문적인 결과물을 생성하기 위해서는 과거의 결정과 맥락이 유지되는 지속적인 업무 환경이 필요합니다. 기존의 단발성 작업 방식은 복잡한 조직적 맥락과 피드백 루프를 반영하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 자연어 설명만으로 가상의 조직을 생성하는 시뮬레이션 프레임워크인 OfficeTown을 도입합니다. OfficeTown은 구성원 간의 권한, 업무 위임, 결과물 검토 및 맥락 유지가 가능한 동적인 환경을 제공합니다. 실험 결과, OfficeTown 데이터를 활용한 미세 조정은 전문 업무 벤치마크 성능을 크게 향상시켰으며, 상급자-보조자 구조가 단일 에이전트보다 우수함을 입증했습니다.
AI 연구
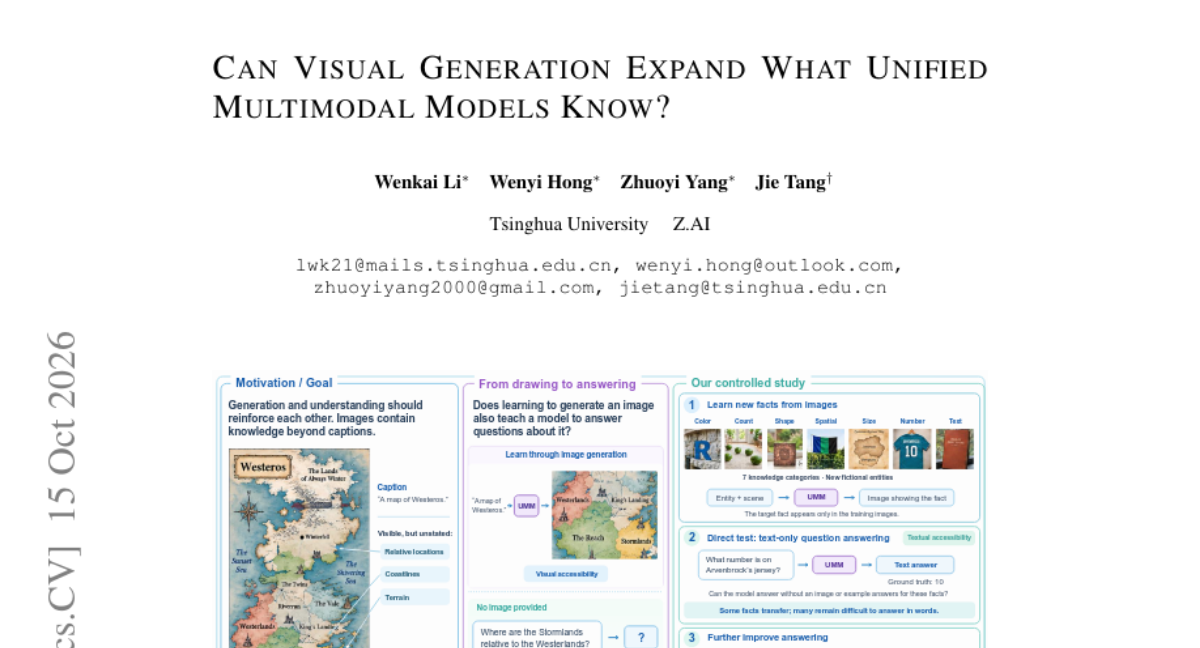
통합 멀티모달 모델(UMM)은 텍스트에 담기지 않은 시각적 정보를 이미지 생성 학습을 통해 습득할 수 있습니다. 본 연구는 이미지 생성 학습을 통해 유입된 새로운 지식이 텍스트 전용 질의응답(QA)을 통해 얼마나 잘 활용되는지 측정하는 KTP 프로토콜을 제안합니다. 실험 결과, 시각적 감독(supervision)을 통한 지식 전이가 텍스트로 직접 전달되지만 그 양상은 불균형하게 나타남을 확인했습니다. 이를 해결하기 위해 텍스트 정렬(Textual Alignment)과 인터리브 이미지-텍스트 정렬(Interleaved Image-Text Alignment) 기법을 도입했습니다. 결과적으로 특정 엔티티에 대한 가이드가 다른 엔티티의 지식 접근성을 높였으며, 시각적 생성 능력이 텍스트 지식 확장으로 이어질 수 있음을 보여주었습니다.
AI 연구
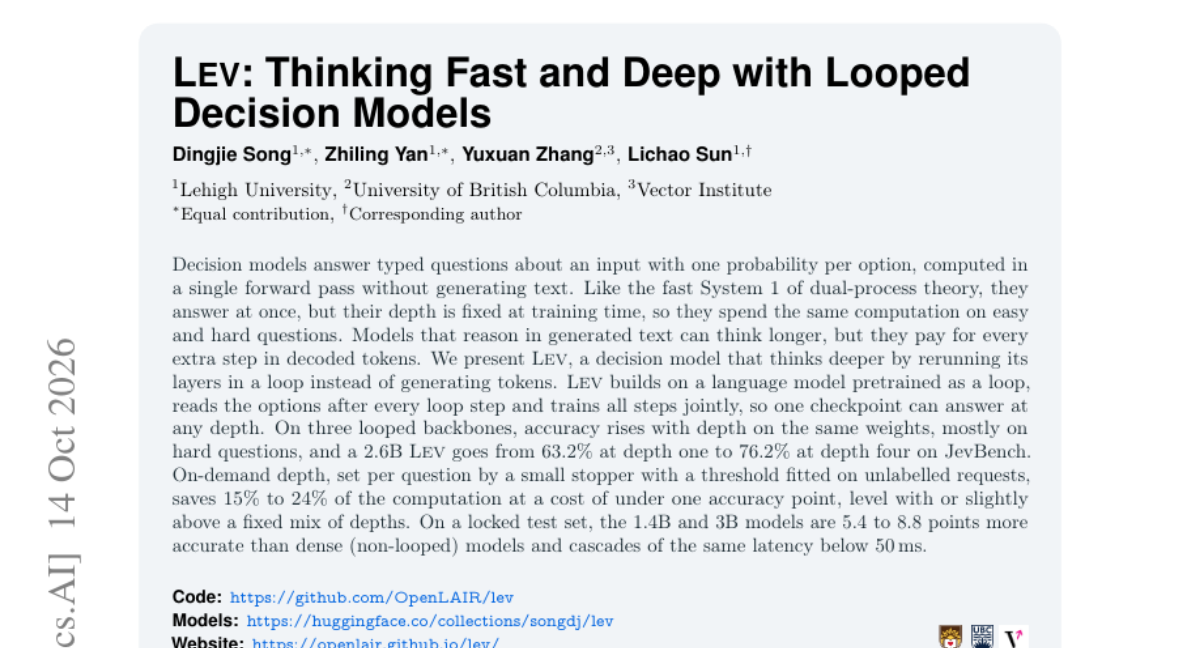
기존의 결정 모델은 단일 패스 방식으로 동작하여 문제 난이도와 상관없이 고정된 연산량만 소비하는 한계가 있었습니다. 텍스트 생성 방식의 추론 모델은 사고 시간을 늘릴 수 있지만 토큰 생성 비용이 발생한다는 단점이 있습니다. 본 논문은 레이어를 루프로 재실행하여 토큰 생성 없이 추리 깊이를 높이는 LEV 모델을 제안합니다. 사전 학습된 언어 모델을 루프 구조로 변형하고, 매 단계에서 옵션을 읽으며 모든 단계를 공동 학습하여 하나의 체크포인트로 다양한 깊이를 구현했습니다. 실험 결과, LEV는 고정된 연산량 대비 정확도가 크게 향상되었으며, 난이도에 따른 온디맨드 깊이 조절을 통해 효율적인 추론이 가능함을 입증했습니다.
AI 연구
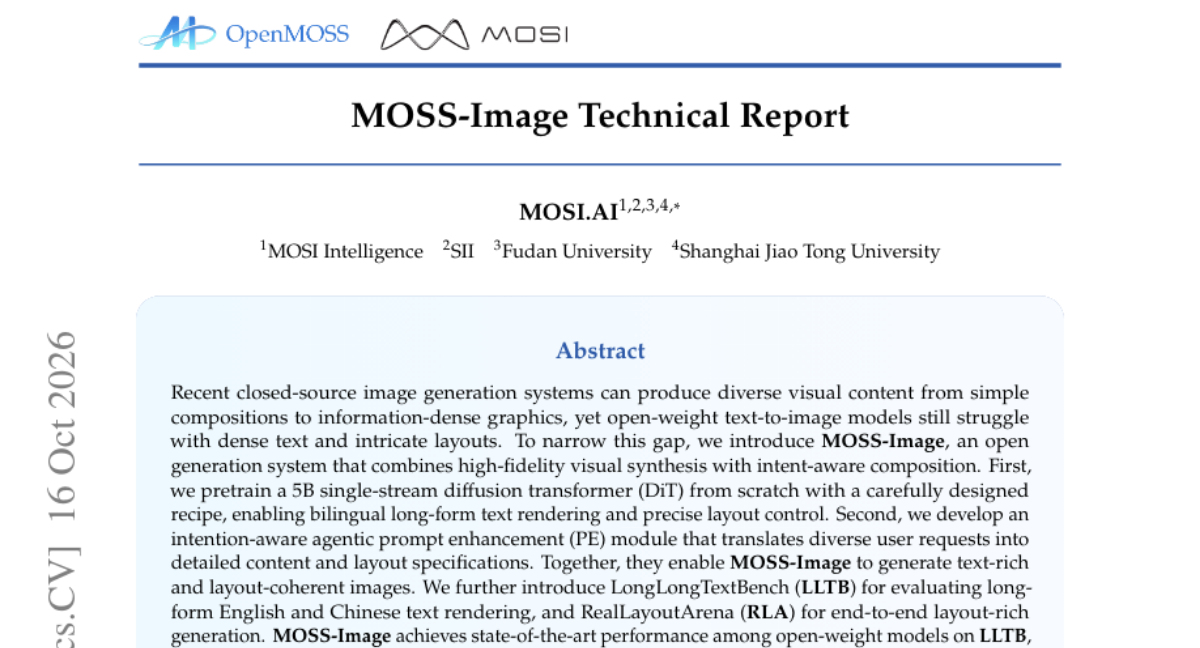
최근 폐쇄형 모델은 뛰어난 이미지 생성 능력을 보여주지만, 오픈 웨이트 모델은 복잡한 레이아웃과 텍스트 렌더링에서 한계를 보입니다. 이를 해결하기 위해 고정밀 시각 합성 및 의도 인지 구성을 결합한 MOSS-Image를 제안합니다. 5B 파라미터 규모의 단일 스트림 Diffusion Transformer(DiT)를 사전 학습하여 이중 언어 텍스트와 정밀한 레이아웃 제어를 가능하게 했습니다. 또한, 사용자 요청을 상세한 콘텐츠 및 레이아웃 사양으로 변환하는 의도 인지 에이전트 프롬프트 강화(PE) 모듈을 개발했습니다. 결과적으로 MOSS-Image는 텍스트 밀도가 높은 이미지 생성에서 SOTA 성능을 달성하며, 모델과 학습 레시피를 공개할 예정입니다.
AI 연구
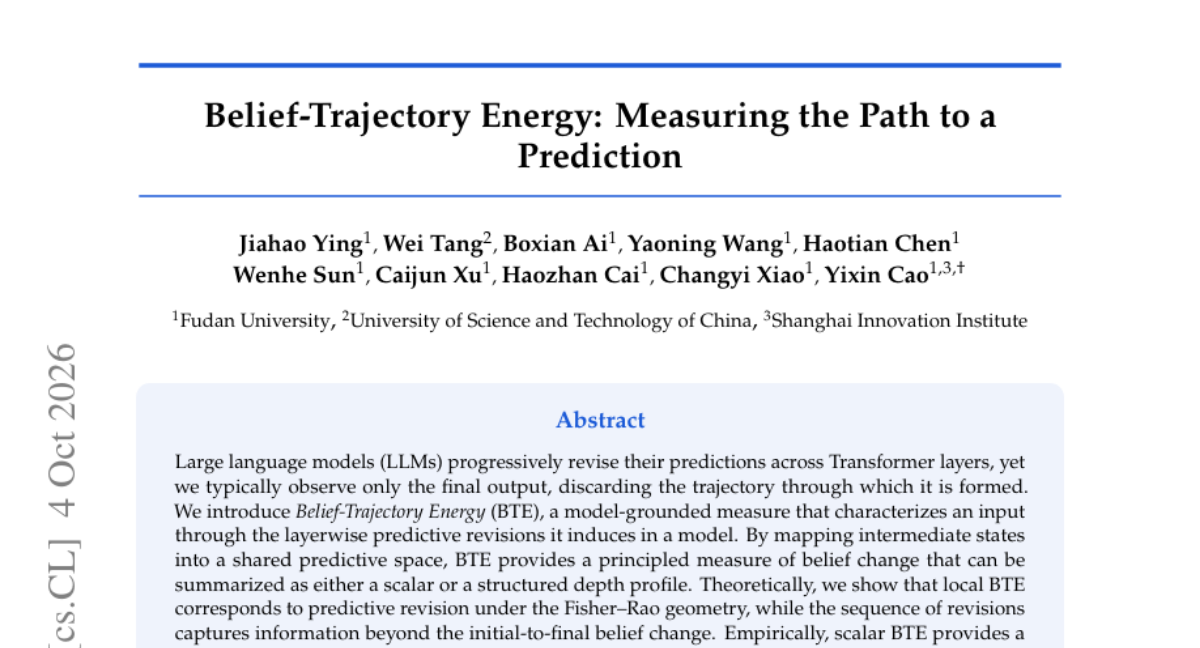
LLM은 레이어를 거치며 예측을 점진적으로 수정하지만, 기존에는 최종 출력값만 관찰할 뿐 그 과정인 궤적(trajectory)은 무시되어 왔습니다. 본 논문은 입력 데이터가 모델 내부에서 유도하는 레이어별 예측 수정 과정을 통해 입력을 특성화하는 'Belief-Trajectory Energy(BTE)'를 도입합니다. BTE는 중간 상태를 공유된 예측 공간으로 매핑하여 신념 변화를 스칼라 또는 구조화된 깊이 프로필로 요약합니다. 이론적으로 BTE는 Fisher-Rao 기하학 하에서의 예측 수정과 대응되며, 단순한 최종 결과 이상의 정보를 포착합니다. 실험 결과, BTE는 추론 작업의 난이도 측정뿐만 아니라 인간-LLM 리뷰 탐지 및 생성자 식별에서 매우 높은 정확도를 달성했습니다.
AI 연구
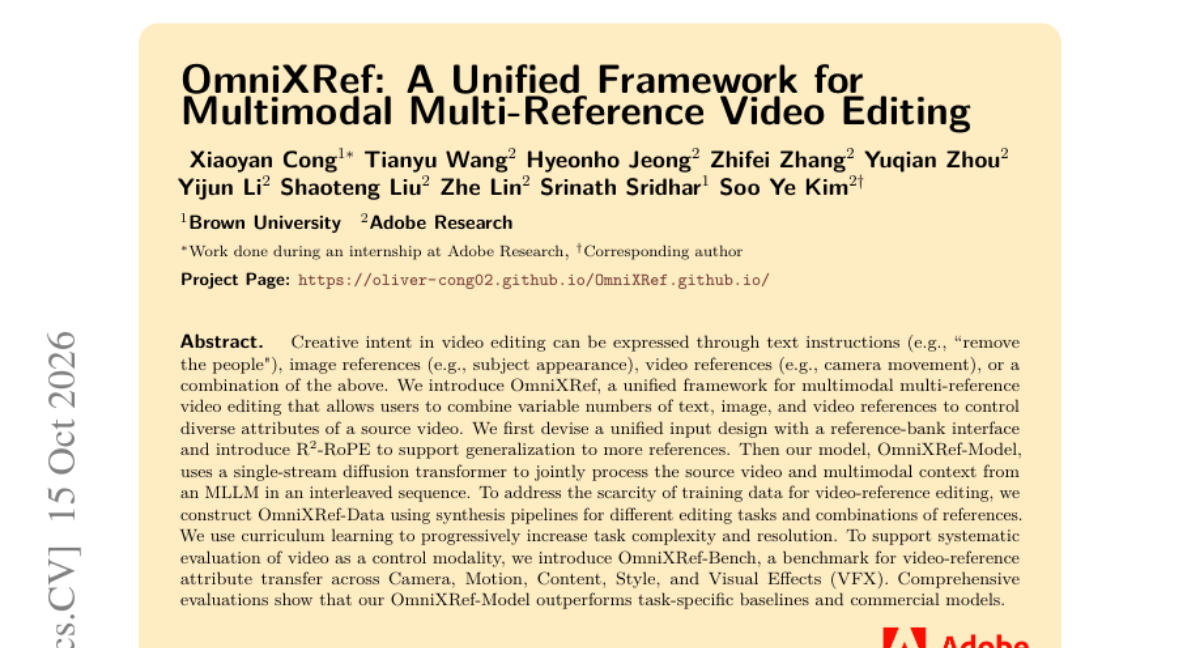
기존 비디오 편집은 텍스트, 이미지, 비디오 등 다양한 형태의 참조를 동시에 결합하여 제어하는 데 어려움이 있었습니다. 이를 해결하기 위해 다양한 수의 참조를 수용할 수 있는 통합 입력 설계와 R^2-RoPE 기술을 제안합니다. OmniXRef-Model은 단일 스트림 디퓨전 트랜스포머를 사용하여 소스 비디오와 MLLM으로부터 추출된 멀티모달 컨텍스트를 인터리브된 시퀀스로 처리합니다. 데이터 부족 문제를 해결하기 위해 합성 파이프라인을 통한 OmniXRef-Data를 구축하고 커리큘럼 학습을 적용했습니다. 결과적으로 제안된 모델은 카메라 움직임, 스타일, VFX 등 다양한 속도 전이 작업에서 기존 모델들을 상회하는 성능을 보였습니다.
AI 연구
멀티모달 검색 시스템에서 객체와 속성을 정확히 연결하는 결합(Binding) 능력은 필수적이지만, 기존 벤치마크는 복잡한 시나리오를 충분히 반영하지 못합니다. 본 논문은 다양한 모달리티 쌍과 복잡한 객체 구성을 포함하는 새로운 벤치마크인 SABER를 제안합니다. 연구 결과, 기존 CLIP 및 MLLM 기반 임베더들이 속성 결합 문제에 취약함을 확인했습니다. 이를 해결하기 위해 이미지 없이 오직 합성된 텍스트 데이터만을 사용하여 MLLM 기반 임베더를 미세 조정하는 방식을 제안합니다. 실험 결과, 이미지 학습 없이도 속성 결합 능력이 크게 향상되었으며 이는 다른 모달리티 간 검색 성능으로도 전이되었습니다.
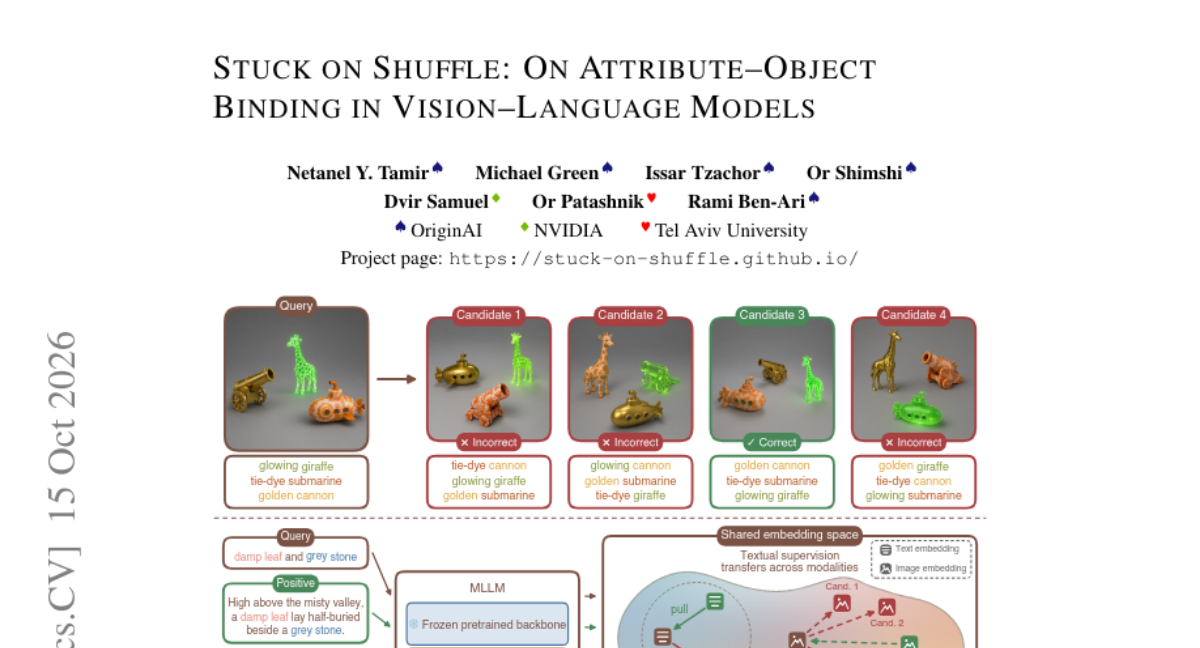
AI 연구
과학적 발견 과정에서 가치 있는 가설을 개발하고 이를 연구 프로세스로 학습하는 것은 매우 어려운 과제입니다. 본 논문은 증거 기반의 주장과 실행 가능한 조사 방식을 결합한 가설의 운영적 정의를 제안합니다. 이를 위해 멀티 에이전트 진화 탐색을 통해 가설 트리를 구축하고, Harbor 태스크를 통해 조사를 실행하며, 신용 최적화, 하네스 리플레이, 재발견이라는 세 가지 메커니즘을 통해 재귀적으로 학습하는 DiscoveryRSI 프레임워크를 도입합니다. 또한 가설 품질과 연구 진척도를 종합적으로 평가할 수 있는 DFM-Bench를 함께 제안합니다. 실험 결과, 생명 과학 분야에서 가설의 품질과 반증 가능성이 크게 향상되었으며, 기존 LLM 모델들보다 높은 가설 중요도와 근거 기반의 신뢰도를 기록했습니다.
AI 연구
LLM 에이전트가 자율적인 연구를 수행하려면 단순한 실험 수행을 넘어 과학적 판단력이 필수적입니다. 그러나 연구 결정은 맥락 의존적이고 개방적이라 평가가 매우 어렵습니다. 본 논문은 6개월간의 실제 연구 기록과 전문가의 개입 사례를 바탕으로 248개의 사례로 구성된 SciΠsot 벤치마크를 구축했습니다. 실험 결과, 최첨단 모델들은 프로젝트 기록이 주어졌을 때 오히려 인간의 수정안보다 원래의 LLM 계획을 선택하는 경향을 보였습니다. 결과적으로 현존하는 모델들은 과학적 판단 영역에서 인간 연구자의 성능에 미치지 못하며, 특히 맥락이 주어졌을 때 성능이 저하되는 양상을 보였습니다.
AI 연구
기존의 온폴리시 증류(OPD)는 학생 모델이 생성한 접두사를 활용하지만, 감독이 출력 공간에만 국한되어 중간 연산 과정의 지식 전수가 어렵다는 문제가 있었습니다. 단순히 중간 표현을 일치시키는 방식은 교사와 학생 간의 기하학적 차이로 인해 효과가 제한적이었습니다. 본 논문은 교사의 표현을 학생의 연산에 적합하도록 변환하는 '학생 호환형 교사(student-compatible teacher)'를 구축하는 OPMD를 제안합니다. OPM써는 온폴리시 궤적에서 이러한 변환된 상태를 내재화함으로써 중간 메커니즘을 효과적으로 전수합니다. 실험 결과, OPMD는 다양한 설정에서 기존 베이스라인을 상회하는 성능을 보였으며 추론 능력과 해결 전략에서도 우수한 일반화 성능을 입증했습니다.
AI 연구
기존의 데스크톱 자동화는 시각적 GUI 조작과 프로그래밍적 코드 실행 사이의 조율이 어려워 단순한 툴 조합만으로는 성능 향상에 한계가 있었습니다. 본 논문은 GUI 액션과 코드 실행을 단일 액션 공간으로 통합한 end-to-end 멀티모달 에이전트인 OS-Helix를 제안합니다. 이를 위해 애플리케이션과 파일 아티팩트를 결합한 데이터 생성 방식과 검증 가능한 환경 기반 태스크 생성 파이프라인을 도입했습니다. 학습 과정에서는 SFT로 콜드 스타트를 수행한 후, 긴 코드 실행이 최적화를 방해하지 않도록 설계된 Step-balanced GSPO 알고리즘을 통해 온라인 RL을 진행했습니다. 실험 결과, OS-Helix는 기존 하이브리드 베이스라인 대비 대폭 향상된 성공률을 기록하며 GUI와 코드 간의 효과적인 협업 능력을 입증했습니다.
AI 연구
기존의 Looped 언어 모델은 재귀적 구조, 입력 주입 방식, 순환 상태 설계가 서로 복잡하게 얽혀 있어 최적의 설계 원칙을 찾기 어려웠습니다. 본 연구는 파라미터 규모와 논리적 깊이, 토큰 예산을 동일하게 맞춘 상태에서 각 설계 축을 분리하여 실험했습니다. 실험 결과, 'prelude-recurrent block-coda' 샌드위치 구조가 추론 및 문맥 추출 작업에서 가장 우수한 성능을 보였습니다. 또한 입력 주입 방식은 지식 검색과 문맥 활용 능력을 향상시키는 데 핵심적인 역할을 함을 확인했습니다. 최종적으로 제안된 Huginn 아키텍처는 MoE 모델로 확장 시에도 우수한 성능과 효율적인 전문가 라우팅을 보여주었습니다.
AI 연구
AI의 자율적 발견(Discovery) 과정에서 실제 환경의 높은 평가 비용은 탐색 규모를 제한하는 핵심 병목 현상입니다. 기존 방식은 단일 평가에 수 시간이 소요되어 탐색 횟수가 극히 제한되는 문제를 겪습니다. 이를 해결하기 위해 DuoDiscover는 최적화 대상과 효율적인 대리 평가기(Yardstick)를 동시에 찾아내는 시스템을 제안합니다. 에이전트가 직접 맞춤형 Yardstick을 만들고, 피델리티 테스트를 통해 평가 정확도를 유지하며, 중앙 통제 없이 분산된 방식으로 작업을 수행합니다. 실험 결과, 소프트웨어 엔진 최적화부터 칩 아키텍처 설계에 이르기까지 인간 전문가와 기존 자동화 도구를 뛰어넘는 성능을 입증했습니다.
AI 연구
최근 오디오-비디오 생성 모델이 복잡한 멀티 이벤트와 비대칭적 관계를 생성함에 따라, 기존의 단순한 전체 단위 평가 방식은 한계에 직면했습니다. 기존 지표들은 단순한 관계에 의존하여 복잡한 장면의 일관성을 정확히 측정하지 못하는 문제가 있었습니다. 이를 해결하기 위해 본 논문은 이벤트를 개별적으로 분리하고 교차 검증하는 이벤트 중심의 평가 프레임워크를 제안합니다. 제안된 AVC-Reward는 전역적 서사 조화, 이벤트별 시간적 동기화, 세부 속성 정렬을 아우르는 3단계 일관성 지표를 제공합니다. 실험 결과, AVC-Reward는 인간의 판단과 가장 유사한 성능을 보였으며, 강화학습 신호로 사용 시 생성 모델의 일관성을 크게 향상시켰습니다.
AI 연구
LLM 기반 멀티 에이전트 시스템(MAS)의 성능은 에이전트 간의 협업 구조인 토폴로지에 크게 의존합니다. 기존 방식은 실행 결과가 검증된 그래프를 학습하지만, 특정 쿼리에 대해 어떤 구조가 더 우수한지에 대한 선호도(Preference) 정보를 활용하지 못해 특정 작업에 편향되는 문제가 있었습니다. 이를 해결하기 위해 PRISM은 학습 시에만 존재하는 '특권 정보(Privileged Information)'를 활용하는 방식을 제안합니다. 교사 모델은 배포 시에는 사용할 수 없는 다른 성공적인 그래프(Sibling graph)를 참조하여 학습하고, 학생 모델은 이를 따라 하도록 학습됩니다. 실험 결과, PRISM은 다양한 벤치마크에서 기존 토폴로지 설계 베이스라인들을 상회하는 성능을 보였습니다.
AI 연구
LLM 기반 멀티 에이전트 시스템의 신뢰성 있는 배포를 위해서는 실행 과정 중 실패를 예측하는 런타임 감사(Auditor)가 필수적입니다. 그러나 검증된 실행 궤적 데이터를 확보하는 데는 막대한 비용과 시간이 소요되며, 단순히 데이터 양을 늘리는 것만으로는 모델이 어려워하는 사례를 식별하기 어렵습니다. 이를 해결하기 위해 본 논문은 예측 손실(Loss)을 가이드로 삼아 암시적 증강을 수행하는 Dream2Discern 프레임워크를 제안합니다. Dream 단계에서는 모델의 표현 연산자를 변형하여 예측 손실을 높이는 '어려운 잠재 변형(Hard Latent Variants)'을 생성하고, Discern 단계에서는 이 변형된 데이터로부터 원래의 레이블을 예측하도록 학습합니다. 이 과정을 반복함으로써 추가적인 데이터 수집 없이도 한정된 코퍼스를 지속 가능한 학습 자원으로 전환합니다. 실험 결과, 제안 기법은 기존 방식보다 우수한 성능을 보였으며 높은 정확도와 실시간성을 동시에 달성했습니다.
AI 연구
로봇 학습의 일반 지능 확보를 위해 다양한 환경에서의 스케일링이 필요하지만, 기존 정책은 고정된 파라미터를 공유하여 서로 다른 작업 간의 충돌이 발생합니다. 연구진은 서로 다른 작업의 업데이트 방향이 상충하여 개별 작업의 성능이 저하되는 문제를 확인했습니다. 이를 해결하기 위해 문맥에 따라 파라미터를 동적으로 조정하는 MorphAct 프레임워크를 제안합니다. 두 개의 결합된 생성기가 시각-언어 및 액션 모듈에 대해 문맥 의존적인 저차원 업데이트를 생성하며, 시각-언어 업데이트가 액션 생성을 조건화하는 구조를 가집니다. 실험 결과 LIBERO, Meta-World 및 실세계 환경에서 기존 방식 대비 유의미한 성능 향상을 달립했습니다.
AI 연구
기존의 웹 생성 벤치마크는 고정된 명세에 맞춘 개발 능력만을 평가하여, 실제 개발처럼 점진적으로 기능이 확장되는 과정을 반영하지 못합니다. 이를 해결하기 위해 32개의 웹 애플리케이션과 320개의 누적 요청으로 구성된 EvoWeb 벤치마크를 도입합니다. 에이전트는 기존 코드를 반복적으로 수정하며, 멀티모달 에이전트가 브라우저를 통해 기능 통합 및 회귀 테스트를 수행합니다. 실험 결과, 모델 간 성능 차이가 뚜렷하게 나타났으며 특히 이전 기능과의 통합(cross-request integration)이 주요 과제로 확인되었습니다. 또한 요청이 진행될수록 의존성이 깊어짐에 따라 정확도가 낮아지고 런타임 오류가 증가하는 경향을 보였습니다.
AI 연구
사용자의 연속적인 지시에 따라 이미지를 수정하는 멀티턴 편집은 인간과의 협업에 필수적이지만, 기존의 순차적 롤아웃 방식은 단계가 거듭될수록 오류가 누적되고 화질이 저하되는 문제가 있었습니다. 이를 해결하기 위해 본 논문은 'Packed Trajectory Canvas(PTC)' 생성 파이프라인을 중심으로 한 멀티턴 데이터셋인 MTEdit를 제안합니다. MTEdit는 여러 편집 상태를 하나의 통합된 시각적 컨텍스트 내에서 동시에 생성하여 화질 저하를 방지하며, 총 50만 개의 고품질 편집 궤적을 포함합니다. 또한 모델의 지시 이행, 일관성 유지, 컨텍스트 활용 능력을 평가하기 위한 벤치마크인 MTEdit-Bench를 함께 도입했습니다. 실험 결과, MTEdit로 파인튜닝된 Qwen-Image-MTEdit가 오픈소스 모델 중 최고 성능을 기록하며 데이터셋의 효과를 입증했습니다.
AI 연구
소형 언어 모델(SLM)에서 임베딩 테이블은 모델 파라미터의 상당 부분을 차지하며 압축 시에도 용량 최적화의 병목이 됩니다. 본 연구는 학습 가능한 임베딩 대신 사전 학습된 임베딩에서 추출한 512비트 코드 기반의 16MB 고정 테이블을 제안합니다. 이 테이블은 학습 파라미터 없이 주성분 투영과 부호 이진화를 통해 생성되었습니다. 실험 결과, 제안된 방식은 학습 파라미터를 대폭 줄이면서도 주요 벤치마크에서 기존 모델과 대등하거나 더 나은 성능을 보였습니다. 특히 BitNet과 결합 시 극도로 작은 메모리 점유율과 압도적인 추론 속도를 달성했습니다.
AI 연구
최근 소프트웨어 엔지니어링(SWE) 에이전트는 RL을 통해 학습되지만, 기존 방식은 실패한 시도의 진단 정보를 다음 시도에 활용하지 못하는 한계가 있습니다. 또한 실패한 경로를 복구 경로로 연결하여 학습하는 과정에서 보상 체계와 샘플링 방식의 불균형 문제가 발생합니다. 이를 해결하기 위해 실패한 패치와 검증 피드백을 복구 시도의 컨텍스트로 사용하는 FC-SWE 프레임워크를 제안합니다. FC-SWE는 개별 시도의 보상을 보존하는 Trajectory-local rewards와 실행된 시도들만 비교 그룹에 포함하는 Active-set advantage estimation 메커니즘을 도입합니다. 실험 결과, FC-SWE는 SWE-bench Verified 벤치마크에서 기존 GRPO 대비 높은 해결 성능을 기록하며 복구 시도의 효율성을 입증했습니다.
AI 연구
기존 Transformer는 고정된 잔차 연결(residual connections) 구조를 사용하여 모델의 잠재적 연결 효율을 충분히 활용하지 못합니다. 기존의 라우팅 방식은 레이어별로 개별적인 연결을 설정하는 한계가 있었습니다. 본 논문은 모델 전체의 토폴로지를 한 번에 계획하는 DAGFormer를 제안합니다. DAGFormer는 입력 토큰에 따라 이전 레이어에서 이후 레이어로의 직접적인 연결 강도를 조절하는 토폴로지 예측기를 도입합니다. 실험 결과, 동일 파라미터 대비 낮은 퍼플렉시티(perplexity)를 달성했으며, 적은 학습 데이터로도 더 높은 성능을 보여주었습니다. 또한 구조적 프루닝(structured pruning) 상황에서도 성능 저하가 적어 모델 압축 및 효율성 측면에서 우수함을 입증했습니다.
AI 연구
장기 작업(Long-horizon)을 수행하는 에이전트는 과거의 특정 시점에서 발생한 실패 원인을 해결하지 못해 작업 전체가 실패하는 문제를 겪습니다. 이를 해결하기 위해 연구진은 과거의 증거를 유지하면서 미래의 복구 방향을 예측하는 BELIEFWEAVER 프레임워크를 제안합니다. 이 프레임워크는 관계형 신념 상태를 유지하며, 실행 증거를 통해 우선순위를 조정하고 암시적 세계 모델(IWM)을 통해 복구 가설을 평가합니다. 또한, 이러한 추론 과정을 9B 규모의 학생 모델로 증류(Distillation)하여 효율성을 극대화했습니다. 실험 결과, 제안된 방식은 기존 베이스라인 대비 최종 점수를 크게 향상시켰으며, 교사 모델 의존도를 낮추면서도 높은 성능을 유지했습니다.
AI 연구
학술 논문 투고량 증가로 인해 인간과 AI가 작성한 리뷰의 사실 오류 문제가 심각해지고 있습니다. 기존 방식은 LLM이 전체 논문을 읽어야 하므로 비용과 지연 시간이 크거나, 경량 모델은 복잡한 문맥 파악에 한계가 있었습니다. 이를 해결하기 위해 LLM이 리뷰를 명시적 전제로 재작성하고, 경량 모델이 이를 논문과 대조하는 PremiseCheck 프레임워크를 제안합니다. 실험 결과, 이 방식은 GPT-5.5 수준의 정확도를 유지하면서도 비용은 절반 이하, 지연 시간은 대폭 단축하는 성과를 보였습니다.
AI 연구
시각-언어 모델(VLM)의 핵심인 시각적 추론 능력 평가가 주로 실제 데이터나 절차적 생성 작업에 의존하고 있습니다. 하지만 게임과 같은 단순화된 환경에서의 능력이 실제 세계의 추론 능력과 일치하는지, 그리고 게임 학습이 실제 성능 향상으로 이어지는지는 불분명했습니다. 본 논문은 미세 지각, 공간 추론, 제약 추론, 순차적 계획 등 4개 영역을 포함하는 Game2Real-Bench를 제안합니다. 1,000개의 게임 샘플과 400개의 정렬된 실제 샘플을 통해 25개 VLM을 평가한 결과, 게임과 실제 성능 간의 높은 상관관계를 확인했습니다. 또한 게임 예시를 통한 원샷 전이 실험을 통해 제약 추론은 향상되나 미세 지각 능력은 저하될 수 있음을 밝혀냈습니다.
AI 연구
상세 초록은 원문 페이지에서 확인 가능합니다.
AI 연구
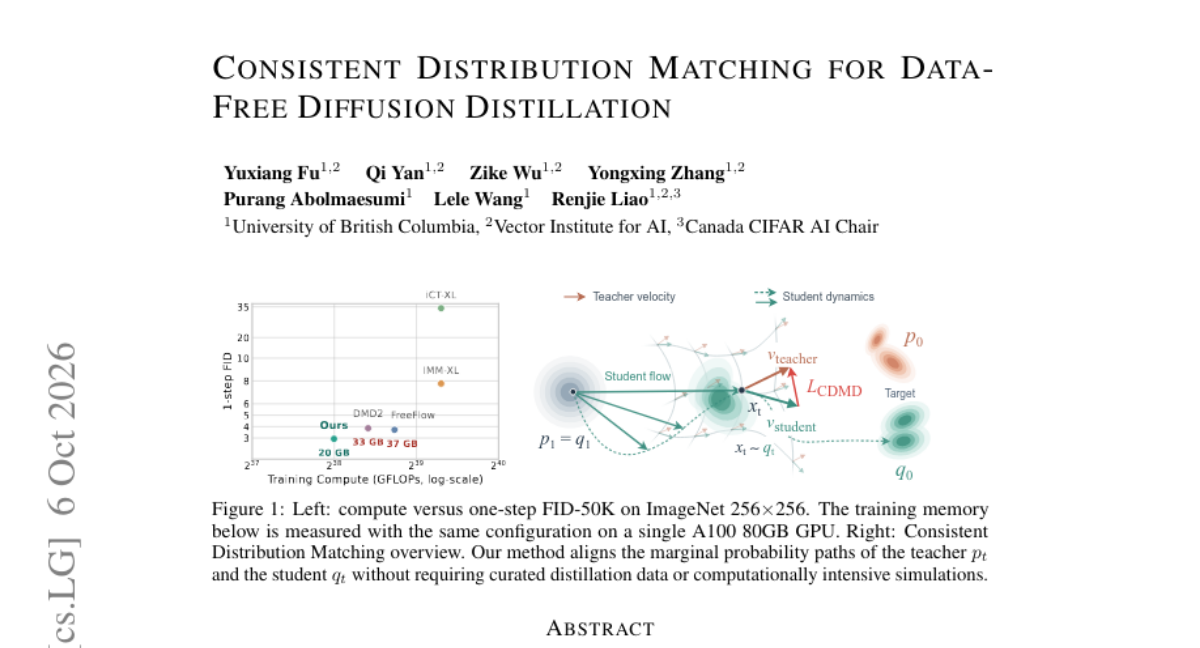
기존의 확산 및 소식(Flow) 모델은 추론 시 수치적 적분 과정이 필요하여 속도가 느리다는 단점이 있습니다. 기존의 증류 방식은 정제된 데이터셋이나 복잡한 보조 네트워크를 필요로 하여 확장성이 떨어지는 문제가 있었습니다. 본 논문에서는 데이터 없이도 강력한 생성 능력을 유지하며 모델을 가속화하는 'Consistent Distribution Matching' 방식을 제안합니다. 제안된 프레임워크는 고정된 교사(Teacher)와 학습 가능한 학생(Student) 모델만을 사용하여 샘플 생성과 점수 추정을 단일 네트워크로 통합합니다. 실험 결과, ImageNet 데이터셋에서 기존 SOTA를 뛰어넘는 성능을 보이며 단일 단계(1-NFE)에서도 매우 낮은 FID를 달성했습니다.
AI 연구
대규모 저장소를 다루는 코딩 에이전트는 컨텍스트 윈도우 제한 문제를 해결하기 위해 프롬프트 압축이나 검색 기술을 사용합니다. 그러나 기존 방식은 수정이 필요한 파일을 놓치거나, 코드를 압축하는 과정에서 원본 텍스트를 변형하여 패치 적용을 어렵게 만듭니다. 본 논문은 동일한 토큰 예산 내에서 압축이나 검색 대신 파일 전체를 그대로 보여주는 CQ2-CARE 방식을 제안합니다. SWE-bench 테스트 결과, CQ2-CARE는 기존 압축 및 검색 방식보다 높은 이슈 해결 성공률을 기록했습니다. 이는 정확한 코드 복제와 파일 선택이 에이전트의 문제 해결에 핵심적임을 보여줍니다.
AI 연구
지시 이행 언어 모델이 안전 가이드라인에 반하는 유해한 요청을 수행하는 문제가 발생하고 있습니다. 기존의 프롬프트 기반 제어는 프롬프트 변경 시 무력화될 수 있다는 취약점이 있습니다. 본 논문은 소수의 프롬프트 쌍에 대한 순방향 패스(forward pass)만으로 가중치를 수정하는 학습 불필요(training-free) 방식의 가중치 편집 기법을 제안합니다. 이 방식은 수정 사항이 모델 가중치에 직접 반영되므로 프롬프트 조작을 통한 우회 공격에 강건합니다. 실험 결과, 거짓말 유도 및 성차별적 발언 억제 측면에서 기존 방식보다 우수한 성능을 보였습니다. 결과적으로 이 방식은 프롬프트 기반 안전 장치와 병행하여 효과적인 개입 수단이 될 수 있음을 입증했습니다.
AI 연구
최근 자기 진화형 언어 모델은 생성된 태스크를 통해 스스로 학습하며 모델을 업데이트하는 루프를 사용합니다. 그러나 기존 방식은 학습 가능해 보이는 태스크를 무조건 수용함으로써, 실제 성능 향상에 도움이 되지 않는 업데이트를 상속받는 문제를 야기합니다. 본 논문은 선택과 업데이트 사이의 간극을 식별하고, 이를 해결하기 위해 모델 업데이트 여부를 결정하는 HeirCommit과 경험 상속을 분리하는 EvoHeir 프레임워크를 제안합니다. 실험 결과, 제안된 방식은 무작위 상속 대비 유해한 업데이트를 68-83% 줄였으며 수학 및 일반 추론 성능에서 기존 SOTA를 상회했습니다. 결과적으로 유용한 경험을 보존하면서도 모델의 성능 저하를 방지하는 효율적인 진화 루프를 구축할 수 있습니다.
AI 연구
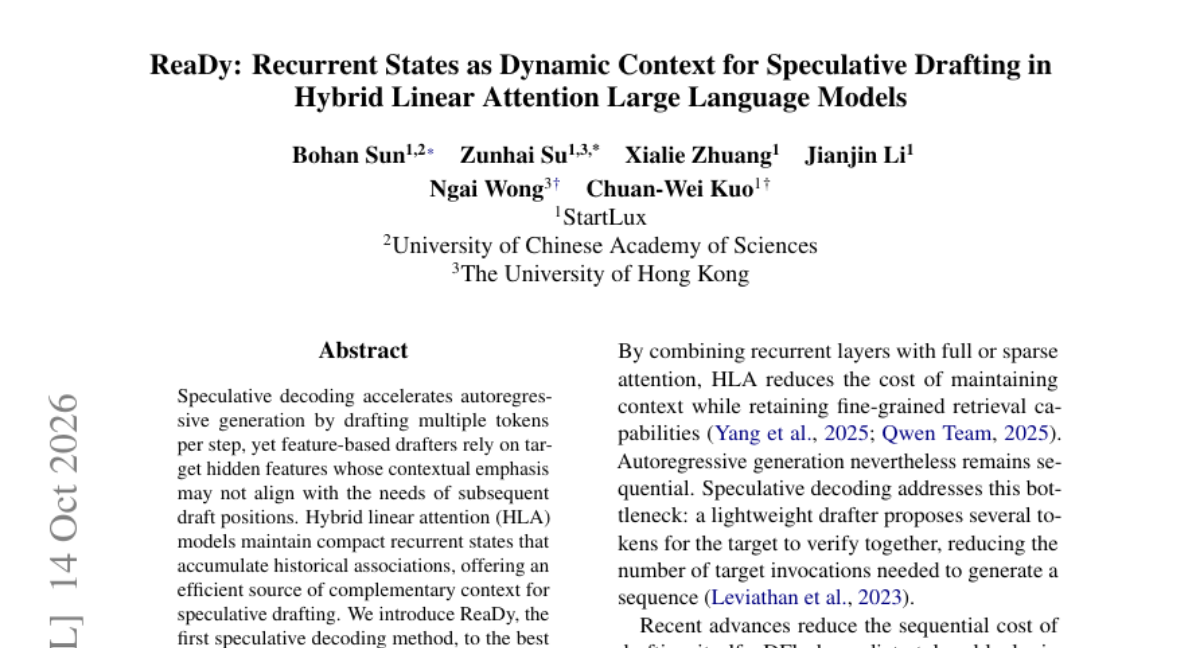
기존의 추측적 디코딩은 타겟 모델의 은닉 특징을 사용하지만, 이는 이후 드래프트 위치의 문맥 요구사항과 일치하지 않을 수 있습니다. 본 논문은 Hybrid Linear Attention(HLA) 모델의 압축된 순환 상태를 활용하여 위치별 맞춤형 문맥을 제공하는 ReaDy를 제안합니다. 각 드래프트 위치에 학습된 쿼리를 부여하여 타겟의 순환 상태에서 보충 문맥을 검색하고, 경량화된 상태 리더(State Reader)를 통해 이를 잔차 업데이트 방식으로 통합합니다. 저차원 상태 읽기 및 융합 연산자를 통해 계산 및 I채널 I/O 오버헤드를 최소화했습니다. 실험 결과, Qwen3.8-27B 모델에서 기존 DSpark 대비 향상된 처리량과 수락 길이를 달리기 쉬운 속도로 달성했습니다.
AI 연구
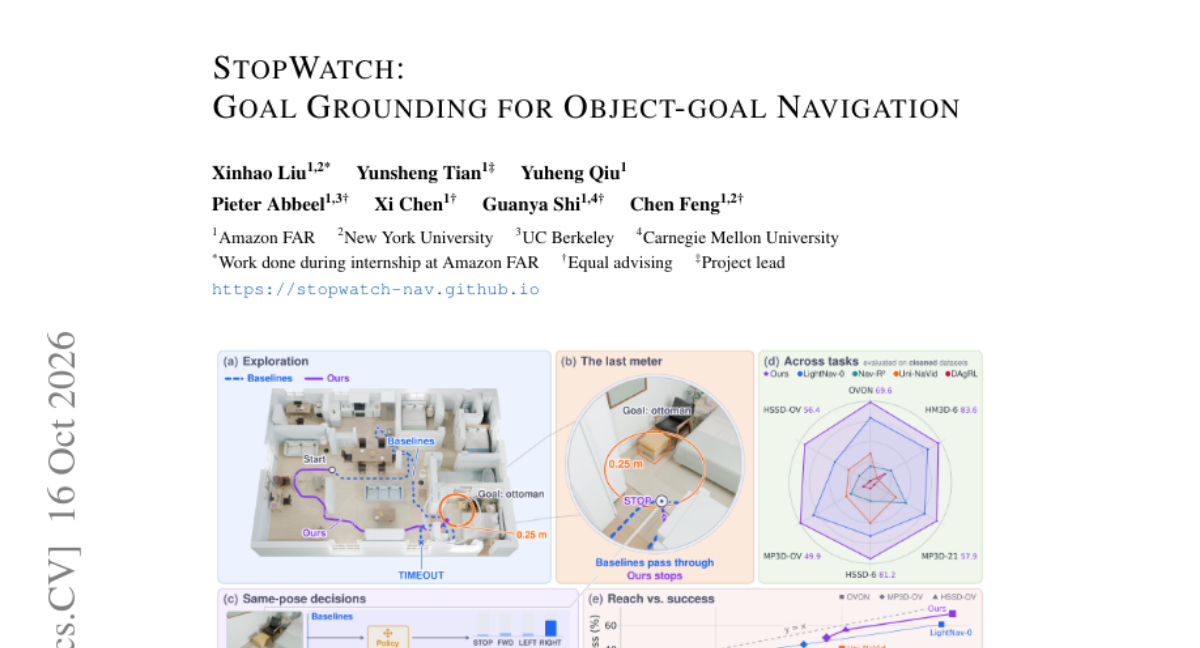
사전 학습된 VLM을 탐색 정책에 미세 조정하는 방식이 대중화되었으나, 여전히 성공률이 낮고 실패 원인이 불분명했습니다. 연구진은 분석을 통해 정책 학습 자체보다 목표 객체를 식별하거나 거리를 추정하는 '목표 접지' 능력이 부족함을 발견했습니다. 이를 해결하기 위해 목표를 명시적으로 접지하는 StopWatch 방식을 제안했습니다. 실험 결과, 제안 방식은 다양한 벤치마크에서 SOTA를 달성했으며 데이터셋의 주석 오류까지 수정하여 평가의 신뢰도를 높였습니다. 결과적으로 목표 접지 능력이 확보되면 정책 학습의 여지가 훨씬 커짐을 입증했습니다.
30건
이날 공개된 제품과 도구




6건
새 모델과 주요 평가 결과
HF Model Trending
OpenBMB에서 공개한 MiniCPM-V-4.7-35B-A3B 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 이미지와 텍스트를 결합하여 처리하는 image-text-to-text 파이프라인을 지원합니다.
HF Model Trending
black-forest-labs/flux-3-image-klein-comfy 모델이 Hugging Face에서 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 image-to-image 파이프라인을 지원하는 것이 특징입니다.
HF Model Trending
DeepSeek-V4.1-Flash-1017 모델이 Hugging Face에서 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 image-text-to-text 파이프라인을 지원하는 멀티모달 성격의 모델입니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.