
NPR
What if an AI bubble bursts — and that accelerates AI job losses? : Planet Money - NPR
AI 산업의 과잉 투자가 거품(Bubble)으로 판명되어 붕괴할 경우, 기업의 수익성 악화가 오히려 인력 감축을 가속화하는 역설적 상황이 발생할 수 있음을 경고합니다. 기술적 진보가 경제적 가치 창출로 즉각 연결되지 못할 때 발생하는 고용 시장의 변동성을 다룹니다.
지난 소식
이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.
19건
주요 기사와 기업의 공식 발표
NPR
AI 산업의 과잉 투자가 거품(Bubble)으로 판명되어 붕괴할 경우, 기업의 수익성 악화가 오히려 인력 감축을 가속화하는 역설적 상황이 발생할 수 있음을 경고합니다. 기술적 진보가 경제적 가치 창출로 즉각 연결되지 못할 때 발생하는 고용 시장의 변동성을 다룹니다.
The New York Times
AI가 설계한 맞춤형 바이러스를 활용해 환자 치료를 시도한 스타트업의 사례를 통해, 생성형 AI가 생명공학 및 정밀 의료 분야에 가져올 혁신과 윤리적 쟁점을 다룹니다.
WIRED
인터넷 연구자 협회(AoIR)의 메일링 리스트에 AI Agent인 'Velvet Vale'가 정체를 밝히며 등장하자, 학계 연구자들이 데이터 스크래핑 및 윤리적 문제를 제기하며 거센 반발이 일어난 사건을 다룹니다. 이 사건은 AI 학습 데이터로서의 공개적 기록물에 대한 '동의(Consent)'의 개념과 AI Agent의 커뮤니티 참여 가능성에 대한 철학적·기술적 논쟁을 촉발했습니다.
Reuters
AstraZeneca가 Oracle과 협력하여 AI 기반의 임상 시험 프로세스를 혁신하기 위한 전략적 파트너십을 체결했습니다. 이번 협업은 Oracle의 클라우드 인프라와 AI 기술을 활용하여 임상 데이터 관리 및 분석의 효율성을 극대화하는 데 중점을 둡니다.
Axios
AI Agent가 인간의 개입 없이 스스로 목표를 설정하고 실행하는 '자율적 의사결정' 실험의 가능성과 위험성을 다룹니다. 단순한 질의응답을 넘어, 복잡한 워크플로우를 스스로 설계하는 Autonomous Agent 기술의 진화 방향을 조명합니다.
AstraZeneca
AstraZeneca와 Oracle이 임상 시험 최적화 및 환자 케어 워크플로우 혁신을 위한 글로벌 AI 협업을 발표했습니다. 양사의 과학적 전문성과 클라우드 기반 AI 인프라를 결합하여 질병 진단부터 약물 안전성 모니터링까지 임상 연구의 전 과정을 가속화하는 것이 목표입니다.
The Guardian
AI 생성 배우 기술이 실사 영화 제작 공정을 혁신하며 할리우드의 전통적인 연기 개념을 위협하고 있습니다. 현재의 기술은 감정의 깊이보다는 시각적 재현에 치중되어 있으나, 생성형 비디오 모델의 발전으로 제작 기간 단축과 비용 절감이 가속화되고 있습니다.
TechCrunch
AI 회의 기록 도구인 Otter.ai가 General Catalyst의 Customer Value Fund(CVF)로부터 3억 2,000만 달러 규모의 투자를 유치하며 기업용 시장 확장을 본격화합니다. 이번 투자는 지분 희석 없이 마케팅 성과에 기반해 자본을 공급하는 방식으로, Otter.ai는 이를 통해 글로벌 확장과 제품 혁신에 집중할 계획입니다.
OpenAI
OpenAI가 생물학적 데이터 분석 및 신약 개발 분야의 전문성을 강화하기 위해 Orchestra Bio를 인수했습니다. 이번 인수는 LLM 기술을 생명과학 연구 워크플로우에 통합하여 데이터 기반의 생물학적 발견 속도를 가속화하는 데 목적이 있습니다.
Whitman College
리버럴 아츠 교육(Liberal Arts Education)의 가치와 생성형 AI 기술이 만나는 지점에서, 기술적 숙련도를 넘어선 비판적 사고와 인간 중심적 역량의 중요성을 다룹니다. AI가 지식 습득의 효율성을 높이는 도구로 활용되는 동시에, 인간 고유의 판단력과 윤리적 책임감을 어떻게 유지할 것인지에 대한 교육적 담론을 제시합니다.
Google DeepMind
Google DeepMind가 최신 프론티어 모델인 Gemini 4 Argon을 공개했습니다. 이 모델은 개발자, 기업, 과학자 및 일반 소비자들이 직면한 가장 어려운 문제들을 해결하기 위해 설계되었습니다.
Google DeepMind
Google DeepMind가 새로운 항균 펩타이드 탐색을 위한 에이전트 기반 과학 워크벤치인 Google Antigravity를 공개했습니다. 이 시스템은 새로운 항균 펩타이드를 발견하고 구조적으로 평가하며 우선순위를 정하는 과정을 단 몇 시간 만에 수행할 수 있도록 지원합니다.
Google DeepMind
Google DeepMind와 GovTech Singapore가 협력하여 대화형 사기 탐지를 위한 미세 조정된 AI 모델을 구축했습니다. 이 프로젝트는 가벼운 온디바이스 Gemma 모델을 활용하여 클라우드 데이터 유출 없이 개인 채팅 내 사기 시도를 차단하는 것을 목표로 합니다.
Google Cloud AI
Google Cloud가 오픈 에코시스템 구축과 개발자 선택권 확대를 위해 Claude Opus 5.5 및 Claude Sonnet 5.5를 Google Antigravity에 출시했습니다. 이를 통해 개발자들은 작업 목적에 맞는 적절한 모델을 선택하여 사용할 수 있습니다.
Google Cloud AI
Google Cloud가 정부 기관을 위한 Gemini for government services 프리뷰 버전을 출시했습니다. 이 서비스는 거버넌스가 내장된 환경에서 정부 기관에 필요한 기술, 커넥터 및 파트너 에이전트를 제공합니다.
OpenAI News
Schlotzsky’s와 Cinnabon의 독립 가맹점 운영자가 ChatGPT Work를 활용하여 메뉴 가격 책정 시간을 95% 단축했습니다. 이를 통해 현금 내용을 확보할 수 있는 워크플로우를 구축하여 운영 효율성을 극대화했습니다.
OpenAI News
OpenAI가 저자원 프로그래밍 언어에서의 코딩 능력을 향상시키기 위한 새로운 연구 결과를 발표했습니다. 소프트웨어 엔지니어링, SQLite, COBOL 마이그레이션 분야를 포함한 새로운 평가 방식을 통해 ChatGPT의 성능을 개선하는 방법을 다룹니다.
Google Cloud AI
Google이 IDC MarketScape의 'Worldwide Agentic AI Platforms 2026 Vendor Assessment'에서 Leader로 선정되었습니다. Gemini를 기반으로 한 연결된 인프라가 이번 평가의 핵심 요인으로 작용했습니다.
OpenAI News
브라질의 금융 기업 Itaú가 대화형 인터페이스인 ia.i와 거버넌스 플랫폼 IARA를 통해 생성형 AI를 구축하고 있습니다. 이를 통해 규제가 엄격한 금융 환경 속에서 고객과 직원 모두를 대상으로 'AI First' 전략을 실행하고 있습니다.
24건
Hacker News, GeekNews, Reddit 반응
Hacker News
DeepSeek 모델의 대규모 프로덕션 서비스를 위해 개발된 고성능 추론 프레임워크인 DeepInfer가 오픈 소스로 공개되었습니다. 이 프레임워크는 최적화된 커널과 비동기 스케줄링을 통해 대규모 추론 환경에서 높은 처리량과 낮은 지연 시간을 동시에 달현하는 것을 목표로 합니다.
Hacker News
테슬라가 공개한 새로운 로드스터 모델의 기술적 성능과 그에 따른 커뮤니티의 열띤 논쟁을 다룹니다. 고성능 차량에 로켓 엔진과 팬을 통합한 엔지니어링 성과와 실용성 사이의 간극이 핵심 쟁점입니다.
Hacker News
NIST의 ECDSA 타원 곡선 생성에 사용된 '시드(seed)' 값의 출처가 Claude를 통해 밝혀지며 오랜 암호학적 미스터리가 해소되었습니다. 이번 발견은 보안 표준의 투명성과 생성 알고리즘의 근거를 확인하는 중요한 계기가 되었습니다.
Hacker News
DeepSeek-v4.1-Flash 모델 출시로 추론, 코딩, 에이전트 작업 성능이 대폭 향상되었으며 비용 효율성까지 확보했습니다. 커뮤니티에서는 벤치마크 점수보다 실제 체감 성능이 뛰어나다는 점과 모델 생태계의 다양성 측면에서 긍정적인 반응이 나오고 있습니다.
Hacker News
WhatsApp의 고객 지원 페이지에 숨겨진 LLM 지침이 사용자 권리 행사를 방해하려 했다는 의혹이 제기되었습니다. 커뮤니티에서는 이를 기업의 의도적인 가이드라인 설계로 보는 시각과 단순한 버그로 보는 시각이 대립하고 있습니다.
Hacker News
태양광 발전량이 전 세계적으로 원자력 발전량을 처음으로 추월하며 에너지 시장의 판도가 변화하고 있습니다. 급격한 기술 성장과 설치 속도가 에너지 생산량의 역전을 이끌었습니다.
Hacker News
도메인 등록 대행업체 Namecheap이 사용자의 계정과 도메인을 일방적으로 압류 및 비활성화한 사건에 대한 내용입니다. 커뮤니티에서는 서비스 제공자의 권한 남용과 데이터 백업의 중요성에 대해 논의하고 있습니다.
Hacker News
AI 기술의 발전으로 프로그래밍의 본질적 즐거움이 퇴색될 수 있다는 우려와 이에 대한 개발자들의 반응을 다룹니다. 기술적 숙련도보다 결과물 중심의 환경이 변화하는 과정에서 프로그래밍의 가치를 어떻게 유지할 것인지가 핵심입니다.
Hacker News
Transformer 아키텍처의 핵심 원리를 직관적으로 이해할 수 있는 가이드가 공개되어 주목받고 있습니다. 복잡한 수식 없이도 모델의 구조를 재구성할 수 있다는 점이 기술적 핵심입니다.
Hacker News
단 하나의 모터만을 사용하여 비행이 가능한 드론 제작 기술과 이에 대한 로봇 공학적 관점의 논의를 다룹니다. 제어 공학의 독특한 설계 방식이 가져온 혁신적인 결과물에 대해 커뮤니티가 주목하고 있습니다.
GeekNews / Hada
국가 간 법적 관할권 차이로 인해 규제 기관의 벌금 집행력이 제한될 수 있음을 보여주는 사례입니다. 이는 글로벌 플랫폼에 대한 각국 정부의 규제 집행이 국제법적 충돌로 인해 실효성을 잃을 수 있다는 기술적·법적 시사점을 던집니다.
GeekNews / Hada
Voxtral 3는 음성 인식부터 합성까지의 전 과정을 단일 파이프라인으로 통합하여 지연 시간을 최소화한 것이 기술적 핵심입니다. 이는 단순한 음성 인식을 넘어 실시간 상호작용이 가능한 지능형 음성 에이전트 개발의 효율성을 크게 높일 것으로 전망됩니다.
GeekNews / Hada
tsrs는 기존 TypeScript 컴파일러를 Rust 언어로 재구현하여 개발 도구의 성능을 극대화하려는 시도입니다. 이는 대규모 프로젝트에서 타입 검사 속도를 높여 개발 생산성을 개선하는 데 기술적 본질이 있습니다.
GeekNews / Hada
Tor 네트워크의 신뢰를 기반으로 하는 출구 노드 대규모 감염을 통해 SSH 트래픽 탈취가 이루어진 보안 사고입니다. 이는 익명 네트워크 환경에서도 종단 간 암호화가 완벽하지 않을 경우 데이터 노출 위험이 있음을 시사합니다.
GeekNews / Hada
신뢰할 수 있는 루트 인증서와 연결된 중간 CA의 개인 키 유출은 광범위한 디지털 신뢰 체인을 무너뜨릴 수 있는 심각한 보안 결함입니다. 이번 사고는 인증서 체인의 상위 계층이 탈취될 경우 전 세계 사용자의 브라우저 환경에 즉각적인 위협이 될 수 있음을 시사합니다.
GeekNews / Hada
LLM이 웹상의 허위 정보를 학습하거나 인용함으로써 발생하는 데이터 오염과 새로운 형태의 트래픽 유입 경로를 보여주는 사례입니다. 검색 엔진 중심의 SEO에서 LLM 답변 중심의 인용 구조로 변화하는 과정에서 정보의 신뢰성 검증이 핵심 과제로 떠오르고 있습니다.
GeekNews / Hada
플랫폼이 외부 링크를 제한하고 과금하는 것은 사용자 경험보다 플랫폼 내 체류 시간과 광고 노출을 우선시하는 전략적 변화를 의미합니다. 이는 소셜 미디어 생태계에서 정보 공유의 자유와 플랫폼 수익성 사이의 갈등을 심화시킬 수 있습니다.
GeekNews / Hada
네덜란드는 NixOS의 선언적 구성 방식을 활용해 미국산 소프트웨어 의존도를 낮추고 국가 차원의 디지털 자립을 시도하고 있습니다. 이는 특정 기업의 생태계에 종속되지 않는 기술적 주권을 확보하려는 국가적 차원의 IT 전략 모델로 평가됩니다.
GeekNews / Hada
iPad의 화면 미러링 방식이 발표용 콘텐츠와 기기 화면을 분리하지 못해 발생하는 기술적 결함입니다. 이는 전문적인 프레젠테이션 도구로서 iPad의 신뢰성을 저하시키는 요소로 작용할 수 있습니다.
코딩 및 웹 개발을 목적으로 16GB GPU를 추가하여 듀얼 GPU 구성을 유지할지, 아니면 기존 GPU만 사용하고 부족한 자원은 클라우드로 해결할지에 대한 고민을 다루고 있습니다. 모델 성능이 계속 발전하는 상황에서 16GB급 GPU 두 개를 운용하는 것이 실질적인 가치가 있을지에 대해 조언을 구하고 있습니다.
데스크톱 AI 에이전트를 모바일로 제어할 수 있는 기능에 대한 수요를 묻는 게시글입니다. 사용자가 이동 중에도 채팅에 참여하고 에이전트를 제어할 수 있도록 종단간 암호화가 적용된 모바일 접근 방식을 계획하고 있습니다.
XHToken에서 발표한 Spark-X2.6-4B 모델은 온디바이스 배포를 위해 설계된 소형 범용 언어 모델입니다. 이전 버전인 Spark-X2.5의 아키텍처를 유지하면서도 사후 학습(post-training)을 통해 코딩, 에이전트 기능, 긴 문맥 처리 능력을 대폭 향상시켰습니다.
소프트웨어 개발의 전 과정을 자동화하는 MIT 라이선스 오픈소스 템플릿인 one-man-startup이 공개되었습니다. 이 도구는 단순한 프롬프트를 넘어 요구사항 정의부터 설계, 테스트, QA, 배포에 이르는 표준 워크플로우를 따르도록 설계되었습니다.
50건
읽어볼 만한 AI 연구
AI 연구
뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는 것이 목적이지만, 제한된 신경 데이터로 인해 거대 모델을 직접 학습하거나 전체 파라미터를 미세 조정하는 것은 매우 어렵습니다. 본 연구는 PEFT(Parameter-Efficient Fine-Tuning)를 활용하여 소수의 파라미터만으로 거대 사전 학습 모델을 뇌 인코딩에 효과적으로 적응시키는 방법을 제안합니다. 특히 백본의 인과적 구조를 활용해 슬라이딩 윈도우 대신 단일 패스로 여러 시점을 예측함으로써 연산 비용을 획기적으로 줄였습니다. LoRA와 경량 리드아웃을 결합한 결과, 104B 규모의 모델에서도 우수한 성능을 보였으며 Algonauts 2025 챌린지에서 최고 성능을 달성했습니다. 또한 멀티-LoRA 커널을 개발하여 수백 개의 모델을 효율적으로 학습 및 앙상블할 수 있는 확장성까지 확보했습니다.
AI 연구
기존 파라미터 기반 모델은 정보를 지속적으로 축적하고 활용하는 데 한계가 있습니다. 이를 해결하기 위해 메모리를 모델 연산의 핵심 요소로 통합하는 MemT-1.0 아키텍처를 제안합니다. Gated DeltaNet-2를 통해 안정적인 토큰 단위 메모리 업데이트를 구현하고, Mixture-of-Storage를 도입하여 메모리 용량을 확장했습니다. 34B 토큰 규모의 2단계 학습 파이프라인을 통해 모델을 최적화했습니다. 실험 결과, 기존 파라미터 기반 방식보다 우수하며 RAG 방식과 경쟁 가능한 성능을 보이면서도 추론 속도와 저장 공간 효율을 크게 개선했습니다.
AI 연구
로봇 배포 과정에서 발생하는 실행 경험은 정책 신뢰도를 높일 수 있는 중요한 자원이지만, 기존의 인간 개입 방식은 로봇 규모가 커질수록 유지 관리가 어렵다는 문제가 있습니다. 본 논문은 배포된 로봇들이 실행 경험을 공유하여 공통 정책을 개선하는 집단 경험 학습(CEL) 패러다임을 소개합니다. 이를 위해 실패 상황에서 관련된 성공 궤적을 검색하여 정책을 업데이트하는 FERT(failure-guided experience retrieval fine-tuning) 기법을 제안합니다. 또한, 로봇 군집 내 국소적 중단 상황에서도 학습과 배포가 원활히 이루어지는 결함 허용 비동기 학습 시스템(FATS)을 구현했습니다. 실험 결과, 다양한 조작 작업에서 높은 성공률을 달ั้น 데다 로봇 규모가 커질수록 성능이 향상됨을 입증했습니다.
AI 연구
기존의 OR 벤치마크는 정제된 문제 위주로 구성되어 있어, 실제 비즈니스 요구사항을 최적화 모델로 변환하는 실무 역량을 평가하기 어렵습니다. 이를 해결하기 위해 실제 368만 달러 규모의 프로젝트 데이터를 기반으로 한 end-to-end 벤치마크인 OR-License를 제안합니다. 연구진은 비즈니스 사실만을 제공하는 시뮬레이터 ORSim을 도입하여 정보 획득 및 문제 정식화 과정을 통제하며 평가합니다. 실험 결과, 최신 모델들이 일부 지표에서 전문가를 상회하기도 했으나, 실행 가능성과 품질을 종합한 DAQ 지표에서는 아직 전문가 수준에 미치지 못했습니다. 결론적으로 에이전트가 신뢰할 수 있는 솔루션을 내놓기 위해서는 정보 격차 해소와 충실한 문제 정식화 능력이 필수적임을 확인했습니다.
AI 연구
인간의 자기중심적(egocentric) 경험은 세계의 구조와 변화를 학습하기 위한 풍부한 기초를 제공하지만, 이를 대규모 학습 자원으로 변환하는 데는 막대한 수동 주석 비용이 발생합니다. 본 논문은 경험 캡처, 세계 표현, 자동 데이터 구축, 모델 학습 및 평가를 연결하는 통합 생태계인 HOLI-WORLD를 제안합니다. HOLIWORLD-Foundry는 정적/동적 인식을 결합하여 장면 구조와 객체 상태, 상호작용 이력을 연결하는 세계 기록을 자동 생성합니다. 이를 통해 구축된 HOLIWORLD-Data는 약 80K의 QA 쌍을 포함하며, 이를 통해 학습된 HOLIWORLD-VL-4B 모델은 강력한 공간 및 시간 추론 능력을 보여줍니다. 실험 결과, 제안된 방법론은 기존 벤치마크와 HOLIWORLD-Bench에서 뛰어난 성능을 입증하며 실용적인 세계 모델링 기반을 제공합니다.
AI 연구
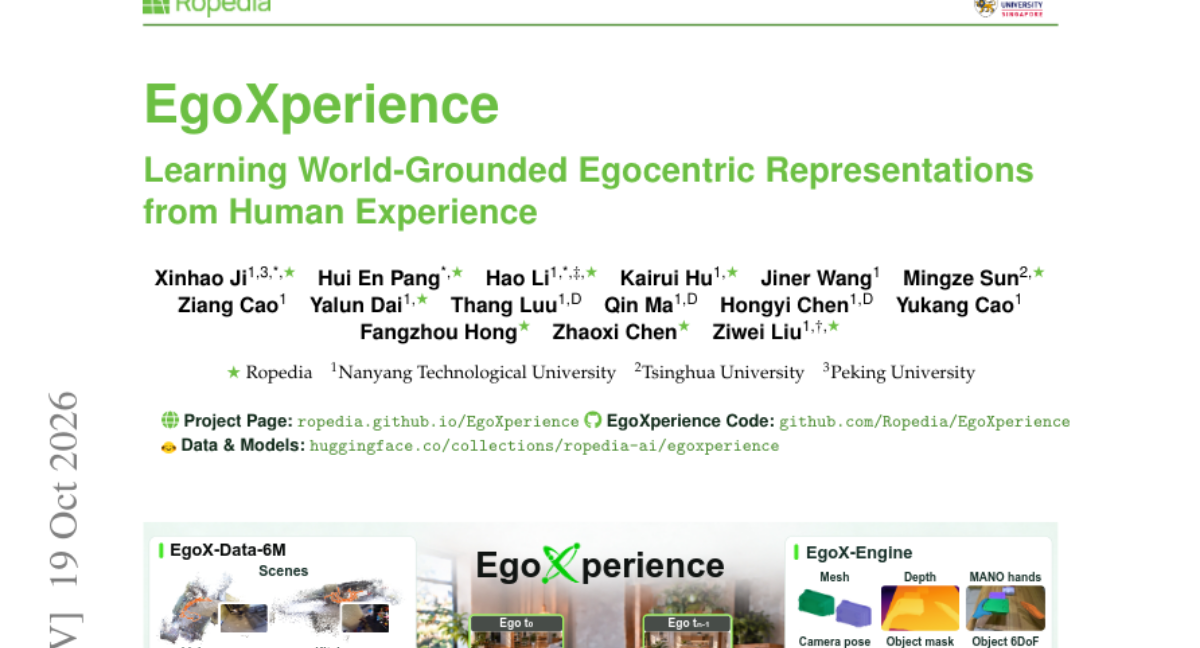
기존의 1인칭 시점(egocentric) 비디오 재구성은 카메라 움직임, 주변 기하 구조, 손-객체 상호작용 간의 일관성을 유지하는 데 어려움이 있었습니다. 이를 해결하기 위해 데이터 수집부터 자동 주석 생성, 모델링, 벤치마킹을 아우르는 EgoXperience 패러다임을 제안합니다. 핵심인 EgoX-Engine은 SLAM 기반의 세계 정렬과 기하학적 객체 추적을 결합하여 정밀한 주석을 생성합니다. 이를 통해 구축된 EgoX-Data-6M 데이터셋과 EgoX 모델은 단일 포워드 패스로 일관된 세계 좌표계 내에서 4가지 요소를 동시에 재구성합니다. 실험 결과, 기존 베이스라인 대비 카메라, 손, 깊이 오차를 대폭 줄이며 최첨단 성능을 달성했습니다.
AI 연구
언어 지시를 따르는 로봇 내비게이션은 다양한 환경에 대한 일반화가 필수적이지만, 실세계 데이터 수집 비용과 시뮬레이션과 실세계 간의 간극(Sim-to-Real)이 큰 문제였습니다. 본 논문은 인터넷의 1인칭 시점 영상이 풍부한 내비게이션 경험을 제공할 수 있다는 점에 주목했습니다. 이를 위해 제안된 ScaleNav는 목표 지향적 시각 역학(Visual Dynamics)을 학습하는 3단계 훈련 프레임워크를 제안합니다. 먼저 비디오 사전학습을 통해 지시된 목표에 접근할 때 관찰값이 어떻게 변하는지 학습하고, 이후 시뮬레이션 데이터를 통해 실행 가능한 액션 청크를 예측하도록 정렬합니다. 마지막으로 전체 모델을 공동 미세 조정하여 최종 내비게이션 성능을 최적화합니다. 실험 결과, 제안 모델은 주요 벤치마크에서 기존 베이스라인을 상회하였으며 실제 4족 보행 로봇에서도 성공적으로 동작함을 입증했습니다.
AI 연구
기존의 Matryoshka Representation Learning(MRL)은 중첩된 프리픽스 최적화를 통해 유연한 차원 조절을 지원하지만, 앞부분의 차원이 충분히 압축된 정보를 담도록 보장하는 제약 조건이 부족합니다. 이를 해결하기 위해 본 논문은 특징 공간을 재구성하여 프리픽스 읽기 성능을 높이는 SpecM의 방식을 제안합니다. 구체적으로, 특징 중요도에 따라 정렬된 파라미터 유도 스펙트럼 기저(spectral basis)를 MRL에 도입했습니다. SpecMRL은 표준 MRL의 형식을 따르되, 학습된 스펙트럼 공간 내에서 프리픽스 읽기가 수행됩니다. 실험 결과, SpecMRL은 MTEB 벤치마크의 모든 차원 축소 구간에서 기존 MRL을 능가했으며, 특히 압축률이 높을수록 성능 향폭이 컸습니다. 결과적으로 SpecMRL은 절반의 차원만으로도 전체 차원을 사용하는 기존 MRL의 성능을 뛰어넘는 효율성을 보여주었습니다.
AI 연구
최근 MLLM의 발전에도 불구하고, 외부 지식이나 정밀한 수치 측정이 필요한 복잡한 시각적 추론 작업은 모델 내부의 추론만으로는 한계가 있습니다. 단순히 추론 예산을 늘리는 것만으로는 이러한 외부 증거 기반 작업의 성능 향상이 미미하다는 점이 확인되었습니다. 이를 해결하기 위해 도구 인터페이스와 증거 렌더링을 결합한 'Capability Layer'와 데이터/이미지를 유지하는 'Persistent Multimodal Memory'를 갖춘 OpenVLHarness를 제안합니다. 이 프레임워크는 코딩 인터페이스를 통해 여러 도구의 결과를 조합하고 반복적인 증거 확보를 가능하게 합니다. 실험 결과, 다양한 백본 모델에서 기존 베이스라인 대비 유의미한 성능 향상을 보였으며, 특히 적은 토큰 비용으로도 고성능 모델의 최대 추론 성능을 상회하는 효율성을 입증했습니다.
AI 연구
LLM 코딩 에이전트의 성능은 모델 정책과 환경 간의 상호작용에 의해 결정되지만, 기존 방식은 고정된 환경에서 모델만 학습하거나 그 반대의 경우에 머물러 최적의 시너지를 내지 못합니다. 이를 해결하기 위해 정책과 환경을 번갈아 최적화하는 Self-HPO 프레임워크를 제안합니다. 에이전트가 자신의 실패 사례를 분석하여 새로운 테스트 환경을 제안하고, 그 환경에서 다시 강화학습을 수행하는 방식으로 두 요소를 동시 진화시킵니다. 실험 결과, 제안된 방식은 기존의 단일 최적화 방식보다 높은 성능 향상을 보였으며 일반화 성능과 신뢰도(Pass@1)를 동시에 개선했습니다. 특히 두 구성 요소의 결합 효과가 개별 효과의 합보다 크게 나타나 상호 보완적 진화가 가능함을 입증했습니다.
AI 연구
AI 동료 에이전트는 도구 사용, 다중 턴 통신, 변화하는 작업 환경 대응 등 복잡한 협업 능력이 필요합니다. 하지만 이러한 능력을 학습시키기 위한 일관된 요청, 서비스 기록, 도구 인터페이스 및 검증 체계를 구축하는 것은 매우 어렵습니다. 본 논문은 워크플로우 요구사항에 따라 실행 가능한 학습 환경을 생성하는 CoworkEnv 프레임워크를 제안합니다. 생성된 환경은 프로그래밍 방식의 검증을 거치며, 교사 모델의 실행 데이터는 SFT용으로, 학생 모델의 상호작용은 RL용으로 활용됩니다. 실험 결과, 제안된 방식을 통해 모델의 성능이 크게 향상되었으며 RL 학습 역학에 대한 분석을 통해 환경의 유효성을 입증했습니다.
AI 연구
사용자의 연속적인 명령에 따라 이미지를 수정하는 다회차 이미지 편집은 대화형 콘텐츠 생성에 필수적입니다. 그러나 기존 방식은 편집 횟수가 늘어날수록 화질 저하와 의도치 않은 영역의 변형이 발생하는 드리프트 현상을 겪습니다. 이를 해결하기 위해 본 논문은 자기회귀 확산 기반의 통합 멀티모달 모델(UMM)을 위한 'MT Forcing' 학습 패러다임을 제안합니다. Single-Turn DMD를 통해 재귀적 오차 누적 없이 고품질 가이드를 제공하며, Teacher-Forcing Guidance를 통해 턴 간 콘텐츠 일관성을 유지합니다. 실험 결과, 제안 방식은 시각적 품질 안정성과 턴 간 일관성을 모두 크게 개선함을 입증했습니다.
AI 연구
LLM 에이전트가 복잡한 환경에서 장기 과업을 수행할 때, 개별 요구사항은 충족하더라도 요소 간의 의존성이나 관계를 놓쳐 최종 과업 완수에 실패하는 문제가 발생합니다. 이를 해결하기 위해 각 과업을 타입화된 '완성 그래프(Completion Graph)'로 표현하는 Interlock 프레임워크를 제안합니다. 이 프레임워크는 증거, 결정, 결과 간의 관계를 그래프로 구조화하고, 이를 워크스페이스와 평가 루브릭으로 컴파일하여 검증합니다. 검증 과정에서는 소스 커버리지 리뷰, 공개 입력 리뷰, 에이전트 판사(Agent-as-judge)를 통해 요구사항 준수 여부를 엄격히 확인합니다. 실험 결과, 생성된 성공 궤적을 활용한 미세 조정(Fine-tuning)이 다양한 벤치마크에서 성능 향상을 이끌어냄을 입증했습니다.
AI 연구
월드 모델은 환경의 역학을 학습하여 에이전트의 계획과 시뮬레이션을 가능하게 하지만, 학습 데이터(Expert rollouts)를 벗어난 상태-행동 조합에서의 신뢰성 문제는 여전히 해결되지 않았습니다. 본 논문은 데이터 커버리지와 역학 일반화 사이의 관계를 조사하기 위해, 익숙한 요소들을 새로운 조합으로 재구성하는 '조합적 일반화(Compositional generalization)' 관점을 도입합니다. 이를 위해 기존 월드 모델 환경을 기반으로 목표가 이동된 태스크 변형들을 포함하는 벤치마크인 AnyGoal과 오픈소스 라이브러리를 제안합니다. 실험 결과, 현재의 다양한 월드 모델들은 학습 데이터 내의 요소들을 사용함에도 불구하고 새로운 조합 상황에서 일관된 실패를 보였습니다. 본 연구는 월드 모델이 새로운 계획 태스크로 일반화되는 과정을 평가하기 위한 체계적인 프레임워크를 제공합니다.
AI 연구
기존의 선형 어텐션 모델들은 장기 문맥 학습 시 메모리 간섭 문제와 수치적 불안정성 문제를 겪어왔습니다. 이를 해결하기 위해 본 논문은 연상 행렬 메모리 업데이트를 위한 새로운 규칙인 Kronecker Delta Rule 기반의 KronLSTM을 제안합니다. 이 방식은 메모리 공간 내에서 단일 방향으로만 수정이 이루어지도록 하여 기존 델타 룰 대비 정보 간섭을 최소화합니다. 수학적으로는 메모리 동역학이 마르코프 체인 형태로 수렴하며 노름(norm)이 일정하게 유지되어 별도의 정규화 없이도 안정적인 학습이 가능함을 증명했습니다. 실험 결과, KronLSTM은 기존 Gated DeltaNet 등 선형 어텐션 모델들과 경쟁력을 보이면서도 특히 장기 문맥 벤치마크에서 우수한 성능을 기록했습니다.
AI 연구
LLM 에이전트가 미지의 환경에서 스스로 규칙을 발견하고 변화에 적응하는 능력이 중요해지고 있으나, 기존 벤치마크는 이러한 능력을 검증하기 부족합니다. 이를 해결하기 위해 숨겨진 규칙과 규칙 변화(drift)를 포함한 AdaExploreBench를 제안합니다. 에이전트는 환경의 동역학을 파악하기 위해 능동적으로 증거를 수집하고, 성능 저하를 통해 변화를 감지해야 합니다. 실험 결과, 최신 LLM들도 능동적 탐색과 변화 감지 측면에서 여전히 낮은 성능을 보였습니다. 이는 에이전트가 주어진 정보로 추론하는 능력은 뛰어나지만, 스스로 정보를 획득하거나 기존 지식의 유효성을 판단하는 데 어려움이 있음을 시사합니다.
AI 연구
효과적인 비주얼 토크나이저는 이미지 충실도를 유지하면서도 확산 모델이 학습하기 쉬운 잠재 공간을 생성해야 합니다. 기존 방식은 의미적 정렬이나 공동 학습을 통해 이를 해결하려 했으나, 본 연구는 생성에 필요한 정보가 손상된 잠재 공간에서도 복구 가능해야 한다는 '강건한 예측' 원칙에 주목했습니다. 이를 위해 고수준 구조를 유지하는 RobustAlign과 세부 정보를 복원하는 RobustRecon이라는 두 가지 상호 보완적 목적 함수를 제안합니다. 실험 결과, RoAR-VAE는 기존 베이스라인 대비 생성 성능을 향상시켰으며 특히 텍스트 재구성 정확도에서 큰 개선을 보였습니다. 결과적으로 제안된 방식은 재구성 충실도와 생성 학습 용이성 사이의 균형을 효과적으로 달성합니다.
AI 연구
LLM 에이전트의 메모리 시스템은 정보 유지와 재사용을 위해 필수적이지만, 기존 방식은 쿼리와 무관하게 메모리를 구축하여 불필요한 비용을 발생시키거나 중요한 세부 정보를 유실하는 문제가 있습니다. 최근 런타임 적응 방식이 시도되고 있으나, 성능·비용·지연시간 사이의 유연한 제어는 여전히 미흡한 실정입니다. 본 논문은 다양한 선호도에 따라 온디맨드 메모리 큐레이션을 수행하는 MemPilot 프레임워크를 제안합니다. 강화학습을 통해 쿼리별로 메모리 검색과 원시 멀티모달 이력의 정제 작업을 적절히 배분하는 다단계 정책을 최적화합니다. 실험 결과, MemPilot는 기존 방식보다 넓은 성능-비용-지연시간 트레이드오프 경계(Pareto frontier)를 달める 데 성공했습니다.
AI 연구
기존의 VLM 기반 3D 에셋 생성은 단순한 형태에 그치거나 미리 정의된 API 범위 내에서만 작동하는 한계가 있었습니다. 본 논문은 오픈 엔드 3D 월드 생성을 위한 VLM 기반 프레임워크인 InfiniDream을 제안합니다. 먼저, 기존 절차적 알고리즘을 활용해 편집 가능성과 다양성을 유지하며 새로운 에셋을 만드는 '기호적 제약 에셋 생성' 방식을 도입했습니다. 또한, 의미론적 장면 계획과 결정론적 프러스텀 가이드 그리드 배치를 결합하여 정밀한 객체 배치와 애니메이션이 포함된 대규모 월드 생성 파이프라인을 구축했습니다. 실험 결과, 다양한 객체 및 장면 생성 작업에서 기존 방식보다 뛰어난 성능과 시각적 품질을 입증했습니다.
AI 연구
AI 에이전트 개발에서 성능 향상을 위한 재귀적 자기 개선(RSI) 방식은 종종 높은 실행 비용을 초래하는 문제가 있습니다. 본 논문은 정답(ground-truth) 없이도 성능과 비용 사이의 균형을 맞추며 하네스를 진화시키는 HarnessPro를 제안합니다. 특화된 에이전트들이 실행 궤적을 진단하고, 비용 우선 또는 성능 우선 등 다양한 우선순위에 따라 업데이트를 계획 및 구현합니다. Pareto 최적화 기법을 통해 예산에 맞춘 세 가지 모드(lite, medium, heavy)의 하네스를 제공하며, 선택된 하네스는 다음 반복 과정에 투입됩니다. 실험 결과, 기존 방식 대비 성능 향상과 비용 절감을 동시에 달성하며 다양한 벤치마크에서 우수한 성과를 입증했습니다.
AI 연구
기존의 만화 애니메이션 생성 방식은 텍스트 기반 접근 시 화풍을 잃거나, 페이지 직접 입력 시 구조적 해석 오류로 인해 스토리라인이 왜곡되는 문제가 있었습니다. 본 논문에서는 모든 생성 단계를 원본 만화에 근거하는 'Manga2Animate' 프레임워크를 제안합니다. 이 프레임워크는 작업을 애니메이션 스크립트와 시각적 스토리보드라는 두 가지 중간 표현으로 분해합니다. 각 단계는 생성 에이전트와 원본 패널을 검토하는 리뷰 에이전트 간의 상호작용을 통해 정교하게 다듬어집니다. 실험 결과, 제안 방식은 기존 SOTA 모델 대비 원작에 더 충실하고 샷 간 일관성이 뛰어난 애니메이션을 생성함을 입증했습니다.
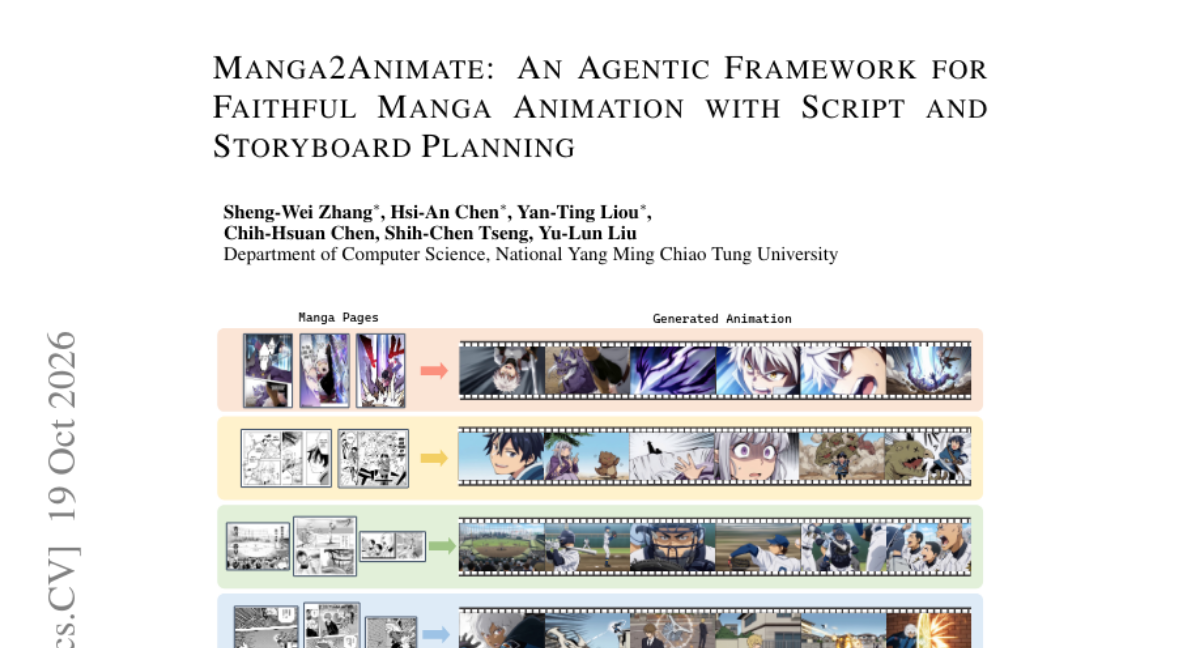
AI 연구
최근 MLLM 기반 3D 생성 에이전트가 발전하고 있으나, 실제 워크플로우의 복잡한 요구사항을 평가할 벤치마크는 부족한 실정입니다. 이를 해결하기 위해 다양한 참조 데이터(텍스트, 이미지, 비디오 등)를 기반으로 3D 콘텐츠를 생성하는 능력을 측정하는 BlenderWorld를 도입합니다. 223개의 태스크와 2,651개의 세부 규칙을 통해 렌더링된 결과물의 품질을 정밀하게 평가하는 프로토콜을 구축했습니다. 13개의 최신 모델을 테스트한 결과, GPT-6-Astra가 가장 높은 성능을 보였습니다. 연구 결과, 현재 모델들은 광범위한 지시 수행은 가능하나 미세한 3D 공간 일관성과 구조적 재현 능력에서 한계를 보였습니다.
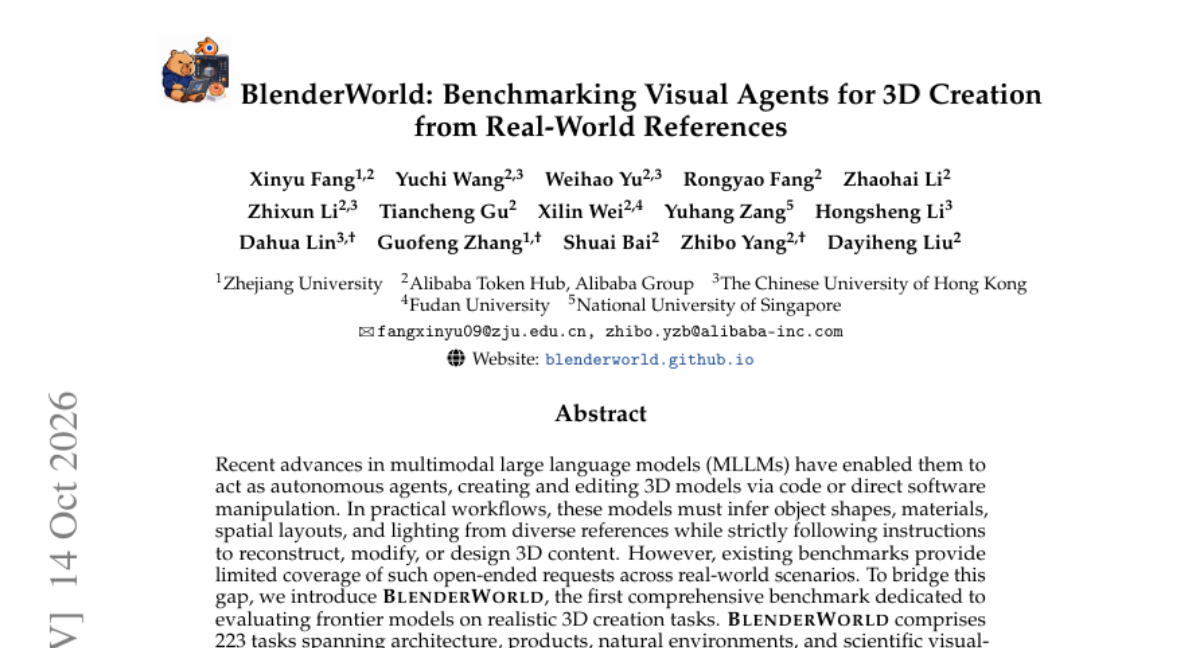
AI 연구
로봇 가치 모델은 시각 정보와 지시사항을 바탕으로 작업 수행을 평가하여 정책 학습과 모니터링에 기여합니다. 그러나 기존 평가는 실행 이해의 일부 측면만 다루어 가치 피드백의 신뢰성을 충분히 검증하지 못하는 한계가 있습니다. 본 논문은 작업 상태 이해, 시간적 진행 모니터링, 실패 및 복구 추론, 가치 일관성이라는 네 가지 차원을 평가하는 RoboValue 벤치마크를 도입합니다. 15개의 시뮬레이션 및 20개의 실세계 조작 태스크를 포함하는 데이터셋을 통해 제로샷 및 원샷 환경에서 기존 모델들을 평가했습니다. 실험 결과, 기존 모델들이 세부 지시 이행, 이력 기반 진행 추적, 복구 평가 등에서 취약함을 보임을 확인했습니다. 이 연구는 가치 감독(Value Supervision)의 구체적인 타겟을 제시하며, 공개된 데이터셋과 리더보드를 통해 지속적인 평가 환경을 제공합니다.
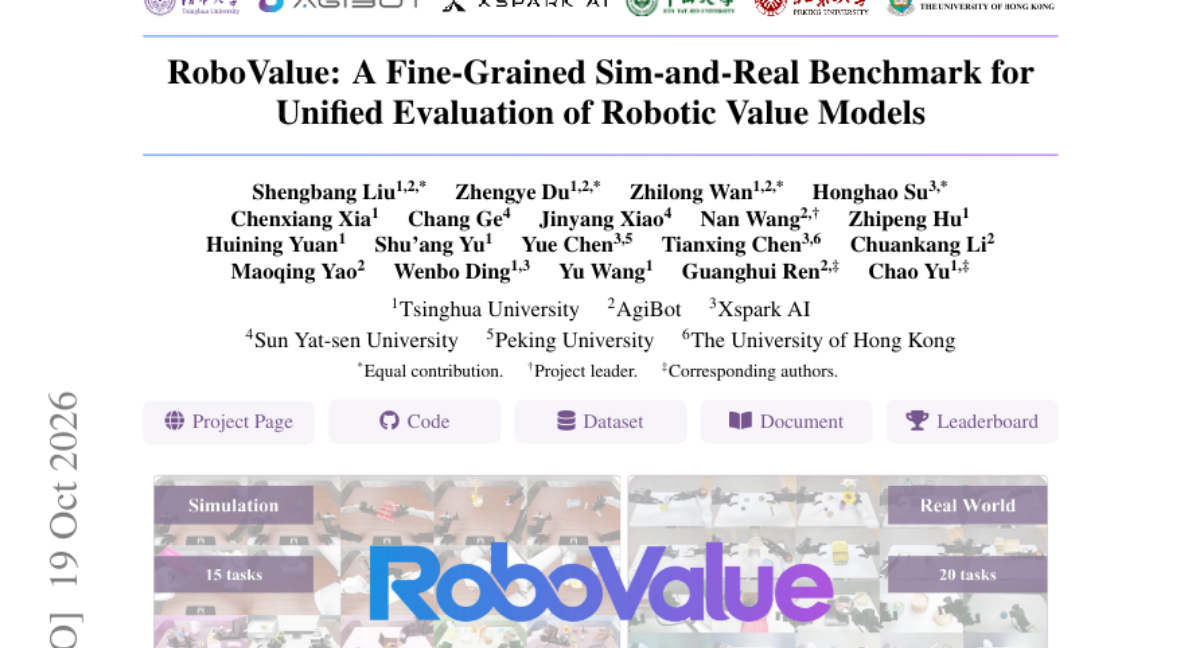
AI 연구
비디오 추론 세그멘테이션(VRS)은 텍스트 설명에 따라 대상의 픽셀 마스크를 예측해야 하는 복잡한 과제입니다. 기존의 텍스트 중심 Chain-of-Thought(CoT) 방식은 언어적 추론과 실제 비디오 프레임 간의 시각적 근거 차이를 메우지 못하는 한계가 있습니다. 이를 해결하기 위해 시공간적 근거를 연대기적 추론 체인으로 구성하는 TCo써리(TCoVP)를 도입합니다. TCoVP는 개체 참조, 시간적 근거, 공간적 증거를 결합하여 질문에 부합하는 대상을 식별하고 마스크 예측을 위한 프롬프트를 생성합니다. 제안된 SFT 및 RL 학습 방식을 통해 검증한 결과, 다양한 벤치마크에서 강력한 성능 향상을 입증했습니다.
AI 연구
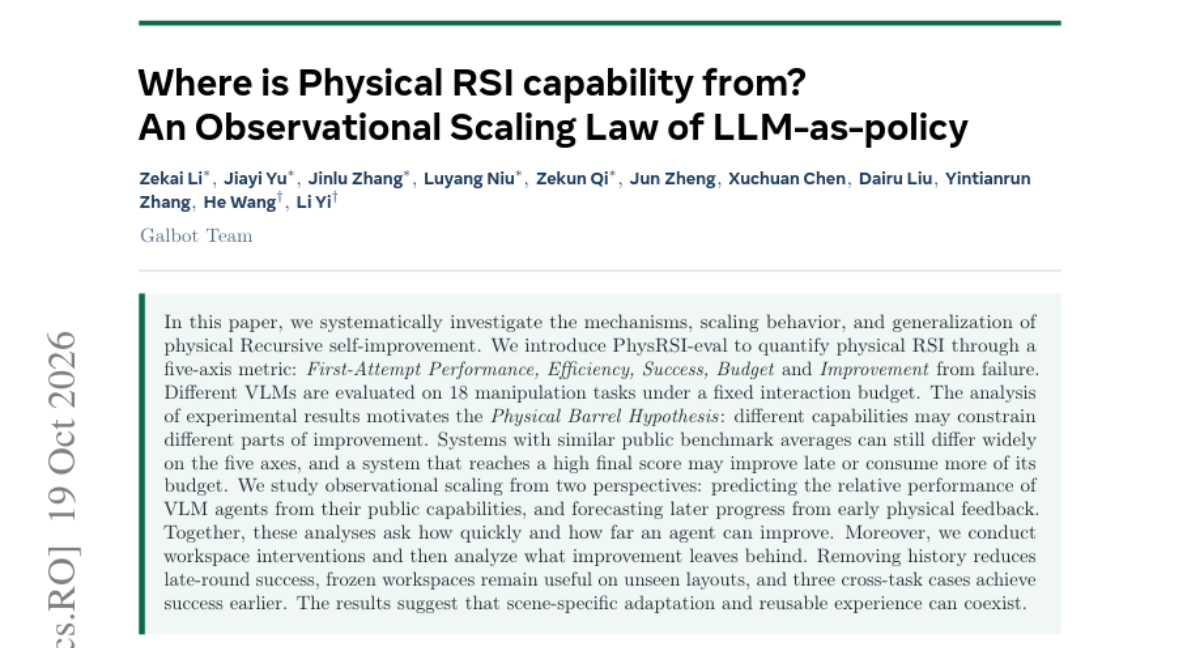
물리적 환경에서 에이전트가 스스로 성능을 개선하는 'Physical RSI'의 메커니즘과 일반화 능력을 체계적으로 조사하고자 합니다. 이를 위해 성공률, 효율성, 예산 등을 포함한 5축 지표인 PhysRSI-eval을 도입하여 다양한 VLM 에이전트를 평가했습니다. 실험 결과, 서로 다른 역량이 개선의 특정 영역을 제약한다는 'Physical Barrel Hypothesis'를 제안했습니다. 또한 공공 벤치마크 성능을 통해 상대적 성능을 예측하고, 초기 피드백을 통해 향후 발전을 예측하는 관찰적 스케일링 법칙을 연구했습니다. 최종적으로 장면 적응과 재사용 가능한 경험이 공존할 수 있음을 확인했습니다.
AI 연구
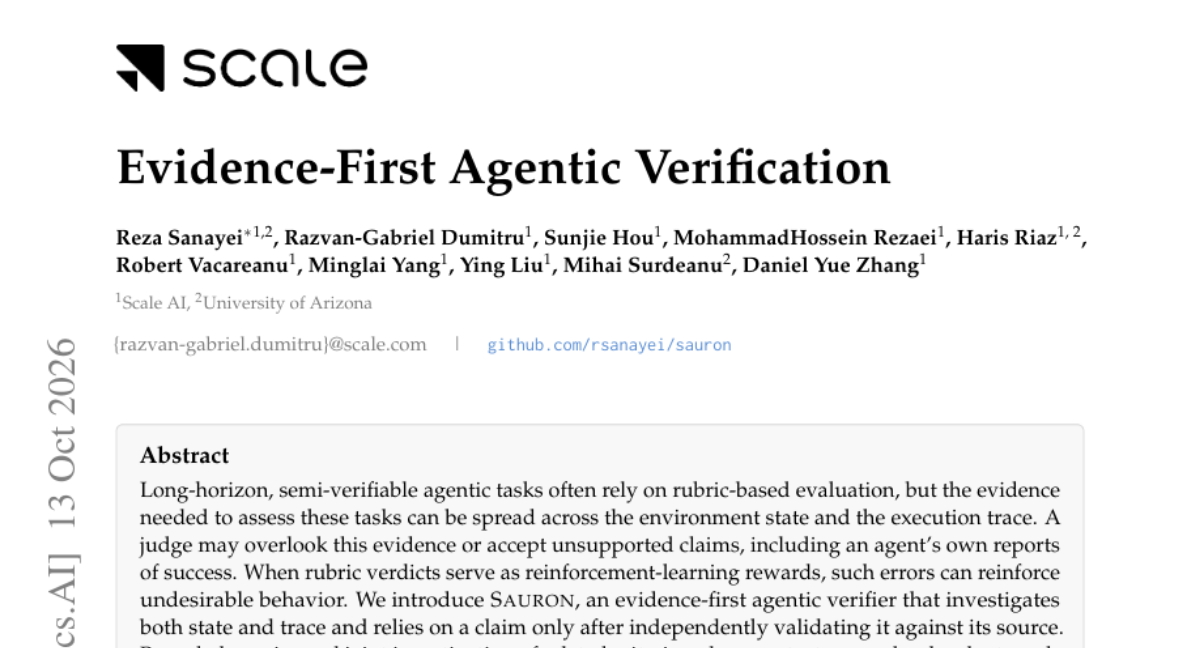
장기 실행 에이전트의 평가는 루브릭 기반으로 이루어지지만, 증거가 환경 상태와 실행 기록에 분산되어 있어 판단 오류가 발생하기 쉽습니다. 특히 에이전트의 성공 보고를 무비판적으로 수용할 경우 강화 학습 과정에서 잘못된 행동이 강화되는 문제가 발생합니다. 이를 해결하기 위해 상태와 실행 기록을 동시에 조사하고, 주장이 독립적인 증거로 검증된 후에만 판결을 내리는 'S선(Sauron)'을 도입합니다. Sauron은 제한된 쿼리와 공동 조사를 통해 컨텍스트 사용을 최적화하며, 모든 판결에 감사 가능한 증거 영수증을 제공합니다. 실험 결과, Sauron은 기존 베이스라인보다 낮은 비용으로 더 높은 F1 점수를 달성하며 보상 해킹 및 에이전트 오류 탐지에서 탁월한 성능을 보였습니다.
AI 연구
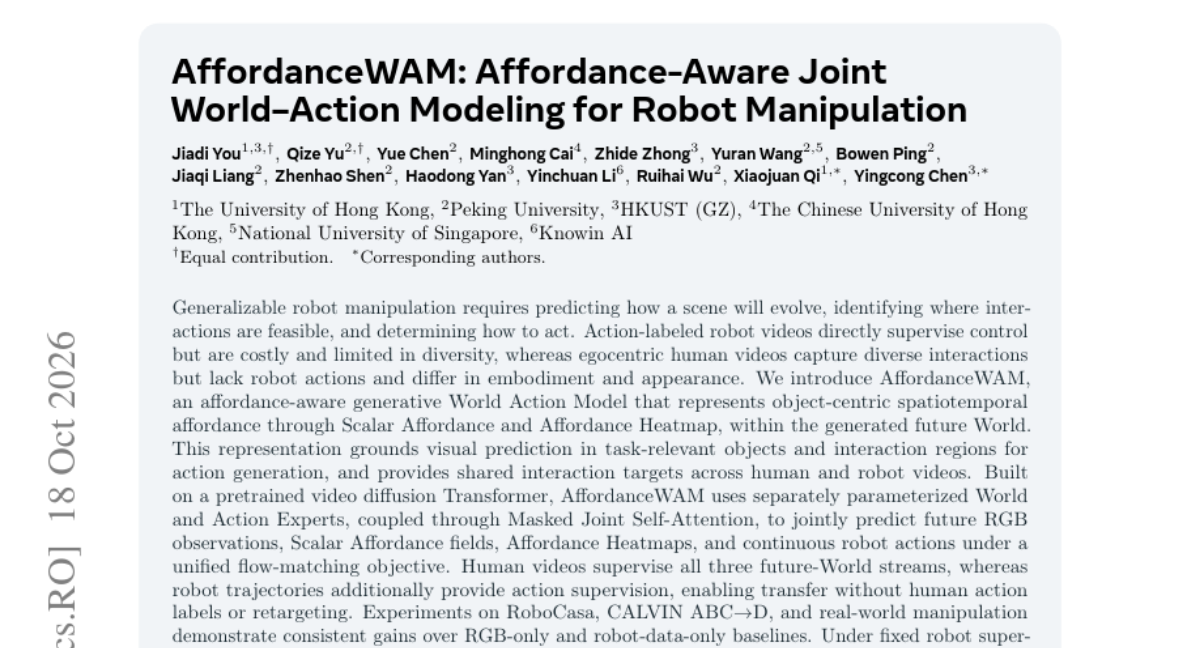
로봇 조작을 위한 일반화된 모델링은 미래 장면 예측과 상호작용 가능 영역 식별이 필수적이지만, 로봇 데이터는 다양성이 부족하고 인간 데이터는 로봇 액션 정보가 없다는 문제가 있습니다. 이를 해결하기 위해 AffordanceWAM은 객체 중심의 스파이시오템포럴 어포난스를 표현하는 스칼라 어포던스와 히트맵을 생성하는 월드-액션 모델을 제안합니다. 사전 학습된 비디오 확산 트랜스포머를 기반으로, 마스킹된 공동 자기 주의(Masked Joint Self-Attention)를 통해 미래 관측값, 어포던스 필드, 로봇 액션을 통합적으로 예측합니다. 인간 영상은 미래 월드 예측을 학습시키고, 로봇 데이터는 액션 학습에 사용되어 인간-로봇 간의 데이터 전이가 가능해집니다. 실험 결과, 인간의 어포던스 데이터가 늘어날수록 로봇의 조작 성능이 향상됨을 입증했습니다.
AI 연구
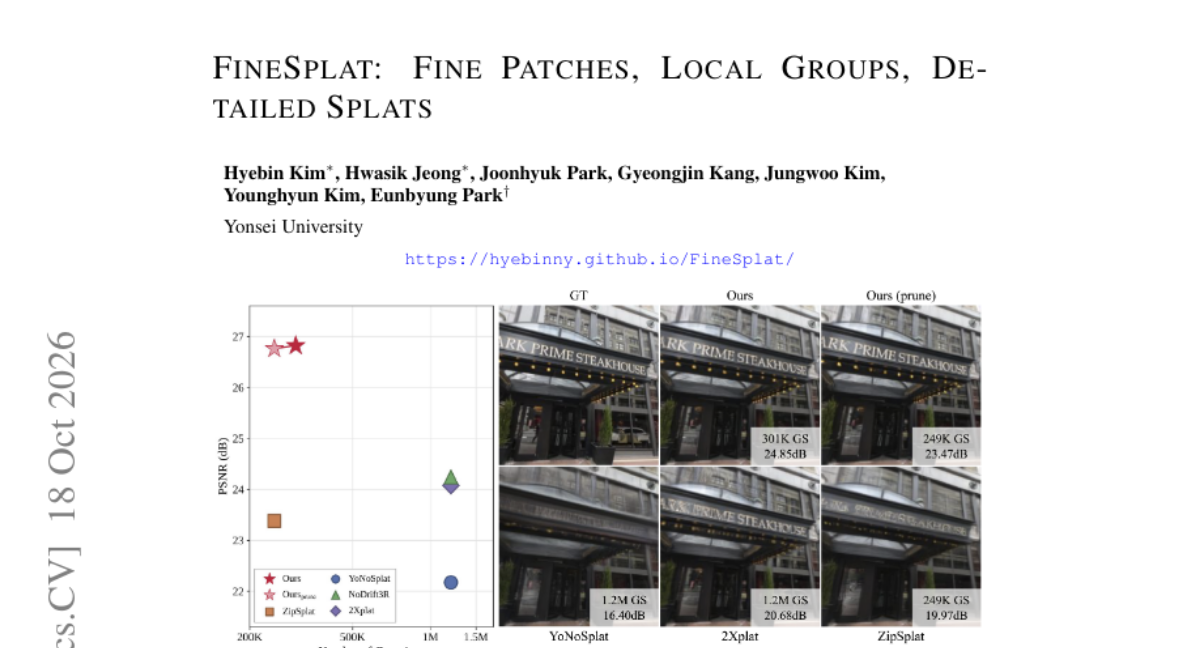
기존의 Feed-forward 3D Gaussian Splatting(3DGS) 방식은 빠른 재구성이 가능하지만, 미세한 기하학적 구조와 외형을 복원하는 데 한계가 있습니다. 이를 해결하기 위해 본 논문은 미세한 이미지 패치를 기반으로 하는 FineSplat 프레임워크를 제안합니다. 연산 비용 문제를 해결하기 위해 인접 시점 간의 상호작용을 위한 'view-wise grouping'과 3D 공간 상의 기하학적 관계를 연결하는 '3D spatial grouping'을 결합한 이중 그룹화 전략을 도입했습니다. 또한, 단일 패스 예측의 한계를 극복하기 위해 재구성 오차를 직접적인 피드백으로 활용하는 렌더링 기반 신호를 적용했습니다. 결과적으로 FineSplat은 적은 수의 가우시안 프리미티브를 유지하면서도 기존 방식보다 훨씬 정교한 기하학적 구조와 외형을 복원하며 SOTA 성능을 달성했습니다.
AI 연구
비디오 월드 모델은 짧은 클립으로 학습할 경우, 생성된 결과가 다시 입력으로 들어가는 과정에서 오차가 누적되어 예측이 빗나가는 드리프트 현상이 발생합니다. 기존의 교사 모델(Teacher) 방식은 액션 반영이 어렵거나 학습 데이터의 길이에 제약을 받는 문제가 있었습니다. 본 논문은 교사 모델 없이도 실시간 데이터 통계와 액션 조건을 활용하는 'Fréchet Forcing' 기법을 제안합니다. 이 방법은 생성된 이력과 실제 데이터 사이의 정렬, 장면 충실도 유지, 현실성 유지를 동시에 수행하는 세 가지 제약 조건을 사용합니다. 실험 결과, 짧은 클립으로 학습했음에도 4,000 프레임 이상의 장기 롤아웃에서도 안정적인 제어와 장면 유지가 가능함을 입증했습니다.
AI 연구
비디오 오버레이 제거는 자막이나 로고로 가려진 장면을 주변 콘텐츠를 유지하며 복원하는 기술입니다. 기존 방식은 잔여물이 남거나 소스 정보가 가려졌을 때 구조적 왜곡이 발생하는 문제가 있었습니다. 이를 해결하기 위해 소스 잠재 변수(latent)를 고정된 가이드로 사용하는 소스 고정 플로우(source-anchored flow) 모델인 DeOverlay를 제안합니다. 가시성 정규화된 시간적 집계(visibility-normalized temporal aggregation)를 통해 가려진 영역을 제외한 유효한 소스 단서를 선택하며, 지역적/전역적 컨텍스트를 결합해 정교한 복원을 수행합니다. 실험 결과, 제안된 방식은 기존 베이스라인 대비 재구성 및 지각적 성능 지표에서 압도적인 성능 향상을 보였습니다.
AI 연구
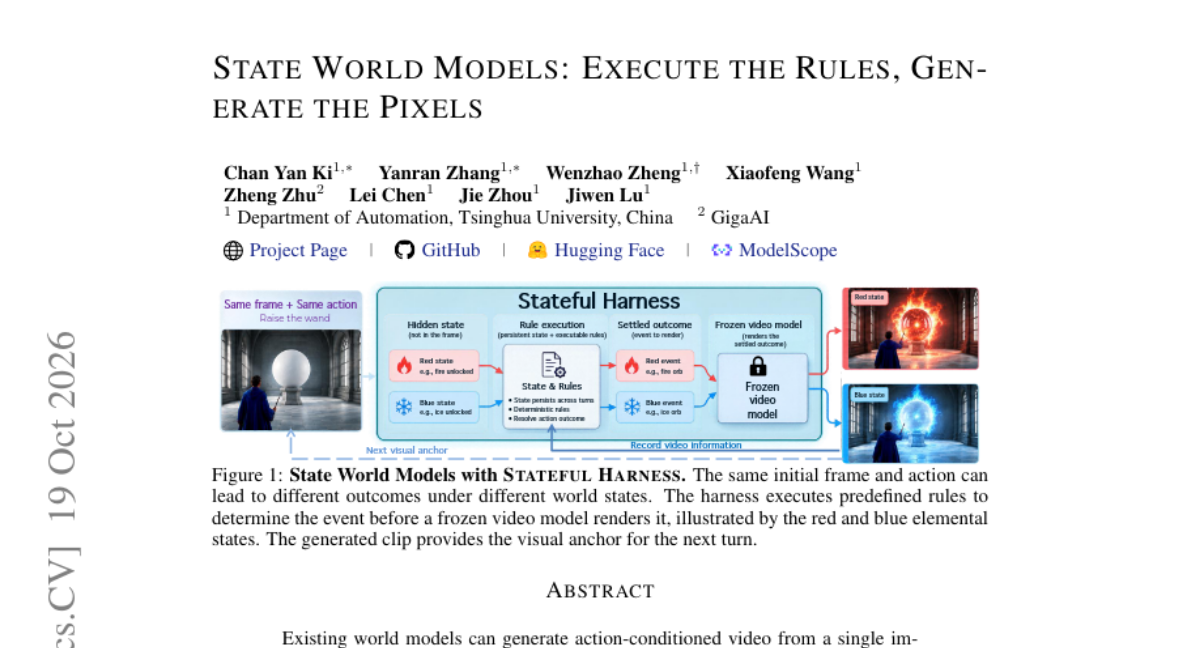
기존의 월드 모델은 단일 이미지에서 액션 기반 비디오를 생성하지만, 현재 프레임에 보이지 않는 숨겨진 상태에 따른 규칙 준수에는 어려움이 있습니다. 본 논문은 세계의 진화와 비디오 렌더링을 분리하여 규칙 기반 상호작용을 지원하는 'Stateful Harness' 프레임워크를 제안합니다. 이 프레임워크는 규칙에 따라 진화하는 세계 상태를 유지하며, 고정된 비디오 모델로 이벤트를 렌더링하고 생성된 클립을 통해 다음 상태를 업데이트합니다. 평가를 위해 숨겨진 상태에 따른 결과 차이를 검증하는 'WorldState-Bench'를 구축했습니다. 실험 결과, 규칙 실행과 렌더링을 분리함으로써 기존 비디오 모델의 성능을 대폭 향상하며 일관된 결과물을 생성함을 입증했습니다.
AI 연구
멀티모달 거대언어모델(MLLM)의 안전성 확보를 위해 기존에는 위험한 멀티모달 데이터 수집이 필수적이었으나, 이는 윤리적·법적 문제를 야기합니다. 본 연구는 LLM 백본에서 추출한 텍스트 거절 방향이 다른 모달리티(이미지, 비디오)로도 일반화될 수 있는지 조사했습니다. 이를 바탕으로 별도의 학습 없이 안전성을 주입하는 Modality-Agnostic Refusal Steering(MARS) 기법을 제안합니다. MARS는 활성화 중심화(activation centering)를 통해 모달리티 불일치를 해결하고, 신뢰 영역 내에서 스티어링 강도를 적응적으로 조절합니다. 실험 결과, MARS는 유용성을 유지하면서도 안전성을 크게 향상시켰으며 텍스트 거절 방향이 강력한 멀티모달 정렬 기반이 될 수 있음을 입증했습니다.
AI 연구
기존의 이미지 편집 모델은 단일 편집에는 뛰어나지만, 여러 번의 편집이 반복될수록 누적되는 분포 변화(distribution shift)로 인해 품질이 급격히 저하되는 문제가 있습니다. 이를 해결하기 위해 모델이 이전 단계의 출력물을 다시 입력으로 사용하는 'Self-Forcing' 원리를 이미지 편집에 도입했습니다. 하지만 자가 생성된 이미지는 정답(ground-truth)과 차이가 있어 직접적인 학습이 어렵다는 난관이 있습니다. 이를 해결하기 위해 원본 이미지를 유지하는 교사(Teacher) 모델과 이전 출력을 사용하는 학생(Student) 모델 간의 비대칭 조건부 증류(Asymmetric Conditioning) 방식을 제안합니다. 실험 결과, 긴 멀티턴 편집 과정에서도 품질 저하를 최소화하며 지시사항을 정확히 반영하는 성능을 보였습니다.
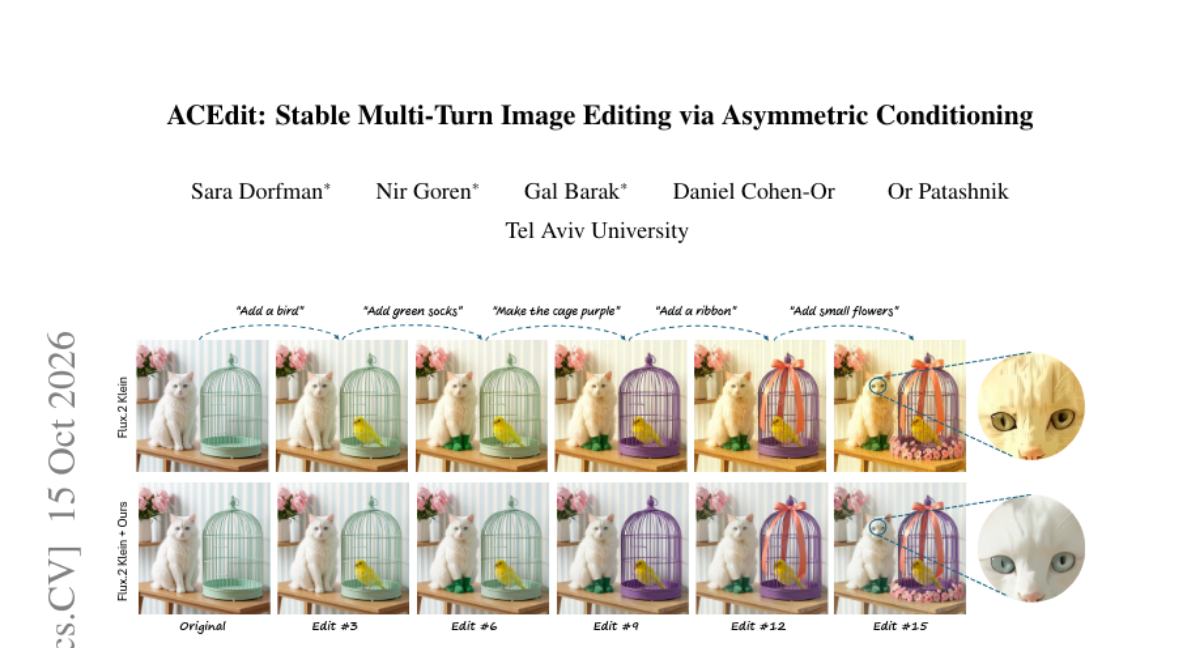
AI 연구
HMLV(다품종 소량 생산) 환경의 로봇 조작은 제품 변동성, 이동하는 물류, 엄격한 기하학적 공차 등 복잡한 산업적 제약 조건을 수반합니다. 기존의 로봇 학습 프레임워크는 이러한 실질적인 산업 공정 제약 조건을 체계적으로 평가하는 데 한계가 있었습니다. 본 논문은 LIBERO 벤치마크를 확장하여 산업적 제약 조건을 제어 가능한 작업 조건과 측정 가능한 성공 기준으로 변환한 LIBERO-Industry를 소개합니다. S2D, D2S, D2D와 같은 세 가지 시나리오를 통해 총 216개의 태스크를 제공하며, 물체 형상, 컨베이어 속도, 작업 시간 등을 체계적으로 변화시킵니다. 실험 결과, 일반화 로봇 정책들은 제약 조건이 복합적으로 적용될수록 성능이 점진적으로 저하됨을 확인했습니다. 또한, 제안된 공동 학습(co-training) 프로토콜이 기존 방식보다 높은 전이 성능을 달성함을 입증했습니다.
AI 연구
지속적 학습 에이전트는 배포 후 경험을 축적하지만, 실제 환경에서는 생성 및 메모리 예산이 매우 제한적입니다. 기존의 메모리 방식은 자원이 부족할 때 관련성이 높더라도 실행에 도움이 되지 않는 메모리를 가져와 오히려 귀중한 컨텍스트를 낭비하는 문제가 발생합니다. 본 논문은 단순히 관련 있는 경험을 찾는 것이 아니라, 어떤 경험이 보관 및 재사용할 가치가 있는지를 결정하는 것이 핵심임을 밝힙니다. 이를 해결하기 위해 희소한 실행 피드백으로부터 쿼리 의존적 메모리 가치를 학습하는 경량 온라인 프레임워크인 TokenWorth를 제안합니다. 실험 결과, TokenWorth는 가장 적은 토큰을 사용하면서도 높은 작업 성공률을 달리며 자원 제약 하에서의 효율적인 메모리 관리 능력을 입증했습니다.
AI 연구
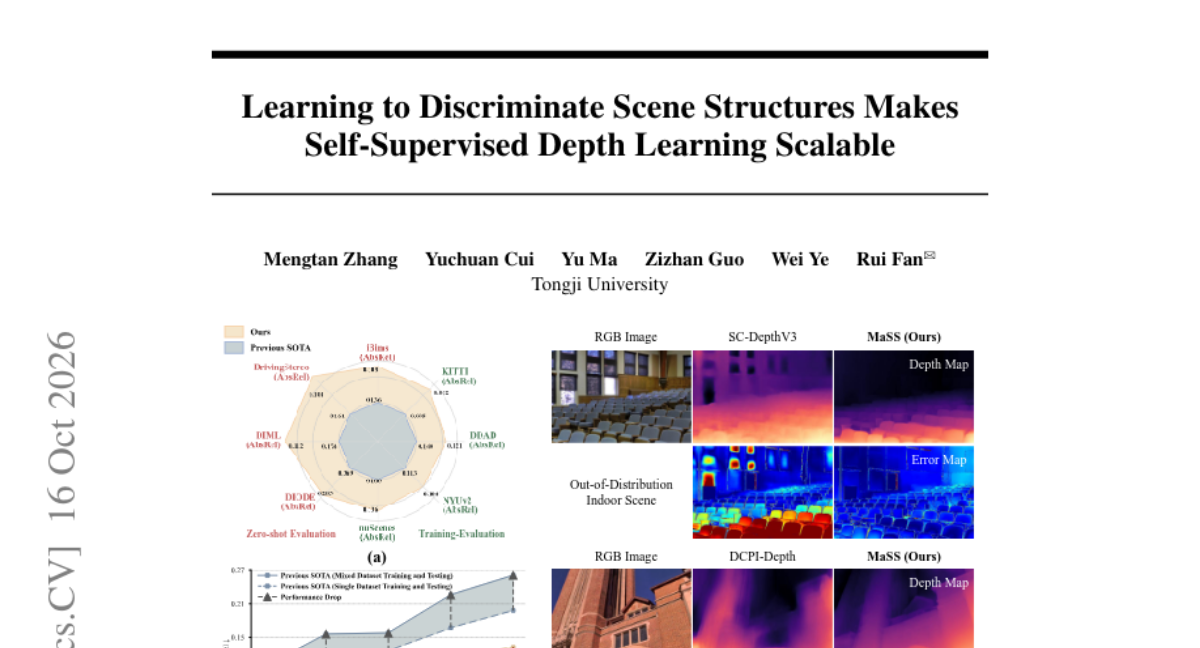
자기주도형 단안 깊이 추정은 미라벨링 데이터 활용이 가능해 매력적이지만, 다양한 장면을 학습할 때 성능이 저하되는 문제가 있습니다. 기존 방식은 전이 가능한 기하학적 구조 대신 데이터셋 특유의 구조적 편향을 학습하여 도메인 간 최적화 충돌을 일으킵니다. 이를 해결하기 위해 문맥적 특징과 분리된 전용 구조 표현 경로를 도입한 MaSS 프레임워크를 제안합니다. 새로운 장면 구조 판별 목적 함수를 통해 일반화된 레이아웃 인지 구조를 학습하도록 유도합니다. 실험 결과, MaSS는 혼합 도메인 학습 시 성능 향상을 보이는 최초의 모델로 입증되었으며 제로샷 평가에서도 뛰어난 일반화 성능을 보였습니다.
AI 연구
재귀적 에이전트는 복잡한 작업을 하위 작업으로 분해하여 해결하지만, 중간 단계의 정답(Ground Truth)이 없어 학습이 어렵다는 문제가 있습니다. 기존의 외부 검증 방식은 비용이 많이 들고 분해 품질을 반영하기 어렵습니다. SERA는 부모 에이전트가 자식 작업에 대한 가중치 기반 평가 기준(Rubik)을 직접 작성하도록 하여 평가를 정책 자체의 학습 능력으로 전환합니다. 랭킹 목적 함수와 리프 커버리지 신호를 통해 분해, 해결, 평가 능력을 하나의 가중치 내에서 통합 학습합니다. 실험 결과, 스스로 생성한 평가 기준이 해결 능력을 높이는 핵심 동력임을 확인했으며 기존 베이스라인 대비 성능을 크게 향상시켰습니다.
AI 연구
기존의 멀티 토큰 예측(MTP) 방식은 별도의 모듈을 추가해야 하며, 이는 연산 비용 증가와 학습 효율 저하를 야기합니다. 이를 해결하기 위해 백본의 최종 레이어가 모든 예측 호라이즌을 담당하는 Efficient Causal Self-Recursion(ECHO) 방식을 제안합니다. 학습 시에는 Dynamic Depth Sampling(DDS)을 통해 깊은 호라이즌의 비용을 효율적으로 관리하며, 미래 예측을 부가 작업이 아닌 자기회귀 목적 함수 자체에 통합합니다. 그 결과, 학습 오버헤드를 절반으로 줄이면서도 추론 및 코드 생성 성능을 높였습니다. 추론 시에는 모델이 스스로 드래프터(drafter) 역할을 수행하며, 높은 엔트로피 상황에서도 정렬된 생성 능력을 유지합니다.
AI 연구
최근 가드레일 분류기는 '유해성'을 텍스트 자체의 속성처럼 보고하지만, 실제로는 학습된 정책의 속성이다. 연구진은 동일한 데이터셋이 서로 다른 두 가지 운영 정의(정책)로 라벨링되어 10개의 가드레일 모델 학습에 사용된 산업적 사례를 분석했다. 실험 결과, 기존 안전 벤치마크 데이터가 학습 코퍼스에 포함되어 있어 성능이 과대계상되는 오염 문제가 발견되었다. 또한, 벤치마크 점수는 모델의 탐지 능력보다 학습 시 주입된 정책 정의에 따라 극단적으로 갈리는 경향을 보였다. 결론적으로 벤치마크 점수는 모델의 실질적 성능이 아닌, 어떤 정책으로 학습되었는지를 나타내는 지표로 오인될 위험이 크다.
AI 연구
자기회귀 트랜스포머 모델이 생성 과정에서 초기 프롬프트 정보를 얼마나 유지하는지 분석하고자 합니다. 서로 다른 프롬프트가 동일한 후속 텍스트를 생성할 때, 은닉 상태 간의 거리가 생성 토큰 수(t)에 따라 멱법칙 형태로 감소함을 발견했습니다. 연구 결과, 학습된 모델은 프롬프트를 빠르게 잊는 반면(α ≈ 0.55~0.7), 학습되지 않은 모델은 더 느리게 잊는 특성을 보였습니다. 이를 수학적으로 증명하기 위해 pre-LN 구조와 유한 깊이 조건을 바탕으로 프롬프트 영향력의 상한선을 도출했습니다. 결과적으로 프롬프트의 직접적 영향은 문맥이 길어짐에 따라 희석되며, 생성된 텍xt 자체가 프롬프트의 속성을 전달하는 역할을 하게 됩니다.
AI 연구
기존의 오디오-비디오 생성 모델은 부족한 쌍(paired) 데이터에 의존하여 단일 모달리티 학습에 치중하거나, 두 모달리티 간의 정보 밀도 차이를 무시한 동일한 노이즈 스케줄을 사용하여 성능 저하를 겪었습니다. 이를 해결하기 위해 UniAVC는 먼저 각 모달리티를 독립적으로 학습하여 생성 및 편집 능력을 확보한 후, 쌍 데이터를 통해 교차 모달 상관관계를 학습하는 점진적 학습 방식을 제안합니다. 또한, 정보 밀도 차이를 고려하여 모달리티별로 독립적인 노이즈 스케줄을 적용하는 비대칭 스케줄링을 도입했습니다. 이러한 방식은 한쪽 모달리티를 고정한 채 다른 쪽을 편집하거나, 만족스럽지 않은 결과물만 선택적으로 재생성하는 기능을 가능하게 합니다. 결과적으로 UniAVC는 별도의 어댑터 없이도 다양한 생성 및 편집 작업을 하나의 가중치로 수행할 수 있습니다.
AI 연구
최근 언어 모델은 선형 시간 순환 구조와 소프트맥스 어텐션을 결합한 하이브리드 아키텍처를 채택하고 있습니다. 그러나 순환 레이어가 어텐션보다 정보 검색 기능을 더 빠르게 학습하여, 어텐션이 관련 기능을 학습하지 못하게 방해하는 '경쟁적 학습(Competing Learning)' 현상이 발생합니다. 연구진은 레이어 기여도 분석을 통해 순환 레이어가 어텐션의 학습 신호를 억제함을 밝혀냈습니다. 이를 해결하기 위해 학습 중간에 순환 레이어의 업데이트를 일시 중단하여 어텐션이 학습할 기회를 주는 단계별 학습 절차를 제안합니다. 실험 결과, 최대 1B 파라미터 모델에서 언어 모델링 손실과 상식 추론, 다양한 길이의 검색 작업 성능이 크게 향상되었습니다.
AI 연구
Speculative Decoding은 Drafter가 제안한 토큰을 병렬 검증하여 LLM 추론을 가속하지만, 제안된 토큰이 앞부분에서 거부되면 이후 토큰이 유효하더라도 활용되지 못하는 문제가 있습니다. 또한, 높은 수락률(MAT)을 확보하더라도 라운드당 지연 시간이 늘어나면 전체 처리량은 오히려 감소할 수 있습니다. 이를 해결하기 위해 DScout는 학습 시 손실 함수를 포함(inclusion), 가중치(weighting), 예측(prediction) 손락으로 분해하여 접두사 수락률을 높이도록 유도합니다. 추론 시에는 처리량을 MAT와 라운드당 지연 시간의 비율로 정의하여 최적의 구성(깊이, 블록 크기 등)을 결정합니다. 실험 결과, DScout는 기존 자기회귀 디코딩 대비 최대 4배 이상의 속도 향상을 달성하며 SOTA 모델보다 우수한 성능을 보였습니다.
AI 연구
언어 에이전트 학습은 긴 과정의 롤아웃 비용이 높고, 최종 보상만 사용하는 기존 RL 방식은 중간 단계의 풍부한 정보를 활용하지 못하는 문제가 있습니다. 기존의 가치 타겟이나 관찰 타겟 방식은 단일 스칼라 신호에 의존하거나 노이즈가 많은 환경 데이터에 국한된다는 한계가 있습니다. 이를 해결하기 위해 CoPE는 성공적인 궤적에서 미래 액션 시퀀스를 생성하도록 학습하는 '멀티스텝 액션 타겟'을 제안합니다. 이 방식은 액션 수행(Acting)과 미래 예측(Forecasting)이 하나의 백본에서 상호 진화하도록 유도합니다. 실험 결과, CoPE는 기존 GRPO 및 RL 베이스라인보다 높은 성능을 보였으며, 특히 ScienceWorld 환경에서 최대 2배에 달하는 샘플 효율성을 달정을 기록했습니다. 추론 시에는 추가 오버헤드 없이 단일 정책 백본만으로 동작합니다.
AI 연구
최근 등장한 JEPA(Joint-Embedding Predictive Architectures)는 단순 표현 학습을 넘어 예측, 계획, 제어를 지원하는 잠재 세계 모델로 진화하고 있습니다. 그러나 이러한 잠재 공간은 인간이 직관적으로 이해하기 어려운 구조를 가집니다. 본 논문은 해석 가능성의 초점을 단순한 표현 디코딩에서 잠재 변수의 상호작용, 진화, 인과적 예측 능력 이해로 전환해야 한다고 주장합니다. 이를 위해 Ground, Structure, Verify, Act라는 4단계 연구 아젠다를 제안합니다. 기존의 해석 방식은 초기 단계인 Ground에 머물러 있으며, 구조적 분석과 인과적 검증 및 개입은 여전히 미개척 영역으로 남아 있습니다. 결과적으로 본 논문은 잠재 세계를 이해하고 검증하며 행동하는 데 초점을 맞춘 새로운 해석 가능성 패러다임을 제시합니다.
AI 연구
코딩 에이전트가 실패할 작업에 계속 자원을 소모하는 것은 막대한 비용 문제를 야기합니다. 기존의 거대 모델(LLM)을 활용한 모니터링은 그 자체로 비용이 높다는 단점이 있습니다. 본 논문은 완료된 궤적과 검증 결과를 학습하여 실패를 예측하는 경량 외부 모니터인 StopLoss를 제안합니다. StopLoss는 최종 결과를 기반으로 이전 단계들을 라벨링하여 학습하며, 임계값 조정을 통해 실행기 수정 없이 조기 중단 여부를 결정합니다. 실험 결과, StopLoss는 성공적인 작업의 99%를 유지하면서도 작업당 비용을 크게 절감하며 기존 LLM 판사 모델들보다 훨씬 낮은 비용으로 유효한 실패 예측 신호를 제공했습니다.
AI 연구
LLM 기반 에이전트는 뛰어난 성능을 보이지만 높은 토큰 소비와 지연 시간이라는 실무적 한계가 있습니다. 이를 해결하기 위해 대형 모델의 능력을 소형 언어 모델(SLM)로 전이하는 증류 방식이 사용되지만, 작업 과정이 길어질수록 SLM이 무의미한 루프에 빠지는 '정체 현상'이 발생합니다. 본 논문은 학생 모델의 궤적에서 정체 구간을 감지하고 페널티를 부여하는 Progress-Aware Distillation(ProD) 기법을 제안합니다. ProD는 교사와 학생 사이의 정체 격차를 적응형 마진으로 인코딩하여 학생이 교사의 행동을 점진적으로 모방하도록 유도합니다. 실험 결과, 0.6B~8B 규모의 다양한 SLM에서 성공률과 작업 완료 효율이 크게 향상됨을 확인했습니다.
AI 연구
LLM의 용량을 확장하기 위해 조건부 메모리(Conditional memory)를 사용하지만, 모든 임베딩 테이블을 유지해야 하는 메모리 부담이 발생합니다. 본 논문은 입력이 요청하는 행(row)만 재구성할 수 있는 압축 표현 방식인 Conditional Program(CP)을 제안합니다. CP는 각 행을 짧은 코드와 로컬 스케일로 표현하며, 공유된 재구성 프로그램을 통해 효율적으로 복원합니다. Gaussian trellis와 독립적 디코딩 방식을 적용한 결과, 2비트 양자화 환경에서 기존 방식 대비 KL 발산(KL divergence)을 41~63% 낮추었습니다. DeepSeek 모델 적용 시 테이블 저장 용량을 203GB에서 51GB로 대폭 절감하여 GPU 메모리 확보에 성공했습니다.
AI 연구
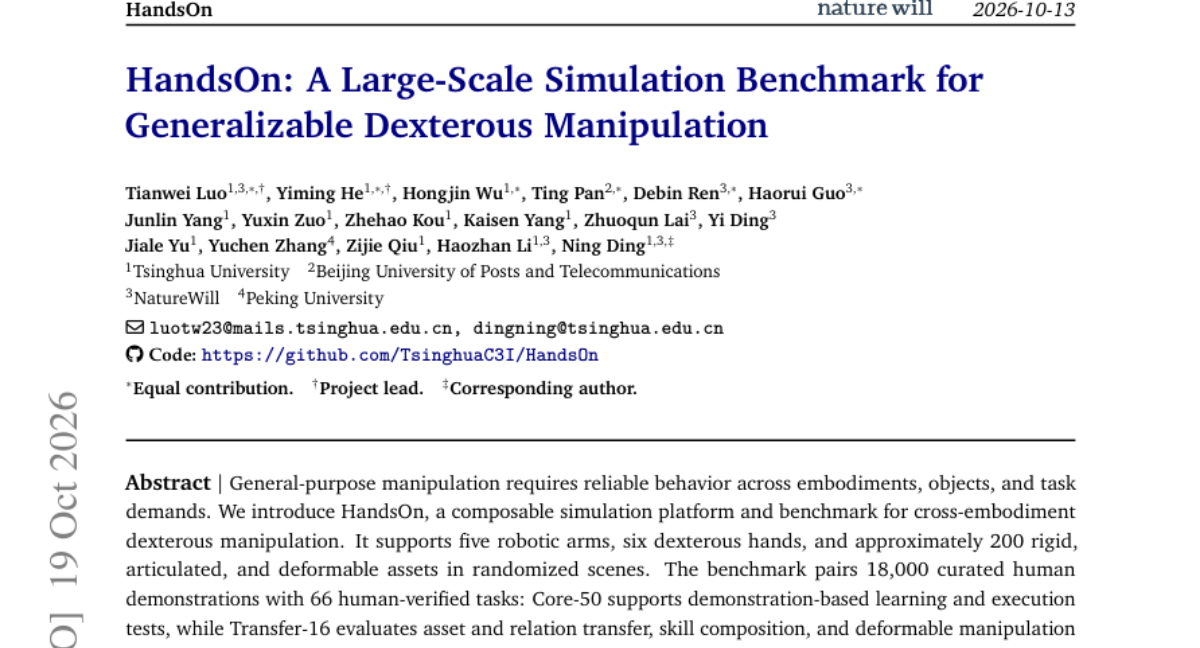
범용 조작 기술은 로봇의 형태, 물체, 작업 요구사항이 변해도 신뢰할 수 있는 동작을 수행해야 합니다. 본 논문은 다양한 로봇 팔과 손, 수많은 자산을 포함하는 합성 시뮬레이션 플랫폼인 HandsOn을 소개합니다. 이 벤치마크는 18,000개의 인간 데모와 66개의 검증된 태스크를 제공하며, Core-50과 Transfer-16이라는 두 가지 평가 체계를 통해 일반화 능력을 측정합니다. 실험 결과, 최적의 멀티태스크 정책은 Core-50에서 29.1%의 성공률을 기록했으며, LLM 기반 제어 방식과의 성능 차이를 통해 정교한 물리적 상호작용의 난이도를 입증했습니다. HandsOn은 향후 조작 일반화 연구와 물리적 상호작용의 한계를 탐구하는 데 중요한 기준이 될 것입니다.
AI 연구
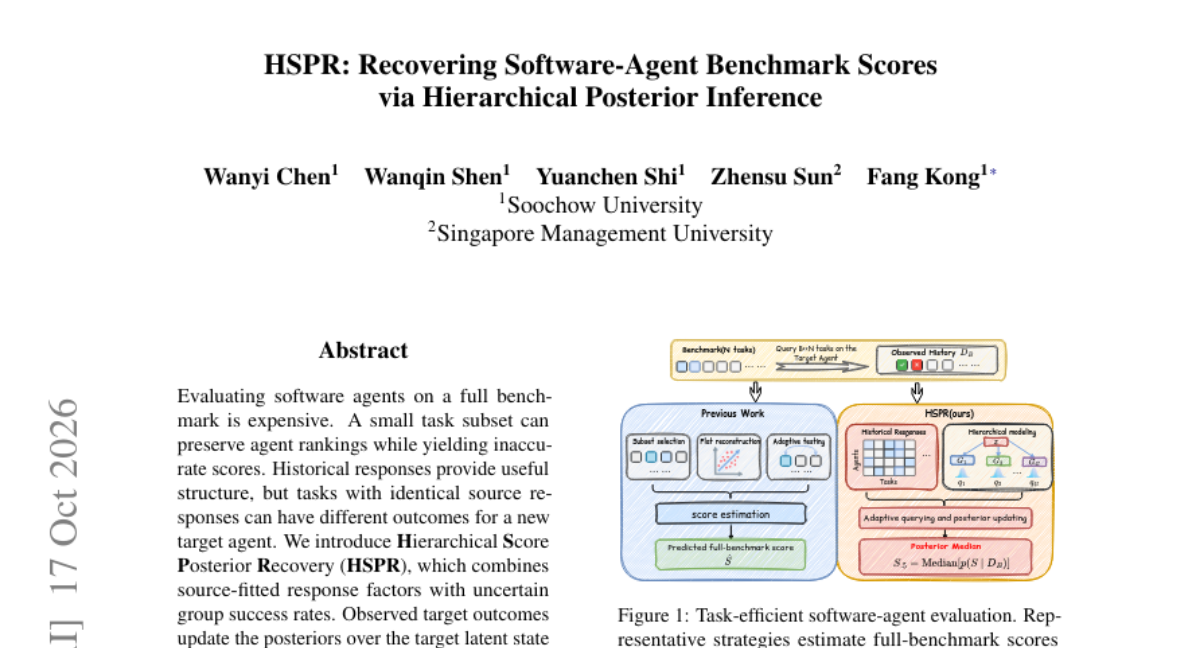
소프트웨어 에이전트의 전체 벤치마크 평가에는 막대한 비용과 시간이 소요됩니다. 일부 태스크만 평가할 경우 에이전트 간 순위는 유지될 수 있으나 개별 점수의 정확도는 떨어지는 문제가 발생합니다. 이를 해결하기 위해 HSPR은 소스 데이터의 응답 요인과 그룹별 성공률의 불확실성을 결합한 계층적 사후 추론 방식을 도입합니다. 관찰된 결과를 바탕으로 타겟 에이전트의 잠재 상태와 그룹 성공률을 업데이트하며, 사후 분포 가이드를 통해 다음 태스크를 적응적으로 선택합니다. 실험 결과, SWE-bench 계열의 벤치마크에서 10%의 적은 예산만으로도 기존 방식 대비 가장 낮은 오차(MAE)를 기록하며 우수한 성능을 입증했습니다.
30건
이날 공개된 제품과 도구
6건
새 모델과 주요 평가 결과
HF Model Trending
OpenMOSS-Team에서 공개한 MOSS-Image-SFT 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 text-to-image 파이프라인을 지원하는 약 5B 파라미터 규모의 모델입니다.
HF Model Trending
OpenMOSS-Team에서 공개한 text-to-image 모델인 MOSS-Image-Base가 Hugging Face에서 주목받고 있습니다. 약 5.08B 파라미터를 보유한 이 모델은 최근 높은 다운로드 수를 기록하며 트렌드에 진입했습니다.
HF Model Trending
black-forest-labs/flux-3-image-klein-comfy 모델이 Hugging Face에서 높은 관심을 받고 있습니다. 해당 모델은 image-to-image 파이프라인을 지원하며 많은 다운로드 수를 기록하고 있습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.