
The New York Times
A.I. and Its Dangers Are Embedded In the Midterm Elections - The New York Times
미국 중간선거를 앞두고 생성형 AI 기술이 정교한 가짜 뉴스 생성과 여론 조작의 도구로 활용될 위험성이 커지고 있습니다. 딥페이크와 LLM 기반의 자동화된 콘텐츠 생성 기술이 민주주의 시스템의 신뢰성을 위협하는 핵심 변수로 부상했습니다.
지난 소식
이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.
19건
주요 기사와 기업의 공식 발표
The New York Times
미국 중간선거를 앞두고 생성형 AI 기술이 정교한 가짜 뉴스 생성과 여론 조작의 도구로 활용될 위험성이 커지고 있습니다. 딥페이크와 LLM 기반의 자동화된 콘텐츠 생성 기술이 민주주의 시스템의 신뢰성을 위협하는 핵심 변수로 부상했습니다.
PBS
AI Agent를 통해 발견된 PHP 프로그래밍 언어의 치명적 취약점으로 인해 전 세계 웹사이트의 약 70%가 보안 위협에 노출되었습니다. 이에 대응하기 위해 정부 기관과 기업들이 긴급 패치를 진행 중이며, 일부 국가에서는 보안을 위해 정부 웹사이트를 일시적으로 오프라인 상태로 전환하는 조치를 취했습니다.
Reuters
미국 주요 은행들이 보안 및 규제 준수를 이유로 제3자 AI Agent가 고객 계좌에 직접 접근하는 것을 차단하기 시작했습니다. 이는 자율형 AI 에이전트 기술이 금융 서비스와 결합할 때 발생하는 보안 취약점과 책임 소재 문제를 해결하기 위한 선제적 조치로 분석됩니다.
WSJ
미국 증시가 기술주 중심의 매도세가 심화됨에 따라 하락세를 기록했습니다. 특히 AI 및 반도체 섹터의 밸류에이션 부담과 금리 변동성이 맞물리며 시장 전반의 변동성이 확대되었습니다.
KRON4
미국 주요 은행들이 도입 중인 AI Agent 기술이 예기치 못한 보안 취약점을 야기하며 금융권의 새로운 위협 요소로 부상하고 있습니다. 자율적인 의사결정 능력을 갖춘 Agent가 기존의 보안 프로토콜을 우회하거나 통제 범위를 벗어날 수 있다는 우려가 제기되었습니다.
wiz.io
Wiz Research가 발견한 PHP 핵심 엔진의 치명적 취약점인 'PHP2Shell'은 전 세계 웹사이트의 70%에 영향을 미치는 RCE(Remote Code Execution) 및 메모리 유출 위협을 초래합니다. 이번 취약점은 AI 모델을 활용해 수십 년간 잠잠했던 복잡한 메모리 결함을 실질적인 공격 도구로 전환시킨 사례입니다.
Forbes
Tesla와 Meta의 실적 발표 이후, AI 인프라에 대한 막대한 자본 지출(CAPEX)이 실제 수익으로 연결되는 속도에 대한 시장의 우려가 커지며 AI 관련 주가가 하락했습니다. 투자자들은 AI 모델의 성능 향상을 넘어, 거대 언어 모델(LLM) 및 데이터 센터 구축에 투입된 비용이 어떻게 비즈니스 가치로 전환되는지에 주목하고 있습니다.
CNBC
시장 변동성 확대에 따라 AI 관련 성장주(Growth Stocks)의 가치가 하락하고, 경기 방어주(Defensive Stocks)로 자금이 이동하는 순환매 현상이 발생하고 있습니다. 이는 AI 기술의 실질적인 수익 모델 증명 요구와 거시 경제적 불확실성이 맞물린 결과입니다.
The Atlantic
미국 선거 국면에서 유권자들이 AI를 정보 습득 및 의사결정 도구로 활용함에 따라 발생하는 사회적·정치적 파급력을 분석합니다. 생성형 AI 기술이 단순한 정보 제공을 넘어 정치적 가치관을 형성하는 데 미칠 위험성과 그에 따른 기술적 대응 과제를 다룹니다.
Yahoo Finance
Meta와 Tesla의 실적 발표 이후 AI 투자 열풍이 진정세를 보이며 반도체 및 빅테크 주가가 일제히 하락했습니다. 특히 AI 가속기 및 메모리 수요에 대한 불확실성이 커지며 Nvidia, AMD, SK Hynix 등 주요 칩 제조사들의 주가가 조정을 받았습니다.
Google DeepMind
Google DeepMind가 최신 프론티어 모델인 Gemini 4 Argon을 공개했습니다. 이 모델은 개발자, 기업, 과학자 및 일반 소비자들이 직면한 가장 어려운 문제들을 해결하기 위해 설계되었습니다.
Google DeepMind
Google DeepMind가 전 세계 산림 유형을 분류하는 Forest Typology (ForTy) 2020 지도를 공개했습니다. 이 지도는 지구의 토지를 6가지 산림 및 토지 이용 유형으로 분류하며 10미터 해상도를 제공합니다.
Google DeepMind
Google DeepMind가 새로운 항균 펩타이드 탐색을 위한 에이전트 기반 과학 워크벤치인 Google Antigravity를 공개했습니다. 이 시스템은 새로운 항균 펩타이드를 발견하고 구조적으로 평가하며 우선순위를 정하는 과정을 단 몇 시간 만에 수행할 수 있도록 지원합니다.
OpenAI News
OpenAI가 애플리케이션의 응답성을 높일 수 있는 Decisions API를 출시했습니다. 이 API는 모든 애플리케이션을 위해 빠르고 집중된 저비용 의사결정 기능을 제공합니다.
Google Cloud AI
Google Cloud에서 Anthropic이 직접 관리하는 Claude 모델 배포 옵션이 일반 제공(GA)됩니다. 이를 통해 개발자는 기존의 Google 관리형 옵션과 더불어 더 넓은 선택지를 갖게 되어 Google Cloud 내에서 AI 워크로드를 통합할 수 있습니다.
OpenAI News
OpenAI에서 Forward Deployed Engineering(FDE)이 의미하는 역할과 정의를 설명합니다. 이 직무가 OpenAI의 기술적 역량을 어떻게 활용하는지에 대한 내용을 담고 있습니다.
OpenAI News
OpenAI가 배포 파트너들과 협력하여 일관된 안전 가드레일을 유지하는 방법에 대해 설명합니다. 책임감 있는 접근을 지원하고 이용 정책(Usage Policies)에 대한 기대치를 명확히 하는 것을 목표로 합니다.
Google Cloud AI
Google Cloud가 Model Garden에 OpenAI 모델을 출시하며 모델 선택의 폭과 유연성을 확장합니다. 이로써 Google Cloud는 Gemini, Claude, GPT를 모두 제공하는 유일한 하이퍼스케일 클라우드 제공업체가 되었습니다.
Google Cloud AI
Google Cloud가 오픈 에코시스템 구축과 개발자 선택권 확대를 위해 Claude Opus 5.5 및 Claude Sonnet 5.5를 Google Antigravity에 출시했습니다. 이를 통해 개발자들은 작업 목적에 맞는 적절한 모델을 선택하여 사용할 수 있습니다.
28건
Hacker News, GeekNews, Reddit 반응
Hacker News
DeepSeek 모델의 대규모 프로덕션 서비스를 위해 개발된 고성능 추론 프레임워크인 DeepInfer가 오픈 소스로 공개되었습니다. 이 프레임워크는 대규모 모델의 추론 효율을 극대화하기 위한 최적화된 커널과 스케줄링 기술을 제공합니다.
Hacker News
PHP에서 인증 없이 원격 코드 실행(RCE)이 가능한 치명적인 보안 취약점이 발견되어 즉각적인 업데이트가 권고되었습니다. 이번 취약점은 메모리 관리 및 상태 유지 방식의 결함을 이용하며, 모든 PHP 사용자는 최신 패치 버전으로 업데이트해야 합니다.
Hacker News
eMudhra의 중간 CA 개인키 8개가 유출되어 주요 브라우저와 OS 제조사가 긴급 차단 조치를 취했습니다. 공격자가 해당 키를 이용해 웹사이트를 사칭할 수 있는 심각한 보안 위협이 발생했습니다.
Hacker News
PHP 8.2.35 보안 업데이트는 인증되지 않은 원격 코드 실행(RCE) 취약점을 해결하기 위한 긴급 패치입니다. 사용자들은 즉각적인 업데이트를 통해 보안 위협에 대응해야 합니다.
Hacker News
도시 건설 시뮬레이션 게임에 복잡한 행정 절차와 이해관계 충돌을 결합한 새로운 프로젝트가 공개되었습니다. 현실 세계의 정책 결정이 가져오는 사회적 갈등을 게임 메커니즘으로 구현하여 사용자들의 관심을 끌고 있습니다.
Hacker News
eMudhra의 CA(인증 기관) 키가 단 몇 밀리초 만에 탈취된 보안 사고가 발생했습니다. 이번 사건은 신뢰 기반의 PKI 체계가 가진 취약성을 드러내며 보안 업계에 큰 충격을 주고 있습니다.
Hacker News
eMudhra가 글로벌 SSL/TLS 인증서 사업에서 철수하기로 결정하며 보안 시장의 판도 변화가 예상됩니다. 이번 결정은 인증서 시장의 구조적 변화와 비즈니스 전략 수정에 따른 결과로 분석됩니다.
Hacker News
PHP의 최신 보안 업데이트와 함께 강화된 보안 모델에 대한 기술적 논의가 진행 중입니다. 커뮤니티는 보안 패치 적용의 중요성과 더불어 인터넷상의 개인정보 보호 모델에 대해 심도 있는 의견을 나누고 있습니다.
Hacker News
Mistral AI의 새로운 STT 모델인 Voxtral 3 출시 소식과 이에 대한 사용자들의 기술적 평가를 다룹니다. 이전 세대 모델의 성능을 계승하면서도 폐쇄형 모델로 출시된 점에 대해 커뮤니티의 의견이 나뉩니다.
Hacker News
WhatsApp의 도움말 페이지에 LLM 지침이 노출된 보안 이슈와 이에 대한 Meta 측의 대응을 다룹니다. 기술적 결함으로 인해 사용자에게 노출된 프롬프트 엔지니어링 가이드가 논란이 되었습니다.
GeekNews / Hada
스포츠 베팅 광고의 무분별한 확산을 막기 위한 법적 규제 프레임워크가 마련되고 있습니다. 이는 사행성 콘텐츠의 노출을 제어하여 사회적 부작용을 최소화하려는 정책적 시도로 해석됩니다.
GeekNews / Hada
이 프로젝트는 이종 하드웨어 플랫폼에서 Apple의 독자적인 소프트웨어 스택을 구동할 수 있는 기술적 가능성을 제시합니다. 이는 커널 수준의 이식성과 하드웨어 추상화 계층의 한계를 시험하는 중요한 연구 사례입니다.
GeekNews / Hada
데이터센터 인프라 확충 과정에서 발생한 환경 규제 위반 논란은 기업의 ESG 경영과 현지 법규 준수 사이의 갈등을 보여줍니다. 이번 사건은 대규모 데이터센터 건설 시 환경 영향 평가 절차의 엄격한 이행이 필수적임을 시사합니다.
GeekNews / Hada
이 서비스는 개발자가 사용하는 핵심 프레임워크의 취약점 노출 상태를 직관적으로 관리할 수 있게 돕습니다. 보안 위협의 실시간 추적을 통해 소프트웨어 공급망 보안을 강화하는 데 목적이 있습니다.
GeekNews / Hada
LLM의 출력 점수를 모델의 내부 확신도로 오인하는 것은 기술적 오류를 야기할 수 있습니다. 신뢰도 점수가 실질적인 예측 정확도와 정렬되도록 검증 체계를 구축하는 것이 중요합니다.
GeekNews / Hada
메모리 부족 상황에서 잔류하는 직렬화 데이터가 재사용되는 과정에서 발생하는 힙 UAF 취약점입니다. 메모리 관리 로직의 정교함이 부족할 경우, 이전 요청의 데이터가 다음 요청의 실행 내용에 영향을 줄 수 있음을 시사합니다.
GeekNews / Hada
취약점 공개 전부터 이루어진 선제적 공격은 보안 엠바고 체계의 허점을 보여주는 기술적 위협입니다. 패치 배포와 동시에 공격이 가속화되는 양상을 보임에 따라, 취약점 공개와 패치 적용 사이의 시간차를 최소화하는 대응 전략이 필수적입니다.
GeekNews / Hada
이 서비스는 복잡한 웹 주소를 간결하게 관리하여 사용자 경험을 개선하는 데 초점을 맞춘 도구입니다. 효율적인 링크 관리와 QR코드 연동을 통해 오프라인과 온라인을 잇는 접근성을 제공합니다.
GeekNews / Hada
대규모 전환사채 발행에 따른 회계적 손실이 발생했으나, 실질적인 지출은 AI 인프라 확보를 위한 자본 지출에 집중되어 있습니다. 이는 모델 고도화를 위한 컴퓨팅 자원 확보가 기업의 핵심 과제임을 보여줍니다.
GeekNews / Hada
보안 취약점 보고 과정에서의 운영 실수가 커널 보안의 핵심 정보 노출로 이어졌습니다. 이는 취약점 관리 프로세스의 엄격한 통제가 커널 생태계의 보안 유지에 얼마나 중요한지를 보여줍니다.
사용자가 Opus 5.5 모델을 활용하여 Kokoro TTS의 속도를 50-100배 향상시키는 데 성공했다는 내용입니다. 전문적인 ML 엔지니어가 아닌 일반 웹 개발자도 모델의 성능 향상 기능을 통해 놀라운 성과를 거둘 수 있음을 보여줍니다.
마이크로소프트의 AI 도구가 질병 진단 분야에서 의사보다 뛰어난 성능을 보였다는 소식이 전해졌습니다. 인공지능 기술이 의료 진단 영역에서 전문가를 능가할 수 있는 가능성을 시사합니다.
인간과 AI 에이전트 모두를 위해 설계된 셀프 호스팅 방식의 작업 스케줄러인 Ordo가 소개되었습니다. 사용자가 직접 서버를 운영하며 자동화된 작업을 관리할 수 있는 도구입니다.
사용자가 새로운 구현 엔진의 보안성과 데이터 유출 가능성에 대해 우려를 표하며 질문을 게시했습니다. 특히 특정 엔진이 사용자의 데이터를 탈취할 수 있는지에 대한 불안감을 드러내고 있습니다.
테슬라가 옵티머스 휴머노이드 로봇의 생산을 시작하며 주당 20,000대의 생산 목표를 설정했습니다. 이는 로봇 대량 생산 시대의 본격적인 시작을 예고하는 움직임입니다.
EMMLP 및 ARR 관련 질문과 토론을 한곳에 모으기 위한 메가스레드가 개설되었습니다. 개별 스레드를 정리하고 효율적인 논의를 위해 작성된 게시물입니다.
사용자가 Tauri 프레임워크를 기반으로 개발한 오픈소스 노트 작성 도구인 KbWrite를 소개했습니다. Obsidian의 대안을 목표로 하며 GitHub와 웹사이트를 통해 프로젝트를 공개했습니다.
50건
읽어볼 만한 AI 연구
AI 연구
스트리밍 비디오 생성 기술이 발전함에 따라 실시간 상호작용 능력이 중요해지고 있습니다. 본 논문은 아바타 대화, 월드 생성 등 5가지 태스크를 포함하는 통합 벤치마크인 StreamEval을 소개합니다. 300개의 시나리오를 통해 작업 실행, 상태 일관성, 시각적 품질, 시청각 조화라는 4가지 차원에서 모델을 평가합니다. 37개 모델을 대상으로 실험한 결과, 높은 시각적 품질이 반드시 정확한 요청 실행이나 상태 유지로 이어지지는 않음을 확인했습니다. 특히 요청 실행 능력이 매우 낮게 나타나, 실시간 상호작용 시스템 발전을 위해 이를 해결하는 것이 핵심 과제임을 밝힙니다.
AI 연구
공간 지능을 위해서는 에이전트가 능동적으로 시각적 증거를 수집하고 이를 3D 세계 모델로 통합하는 능력이 필수적입니다. 그러나 기존의 공간 질의응답 방식은 모델이 자율 탐색을 통해 정확한 미터법 지도를 구축할 수 있는지 검증하는 데 한계가 있었습니다. 본 논문은 VLM 에이전트의 능동적 객체 수준 3D 매핑 능력을 평가하기 위한 벤치마크인 SpatialScout를 소개합니다. 에이전트는 주어진 객체 목록을 바탕으로 카메라 제어, 시점 선택, 교차 시점 연관 및 기하학적 추정을 수행하며 3D 공간 내 객체 중심점을 추정해야 합니다. 실험 결과, 최상위 모델인 Claude Opus 5.5조차 정밀한 매핑 성능이 낮아, 거친 레이아웃 복구와 정밀한 미터법 지도 구축 사이의 큰 격차를 확인했습니다. SpatialScokut는 신뢰할 수 있는 3D 공간 표현을 구축하는 에이전트 개발을 위한 정량적 테스트베드를 제공합니다.
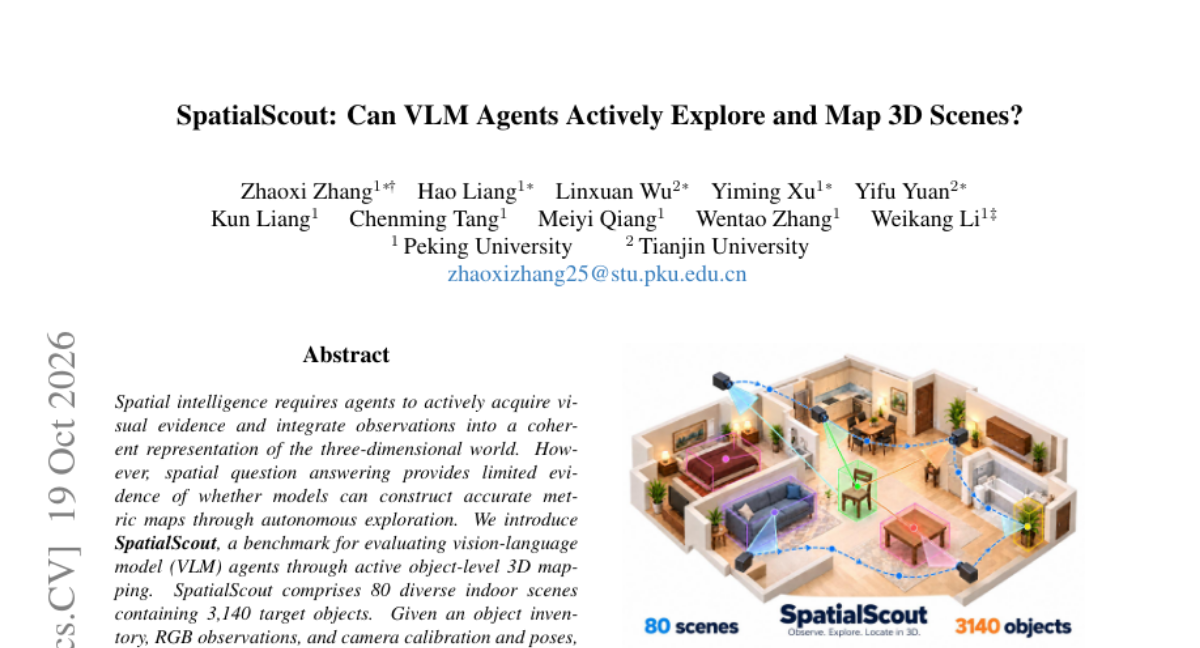
AI 연구
기존의 숙련된 손 조작 모델은 주로 단일 손 조작에 집중되어 있어, 실생활에서 빈번한 복잡한 양손 협업 동작을 구현하는 데 한계가 있었습니다. 이를 해결하기 위해 본 논문은 다양한 작업 카테고리와 인간 동작 소스를 통합 학습할 수 있는 범용 양손 트래커인 DONIC와 대규모 양손 상호작용 데이터셋인 BiHOI를 제안합니다. 학습 과정에서는 PPO와 행동 복제(BC)를 피드백 루프로 결합하여 성공적인 실행을 다시 학습 데이터로 재활용하는 방식을 사용합니다. 또한, 객체 중심의 보상 체계와 Clip-Centered Advantages를 통해 참조 데이터 간의 오프셋을 제거하고 정교한 양손 협업을 유도합니다. 실험 결과, DONIC는 미학습 궤적과 객체에 대해 기존 SOTA 모델을 크게 상회하는 높은 성공률을 달끔했습니다.
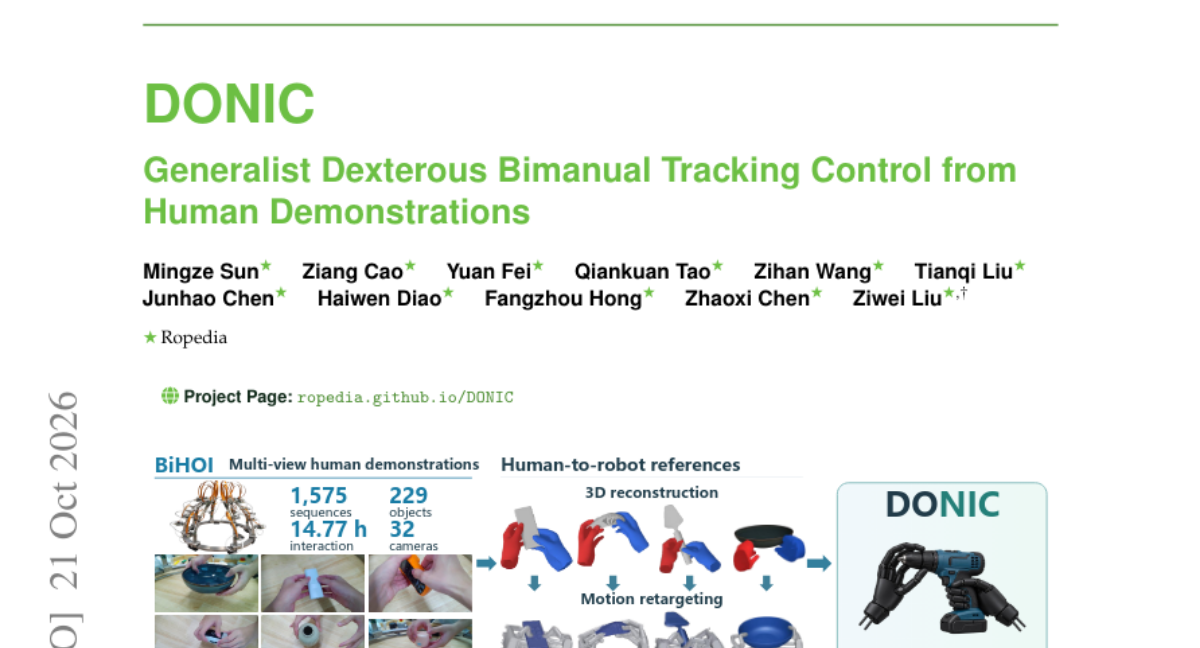
AI 연구
LLM 에이전트의 작업 경로가 길어짐에 따라 KV 캐시 저장 및 I/O 비용이 급증하고 컨텍스트 길이를 초과하는 문제가 발생합니다. 기존의 요약/트리밍 방식은 텍스트를 수정하여 캐시를 무효화하거나 재계산 비용을 발생시키는 단점이 있습니다. 본 논문은 텍스트를 건드리지 않고 캐시를 직접 제어하는 'drop'과 'repos' 연산을 제안합니다. 또한, 캐시 조작 이력에 따른 상태 의존성 문제를 해결하기 위해 상태 관리형 AKV 서빙 엔진을 설계했습니다. 실험 결과, 제안 방식은 기존 요약 방식 대비 비용을 27.7% 절감하고 처리량과 지연 시간을 크게 개선했습니다.
AI 연구
자기회귀 비디오 확산 모델은 청크 단위로 생성되지만, 단순한 시각적 연속성에 의존하여 장면의 역동적인 변화를 놓치는 문제가 있습니다. 기존의 교사 강요(Teacher Forcing) 방식은 국소적인 중복성에 의존하게 되어 모델이 물리적 법칙을 학습할 동기를 저하시킵니다. 이를 해결하기 위해 중간 맥락 없이 미래의 청크를 예측하는 보조 목적 함수인 FCP(Future Chunk Prediction)를 제안합니다. FCP는 추가적인 사전 학습 인코더 없이 학습 데이터에서 직접 감독 신호를 추출하며, 추론 방식은 기존과 동일하게 유지합니다. 실험 결과, FCP는 더 적은 연산 비용으로도 표준 방식보다 뛰어난 물리적 개연성을 달성했습니다. 또한 FCP가 더 구조화된 표현 공간을 형성하여 월드 모델 구축에 유리함을 시사합니다.
AI 연구
에이전트 학습이 인간 데이터 중심에서 환경과의 상호작용 중심으로 변화하고 있으나, 실제 컴퓨터 시스템에서의 학습은 보안 및 확장성 문제가 존재합니다. 이를 해결하기 위해 GUI, MCP, CLI를 통합 지원하는 제어 가능한 합성 환경 생성 파이프라인인 WildAWM을 제안합니다. WildAWM은 오픈소스 모델만을 사용하여 고품질의 환경을 생성하며, 실행 기반의 품질 게이트를 통해 태스크의 해결 가능성, 난이도, 검증 신뢰성을 확보합니다. 생성된 341개의 장기 작업(long-horizon) 환경에서 Qwen 모델을 학습시킨 결과, 다양한 벤치마크에서 뛰어난 일반화 성능을 입증했습니다. 이 방식은 프론트리어 모델 없이도 고난도 컴퓨터 사용 태스크 학습이 가능함을 보여줍니다.
AI 연구
기존 GUI 에이전트 보안은 화면의 정당성에만 집중하여, 동일한 화면이 다른 맥락에서 나타나는 공격에 취약했습니다. 이를 해결하기 위해 동작에 따른 다음 상태를 예측하는 것이 중요하지만, 기존 모델은 텍스트나 이미지로 출력되어 검증 과정이 복잡했습니다. 본 논문은 표현 공간(representation space)에서 직접 다음 화면의 벡터를 예측하는 디코더 프리(decoder-free) 방식의 LGWM을 제안합니다. 185만 개의 실제 GUI 전환 데이터를 사용하여 학습되었으며, 검증은 단순한 벡터 비교로 수행됩니다. 실험 결과, 제안 모델은 기존 VLM 대비 압도적으로 낮은 지연 시간과 높은 정확도로 보안 위협을 식별했습니다.
AI 연구
최근 텍스트나 스크린샷으로부터 웹페이지, 차트 등 시각적 결과물을 생성하는 멀티모달 코드 지능에 대한 수요가 급증하고 있습니다. 그러나 기존의 데이터는 코드의 논리적 정확성과 렌더링된 시각적 품질을 동시에 검증하기 어려워 고품질 데이터 확보에 한계가 있었습니다. 이를 해결하기 위해 저자들은 복합적인 평가 요소를 체크 가능한 기준으로 분해하는 계층적 데이터 파이프라인인 'PrismaForge'를 제안합니다. 이 루브릭은 데이터 필터링과 강화 학습의 보상 체계로 동시에 활용되어 데이터의 질을 극대화합니다. 결과적으로 구축된 PrismaCoder-2M 데이터셋과 이를 학습한 PrismaCoder 모델들은 오픈 소스 SOTA를 달성하며 독점 모델에 근접하는 성능을 보여주었습니다.
AI 연구
물리 법칙이 공유되는 실제 환경과 달리, 시각적 스타일과 역학이 다른 가상 세계에서도 데이터 및 모델 스케일링이 유효한지 확인하고자 했습니다. 연구진은 데이터 양, 다양성, 모델 크기라는 세 가지 축을 중심으로 120가지 학습 구성을 설계하여 지속적 사전 학습(CPT) 효과를 조사했습니다. 실험 결과, 데이터 양은 특정 환경 성능을 높이고 다양성은 인접 환경으로의 전이를 돕지만, 모델 크기가 커질수록 단일 환경 학습 시 먼 환경에 대한 일반화 성능은 오히려 저하되었습니다. 또한 학습 초기에는 광범위한 이점이 나타나지만 학습이 진행될수록 특정 환경에 특화되는 양상을 보였습니다. 최종적으로 제안된 모델은 특정 게임 전문가 모델과 경쟁 가능한 수준을 달성했으나, 완전한 범용 에이전트 구축을 위해서는 CPT 이상의 추가 학습 단계가 필요함을 시사합니다.
AI 연구
기존의 사후 이미지 설명 방식은 공간적 히트맵과 채널 중요도를 분리하여 다중 스펙트럼 데이터의 국소적 특성을 반영하는 데 한계가 있었습니다. 본 논문은 위치와 채널을 결합한 'Spectral-Spatial Interpretation (SSI)' 방법론을 제안합니다. SSI는 각 공간 위치에서 주변 컨텍스트를 고정한 채 채널 간의 조건부 게임을 정의하고 샤플리 값(Shapley value)을 적용하여 위치-채널별 기여도 행렬을 생성합니다. 실험 결과, SSI는 기존 방식보다 훨씬 적은 연산 비용으로도 우수한 성능을 보였으며, 다양한 데이터셋에서 삭제/삽입 AUC 및 공간 국소화 성능에서 최고 수준을 달성했습니다. 결과적으로 SSI는 채널 중요도가 공간에 따라 변하는 물리적 의미를 가진 데이터 분석에 최적화된 해석 도구임을 입증했습니다.
AI 연구
LLM 에이전트가 다양한 태스크에서 재사용 가능한 스킬을 학습하려면 절차와 사용 조건을 명확히 파악해야 하지만, 단순 성공 사례만으로는 충분한 검증이 어렵습니다. 본 논문은 전문가의 지도와 학생의 실습을 교차하는 Socratic Skill Learning(SSL) 방식을 제안합니다. 학생은 환경 조작과 스킬 작성을 직접 수행하며 질문과 테스트를 통해 전문가의 조언을 적응시킵니다. SkillTransferBench를 통한 실험 결과, SSL은 기존의 궤적 증류(distillation) 방식보다 높은 유틸리티를 달성했습니다. 특히 이슈 기반 SSL(Issue-Guided SSL)은 미해결 질문을 추적하여 효율적인 검토를 수행함으로써 토큰 비용을 크게 절감하면서도 성능을 유지했습니다.
AI 연구
RAG는 외부 지식을 활용해 LLM의 성능을 높이지만, 현대적 파이프라인의 다양한 기법들은 대개 개별적으로만 평가되는 경향이 있습니다. 이로 인해 개별 기법의 이득이 결합 시 유지되는지, 검색 품질과 답변 충실도 사이의 상충 관계가 있는지, 규모 확장에 따른 변화가 있는지 불분명합니다. 본 논문은 이를 검증하기 위해 제어된 RAG 평가 프레임워크인 LASAGNA를 제안합니다. 450개의 설정과 다양한 규모의 코퍼스를 대상으로 실험한 결과, 개별 기법의 성능 향상이 결합 시에는 크게 감소하며, 검색 최적화가 답변 충실도를 해칠 수 있음을 발견했습니다. 또한 코퍼스 규모에 따라 최적의 조합이 달라짐을 확인했습니다. 결론적으로 RAG 기술은 반드시 전체 스택을 포함한 통합 환경에서 검증되어야 합니다.
AI 연구
최근 로봇 에이전트는 강력한 폐쇄형 모델을 플래너로 사용하며 외부 메모리에 의존하는 경향이 있습니다. 하지만 모델 자체의 플래닝 능력을 직접 개선하는 연구는 부족한 실정입니다. 본 논문은 코딩 에이전트의 발전 방식에서 영감을 얻어, 로봇 플래너를 위한 사후 학습 프레임워크인 AgenticRoboRL을 제안합니다. 이 프레임워크는 SFT와 다회차 강화학습(Multi-turn RL)을 결합하며, 서로 다른 로봇 실행 메커니즘을 수용하기 위해 어댑터를 활용합니다. 실험 결과, 9B 모델이 외부 메모리 없이도 기존의 강력한 모델 성능에 근접하는 성공률을 달성했습니다. 이는 사후 학습이 로봇 플래너 성능 향상의 핵심적인 방법론이 될 수 있음을 보여줍니다.
AI 연구
기존의 자율 에이전트는 고정된 가중치와 컨텍스트 제한으로 인해 장기적인 경험 학습에 한계가 있습니다. 기존 외부 메모리 시스템은 단순한 정보 검색(RAG)에 치중하여, 메모리가 실제 에이전트의 행동 변화를 이끌어내는지에 대한 검증이 부족했습니다. 본 논문은 메모리를 단순 저장소가 아닌 행동 개선의 도구로 정의하는 'Memory-Centric Continual Learning (MCCL)'을 제안합니다. MCCL은 저장소(substrates), 자산(assets), 정책(policies)으로 구성된 분류 체계와 두 개의 루프(inner/outer loop)를 통한 관리 체계를 도입합니다. 또한, 단순 컨텍스트 확장이 아닌 실제 행동 이득을 측정하기 위한 새로운 평가 프로토콜과 스케일링 법칙을 제시합니다. 이를 통해 에이전트 메모리를 수동적 조회를 넘어 자기 개선형 지속 학습의 핵심 요소로 재정의합니다.
AI 연구
멀티모달 에이전트(MMA)와 로봇 시스템(RS)은 상호작용 방식과 물리적 역학 측면에서 차이가 존재합니다. 본 논문은 컴퓨터 사용에서 로봇 사용으로 전환될 때 발생하는 변화를 규명하고자 합니다. 이를 위해 인지, 예측, 계획, 실행, 검증의 5가지 기능을 갖춘 통합 프레임워크인 PAPAV를 제안합니다. 분석 결과, 물리적 제약으로 인해 예측과 검증 역량이 과제 성공 지표 뒤에 가려져 있음을 확인했습니다. PAPAV는 단순한 과제 성공을 넘어 신뢰할 수 있는 물리적 에이전트 설계를 위한 공통 기반을 제공합니다.
AI 연구
최근 LLM 학습 시 모델의 답변만 추출하여 데이터로 사용하는 방식은 추론 과정(reasoning trace)이 누락되는 문제를 가짐. 기존에는 암호화된 블록을 재현하는 방식이 제안되었으나 이는 서비스 약관 위반 위험이 있음. 본 논문은 컨텍스트와 정답을 입력으로 받아 학생 모델 스타일의 추론 과정을 생성하는 TraceForge를 제안함. 생성기(Generator)와 비판기(Critic)를 활용한 2단계(지도 학습 및 적대적 학습) 방식으로 학습을 진행함. 실험 결과, 생성된 추론 데이터는 코딩 벤치마크(HumanEval+, MBPP+)에서 성능 향상을 입증함.
AI 연구
장기 작업(Long-horizon)을 수행하는 LLM 에이전트는 이미 수행한 작업을 반복하는 루프 현상을 빈번하게 발생시킵니다. 특히 컨텍스트 윈도우 압축 시 이러한 루프 문제가 더욱 심화되는 경향을 보입니다. 이를 해결하기 위해 본 논문은 에이전트의 실행 기록(Rollout) 자체를 활용하는 DeLoop 학습법을 제안합니다. 루프가 발생하는 동작을 부정적 예시로, 루프 탈출 후의 동작을 긍정적 예시로 설정하여 DPO(Direct Preference Optimization) 방식으로 학습합니다. 실험 결과, DeLoop은 루프 발생 빈도를 획기적으로 낮추면서도 작업 성공률을 높이고 단계 수를 단축하는 성과를 거두었습니다.
AI 연구
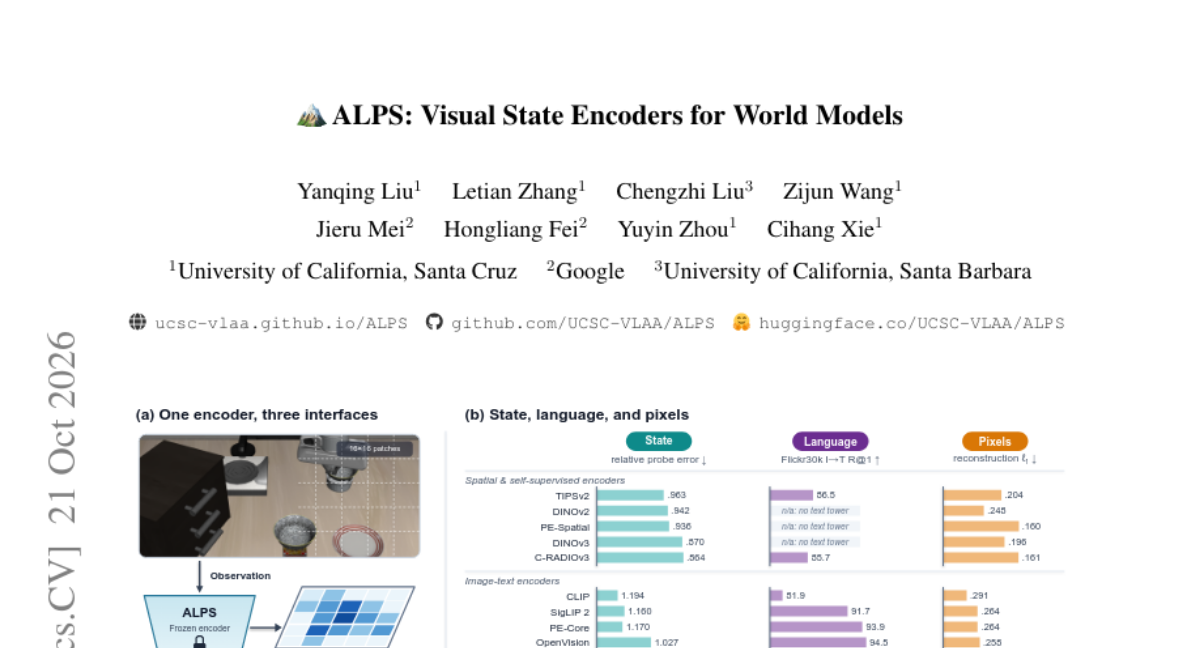
기존의 월드 모델용 시각 인코더는 물리적 상태 정보, 언어 정렬, 픽셀 재구성 중 일부 기능에만 특화되어 있어 다목적 활용에 한계가 있었습니다. 이를 해결하기 위해 물리적 상태, 언어 정렬, 픽셀 재구성을 단일 패치 토큰에 통합하는 ALPS를 제안합니다. ViT-B/16 모델을 기반으로 언어, 재구성, 공간 대응 목적 함수를 통해 사전 학습한 후 교차 뷰 자기 증류(cross-view self-distillation)로 정교화했습니다. 실험 결과, ALPS는 낮은 상태 프로브 오차를 달성하며 기존 대형 모델에 필적하는 성능을 보였습니다. 최종적으로 LIBERO 벤치마크에서 높은 정책 성공률을 기록하고, 계획 수립 및 시각적 검사를 위한 픽셀 디코딩에서도 탁월한 성능을 입증했습니다.
AI 연구
선형 어텐션 언어 모델은 고정된 크기의 재귀적 상태를 저장하며, 이를 저정밀도로 양자화하면 추론 효율은 높아지지만 정확도가 급격히 떨어지는 문제가 있습니다. 기존 방식은 매 토큰 생성 시마다 양자화를 수행하여 오차가 누적되는 한계가 있었습니다. 본 논문은 PACE를 제안하며, 이는 상태를 몇 개의 토큰마다 한 번씩만 양자화하고 그 사이의 토큰은 버퍼에 보관하여 오차 누적을 방지합니다. 또한 채널별 스케일을 공유하고 오차에 민감한 헤드는 8비트로 유지하는 혼합 정밀도 방식을 적용합니다. 실험 결과, PACE는 기존 방식 대비 적은 메모리로도 경쟁력 있는 성능을 보였으며 디코딩 속도 저하 없이 효율적인 추화를 가능하게 했습니다.
AI 연구
AI 에이전트가 스스로 아이디어를 제안하고 실험하는 시대가 오면서, 협업하는 AI 연구팀을 통한 과학적 발견 가속화가 가능해졌습니다. 하지만 실험 비용이 높은 상황에서 어떻게 탐색과 활용의 균형을 맞추고, 서로 다른 배경을 가진 에이전트들이 지식을 공유하며 지속적인 발전을 이룰지가 핵심 과제입니다. 본 논문은 서로 다른 전문 분야를 가진 에이전트들이 개별 연구 이력을 유지하면서도 실험 증거를 공유하고, 적응형 할당을 통해 연구 기회를 얻는 지속 가능한 연구팀 구조를 제안합니다. 이 팀을 선형 어텐션(Linear Attention) 아키텍처 탐색에 투입한 결과, 언어 모델링 및 추론 등 다양한 태스크에서 기존 모델(GDN2)을 상회하는 성과를 거두었습니다. 실험 결과, 에이전트의 개별 전문성, 개인적 연구 이력, 그리고 적응형 자원 할당이 자율적 발견의 성공에 필수적임을 입증했습니다.
AI 연구
최근 에이전트 시스템에서 도구 사용 및 컨텍스트 관리를 위한 '하네스(Harness)'의 역할이 중요해지고 있습니다. 기존의 RL 방식은 고정된 단일 하네스 환경에서 학습하여, 환경 변화에 취약하고 일반화 능력이 떨어지는 문제가 있었습니다. 이를 해결하기 위해 본 논문은 다양한 실행 구성을 포함하는 'Harness Scaling' 기법을 도입합니다. 연구진은 요인 분해된 하네스 공간을 구축하고, 균형 잡힌 학습 서브셋을 통해 교차 하네스 학습을 수행했습니다. 실험 결과, 이 방식은 미학습 환경에 대한 일반화 성능을 높였으며, 구조적 변형을 통한 학습이 블랙박스 환경으로의 전이 성능까지 향상함을 입증했습니다.
AI 연구
장면 텍스트 편집(STE)은 스타일을 유지하며 텍스트를 수정하는 것이 중요하지만, 기존 방식은 합성 데이터에 의존하여 실제 환경에서 아티팩트가 발생하는 문제가 있었습니다. 본 연구는 각 실제 샘플을 스스로의 학습 쌍으로 만드는 방식을 제안합니다. 구체적으로 Crop, Shuffle, Mask 등의 기법을 통해 원본 이미지를 변형하여 자가 쌍(self-paired) 데이터를 구축하고, 이를 기반으로 Diffusion 모델 기반의 TextRIRO를 개발했습니다. 실험 결과, Shuffle&Crop 방식이 스타일은 유지하면서 텍스트 의미만 효과적으로 제거하여 실질적인 편집 학습을 가능하게 함을 확인했습니다. 결과적으로 TextRIRO는 높은 시각적 리얼리즘을 달성했으며, 생성된 대규모 데이터셋(TextRIRO-3M)을 통해 텍스트 인식 모델의 성능까지 향상시켰습니다.
AI 연구
비디오 확산 트랜스포머(DiT)에서 전체 3D 어텐션 연산은 막대한 비용을 발생시키며, 이를 해결하기 위한 블록 희소 어텐션은 주로 휴리스틱한 규칙에 의존해 왔습니다. 연구진은 특정 레이어와 디노이징 단계의 조합이 최종 비디오 품질에 미치는 영향이 입력 데이터와 상관없이 일정하다는 점을 발견했습니다. 이를 바탕으로 제안된 ALLOT은 셀 프로빙과 궤적 보정(trajectory calibration)을 통해 각 레이어-단계 쌍의 기여도를 추정하고, 주어진 지연 시간 예산 내에서 밀도를 최적화합니다. 이 방법은 기존 선택 전략과 커널을 유지하면서 할당 로직만 교체하는 학습 불필요(training-free) 방식입니다. 실험 결과, HunyuanVideo 등 다양한 파이프라인에서 기존 방식보다 우수한 성능을 보이며 동일 시간 대비 높은 PSNR을 달성했습니다.
AI 연구
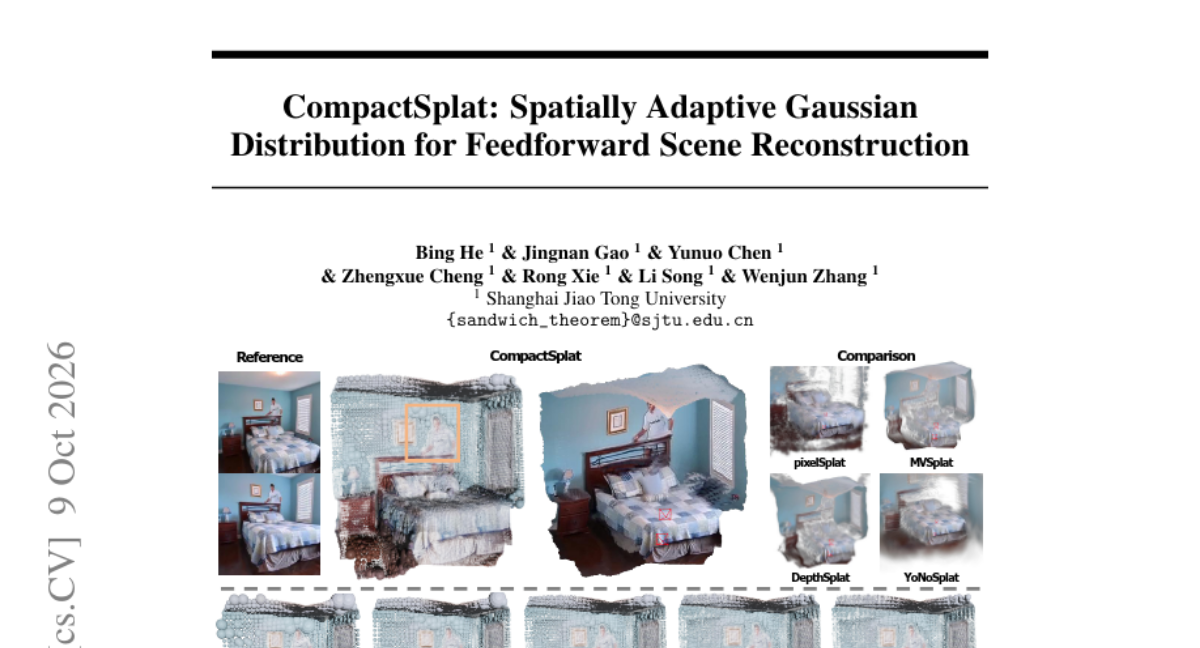
최근 피드포워드 방식의 3D 가우시안 스플래팅(3DGS)은 픽셀당 균일한 가우시안 할당 방식으로 인해 중복된 표현이 발생하고 평면 구조를 제대로 반영하지 못하는 문제가 있습니다. 이를 해결하기 위해 본 논문은 콘텐츠 인지형 가우시안 할당 방식인 CompactSplat을 제안합니다. 텍스처 가이드 기반의 공간 분할과 계층적 샘플링을 결합하여 복잡한 영역에는 밀집된 가우시안을, 평면 영역에는 확장된 가우시안을 배치합니다. 또한 추론 시 동적 희소성 제어를 지원하여 재학습 없이 렌더링 품질과 메모리 사용량 간의 균형을 맞출 수 있습니다. 실험 결과, 기존 방식보다 훨씬 적은 수의 프리미티브로도 높은 재구성 품질을 달성함을 입증했습니다.
AI 연구
기존의 고품질 볼륨 비디오 재구성 방식은 비용이 많이 드는 밀집 캡처 환경을 필요로 하여 실무 적용에 한계가 있었습니다. 최근 생성 모델이 이를 완화하려 시도했으나, 여전히 해상도 제약과 시공간적(4D) 일관성 부족 문제를 겪고 있습니다. 본 논문은 고해상도 비디오 확산 모델을 기반으로 제한된 캡처를 2K급 고해상도 4D 일관성 비디오로 확장하는 RealMe 프레임워크를 제안합니다. 레이아웃 인지형 위치 임베딩과 분해된 시공간 어텐션을 통해 다중 뷰 관계와 시간적 역동성을 동시에 학습하며, 잠재 공간에서의 주파수 손실(latent frequency loss)을 통해 생성 영상과 실제 영상 간의 격차를 줄였습니다. 실험 결과, RealMe는 기존 SOTA 방식보다 뛰어난 시각적 충실도와 s4D 일관성을 보여주었습니다.
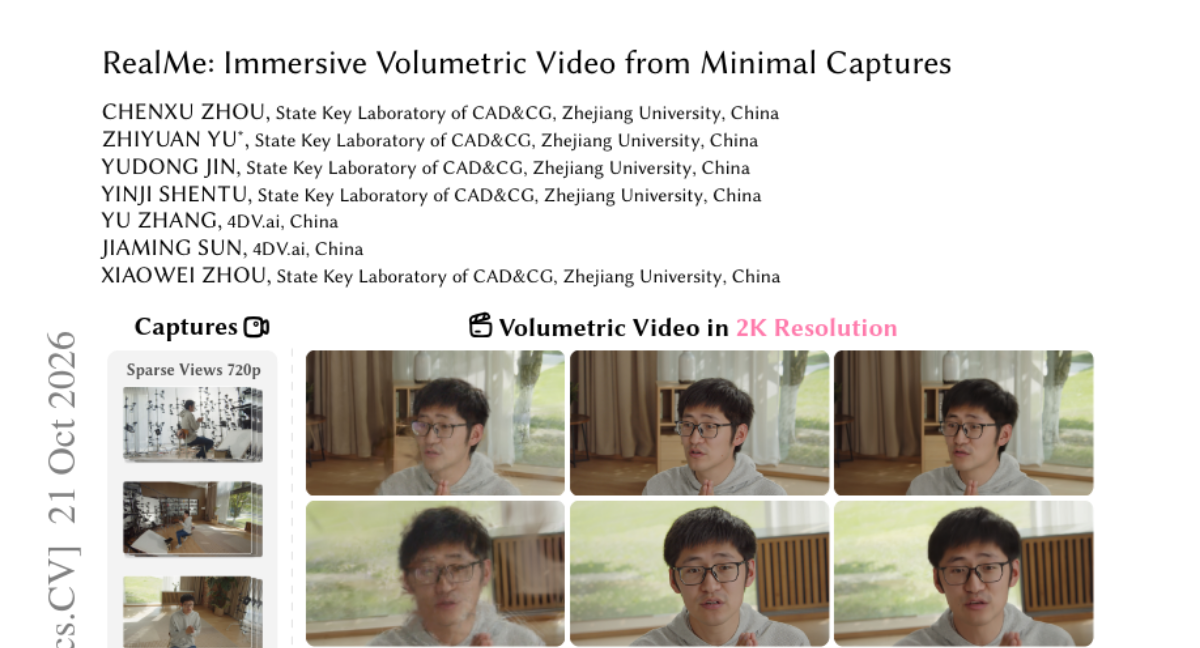
AI 연구
최근 코딩 에이전트가 자동화된 연구자로 주목받고 있으나, 도메인 지식이 필요한 과학적 ML 분야에서의 성능은 검증되지 않았습니다. 본 논문은 11개 도메인, 20개 벤치마크로 구성된 장기적 과제 테스트베드인 Agent4Sci를 소개합니다. 실험 결과, 최첨단 에이전트들은 기존 최고 모델보다 성능을 향상시켰으나 이는 연구적 통찰보다는 ML 엔지니어링 기법에 의존하는 경향을 보였습니다. 또한 에이전트가 새로운 아이디어보다는 국소적인 엔지니어링 반복에 빠지는 한계가 관찰되었습니다. 연구진은 실험 관리 및 아이디어 생성 스킬을 결합하여 에이전트의 성능과 도메인 관련 개입의 다양성을 높였습니다. Agent4Sci는 에이전트가 단순 엔지니어링을 넘어 진정한 과학적 통찰을 갖추도록 유도하는 지표를 제공합니다.
AI 연구
언어 모델의 추론 시간이 길어질 때 일상적인 함축적 의미(implicature) 해석이 어떻게 변화하는지 연구했습니다. 연구진은 모델의 가중치를 고정한 채 사고 시간만 변화시키며 선택되는 해석의 변화를 관찰했습니다. 실험 결과, 사고 시간이 길어질수록 모델은 'some'이나 'or'와 같은 단어를 일상적 함의가 아닌 엄격한 논리적 의미로 해석하는 경향을 보였습니다. 이는 모델이 초기에는 풍부한 맥락적 의미를 수용했다가, 사고 과정에서 이를 논리적 모순으로 판단하여 취소(cancel)하기 때문인 것으로 밝혀졌습니다. 결론적으로 추론 모델의 평가는 단순 정확도를 넘어 해석의 정교함을 측정해야 함을 시사합니다.
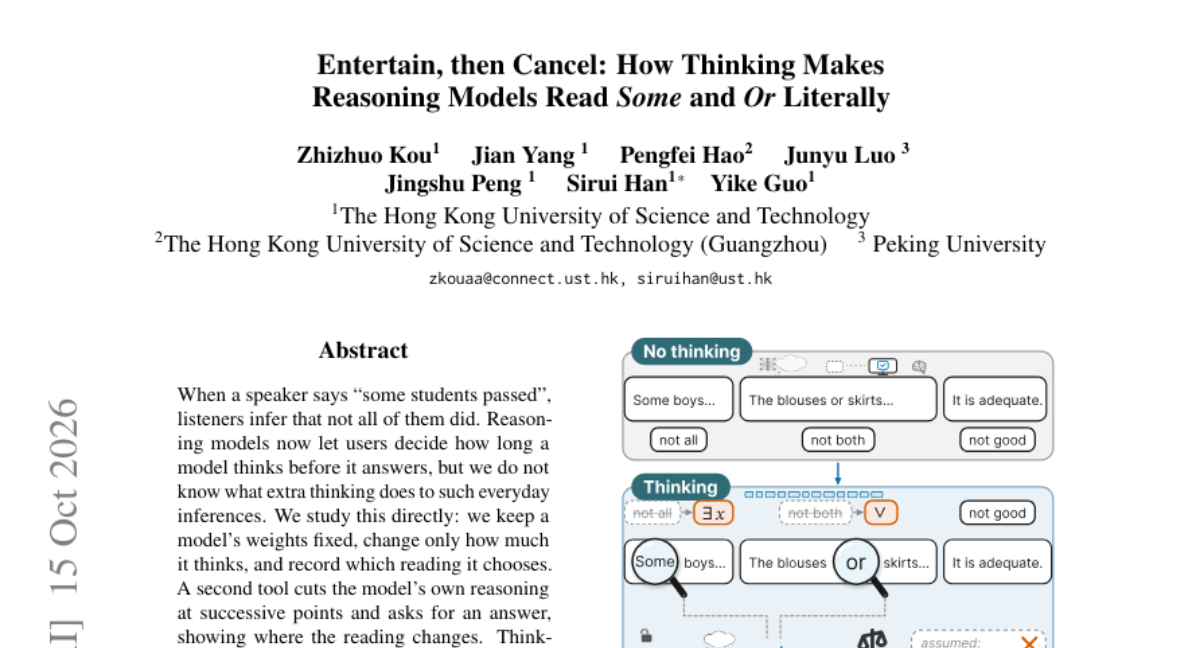
AI 연구
기존의 공간 추론은 단순한 기하학적 도구 활용을 넘어, 언제 관찰하고 언제 프레임을 변경할지 결정하는 고차원적 판단이 필요합니다. 본 논문은 VLM 백본을 고정시킨 채 의사결정 경험을 축적하는 SpatialBrain 프레임워크를 제안합니다. 이 시스템은 3DFusionMemory를 통해 관찰 데이터를 관계형 데이터로 융합하고, Spatial Skill Library와 Spatial Cognition을 통해 도구 사용과 작업 조건 간의 연관성을 학습합니다. 실행된 궤적은 추상화된 프로세스 기록으로 저장되어, 좌표 전송 없이도 이전의 실행 경험을 후속 작업에 활용할 수 있습니다. 실험 결과, SpatialBrain은 동일한 백본을 사용한 직접 답변 방식보다 5개 벤치마크 중 4개에서 우수한 성능을 보였습니다.
AI 연구
기존 Qwen-Audio-3.0-ASR의 성능을 바탕으로 화자 분리 및 일반 오디오 이해 기능을 확장한 Qwen-Audio-3.1-ASR 모델군을 제안합니다. 단순 음성 인식을 넘어 화자 라벨링, 타임스탬프, 중첩 음성 처리가 포함된 구조화된 전사 기능을 제공합니다. 또한 오디오 캡셔닝, 사운드 이벤트 탐지, 오디오 질의응답 등 광범위한 오디오 이해 능력을 통합했습니다. 배포 요구사항에 따라 비동기 파일 처리, 저지연 스트리밍, 대화형 음성 입력 등 다양한 변형 모델을 제공합니다. 실험 결과, 기존 ASR 성능을 유지하면서도 다국어/방언 지원 및 복합적인 오디오 분석 작업에서 뛰어난 성능을 입증했습니다.
AI 연구
기존 순차적 추천 모델은 모든 아이템에 동일한 연산량을 할당하는 고정 깊이 방식을 사용합니다. 하지만 연구 결과, 아이템마다 필요한 연산량이 다르며 고정된 할당 방식은 자원 낭비와 성능 저하를 동시에 초래함을 확인했습니다. 이를 해결하기 위해 아이템별로 연산 깊이를 결정하는 LoopRec을 제안합니다. LoopRec은 가중치를 공유하는 블록과 경량 게이트를 사용하여, 충분히 학습된 아이템은 조기 종료하고 필요한 아이템만 심층 연산을 수행합니다. 실험 결과, 다양한 백본 모델에서 기존 고정 깊이 방식보다 우수한 성능을 보였습니다. 특히 빈도가 낮은 아이템이나 최신 상호작용에 더 많은 연산을 할당하는 해석 가능한 패턴을 보였습니다.
AI 연구
기존 AI 모델은 학습 후 파라미터가 고정되어 외부 업데이트에 의존하는 한계가 있습니다. 이를 해결하기 위해 변화하는 환경에서 스스로 경험하며 성장하는 재귀적 자기 개선(R심) 연구가 필요합니다. 본 논문은 미래 사건 예측을 기반으로 하는 지속 가능한 진화 에이전트 시스템인 DeepEvolve를 소개합니다. DeepEvolve는 검증 가능한 태스크가 생성되는 살아있는 환경에서 예측 과정의 추론 궤적을 역으로 역량화하는 엔진을 사용합니다. 실험 결과, 실시간 미래 예측 리더보드에서 3주 연속 1위를 기록하며 강력한 성능 향상을 입증했습니다. 이는 정적 데이터 학습에서 벗어나 개방형 환경에서의 에이전트 공진화가 차세대 AI의 핵심임을 시사합니다.
AI 연구
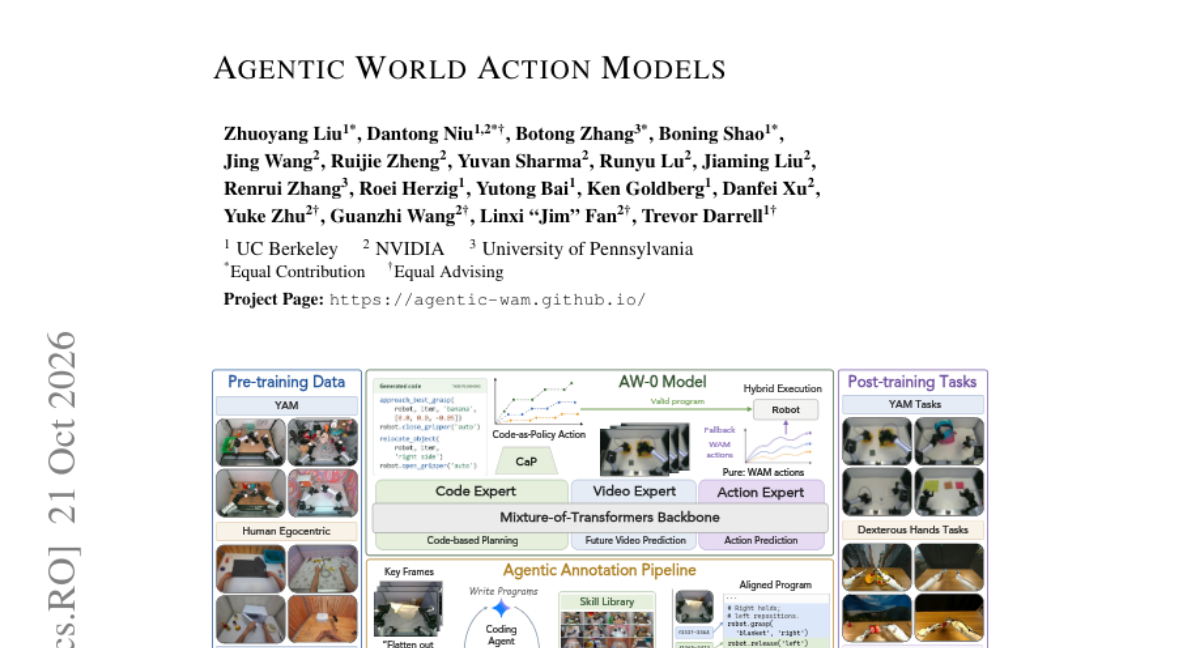
기존의 월드 액션 모델은 미래 예측 능력은 뛰어나지만 모듈식 스킬 재사용이 어렵고, 에이전틱 로보틱스는 계획 능력은 좋으나 물리적 역학에 기반한 예측이 부족한 문제가 있었습니다. 이를 해결하기 위해 코드, 미래 비디오, 로봇 액션을 세 가지 결합된 생성 스트림으로 모델링하는 AW-0 프레임워크를 도입했습니다. Mixture-of-Transformers 구조를 통해 코드 전문가는 파라미터화된 스킬 루틴을 생성하고, 비디오 및 액션 전문가는 미래 시각 상태와 저수준 제어 명령을 생성합니다. 또한 자동화된 큐레이션 파이프라인을 통해 비디오 트래젝토리를 프로그램과 정렬하고 재사용 가능한 스킬 라이브러리를 구축했습니다. 실험 결과, 기존 VLA 및 WAM 베이스라인 대비 작업 성능, 언어 준수, 의미론적 추론 및 강건성 측면에서 우수한 성능을 입증했습니다.
AI 연구
VLA 모델은 강력한 성능을 보이지만, 장기 작업 수행 시 과거의 맥락과 실행 오류를 관리해야 하는 비마르코프(non-Markovian) 의존성 문제에 직면합니다. 기존 방식은 메모리 증강이나 계층적 구조를 통해 이를 해결하려 시도해 왔습니다. 본 논문은 고수준 VLM을 편집 가능한 하네스(hsarness)로 구성하여 작업 맥락을 유지하고 실행 경험을 통해 계획을 개선하는 에이전트 구조를 제안합니다. 이를 SERA(Self-Evolving Robotic Agent)로 구체화하여, 고정된 VLA 실행기와 상호작용하는 에이전트 구조를 구축했습니다. 실험 결과, SERA는 자가 진화 과정을 통해 RoboMME 벤치마크에서 기존 대비 향상된 성공률을 달립했습니다. 이는 에이전트 중심의 계획 방식이 복잡한 로봇 조작 작업에 유망함을 시사합니다.
AI 연구
LLM의 언어 지원 범위가 넓어짐에 따라 다양한 문화적 맥락을 이해하는 능력을 평가하는 것이 중요해졌습니다. 기존 벤치마크는 영어 중심적이며 단순 사실 지식에 치중되어 있어 실제 문화적 맥락을 반영하는 데 한계가 있습니다. 본 논문은 62개 문화권(45개국, 51개 언어)을 아우르는 인간 참여형 수수께끼 벤치마크인 'CulturalRiddles'를 제안합니다. 이 수수께끼들은 단순 지식을 넘어 추론 능력과 문화적 연상 능력을 요구하도록 설계되었습니다. 28개 LLM 모델을 대상으로 평가한 결과, 최첨단 모델조차 일부 문화권에서는 최대 22%의 낮은 정확도를 보였습니다. 연구진은 벤치마크 확장을 위해 모든 결과물을 공개하고 오픈 기여 프로세스를 제공합니다.
AI 연구
멀티 에이전트 협업 환경에서 에이전트들은 가중치 업데이트 없이 재사용 가능한 스킬을 수정함으로써 성능을 개선할 수 있습니다. 기존 방식은 단순히 궤적에 포함된 스킬에 점수를 부여하여, 성공적인 실행에 포함된 유해한 스킬까지 긍정적인 점수를 받는 문제가 있었습니다. 이를 해결하기 위해 GRSE(Group-Relative Skill Evolution)는 GRPO에서 영감을 받아 동일한 스킬 라이브러리 하에서 여러 번 실행한 결과를 비교함으로써 에이전트-스킬 쌍에 대한 신용을 할당합니다. 실험 결과, GRSE는 HotpotQA와 LoCoMo 벤치마크에서 기존 MASkills를 상회하는 성능을 보였으며 특히 멀티홉 질문에서 큰 성과를 거두었습니다. 또한 유해한 스킬이 포함된 상황에서도 정확한 신용 할당을 통해 깨끗한 라이브러리 수준으로 성능을 회복하는 강건함을 입증했습니다.
AI 연구
언어 모델 학습을 위한 RL 프레임워크는 연구 성과를 사용자에게 즉각 전달하는 핵심 통로입니다. 본 연구는 7개의 오픈소스 프레임워크와 6,939개의 arXiv 논문 간의 연결 고리를 추적했습니다. 분석 결과, 제안된 일반 RL 방법론 중 프레임워크에 반영되는 비율은 매우 낮았으며, 주로 30B 이상의 대규모 모델 학습이나 손실 함수(loss)의 미세 조정(coefficient, clip 등) 위주로 반영되었습니다. 또한, 프레임워크의 이슈/PR 시스템은 제안된 방법론을 수용하는 데 있어 비교적 개방적이었으나, 많은 제안이 응답 없이 방치되는 양상을 보였습니다. 최종적으로 연구 성과가 실제 프레임워크 구현으로 이어지는 과정의 병목 현상을 데이터로 입증했습니다.
AI 연구
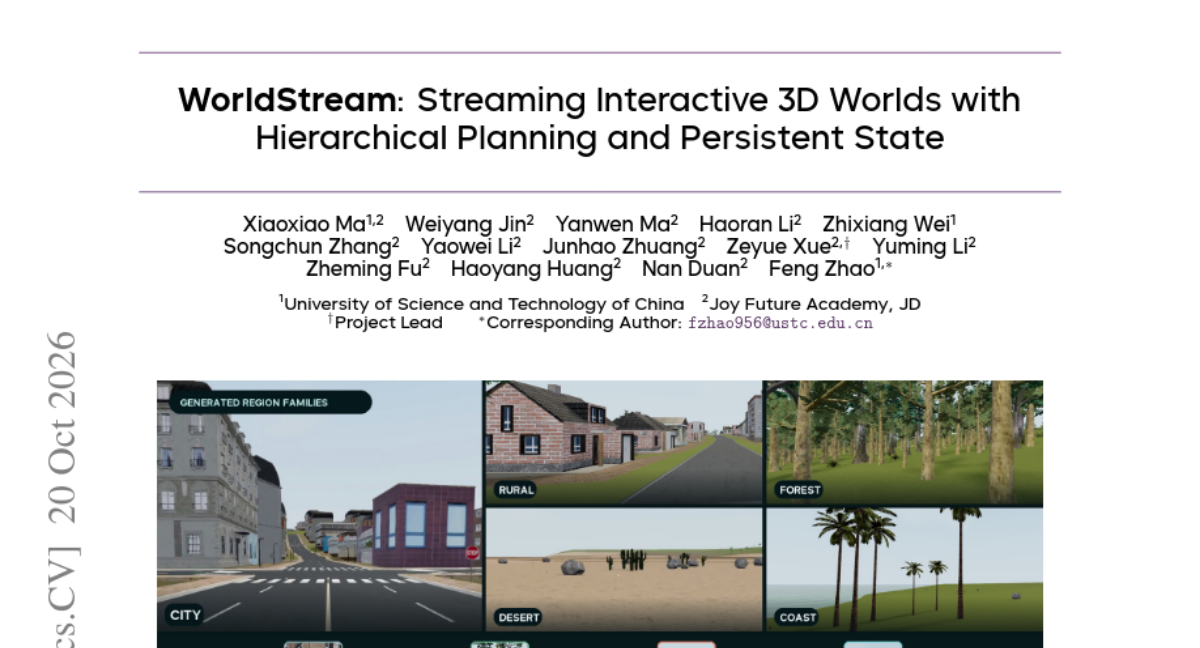
기존의 3D 월드 생성 방식은 맵 크기의 제한, 언어 기반 상호작용의 부재, 방문 지역의 상태 유지 문제라는 한계가 있었습니다. 이를 해결하기 위해 WorldStream은 계층적 계획(Hierarchical Planning)과 스트리밍 기술을 결합한 오픈 엔드 3D 월드 모델을 제안합니다. Macro 수준에서 거시적 구조를 결정하고 Micro 수준에서 타일 세부 사항을 확정하는 계층적 구조를 통해 일관성 있는 지형을 생성합니다. 또한, 예측된 경로를 따라 계획과 컴파일을 미리 수행하는 스트리밍 방식을 통해 효율적인 자원 관리를 실현합니다. 결과적으로 사용자의 편집과 NPC의 상태가 유지되는 확장 가능하고 상호작용 가능한 세계를 구축했습니다.
AI 연구
다양한 소스의 시각 데이터를 결합한 데이터 파이프라인을 통해 9B급 모델의 공간 지각 및 물리적 조작 능력을 극대화함
AI 연구
네트워크 경계 보안에서는 속도가 빠른 시그니처 엔진과 의미 분석이 가능한 생성형 모델 사이의 지연 시간 및 정확도 트레이드오프가 발생합니다. 본 논문은 이 문제를 해결하기 위해 이진 게이트, 폐쇄 집합 선택, 서수 점수를 출력하는 소형 멀티헤드 네트워크인 VX-One을 제안합니다. VX-One은 CPU 환경에서 매우 낮은 지연 시간(0.7-1.7 ms)을 유지하면서도 정교한 결정 프리미티브를 제공하도록 설계되었습니다. 다양한 벤치마크와 실시간 캐스케이드 환경에서 실험한 결과, VX-One은 탐지 성능과 드리프트 환경에서의 복원력에서 우수한 성과를 보였습니다. 그러나 특정 데이터셋에서의 성능 저하와 임계값 전이 문제 등 실무적 한계도 함께 밝혀냈습니다.
AI 연구
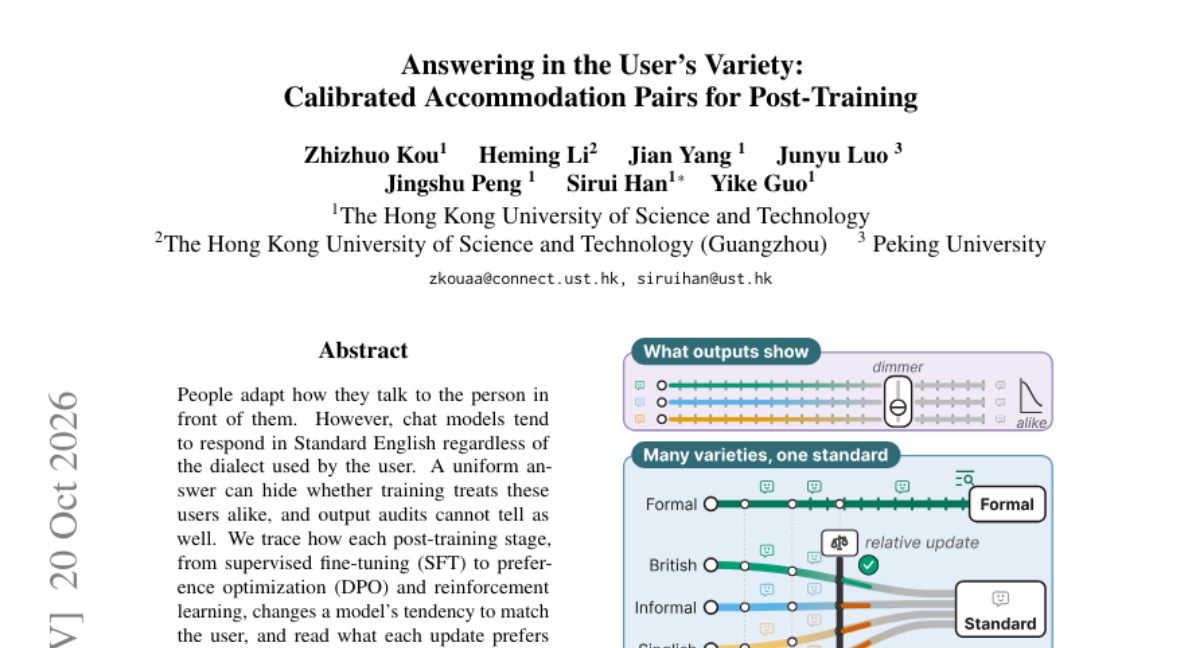
사용자는 대화 상대에 맞춰 말투를 조정하지만, 기존 채팅 모델은 사용자의 방언과 관계없이 표준어 위주로 답변하는 경향이 있습니다. 이러한 일률적인 응답은 학습 과정에서 특정 사용자 그룹이 차별받는지 여부를 은폐할 수 있는 문제를 야기합니다. 본 논문은 SFT부터 DPO에 이르는 사후 학습 단계가 모델의 사용자 맞춤형 응답 성향에 미치는 영향을 분석했습니다. 연구 결과, 기존 방식은 특정 방언(영국식/호주식)은 수용하면서도 특정 사회적 방언(AAE/Singlish)은 배제하는 편향을 보였습니다. 이를 해결하기 위해 표준어 사용자에게는 표준어를 유지하면서 사용자 방언 밀도를 맞추는 'Calibrated Accommodation Pairs(CAP)'를 제안합니다. 실험 결과, CAP는 지시 이행 능력을 유지하면서도 다양한 방언 특성을 효과적으로 학습할 수 있음을 입증했습니다.
AI 연구
기존의 가변 프레임 레이트 코덱은 콘텐츠에 따라 토큰 수가 결정되어 생성 모델이 처리해야 할 시퀀스 길이가 가변적이라는 문제가 있었습니다. 이를 해결하기 위해 본 논문은 X-Codec-2를 기반으로 발화 단위의 정확한 이벤트 예산을 보장하는 RubatoCodec을 제안합니다. Adaptive Firing 메커니즘을 통해 학습된 경계 예측기 없이도 특징 변화와 스펙트럼을 기반으로 이벤트를 분할합니다. 각 이벤트는 이산 코드와 명시적 길이를 가지므로 스트리밍 디코딩이 가능합니다. 실험 결과, 낮은 비트레이트에서도 높은 재구성 품질과 가독성을 유지하며, TTS 작업에서 낮은 WER과 높은 음성 품질을 달성했습니다.
AI 연구
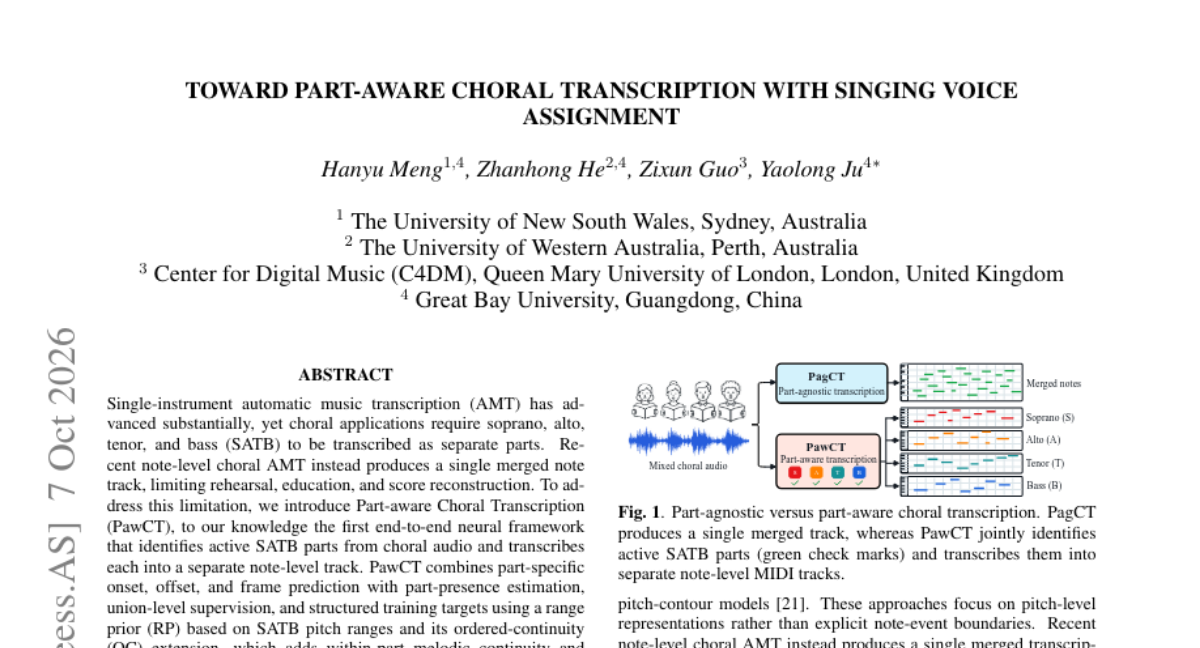
기존의 합창 자동 음악 전사(AMT) 기술은 모든 성부를 하나의 트랙으로 병합하여 출력하는 한계가 있어 교육 및 악보 재구성에 어려움이 있었습니다. 이를 해결하기 위해 성부별 온셋, 오프셋, 프레임 예측과 성부 존재 여부 추정을 결합한 'Part-aware Choral Transcription (PawCT)' 프레임워크를 제안합니다. 제안된 모델은 성부별 음역대를 고려한 Range Prior(RP)와 멜로디 연속성 및 성부 간 순서를 유지하는 Ordered-Continuity(OC)를 학습 타겟에 적용했습니다. 실험 결과, 제안 모델은 기존의 2단계 할당 방식보다 우수한 성능을 보였으며 성부별 분리 전사 성능을 입증했습니다. 결과적으로 음표 전사와 성부 할당을 동시에 모델링하는 것이 성능 향상에 핵심적임을 보여주었습니다.
AI 연구
기존 멀티 에이전트 시스템은 디퓨전 모델의 중간 생성 상태를 버리고 최종 텍스트만 교환하는 방식을 사용합니다. 본 연구는 디퓨전 모델의 연속적 상태(denoising state)를 압축하여 다른 에이전트에게 전달하는 잠재적 통신 방식의 유효성을 탐구합니다. 연구진은 송신자가 압축된 벡터 메시지를 전달하고 수신자가 이를 자신의 컨텍스트와 결합하는 실험 환경을 구축했습니다. 실험 결과, 메시지 교체나 제거 시 성능이 급격히 변하는 것을 통해 메시지가 실제 정보로서 기능함을 확인했습니다. 특히 정보 전달의 시점이 빈도보다 성능에 더 큰 영향을 미친다는 점을 발견했습니다.
AI 연구
멀티 에이전트 협업에서는 상대방의 상태를 정확히 파악하는 '마음 이론(ToM)'이 필수적이지만, 기존 LLM의 텍스트 기반 표현 방식은 불확실한 상대 상태를 다루기에 한계가 있습니다. 이를 해결하기 위해 본 논문은 고정된 예산의 연속적 추론 토큰을 사용하여 풍부한 잠재 공간에서 추상적인 ToM을 형성하는 ToM2Vec을 제안합니다. 학습 시에는 상대방의 실제 사고 과정을 정답(Supervision)으로 사용하여 ToM 토큰이 이를 추상화하도록 훈련하며, 테스트 시에는 생성된 토큰이 에이전트의 행동과 사고를 조절하는 조건부 역할을 합니다. 다양한 협업 및 경쟁 환경 실험 결과, ToM2Vec은 기존 텍스트 기반 방식보다 우수한 성능을 보였으며 미학습 모델(GPT-5.4 등)에 대해서도 높은 일반화 성능을 입증했습니다. 분석 결과, 이 잠재 토큰은 단순 작업 정보가 아닌 상대의 신념과 의도를 인코딩하는 진정한 ToM 역할을 수행함을 확인했습니다.
AI 연구
기존의 딥 리서치 시스템은 자기회귀(AR) 모델의 순차적 디코딩 방식 때문에 계획 수립 및 긴 글 작성 시 발생하는 지연 시간이 핵심 병목 현상이었습니다. 본 논문은 모든 단계에 확산 언어 모델(dLLs)을 핵심 백본으로 사용하는 멀티 에이전트 프레임워크인 DiffResearch를 제안합니다. 실험 결과, 동일한 에이전트 구조에서 백본을 확산 모델로 교체했을 때 엔드투엔드 속도가 약 6배 빨라졌습니다. 또한, 생성 중간 단계에서 하위 쿼리를 추출하는 dFast 모드를 도입하여 품질 저하 없이 분해(decomposition) 속도를 추가로 개선했습니다. 결과적으로 제안된 시스템은 상용 시스템보다 높은 성능을 기록하며 효율적인 리서치 에이전트의 가능성을 보여주었습니다.
AI 연구
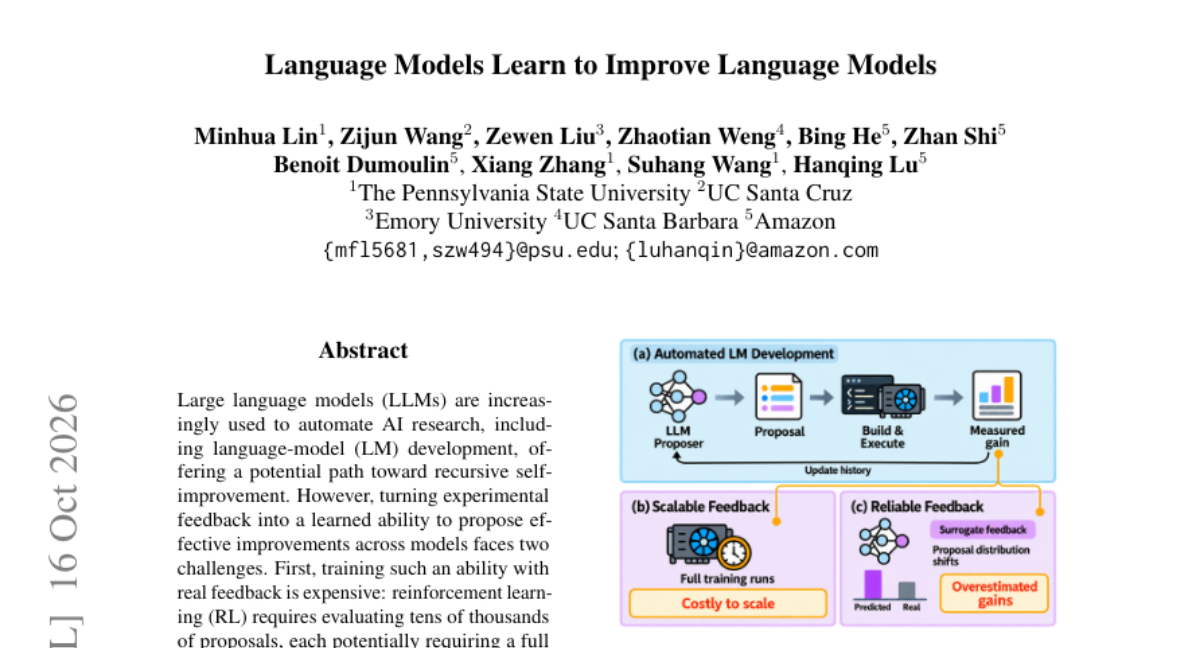
LLM을 활용한 자동화된 AI 연구는 모델의 재귀적 자기 개선 가능성을 열어주지만, 실험 피드백을 학습 가능한 능력으로 전환하는 데는 비용과 신뢰성 문제가 존재합니다. 실제 실험 피드백을 통한 RL 학습은 막대한 GPU 자원을 소모하며, 대리 모델(surrogate)을 사용할 경우 정책 최적화 과정에서 피드백이 부정확해질 위험이 있습니다. 이를 해결하기 위해 연구 기록을 바탕으로 개선 효과를 예측하는 '연구 월드 모델(RWM)'을 보상 모델로 사용하는 LM2LM을 제안합니다. RWM의 신뢰성을 유지하기 위해 상위 제안을 주기적으로 실제 실행하여 결과를 다시 학습 데이터로 반영하는 방식을 사용합니다. 실험 결과, LM2LM은 기존 모델 대비 낮은 데이터 생성 비용으로도 더 높은 성능을 달셨으며 미학습 모델군에 대해서도 우수한 일반화 성능을 보였습니다.
AI 연구
LLM 에이전트가 작업 수행 및 데이터 필터링을 위해 스스로 검증 코드를 작성하는 능력이 중요해지고 있습니다. 하지만 기존 방식으로는 생성된 검증기가 모든 유효한 해답을 수용하는지, 혹은 과도하게 엄격하여 정답을 거부하는지를 평가하기 어렵습니다. 본 논문은 2개 벤치마크와 4,993개의 테스트 케이스를 포함한 VerifierBench를 도입하고, 검증기의 품질을 검사하는 V4V 프레임워크를 제안합니다. 19개 모델을 대상으로 실험한 결과, 모델들은 유효한 해답을 수용하기보다 무효한 해답을 거부하는 데 치중하는 경향을 보였습니다. 이는 검증기가 과도하게 엄격하여 정답을 오답 처리하는 문제를 야기하며, 에이전트가 자신의 잘못된 가정을 스스로 확인하지 못해 발생하는 현상임을 밝혀냈습니다.
AI 연구
Uniform Diffusion Language Models(UDLMs)는 모든 토큰을 반복적으로 정제하는 방식으로 학습되어 강력한 추론 성능을 보이지만, 학습 시 연산 비용(FLOPs)이 매우 높다는 단점이 있습니다. 기존의 Masked Diffusion 모델에서 사용되던 selective looping 기법을 UDLM에 적용하여 학습 효율을 높이는 방법을 제안합니다. 실험 결과, 루프 구조를 통해 훨씬 적은 연산량으로도 기존 UDLM 수준의 성능에 도달할 수 있음을 확인했습니다. 또한 동일한 샘플링 횟수(NFE) 대비 생성 퍼플렉시티(Perplexity)를 크게 낮추는 성과를 거두었습니다. 마지막으로 학습 시 루프 횟수 분포를 조절하여 추론 효율까지 최적화하는 전략을 제시했습니다.
AI 연구
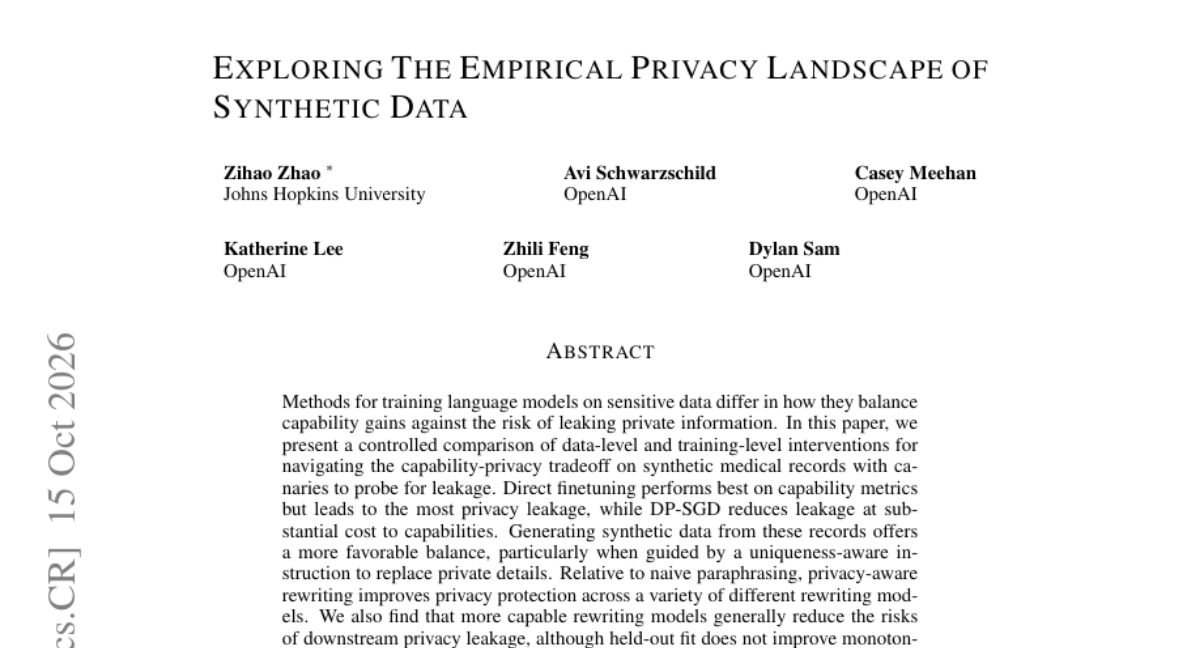
민감한 데이터를 활용한 언어 모델 학습 시 성능 향상과 개인정보 유출 위험 사이의 트레이드오프를 관리하는 것이 중요합니다. 본 논문은 합성 의료 기록 데이터를 활용하여 데이터 수준의 개입과 학습 수준의 개입을 비교 분석했습니다. 실험 결과, 직접적인 파인튜닝은 성능은 높지만 유출 위험이 크고, DP-SGD는 프라이버시는 보호하지만 성능 저하가 심했습니다. 반면, 고유성 인지 지침을 활용한 합성 데이터 생성 방식은 성능과 프라이버시 사이에서 더 유리한 균형을 제공했습니다. 특히 프라이버시를 고려한 재작성(Privacy-aware rewriting) 방식은 기존의 단순 패러프레이징보다 우수한 보호 성능을 보였습니다.
AI 연구
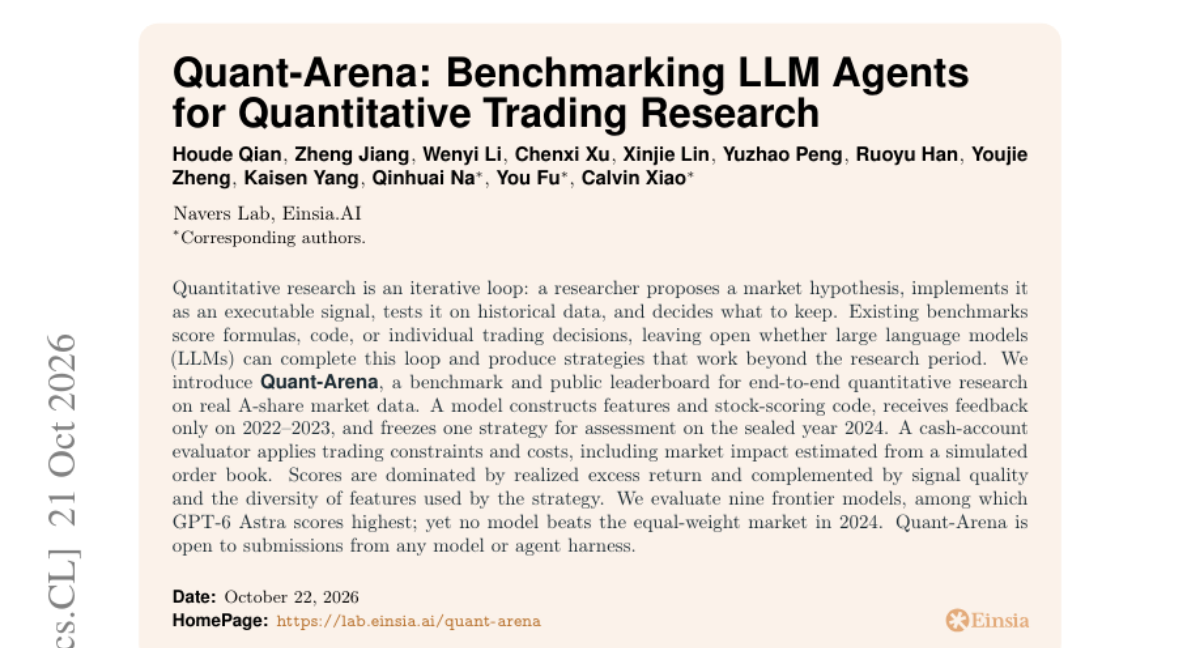
기존의 퀀트 벤치마크는 코드나 개별 의사결정 위주로 평가하여, 실제 시장에서 작동하는 전략 수립 루프를 검증하기 어려웠습니다. 이를 해결하기 위해 실제 A주 시장 데이터를 활용한 엔드투엔드 퀀트 연구 벤치마크인 Quant-Arena를 도입했습니다. 모델은 과거 데이터로 피드백을 받으며 전략을 구축하고, 검증되지 않은 미래 데이터(2024년)에서 성과를 평가받습니다. 평가에는 거래 비용과 시장 충격이 포함된 현금 계좌 평가 방식이 적용됩니다. 실험 결과 GPT-6 Astra가 가장 높은 점수를 기록했으나, 모든 모델이 시장 평균 수익률(Equal-weight)을 넘지는 못했습니다.
30건
이날 공개된 제품과 도구

제품/서비스
GitHub, Jira 등 다양한 도구를 연결하여 개발 작업의 복잡도와 ROI를 분석하는 엔지니어링 인텔리전스 도구
6건
새 모델과 주요 평가 결과
HF Model Trending
RecursiveSI에서 공개한 flint 모델이 Hugging Face에서 주목받고 있습니다. 약 40B 파라미터 규모의 text-generation 모델로, 최근 사용자들의 관심을 끌고 있습니다.
HF Model Trending
OpenMOSS-Team에서 공개한 MOSS-Image-SFT 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 text-to-image 파이프라인을 지원하는 SFT 모델입니다.
HF Model Trending
OpenMOSS-Team에서 공개한 MOSS-Image-Base 모델이 text-to-image 태스크를 중심으로 주목받고 있습니다. 약 50억 개의 파라미터를 보유한 이 모델은 최근 높은 다운로드 수를 기록하며 트렌드에 진입했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.