지난 소식

2026.10.22

이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.

19건

뉴스

주요 기사와 기업의 공식 발표

OpenAI

Patch the Planet: global response coordination as agents uncover critical vulnerabilities - OpenAI

OpenAI가 AI Agent가 자율적으로 소프트웨어의 취약점을 발견하고 패치를 제안하는 보안 자동화 프레임워크의 성과와 글로벌 대응 체계를 발표했습니다. 이는 AI가 단순한 코드 작성을 넘어, 복잡한 시스템의 보안 허점을 식별하고 해결하는 '자율적 보안 전문가'로서의 가능성을 입증한 사례입니다.
wiz.io

PHP2Shell: AI uncovers critical RCE vulnerabilities affecting 70% of the Internet - wiz.io

Wiz Research가 발견한 PHP 핵심 엔진의 치명적 취약점인 'PHP2Shell'은 전 세계 웹사이트의 70%에 영향을 미치는 RCE(Remote Code Execution) 및 메모리 유출 위협을 초래합니다. 이번 취약점은 AI 모델을 활용해 수십 년간 잠잠했던 복잡한 메모리 결함을 실질적인 공격 도구로 전환시킨 사례입니다.
The Atlantic

The AI-Hacking Apocalypse Began Last Night - The Atlantic

AI 기술의 급격한 발전이 기존의 보안 체계를 무력화하는 'AI-Hacking' 시대의 서막을 알리며, 전통적인 방어 방식이 더 이상 유효하지 않은 위기 상황을 경고합니다.

NVIDIA Newsroom

NVIDIA Introduces DSX POD AI Factories to Accelerate Europe’s Infrastructure Deployment - NVIDIA Newsroom

NVIDIA가 차세대 AI 인프라 구축을 위한 레퍼런스 디자인인 'DSX POD'를 발표하며, 모듈형 컨테이너 기반의 AI 팩토리 솔루션을 공개했습니다. 이 솔루션은 NVIDIA Vera Rubin 아키텍처를 기반으로 설계되어, 기존 수개월이 소요되던 데이터 센터 구축 기간을 단 14일로 단축하는 것을 목표로 합니다.

나머지 14건 펼쳐보기

Reuters

OpenAI president urges AI safeguards as group he funds opposes regulation - Reuters

OpenAI의 Greg Brockman 사장이 AI 안전 장치(Safeguards)의 필요성을 강조하는 가운데, 그가 자금을 지원하는 단체가 규제에 반대하는 모순적 상황이 발생하며 AI 거버넌스 논쟁이 심화되고 있습니다. 이는 기술적 안전성 확보와 산업적 규제 사이의 복잡한 이해관계를 보여줍니다.

Forbes

OpenAI Says AI Found One Of The Biggest Web Weaknesses Ever - Forbes

OpenAI의 최신 AI 모델이 웹 보안 체계의 근간을 위협할 수 있는 중대한 취약점을 발견하며 사이버 보안 분야의 새로운 국면을 제시했습니다. 이번 발견은 AI가 단순한 코드 작성을 넘어 시스템의 구조적 결함을 식별하는 데 탁월한 능력을 갖추었음을 입증합니다.

BBC

Google staff resign in backlash over its AI contracts with military - BBC

Google DeepMind 연구원들이 미 국방부 및 이스라엘 군과의 AI 계약에 반발하며 퇴사하는 등 기업 윤리와 기술 오남용에 대한 내부 갈등이 심화되고 있습니다. 이는 AI 기술이 전장 의사결정 시스템에 통합됨에 따라 발생하는 '인간의 통제권(Human Oversight)' 상실 우려와 직결되어 있습니다.

Google DeepMind

Gemini 4 Argon: Built to solve your hardest problems

Google DeepMind가 최신 프론티어 모델인 Gemini 4 Argon을 공개했습니다. 이 모델은 개발자, 기업, 과학자 및 일반 소비자들이 직면한 가장 어려운 문제들을 해결하기 위해 설계되었습니다.

Google DeepMind

Accelerating the search for antimicrobial peptides with Google Antigravity

Google DeepMind가 새로운 항균 펩타이드 탐색을 위한 에이전트 기반 과학 워크벤치인 Google Antigravity를 공개했습니다. 이 시스템은 새로운 항균 펩타이드를 발견하고 구조적으로 평가하며 우선순위를 정하는 과정을 단 몇 시간 만에 수행할 수 있도록 지원합니다.

OpenAI News

How AT&T is rethinking in-house legal work with OpenAI

AT&T는 법률 지식에 대한 접근성을 높이기 위해 OpenAI와 협력하고 있습니다. AT&T의 LegalEdge 팀은 업무 수급 방식을 재고하고 법적 판단의 규모를 확장하는 방법을 모색 중입니다.

OpenAI News

OpenAI models are coming to Google Cloud

OpenAI와 Google Cloud가 협력하여 OpenAI의 프론티어 모델과 Codex 워크플로우를 Gemini의 Model Garden에 도입합니다. 이번 협업을 통해 해당 모델들은 Google Cloud Marketplace를 통해 제공될 예정입니다.

Google Cloud AI

Introducing Gemini for government services

Google Cloud가 정부 기관을 위한 Gemini for government services 프리뷰 버전을 출시했습니다. 이 서비스는 거버넌스가 내장된 환경에서 정부 기관에 필요한 기술, 커넥터 및 파트너 에이전트를 제공합니다.

22건

커뮤니티

Hacker News, GeekNews, Reddit 반응

Hacker News

DeepInfer: High-performance inference framework for DeepSeek models

DeepSeek 모델의 대규모 서비스 운영을 위해 개발된 고성능 추론 프레임워크인 DeepInfer가 오픈 소스로 공개되었습니다. 이 프레임워크는 최적화된 커널과 비동기 스케줄링을 통해 대규모 추론 환경에서 높은 처리량과 낮은 지연 시간을 동시에 달현하는 것을 목표로 합니다.

Hacker News

Tesla Roadster

테슬라가 공개한 새로운 로드스터 모델의 기술적 성능과 그에 따른 커뮤니티의 열띤 반응을 다룹니다. 고성능 차량에 로켓 엔진과 팬 시스템을 결합한 엔지니어링 성과에 대해 기술적 실효성을 중심으로 논쟁이 이어지고 있습니다.

Hacker News

Security advisory: Critical remote code execution vulnerabilities, update now

PHP에서 인증되지 않은 사용자가 원격 코드를 실행할 수 있는 심각한 취약점이 발견되어 즉각적인 업데이트가 권고되었습니다. 이번 취약점은 메모리 관리 방식의 허점을 이용하며, 모든 PHP 기반 웹 서버 환경이 잠재적 공격 대상입니다.

Hacker News

eMudhra intermediate CA compromise

eMudhra의 중간 CA 개인키 8개가 유출되어 주요 브라우저와 OS 제조사들이 긴급 차단 조치를 취했습니다. 공격자가 해당 키를 이용해 웹사이트를 사칭할 수 있는 심각한 보안 위협이 발생했습니다.

Hacker News

Show HN: SimCity, but with Permits

도시 건설 시뮬레이션 게임에 복잡한 행정 절차와 이해관계 충돌을 결합한 새로운 게임 프로젝트가 공개되었습니다. 현실 세계의 정책 결정이 가져오는 사회적 갈등을 게임 메커니즘으로 구현한 것이 특징입니다.

나머지 17건 펼쳐보기

Hacker News

PHP 8.2.35

PHP 8.2.35 보안 업데이트와 함께 발견된 새로운 취약점인 PHP2Shell에 대한 기술적 분석이 이루어지고 있습니다. 보안 전문가들은 AI를 활용한 취약점 탐지 기법이 실제 RCE(원격 코드 실행) 공격으로 이어지는 과정을 주목하고 있습니다.

Hacker News

Voxtral 3

Mistral AI의 새로운 STT 모델인 Voxtral 3 출시 소식과 이에 대한 사용자들의 기술적 평가를 다룹니다. 이전 세대 모델의 성능을 계승하면서도 폐쇄형 모델로 출시된 점에 대해 커뮤니티의 의견이 나뉩니다.

Hacker News

Eight Bits of Trust: eMudhra's CA keys cracked in milliseconds

eMudhra의 CA(인증 기관) 키가 단 몇 밀리초 만에 탈취된 보안 사고가 발생하여 신뢰 체계에 큰 충격을 주었습니다. 이번 사건은 취약한 암호화 알고리즘이 신뢰의 근간을 어떻게 무너뜨릴 수 있는지 보여주는 사례입니다.
Hacker News

It's still ok to enjoy programming

AI 기술의 발전으로 프로그래밍의 본질과 즐거움이 변하는 과정에서 개발자들이 느끼는 심리적 변화를 다룹니다. 기술적 숙련도보다 도구 활용 능력이 중요해지는 시대에 프로그래밍을 대하는 태도에 대해 논의합니다.

GeekNews / Hada

EA, BioWare 폐쇄

이번 조치는 수익성 중심의 경영 전략에 따라 IP 개발보다 구조조정을 우선시한 결과로 분석됩니다. 이는 거대 게임사의 비상장 전환 과정에서 핵심 개발 스튜디오가 희생될 수 있음을 보여주는 사례입니다.
GeekNews / Hada

온갖 제약 속에서도 빛나는 타이포그래피

디스플레이 갱신 과정에서 발생하는 물리적 시차로 인해 타이포그래피의 왜곡이 발생할 수 있음을 보여줍니다. 이는 하드웨어의 렌더링 방식과 소프트웨어의 시각적 결과물 사이의 상관관계를 이해하는 데 중요한 기술적 단서를 제공합니다.

GeekNews / Hada

변조된 PyPI LiteLLM 1.107.0, 자격 증명 탈취 악성코드와 백도어 설치

공급망 공격을 겨냥한 악성 패키지가 배포되어 사용자 시스템의 자격 증명을 탈취하고 백도어를 설치하는 심각한 보안 위협이 발생했습니다. 개발 환경에서 의존성 관리의 중요성과 검증되지 않은 패키지 설치에 대한 주의가 필요함을 시사합니다.

GeekNews / Hada

오늘의 PHP 보안 릴리스와 PHP 보안 강화 방안

이번 보안 릴리스는 메모리 관리와 오류 처리 과정의 결함을 해결하여 원격 코드 실행 위협을 차단하는 데 중점을 두었습니다. 시스템 안정성과 보안을 위해 사용 중인 PHP 버전을 최신 보안 패치 버전으로 즉시 업데이트해야 합니다.

GeekNews / Hada

DuckDB 2.0.0 LTS “Cinnamon Teal” - 서버 연결과 비동기 I/O 강화

이번 업데이트는 DuckDB의 데이터 처리 성능과 원격 연결성을 대폭 강화하여 로컬 분석 도구를 넘어선 확장성을 확보한 것이 핵심입니다. 특히 비동기 I/O와 프로토콜 개선은 대규모 데이터 워크로드에서의 안정적인 운영을 가능하게 합니다.
GeekNews / Hada

PHP2Shell: AI로 PHP의 치명적인 원격 코드 실행 취약점 발견

이번 취약점은 애플리케이션 계층이 아닌 언어 엔진 자체의 구조적 결함을 공략했다는 점에서 기술적 파급력이 매우 큽니다. PHP를 사용하는 수많은 레거시 시스템과 최신 환경 모두가 잠재적 공격 대상이 될 수 있음을 시사합니다.
Reddit

Published a few model conversions for OpenVINO please request more

사용자가 직접 변환한 OpenVINO 형식의 모델들을 공유하며 추가적인 모델 변환 요청을 받고 있습니다. 기존에 온라인에서 제공되지 않던 특정 모델들을 직접 변환하여 배포하는 것이 목적입니다.

Reddit

Qwen researching Qwen

사용자가 가상의 미래 모델인 Qwen 3.8 Flash Next의 시스템 요구 사항과 아키텍처에 대해 질문하며 시작된 논의입니다. 해당 모델은 n-gram 가중치를 시스템 RAM으로 오프로딩하는 독특한 구조를 가정하며, 하드웨어 자원 배분에 따른 성능 예측을 다루고 있습니다.

50건

논문

읽어볼 만한 AI 연구

AI 연구

Focused Omni-Modal GUI Agents

멀티모달 GUI 에이전트의 정보 과부하로 인한 오작동을 방지하기 위해, 단계별로 필요한 정보만 동적으로 압축하여 주입하는 경량 어댑터 기술입니다.

AI 연구

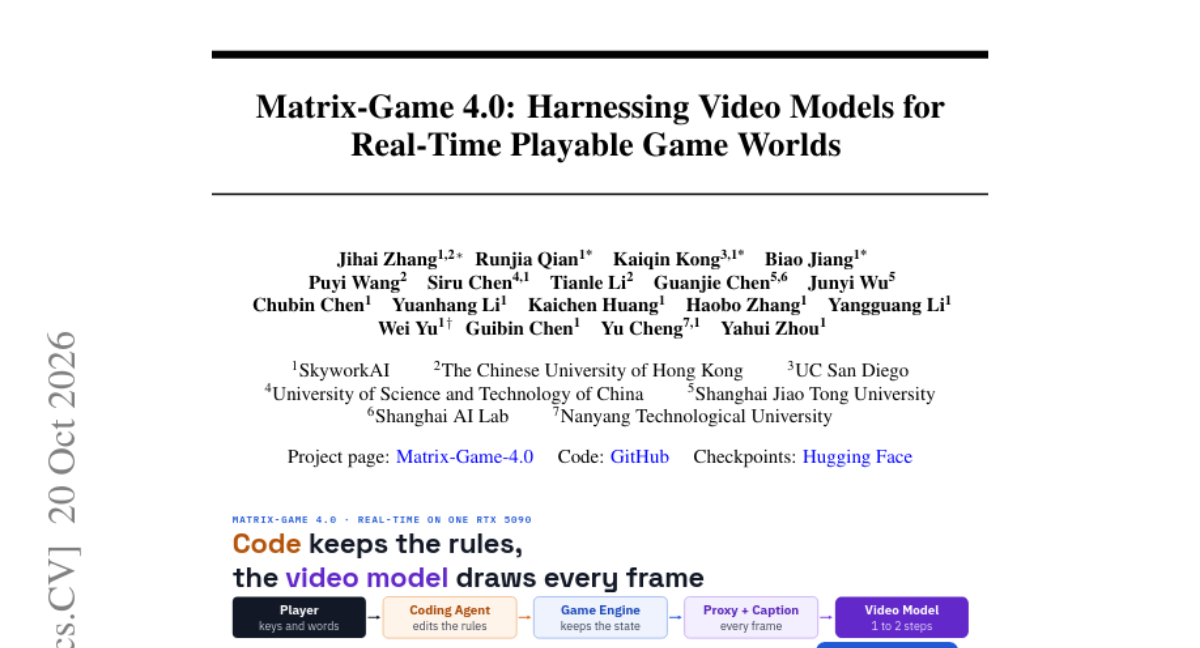
Matrix-Game 4.0: Harnessing Video Models for Real-Time Playable Game Worlds

기존의 제어 가능한 비디오 생성 기술은 지속적인 월드 상태 유지와 낮은 지연 시간의 상호작용을 구현하는 데 한계가 있었습니다. 이를 해결하기 위해 게임 실행(Engine)과 시각적 생성(Renderer)을 분리하는 Matrix-Game 러드맵을 제안합니다. 경량 게임 엔진이 물리적 규칙과 상태를 관리하고, 멀티모달 코딩 에이전트가 플레이어의 아이디어를 코드로 변환하며, 오토레그레시브 비디오 모델이 저폴리곤 프록시를 고해상도 비주얼로 렌더링합니다. 결과적으로 단일 RTX 5090에서 480p 60 FPS의 실시간 플레이를 달성하며, 자연어 기반의 게임 생성 및 수정이 가능함을 입증했습니다.

AI 연구

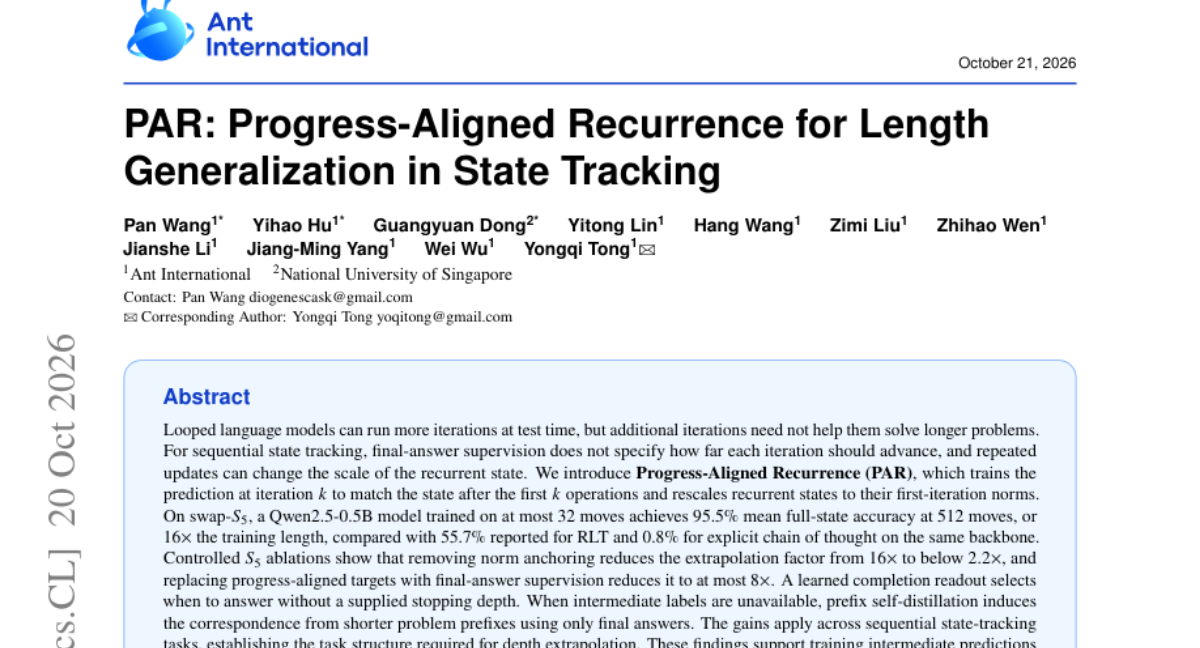
PAR: Progress-Aligned Recurrence for Length Generalization in State Tracking

루프형 언어 모델은 테스트 시 반복 횟수를 늘릴 수 있지만, 단순히 반복하는 것만으로는 더 긴 문제를 해결하는 데 한계가 있습니다. 특히 상태 추적 작업에서는 최종 정답만으로는 각 반복 단계의 진행 정도를 제어하기 어렵고, 반복 시 상태 값의 스케일이 변하는 문제가 발생합니다. 이를 해결하기 위해 k번째 예측이 k번째 작업 직후의 상태와 일치하도록 학습하고, 재귀적 상태를 첫 번째 반복의 노름(norm)으로 재조정하는 PAR(Progress-Aligned Recurrence) 방식을 제안합니다. 실험 결과, 학습 시보다 16배 더 긴 시퀀스에서도 높은 정확도를 유지하며 기존 방식 대비 압도적인 길이 확장 성능을 보였습니다. 또한, 중간 라벨이 없는 경우에도 자기 증류(self-distillation)를 통해 효과적으로 학습할 수 있음을 입증했습니다.

AI 연구

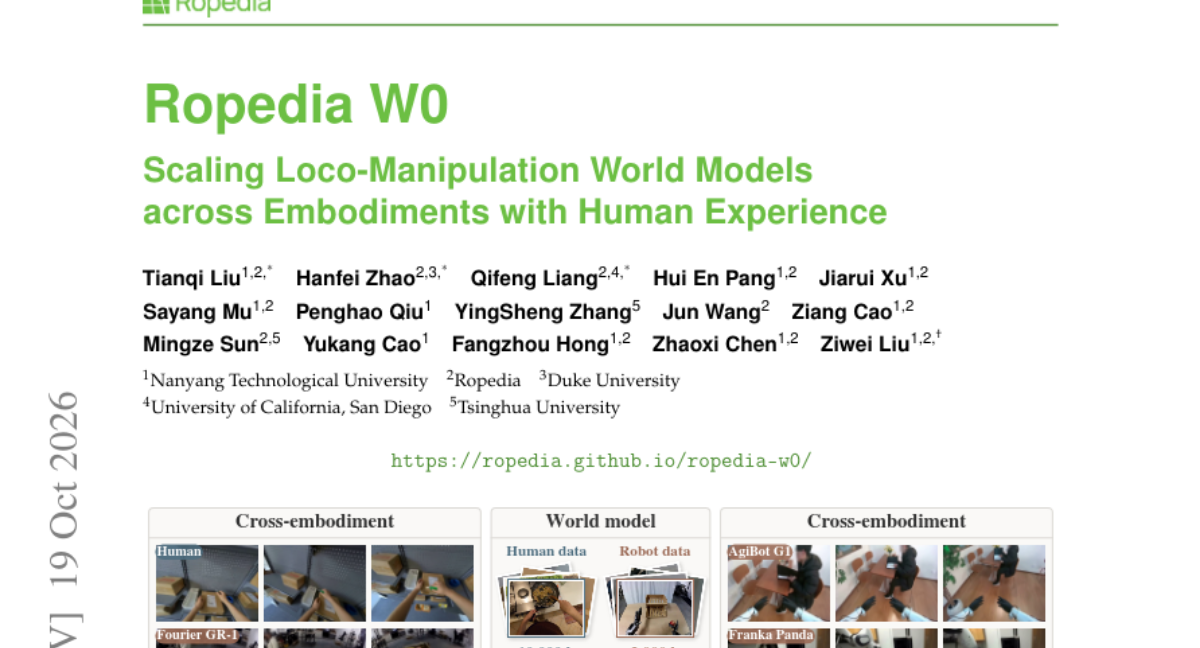
Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience

로봇의 이동(Locomotion)과 조작(Manipulation)을 동시에 모델링하는 것은 서로 다른 동작 공간과 데이터 부족 문제로 인해 매우 어렵습니다. 본 논문은 인간과 로봇의 다양한 형태를 아우르는 최초의 1인칭 시점 이동-조작 세계 모델인 Ropedia W0를 제안합니다. 이를 위해 1만 시간의 인간 데이터와 라벨링된 로봇 데이터를 포함하는 Xp-Data를 구축하고, 카메라 포즈와 투영된 스켈레톤을 결합한 통합 운동학 표현 방식을 도입했습니다. 또한 고품질 휴머노이드 텔레오퍼레이션 기반의 벤치마크인 Xp-Teleop을 함께 선보였습니다. 실험 결과, 제로샷 및 퓨샷 환경에서 다양한 로봇 벤치마크와 인간 영상 데이터에 대해 SOTA 성능을 달성했습니다. 최종적으로 모델 증류를 통해 실시간 분 단위 롤아웃을 구현하여 VR 상에서의 상호작용 가능성을 입증했습니다.

AI 연구

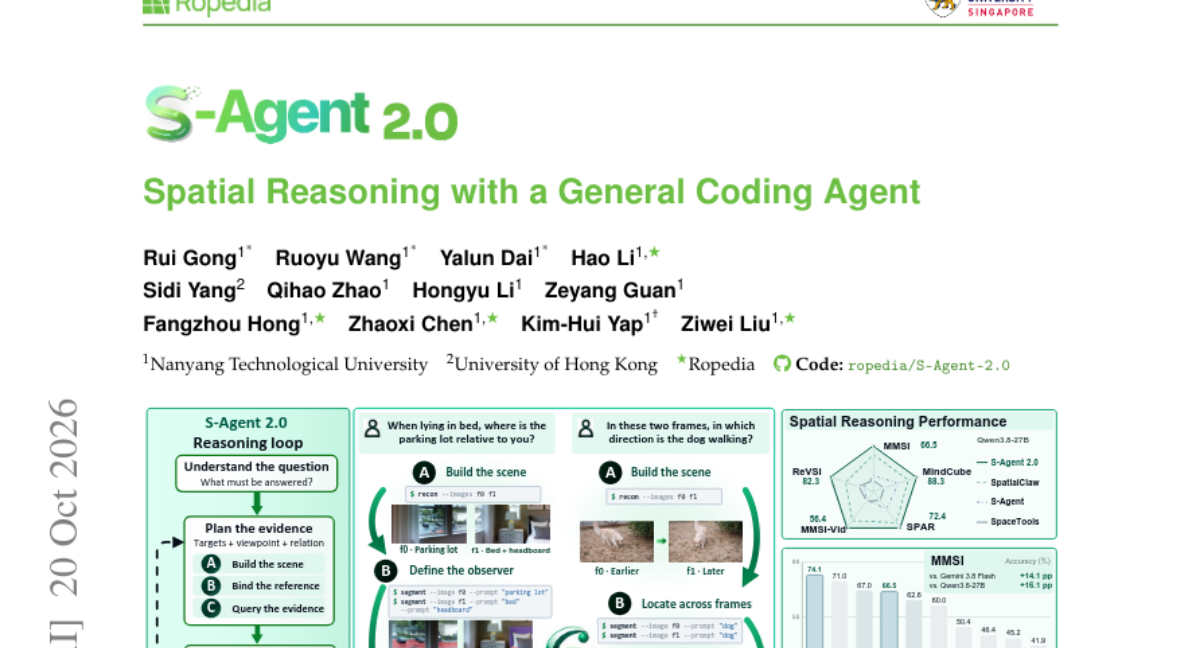
S-Agent 2.0: Spatial Reasoning with a General Coding Agent

최근 에이전트형 VLM은 3D 인지 도구를 통해 공간 추론 능력을 향상시켰으나, 도구가 제공하는 원시 데이터를 유효한 결론으로 변환하는 데 어려움을 겪고 있습니다. 본 논문은 범용 코딩 에이전트에 명령줄 기반의 인지 툴킷을 결합한 S-Agent 2.0을 제안합니다. 이 시스템은 증거 수집, 지속 가능한 장면 메모리 유지, 평이한 공간 언어를 통한 해석이라는 세 가지 원칙을 통해 모델과 도구 사이의 간극을 메웁니다. 실험 결과, S-Agent 2.0은 Qwen 및 Gemini와 같은 강력한 모델의 성능을 유의미하게 향상시켰으며 기존 전문 시스템보다 우수한 성능을 보였습니다. 특히 범용 코딩 에이전트 프레임워크(Codex, Claude Code 등)와 유연하게 결합될 수 있음을 입증했습니다.

나머지 45건 펼쳐보기

AI 연구

Sage-A1.5: From Long-Horizon Execution to Scientific Exploration with Capability Composition

기존 에이전트 모델은 개별 작업 해결에는 능숙하지만, 복잡한 장기 과제를 계획하고 실행하는 데 한계가 있었습니다. 이를 해결하기 위해 35B MoE 모델인 Sage-A1.5를 개발하여 적응형 역량 구성을 도입했습니다. 이 모델은 작업 위임과 병렬 협업을 지원하는 오케스트레이션, 진행 상황을 점검하고 전략을 수정하는 검증 메커니즘, 그리고 탐구적 연구를 위한 과학적 발견 능력을 핵심으로 합니다. 실험 결과, 복잡한 에이전트 작업과 다학제적 과학 연구 분야에서 뛰어난 성능을 입증했습니다. 결과적으로 Sage-A1.5는 단순한 질의응답을 넘어 자율적인 연구와 실행이 가능한 에이전트의 토대를 제공합니다.

AI 연구

VLA-Rolling: Fewer Denoising Steps, Better Control via Adaptive Action Reuse

Flow-matching 기반 VLA 모델은 액션 청크를 생성하지만, 실행 후 남은 잔여 액션(tail)은 매번 버려지는 비효율이 발생합니다. 연구진은 이 버려지는 tail이 유효한 디노이징 정보를 담고 있음에 주목했습니다. 이를 활용하기 위해 액션 상속, 신뢰도 추정, 신뢰도 기반 재노이징 및 예산 할당을 결합한 VLA-Rolling 프레임워크를 제안합니다. 실험 결과, 기존 모델을 동결한 상태에서도 추론 속도를 최대 1.48배 높이면서 성공률을 최대 15.08%p 향상시켰습니다. 결과적으로 액션 tail이 효율적이고 정확한 VLA 추론을 위한 재사용 가능한 중간 상태임을 입증했습니다.

AI 연구

CoEvo-RSI: When Harnesses Evolve, Which Models Should Follow?

최근 에이전트 개발에서는 모델(Brain)과 실행 환경(Body)을 동시에 발전시키는 재귀적 자기 개선(RSI) 방식이 주목받고 있습니다. 그러나 진화하는 환경이 모델의 능력을 초과하거나 이미 가진 능력을 제약하는 '뇌-신체 불일치(brain-body mismatch)' 문제가 발생합니다. 이를 해결하기 위해 CoEзо-RSI는 공유된 진화 아카이브와 실행 피드백을 활용하는 양방향 역사적 상속 프레임워크를 제안합니다. 메타 에이전트가 과거의 설계와 모델 체크포인트를 조율하여 환경과 모델의 능력을 정렬하며, SFT만으로도 고성능을 유도합니다. 실험 결과, Qwen3.5-9B 모델이 훨씬 큰 모델들을 능가하며 다양한 수직적 애플리케이션에서 뛰어난 성능을 입증했습니다.

AI 연구

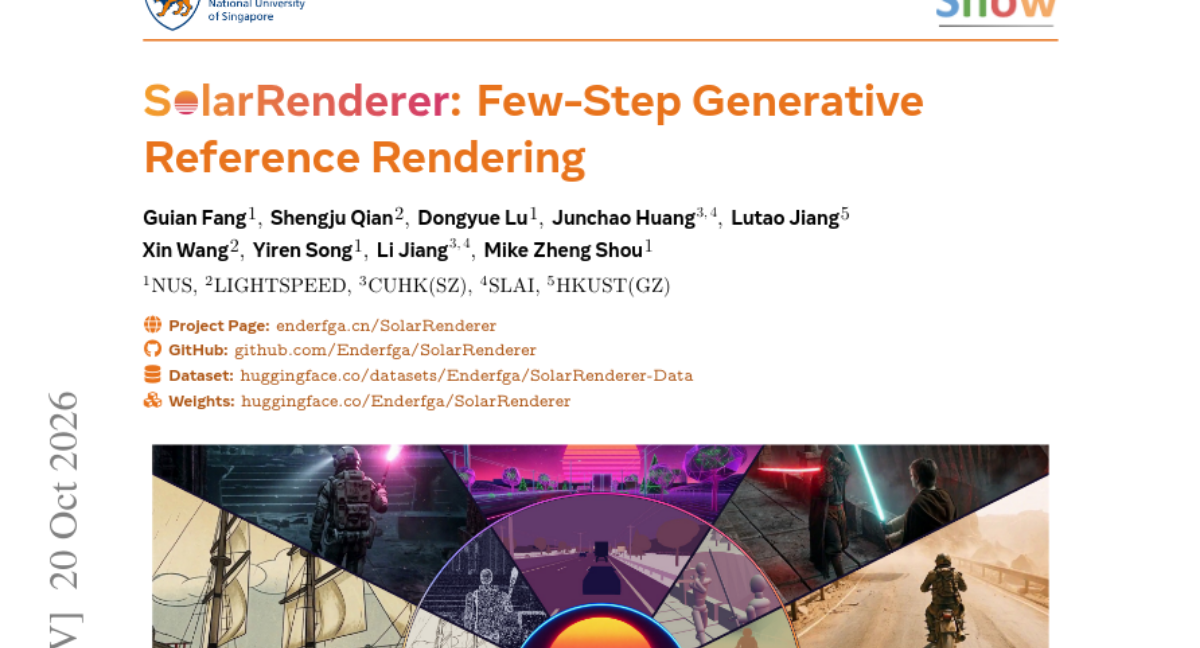
SolarRenderer: Few-Step Generative Reference Rendering

게임 엔진이나 코딩 에이전트가 생성한 거친 구조 정보를 실사 비디오로 변환하는 것은 매우 어려운 과제입니다. 기존 렌더러는 특정 엔진의 표현 방식에 종속되거나, 생성 속도가 느리고 학습 데이터와 타겟 비디오 간의 정렬 문제가 존재했습니다. 본 논문은 고정된 MiniMax-H3 33B 백본에 두 개의 경량 LoRA를 결합한 SolarRenderer를 제안합니다. 구조적 비디오를 백본의 네이티브 참조 경로에 직접 입력하여 다양한 구조 표현을 수용하며, 4단계의 분포 매칭 방식을 통해 기존 대비 12.3배 빠른 속도를 달성했습니다. 실험 결과, 포즈 스켈레톤이나 포인트 클라우드 등 학습되지 않은 다양한 구조적 표현에 대해서도 뛰어난 일반화 성능을 보였습니다.

AI 연구

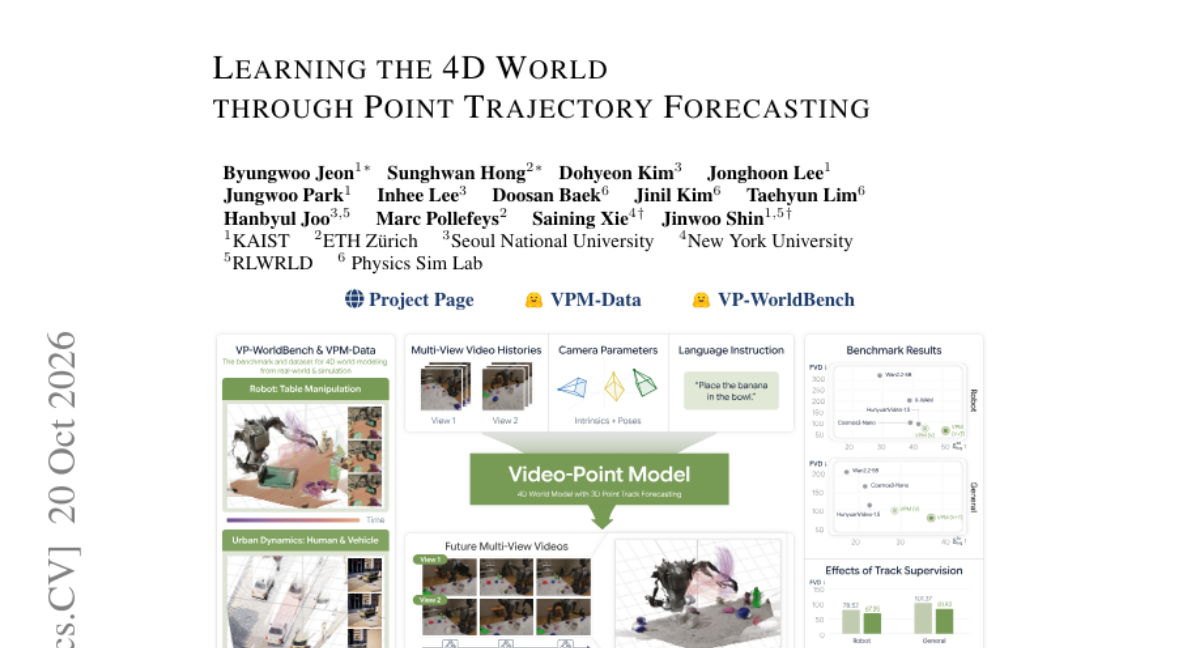
Learning the 4D World through Point Trajectory Forecasting

신뢰할 수 있는 멀티뷰 비디오 예측을 위해서는 서로 다른 카메라 뷰에서 동일한 3D 장면의 변화를 설명할 수 있어야 합니다. 기존 방식은 시각적 변화와 실제 3D 움직임 사이의 정렬이 어려워 물리적 일관성을 유지하기 힘들었습니다. 본 논문은 멀티뷰 비디오와 언어 지시를 조건으로 미래 비디오 및 3상점의 3D 궤적을 동시에 예측하는 Video-Point Model(VPM)을 제안합니다. VPM은 카메라 조건부 멀티뷰 처리와 궤적 예측 헤드를 결합하여, 시각적 외형 변화를 공유된 3D 운동 정보에 고정(anchor)시킵니다. 실험 결과, 점 궤적 감독(point supervision)은 비디오 품질과 3D 움직임 정확도를 모두 향상시켰으며, 로봇 제어 작업에서도 성공률을 높였습니다.

AI 연구

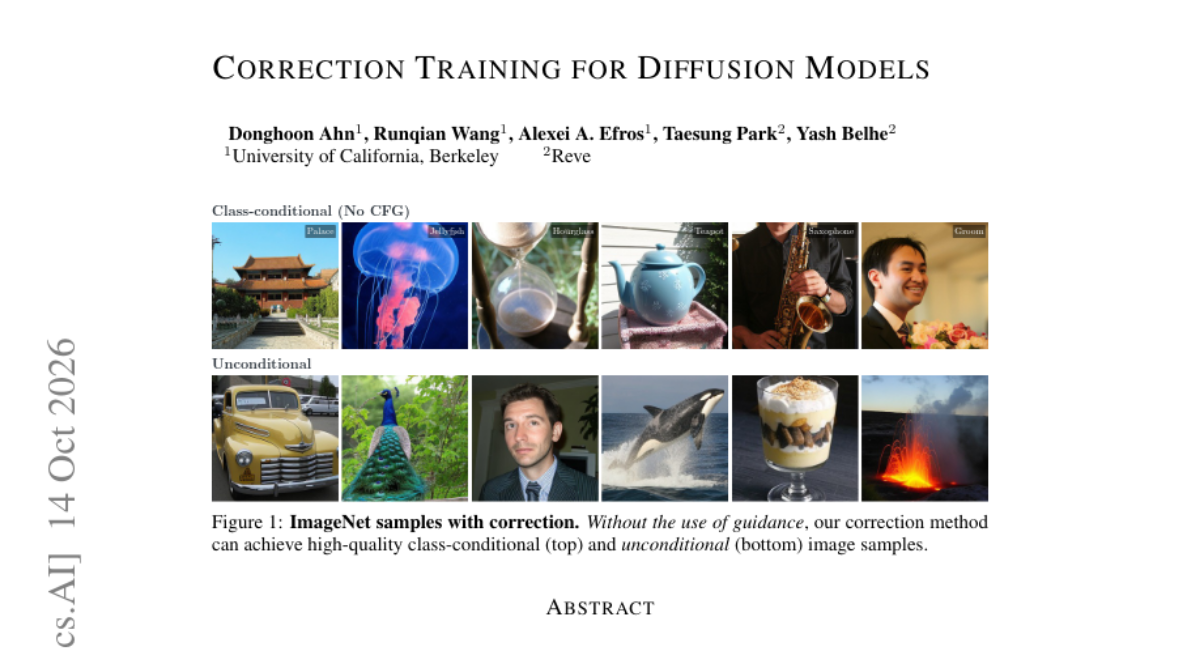
Correction Training for Diffusion Models

확산 모델의 반복적 샘플링 과정에서 발생하는 노이즈 누적과 노출 편향(Exposure Bias)은 생성 품질을 저하시키는 주요 원인입니다. 기존 모델은 학습 시 실제 이미지와 노이즈를 사용하지만, 추론 시에는 이전 단계의 불완전한 예측값을 입력으로 사용하기 때문입니다. 이를 해결하기 위해 베이스 모델의 예측값을 입력으로 받아 정답(Ground-truth)을 예측하도록 하는 별도의 '보정(Corrector)' 단계를 도입합니다. 샘플링 과정에서 각 단계마다 예측값을 반복적으로 정제함으로써 초기 단계의 오류가 최종 결과물로 전이되는 것을 방지합니다. 결과적으로 CFG와 유사한 성능을 내면서도 다양성을 유지하며, 증류(Distillation)를 통해 추론 비용 문제까지 해결할 수 있음을 입증했습니다.

AI 연구

SWIFT: Self-guided Weak-to-strong dIFfusion models via Target extrapolation

고품질 확산 모델 학습은 막대한 연산 비용이 들며, 추론 시 가이드를 적용하면 샘플링 비용이 증가하는 문제가 있습니다. 본 논문은 고정된 약한 노이즈 제거기(weak denoiser)를 활용하여 추론 오버헤드 없이 모델 성능을 높이는 SWIFT 학습법을 제안합니다. SWIFT는 약한 모델의 예측값으로부터 정답 타겟을 멀어지게 하는 외삽 방식을 통해 미학습 성분을 증폭시킵니다. 이 방식은 학습 과정에서만 사용되고 버려지므로 추론 시에는 기존 샘플러를 그대로 유지할 수 있습니다. 이론적 분석과 실험을 통해 제안 방식이 표준 학습보다 낮은 오차를 달성함을 증명하였으며, ImageNet 등에서 적은 연산량으로도 우수한 성능을 기록했습니다.

AI 연구

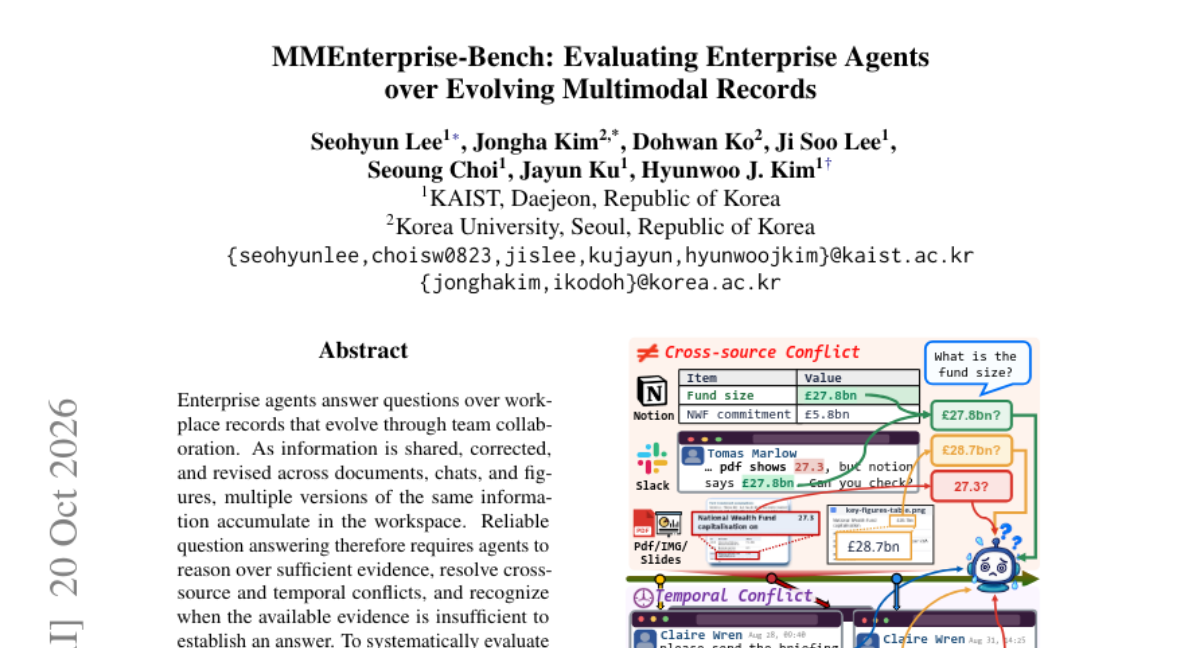
MMEnterprise-Bench: Evaluating Enterprise Agents over Evolving Multimodal Records

기업용 에이전트는 팀 협업을 통해 지속적으로 수정 및 업데이트되는 멀티모달 기록을 바탕으로 답변해야 합니다. 기존 방식은 정보가 공유되고 수정되는 과정에서 발생하는 소스 간 충돌이나 시간적 모순을 해결하는 능력을 평가하기 어렵습니다. 이를 위해 시뮬레이션된 협업 프로젝트의 진화하는 멀티모달 기록을 기반으로 1,613개의 질문을 포함한 MMEnterprise-Bench를 도입했습니다. 10종의 최신 멀티모달 LLM을 평가한 결과, 강력한 모델조차 소스 간 충돌이나 시간적 차이, 다중 이미지 추론 상황에서 성능이 크게 저하되었습니다. 또한 검색 예산(retrieval budget)을 늘리는 것이 반드시 답변 정확도로 이어지지 않음을 확인했습니다.

AI 연구

LLM2R: From Large Language Models to 3D Reassemblers

3D 부품 조립은 각 부품의 SE(3) 변환을 예측하여 완전한 형상을 재구성하는 작업입니다. 기존 방식은 쌍별 관계나 반복적 생성 방식에 의존하여 부품 수가 많아질수록 확장성이 떨어지는 문제가 있었습니다. 본 논문은 LLM2R을 제안하며, Point-BERT와 Q-Former를 통해 부품을 기하학적 토큰으로 압축한 뒤 LLM의 시퀀스 모델링 능력을 활용합니다. 특히 학습 가능한 요약 토큰(summary tokens)을 도입하여 인과적 어텐션의 제약을 극복하고 전체 부품 정보를 통합합니다. 실험 결과, LLM2R은 PartNet 및 Breaking Bad 등 주요 벤치마크에서 기존 방식보다 높은 정확도와 빠른 추론 속도를 기록하며 뛰어난 확장성을 입증했습니다.

AI 연구

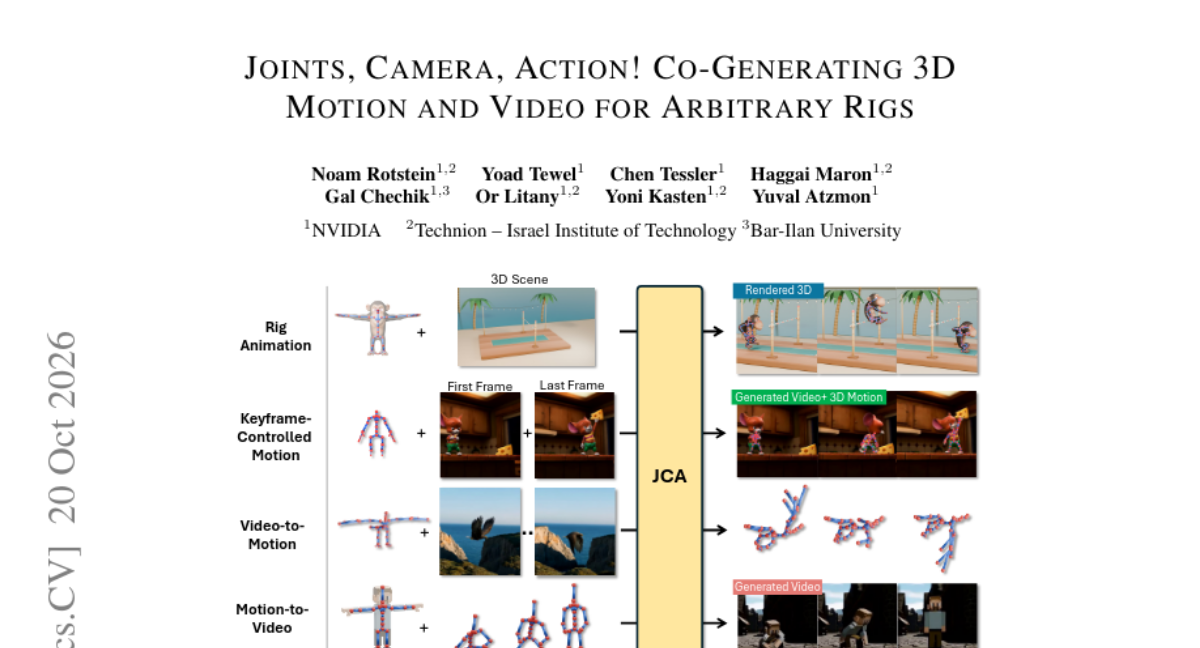
Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs

기존 비디오 생성 모델은 사실적인 움직임을 보여주지만, 이를 3D 장면 내에서 재사용 가능한 3상 모션 데이터로 변환하는 데 한계가 있습니다. 본 논문은 임의의 스켈레톤 구조를 지원하는 3D 모션 모델과 사전 학습된 비디오 모델을 결합하여, 비디오와 3D 모션 및 카메라 정보를 동시에 생성하는 프레임워크를 제안합니다. 모션 모델은 별도로 분리되어 다양한 스켈레톤의 움직임을 학습하며, 비디오 모델과의 크로스 어텐션을 통해 상호 작용합니다. 또한, 생성된 비디오 내 관절 위치를 통해 카메라 정보를 복원하여 3D 장면과의 정렬을 가능하게 합니다. 실험 결과, 제안 모델은 기존 방식보다 다양한 리그에 대해 더 충실한 애니메이션을 생성하며 비디오와 모션 간의 양방향 변환을 지원합니다.

AI 연구

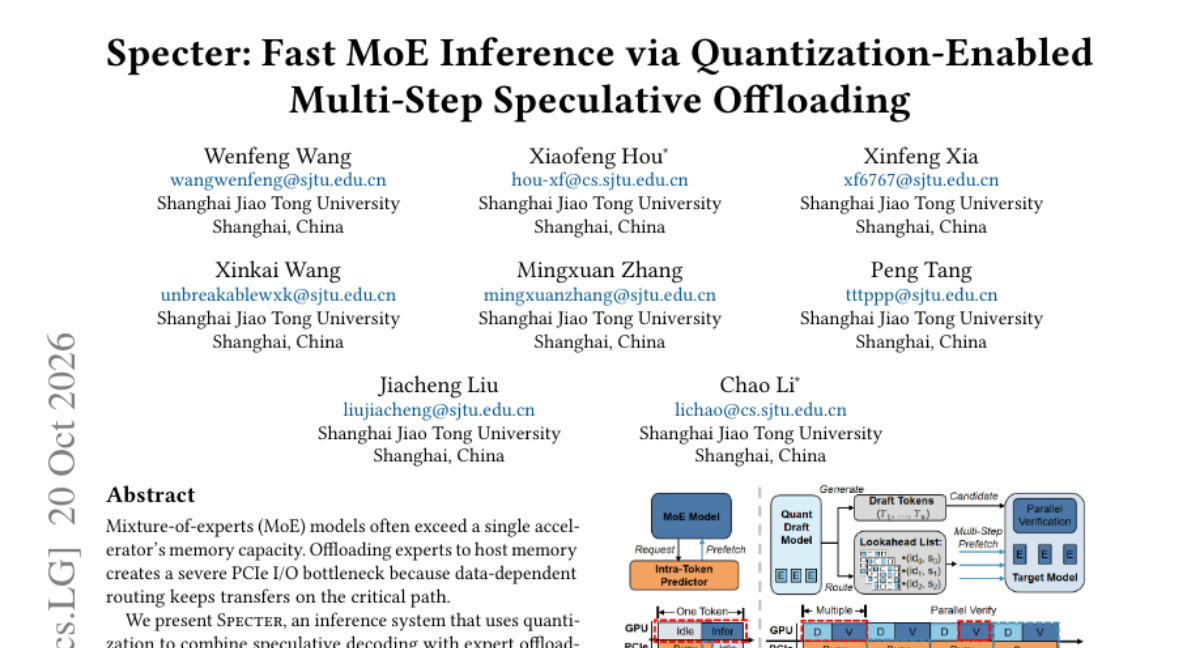
Specter: Fast MoE Inference via Quantization-Enabled Multi-Step Speculative Offloading

대규모 MoE 모델은 단일 가속기의 메모리 용량을 초과하는 경우가 많아 호스트 메모리로 전문가(Expert)를 오프로딩해야 합니다. 그러나 데이터 의존적인 라우팅 특성상 PCIe I/O 병목이 발생하여 추론 속도가 저하되는 문제가 있습니다. 본 논문은 양자화를 통해 Speculative Decoding과 Expert Offloading을 결합한 Specter를 제안합니다. 경량 양자화 드래프트 모델이 장치 내에서 효율적으로 실행되며 미래의 전문가 사용 패턴을 정확하게 예측합니다. 이를 통해 런타임이 검증 단계 이전에 전문가 이동 및 실행을 미리 준비할 수 있어 통신과 실행 효율을 동시에 개선합니다. 실험 결과, 단일 요청 추론 환경에서 기존 SOTA 대비 평균 1.50배(최대 1.88배)의 TPOT 성능 향상을 달られ했습니다.

AI 연구

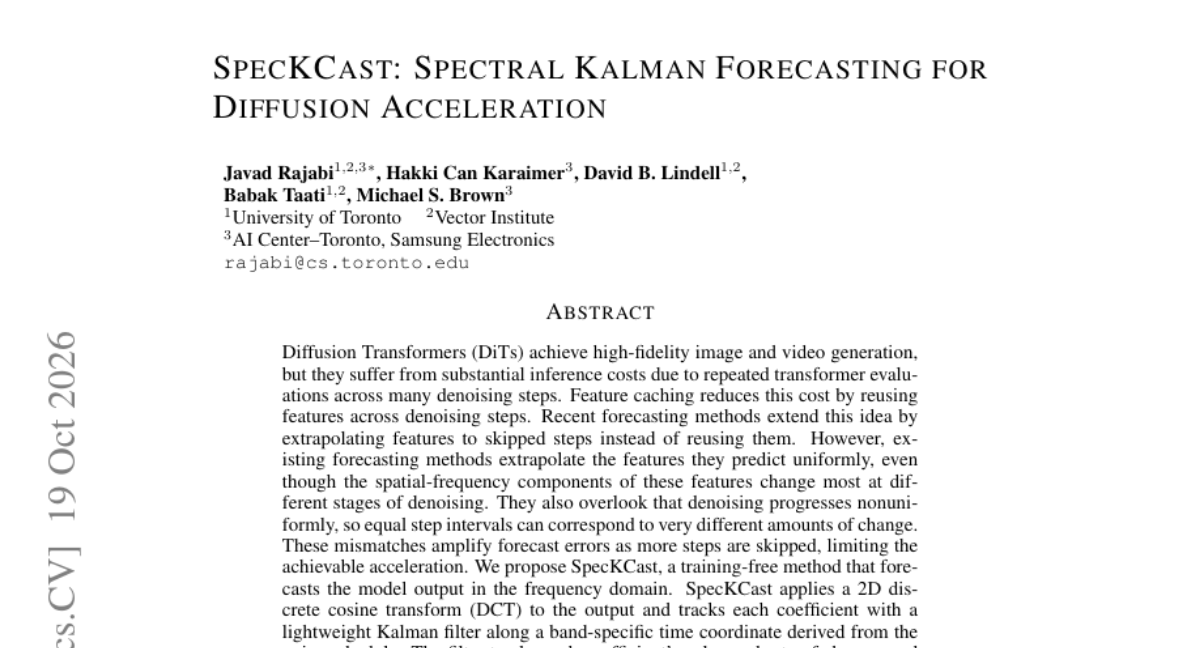
SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration

Diffusion Transformer(DiT)는 고품질 생성 성능을 제공하지만, 반복적인 디노이징 단계로 인해 추론 비용이 매우 높습니다. 기존의 피처 캐싱 및 예측 방식은 공간-주파수 성분의 변화 특성과 비균일한 노이즈 스케줄을 고려하지 못해 예측 오차가 누적되는 문제가 있었습니다. 이를 해결하기 위해 제안된 SpecKCast는 출력값에 2D DCT를 적용하여 주파수 도메인에서 계수를 추적합니다. 각 계수는 노이즈 스케줄에 기반한 밴드별 시간 좌표를 가진 경량 칼만 필터에 의해 관리됩니다. 필터의 예측 불확실성이 임계값을 초과할 때만 트랜스포머를 실행함으로써 효율적인 가속을 달성합니다. 실험 결과, FLUX.1-dev 등 최신 모델에서 메모리 증가를 최소화하면서 기존 방식보다 뛰어난 가속-품질 트레이드오프를 보여주었습니다.

AI 연구

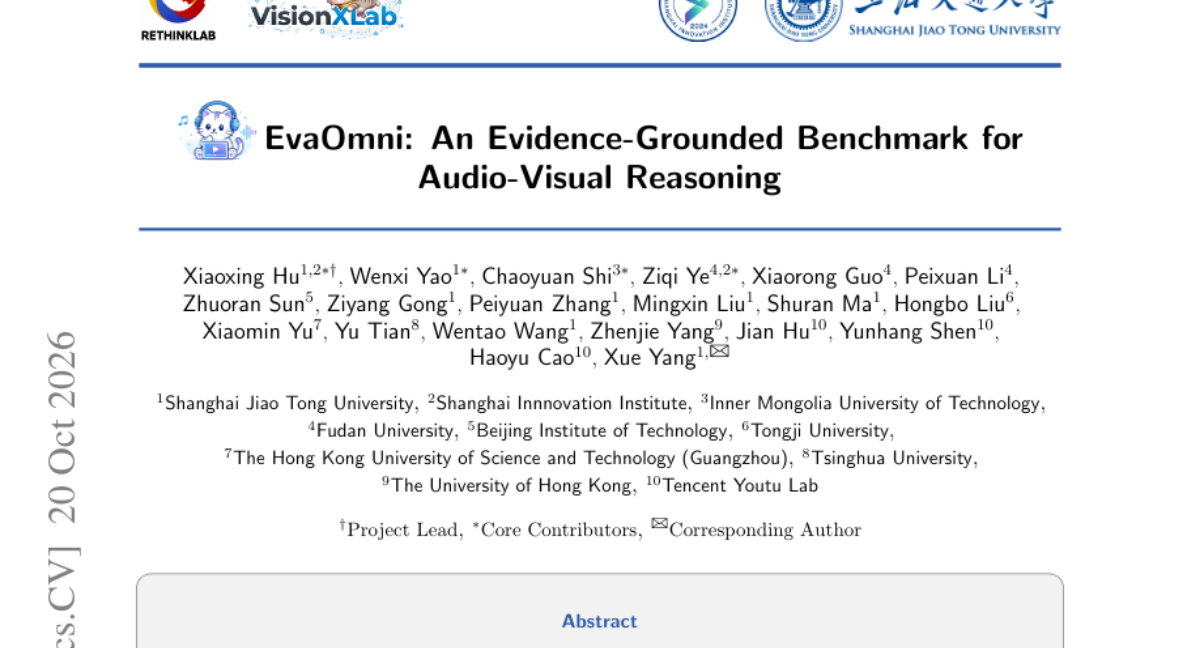
EvaOmni: An Evidence-Grounded Benchmark for Audio-Visual Reasoning

기존의 멀티모달 벤치마크는 객관식 정답 여부에만 치중하여 모델이 실제 근거를 바탕으로 추론하는지 확인하기 어렵고, 텍스트나 단일 모달리티의 지름길(shortcut)을 이용한 부정확한 정답 도출 문제를 안고 있습니다. 이를 해결하기 위해 전문가가 직접 오디오/비디오 근거와 방해 요소를 설계한 392개의 비디오와 1,027개의 QA 쌍을 포함한 EvaOmni 벤치마크를 제안합니다. 모델이 정답과 함께 근거 구간을 동시에 제출하도록 하여 추론 과정을 검증하며, 근거 커버리지(C.G.)와 시간적 국소화 정확도(B.G.)를 결합한 새로운 평가 지표를 도입했습니다. 실험 결과, 최신 모델인 Gemini 1.5 Flash가 가장 높은 성능을 보였으나, 복잡한 추론 단계에서 근거 구간을 찾는 능력은 여전히 개선의 여지가 있음을 확인했습니다.

AI 연구

Evolving Agent Interfaces

기존의 컴퓨터 사용 에이전트는 사람이 수동으로 설계한 인터페이스에 의존하여 비효율적인 작업 방식을 반복하는 한계가 있습니다. 이를 해결하기 위해 인터페이스 설계 자체를 에이전트의 핵심 역량으로 만드는 'Agent S4'를 제안합니다. Agent S4는 메타 에이전트가 작업 궤적을 분석하여 인터페이스와 사용법을 저장소에 구축하고, 인구 기반 진화(Population-based evolution)를 통해 일반화 성능이 높은 인터페이스를 선택합니다. 실험 결과, Agent S4는 OSWorld V2 벤치마크에서 기존 고정 인터페이스 대비 3.8배 높은 성능을 기록하며 SOTA를 달성했습니다. 이는 모델의 발전만큼이나 자동화된 인터페이스 설계가 에이전트 성능 향상의 핵심 동력이 될 수 있음을 시사합니다.

AI 연구

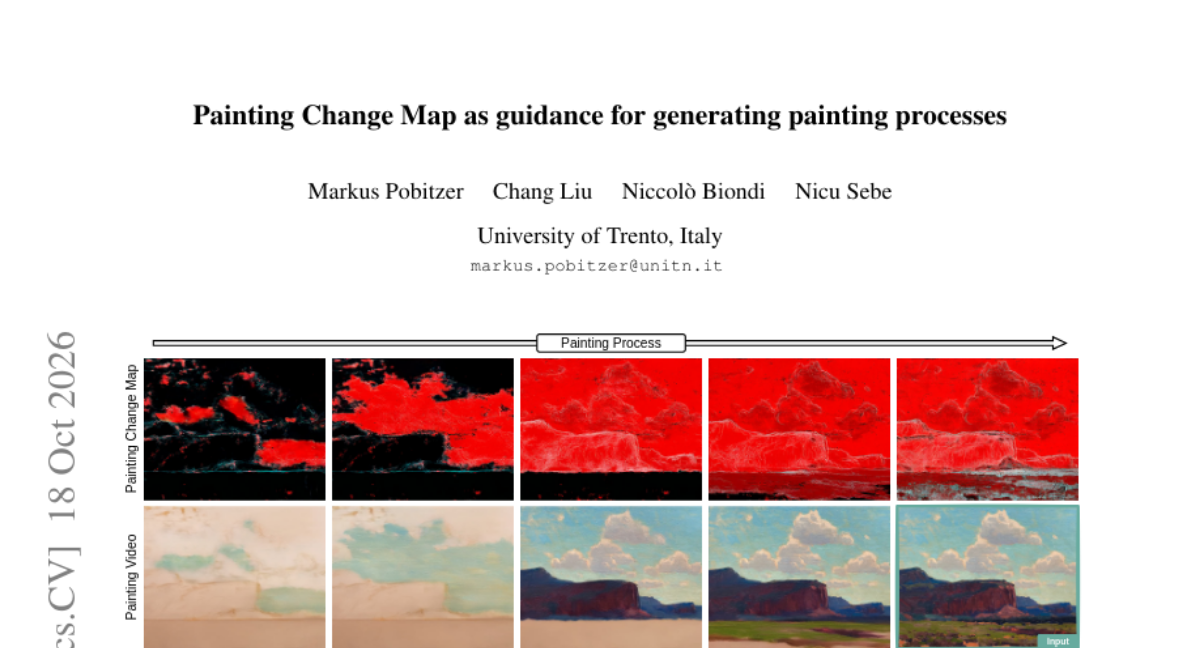
Painting Change Map as guidance for generating painting processes

기존의 디지털 아트 생성 모델은 정적인 이미지 합성을 넘어 동적인 페인팅 과정을 모방하는 방향으로 진화하고 있습니다. 그러나 기존 방식은 기하학적 큐(C적 엣지 등)에 의존하여 너무 경직되어 있거나, 단순 진행도 변수를 사용하여 국소적인 제어가 불가능하다는 문제가 있었습니다. 본 논문은 예술적 행위의 '위치'와 '시기'를 동시에 제어해야 한다고 주장하며, 1,000단계의 시공간적 변화를 추적하는 'Painting Change Map'을 제안합니다. 이 메커니즘은 국소적 시각적 차이를 인코딩된 RGB 공간으로 매핑하여 정교한 페인팅 및 언페인팅 과정을 가능하게 합니다. 실험 결과, 제안 방식은 기존 베이스라인을 능가하며 오라클 조건에서 압도적인 성능을 보여주었습니다.

AI 연구

Breaking Diffusion: Parallel Reasoning with Draft Refinement

기존의 확산(Diffusion) 모델은 개별 토큰 업데이트가 전체 답변의 품질로 이어지는 것을 보장하기 어렵다는 문제가 있었습니다. 이를 해결하기 위해 저자들은 단일 디노이저로 병렬 수정을 제안하고 초안을 평가하는 DRLM을 도입했습니다. 모델은 무작위로 손상된 초안에서 토큰을 복구하는 방식으로 학습되어 보존과 수리 능력을 동시에 갖춥니다. 별도의 스코어링 모델 없이도 신뢰도 기반의 'Cavity Energy'를 계산하여 초안의 품질을 평가합니다. 실험 결과, Countdown 및 Sudoku-Extreme 등 복잡한 추론 작업에서 기존 자기회귀 및 확산 모델보다 뛰어난 성능을 기록했습니다.

AI 연구

PhysSkin++: Real-Time and Generalizable Physics-Based Animation via Self-Supervised Neural Skinning

다양한 3격자 구조와 형상에 대해 실시간 물리 애니메이션을 일반화하는 것은 매우 어려운 과제입니다. 본 논문은 정적 기하 구조로부터 연속적인 뉴럴 스키닝 필드를 학습하여 압축된 변형 서브스페이스를 구축하는 PhysSkin++ 프레임워크를 제안합니다. 제안된 Neural Skinning Fields Autoencoder는 개별 객체별 학습 없이도 형상에 의존적인 변형 공간을 예측합니다. 또한, 시뮬레이션 궤적 없이 학습하기 위해 스키닝 필드 정규화와 충돌 인지 그래디언트 보정을 결합한 자기주도 학습 전략을 사용합니다. 결과적으로 학습된 표현은 사용자 제어, 충돌 상호작용, 그리고 메쉬/포인트 클라우드/3D 가우시안에 대한 직접적인 애니메이션 바인딩을 지원하며 실시간 시뮬레이션을 가능하게 합니다.

AI 연구

FlowState: Execution State as Memory for Long-Horizon LLM Agents

장기 작업(Long-horizon tasks)을 수행하는 LLM 에이전트는 과거 정보를 유지해야 하지만, 전체 이력을 유지하면 비용이 증가하고 압축하면 세부 정보가 손실되는 문제가 있습니다. 이를 해결하기 위해 실행 상태를 메모리로 취급하여 필요할 때만 재방문하는 FlowState를 제안합니다. FlowState는 의미론적 상태 노드와 도구 관찰 기록을 분리하여 보존하며, Incremental State Update(IS식 업데이트)와 Progressive State Access(점진적 상태 접근) 메커니즘을 통해 상태를 관리합니다. 실험 결과, 기존 Full-context 방식 대비 성공률은 높이면서 토큰 소비량은 약 40% 이상 절감하는 성과를 거두었습니다. 이는 정보의 지속적 유지와 온디맨드 접근을 결합하여 에이전트의 추론 효율성을 극대화한 결과입니다.

AI 연구

Epi: Towards a Persistent, Self-Improving Agent for Autonomous Research

기존의 AI 에이전트는 세션이 종료되면 연구 맥락이 소실되거나 실험 결과로부터 스스로 진화하는 데 한계가 있었습니다. 이를 해결하기 위해 지속적인 연구 이력, 계층적 메모리, 분기형 탐색 및 독립적 검증 메커니즘을 결합한 Épi를 제안합니다. Épi는 세션 경계를 넘나드는 실험과 고정된 검증기를 통해 연구의 연속성을 유지하며, 축적된 경험을 바탕으로 방법론을 스스로 개선합니다. 실험 결과, 수많은 수치적 기록 경신과 더불어 Tuza의 추측에 대한 컴퓨터 보조 증명을 달성하는 등 탁월한 연구 역량을 입증했습니다. 또한 경량화 버전인 Épi-turbo를 통해 알고리즘 코딩 분야에서도 높은 효율성을 보여주었습니다.

AI 연구

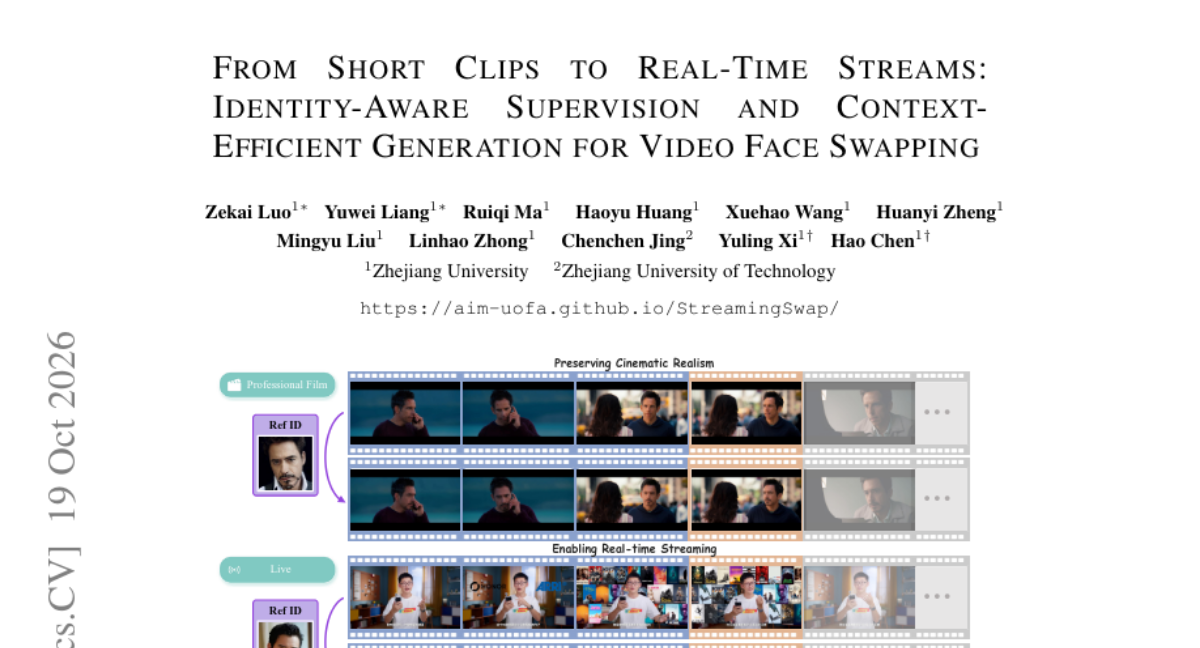
From Short Clips to Real-Time Streams: Identity-Aware Supervision and Context-Efficient Generation for Video Face Swapping

기존의 비디오 페이스 스와핑 기술은 정체성 전이, 고화질 유지, 그리고 긴 비디오 스트림에서의 실시간 생성이라는 세 가지 목표를 동시에 달성하는 데 어려움이 있었습니다. 본 논문은 페이스 스와핑 작업의 특성을 재해석하여 두 가지 핵심 전략을 제안합니다. 첫째, 정체성 정보와 잠재 재구성 사이의 균형을 맞추는 Joint Rec-ID Loss를 통해 정체성 전이 성능을 높였습니다. 둘째, Face-RoI Generation과 Short-Context Rollout Training을 통해 연산 효율을 극대화하여 적은 토큰과 짧은 컨텍스트로도 안정적인 생성을 가능케 했습니다. 이를 통해 제안된 StreamingSwap은 단일 RTX 4090 GPU에서 20 FPS의 속도로 최대 10분 길이의 영상에서도 안정적인 성능을 보여줍니다. 또한 대규모 데이터셋인 HumanFaceVid를 함께 공개하여 연구의 신뢰성을 높였습니다.

AI 연구

Event-STVG: Spatio-Temporal Video Grounding for Long-Form Event Reasoning

기존의 시공간 비디오 접지(STVG)는 주로 개별 객체의 외형적 특징을 찾는 데 집중하여, 긴 영상 속 맥락을 파악하는 추론 능력과는 거리가 있었습니다. 본 논문은 단순 위치 탐지를 넘어 사건 중심의 추론을 요구하는 'Event-STVG' 태스크를 제안합니다. 이를 위해 축구 등 다양한 도메인을 포함한 4,016개의 이벤트가 포함된 대규모 벤치마크를 구축했습니다. 실험 결과, 최신 MLLM 모델들도 긴 시간 범위 내에서 복잡한 이벤트를 수행하는 데 매우 큰 어려움을 겪는 것으로 나타났습니다. 결과적으로 본 연구는 시공간적 맥락과 역할 추론이 결합된 차세대 비디오 이해 모델의 필요성을 입증했습니다.

AI 연구

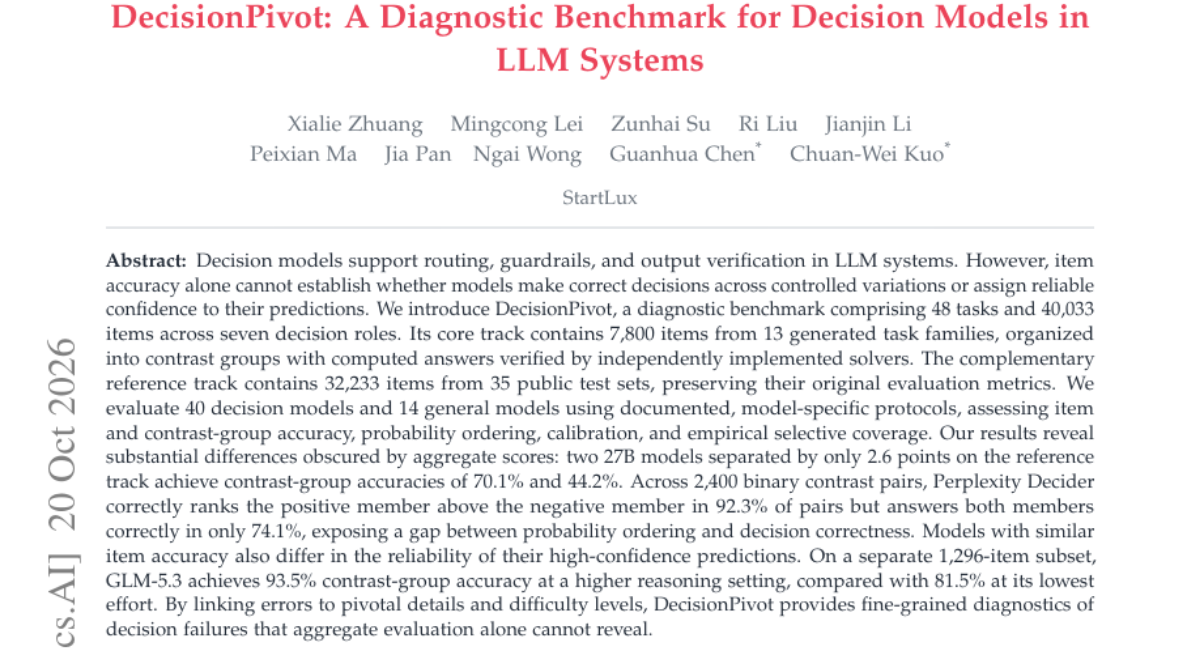
DecisionPivot: A Diagnostic Benchmark for Decision Models in LLM Systems

LLM 시스템에서 라우팅, 가드레일, 검증을 담당하는 의사결정 모델의 성능은 단순 정확도만으로 판단하기 어렵습니다. 기존 평가 방식은 모델이 제어된 변동 상황에서 일관된 결정을 내리는지, 혹은 예측에 신뢰할 수 있는 확신을 부여하는지 파악하는 데 한계가 있습니다. 이를 해결하기 위해 48개 태스크와 4만 개 이상의 아이템으로 구성된 진단 벤치마크 DecisionPivot를 도입합니다. 연구진은 54개 모델을 대상으로 확률 순위, 캘리브레이션, 선택적 커버리지 등을 평가했습니다. 결과적으로 총점은 비슷해도 의사결정의 일관성이나 고신뢰도 예측의 신뢰도에서 큰 차이가 발생함을 확인했습니다. DecisionPivot는 집계 점수에 가려진 미세한 의사결정 실패 원인을 파악할 수 있는 정밀 진단 도구를 제공합니다.

AI 연구

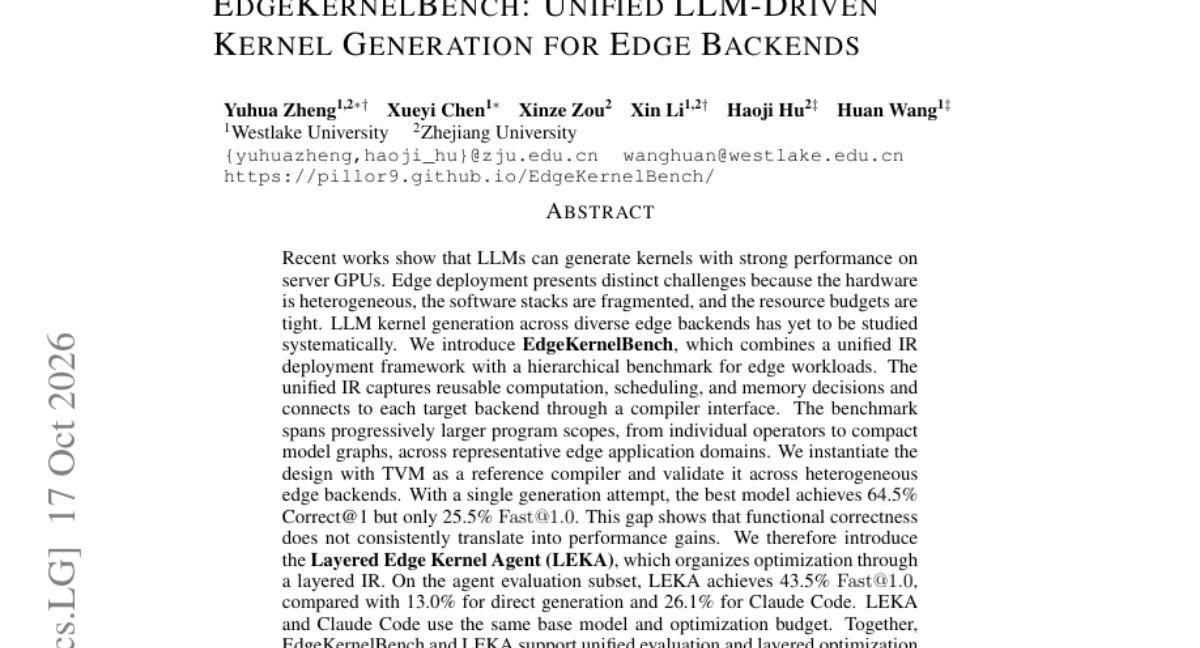
EdgeKernelBench: Unified LLM-Driven Kernel Generation for Edge Backends

최근 LLM을 이용한 GPU 커널 생성 성능이 향상되었으나, 하드웨어가 이기종이고 자원이 제한된 엣지 환경에서는 성능 최적화가 어렵습니다. 이를 위해 통합 IR 프레임워크와 계층적 벤치마크를 결합한 EdgeKernelBench를 제안합니다. 제안된 프레임워크는 재사용 가능한 연산과 스케줄링 결정을 캡처하며, TVM을 통해 다양한 엣지 백엔드에서 검증되었습니다. 실험 결과, 단순 생성 방식은 기능적 정확도에 비해 성능 최적화가 부족함을 확인했습니다. 이를 해결하기 위해 계층적 IR을 활용하는 LEKA 에이전트를 도입하여 성능을 대폭 개선했습니다. 결과적으로 EdgeKernelBench와 LEKA는 엣지 환경에 특화된 LLM 커널 생성 및 평가 체계를 제공합니다.

AI 연구

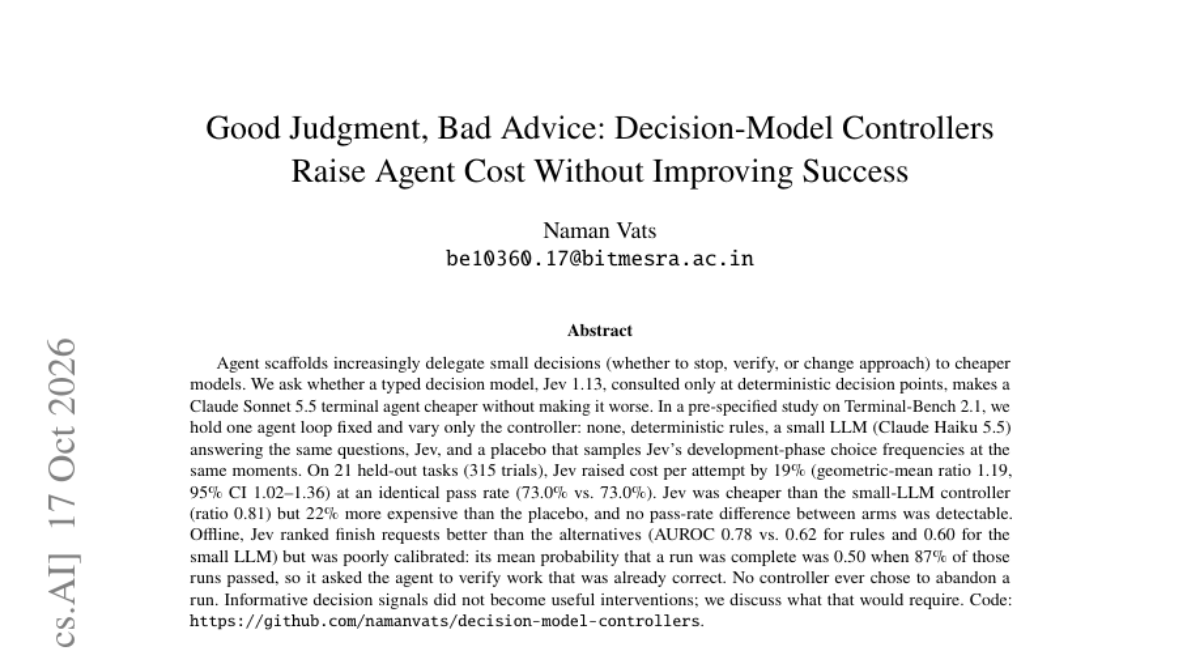
Good Judgment, Bad Advice: Decision-Model Controllers Raise Agent Cost Without Improving Success

에이전트 프레임워크는 비용 절감을 위해 작은 모델이 의사결정을 내리는 스캐폴드를 점차 도입하고 있습니다. 본 연구는 결정론적 의사결정 모델인 Jev 전용 컨트롤러가 에이전트의 비용과 성공률에 미치는 영향을 분석했습니다. Terminal-Bench 2.1 환경에서 규칙 기반, 소형 LLM, Jev, 위약(placebo) 컨트롤러를 비교 실험했습니다. 실험 결과, Jev는 성공률 변화 없이 비용만 19% 증가시켰으며, 위약 모델보다 22% 더 비싼 비용을 발생시켰습니다. Jev는 작업 종료 시점을 예측하는 데는 우수했으나, 이미 성공한 작업에 대해 불필요한 검증을 요청하는 등 캘리브레이션 문제가 발생했습니다. 결론적으로 정보성 의사결정 신호가 실제 유효한 개입으로 이어지지 못함을 보여줍니다.

AI 연구

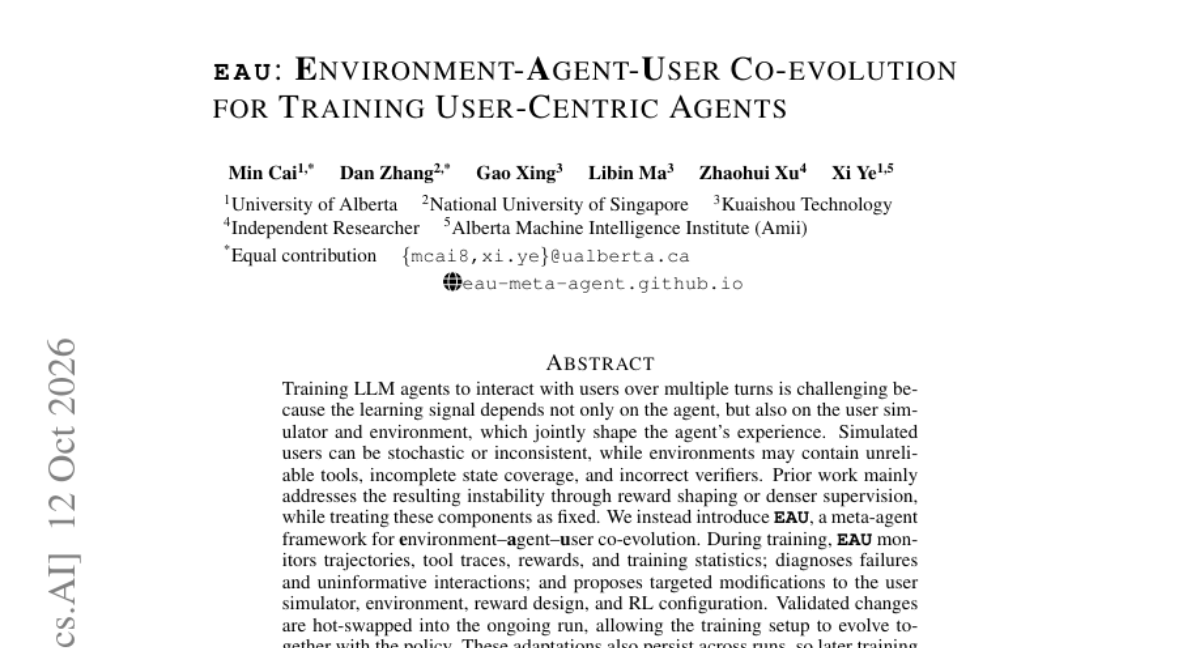
EAU: Environment-Agent-User Co-evolution for Training User-Centric Agents

멀티턴 대화형 에이전트 학습은 에이전트뿐만 아니라 사용자 시뮬레이터와 환경의 상호작용에 의해 학습 신호가 결정되는 복잡한 문제를 가집니다. 기존 방식은 환경이나 사용자를 고정된 요소로 간주하여 보상 설계나 감독을 통해 불안정성을 해결하려 했습니다. 본 논문은 환경-에이전트-사용자가 함께 진화하는 메타 에이전트 프레임워크인 EAU를 제안합니다. EAU는 궤적과 도구 실행 기록 등을 모니터링하여 실패 원인을 진단하고, 사용자 시뮬레이터와 환경 설정을 동적으로 수정합니다. 이러한 변화는 심볼릭 표현을 통해 관리되며 학습 과정에 즉시 반영되어 에이전트 정책과 함께 진화합니다. 실험 결과, EAU는 기존 RL 방식 대비 성능을 크게 향상시켰으며 특히 태스크 성공률을 대폭 개선했습니다.

AI 연구

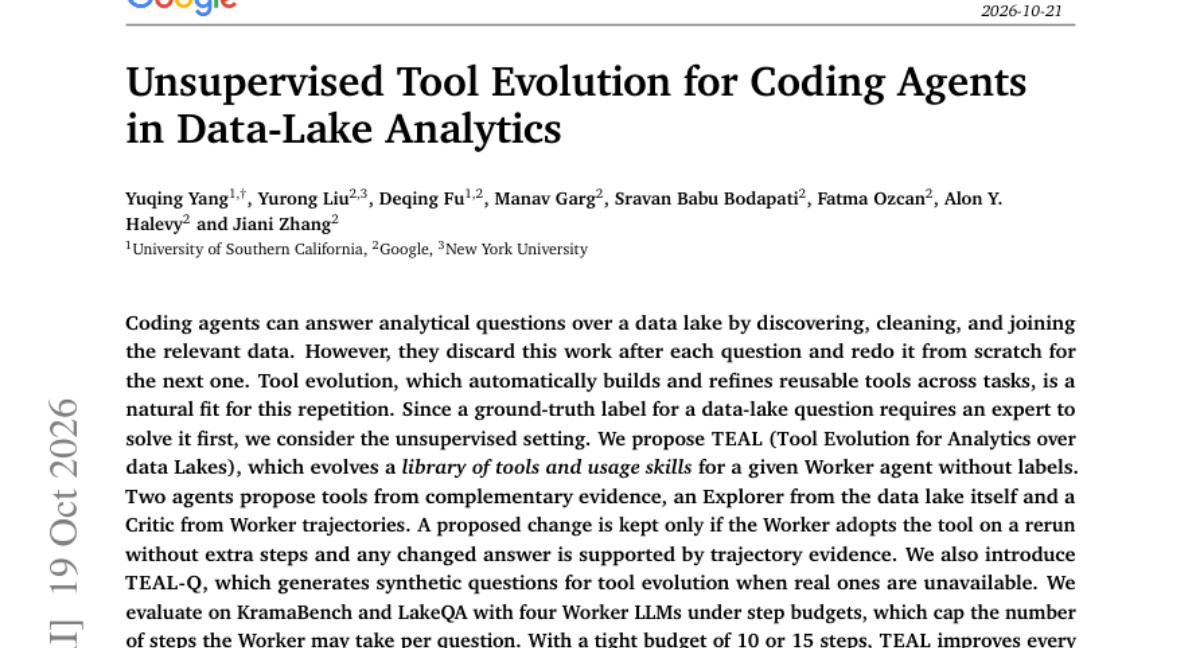
Unsupervised Tool Evolution for Coding Agents in Data-Lake Analytics

데이터 레이크 분석 에이전트는 매 질문마다 데이터 탐색과 정제 과정을 처음부터 반복하는 비효율성을 가집니다. 이를 해결하기 위해 정답 라벨 없이도 도구를 자동 구축하는 비지도 방식의 TEAL 프레임워크를 제안합니다. TEAL은 데이터 자체에서 도구를 제안하는 Explorer와 작업 궤적을 분석하는 Critic 두 에이전트가 협력하여 도구를 진화시킵니다. 제안된 도구는 작업자가 추가 단계 없이 이를 채택하고 결과가 검증될 때만 라이브러리에 유지됩니다. 실험 결과, 제안된 방식은 제한된 단계(step budget) 내에서 기존 모델들의 성능을 크게 향상시켰으며 합성 데이터로도 효과적인 진화가 가능함을 입증했습니다.

AI 연구

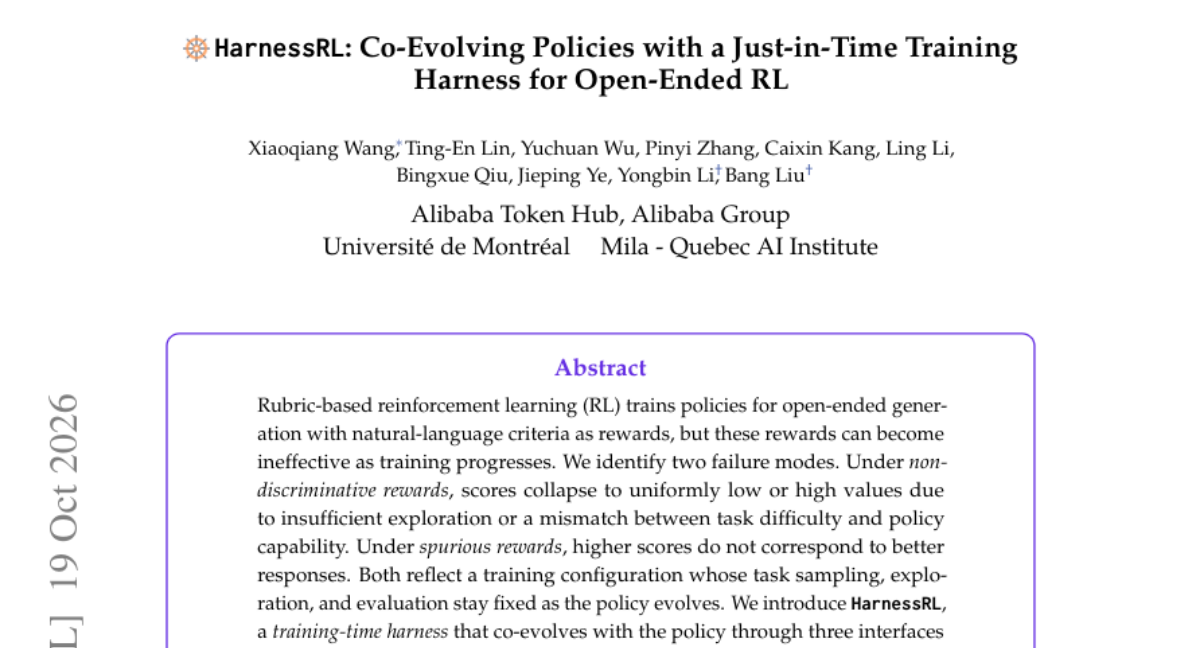
HarnessRL: Co-Evolving Policies with a Just-in-Time Training Harness for Open-Ended RL

자연어 기준을 보상으로 사용하는 루브릭 기반 RL은 학습이 진행됨에 따라 보상이 무력해지는 문제가 발생합니다. 연구진은 탐색 부족으로 인한 점수 붕괴와 보상과 성능 간의 불일치라는 두 가지 주요 실패 모드를 식별했습니다. 이를 해결하기 위해 태스크 샘플링, 롤아웃 가이드, 루브릭 기준을 정책과 함께 동적으로 변화시키는 HarnessRL 프레임워크를 도입했습니다. HarnessRL은 학습 메모리를 활용해 실패 원인을 분석하고, 제안자(proposer)와 비판자(critic) 루프를 통해 검증된 업데이트만 적용합니다. 실험 결과, HarnessRL은 다양한 도메인에서 기존 베이스라인보다 높은 성능을 보였으며 학습 단계(training steps)를 대폭 단축했습니다.

AI 연구

Harness Self-Evolution for Long-Horizon Terminal Agents

장기 작업 수행 에이전트는 동일한 설정에서도 실행 시마다 성공과 실패가 갈리는 확률적 오류 문제를 겪습니다. 이러한 오류는 액션과 컨텍스트의 전파로 인해 발생하며, 모델의 잠재적 능력과 실제 실행 신뢰도 사이의 간극을 만듭니다. 본 논문은 모델 가중치를 고정한 채 에이전트 실행 환경을 반복적으로 개선하는 RiseHarness 프레임워크를 제안합니다. RiseHarness는 성공과 실패 사례를 비교 분석하고, 런타임 모니터링을 통해 모델의 액션과 실행 환경 간의 상호작용을 추적합니다. 수집된 증거를 바탕으로 기존 프레임워크의 구현체를 탐색 및 적응시키며, 검증된 개선 사항을 다음 반복 루프에 반영합니다. 이를 통해 특정 모델에 최적화된 실행 환경을 구축하여 작업 성공률과 신뢰도를 높일 수 있음을 입증했습니다.

AI 연구

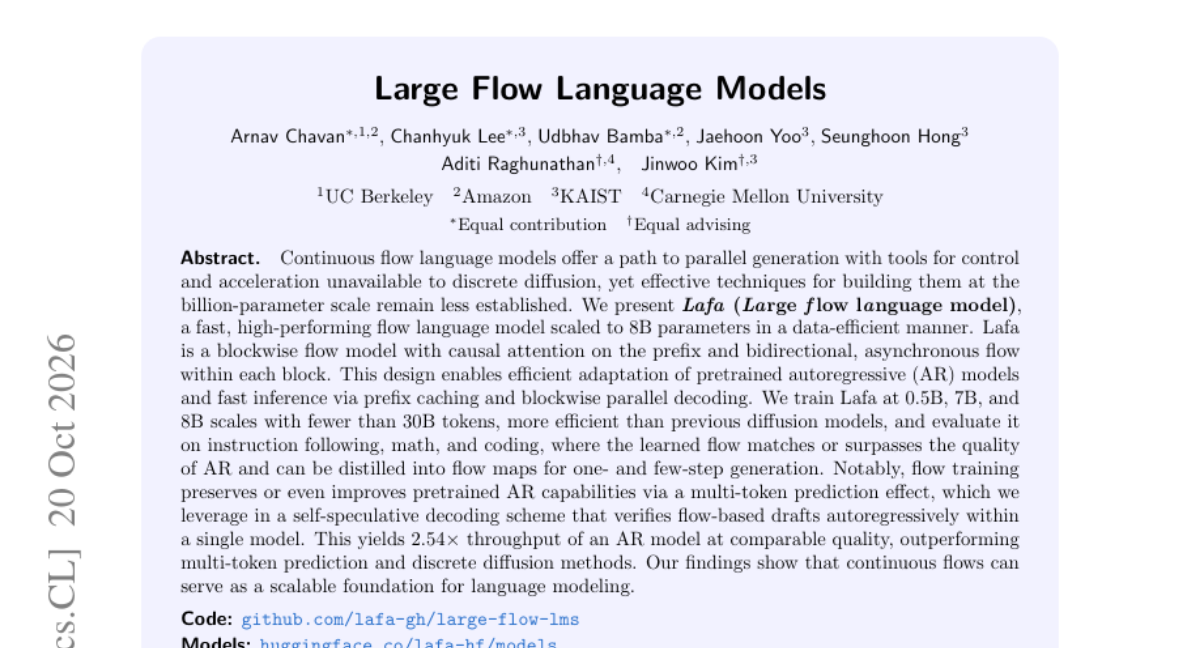
Large Flow Language Models

기존의 이산 확산 모델(Discrete Diffusion)은 병렬 생성과 제어 측면에서 장점이 있지만, 대규모 파라미터 모델로 확장하는 데 어려움이 있었습니다. 본 논문은 사전 학습된 AR 모델을 효율적으로 변형하여 8B 규모까지 확장 가능한 블록 단위 Flow 모델인 Lafa를 제안합니다. Lafa는 접두사(Prefix)에는 인과적 어텐션을, 블록 내부에는 양방향 비동기 Flow를 적용하여 효율적인 학습과 빠른 추론을 동시에 달성합니다. 적은 토큰 데이터로도 높은 성능을 내며, 자기 투기적 디코딩(Self-speculative decoding)을 통해 AR 모델 대비 2.54배 높은 처리량을 기록했습니다. 결과적으로 연속적 Flow 방식이 대규모 언어 모델의 확장 가능한 기초가 될 수 있음을 입증했습니다.

AI 연구

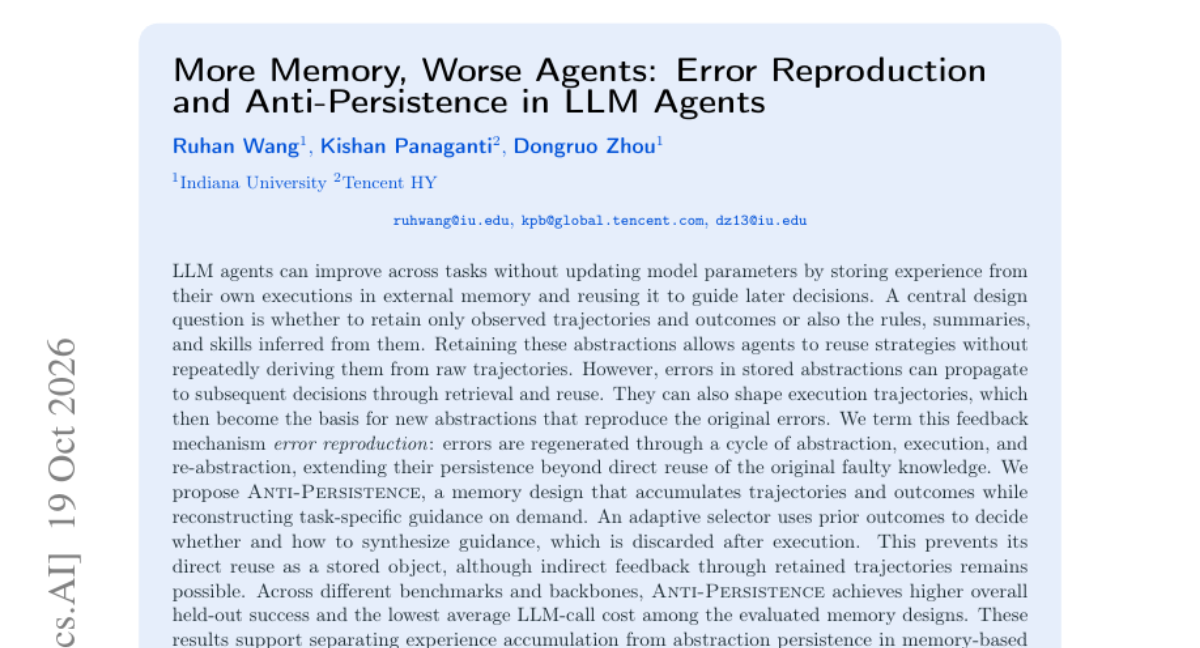
More Memory, Worse Agents: Error Reproduction and Anti-Persistence in LLM Agents

LLM 에이전트는 외부 메모리에 경험을 저장하고 재사용함으로써 파라미터 업데이트 없이도 성능을 개선할 수 있습니다. 그러나 저장된 추상화(규칙, 요약 등)에 포함된 오류는 재사용 과정에서 의사결정에 영향을 미치며, 새로운 실행 경로를 통해 오류가 재생산되는 'Error Reproduction' 현상을 야기합니다. 이를 해결하기 위해 본 논문은 경험은 축적하되 가이드는 실행 시점에만 생성하고 폐기하는 'Anti-Persistence' 메모리 설계를 제안합니다. 이 방식은 적응형 선택기를 통해 필요할 때만 가이드를 합성하여 오류의 직접적인 전파를 방지합니다. 실험 결과, 제안 방식은 다양한 벤치마크에서 더 높은 성공률과 낮은 LLM 호출 비용을 달성했습니다.

AI 연구

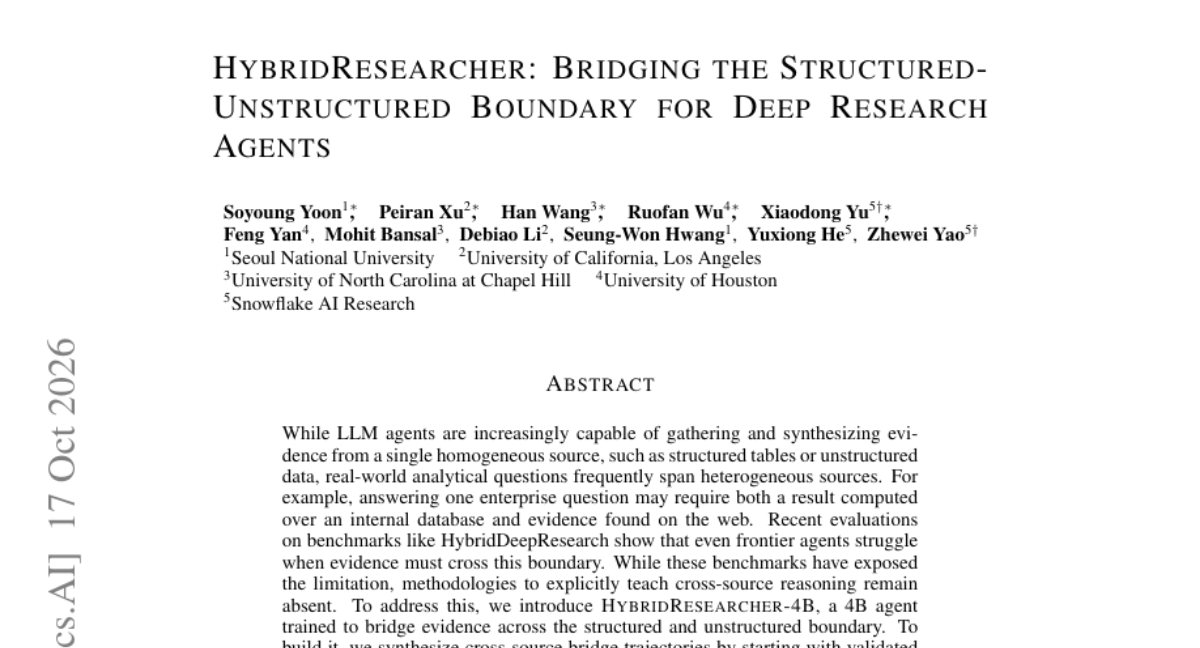
HybridResearcher: Bridging the Structured-Unstructured Boundary for Deep Research Agents

최근 LLM 에이전트는 단일 소스 데이터 처리에 능숙하지만, 데이터베이스와 웹 검색처럼 서로 다른 성격의 소스를 결합해야 하는 실무적 문제 해결에는 어려움을 겪습니다. 이를 해결하기 위해 연구진은 구조화된 데이터와 비구조화된 데이터 사이의 경계를 넘나드는 'HybridResearcher'를 제안합니다. 데이터 구축 과정에서 단일 소스만으로는 정답을 얻을 수 없도록 엄격한 제약 조건을 적용한 교차 소스 추론 트레이닝 데이터를 합성했습니다. 이 데이터를 바탕으로 SFT와 RL을 결합하여 소형 모델을 학습시켰습니다. 실험 결과, HybridResearcher는 훨씬 거대한 모델보다 높은 성능을 보였으며 단일 소스 작업에 대한 성능 저하 없이 복합 추론 능력을 확보했습니다.

AI 연구

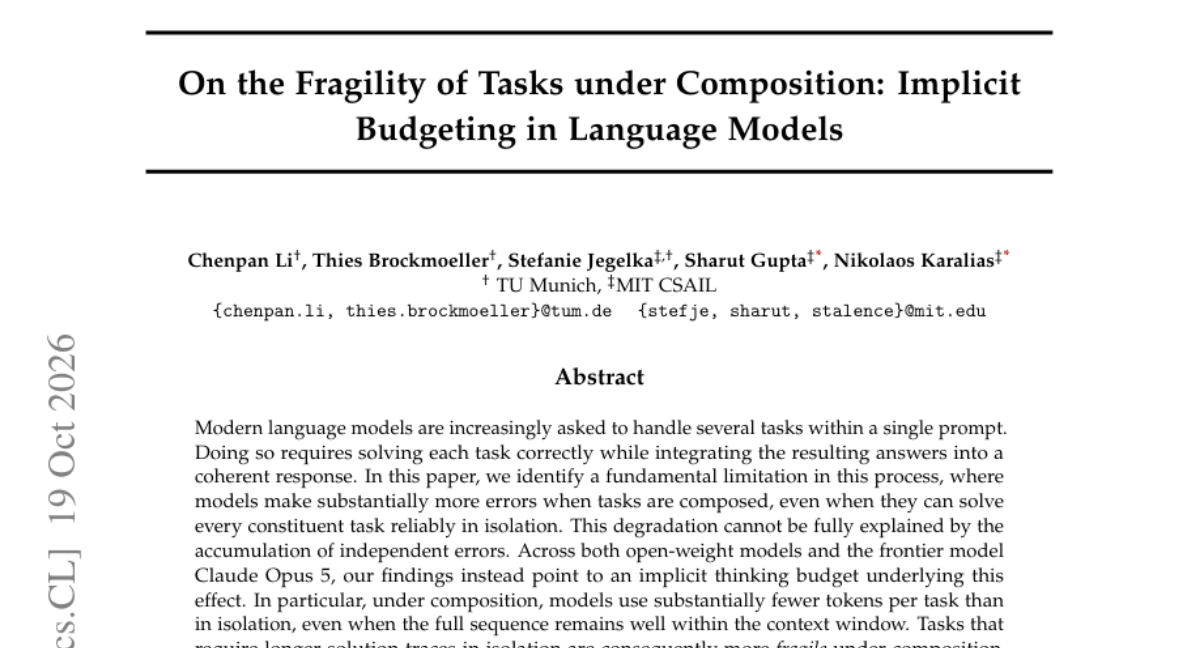
On the Fragility of Tasks under Composition: Implicit Budgeting in Language Models

최근 언어 모델은 단일 프롬프트 내에서 여러 작업을 동시에 수행하는 경우가 많아지고 있습니다. 연구진은 개별 작업은 잘 수행하던 모델이 여러 작업을 결합할 때 성능이 급격히 저하되는 현상을 발견했습니다. 이러한 성능 저하는 단순한 오류 누적이 아니라, 모델이 할당하는 '암묵적 사고 예산(implicit thinking budget)'의 한계 때문임을 밝혀냈습니다. 실험 결과, 복합 작업 시 모델은 개별 작업에 할당하는 토큰 수를 줄이며, 특히 긴 추론이 필요한 작업에서 취약성이 두드러졌습니다. 이를 해결하기 위해 작업의 난이도에 따라 그룹화하여 배치함으로써, 정확도를 유지하면서도 토큰 사용량을 43% 절감할 수 있음을 증명했습니다.

AI 연구

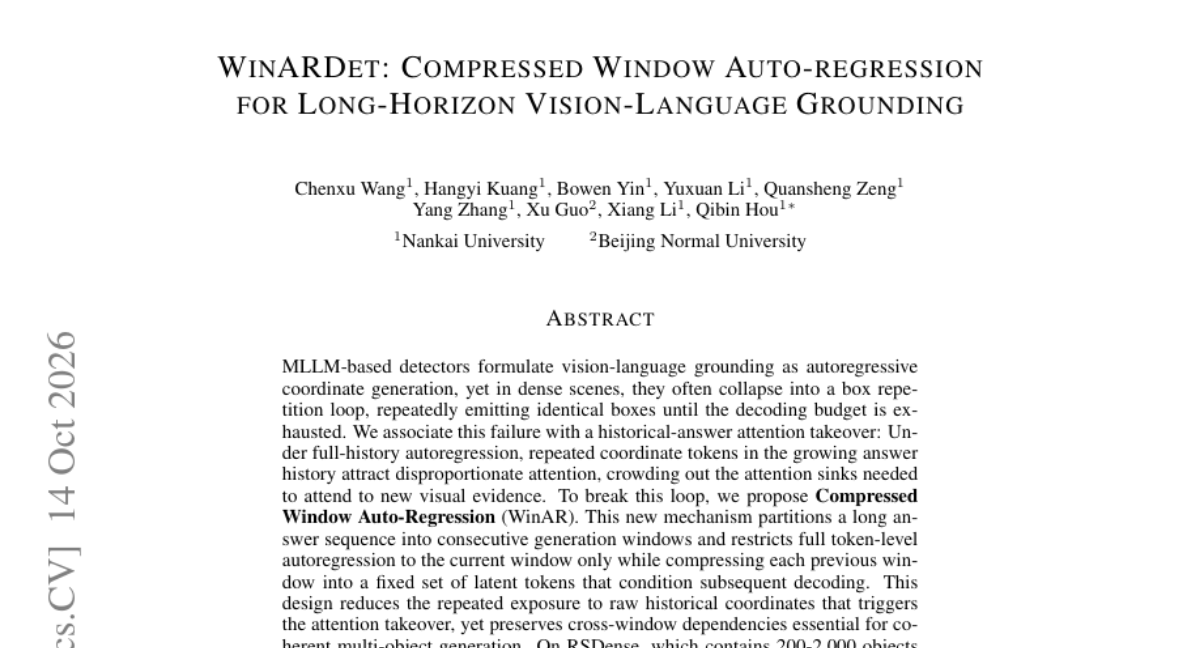
WinARDet: Compressed Window Auto-Regression for Long-Horizon Vision-Language Grounding

MLLM 기반 탐지 모델은 좌표를 순차 생성하는 방식을 사용하지만, 밀집된 장면에서 동일한 박스를 반복 생성하는 루프 현상이 발생합니다. 연구진은 이 문제가 과거의 반복된 좌표 토큰이 어텐션을 독점하여 새로운 시각 정보에 대한 주의를 방해하는 'historical-answer attention takeover' 현상 때문임을 밝혀냈습니다. 이를 해결하기 위해 제안된 WinAR 방식은 전체 이력을 윈도우 단위로 분할하고, 이전 윈도우를 고정된 잠재 토큰으로 압축하여 현재 윈도우의 생성에만 영향을 주도록 설계되었습니다. 이 방식은 반복적인 좌표 노출을 줄이면서도 윈도우 간 의존성을 유지하여 일관된 객체 생성을 가능하게 합니다. 실험 결과, 밀집 객체 환경(RSDense)에서 F1 스코어를 크게 향상시키고 중복 생성률을 대폭 낮추었습니다.

AI 연구

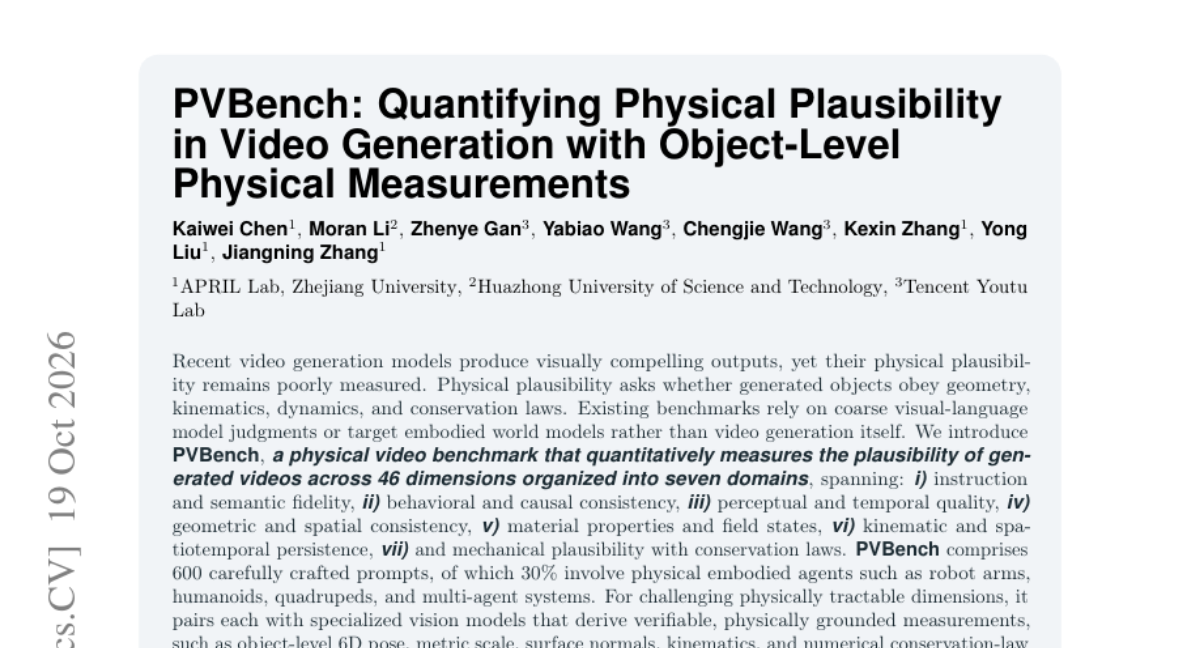
PVBench: Quantifying Physical Plausibility in Video Generation with Object-Level Physical Measurements

최근 비디오 생성 모델은 시각적으로는 뛰어나지만, 물리 법칙 준수 여부를 측정하는 데는 한계가 있습니다. 기존 벤치마크는 주관적인 언어 모델 판단이나 특정 세계 모델에 의존하여 물리적 실재감을 정밀하게 측정하지 못합니다. 이를 해결하기 위해 7개 도메인, 46개 차원의 물리적 타당성을 측정하는 PVBench를 도입합니다. PVBench는 600개의 정교한 프롬프트와 함께 6D 포즈, 표면 법선, 운동학 등 검증 가능한 물리적 측정 모델을 결합하여 객체 수준의 정량적 평가를 수행합니다. 실험 결과, 자동화된 지표가 인간의 판단과 높은 일치도를 보임을 확인하였으며 주요 모델들을 대상으로 물리적 성능을 평가했습니다.

AI 연구

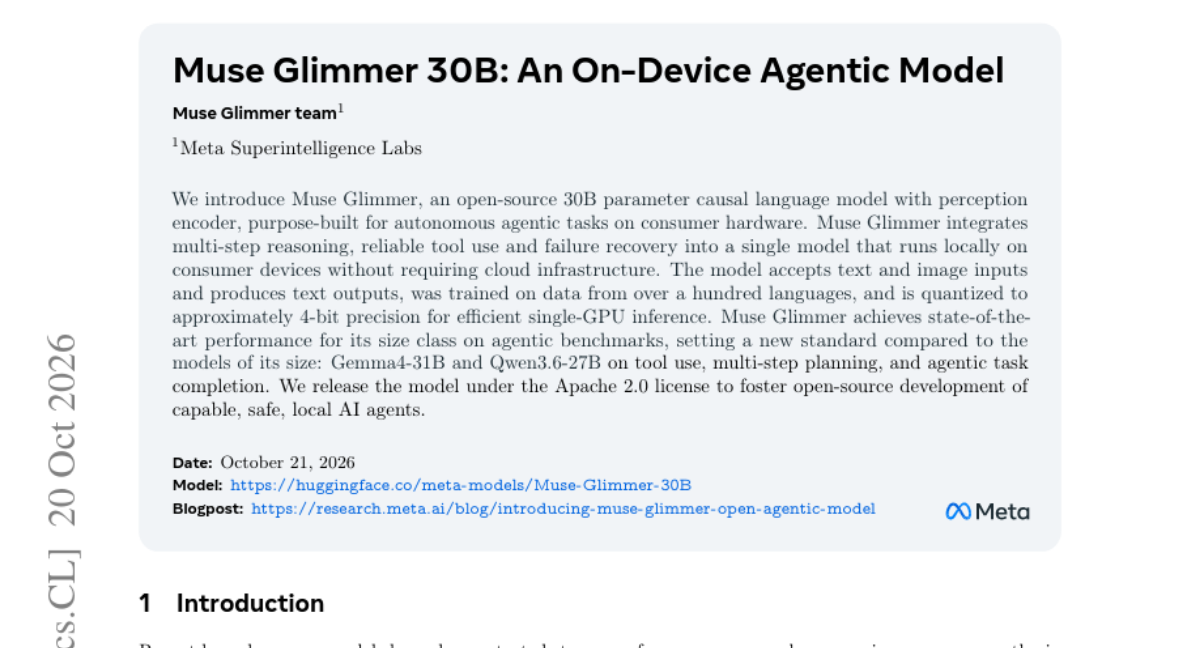
Muse Glimmer 30B: An On-Device Agentic Model

클라우드 인프라 의존도를 낮추고 로컬 환경에서 자율적인 에이전트 작업을 수행하는 것이 중요해졌습니다. 기존의 소형 모델들은 복잡한 도구 사용이나 다단계 추론에서 성능 한계를 보였습니다. 이를 해결하기 위해 멀티모달 인코더를 통합하고 추론, 도구 사용, 실패 복구 능력을 갖춘 30B 파라미터 모델 Muse Glimmer를 개발했습니다. 4비트 양자화를 통해 단일 GPU에서 효율적으로 동작하도록 설계되었습니다. 실험 결과, 동급 모델인 Gemma4-31B 및 Qwen3.6-27B 대비 에이전트 벤치마크에서 뛰어난 성능을 기록했습니다.

AI 연구

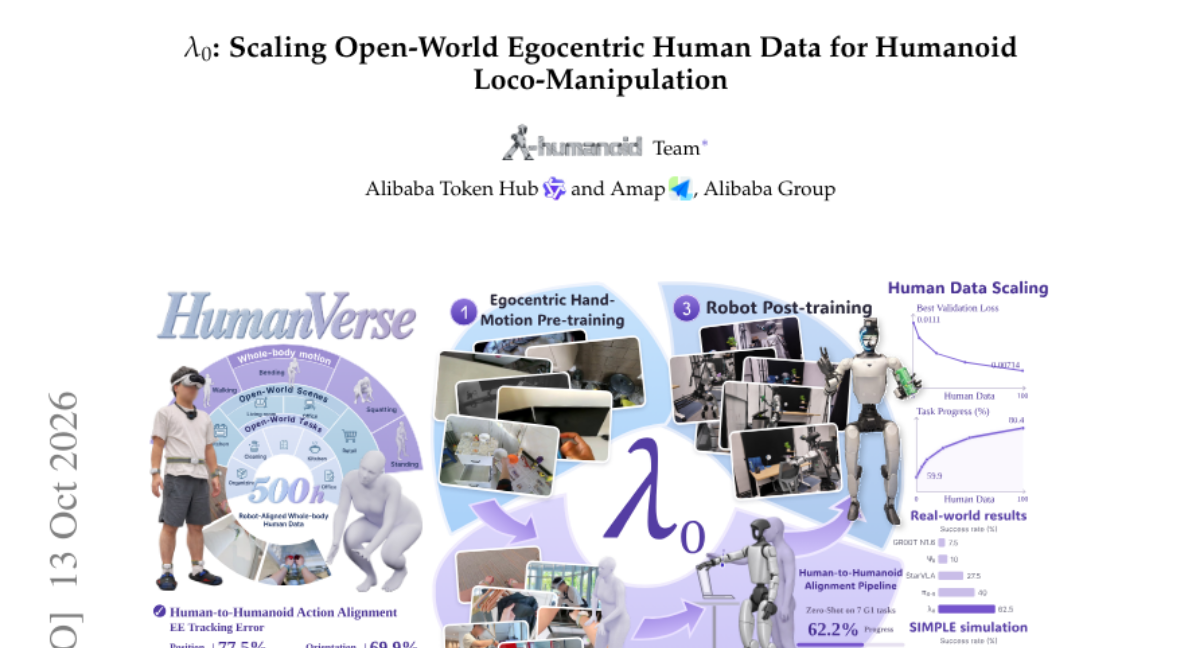
λ_0: Scaling Open-World Egocentric Human Data for Humanoid Loco-Manipulation

휴머노이드의 전신 상호작용을 위해 대규모 로봇 데모를 수집하는 것은 비용이 매우 많이 드는 작업입니다. 기존의 1인칭 인간 데이터는 이동 및 자세 정보가 누락되거나 로봇과의 신체 구조 차이로 인해 정밀한 제어가 어렵다는 문제가 있었습니다. 본 논문은 500시간 분량의 전신 동작 데이터셋인 HumanVerse를 구축하고, 카메라 시점과 외형을 정렬하며 제어 입력을 정제하는 파이프라인을 제안합니다. 이를 통해 수집된 데이터를 기반으로 휴머노이드 파운데이션 모델인 λ_0를 개발했습니다. 실험 결과, λ_0는 별도의 로봇 데모 없이도 실세계 이동-조작 작업에서 높은 성공률을 기록하며 데이터 규모에 따른 성능 향상을 입증했습니다.

AI 연구

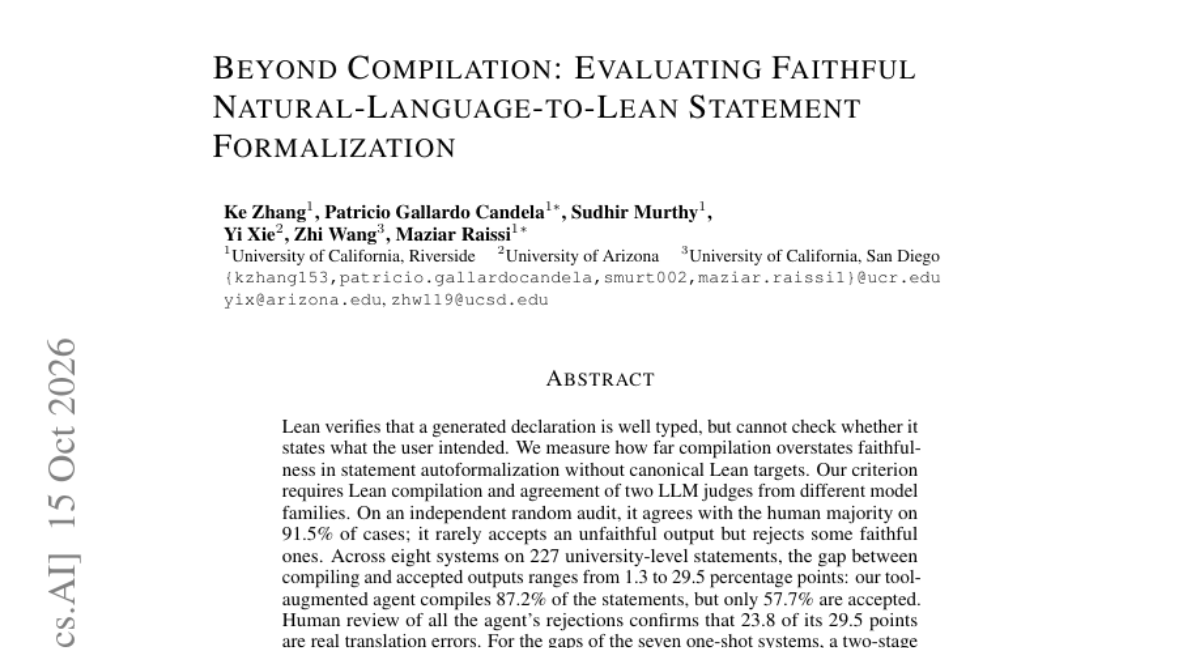
Beyond Compilation: Evaluating Faithful Natural-Language-to-Lean Statement Formalization

Lean과 같은 정형 검증 도구는 타입 체크는 가능하지만 사용자의 의도가 반영되었는지는 확인할 수 없습니다. 본 연구는 컴파일 성공 여부가 실제 번역의 충실도(Faithfulness)를 과대평가하는 문제를 다룹니다. 이를 위해 Lean 컴파일과 서로 다른 모델 가문의 LLM 판사들의 합의를 결합한 새로운 평가 기준을 제안했습니다. 227개의 대학 수준 문장을 대상으로 실험한 결과, 컴파일 성공률과 실제 정답률 사이에는 최대 29.5%의 격차가 발생했습니다. 연구 결과, 컴파일 성공이 반드시 의미론적 정확성을 보장하지 않으며, 판사 모델의 오류가 평가 지표에 큰 영향을 미칠 수 있음을 확인했습니다.

AI 연구

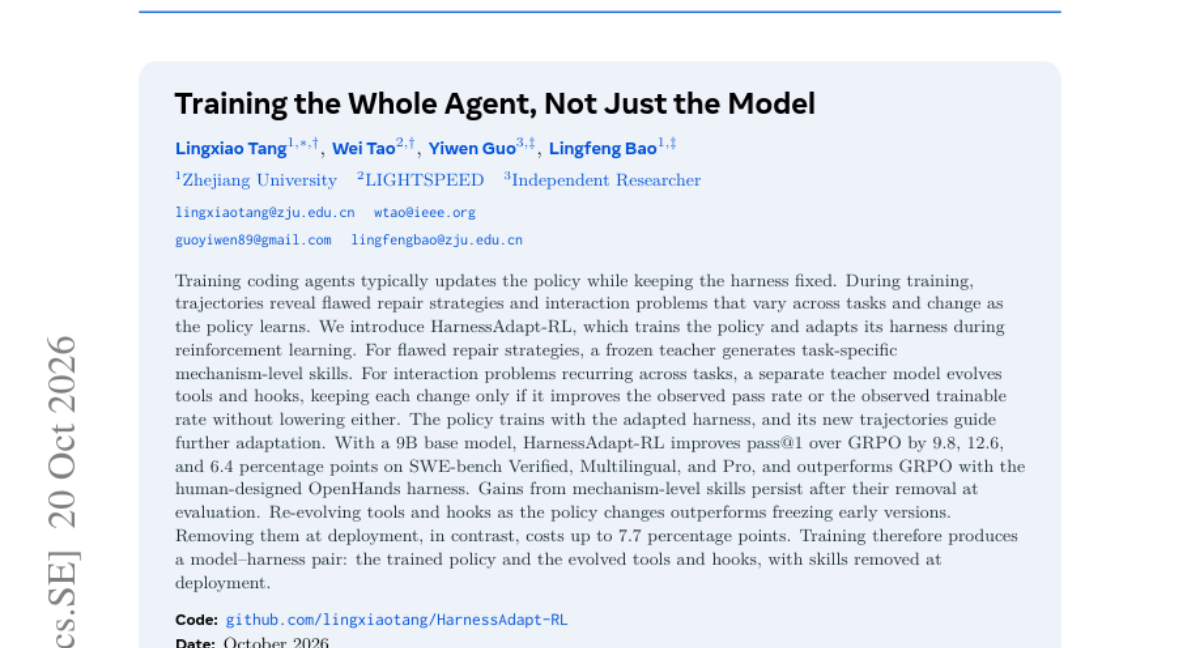
Training the Whole Agent, Not Just the Model

기존 코딩 에이전트 학습은 고정된 환경에서 모델의 정책만 업데이트하는 방식이었습니다. 하지만 학습 과정에서 발생하는 잘못된 복구 전략이나 환경과의 상호작용 문제는 고정된 환경에서는 해결하기 어렵습니다. 이를 해결하기 위해 HarnessAdapt-RL은 강화학습 과정에서 정책과 환경(Harness)을 동시에 적응시키는 방식을 도입했습니다. 교사 모델을 통해 작업별 메커니즘 스킬을 생성하고, 도구와 훅(hooks)을 진화시켜 최적의 상호작용 환경을 구축합니다. 실험 결과, SWE-bench 등 주요 벤치마크에서 기존 GRPO 방식보다 높은 성능 향상을 달끔했습니다. 최종적으로 학습된 모델과 진화된 환경이 결합되어 최적의 에이전트 성능을 발휘합니다.

AI 연구

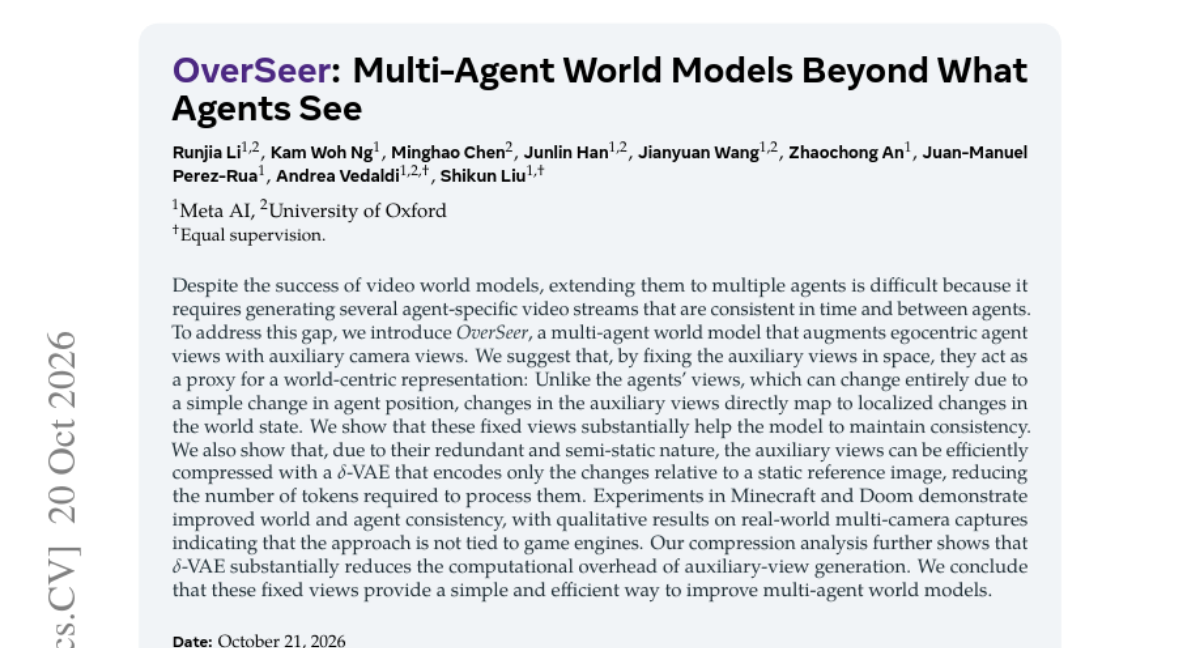
OverSeer: Multi-Agent World Models Beyond What Agents See

기존의 비디오 월드 모델은 여러 에이전트의 시점을 시간적, 공간적으로 일관되게 생성하는 데 어려움이 있었습니다. 이를 해결하기 위해 에이전트의 1인칭 시점 외에 공간에 고정된 보조 카메라 뷰를 추가하는 OverSeer를 제안합니다. 고정된 보조 뷰는 에이전트의 움직임과 관계없이 세계 상태의 국소적 변화를 반영하는 프록시 역할을 하여 모델의 일관성을 높입니다. 또한, 변화량만 인코딩하는 delta-VAE를 도입하여 보조 뷰의 데이터 압축 효율을 극대화했습니다. 실험 결과, Minecraft와 Doom 환경에서 향상된 일관성을 보였으며 실세계 데이터에서도 유효함을 입증했습니다.

AI 연구

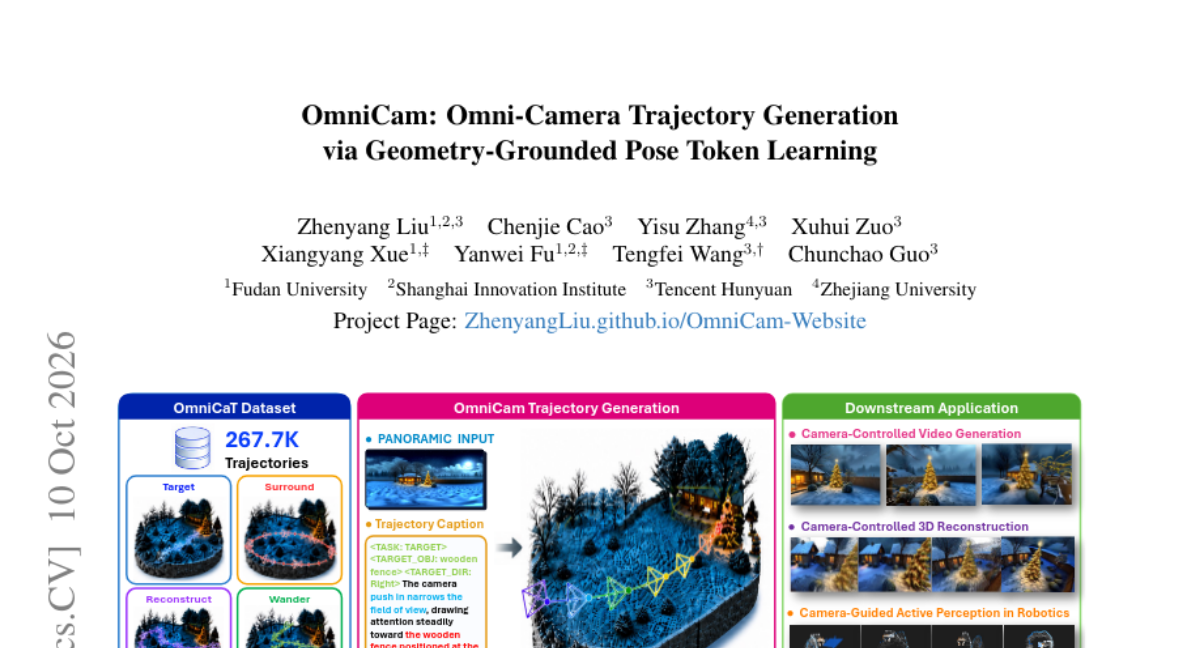
OmniCam: Omni-Camera Trajectory Generation via Geometry-Grounded Pose Token Learning

비디오 생성 및 로봇 인식을 위한 카메라 궤적 생성은 장면의 기하학적 구조와 목표 지점을 동시에 고려해야 하는 과제가 있습니다. 기존 방식은 텍스트 설명만으로는 복잡한 3D 공간의 구조를 반영하기 어려웠습니다. 본 논문은 단일 파노라마와 สั่ง 텍스트 설명을 입력받아 카메라 포즈 시퀀스를 생성하는 자기회귀 모델 OmniCam을 제안합니다. 이를 위해 파노라마 포인트 클라우드 인코더와 시간적 일관성을 유지하는 하이브리드 토큰화 방식을 결합하여 기하학적 맥락을 확보했습니다. 실험 결과, 제안된 모델은 기존 모델 대비 궤적 오차를 크게 줄이고 충돌 발생률을 획기적으로 낮추었습니다.

AI 연구

Multimodal Reranking Is a System One Decision

기존의 멀티모달 리랭커는 특정 데이터셋에 맞춰 학습된 전용 모델을 사용하는 방식이 일반적이었습니다. 하지만 저자들은 리랭킹을 상태(query/candidates)에서 옵션(candidates)을 선택하는 'System One' 의사결정 문제로 정의했습니다. 이를 위해 범용 VLM에 16개의 후보군 중 하나를 고르는 질문을 던져 한 번의 포워드 패스로 순위를 매기는 방식을 제안합니다. 실험 결과, 제로샷 Qwen2.5-27B 모델이 훨씬 작은 크기의 지도 학습된 리랭커 모델들과 대등하거나 더 높은 성능을 기록했습니다. 결과적으로 범용 모델의 의사결정 튜닝만으로도 강력한 리랭킹 성능을 확보할 수 있음을 입증했습니다.

AI 연구

EMBER: Predicting TCR--pMHC Binding Without a Docked Complex

기존의 구조 기반 TCR-pMHC 결합 예측 방식은 수용체와 항원이 결합된 복합체 구조를 사전에 예측해야 하는 데서 발생하는 배치 오류(placement error) 문제에 직면해 있습니다. 이를 해결하기 위해 EMBER는 복합체 구조를 직접 생성하는 대신, TCR과 pMHC를 독립적으로 폴딩한 후 SE(3)-불변 잔기 그래프로 인코딩하는 방식을 제안합니다. 이 방법론은 공유 좌표계 없이 학습된 표현형을 비교함으로써 도킹 오류가 예측으로 전이되는 것을 원천 차단합니다. 실험 결과, EMBER는 에피토프가 분리된 평가 환경에서 기존 베이스라인 대비 AUROC, AUPRC, MCC 등 모든 지표에서 압도적인 성능 향상을 기록했습니다. 또한 다양한 폴딩 도구 사용 시에도 예측 순위가 매우 안정적으로 유지됨을 입증했습니다.

AI 연구

Self-Credit: Credit Assignment for Long-Horizon Agentic RL via Intra-group Rescaling

LLM 에이전트 학습 시 발생하는 희소한 보상(Sparse Reward)은 긴 작업 과정에서 어떤 행동이 유효했는지 판단하는 신용 할당(Credit Assignment) 문제를 야기합니다. 이를 해결하기 위해 본 논문은 Self-Credit이라는 엔드투엔드 에이전트 RL 방식을 제안합니다. 모델이 이전 단계의 근거를 인용하는 요약문을 생성하게 하고, 동일 프롬프트 내 성공/실패 사례 간의 행동 차이를 비교하는 '그룹 내 재스케일링(Intra-group Rescaling)'을 통해 신용을 정제합니다. 최종적으로 재스케일링된 가중치를 어드밴티지 재가중(Advantage Reweighting)에 적용하여 핵심 행동을 강화합니다. 실험 결과, BrowseComp-Plus 및 GAIA 등 주요 벤치마크에서 기존 에이전트 RL 베이스라인을 크게 상회하는 성능 향상을 달성했습니다.

AI 연구

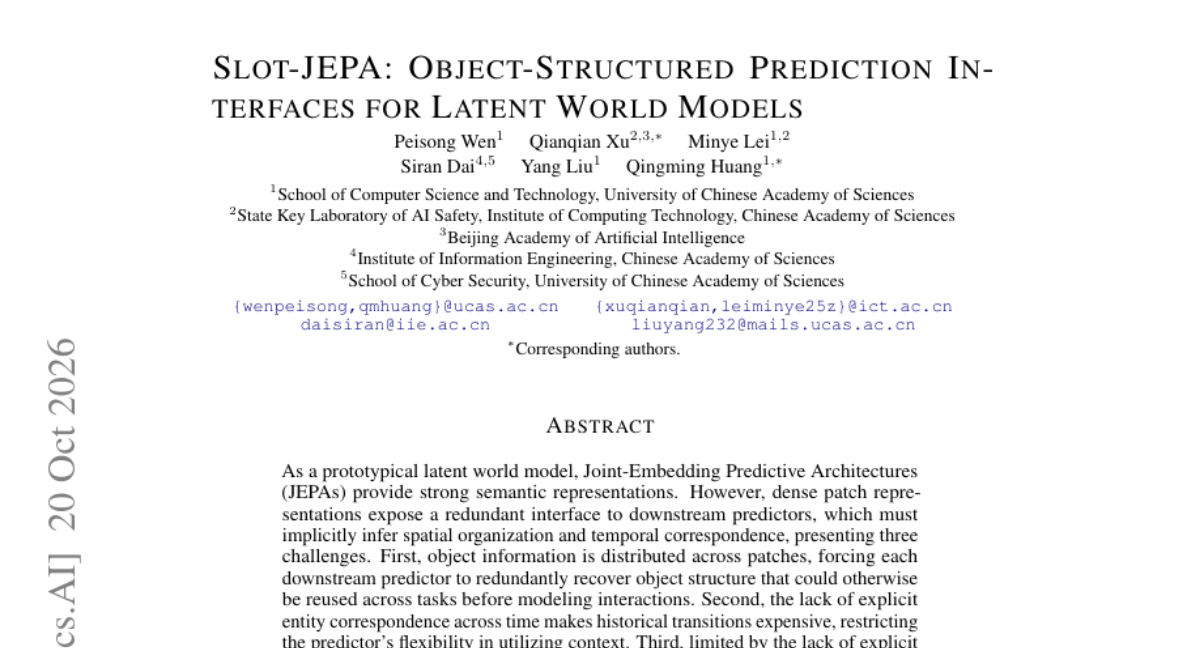
Slot-JEPA: Object-Structured Prediction Interfaces for Latent World Models

기존의 Joint-Embedding Predictive Architectures(JEPA)는 패치 단위의 밀집 표현을 사용하여 객체 구조 복구와 시간적 대응 관계 파악에 비효율적이라는 문제를 가집니다. 이를 해결하기 위해 본 논문은 밀집 표현을 안정적인 의미 슬롯(Semantic Slots)과 가변적인 공간 마스크(Spatial Masks)로 분해하는 Slot-JEPA를 제안합니다. 제안된 Transition Memory Predictor(TMP)는 슬롯 기반의 압축된 메모리를 통해 효율적인 문맥 활용과 동역학 모델링을 수행합니다. 또한 Unbalanced Optimal Transport(UOT)를 도입하여 공간적 변위가 큰 상황에서도 정교한 마스크 예측과 계획 평가가 가능하도록 설계했습니다. 실험 결과, 제안 모델은 시각 이해 벤치마크와 로봇 팔 계획 작업 등 다양한 환경에서 우수한 성능과 전이 학습 능력을 입증했습니다.

30건

제품/서비스

이날 공개된 제품과 도구

제품/서비스

UseIt Studio

한 문장 설명으로 실물 제작용 편집 가능한 디자인 파일을 만드는 AI 디자인 에이전트

제품/서비스

BAND for Developers

여러 코딩 에이전트 간의 협업과 작업 조율을 자동화하는 공유 워크스페이스

제품/서비스

Needle

AI 프롬프트만으로 잠재 고객 발굴부터 아웃바운드 영업까지 자동화하는 엔진

제품/서비스

The Library

비즈니스 질문과 맥락을 학습하여 신뢰할 수 있는 답변을 제공하는 데이터 라이브러리

제품/서비스

TwinMind for Desktop

회의 자동 기록부터 어디서든 가능한 음성 받아쓰기까지, 데스크톱용 올인원 AI 비서

나머지 25건 펼쳐보기

제품/서비스

Notion Auto

24시간 연속 실행이 가능한 저비용·고효율 Notion AI 에이전트 자동화 솔루션

제품/서비스

NativeShip

기존 API를 활용해 복잡한 코딩 없이 n8n 네이티브 통합 노드를 구축하고 배포하는 도구

제품/서비스

The Brains

유명 창업가와 투자자의 인사이트를 AI 도구에서 즉시 검색할 수 있는 MCP 서버 서비스

제품/서비스

Flagsmith Experiments

기존 피처 플래그를 활용해 즉시 A/B 테스트를 수행할 수 있는 오픈소스 실험 도구

제품/서비스

Mouse-1

에이전트의 수많은 미세 의사결정을 저비용·고속으로 처리하는 전용 모델

제품/서비스

ilha

Claude Code 및 Grok 등 AI 모델의 사용량 제한을 맥 노치에서 실시간으로 관리하는 도구

제품/서비스

Agent Pets

브라우저 하단에서 살아 움직이는 코딩 에이전트 펫

제품/서비스

Yarite

소중한 사람들과의 관계를 놓치지 않도록 매일 아침 연락할 사람을 제안하는 프라이버시 중심의 관계 관리 앱

제품/서비스

Burrow MacOS

Mac에서 Windows 11과 Linux를 클릭 한 번으로 무료 실행하는 도구

제품/서비스

iglass

iTerm2와 Ghostty 사용자를 위한 세련된 리퀴드 글래스 스타일 테마

제품/서비스

Tend

iMessage와 SMS를 통해 기존 업무 툴을 제어하는 개인용 AI 에이전트

제품/서비스

Flyweel

AI 에이전트를 위한 광고 집행용 가상 카드 및 자금 관리 솔루션

제품/서비스

Hotly

DM 답변을 수익화할 수 있는 오픈소스 기반의 유료 메시징 서비스

제품/서비스

Scout by Fini

Slack에서 티켓과 통화 기록을 분석해 해결책을 제안하는 AI 고객 지원 동료

제품/서비스

Blooio

애플 메시지 앱 내에서 브랜드 인증을 거친 대화형 비즈니스 채널을 구축하는 통합 API 솔루션

제품/서비스

Lea by LeanAIOS

건설 관리 및 사전 시공을 위한 18가지 전문 역할을 갖춘 자율형 AI 팀

제품/서비스

hibi

자유로운 문서 편집과 강력한 조직 관리를 제공하는 오픈소스 데스크톱 노트 앱

제품/서비스

Intelli for ChatGPT & Claude

ChatGPT와 Claude를 통해 WhatsApp, Instagram 등 다양한 채팅 채널을 제어하는 AI 자동화 도구

제품/서비스

Triage by Chodeberg

사용자가 보고한 버그를 깨끗한 샌드박스 환경에서 자동으로 재현해주는 디버깅 도구

제품/서비스

Animatica Marionette

손과 발을 드래그하는 것만으로 인체 포즈를 완성하는 블렌더용 뉴럴 컨트롤 리그

제품/서비스

Nimbalyst Wiki

AI 에이전트가 작성하고 사용자가 시각적으로 편집하는 로컬 위키 도구

제품/서비스

LearnExcel

직접 수식을 입력하며 실전 감각을 익히는 대화형 엑셀 학습 플랫폼

제품/서비스

PrivOS

협업 도구와 AI 에이전트가 결합된 보안 중심의 셀프 호스팅 AI 운영체제

제품/서비스

Koi

받아쓰기, 회의록 작성, AI 비서를 하나로 통합한 올인원 Mac 생산성 앱

제품/서비스

AskDoozy

Slack에서 멘션만으로 데이터 조회부터 업무 자동화까지 수행하는 AI 동료

6건

모델/벤치마크

새 모델과 주요 평가 결과

HF Model Trending

OpenMOSS-Team/MOSS-Image-SFT

OpenMOSS-Team에서 공개한 MOSS-Image-SFT 모델이 text-to-image 태스크를 중심으로 주목받고 있습니다. 약 5B 규모의 파라미터를 가진 이 모델은 최근 높은 다운로드 수를 기록하며 트렌드에 진입했습니다.

HF Model Trending

OpenMOSS-Team/MOSS-Image-Base

OpenMOSS-Team에서 공개한 MOSS-Image-Base 모델이 text-to-image 태스크를 중심으로 주목받고 있습니다. 약 5.08B 파라미터를 보유한 이 모델은 최근 높은 다운로드 수를 기록하며 트렌드에 진입했습니다.

HF Model Trending

black-forest-labs/flux-3-image-klein-comfy

black-forest-labs/flux-3-image-klein-comfy 모델이 Hugging Face에서 높은 관심을 받고 있습니다. 해당 모델은 image-to-image 파이프라인을 지원하며 많은 다운로드 수를 기록하고 있습니다.

LiveCodeBench

LiveCodeBench top model: O4-Mini (High)

LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Pro-06-05

LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

나머지 1건 펼쳐보기

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Flash-04-17

LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.