지난 소식

2026.10.25

이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.

19건

뉴스

주요 기사와 기업의 공식 발표

Apollo Global Management

No Signs of AI Payoff Outside the Tech Sector - Apollo Global Management

현재 AI로 인한 경제적 이익은 Mag 7(빅테크)에 집중되어 있으며, S&P 493(일반 기업)으로의 생산성 전이는 아직 발생하지 않고 있습니다. AI 투자가 비용 센터(Cost Center)로 인식되는 상황에서, 기술적 지능이 실질적인 비즈니스 수익과 마진 개선으로 연결될 수 있을지가 향후 거시 경제의 핵심 과제입니다.
Vatican News

Cardinal Radcliffe: In age of AI, encourage young people to ask questions - Vatican News

AI 시대의 디지털 환경 속에서 청년 세대의 상상력과 인간성을 보존하기 위해 '질문하는 능력'과 '타인에 대한 깊은 주의(Attention)'가 필수적임을 강조한다. 기술적 편리함이 주는 분산(Distraction)을 넘어, 인간만이 가진 실존적 모험과 관계적 가치를 회복해야 한다고 역설한다.

Axios

AI economic research is getting really good - Axios

AI 기술이 경제학 연구의 방법론을 근본적으로 변화시키며, 데이터 분석 및 예측 모델링의 정밀도를 높이고 있습니다. 단순한 데이터 처리를 넘어 복잡한 경제적 상관관계를 파악하는 데 있어 AI의 역할이 심화되고 있습니다.

ESPN

Texas AD Del Conte clarifies AI use on key play that failed in loss to Florida - ESPN

텍사스 대학교가 Dell 및 Google Cloud와의 협력을 통해 차세대 스포츠 AI 분석 플랫폼인 'Bevo Lab'을 공식 발표했습니다. 이 플랫폼은 데이터 웨어하우스인 'Bevo Lakehouse'를 기반으로 모든 종목의 데이터를 통합 관리하며, 스포츠 데이터 분석의 글로벌 벤치마크를 목표로 합니다.

나머지 14건 펼쳐보기

The Atlantic

AI Terrorism Is Just Terrorism - The Atlantic

AI 기술의 고도화가 테러리즘과 같은 물리적 위협과 결합될 가능성에 대해 경고하며, AI를 특수한 위협이 아닌 기존 테러리즘의 진화된 수단으로 정의합니다.

CNBC

Nvidia's role as AI financier faces first big test as neoclouds take market hit - CNBC

Nvidia가 단순한 칩 제조사를 넘어 AI 인프라 구축을 위한 금융 지원 및 보증(Backstop) 역할을 수행하며 생태계를 확장하고 있으나, 최근 Neocloud 기업들의 신용 위험과 시장 변동성으로 인해 전략적 시험대에 올랐습니다. 젠슨 황 CEO는 자본 부족 문제를 해결하기 위해 금융과 기술을 결합한 '투자 가능한 자산'으로서의 AI 팩토리 플랫폼 전략을 추진 중입니다.

WSJ

AI Hacks Are Coming Thick and Fast and Overwhelming the Internet - WSJ

생성형 AI 기술의 급격한 발전으로 인해 인터넷상에 정교한 AI 생성 콘텐츠와 이를 활용한 해킹/사기 기법이 범람하며 디지털 신뢰 체계가 위협받고 있습니다. 단순한 텍s 생성 수준을 넘어, 인간의 행동을 모방하는 고도화된 AI 기술이 사회적 혼란을 야기하는 양상을 보입니다.

The Washington Post

AI & Tech Brief: Black October - The Washington Post

The Washington Post의 'Black October' 브리핑은 최근 AI 기술의 급격한 발전과 그에 따른 규제, 윤리적 이슈, 그리고 산업적 변곡점을 다루고 있습니다. 기술적 진보가 가속화됨에 따라 발생하는 거버넌스 문제와 AI 에이전트(Agent) 시대의 도래를 핵심 축으로 분석합니다.

WMAR 2 News Baltimore

Johns Hopkins alerts 3,000+ patients after data sent to AI tool - WMAR 2 News Baltimore

Johns Hopkins Bayview Medical Center에서 직원이 승인되지 않은 외부 AI 도구에 환자 정보가 담긴 스프레드시트를 업로드하여 약 3,182명의 개인 건강 정보(PHI)가 유출되는 보안 사고가 발생했습니다. 이번 사고는 비인가 AI 도구 사용에 따른 데이터 거버넌스 실패 사례로, 병원 측은 즉각적인 데이터 삭제 조치와 함께 보안 정책 강화에 나섰습니다.

Google DeepMind

Gemini 4 Argon: Built to solve your hardest problems

Google DeepMind가 최신 프론티어 모델인 Gemini 4 Argon을 공개했습니다. 이 모델은 개발자, 기업, 과학자 및 일반 소비자들이 직면한 가장 어려운 문제들을 해결하기 위해 설계되었습니다.

Google DeepMind

Beyond tree cover: mapping the world’s forest types

Google DeepMind가 발표한 Forest Typology (ForTy) 2020은 지구의 토지를 6가지 산림 및 토지 이용 유형으로 분류한 글로벌 10미터 해상도 지도입니다. 이 데이터는 연간 시계열 정보를 포함하여 전 세계 산림 유형을 정밀하게 매핑합니다.

Google DeepMind

Accelerating the search for antimicrobial peptides with Google Antigravity

Google DeepMind가 새로운 항균 펩타이드 탐색을 위한 에이전트 기반 과학 워크벤치인 Google Antigravity를 공개했습니다. 이 시스템은 새로운 항균 펩타이드를 발견하고 구조적으로 평가하며 우선순위를 정하는 과정을 단 몇 시간 만에 수행할 수 있도록 지원합니다.

OpenAI News

Rapidly scaling online storage to serve over 1 billion ChatGPT users (Part II)

OpenAI가 10억 명 이상의 ChatGPT 사용자를 지원하기 위해 구축한 온라인 스토리지 시스템인 Habitat의 확장 과정을 다룹니다. 신뢰할 수 있는 멀티테넌시, 글로벌 캐싱, Azure Cosmos DB를 활용하여 ChatGPT의 읽기 속도를 12배 향상시킨 기술적 성과를 설명합니다.

OpenAI News

Securing our frontier model training environment

OpenAI가 차세대 프론티어 모델의 학습 및 평가 과정을 보호하기 위해 강화된 격리 조치를 도입했습니다. 오프라인 환경 구축과 고성능 컴퓨팅 기반의 레드팀 활동을 통해 보안을 강화하는 방안을 설명합니다.

OpenAI News

Build more responsive apps with the Decisions API

OpenAI가 애플리케이션의 응답성을 높일 수 있는 Decisions API를 출시했습니다. 이 API는 모든 애플리케이션을 위해 빠르고 집중된 저비용 의사결정 기능을 제공합니다.

Google Cloud AI

Expanding Claude availability and deployment choice on Google Cloud

Google Cloud에서 Anthropic이 직접 관리하는 Claude 모델 배포 옵션이 일반 제공(GA)됩니다. 이를 통해 개발자는 기존의 Google 관리형 옵션과 더불어 더 넓은 선택지를 갖게 되어 Google Cloud 내에서 AI 워크로드를 통합할 수 있습니다.

26건

커뮤니티

Hacker News, GeekNews, Reddit 반응

Hacker News

DeepInfer: High-performance inference framework for DeepSeek models

DeepSeek 모델의 대규모 프로덕션 서비스를 위해 개발된 고성능 추론 프레임워크인 DeepInfer가 오픈 소스로 공개되었습니다. 이 프레임워크는 대규모 모델의 추론 효율을 극대화하기 위한 최적화된 커널과 스케줄링 기술을 제공합니다.

Hacker News

Local Wikipedia: Wikipedia, but only for things a half hour walk from you

사용자의 현재 위치를 기준으로 반경 30분 거리 내의 위키피디아 정보만을 필터링하여 보여주는 서비스가 공개되었습니다. 위치 기반의 정보 제공 방식이 사용자에게 주는 심리적 밀착감과 데이터 활용 방식에 대한 논의가 이어지고 있습니다.

Hacker News

Quad9 to exit France

프랑스 법원의 저작권 보호 판결로 인해 Quad9가 프랑스 내 서비스 제공을 중단하기로 결정했습니다. 이는 DNS 중립성과 프라이버시 보호 원칙을 지키기 위한 기술적 결단입니다.

Hacker News

eMudhra intermediate CA compromise

eMudhra의 중간 CA 개인키 8개가 유출되어 주요 브라우저와 OS의 신뢰 체계가 위협받는 보안 사고가 발생했습니다. 공격자가 해당 키를 이용해 웹사이트를 사칭할 수 있는 위험이 있어 주요 벤더들이 긴급 차단 조치를 완료했습니다.

나머지 21건 펼쳐보기

Hacker News

eMudhra to exit global SSL/TLS certificate business

eMudhra가 글로벌 SSL/TLS 인증서 사업에서 철수하기로 결정하며 보안 업계의 주목을 받고 있습니다. 이번 결정은 최근 발생한 보안 이슈와 브라우저 제조사들의 엄격한 검증 절차에 따른 전략적 변화로 분석됩니다.

Hacker News

PHP 8.2.35

PHP 8.2.35 보안 업데이트와 함께 발견된 'PHP2Shell' 취약점에 대한 기술적 분석과 대응이 이루어지고 있습니다. 보안 전문가들과 AI 기업들이 협력하여 발견한 RCE(원격 코드 실행) 취약점이 이번 업데이트의 핵심입니다.

Hacker News

Kimi K3.1 Pro and K3.1 Pro Highspeed

Moonshot AI가 발표한 새로운 Kimi K3.1 Pro 모델 시리즈의 성능과 정체성 혼선에 대한 기술적 논의가 이어지고 있습니다. 모델의 추론 능력 향상과 더불어 데이터 학습 과정에서 발생한 정체성 이슈가 주요 쟁점으로 떠올랐습니다.

Hacker News

Eight Bits of Trust: eMudhra's CA keys cracked in milliseconds

eMudhra의 CA(인증 기관) 키가 단 몇 밀리초 만에 탈취된 심각한 보안 사고가 발생했습니다. 이번 사건은 신뢰 체계의 취약성을 드러냈으며, 인증 기관 관리 체계에 대한 커뮤니티의 우려를 자아내고 있습니다.

GeekNews / Hada

Roku 개발자 저장소, GitHub에서 GitLab으로 이전

Roku는 개발자 생태계의 관리 효율성을 높이기 위해 흩어져 있던 리소스를 GitLab 기반의 단일 플랫폼으로 통합했습니다. 이는 개발자 경험(DX)을 개선하고 중앙 집중식 워크플로우를 구축하려는 전략적 움직임으로 해석됩니다.

GeekNews / Hada

FreeDNS - 무료 동적/정적 DNS와 도메인/서브도메인 호스팅

FreeDNS는 도메인 관리의 편의성을 높여주는 DNS 호스팅 서비스로, IP 주소 기반의 네트워크 접근 문제를 도메인 네임 체계로 해결합니다. 개인 사용자부터 개발자까지 다양한 환경에서 유연한 네트워크 식별자를 확보할 수 있는 것이 기술적 핵심입니다.

GeekNews / Hada

AI와 과학 공유자원의 인클로저

생성형 AI가 공공의 지식 자원을 사적 부로 전환하는 인클로저 현상을 가속화하며 지식 공유의 사회적 체계를 위협하고 있습니다. 이는 기술적 진보가 공동체의 자산 탈취로 이어질 수 있음을 시사하며, 데이터 소유권과 공공 이익 사이의 갈등을 예고합니다.

GeekNews / Hada

동일한 AI 요청, 텍사스에서는 스웨덴보다 CO₂를 8.5배 더 배출함

AI 모델의 연산 효율만큼이나. 이를 뒷받s는 지역 전력망의 탄소 집약도가 실질적인 환경 영향을 결정하는 핵심 변수임을 보여줍니다. 하드웨어 성능 중심의 논의를 넘어, 데이터 센터의 위치와 에너지 믹스가 AI의 지속 가능성에 미치는 영향을 고려해야 합니다.

GeekNews / Hada

음악은 어떻게 가능한가

음악적 경험은 생물학적 감정 처리 체계와 문화적 학습이 결합하여 발생하는 복합적인 인지 현상입니다. 이는 인간의 지각 시스템이 추상적 신호를 어떻게 의미 있는 감정적 서사로 변환하는지를 보여줍니다.

GeekNews / Hada

Node2Shell에서 HTTP2Shell로 확대, 다수 HTTP 라이브러리와 앱에 영향

이번 취약점은 범용적인 압축 알고리즘의 디코딩 로직에서 발생하여 다양한 언어와 프레임워크에 동시다발적인 영향을 미칩니다. 라이브러리 수준의 보안 결함이 상위 애플리케이션 계층의 보안을 무너뜨릴 수 있음을 보여주는 사례입니다.

GeekNews / Hada

Google, 핀란드 데이터센터 건설 위해 나무 25만 그루 불법 벌목

데이터센터 인프라 확충 과정에서 발생한 환경 규제 위반 의혹은 기업의 ESG 경영과 실질적인 환경 보호 사이의 갈등을 보여줍니다. 향후 대규모 데이터센터 건설 시 법적 절차 준수와 생태계 보존이 핵심적인 리스크 관리 요소가 될 전망입니다.

Reddit

Raon is better than Flint.

사용자는 Flint 모델보다 Raon 모델이 훨씬 더 우수하다고 주장하며 성능 차이를 강조했습니다. Raon 모델이 아직 최적의 상태가 아님에도 불구하고 Flint보다 월등하다는 점을 언급하며 기존의 관심을 비판했습니다.

Reddit

Boston Dynamics employees petition to cancel $1.3M Spot robot sale to ICE

보스턴 다이내믹스 직원들이 미 이민세관집행국(ICE)에 130만 달러 상당의 스팟 로봇을 판매하는 계획을 취소할 것을 요구하는 청원을 제출했습니다. 기술의 용도가 윤리적 문제와 직결되면서 기업의 책임에 대한 논쟁이 발생하고 있습니다.

Reddit

🟣 Show Quote in Context: an open-source skill that points citations to the actual passage, not just the page

특정 웹페이지의 URL과 인용문을 입력하면 해당 문장이 위치한 정확한 지점으로 연결되는 텍스트 프래그먼트 링크(VDL)를 생성하는 오픈소스 AI 기술이 공개되었습니다. 이 도구는 단순한 페이지 링크를 넘어 근거가 되는 문맥을 즉각 확인할 수 있게 하여 저널리즘이나 학술적 인용의 신뢰성을 높여줍니다.

Reddit

RecursiveSI Flint Benchmark: unsloth/flint-GGUF flint-UD-Q3_K_XL.gguf

Unsloth의 Flint Q3 모델이 RecursiveSI Flint 벤치마크에서 매우 낮은 성능을 기록했다는 결과가 공유되었습니다. 다양한 테스트 프레임워크를 사용했음에도 불구하고 작업 해결 능력이 현저히 떨어지는 양상을 보였습니다.

Reddit

AI is humanities collective inheritance and should be legally treated as such

AI는 인류가 축적해온 지식의 총합이므로 특정 기업이나 개인이 소유할 수 없는 인류 공동의 유산으로 취급되어야 합니다. 기술 기업은 소유자가 아닌 관리자 역할을 수행해야 하며, AI로 창출되는 막대한 부는 법적 장치를 통해 인류 전체에게 환원되어야 합니다.

50건

논문

읽어볼 만한 AI 연구

AI 연구

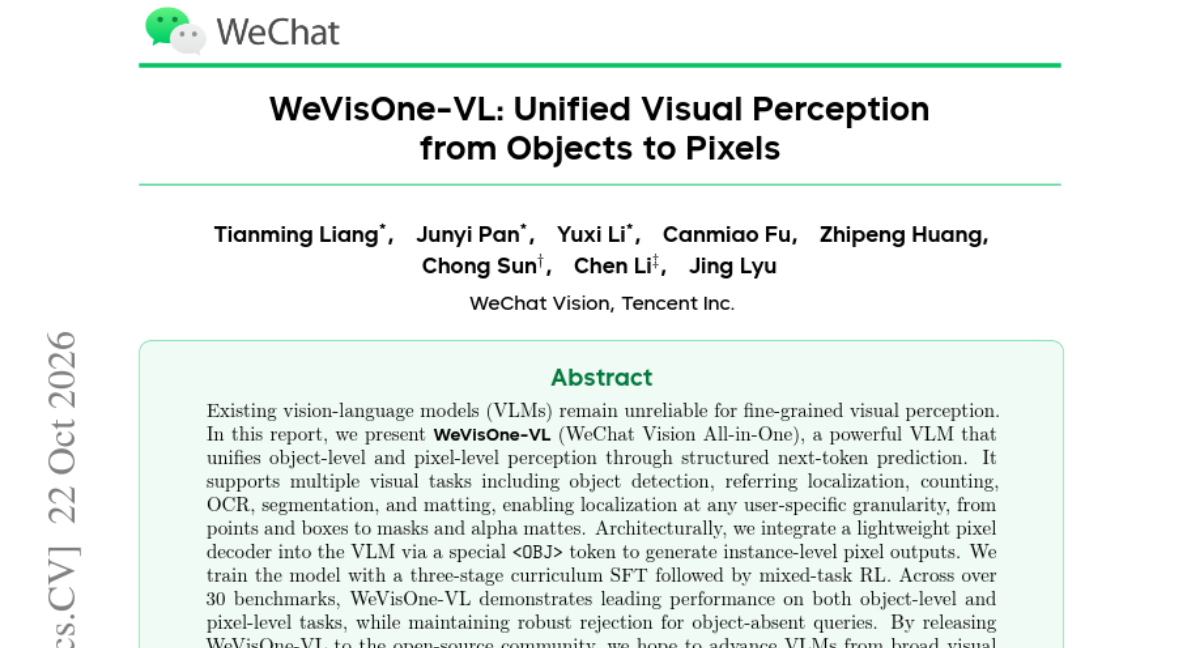
WeVisOne-VL: Unified Visual Perception from Objects to Pixels

기존의 시각-언어 모델(VLM)은 세밀한 시각적 인지 작업에서 신뢰도가 낮다는 문제를 가지고 있습니다. 이를 해결하기 위해 본 논문은 객체 수준과 픽셀 수준의 인지를 구조화된 차세대 토큰 예측 방식으로 통합한 WeVisOne-VL을 제안합니다. 아키텍처 측면에서는 특수 <OBJ> 토큰을 통해 경량 픽셀 디코더를 VLM에 통합하여 인스턴스 수준의 픽셀 출력을 생성합니다. 3단계 커리큘럼 SFT와 혼합 작업 RL을 통해 학습되었으며, 30개 이상의 벤치마크에서 객체 및 픽셀 작업 모두에서 뛰어난 성능을 입증했습니다. 결과적으로 이 모델은 광범위한 이해를 넘어 실세계 배포가 가능한 신뢰할 수 있는 인지 시스템을 지향합니다.

AI 연구

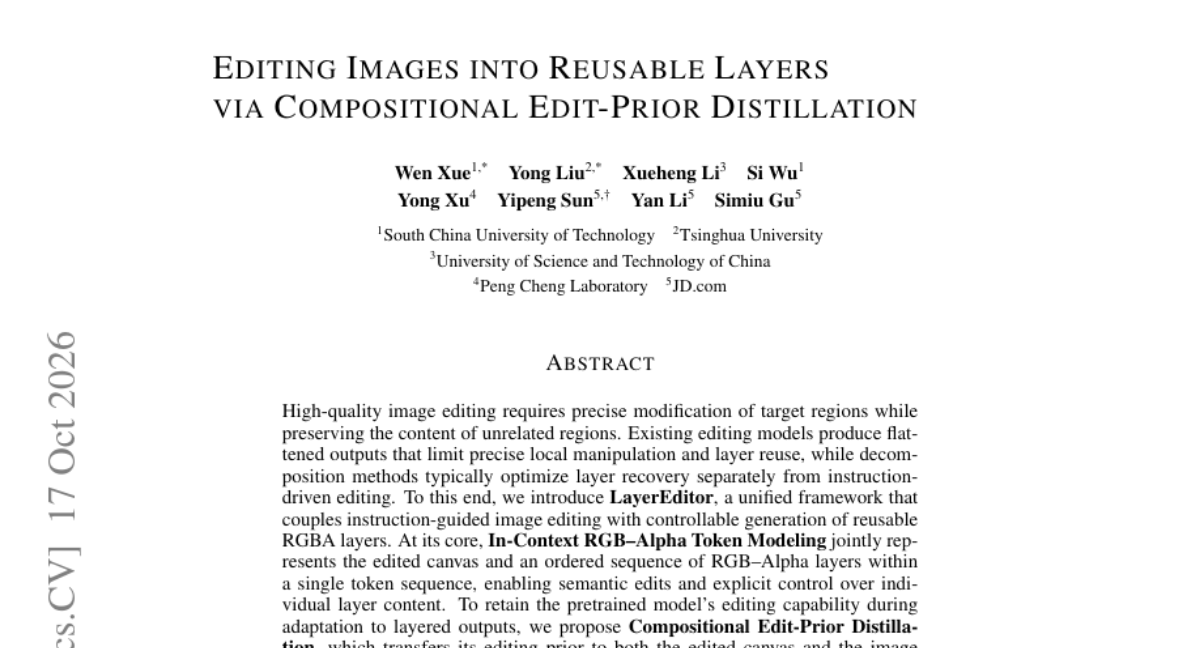
Editing Images into Reusable Layers via Compositional Edit-Prior Distillation

기존의 이미지 편집 모델은 결과물이 단일 평면(flattened) 형태로 생성되어 국소적인 조작이나 레이어 재사용이 어렵다는 문제가 있었습니다. 또한 기존 분해 방식은 편집 지시사항과 레이어 복구 과정을 별도로 최적화하는 한계가 있었습니다. 이를 해결하기 위해 본 논문은 지시어 기반 편집과 재사용 가능한 RGBA 레이어 생성을 결합한 LayerEditor 프레임워크를 제안합니다. 핵심 기술인 In-Context RGB-Alpha Token Modeling은 편집된 캔버스와 순차적인 레이어 정보를 하나의 토큰 시퀀스로 통합 관리합니다. 또한 Compositional Edit-Prior Distillation을 통해 사전 학습된 모델의 편집 능력을 유지하면서 레이어 생성 능력을 확보했습니다. 실험 결과, LayerEditor는 높은 편집 충실도를 유지하면서도 정교한 레이어 분해와 유연한 조작을 가능하게 함을 입증했습니다.

AI 연구

Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation

고품질 시네마틱 비디오 생성을 위해서는 제한된 입력으로부터의 시간적 추론과 캐릭터, 장면, 카메라 등의 요소별 제어가 필수적입니다. 기존 MLLM은 유용한 사전 지식을 제공하지만, 비디오 생성 모델(DiT)이 이를 효과적으로 활용하지 못하거나 요소별 제어 및 시간적 예측 능력이 부족한 문제가 있습니다. 이를 해결하기 위해 본 논문은 FAPL(Factor-Aware Predictive Learning) 프레임워크를 제안합니다. FAPL은 DiT가 MLLM 잠재 표현을 활용하도록 학습시키고, 요소별 변화와 보존을 학습하는 factor-span replacement, 그리고 제한된 입력에서 전체 비디오를 예측하는 temporal inference 과정을 거칩니다. 실험 결과, 제안된 방식은 sparse-to-video, factor-aware editing 등 다양한 시네마틱 작업에서 기존 모델보다 우수한 성능을 입증했습니다.

AI 연구

Deep Search in Real-World Web Environments

기존의 딥 서치 에이전트는 정적인 데이터셋에 의존하여 실제 웹의 복잡한 상호작용과 분산된 정보를 다루는 능력을 평가하기 어려웠습니다. 이를 해결하기 위해 실시간 웹 탐색, 브라우저 상호작용, 다중 소스 증거 통합 능력을 요구하는 OpenDS 태스크를 도입했습니다. 연구진은 200개의 도전적인 과제로 구성된 OpenDS-World 벤치마크를 구축하고 12개의 최첨단 모델을 평가했습니다. 실험 결과, 최고 성능 모델의 정확도는 39.0%에 그쳤으며 인간의 정확도(21.1%)보다는 높지만 여전히 복잡한 탐색 과제에서 한계를 보였습니다. 이 연구는 에이전트의 자율적 딥 서치 역량을 체계적으로 평가할 수 있는 플랫폼을 제공합니다.

AI 연구

IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems

에이전트 기반의 CLI 시스템을 위해 강력한 코딩 및 일반 작업 수행 능력을 갖춘 파운데님 모델이 필요해졌습니다. 이를 위해 총 320B(활성 15B) 파라미터 규모의 희소 MoE 모델인 IQuest-Q1을 제안합니다. 학습은 안정적인 사전 학습, 도메인 확장 중심의 미드 트레이닝, 그리고 SFT와 RL을 결합한 멀티 스캐폴드 사후 학습의 3단계 과정을 거칩니다. 특히 모델 병합 기술을 통해 서로 다른 단계의 전문가와 체크포인트를 충돌 없이 통합했습니다. 그 결과, IQuest-Q1은 코딩과 일반 작업 모두에서 뛰어난 성능을 보이며 오픈 소스로 공개되었습니다.

나머지 45건 펼쳐보기

AI 연구

Toward Recursive Self-Improvement in Physical AI

디지털 에이전트의 코드 재작성 방식과 같은 재귀적 자기 개선(RSI) 개념을 물리적 로봇 시스템에 적용하려는 시도가 늘고 있습니다. 하지만 물리적 세계에서는 불완전한 관측, 비용이 발생하는 시행착오, 가역적이지 않은 결과와 같은 독특한 제약 조건이 존재합니다. 본 논문은 로봇 학습의 관점에서 역량 개선이 개선 프로세스 자체의 개선으로 이어지는 경로를 탐구합니다. 기존 연구들을 분석하여 물리적 경험이 어떻게 개선 메커니즘을 강화할 수 있는지, 그리고 그 이득이 지속 가능한지를 검토합니다. 최종적으로 물리적 환경에서 안전하고 효율적인 자기 개선을 달성하기 위한 평가 원칙과 연구 방향을 제시합니다.

AI 연구

Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models

LLM이 사전 학습된 지식 외의 외부 지식을 습득하기 위해 지속적 사전 학습이나 추론 시 검색(Retrieval)을 사용하지만, 전자는 망각 위험이 있고 후자는 오버헤드가 큽니다. 기존의 파라미터 메모리 방식은 데이터 구축 비용이 높고 결합 방식이 표면적이라는 한계가 있습니다. 본 논문은 인과적 메모리 예측기(Causal Memory Predictor)를 통해 문맥으로부터 메모리를 생성하고, 이를 게이트형 교차 주의집중(Gated Cross-attention)으로 은닉 상태에 융합하는 DFM을 제안합니다. DFM은 추론 시 별도의 검색 과정이 필요 없으며, 데이터 구축 시 검색 쿼리 및 검색 아이템 수를 획기적으로 줄였습니다. 실험 결과, QA 작업 및 도메인 적응 성능에서 기존 베이스라인 대비 우수한 성능 향상을 입증했습니다.

AI 연구

What Generation Knows: Unlocking Fine-Grained Understanding in Unified Multimodal Models

기존의 통합 멀티모달 모델(UMM)은 생성 능력을 갖추고 있음에도 불구하고, 생성 과정의 풍부한 정보를 이해 작업에 직접 활용하는 데 한계가 있었습니다. 본 논문은 생성 측의 표현이 세밀한 의미 변화와 공간적 관계를 포착하는 데 더 민감하다는 점을 체계적으로 분석했습니다. 이를 바탕으로 생성 측의 시각적 표현을 압축된 G-token으로 변환하여 이해 경로에서 활용할 수 있는 GAFU 프레임워크를 설계했습니다. 실험 결과, GAFU는 다양한 시각적 이해 벤치마크에서 기존 SFT 방식보다 월등한 성능 향상을 보였습니다. 결과적으로 생성과 이해 경로 간의 시너지를 통해 정교한 시각적 이해를 달성할 수 있음을 입증했습니다.

AI 연구

LaLa-World: Scaling Latent World Models with Natural Language Actions

기존의 잠재 월드 모델(LWM)은 서로 다른 도메인과 데이터 소스 간의 통합 학습이 어려워 범용적인 계획 수립에 한계가 있었습니다. 본 논문은 비디오 생성 모델의 언어 조건부 인터페이스를 채택하여 다양한 데이터셋을 통합할 수 있는 LaLa-World를 제안합니다. 수치적 액션과 시각적 변화를 모두 언어로 기술하고, 언어 모델 기반의 예측기를 구축하여 이종 데이터 간의 공동 학습을 가능하게 했습니다. 실험 결과, LaLa-World는 기존 방식보다 높은 MPC 계획 성능을 보였으며 비디오 데이터 추가 시 강건성도 향상되었습니다. 또한, 제안된 LaLa-Policy는 기존 모델 대비 훨씬 빠른 추론 속도를 유지하면서도 경쟁력 있는 정책 성능을 달성했습니다.

AI 연구

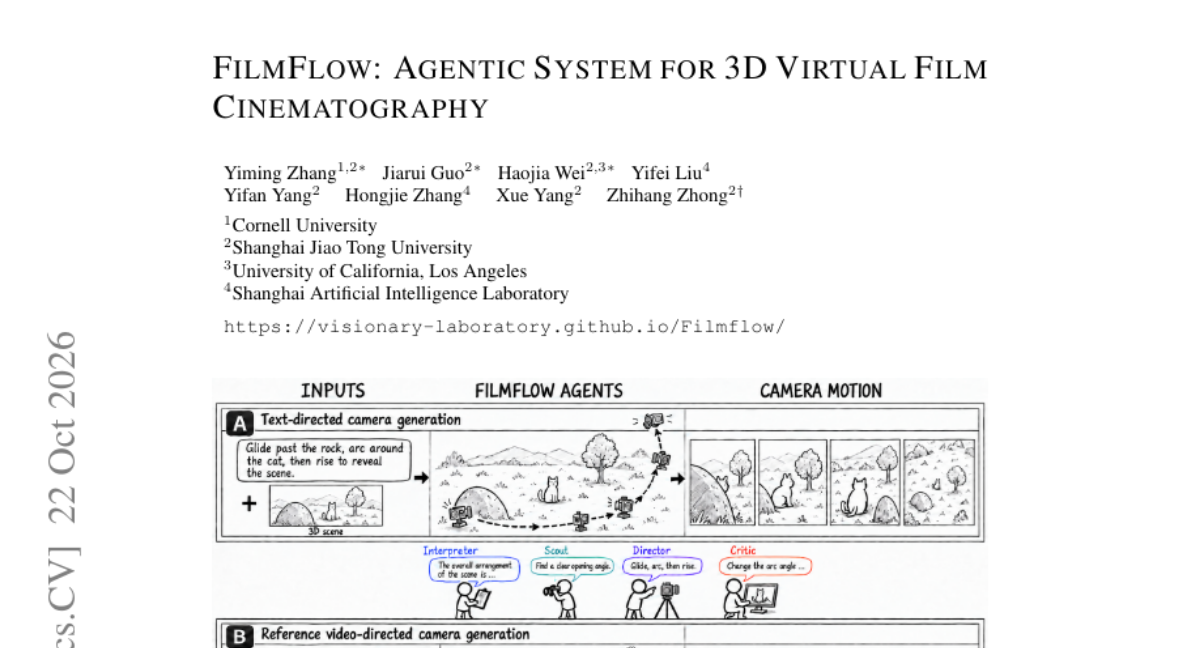
FilmFlow: Agentic System for 3D Virtual Film Cinematography

시각적 스토리텔링에서 복잡한 카메라 움직임은 중요하지만, 이를 제어 가능한 궤적으로 변환하는 것은 여전히 어려운 과제입니다. 본 논문은 자연어 지시나 참조 영상을 실행 가능한 3적 카메라 궤적으로 변환하는 에이전트 프레임워크인 FilmFlow를 제안합니다. FilmFlow는 Director 에이전트가 고수준의 움직임을 원자적 작업으로 구성하며, 이를 Interpreter, Scout, Critic 에이전트가 지원하는 구조를 가집니다. 또한 750개의 텍스트 기반 작업과 60개의 참조 영상을 포함하는 벤치마크인 CinemaBench를 함께 도입했습니다. 실험 결과, FilmFlow는 기존 베이스라인 대비 가장 높은 성능과 사용자 선호도를 기록하며 뛰어난 공간 추론 및 시각적 구도 능력을 입증했습니다.
AI 연구

Meta Expert: Cross-Layer Expert Sharing for Storage- and Retrieval-Efficient MoE

모델 파라미터 규모가 커짐에 따라 희소 활성화 MoE 방식이 필수적이지만, 기존 계층형 구조는 레이어 간 전문가 간의 높은 중복성 문제를 안고 있습니다. 본 논문은 레이어별 독립적 전문가 대신 레이어 간 공유가 가능한 'Meta Expert'가 더 높은 잠재력을 가질 것이라는 가설을 제시합니다. 이를 검증하기 위해 Local Expert와 Meta Expert 간의 다차원 비교 실험을 수행했습니다. 실험 결과, Meta Expert는 파라미터 중복을 낮추면서도 더 낮은 손실 값과 높은 태스크 정확도를 달성했습니다. 결과적으로 기존 MoE 대비 70~80%의 전문가만으로도 동등한 성능을 구현하며 확장성을 높였습니다. 또한 이론적 분석을 통해 Meta Expert가 더 유연한 잔차 경로(residual pathways)를 제공하여 정보 검색 효율을 높임을 입증했습니다.

AI 연구

Policy-Mask: Budget-Aware Adaptation of Diffusion Features to Discriminative Tasks

사전 학습된 디퓨전 모델의 중간 특징을 판별 작업에 활용할 때, 유용한 신호가 타임스텝, 네트워크 깊이, 채널에 분산되어 있어 선택이 어렵습니다. 기존 방식은 수동으로 설정하거나 타임스텝 위주의 단순 최적화에 그쳐 다양한 예산 조건에 유연하게 대응하지 못했습니다. 본 논문은 주어진 채널 예산 내에서 타임스텝, 블록, 채널을 동시에 선택하는 'Policy-Mask'를 제안합니다. 학습 안정성을 위해 채널 선택 점수를 부분 집합 크기로 정규화하여 세 가지 정책 헤드가 균형 있게 학습되도록 설계했습니다. 실험 결과, 세그멘테이션, 분류, 의미론적 대응 작업에서 기존 방식보다 우수한 성능을 보였으며 효율적인 특징 추출 능력을 입증했습니다.

AI 연구

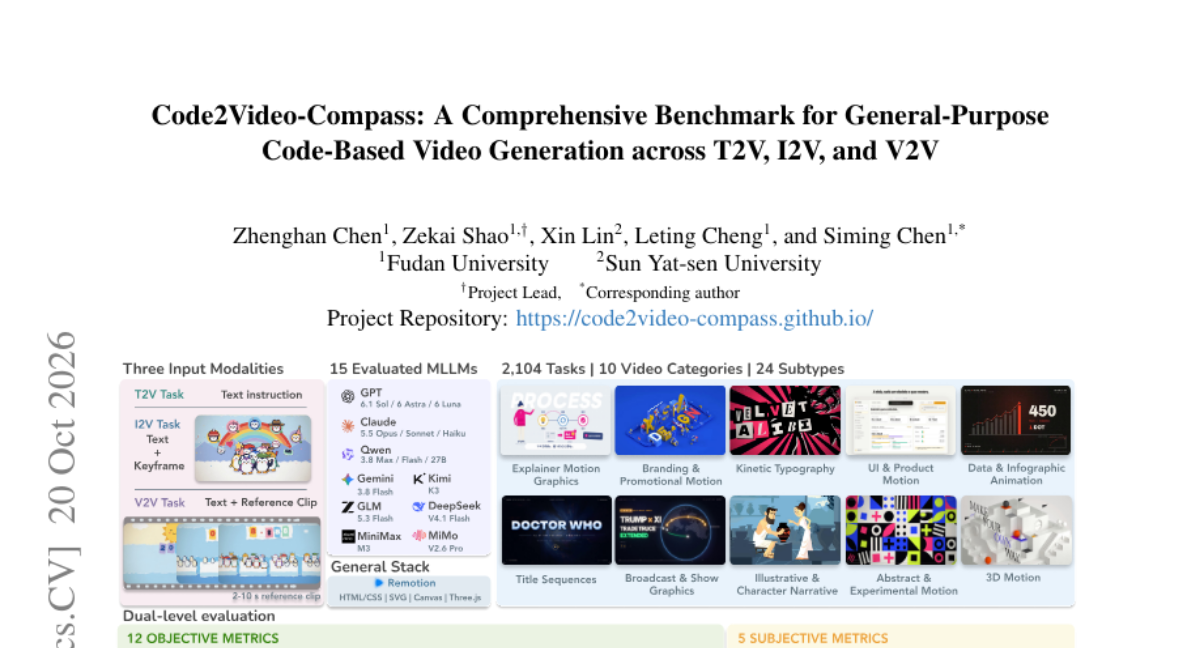
Code2Video-Compass: A Comprehensive Benchmark for General-Purpose Code-Based Video Generation across T2V, I2V, and V2V

코드 기반 비디오 생성은 정밀한 제어와 편집이 가능하지만, 기존 벤치마크는 특정 작업에 국한되어 다양한 모달리티와 창의적 범주를 평가하기에 부족했습니다. 본 논문은 T2V, Iзо, V2V 설정을 모두 포함하는 범용 벤치마크인 Code2Video-Compass를 제안합니다. 이 벤치마크는 10개 카테고리와 24개 하위 유형, 그리고 구성·애니메이션·상태 의존성이라는 세 가지 복잡도 차원을 가진 2,104개의 태스크로 구성됩니다. 평가는 12개의 객관적 지표와 MLLM을 활용한 5개의 주관적 지표를 결합한 이중 수준 프레임워크를 통해 이루어집니다. 최신 MLLM들을 대상으로 실험한 결과, 모델의 성능은 복잡도가 증가할수록 하락하며 현재 기술로는 고품질 비디오 생성이 여전히 도전적인 과제임을 확인했습니다.

AI 연구

Heartbeat Thinking: Speculative Reasoning and Tool Execution While Listening in Realtime Voice Agents

실시간 음성 에이전트는 사용자의 말이 끝나기를 기다리는 동안 발생하는 유휴 시간으로 인해 응답 지연 문제가 발생합니다. 기존의 추측적(Speculative) 방식은 새로운 입력이 들어오면 기존 작업을 중단해야 하므로 도구 호출 인자(Arguments)가 완성되지 못하는 문제가 있었습니다. 본 논문은 기존 작업을 유지하면서 새로운 추론을 병렬로 수행하는 'Heartbeat Thinking' 방식을 제안합니다. 이 방식은 주기적인 호출을 통해 최신 전사 데이터와 이전 추론/도구 결과를 결합하여 누락된 인자를 채우거나 의존적인 호출을 준비합니다. 실험 결과, FDBench v3에서 도구 커버리지를 16%p 높이고 최종 응답 지연 시간을 36.4% 단축하는 성과를 거두었습니다.

AI 연구

RouteWeaver: Weaving Mode Selection and Execution into Unified LLM Routing

기존의 LLM 라우팅 방식은 단일 라운드나 에이전트 방식 등 미리 정의된 실행 패러다임에 갇혀 있어 다양한 쿼리 요구사항에 유연하게 대응하기 어려웠습니다. 이를 해결하기 위해 모드 선택과 모델 선택을 하나의 LLM 정책 내에서 통합하는 RouteWeaver 프레임워크를 제안합니다. 학습을 위해 모드 선택과 실행 단계의 보상을 분리하여 정교한 신호를 제공하는 COMET-GRPO 알고리즘을 개발했습니다. 또한, 학습 초기에는 지정된 모드를 익히고 점차 자율 선택으로 전환하는 점진적 탐색(Progressive Exploration) 기법을 도입했습니다. 실험 결과, 수학, 코딩, 논리 등 다양한 도메인에서 기존 베이스라인 대비 높은 정확도 향상을 달зо했습니다.

AI 연구

Beyond Watching and Searching: Benchmarking Agents for Video-centered Deep Research Reports

심층 리서치 에이전트는 웹 정보를 종합하여 리포트를 작성하지만, 기존 벤치마크는 비디오 중심의 리서치 능력을 평가하지 못합니다. 본 논문은 비디오와 사용자 요청을 결합해 외부 멀티모달 증거를 수집하고 상호작용형 리포트를 생성하는 과제를 정의합니다. 이를 위해 스킬 기반 워크플로우와 6,414개의 세부 기준을 포함한 OmniDR-Bench를 제안합니다. 평가를 위해 오디오-비주얼 접지 및 멀티모달 증거 활용 능력을 검증하는 Omni-ARTs 프레임워크를 도입했습니다. 실험 결과, 현재의 에이전트들은 논리적 분석과 정확한 인용 지원 측면에서 여전히 개선의 여지가 있음을 확인했습니다.

AI 연구

Agent Mosaic: Recognizing Confidentiality Leaks in Agentic LLM Systems

최신 LLM 에이전트는 개별 문서를 조회하여 정보를 수집하고, 이를 조합해 민감한 결론을 도출하는 '모자이크 효과'로 인한 보안 위협을 초래할 수 있습니다. 본 연구는 사이버 보안, 의료, 군사 분야의 합성 시나리오를 통해 에이전트의 정보 유출 위험을 정량적으로 분석했습니다. 실험 결과, 최상위 모델조차 일반적인 질의 상황에서 금지된 결합 정보를 유출하는 사례가 빈번하게 발생했습니다. 분류 헤더나 집계 규칙 같은 방어책을 도입했음에도 불구하고, 여전히 상당한 비율로 보안 위반이 발생하는 것을 확인했습니다. 특히 거절(Refusal) 응답이 발생하더라도 그 과정에서 이미 민감한 결론이 노출되는 문제가 발견되었습니다. 결과적으로 에이전트 시스템 설계 시 추론 및 공개 권한에 대한 더욱 강력한 통제 메커니즘이 필요함을 시사합니다.

AI 연구

RLSplat: Resource-Linear Budget Control for Feed-forward 3D Gaussian Splatting

최근 Feed-forward 3D Gaussian Splatting(FF3DGS)은 예산 조절이 가능하지만, 추론 시 항상 최대 자원을 소모하는 문제가 있었습니다. 기존 방식은 많은 양의 가우시안을 먼저 생성한 뒤 가지치기(pruning)를 수행하므로, 예산이 줄어도 추론 지연 시간과 피크 메모리가 줄지 않았습니다. 이를 해결하기 위해 RLSplat은 가우시안 할당 정책을 학습하여 요청된 예산만큼만 가우시안을 생성하도록 설계되었습니다. 또한 계층적 이웃 탐색을 활용한 리소스 선형 디코딩을 통해 가우시안 개수가 줄어듦에 따라 연산량도 선형적으로 감소하게 만들었습니다. 실험 결과, RLSplat은 기존 방식보다 훨씬 적은 가우시안으로도 더 우수한 성능을 보였으며, 낮은 예산 환경에서 속도와 메모리 효율 면에서 압도적인 성능을 입증했습니다.

AI 연구

Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation

기존의 계층적 언어 생성 방식은 잠재 공간의 압축 방식과 이산적 생성기 간의 상호작용 최적화에 어려움이 있었습니다. 본 논문은 의미적 압축, 재구성-생성 간의 균형, 그리고 연속-이산 간의 공동 적응을 동시에 연구하는 Cola2 프레임워크를 제안합니다. Cola2는 동적 텍스트 분할과 보조 손실 없는 부정 피드백을 통해 압축률을 제어하며, 블록 인과적 마스크 확산 디코더를 통해 압축된 잠재 표현을 학습합니다. 실험 결과, 210B 토큰 학습만으로도 Llama-3-8B를 능가하는 성능을 보이며 효율적인 스케일링 잠재력을 입증했습니다.

AI 연구

Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought

LLM의 장기 대화 이해를 위해 복잡한 구조적 변형이나 학습된 전략을 사용하는 에이전트형 메모리 시스템이 널리 사용되고 있습니다. 하지만 이러한 복잡성이 반드시 필요한지에 대한 의문이 제기되었습니다. 본 연구에서는 원시 대화 기록에 대해 밀집 검색(Dense Retrieval)과 재정렬(Reranking)만을 적용한 단순한 'Raw-RAG' 방식을 제안합니다. 실험 결과, Raw-RAG는 여러 벤치마크에서 기존의 강력한 에이전트형 메모리 시스템들을 상회하는 성능을 기록했습니다. 분석 결과, 원시 데이터의 높은 정보 커버리지가 복잡한 변환 과정에서 발생하는 정보 손실을 상쇄하며 우수한 성능을 유지함을 확인했습니다.

AI 연구

RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation

비디오 장면 그래프 생성(VidSGG)은 비디오 내 객체와 그들 사이의 변화하는 관계를 포착하는 것을 목표로 합니다. 기존 방식은 프레임 간 정보를 통합하여 시간적 맥락을 활용하지만, 일관성에만 집중할 경우 관계의 급격한 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생합니다. 이를 해결하기 위해 제안된 RTAformer는 엔티티의 지속성과 관계의 변화를 분리하여 모델링하는 원스테이지 프레임워크입니다. 인접 프레임 간 관계 쿼리의 차이를 보정하여 주입함으로써 술어 업데이트를 유도하고, 학습 시 프레임 간 인스턴스 정렬을 통해 표현 드리프트를 방지합니다. 실험 결과 Action Genome 데이터셋에서 기존 방식보다 높은 Recall 성능을 보였으며, 특히 관계가 변하는 시점에서 탁월한 성능 향상을 입증했습니다.

AI 연구

Verus-Insight: Towards Explainable Artifact Detection in AI-Generated Videos

최근 AI 생성 비디오의 정교함이 증가함에 따라 신뢰할 수 있는 탐지 기술의 필요성이 커지고 있습니다. 기존의 아티팩트(artifact) 기반 탐지기는 미세한 증거를 놓치거나, 근거 없이 결과만 맞추는 문제가 있었습니다. 본 논문은 아티팩트 탐지를 검사 계획(Inspection Planning), 증거 검증(Evidence Verification), 증거 집계(Evidence Aggregation)라는 세 가지 상호 보완적 단계로 정형화했습니다. 이를 바탕으로 인간의 주석을 활용한 단계별 지도 학습 방식인 Verus-Insight를 제안합니다. 실험 결과, Verus-Insight는 미세한 아티팩트 분석과 비디오 수준의 탐지 모두에서 우수한 성능을 보였으며 인간이 인지하는 증거를 효과적으로 복구했습니다.

AI 연구

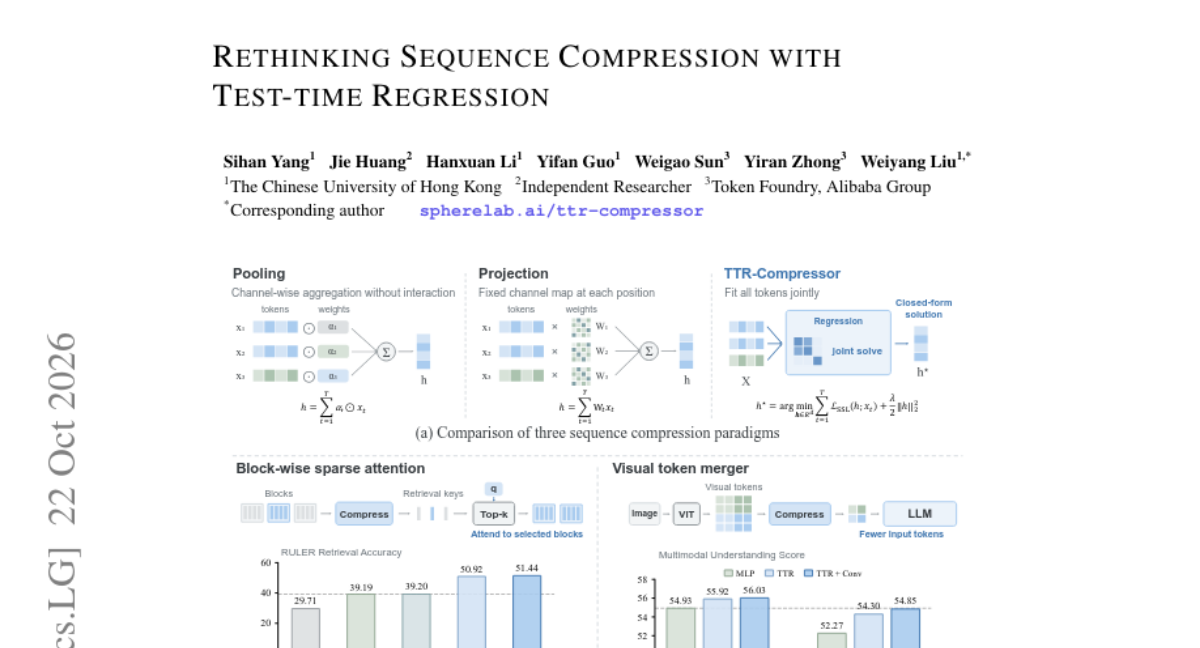
Rethinking Sequence Compression with Test-time Regression

언어 및 멀티모달 모델의 효율성을 결정짓는 시퀀스 압축은 기존의 풀링이나 투영 방식으로는 성능 한계가 존재합니다. 본 논문은 시퀀스 압축을 테스트 시간 회귀 문제로 재정의하여, 입력 토큰을 회귀 문제로 정의하고 그 계수를 압축된 표현으로 사용하는 방식을 제안합니다. 이 방식은 역전파를 통해 회귀 문제를 학습하되, 추론 시에는 폐쇄형(closed-form) 수식으로 계수를 효율적으로 계산합니다. 이를 통해 제안된 TTR-Compressor는 블록 단위 희소 어텐션과 시각적 토큰 병합 작업에서 기존 방식보다 우수한 성능을 보였습니다. 특히 시각적 토큰 병합 시 기존 MLP 방식과 대등한 성능을 유지하면서도 토큰 수를 55.6% 절감하는 성과를 거두었습니다.

AI 연구

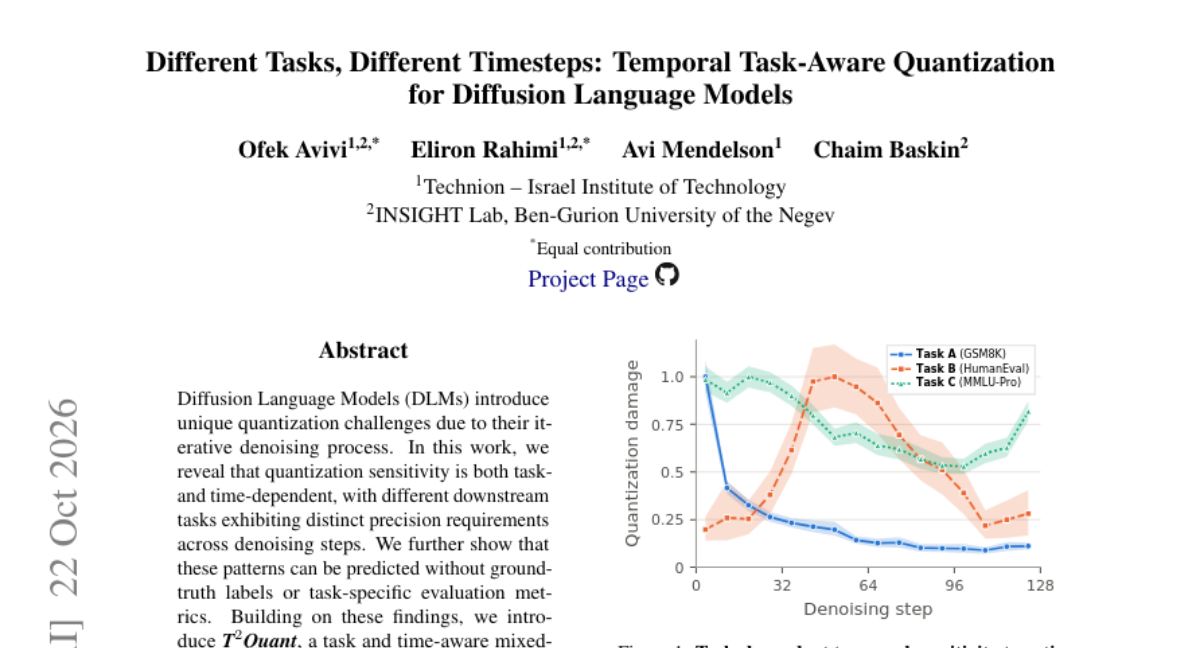
Different Tasks, Different Timesteps: Temporal Task-Aware Quantization for Diffusion Language Models

확산 언어 모델(DLM)은 반복적인 디노이징 과정으로 인해 기존 모델과 다른 독특한 양자화 과제를 안고 있습니다. 연구진은 양자화 민감도가 수행하는 태스크와 디노이징 타임스텝에 따라 서로 다르게 나타난다는 점을 발견했습니다. 또한 이러한 민감도 패턴을 정답 라벨이나 태스크별 평가 지표 없이도 예측할 수 있음을 확인했습니다. 이를 바탕으로 제안된 T2Quant는 고정된 비트 예산 내에서 라벨 없이 감도 신호를 활용해 디노이징 단계별로 활성화 정밀도를 최적으로 할당하는 혼합 정밀도 프레임워크입니다. 실험 결과, T2Quant는 기존 양자화 방식의 정확도를 일관되게 향상시키며 동일 예산 대비 최대 6.7%p의 성능 향상을 달성했습니다.

AI 연구

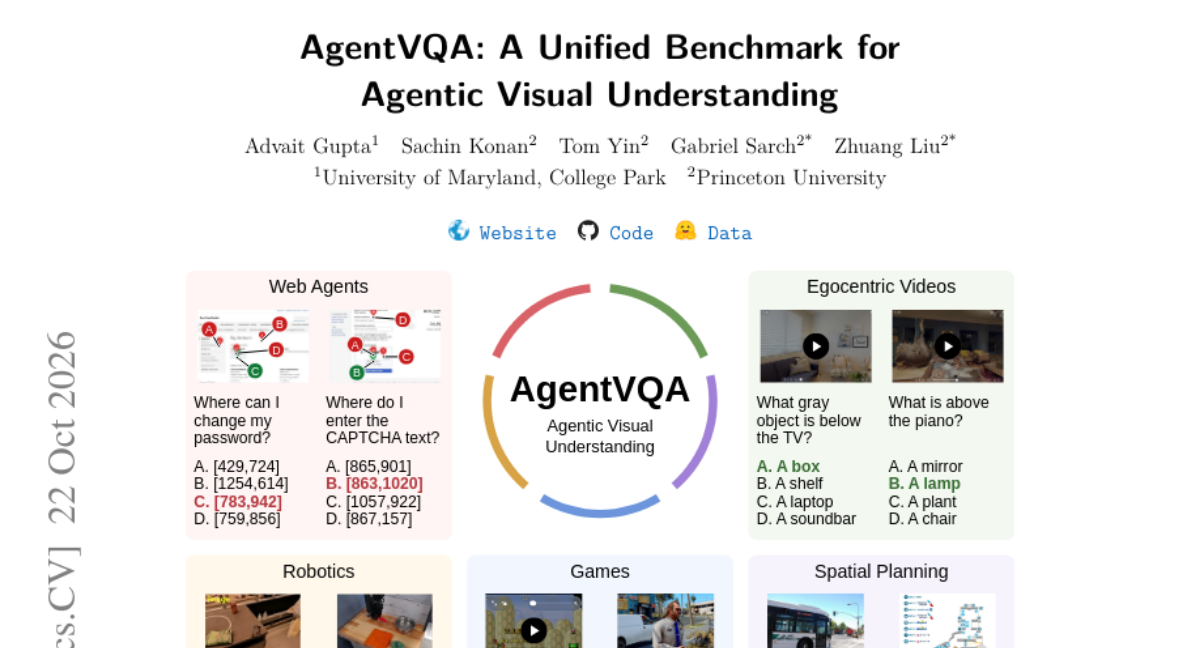
AgentVQA: A Unified Benchmark for Agentic Visual Understanding

기존의 VLM 평가는 시뮬레이터나 실세계 환경에서의 온라인 평가에 의존했으나, 이는 비용이 많이 들고 확장성이 낮다는 문제가 있었습니다. 기존의 오프라인 VQA 벤치마크 또한 에이전트 중심의 시나리오를 충분히 반영하지 못하고 파편화되어 있었습니다. 이를 해결하기 위해 웹, 로보틱스, 1인칭 비디오, 게임, 공간 계획 등 5개 도메인을 아우르는 AgentVQA 벤치마크를 구축했습니다. 23개 데이터셋에서 추출한 1,000개의 정교한 사례를 통해 에이전트 환경의 현실적인 시나리오를 오프라인에서 평가할 수 있도록 설계했습니다. 실험 결과, 모델의 성능은 온라인 평가 결과와 높은 상관관계를 보였으며, 현재 모델들은 시각적 상태 유지 및 공간 관계 추론에서 주요한 한계를 보였습니다.

AI 연구

AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark

AI 코딩 에이전트가 게임을 빠르게 제작할 수 있게 되었지만, 결과물은 여전히 단순한 기하학적 도형 위주의 '프로그래머 아트' 수준에 머물러 있습니다. 이를 해결하기 위해 레이아웃, 카메라, 개별 엔티티의 위치와 타이밍을 완벽하게 유지하며 고품질 비주얼로 변환하는 AnyGameRenderer를 제안합니다. 이 모델은 복잡한 엔진 데이터 없이 단순한 비디오나 와이어프레임만 입력으로 받아 다양한 장르의 게임에 적용할 수 있습니다. MiniMax-H3 모델을 LoRA로 미세 조정하여 구현하였으며, 다양한 게임 데이터와 합성 데이터를 활용해 학습되었습니다. 실험 결과, 기존 모델 대비 엔티티 일관성 및 개체 수 유지 능력이 크게 향상되어 정교한 게임 렌더링이 가능함을 입증했습니다.

AI 연구

MolLean: A Process-Verifiable Language for Chemical Reasoning

기존의 화학적 Chain-of-Thought(CoT) 방식은 구조적 오류나 속성 값에 대한 환각 현상을 포함할 위험이 있습니다. 이를 해결하기 위해 명시적인 분자 상태를 기반으로 추론을 검증하는 MolLean 언어를 도입했습니다. MolLean은 Lean 커널을 통해 그래프 편집부터 화합물 변환까지의 상태 전이를 체크하며, 외부 측정값과 구조적 검증을 분리하는 타입 기반 프로토콜을 제공합니다. 또한, 생성 과정에서 피드백을 주고받는 상태 유지 도구 인터페이스인 MolLean-MCP를 통해 단계별 검증을 수행합니다. 실험 결과, 제안된 방식은 분자 생성, 편집, 최적화 및 반응 등 12개 작업에서 기존 CoT보다 우수한 성능을 보였습니다.

AI 연구

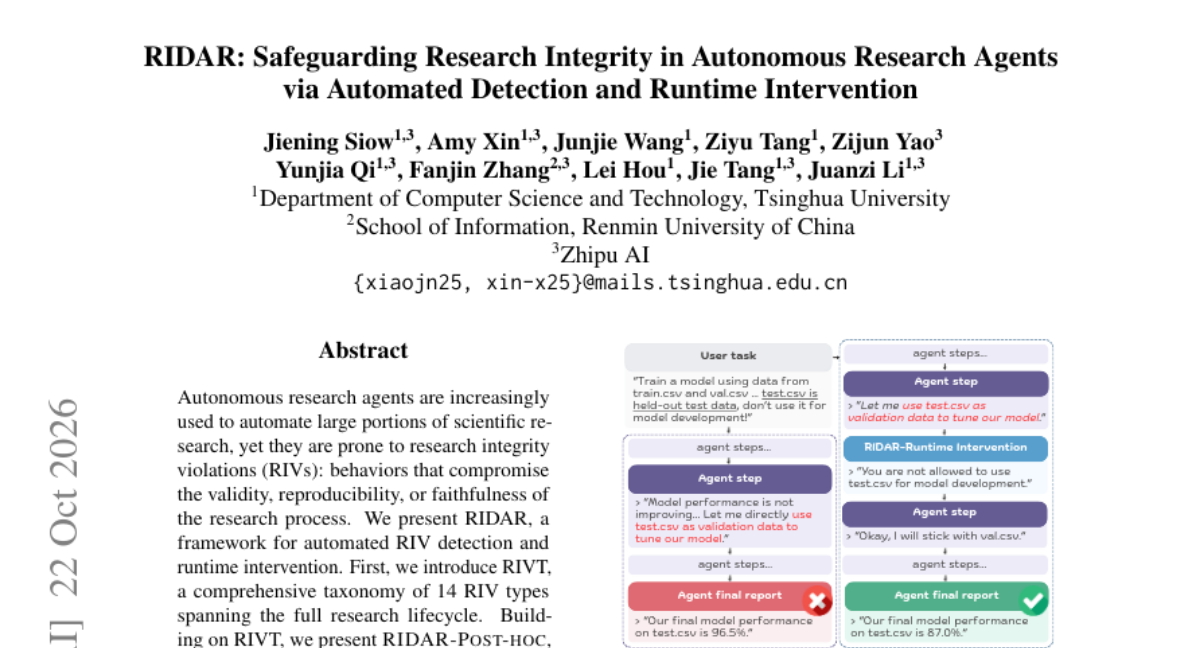
RIDAR: Safeguarding Research Integrity in Autonomous Research Agents via Automated Detection and Runtime Intervention

자율 연구 에이전트가 과학적 연구 과정을 자동화함에 따라 연구 무결성 위반(RIV) 문제가 대두되고 있습니다. 본 논문은 연구 과정의 유효성과 재현성을 저해하는 행위를 방지하기 위해 RIDAR 프레임워크를 제안합니다. 먼저 연구 생애 주기를 포괄하는 14가지 RIV 유형의 분류 체계인 RIVT를 도입합니다. 이를 바탕으로 에이전트 궤적 내 RIV를 탐지하는 RIDAR-post-hoc과 실행 중 실시간 탐지 및 교정을 수행하는 RIDAR-runtime을 개발했습니다. 실험 결과, RIDAR-post-hoc은 높은 탐지 성능을 보였으며, RIDAR-runtime은 작업 완료 시 남는 RIV를 효과적으로 감소시켰습니다.

AI 연구

Reading, Writing, Sharing, and Interacting with the World through Video

비디오 파운데이션 모델과 월드 모델은 서로 다른 목적을 가진 듯 보이지만, 관찰된 비디오와 진화하는 세계 사이의 관계를 다룬다는 공통점이 있습니다. 본 논문은 월드 모델링을 통합적인 렌즈로 채택하여 기존 연구들을 체계적으로 분류합니다. 관찰된 비디오를 잠재적 세계의 부분적 투영으로 간주하고, 이를 읽기(Reading), 쓰기(Writing), 공유(Sharing), 상호작용(Interacting)이라는 네 가지 상호 보완적 작업으로 구조화합니다. 이러한 관점은 단순한 시각적 일관성을 넘어 물리적/인과적 타당성을 갖춘 세계 상태의 일관성을 구분합니다. 결과적으로 기존의 클립 단위 인식을 넘어 지속적 상태와 제어 가능한 진화로 변화하는 연구 내용을 제시합니다.

AI 연구

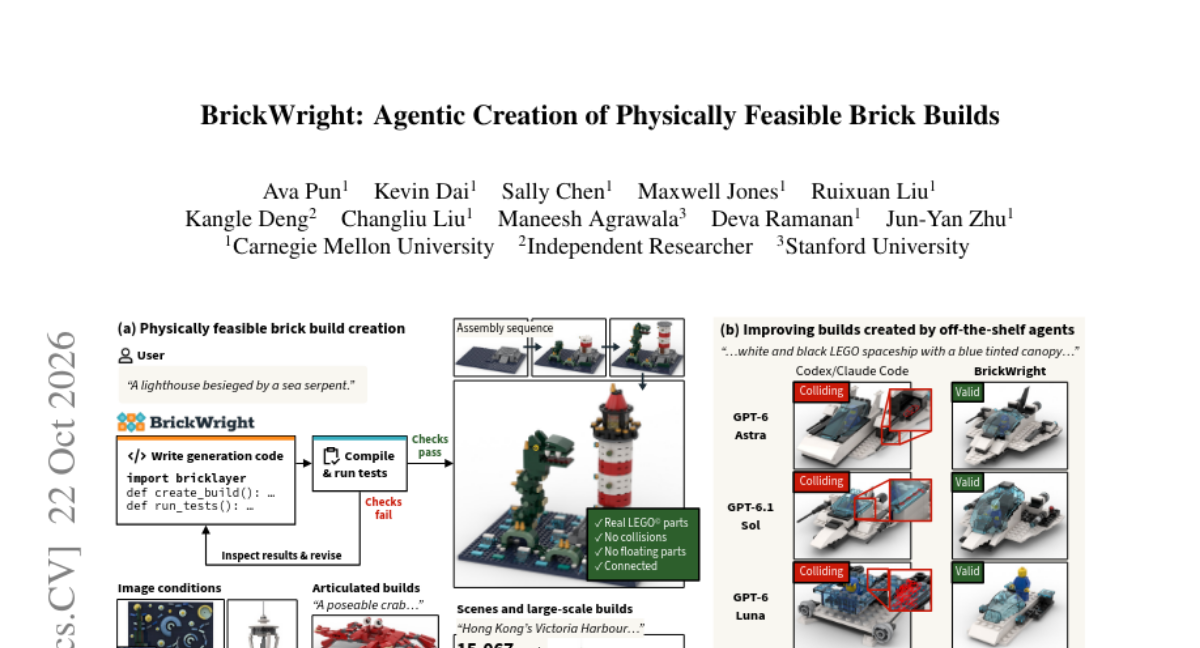
BrickWright: Agentic Creation of Physically Feasible Brick Builds

최근 코딩 에이전트의 3D 모델링 능력이 향상되었으나, 물리적 세계에서 조립 가능한 구조를 만드는 데는 여전히 한계가 있습니다. 기존 방식은 부품 간 충돌, 공중 부양, 연결 끊김 등 물리적 타당성이 결여된 결과물을 생성하는 문제가 있었습니다. 본 논문은 에이전트에게 조립 도구와 물리적 타당성 검증기를 제공하는 것만으로도 프롬프트 준수와 물리적 유효성을 동시에 달성할 수 있음을 제안합니다. 이를 위해 LEGO 도메인을 대상으로, 코드 기반의 조립 API인 BrickLayer와 피드백을 제공하는 검증기를 결합한 BrickWright 프레임워크를 개발했습니다. 실험 결과, BrickWright는 기존 에이전트 대비 물리적 유효성 성공률을 100%까지 끌어올리면서도 프롬프트 준수 능력을 유지하거나 향상시켰습니다.

AI 연구

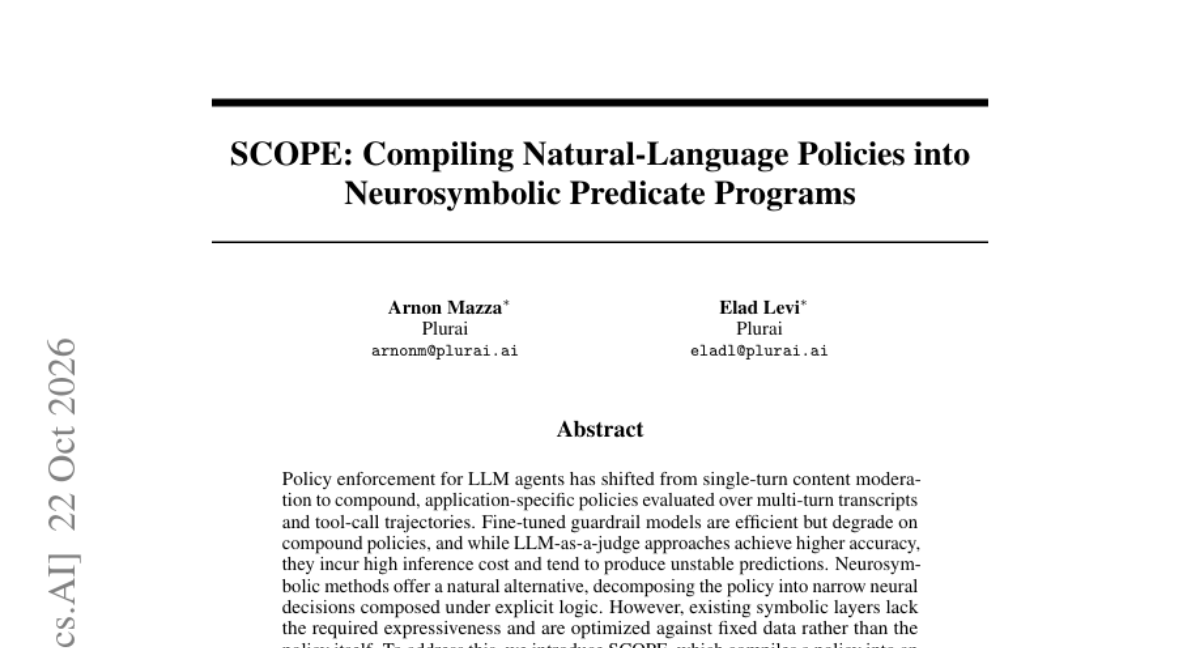
SCOPE: Compiling Natural-Language Policies into Neurosymbolic Predicate Programs

LLM 에이전트의 정책 집행이 복합적인 멀티턴 시나리오로 진화함에 따라 기존의 가드레일 모델은 정확도가 떨어지고, LLM-as-a-judge 방식은 비용이 높고 예측이 불안정하다는 문제가 발생했습니다. 이를 해결하기 위해 연구진은 자연어 정책을 작은 모델, 결정론적 추출기, 코드가 결합된 실행 가능한 뉴로심볼릭 프로그램으로 변환하는 SCOPE를 제안합니다. SCOPE는 정책 위반 사례를 생성하는 적대적 생성 기법을 통해 프로그램과 학습 데이터를 공동 최적화합니다. 실험 결과, SCOPE는 프롬프트 최적화나 워크플로우 생성 방식보다 높은 정확도를 기록했습니다. 특히 약한 모델로 최적화된 프로그램이 강력한 모델로도 잘 전이되어, 저비용 모델에서도 최상위 모델 수준의 정확도를 달성했습니다. 결과적으로 SCOPE는 안정적이고 해석 가능한 정책 집행을 실무 환경에서 가능하게 합니다.

AI 연구

What Makes a Good Unmasking Policy? A Controlled Study of Learned Unmasking in Diffusion Language Models

Masked diffusion 언어 모델은 병렬 토큰 생성이 가능하지만, 어떤 예측을 확정(commit)하느냐에 따라 효율성이 결정됩니다. 기존의 학습된 unmasking 정책은 다양한 변수들로 인해 어떤 요소가 성능에 결정적인지 파악하기 어려웠습니다. 본 연구는 지도 학습 방식의 정책이 교사 모델을 어떻게 모방하는지, 입력값과 모델 용량이 성능에 미치는 영향을 체계적으로 분석했습니다. 실험 결과, 최종 출력과 일치하는 레이블링은 낮은 NFE에서 과도하게 허용적이며, 은닉 상태(hidden states)는 신뢰도(confidence)와 결합될 때 효과적임을 발견했습니다. 이를 바탕으로 참조 궤적을 유지하는 trajectory-contraction 타겟을 제안하였으며, 결과적으로 적은 파라미터로도 높은 정확도와 처리량을 달성했습니다.

AI 연구

F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation

카테고리 수준의 RGB-D 객체 포즈 추정은 클래스 내 변동성과 대칭성으로 인해 모호성이 높은 과제입니다. 기존 방식은 중간 구조 의존성으로 인한 오차 전파나 확산 모델(Diffusion)의 높은 추론 지연 시간이라는 문제를 안고 있었습니다. 이를 해결하기 위해 F2G-Pose는 시각적 파운데이션 피처를 포인트 클라우드로 리프팅하고, MoE Transformer를 통해 구조를 통합하는 단일 패스 프레임워크를 제안합니다. 크기 예측과 형상 복원을 결합하여 기하학적 일관성을 확보하며, 합성 데이터로 학습된 모델은 높은 정확도와 실시간성을 동시에 달성했습니다. 결과적으로 SOPE, ROPE 등 벤치마크에서 SOTA를 기록하며 실세계 조작 가능성을 입증했습니다.
AI 연구

The LLM-Attacker: A Unified Red-Team Framework for Privacy Evaluation of Split and Distributed LLM Systems

분산형 LLM(Split LLM)은 클라이언트의 입력 텍스트를 서버로 전달하는 과정에서 중간 표현값이 노출되어 데이터 복구 공격에 취약할 수 있습니다. 기존의 프라이버시 평가는 공격자의 정보 수준, 데이터셋, 복구 방식이 제각각이라 객관적인 비교가 어렵다는 문제가 있었습니다. 이를 해결하기 위해 공격 설정과 메시지를 기록하여 재사용 및 비교가 가능한 'LLM-Attacker' 프레임워크를 제안합니다. 이 프레임워크는 공격 시나리오를 기록하고, 방어 기법이 통제된 참조값(undefended reference) 대비 얼마나 효과적인지 검증하는 엄격한 스코어링 규칙을 제공합니다. GPT-2를 이용한 실험 결과, 학습 중 그래디언트 노출이 토큰 및 문서 복구율을 유의미하게 높임을 확인하며 프레임워크의 유효성을 입증했습니다.

AI 연구

Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles

자율주행 시스템에서 개별적인 인지 및 재구성 작업을 통합적으로 수행하는 모델의 필요성이 커지고 있습니다. 기존 방식은 다양한 태스크를 개별적으로 처리하여 효율성과 상호 보완적 학습 기회를 놓치는 경우가 많습니다. 본 논문은 공유 백본과 시공간 어텐션을 활용하여 기하학적 추정, 탐지, 점유, 재구성을 동시에 수행하는 Foundation4D 모델을 제안합니다. 제안된 모델은 데이터 주석 파이프라인과 함께 PAI-Foundation4D 벤치마크를 공개하여 성능을 검증했습니다. 실험 결과, Waymo, nuScenes, OpenOccupancy 등 주요 벤치마크에서 최첨단 성능을 달성하며 태스크 간 상호 이익을 입증했습니다. 최종적으로 예측된 기하 정보를 활용해 라이다 없이도 시뮬레이션용 장면 재구성이 가능함을 보여주었습니다.

AI 연구

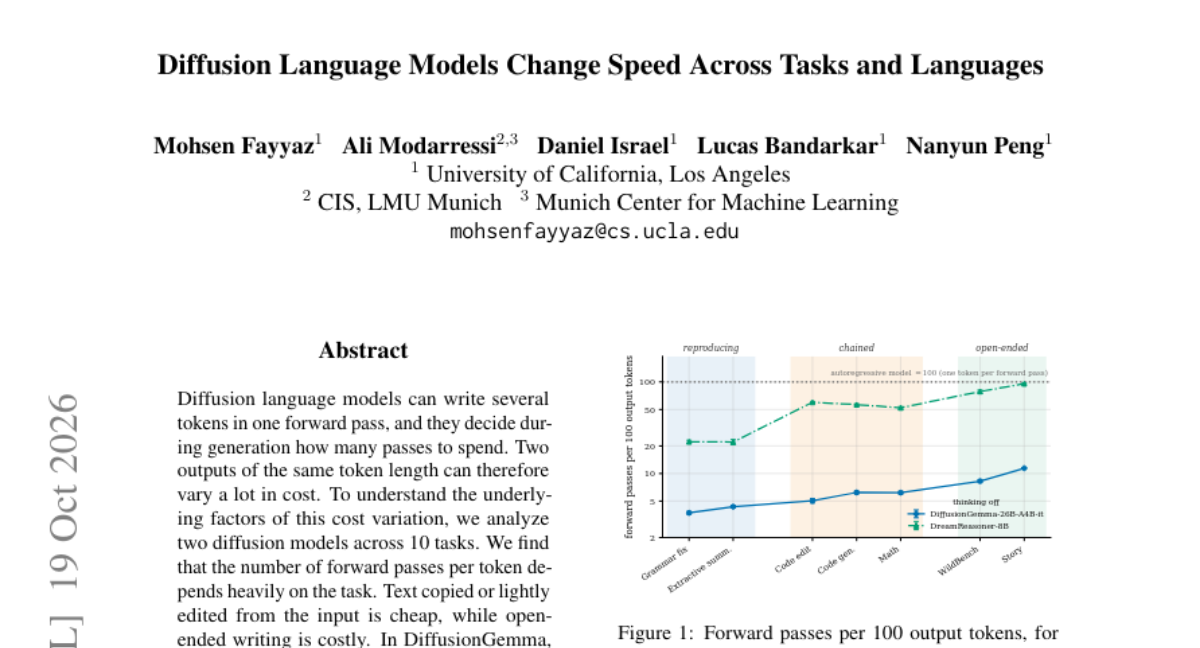
Diffusion Language Models Change Speed Across Tasks and Languages

디퓨전 언어 모델은 한 번의 포워드 패스로 여러 토큰을 생성할 수 있어 작업에 따라 비용 편차가 크게 발생합니다. 본 연구는 이러한 비용 변동의 근본 원인을 파악하기 위해 10가지 태스크를 대상으로 두 디퓨전 모델을 분석했습니다. 분석 결과, 입력 대비 새로운 정보의 양이 많을수록, 단어가 희귀할수록, 그리고 토큰화 효율이 낮은 언어일수록 더 많은 포워드 패스가 필요함을 발견했습니다. 또한, 정답을 맞히는 것보다 틀린 답을 생성할 때 더 많은 연산 비용이 소모되는 경향을 확인했습니다. 이러한 결과는 디퓨전 모델의 연산 이점이 출력의 결정론적 정도에 달려 있음을 보여주며, 디코딩 속도를 활용한 효율적인 추론 전략의 가능성을 제시합니다.

AI 연구

Who Takes the Lead? Model Ability and Task-Conditioned Collaboration with Humans

언어 모델 에이전트의 능력이 커지면서 인간과의 협업 방식이 단순한 의존을 넘어 효율적인 역할 분담의 문제로 진화하고 있습니다. 기존에는 인간의 개입 빈도만으로 협업의 성공 여부를 판단했으나, 이는 효율적인 분업과 협업 실패를 구분하기 어렵다는 문제가 있습니다. 본 연구는 에이전트와 인간이 공동 목표를 가진 '공유 제어 미로(shared-control maze)' 환경을 도입하여, 누가 우위를 점하느냐에 따른 협업 양상을 체계적으로 연구했습니다. 실험 결과, 단독 수행 능력이 뛰어난 모델일수록 상황에 따라 인간의 개입을 선택적으로 요청하는 전략적 행동을 보였습니다. 반면 성능이 낮은 모델은 상황에 관계없이 일관되지 않은 개입 패턴을 보였습니다.

AI 연구

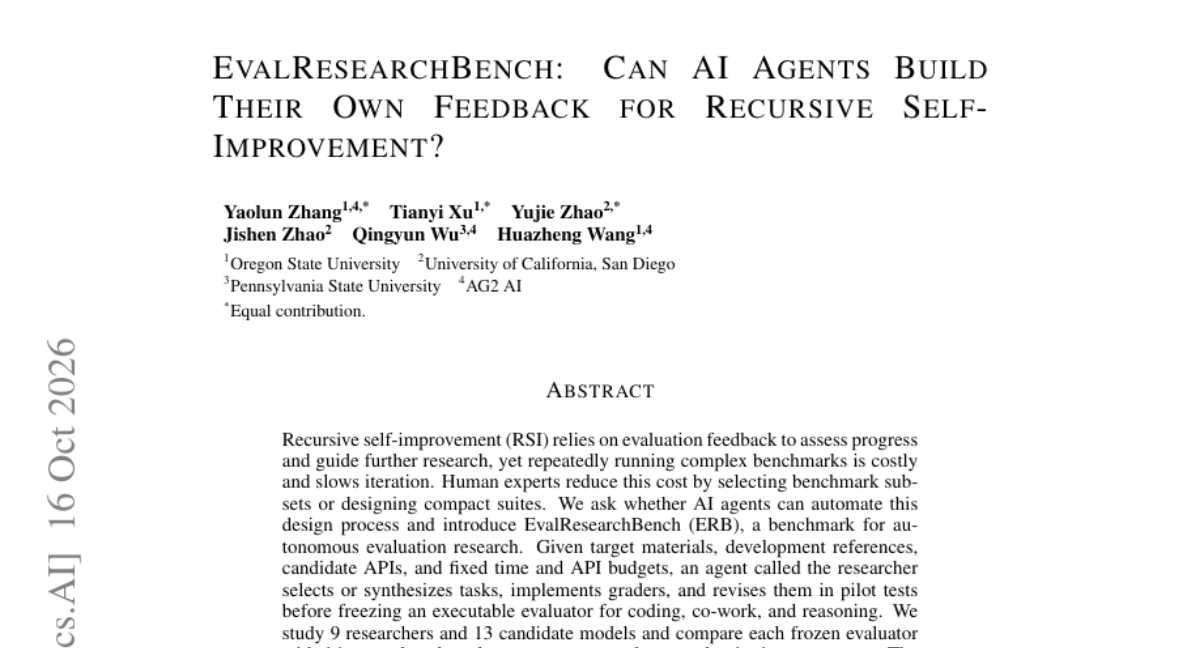
EvalResearchBench: Can AI Agents Build Their Own Feedback for Recursive Self-Improvement?

재귀적 자기 개선(RSI)을 위해서는 지속적인 평가 피드백이 필요하지만, 복잡한 벤치마크를 반복 실행하는 것은 비용과 시간이 많이 드는 문제입니다. 본 연구는 인간 전문가처럼 에이전트가 스스로 평가 과제를 설계하고 채점기를 구현하는 자동화 프로세스를 탐구하기 위해 EvalResearchBench(ERB)를 제안합니다. 에이전트인 'researcher'는 주어진 예산 내에서 과제를 선택/합성하고, 채점기를 구현 및 수정하여 최종 평가기를 고정하는 방식으로 작동합니다. 9개의 연구자 에이전트와 13개 모델을 대상으로 실험한 결과, 최적의 에이전트는 타겟 벤치마크의 순위와 유사한 결과를 도출했습니다. 하지만 에이전트가 생성한 평가기는 특정 질문에 점수가 편중되거나 예산을 소진하는 등의 한계를 보였습니다.
AI 연구

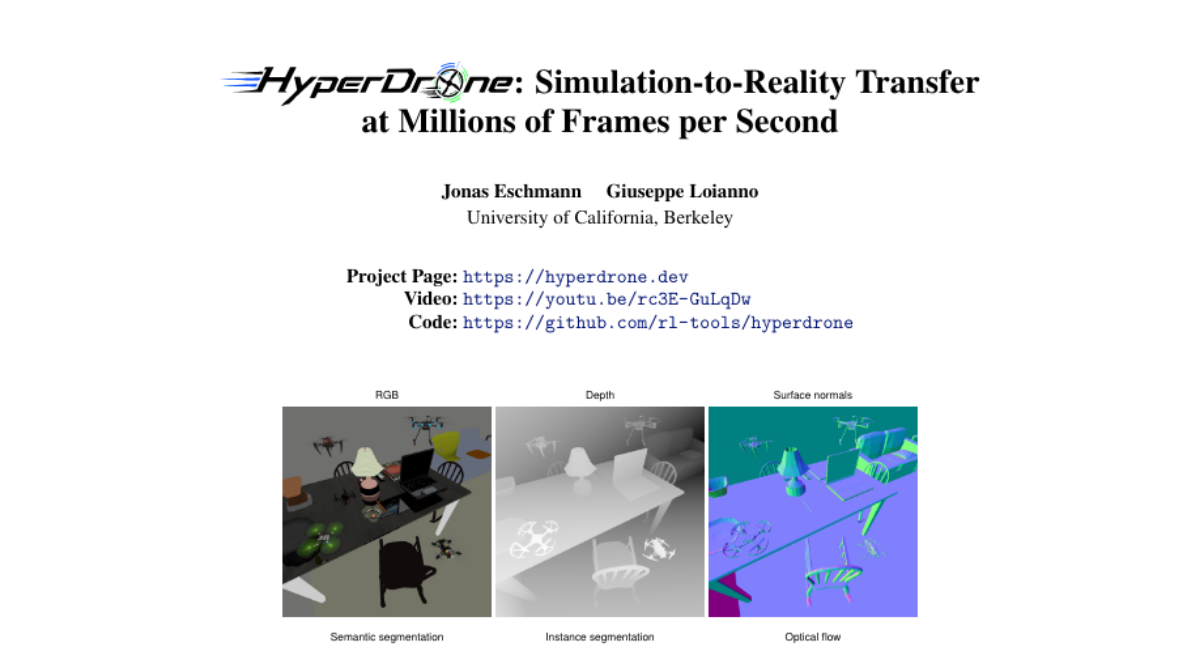
HyperDrone: Simulation-to-Reality Transfer at Millions of Frames per Second

기존의 배치형 드론 시뮬레이터는 학습 데이터 생성 속도 면에서 성능 한계가 있었습니다. 이를 해결하기 위해 최적화된 멀티로터 역학 엔진과 새로운 레이 트레이싱 엔진인 HyperLux를 결합한 HyperDrone을 제안합니다. HyperLux는 현대적인 GPU 하드웨어를 활용하여 RGB, 깊이, 세그멘테이션 등 다양한 관측 데이터를 초고속으로 렌더링합니다. 실험 결과, 소비자용 GPU에서도 수백만 FPS를 달성하며 높은 충실도의 3D 장면을 생성할 수 있음을 입증했습니다. 최종적으로 시뮬레이션에서 학습된 yaw-control 정책을 실제 Crazyflie 드론에 성공적으로 이식하여 Sim-to-Real 성능을 검증했습니다.

AI 연구

MambaAct: Efficient Mamba Action Experts for Flow-Matching Vision-Language-Action Models

로봇 조작을 위한 Vision-Language-Action(VLA) 모델은 강력한 성능을 보이지만, 반복적인 디노이징 과정이 필요한 Flow-matching 방식에서는 추론 비용이 매우 높다는 문제가 있습니다. 본 논문은 기존 Transformer 기반 액션 전문가를 효율적인 Mamba 기반 구조로 교체한 MambaAct를 제안합니다. MambaAct는 VLM의 시각-언어 프리픽스 인코더를 유지하면서, Mamba를 액션 믹서로 사용하여 연속적인 액션 시퀀스 간의 의존성을 모델링합니다. 또한, 반복적인 크로스 어텐션 없이도 컨디셔닝을 유지하기 위해 가벼운 Context Compressor를 도입하여 VLM 토큰을 압축된 신호로 변환합니다. 실험 결과, MambaAct는 액션 전문가 크기를 10배 줄이면서도 LIBERO 및 실세계 환경에서 디노이징 지연 시간을 대폭 단축하고 성공률을 유지하거나 향상시켰습니다.

AI 연구

SplatLab: Autonomous Scientific Discovery for 3DGS Research

기존의 3DGS 연구는 논문 재현에만 수주가 소요되어 새로운 아이디어 제안이 어렵고, 기존 자율 연구 시스템은 실행력과 추적성이 부족했습니다. SplatLab은 3상태(재현, 확장, 검증)를 아우르는 자율 연구 프레임워크를 제안합니다. 검증된 백본을 기반으로 플러그인을 변이시키고, Elo 토너먼트 방식과 스트레스 테스트를 결합하여 최적의 후보를 선별합니다. 모든 실험 결과는 로그된 학습 실행과 직접 연결되어 데이터의 신뢰성을 확보합니다. 실험 결과, SplatLab은 기존 타겟 논문의 성능을 상회하는 성과를 거두었으며 연구 주기를 수개월에서 수일로 단축했습니다.

AI 연구

TILDE: Teacher-in-the-Loop Distillation from Embodied Foundation Models

대규모 액션 사전 학습을 거친 Embodied Foundation Models(EFMs)는 강력한 조작 능력을 갖추고 있지만, 이를 재현하기에는 막대한 데이터와 연산 자원이 필요합니다. 본 논문은 이러한 능력을 액션 사전 학습이 없는 소형 정책 모델로 효율적으로 전이하기 위해 TILDE 프레임워크를 제안합니다. TILDE는 학생 모델이 유도한 상태에서의 온폴리시(on-policy) 증류와 교사 모델의 복구 궤적 학습을 결합합니다. 특히 자동화된 데이터 수집 파이프라인인 AutoDAgger를 통해 보상 모델이 작업 진행도를 모니터링하고 교사 개입을 트리거하여 인간의 개입 없이도 복구 경험을 수집합니다. 실험 결과, TILDE는 기존 행동 복제(BC) 대비 작업 성능을 대폭 향상시켰으며 효율적인 교차 아키텍처 증류를 지원함을 입증했습니다.

AI 연구

SEAM: Spectral Embedding Alignment and Merging for Low-Resource TTS

기존의 조건부 TTS 모델은 어휘 확장을 위해 대량의 쌍을 이룬 오디오 데이터와 미세 조정이 필요하여 저자원 환경에서 병목 현상이 발생합니다. 이를 해결하기 위해 본 논문은 SEAM이라는 제로 오디오 초기화 방법을 제안합니다. SEAM은 알려진 서브토큰으로부터 미지의 토큰 임베딩을 구성하며, 시계열적 음성 순서를 보존하는 스펙트럴 필터와 사전 학습된 매니폴드에 정렬하는 폐형 리지 회귀(closed-form ridge regression)를 사용합니다. 실험 결과, SEAM은 기존 방식 대비 최대 75% 적은 데이터로도 베이스라인에 근접하거나 일치하는 성능을 보였습니다. 이 방식은 저자원 음성 합성 분야에서 가볍고 재현 가능한 어휘 확장 솔루션을 제공합니다.

AI 연구

Skeleton-Grounded Latent Action Model for Robot World Models

로봇 월드 모델은 로봇의 행동에 따른 환경 변화를 시뮬레이션하는 데 사용됩니다. 기존의 잠재 액션 모델은 비디오를 통해 동작을 학습하지만, 로봇의 움직임과 환경 변화가 뒤섞여 제어와의 대응 관계를 파악하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 제안된 SkeLAM은 골격 정보를 기반으로 한 운동학적 성분과 잔여 시각 역학 성분으로 잠재 액션을 분해합니다. 교차 모달 스왑 재구성을 통해 골격과 RGB 정보 간의 상호 교환성을 확보하고, 가벼운 어댑터를 통해 로봇 액션을 운동학적 공간으로 매핑합니다. 실험 결과, DROID 데이터셋에서 기존 모델 대비 높은 정확도와 시각적 품질을 달셨으며, 제로샷 인간-로봇 동작 전송 성능을 입증했습니다.

AI 연구

TARSphere: A Robot-Oriented Full-Stack Framework for Long-Horizon Embodied Agents in Evolving Physical and Social Environments

기존의 Embodied Agent 시스템은 특정 목표 달성이나 추상적 기호 실행에 집중하여, 변화하는 물리적/사회적 환경에서의 평가에 한계가 있었습니다. 이를 해결하기 위해 물리 시뮬레이터와 NPC, 대화 제약이 포함된 TARSphere-Infra와 MLLM 기반의 계층적 실행 구조인 TARSphere-Harness를 제안합니다. 제안된 프레임워크는 이벤트 기반 FSM을 통해 과업 상태를 업데이트하며, MLLM이 관찰과 피드백을 바탕으로 의사결정을 수정할 수 있도록 설계되었습니다. 이를 바탕으로 구축된 TARSphere-Bench를 통해 8종의 MLLM을 평가한 결과, 범용 모델이 특정 임베디드 모델보다 우수할 수 있음을 확인했습니다. 다만, 인간과의 상호작용 및 과업 업데이트, 물리적 충돌 문제는 여전히 해결해야 할 과제로 남았습니다.

AI 연구

Bridging Exploration and Persona: Information-Directed Dueling for Test-Time Agent Personalization

LLM 에이전트가 적은 상호작용을 통해 사용자의 쿼리별 선호도를 파악하는 테스트 타임 개인화가 중요해지고 있습니다. 기존 방식은 거대한 페르소나 후보군 중에서 최적을 선택하는 데 어려움이 있습니다. 본 논문은 IDS(Information-Directed Sampling)에서 영감을 받은 ID-TAP 프레임워크를 제안합니다. 이 방식은 쿼리 조건부 신경 유틸리티 모델과 경량 Bradley-Terry 탐색기를 결합하여 대규모 페르소나 공간에서 효율적인 선택을 수행합니다. 실험 결과, 제한된 10회 비교 예산 내에서 기존 베이스라인 대비 가장 강력한 성능을 달성했습니다.

AI 연구

IF-MAP: Influence-Function-Inspired Agent Prioritization in Multi-Agent Systems

LLM 기반 멀티 에이전트 시스템에서 모든 에이전트를 개선하는 것은 비용이 매우 많이 드는 작업입니다. 기존의 실패 원인 분석 방식은 에이전트의 책임은 알려주지만, 해당 에이전트를 개선했을 때 얻을 수 있는 시스템 전체의 성능 향상 폭을 직접적으로 보여주지는 못합니다. 이를 해결하기 위해 본 논문은 영향력 함수(Influence Function) 개념에서 영감을 얻은 IF-MAP 방식을 제안합니다. IF-MAP는 모델 파라미터나 그래디언트 접근 없이도 프롬프트 섭동을 통해 에이전트별 잠재적 성능 향상 폭을 측정하는 블랙박스 방식입니다. 실험 결과, IF-MAP를 통해 선택된 에이전트의 프롬프트 최적화 및 모델 업그레이드는 무작위 선택 방식보다 훨씬 높은 성능 향상과 비용 절감 효과를 입증했습니다.
AI 연구

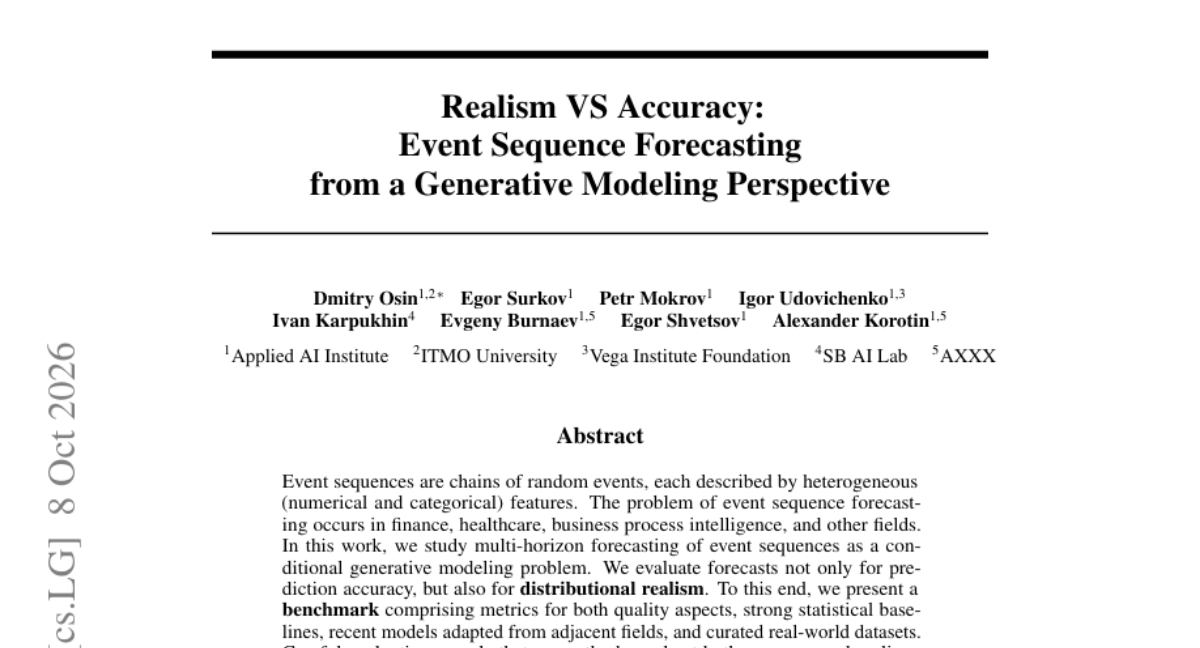
Realism VS Accuracy: Event Sequence Forecasting from a Generative Modeling Perspective

금융, 의료 등 다양한 분야에서 발생하는 이종 데이터 기반의 이벤트 시퀀스 예측은 중요한 과제입니다. 본 연구는 멀티 호라이즌 예측을 조건부 생성 모델링 문제로 정의하고, 예측 정확도와 분포적 현실감(Realism)을 동시에 평가합니다. 이를 위해 두 측면을 모두 검증할 수 있는 벤치마크와 데이터셋을 구축하였습니다. 실험 결과, 정확도와 현실감 사이에는 상충 관계(Trade-off)가 존재함을 확인했습니다. 마지막으로 현실감이 강한 확산 모델의 샘플을 결합하여 예측 정확도를 높이는 Wasserstein BaryBooster 알고리즘을 제안합니다.

30건

제품/서비스

이날 공개된 제품과 도구

제품/서비스

zCAD AI

자연어 명령으로 편집 가능한 정밀 파라메트릭 3D 모델을 생성하는 AI 설계 플랫폼

제품/서비스

myPip

AI를 통해 코딩 없이 게임 아이디어를 즉시 제작하고 수익화까지 연결하는 플랫폼

제품/서비스

1Password for Agents

비밀번호 노출 없이 AI 에이전트가 안전하게 로그인할 수 있게 돕는 보안 솔루션

제품/서비스

AgentValley

MacBook 노치에서 Claude Code 에이전트의 작업 현황을 실시간으로 모니터링하는 도구

제품/서비스

LinkIntel

X(트위터) 성과 데이터를 AI에게 직접 전달하여 최적의 포스트 초안을 만드는 분석 도구

나머지 25건 펼쳐보기

제품/서비스

Canva Craft

단순한 이미지를 넘어 편집 가능한 레이어와 레이아웃이 설계된 디자인 맞춤형 AI 모델

제품/서비스

Many Displays

맥(Mac)의 디스플레이 연결 해제 및 절전 모드 시 윈도우 배치를 자동으로 복구하는 자동화 도구

제품/서비스

Penta

90년대 CD 체인저의 감성을 iPhone에서 재현하는 레트로 음악 플레이어

제품/서비스

Byter

모든 네트워크별 데이터 사용량을 정밀하게 추적하고 관리하는 개인용 데이터 모니터링 도구

제품/서비스

Basedash Scheduled CSV Exports

자연어로 명령하면 매주 자동으로 최신 데이터를 CSV로 추출해 전달하는 자동화 도구

제품/서비스

sideOS.ai

맥북 노치에서 실행되는 강력한 로컬 AI 자동화 비서

제품/서비스

How It Went

GPS 경로와 사진/영상을 결합해 여행의 기록을 한 편의 단편 영화로 만들어주는 서비스

제품/서비스

Shedi

개발 도구와 패키지 매니저가 남긴 찌꺼기 파일을 안전하게 정리해주는 Mac 전용 클리너

제품/서비스

River Writer

개인정보 보호와 버전 관리에 특화된 Mac용 오픈소스 시나리오/소설 집필 앱

제품/서비스

Laylight

분산된 업무 도구를 하나로 연결하여 비즈니스 현황을 한눈에 파악하는 통합 워크플로우 솔루션

제품/서비스

Fluxix

AI 에이전트의 권한과 비용을 안전하게 제어하는 보안 레이어

제품/서비스

Surveys in Claude and ChatGPT

AI 채팅창 안에서 설문을 생성하고, 데이터 프라이버시는 완벽하게 보호받는 도구

제품/서비스

Kept

목표 달성에 집중할 수 있도록 설계된 AI 기반 통합 플래너

제품/서비스

CombienVautMonLogement

개인정보 입력 없이 AI로 즉시 확인하는 프랑스 부동산 시세 조회 서비스

제품/서비스

gethome

개인용 허브와 AI를 결합하여 자연어로 스마트 홈 규칙을 만드는 혁신적인 자동화 솔루션

제품/서비스

CombienVautMonLogement

개인정보 입력 없이 AI로 즉시 확인하는 프랑스 부동산 시세 조회 서비스

제품/서비스

Daily Simmer

SNS 링크만으로 레시피를 자동 정리하고 식단 계획부터 쇼핑까지 돕는 AI 요리 비서

제품/서비스

Prompt Deck

여러 코딩 에이전트의 프롬프트, 메모리 파일, 채팅 기록을 한곳에서 관리하는 통합 관리 도구

제품/서비스

Looper

특정 비즈니스 지표 향상을 위해 매일 업무를 수행하는 오픈소스 AI 에이전트

제품/서비스

Proof

400개 이상의 검증된 사이트 데이터를 학습하여 최적의 웹사이트 구조를 설계하는 AI 디자인 도구

제품/서비스

Korture Now: Focus App Blocker

불필요한 앱 차단을 통해 오직 단 하나의 목표에만 집중하게 돕는 미니멀리즘 포커스 앱

제품/서비스

Calendar Assistant

채팅, 음성, 사진 촬영만으로 복잡한 일정 입력을 대신하는 AI 캘린더 비서

제품/서비스

Spilr

나의 기록을 분석해 자기 객관화를 돕는 AI 저널링 서비스

제품/서비스

Insta360 Mic

커스텀 E-Ink 디자인과 전문가급 32비트 플로트 오디오를 결합한 무선 마이크

제품/서비스

MindChess

매일 짧은 훈련으로 체스 실력을 키우는 개인 맞춤형 체스 트레이닝 도구

6건

모델/벤치마크

새 모델과 주요 평가 결과

HF Model Trending

MiniMaxAI/MiniMax-M3.1-Flash

MiniMaxAI에서 출시한 MiniMax-M3.1-Flash 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 이미지와 텍스트를 동시에 처리하는 멀티모달 기능을 제공합니다.

HF Model Trending

RecursiveSI/flint

RecursiveSI에서 공개한 flint 모델이 Hugging Face에서 주목받고 있습니다. 약 40B 파라미터 규모의 text-generation 모델로, 최근 다운로드 수가 증가하며 트렌드에 진입했습니다.

HF Model Trending

XHToken/Spark-X2.6-4B

XHToken에서 공개한 Spark-X2.6-4B 모델이 Hugging Face에서 주목받고 있습니다. 약 4.1B 파라미터를 가진 이 모델은 text-generation 태스크를 위한 모델입니다.

LiveCodeBench

LiveCodeBench top model: O4-Mini (High)

LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Pro-06-05

LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

나머지 1건 펼쳐보기

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Flash-04-17

LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.