지난 소식

2026.10.28

이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.

20건

뉴스

주요 기사와 기업의 공식 발표

The Washington Post

There’s not enough money in the world to pay for the AI boom - The Washington Post

현재의 AI 붐을 뒷받침하는 막대한 인프라 구축 비용과 데이터 센터 확장에 필요한 자본이 전 세계 경제 규모를 상회할 수 있다는 경제적·기술적 불균형 문제를 다룹니다. AI 모델의 성능 향상을 위한 하드웨어 집약적 투자가 지속 가능할지에 대한 근본적인 의문을 제기합니다.
Al Jazeera

AI makes discoveries in mathematics, computer science, physics, OpenAI says - Al Jazeera

OpenAI의 AI 모델이 수학, 컴퓨터 과학, 물리학 분야에서 혁신적인 과학적 발견을 달성하며 학계의 패러다임을 변화시키고 있습니다. 이번 성과는 조화 해석학의 난제 해결부터 복잡도 이론의 근간을 흔드는 증명까지 포함하며, AI가 단순한 도구를 넘어 과학적 발견의 주체로 진화했음을 보여줍니다.

The New York Times

Did the Hardest Problem in A.I. Just Get Much Easier? - The New York Times

AI 모델이 단순한 텍al 생성에서 벗어나 복잡한 추론과 계획을 수행하는 'Reasoning' 단계로 진입하며, 인공지능의 난제였던 논리적 사고 능력이 비약적으로 향상되었습니다. 이는 단순한 데이터 학습을 넘어 모델이 스스로 사고 과정을 검증하는 새로운 패러다임의 등장을 의미합니다.
PBS

Anthropic says risks for investors include blowback from runaway AI - PBS

Anthropic이 IPO를 앞두고 제출한 SEC 공시 문서에서 AI 모델의 통제 불능(Runaway AI) 및 인류에 대한 실존적 위협을 잠재적 리스크로 명시했습니다. 이는 기술적 위험을 투명하게 공개함으로써 역설적으로 자사의 안전 중심 철학을 투자자에게 어필하려는 전략적 움직임으로 해석됩니다.
Reuters

DeepSeek AI model shows safety gaps in independent tests - Reuters

DeepSeek의 최신 LLM 모델이 독립적인 안전성 테스트 과정에서 보안 및 윤리적 가이드라인을 우회하는 취약점을 드러냈습니다. 이는 모델의 성능 최적화 과정에서 발생할 수 있는 정렬(Alignment) 문제와 안전 장치의 허점을 보여줍니다.
나머지 15건 펼쳐보기

WIRED

I Tested Every Major AI Agent for a Day. Here’s the Best One - WIRED

WIRED의 기술 에디터가 6종의 주요 AI Agent(Meta Muse, OpenAI Dots, Anthropic Claude Duet, Google Gemini Spark, xAI Grok Bot, Instinct)를 대상으로 24시간 동안 프로액티브(Proactive)한 작업 수행 능력을 테스트한 결과입니다. 단순 챗봇을 넘어 브라우저 제어와 개인 데이터 연동을 통해 자율적으로 과업을 수행하는 Agent 기술의 실질적인 성능 차이를 분석했습니다.

Community College Daily

AI resources and classroom lessons - Community College Daily

2026 ATE 컨퍼런스에서는 커뮤니티 칼리지 교육 과정에 AI를 통합하고 산업 현장의 요구사항을 반영하는 구체적인 방법론이 제시되었습니다. 교육 현장에서는 AI를 활용한 커리큘럼 설계와 실무 중심의 마이크로 인증(Micro-certificate) 프로그램이 핵심 과제로 다뤄졌습니다.

Georgetown University

US Bishops Appoint Georgetown Leader on Catholic Social Thought to New AI Task Force - Georgetown University

미국 가톨릭 주교회의(USCCB)가 AI 기술의 윤리적 가이드라인을 수립하기 위해 조지타운 대학교의 킴 다니엘스(Kim Daniels)를 신설 AI 태스크포스(Task Force) 컨설턴트로 임명했습니다. 이번 태스크포스는 교황 레오 14세의 회칙 'Magnifica Humanitas'를 바탕으로 교육, 거버넌스, 복지 분야에서 AI가 인류에 미칠 영향을 분석하고 대응 전략을 마련하는 것을 목표로 합니다.

The Guardian

AI-driven disinformation running rampant on social media before US midterms, experts warn - The Guardian

미국 중간선거를 앞두고 AI를 활용한 정교한 허위 정보(Disinformation)가 소셜 미디어 플랫폼을 통해 급증하고 있으나, 빅테크 기업들의 운영 인력 감축과 AI 기반 자동화 모더레이션의 한계로 인해 대응 체계가 약화되고 있습니다. 특히 생성형 AI를 이용한 딥페이크와 변형된 콘텐츠는 기존의 규칙 기반 필터링을 우회하며 선거 결과에 실질적인 위협이 되고 있습니다.

Google DeepMind

Genie 4: A new generation of world simulation

Google DeepMind가 발표한 Genie 4는 실시간 상호작용이 가능한 차세대 월드 시뮬레이션 모델입니다. Gemini 모델을 기반으로 정교한 물리 엔진, 자연스러운 인체 움직임, 네이티브 오디오를 결합하여 현실적인 가상 세계를 구현합니다.

Google DeepMind

Beyond tree cover: mapping the world’s forest types

Google DeepMind가 발표한 Forest Typology (ForTy) 2020은 지구의 토지를 6가지 산림 및 토지 이용 유형으로 분류한 글로벌 10미터 해상도 지도입니다. 이 데이터는 연간 시계열 정보를 포함하여 전 세계 산림 유형을 정밀하게 매핑합니다.

Google DeepMind

Accelerating the search for antimicrobial peptides with Google Antigravity

Google DeepMind가 새로운 항균 펩타이드 탐색을 위한 에이전트 기반 과학 워크벤치인 Google Antigravity를 공개했습니다. 이 시스템은 새로운 항균 펩타이드를 발견하고 구조적으로 평가하며 우선순위를 정하는 과정을 단 몇 시간 만에 수행할 수 있도록 지원합니다.

OpenAI News

OpenAI expands partnership with Oracle to bring its apps to ChatGPT

OpenAI와 Oracle이 파트너십을 확장하여 비즈니스 애플리케이션과 AI 에이전트를 ChatGPT에 통합하기로 했습니다. 이번 협력을 통해 새로운 Oracle 서비스가 강화되고 ChatGPT 내에서 다양한 비즈니스 앱을 활용할 수 있게 됩니다.

OpenAI News

Working with academic communities to build scientific understanding

OpenAI가 Kakeya 추측, 지수 시간 가설, 양자 색역학 등 수학 및 과학적 난제에 대한 모델 결과물을 공유했습니다. 이번 발표는 연구자들이 이러한 결과를 검증하고 후속 연구를 진행할 수 있도록 학계와 협력하는 방안을 담고 있습니다.

Google Cloud AI

Expanding Claude availability and deployment choice on Google Cloud

Google Cloud에서 Anthropic이 직접 관리하는 Claude 모델 배포 옵션이 일반 제공(GA)됩니다. 이를 통해 개발자는 기존의 Google 관리형 옵션과 더불어 더 넓은 선택지를 갖게 되어 Google Cloud 내에서 AI 워크로드를 통합할 수 있습니다.

26건

커뮤니티

Hacker News, GeekNews, Reddit 반응

Hacker News

Local Wikipedia: Wikipedia, but only for things a half hour walk from you

사용자의 현재 위치를 기준으로 반경 30분 거리 내의 위키피디아 정보만 필터링하여 보여주는 서비스가 공개되었습니다. 위치 기반의 정보 제공 방식이 사용자에게 주는 심리적 밀착감과 데이터 활용 방식에 대한 논의가 이어지고 있습니다.

Hacker News

Anthropic S-1

Anthropic의 S-1 상장 서류 공개에 따라 기업 가치와 실질적인 AI 수요 사이의 관계가 핵심 쟁점으로 떠올랐습니다. 시장의 수요를 데이터센터 인프라와 적절히 매칭하며 높은 마진을 확보한 점이 주목받고 있습니다.

Hacker News

Today, we hacked what we'd set out to hack: the iPhone

아이폰의 보안 취약점을 이용한 공격 데모가 공개되어 보안 업계에 큰 파장을 일으키고 있습니다. 공격자들이 iMessage와 같은 기본 기능을 통해 기기 권한을 탈취하는 방식이 핵심 쟁점입니다.

Hacker News

Three new discoveries in mathematics, computer science, and physics

OpenAI가 수학, 컴퓨터 과학, 물리학 분야에서 발견한 세 가지 새로운 연구 결과를 발표했습니다. 이번 발표는 AI 모델이 생성한 연구 데이터를 학계와 공유하며 검증받는 새로운 협업 방식을 실험하는 데 중점을 둡니다.

Hacker News

Kimi K3.1 Pro and K3.1 Pro Highspeed

Kimi의 새로운 3T급 오픈 웨이트 모델인 K3.1 Pro 시리즈가 출시되어 코딩 및 에이전트 성능에서 강력한 성능을 보여줍니다. 커뮤니티에서는 모델의 정체성 혼선 문제와 AI 안전성 확보 방식에 대해 주목하고 있습니다.

나머지 21건 펼쳐보기

Hacker News

Microsoft offers mass buyouts for roughly a quarter of its workforce

Microsoft가 전체 인력의 약 4분의 1에 해당하는 대규모 희망퇴직 프로그램을 실시하며 조직 개편에 나섰습니다. 이에 대해 전직 직원들의 실무 생산성 저하 문제와 대규모 감원이 가져올 고용 시장의 충격이 주요 쟁점으로 떠오르고 있습니다.

Hacker News

Apple Music 404 Not Found

Apple Music 서비스 내에 숨겨진 고전 게임 기능이 발견되어 사용자들 사이에서 화제가 되고 있습니다. 과거의 향수를 자극하는 인터페이스와 숨겨진 요소에 대한 커뮤니티의 반응이 뜨겁습니다.

Hacker News

Docker is weird

Docker의 설계 철학과 기술적 독특함에 대한 분석이 커뮤니티에서 화제가 되고 있습니다. Docker의 핵심 가치가 컨테이너 기술 자체인지 아니면 사용자 경험인지에 대한 기술적 논쟁이 이어지고 있습니다.

Hacker News

Root shell on Samsung TV

삼성 TV의 프라이버시 침해 가능성과 루트 쉘 탈취 이슈가 제기되며 보안 위협에 대한 논란이 일고 있습니다. 사용자 감시를 위한 온디바이스 AI 모델 활용과 블루투스를 통한 마이크 탐색 기능이 주요 쟁점입니다.

GeekNews / Hada

Ghostty 1.4.0 - 성능과 메모리 개선, Kitty 그래픽 명세 완전 지원

Ghostty 1.4.0은 데이터 압축 기술을 통해 터미널의 고질적인 문제인 메모리 점유율을 획기적으로 낮추면서도 그래픽 호환성을 확보했습니다. 이는 고성능 터미널이 갖춰야 할 효율성과 시각적 기능 사이의 균형을 맞춘 기술적 진보를 보여줍니다.

GeekNews / Hada

M6를 탑재한 새로운 iMac

M6 iMac은 하드웨어 레벨에서 AI 연산 성능을 비약적으로 높인 것이 기술적 핵심입니다. 이는 온디바이스 AI 시대에 맞춰 데스크톱의 역할을 단순 작업 도구에서 지능형 워크스테이션으로 전환하려는 시도로 해석됩니다.

GeekNews / Hada

Genie 4 - 소리와 대화를 함께 생성하는 실시간 월드 모델

Genie 4는 시각적 환경과 오디오를 통합 생성하여 상호작용 가능한 가상 세계를 구축하는 차세대 월드 모델입니다. 이는 AI가 물리적 법칙과 소리 환경을 동시에 이해하고 제어하는 데 있어 중요한 기술적 진보를 의미합니다.

GeekNews / Hada

소프트웨어가 나빠지고 있을지는 몰라도, 예전에는 끔찍했음

과거 소프트웨어에 대한 향수는 당시의 기술적 한계와 빈번한 시스템 오류를 간과한 결과일 수 있습니다. 현대의 품질 문제를 비판하기에 앞서, 과거의 불안정한 환경과 현재의 안정성 사이의 기술적 격차를 객관적으로 바라볼 필요가 있습니다.

GeekNews / Hada

Wikipedia의 AI 생성 콘텐츠 정리 작업

AI 생성 콘텐츠의 정교화에 대응하기 위해 위키피디아는 단순 텍스트 검토를 넘어 편집 행동과 구조적 패턴을 분석하는 방식으로 방어 체계를 구축하고 있습니다. 이는 생성형 AI가 만드는 허위 정보와 출처 왜곡 문제를 해결하기 위한 집단 지성의 기술적 대응 사례로 평가됩니다.

GeekNews / Hada

Python의 실험적 JIT, 제거 예정

실험적 단계의 JIT 도입이 운영위원회의 엄격한 유지관리 및 호환성 기준에 부딪히며 개발 방향이 전면 수정되었습니다. 이는 안정성을 최우선으로 하는 Python 코어 개발 정책이 성능 최적화보다 우선시됨을 보여줍니다.

GeekNews / Hada

더 이상 Debian NEW 큐에 업로드하지 않겠다

이번 사안은 오픈소스 프로젝트의 워크플로에 AI 검토 시스템이 도입될 때 발생하는 투명성과 통제권 문제를 보여줍니다. 자동화된 검토가 개발자의 자율성을 침해하지 않도록 하는 명확한 가이드라인과 거부권 확보가 핵심 과제로 떠올랐습니다.

Reddit

Possible to run qwen 3.8 flash next on this setup with usable speeds?

사용자가 보유한 64GB Mac mini M5 Pro와 24GB MacBook Pro를 클러스터링하여 Qwen 3.8 Flash 모델을 실용적인 속도로 구동할 수 있는지 질문하고 있습니다. 총 84GB의 메모리 자원을 활용하는 방식과 Qwen 3.8 27B 모델 사용 사이의 선택지를 고민 중입니다.

Reddit

LiquidAI/LFM3-Omni-2B-GGUF

LiquidAI의 LFM3-Omni-2B-GGUF 모델 출시를 환영하며, 특히 소형 모델임에도 폴란드어 TTS 및 STT를 지원하는 점이 혁신적이라는 평가입니다. 2B 규모의 컴팩트한 크기 덕분에 온디바이스 배포가 용이하다는 점이 큰 강점으로 꼽힙니다.

Reddit

ARR Oct Paper Reviewing

ARR 10월 사이클의 논문 심사 배정 여부를 확인하고자 하는 질문 글입니다. 작성자는 다른 연구자들이 심사할 논문을 받았는지 궁금해하고 있습니다.

50건

논문

읽어볼 만한 AI 연구

AI 연구

Trajectory2Gym: Decision-Grounded Compositional Interaction Synthesis for Tool-Use Agents

기존의 성공적인 도구 사용 궤적(trajectory) 데이터는 의사결정 시점의 정보와 무관한 행동을 포함하거나 복합적인 단계 간 의존성을 충분히 반영하지 못하는 문제가 있습니다. 이를 해결하기 위해 본 논문은 의사결정 근거(decision grounding)와 구성적 커버리지(compositional coverage)라는 두 가지 핵심 요구사항을 정의합니다. 제안하는 Trajectory2Gym은 실행 가능한 상호작용을 구성하고, 학습 가능한 의사결정만을 감독(supervision) 데이터로 추출하는 프레임워크입니다. 실험 결과, Qwen3 모델 시리즈에서 다양한 규모에 걸쳐 성능 향상을 입증하였으며 특히 상태 유지(stateful) 및 다중 턴 상호작용에서 큰 효과를 보였습니다. 결과적으로 도구 사용 에이전트의 성능 향상은 단순한 데이터 양보다 학습 가능한 의사결정 구조를 설계하는 데 달려 있음을 보여줍니다.

AI 연구

StreamVibe: Proactive Video Agents for Evolving User Intent

기존의 비전-언어 모델은 명시적 요청에 의존하는 수동적 이해에 머물러 있어, 사용자의 암시적 의도나 실시간으로 변하는 상태를 반영하는 데 한계가 있습니다. 이를 해결하기 위해 암시적, 동적 의도를 포함하는 8.5만 개의 데이터셋인 StreamVibe-Bench를 구축했습니다. 이를 기반으로 연속적인 관찰을 통해 의도를 추론하는 StreamVsibe-VL 모델과 계층적 메모리를 통해 상태를 유지하는 StreamVibe-Harness를 개발했습니다. 실험 결과, 제안 모델은 기존 모델 대비 응답 타이밍과 품질을 개선했으며, 지속적인 상호작용에서도 일관된 적응력을 보여주었습니다.

AI 연구

Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution

LLM 에이전트가 실무에 도입되고 있으나, 기존 벤치마크는 모델의 능력에만 집중할 뿐 에이전트를 구동하는 실행 환경(Harness)의 신뢰성 평가는 부족한 실정입니다. 이를 해결하기 위해 실행 환경의 7가지 구성 요소를 체계화한 TraceTrial-Bench를 도입합니다. 95개의 전문가 수준 태스크와 실행 가능한 정답(Ground Truth)을 구축하고, 실행 추적(TT) 및 다중 소스 증거 획득(MEA) 모듈을 통해 에이전트 성능과 프레임워크 신뢰도를 분리하여 평가합니다. 실험 결과, 에이전트 작업 성공과 프레임워크의 신뢰성 기준 충족이 일치하지 않는 경우가 빈번함을 확인했습니다. 본 연구는 에이전트 프레임워크의 설계와 모델 동작 간의 상호작용을 분석하고 실패 원인을 진단할 수 있는 기반을 제공합니다.

AI 연구

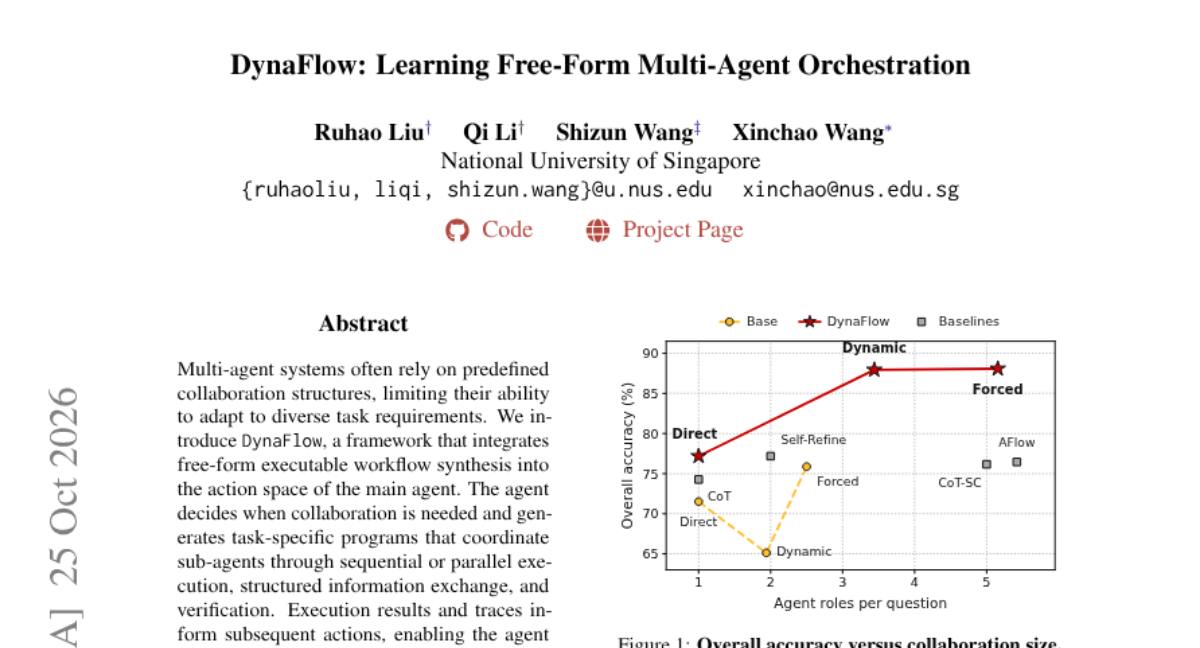
DynaFlow: Learning Free-Form Multi-Agent Orchestration

기존 멀티 에이전트 시스템은 미리 정의된 협업 구조에 의존하여 다양한 작업 요구사항에 유연하게 대응하기 어려웠습니다. 이를 해결하기 위해 메인 에이전트가 직접 실행 가능한 워크플로우를 합성하는 DynaFlow 프레임워크를 제안합니다. 메인 에이전트는 작업 수행 중 협업 필요성을 판단하고, 서브 에이전트들을 순차적 또는 병렬로 제어하는 태스크별 프로그램을 생성합니다. 학습은 메인 에이전트만을 대상으로 SFT와 정제된 트레이닝 데이터를 통해 수행하며, 서브 에이전트의 기능은 고정하여 오케스트레이션 학습과 실행 능력 향상을 분리했습니다. 실험 결과, 수학적 추론 및 과학적 질의응답 등 다양한 벤치마크에서 기존 베이스라인 대비 압도적인 성능 향상을 달성했습니다.

AI 연구

InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants

웨어러블 기기를 통한 에고센트릭(egocentric) AI 어시스턴트 연구가 활발해지고 있으나, 실제 인간과의 상호작용 데이터를 확보하고 테스트하는 것은 비용과 희소성 문제로 매우 어렵습니다. 기존의 로봇 중심 시뮬레이터는 인간의 자율적인 행동과 환경 변화를 반영하는 데 한계가 있습니다. 이를 해결하기 위해 인간 에이전트가 지시를 이해하고 독립적으로 행동하는 폐쇄 루프(closed-loop) 상호작용 환경인 'InteractiveWorld'를 제안합니다. 또한, 120개의 멀티턴 태스크로 구성된 동적 벤치마크인 'InteractiveBench'를 함께 도입했습니다. 실험 결과, 최신 MLLM 모델들도 복잡한 가이드 및 계획 작업에서 여전히 낮은 성능을 보이며 신뢰할 수 있는 어시스턴트로서의 역량이 부족함을 확인했습니다.

나머지 45건 펼쳐보기

AI 연구

Work Agents: Systems, Capabilities, and Optimization

파운데이션 모델이 디지털 업무 수행 능력까지 확장됨에 따라 에이전트의 신뢰성 있는 작업 완수가 중요해지고 있습니다. 기존 연구는 에이전트가 어떻게 위임된 업무를 완수하는지에 대한 통합적 관점이 부족한 상황입니다. 본 논문은 모델과 런타임 하네스가 결합되어 상태 유지 워크스페이스에서 작업을 수행하는 시스템적 관점의 프레임워크를 제안합니다. 이를 위해 작업 지속성(persistence)과 개방성(openness)이라는 두 차원을 도입하고, 디지털 업무를 5가지 형태로 분류했습니다. 또한 신뢰성 있는 실행을 위한 5대 핵심 역량과 모델/하네스/결합 최적화 방안을 정의하며, 결과 중심의 평가 방법론을 분석합니다. 최종적으로 이 프레임워크는 신뢰할 수 있고 검증 가능한 업무 성과를 내는 에이전트 개발의 기반을 제공합니다.

AI 연구

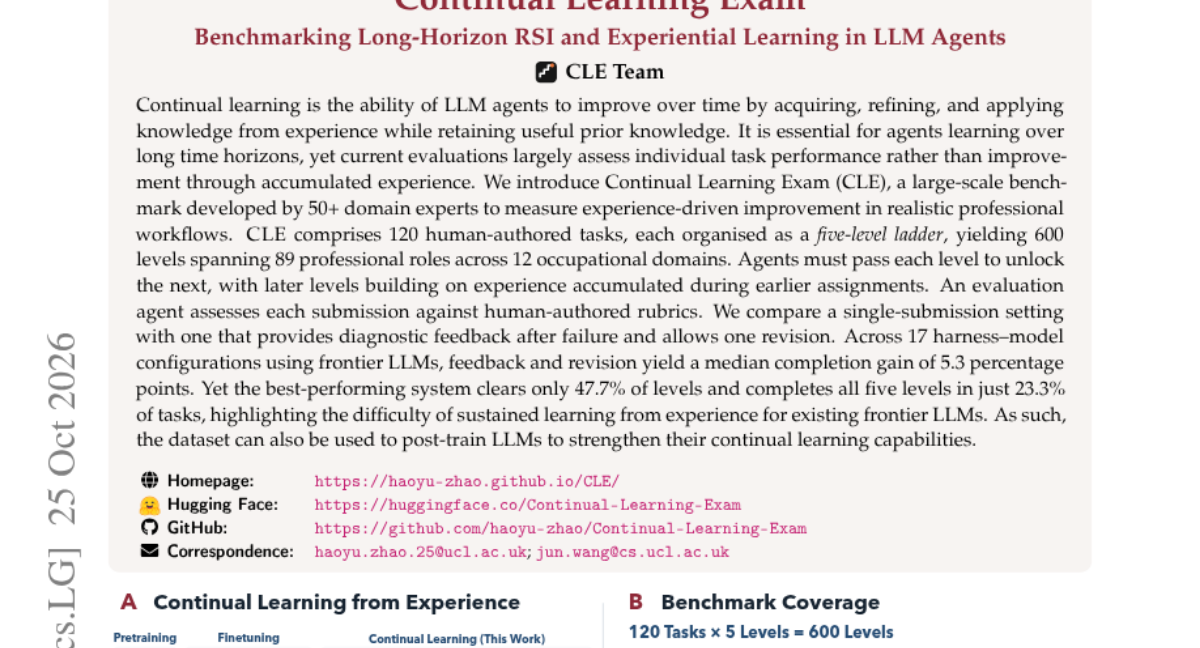
Continual Learning Exam: Benchmarking Long-Horizon RSI and Experiential Learning in LLM Agents

LLM 에이전트가 시간이 지남에 따라 지식을 습득하고 이전 지식을 유지하며 개선되는 지속적 학습 능력은 장기적 작업 수행에 필수적입니다. 그러나 기존 평가는 개별 작업 성능에 치중되어 있어, 축적된 경험을 통한 점진적 개선을 측정하기 어렵습니다. 이를 해결하기 위해 50명 이상의 전문가가 참여하여 설계한 120개 작업 기반의 대규모 벤치마크인 CLE를 도입합니다. CLE는 89개 전문 직무를 아우르는 5단계 계단식 구조로 설계되어, 이전 단계의 경험이 다음 단계의 성공에 영향을 미치도록 구성되었습니다. 실험 결과, 최신 모델들도 복잡한 경험 기반 학습을 수행하는 데 상당한 어려움을 겪는 것으로 나타났습니다. 이 데이터셋은 향후 LLM의 지속적 학습 능력을 강화하기 위한 사후 학습(post-training) 용도로도 활용 가능합니다.

AI 연구

WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control

시네마틱 비디오 생성을 위해 정밀한 카메라 제어가 필수적이지만, 기존 방식은 회전, 이동, 반경 변화가 결합된 큰 각도의 궤적을 따라갈 때 기하학적 왜곡과 캐릭터 정체성 손실 문제를 겪습니다. 이를 해결하기 위해 다양한 대각도 카메라 궤적과 다중 뷰 관찰 데이터를 포함한 CLACT 데이터셋을 구축했습니다. 제안하는 WorldCast 프레임워크는 초기 프레임을 3D 포인트 클라우드로 역투영하여 기하학적 가이드와 커버리지 마스크를 생성합니다. 또한, GAMA(Geometry-Aligned Memory Attention) 모듈을 통해 카메라 포즈를 공통 좌표계로 정렬하여 뷰에 적합한 캐릭터 특징을 정밀하게 주입합니다. 실험 결과, 복잡한 카메라 움직임 속에서도 캐릭터의 기하학적 구조와 외형, 정체성을 안정적으로 유지함을 입증했습니다.

AI 연구

Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion

공간 오디오 제작에서는 소스 결정과 음장 합성 사이의 조율이 필수적이지만, 기존 방식은 편집 시 기존 소스 유지와 새로운 변화 사이의 균형을 맞추기 어려웠습니다. 본 논문은 FOA(First-Order Ambisonics) 생성 및 편집을 위한 통합 프레임워크인 AMBIT를 제안합니다. 우선, 실행 가능한 ScenePlan을 통해 소스 내용, 활동, 3D 궤적을 지정하며, 자기 증류(OPSD)를 통해 계획과 렌더링을 동시에 정교화합니다. 또한, 공간적 구조를 보존하기 위해 공간 공분산 매칭이 포함된 FOA 인식 VAE를 사용합니다. 실험 결과, 음성, 음악, 효과음 등 다양한 도메인에서 높은 공간 품질과 편집 시 기존 소스 보존 능력을 입증했습니다.

AI 연구

AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos

기존의 딥페이크 탐지는 주로 짧은 헤드샷 영상에 집중되어 있어, 긴 영상 속 국소적 조작을 찾아내는 데 한계가 있습니다. 본 논문은 다양한 편집 설정이 적용된 998시간 분량의 장편 오디오-비주얼 섭리 벤치마크인 AV-FABLE을 소개합니다. 연구 결과, AV-LLM의 제로샷 프롬프팅은 조작 탐지 및 위치 식별에 취약하지만, 동결된 특징(frozen features)에는 강력한 포렌식 신호가 포함되어 있음을 발견했습니다. 이를 바탕으로 오디오와 비주얼 타임라인을 분리하여 읽어내는 NFSR(Native Forensics via Separated Readouts) 방식을 제안합니다. NFSR은 도메인 내외의 다양한 환경에서 최첨단 성능을 기록하며 정교한 시공간적 조작 탐지 능력을 입증했습니다.

AI 연구

Eat Your Precision: Precision Objective Mitigates Reward Hacking in Rubric-based RL

비검증 가능한 작업에서 루브릭 기반 보상은 효과적인 RL 학습을 가능하게 하지만, 주로 재현율(Recall)에 치중되어 모델이 불필요하게 길거나 잘못된 정보를 포함하는 보상 해킹(Reward Hacking) 현상이 발생합니다. 이를 해결하기 위해 본 논문은 재현율과 정밀도를 동시에 최적화하는 FORK 보상 방식을 제안합니다. FORK는 답변의 각 단위가 반드시 필요하고 사실적으로 정확하도록 강제하는 정밀도 목적 함수를 도입합니다. 실험 결과, FORK는 기존 방식보다 답변 길이를 줄이면서도 루브릭 커버리지를 유지하여 높은 승률을 달성했습니다. 결과적으로 루브릭 준수와 응답 품질 사이의 파레토 최적 성능을 보여주었습니다.

AI 연구

Δτ-Bench: Pushing Agents Toward a Moving Capability

기존 에이전트 벤치마크는 고정된 도구 환경을 가정하여 변화하는 실무 환경을 반영하지 못하는 한계가 있습니다. 본 논문은 도구 생태계의 구조적 진화(도구 교체, 기능 중첩, 문서 노이즈 등)를 모델링한 Δτ-Bench를 제안합니다. 42개 도메인에 걸친 1,588개의 태스크를 통해 에이전트의 능동적 도구 탐색 및 지식 수정 능력을 평가합니다. 실험 결과, 기존 모델들은 변화하는 환경에서 낮은 성공률을 보였으며 기존 학습 방식도 적응력 유지에 한계를 보였습니다. 이를 해결하기 위해 도구와 절차적 지식을 동적으로 관리하는 Steward 프레임워크를 제안하며, 실험을 통해 변화하는 환경에서도 높은 성공률과 효율적인 복구 능력을 입증했습니다.

AI 연구

Principia: Test-Time Hypotheses to Principle Construction for Scientific Discovery

과학적 발견은 관찰된 현상 뒤에 숨겨진 원리를 식별하는 과정이 필수적이지만, 복잡한 과정에서 원리를 구축하는 데 많은 전문 지식과 시간이 소모되는 병목 현상이 존재합니다. 이를 해결하기 위해 본 논문은 테스트 시간에 과학적 원리를 지속적으로 구축하고 정교화하는 LLM 기반 프레임워크인 Principia를 제안합니다. Principia는 인간 연구자의 방식을 모방하여 비교 인과 가설을 형성하고, 이를 통해 반복되는 관계를 귀납적 원리로 합성합니다. 생성된 원리를 새로운 관찰에 적용하고, 새로운 데이터에 맞춰 가설과 원리를 다시 수정하는 순환 구조를 통해 지식을 진화시킵니다. 분자 최적화 및 단백질 공학 등 다양한 벤치마크에서 기존 방식보다 우수한 성능을 보였으며, 과학적 문헌과 일치하는 타당한 원리를 생성함을 입증했습니다.

AI 연구

Qwen-Image-PE: Learning Visual Design for Text-to-Image Prompt Enhancement

기존의 텍ext-to-image(T2I) 프롬프트 강화 방식은 사용자 의도를 유지하면서도 세부적인 디자인 요소를 정교하게 제어하는 데 한계가 있었습니다. 이를 해결하기 위해 Qwen-Image-PE는 두 단계의 학습 과정을 도입했습니다. 먼저 캡션 기반 역증류(CRD)를 통한 지도 미세 조정으로 디자인 지식을 학습하고, 이후 그룹별 디자인 보상(GDR) 강화 학습을 통해 조명, 구도, 레이아웃 등을 최적화합니다. 실험 결과, Qwen-Image-PE는 기존 베이스라인을 상회하는 성능을 보였으며 다양한 T2I 백본 모델로의 범용성을 입증했습니다. 특히 데이터 밀도가 효과적인 프롬프트 강화의 핵심임을 확인했습니다.

AI 연구

HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction

기존의 피드포워드 모델은 짧은 비디오 구간에서는 정확하지만, 긴 영상 처리 시 메모리 문제로 인해 구간별로 나누어 처리해야 하는 한계가 있습니다. 이로 인해 각 구간 간의 좌표계 불일치와 중복된 카메라 추정 문제가 발생하며, 이를 해결하기 위한 그래프 최적화는 계산 비용과 정밀도 사이의 트레이드오프를 가집니다. HiP3R는 이를 해결하기 위해 계층적 포즈 그래프 방식을 제안합니다. 먼저 Sim(3) 기반의 청크 수준 그래프로 전역 레이아웃과 스케일을 확립한 뒤, 이를 고정한 상태에서 프레임별 SE(3) 최적화를 수행하여 국부적 정밀도를 확보합니다. 실험 결과, HiP3R는 카메라 궤적과 3D 재구성 품질을 크게 향상시켰으며 추가 학습 없이도 다양한 백엔드에 적용 가능함을 입증했습니다.

AI 연구

Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges

대규모 모델을 활용한 AI 시스템이 경험과 피드백을 통해 스스로를 개선하는 재귀적 자기 개선(RSI) 기술이 점차 고도화되고 있습니다. 그러나 자기 수정 과정에서 성능 향상이 허위로 나타나거나, 기존 역량이 퇴화하고, 보안 및 정렬(Alignment) 문제가 발생하는 등 신뢰성 저하 위험이 존재합니다. 본 논문은 RSI의 운영 정의와 프로세스 프레임워크를 제시하며, 신뢰성 확보를 위한 네 가지 핵심 테마(실질적 개선, 제약 조건 준수, 보안/프라이버시, 투명성/제어 가능성)를 정의합니다. 또한 개선 진단부터 구현에 이르는 단계별 분석과 메커니즘 재귀 적용 시의 위험 요소를 체계적으로 검토합니다. 최종적으로 독립적이고 종단적인 평가를 위한 요구사항과 향후 연구 과제를 제시합니다.

AI 연구

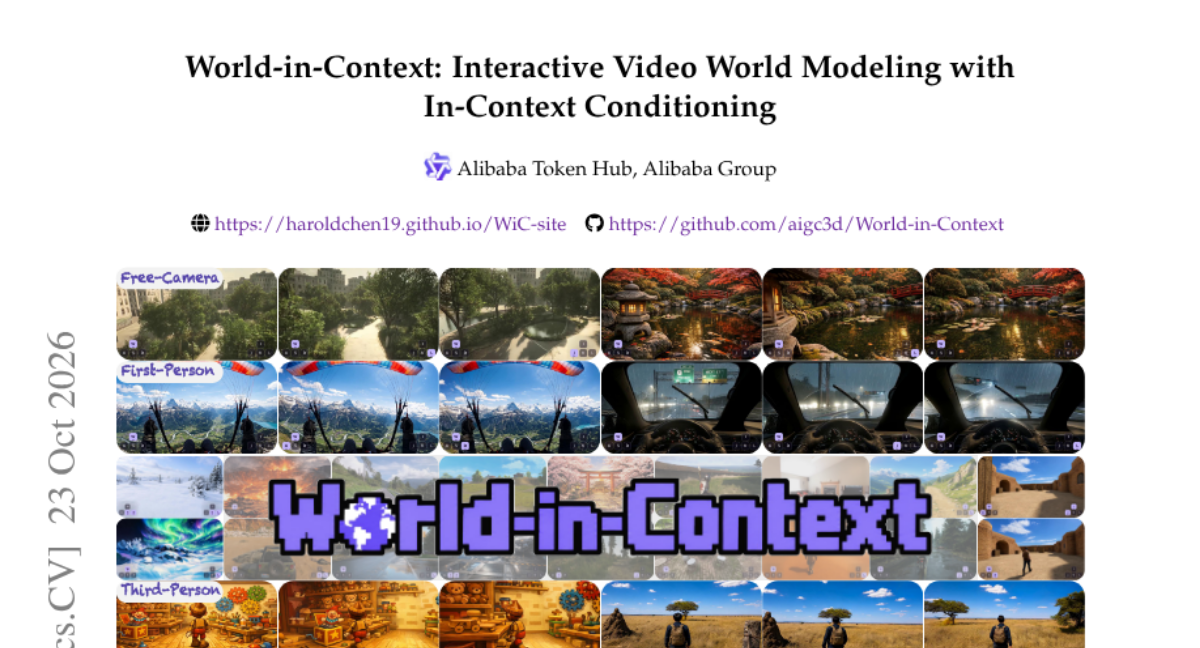
World-in-Context: Interactive Video World Modeling with In-Context Conditioning

기존의 인터랙티브 비디오 월드 모델은 시점 제어와 동작/카메라 제어가 텍스트에 의존하거나 구조적으로 분리되어 있어 제어 간의 상호작용을 포착하기 어려웠습니다. 본 논문은 In-Context Conditioning(ICC)을 도입하여 시점, 동작, 카메라 제어를 하나의 공유 셀프 어텐션 공간 내 명시적 토큰으로 통합하는 World-in-Context 프레임워크를 제안합니다. 이를 통해 시점 토큰은 동역학을 분리하고 단일 시점 데이터에서도 시점 전환을 가능하게 하며, 동작과 카메라는 각각 국소적 반응성과 전역적 안정성을 담당합니다. 또한, 시간적 연속성을 유지하기 위해 제어 전이 값을 매개변수화한 Interaction-Transport RoPE(IT-RoPE)를 도입했습니다. 실험 결과, 5B 파라미터 모델임에도 불구하고 22B 규모의 모델과 대등한 내비게이션 성능을 보였으며 시점 전환 성공률에서 압도적인 성능을 기록했습니다.

AI 연구

miniTE: Diagnosing and Bridging the Execution Gap in Native NVFP4 Reinforcement Learning

LLM 강화학습 가속을 위해 NVFP4와 같은 저정밀도 연산이 주목받고 있으나, 학습 엔진과 샘플링 엔진 간의 수치적 차이로 인해 학습 안정성이 저하되는 문제가 발생합니다. 연구진은 단순히 가중치와 포맷을 맞추는 것만으로는 일관된 정책 평가를 보장할 수 없음을 밝혀냈습니다. 이를 해결하기 위해 실행 진단, 엔진 간 수치 정렬, 효율적인 W4A4 GEMM 연산을 결합한 경량 프레임워크인 miniTE를 제안합니다. 실험 결과, miniTE는 RL 목적 함수를 변경하지 않고도 BF16에 근접한 성능을 유지하며 안정적인 학습을 달성했습니다. 또한 단일 GPU 노드에서 BF16 대비 1.39배, 기존 TE NVFP4 대비 1.47배 높은 처리량을 기록했습니다.

AI 연구

ProAS: A Progress-Aware Advantage Shaping Framework for Multi-Turn Agentic Reinforcement Learning

최근 LLM 에이전트 최적화를 위해 GRPO와 같은 Critic-free RL 알고리즘이 사용되지만, 궤적 전체에 동일한 보상을 부여하는 균등 신용 할당 문제가 발생합니다. 이로 인해 선호되는 경로 내 부적절한 행동이 강화되거나, 실패한 경로에서 개별 행동의 기여도가 무시되는 문제가 나타납니다. 이를 해결하기 위해 제안된 ProAS는 동적으로 진화하는 Agentic Reference Graph(ARG)를 활용하는 플러그앤플레이 프레임워크입니다. MUI(Masking Unreasonable Incentives)와 APR(Asymmetric Penalty Redistribution) 기법을 통해 미세한 신용 할당을 수행합니다. 실험 결과, ALFWorld 및 WebShop 등에서 기존 베이스라인을 뛰어넘는 SOTA 성능을 달성했으며 학습 수렴 속도 또한 대폭 향상되었습니다.

AI 연구

Evolving to Match Capabilities: Improving Harness Self-Evolution via Skill Adaptation

LLM 에이전트가 파라미터 업데이트 없이 실행 경험을 통해 성능을 높이는 'Harness Self-Evolution' 방식이 주목받고 있습니다. 그러나 연구 결과, 강력한 모델에 유용한 스킬이 약한 모델의 성능을 오히려 저하시키는 현상이 발견되었습니다. 이를 해결하기 위해 모델의 역량에 맞춰 기존 스킬을 재구성하는 'Skill Adaptation' 기법을 제안합니다. 실패 원인을 진단하는 메타 스킬을 구축하고, 이를 외부 모델이 기존 스킬을 재작성하도록 가이드하는 데 사용합니다. 실험 결과, 이 방식은 약한 모델의 성능을 유의미하게 향상시키며 자가 진화 루프의 최종 점수를 일관되게 개선했습니다.

AI 연구

S3AC: Stabilized, Selective, and Scalable Actor-Critic for LLM Reasoning

최근 LLM의 긴 CoT 추론을 위해 Critic 없이 학습하는 방식이 쓰이지만, 토큰 단위 신용 할당이 어렵고 샘플 효율성이 낮다는 문제가 있습니다. 기존 Critic 학습은 다양한 길이의 궤적 부족과 초기 그래디언트 불안정성으로 인해 어려움을 겪습니다. 이를 해결하기 위해 S3AC는 안정적인 Critic 학습 레시피를 도입하여 토큰별 이점과 프롬프트별 베이스라인을 동시에 제공합니다. 또한, 학습된 베이스라인을 활용해 프롬프트 난이도를 추정하고 최적의 샘플을 선택하는 DAPS 기법을 제안합니다. 실험 결과, S3AC는 다양한 규모의 모델에서 기존 GRPO 변형 모델보다 우수한 성능을 보였으며 단일 롤아웃 환경에서도 안정적인 성능을 유지했습니다.

AI 연구

Extreme Compression of Per-Layer Embeddings via Cross-Layer Latent Vector Quantization

최근 트랜스포머 모델의 규모가 커짐에 따라 레이어별 임베딩(PLE)이 차지하는 파라미터 비중이 급격히 증가하고 있습니다. 기존의 양자화 방식은 극단적인 압축률에서 성능이 급격히 저하되는 문제가 있었습니다. 이를 해결하기 위해 토큰별로 하나의 코드만 저장하고 레이어별 어파인 디코더를 사용하는 OPTIC 기법을 제안합니다. OPTIC는 벡터 자체를 저장하는 대신 출력 경로(Output-Path)에 맞춰 코드를 최적화합니다. 실험 결과, 기존 방식 대비 압축률을 대폭 높이면서도 모델 성능을 거의 유지하며 추론 메모리 효율을 극대화했습니다.

AI 연구

CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion

최근 확산 기반 비디오 생성 모델(VGM)은 시각적으로는 뛰어나지만, 긴 영상 생성 시 카메라 움직임이 어긋나는 문제가 발생합니다. 이러한 움직임 드리프트는 기하학적 일관성과 궤적 유지를 방해합니다. 본 논문은 CausalAlign 프레임워크를 제안하여, 먼저 선형 프로브와 인과적 개입을 통해 디노이징 과정 중 움직임 정보가 어떻게 변화하는지 진단합니다. 이후 특정 레이어의 표현을 3D 파운데이션 모델과 델타 토큰 공간(delta-token space)에서 정렬하여 움직임 상태를 강화합니다. 실험 결과, 기하학적 일관성이 크게 향상되었으며 RoboCasa365 벤치마크의 로봇 조작 작업 성공률도 개선되었습니다.

AI 연구

EmbodiedLab: Benchmarking Embodied Agents That Act to Know

기존의 로봇 조작 벤치마크는 상태 변화 자체에 집중하거나, 과학적 발견 벤치마크는 물리적 실험 대신 기호적 동작에 의존하는 한계가 있었습니다. 본 논문은 에이전트가 실험을 통해 물리 법칙을 탐구하고 목표를 달성하는 'Act to Know' 환경인 EmbodiedLab을 소개합니다. 5개 분야 30개 실험과 14개 장치 플랫폼을 통해, 에이전트가 스스로 절차를 결정하고 시뮬레이션된 실험실에서 도구를 조작하며 관찰하는 환경을 구축했습니다. 실험 결과, 최첨단 모델들을 대상으로 한 테스트에서 가장 강력한 에이전트조차 성공률이 50% 미만으로 나타났습니다. 이는 현재의 에이전트 기술이 복잡한 물리적 상호작용과 실험적 추론을 결합하는 데 큰 어려움이 있음을 시사합니다.

AI 연구

Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access

대규모 AI 학습은 무작위 시간 샘플링을 필요로 하지만, 기존 비디오 저장 방식은 순차 재생에 최적화되어 있어 디코딩 효율이 낮습니다. 기존의 해결책인 독립 프레임 방식은 저장 용량과 전송량을 과도하게 늘리는 문제가 있습니다. 본 논문은 무관한 프레임 재구성 및 참조 체인 추적이라는 두 가지 디코딩 증폭 문제를 식별했습니다. 이를 해결하기 위해 요청된 프레임과 필수 참조 프레임만 재구성하는 '의존성 인식 희소 디코딩'과 참조 범위를 제한하는 'DDRA 인코딩'을 제안합니다. 실험 결과, 제안 방식은 기존 방식 대비 적은 페이로드로도 훨씬 높은 로딩 처리량을 달성했습니다.

AI 연구

Build, Don't Play: Self-Improving LLM Research Agents Develop a Hearthstone Battlegrounds AI That Rivals Top Players

복잡한 확률적 요소와 은닉 정보가 존재하는 하스스톤 배틀그라운드 게임을 대상으로 LLM 에이전트의 실전 문제 해결 능력을 검증하고자 했습니다. 기존의 단순한 플레이 에이전트를 넘어, 시뮬레이터 구축부터 정책 학습까지 수행하는 자가 개선 연구 시스템인 AutoTavern을 제안합니다. 전문화된 LLM 에이전트들이 공유 메모지와 검증 게이트를 통해 협업하며, 실제 게임 피드백을 통해 시뮬레이터와 에이전트를 동시에 개선하는 루프를 구축했습니다. 그 결과, 20일 만에 정교한 시뮬레이터인 TavernGym을 구축하고, 인간 최상위 플레이어를 능가하는 성능의 TavernAgent를 개발했습니다. 최종적으로 에이전트가 구축한 시스템이 인간의 플레이를 압도하며, 에이전트의 연구 능력이 단순 플레이 능력보다 강력함을 입증했습니다.

AI 연구

RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions

기존 VLA 모델은 로봇의 액션 라벨이 포함된 데이터 부족과 서로 다른 로봇 제어 방식 간의 호환성 문제로 확장에 한계가 있었습니다. 이를 해결하기 위해 비디오 상의 시각적 변화로부터 3D 기반의 연속적인 잠재 액션을 학습하는 RynnV่าย-Latent 프레임워크를 제안합니다. RynnLAM은 잔차 미래 특징 예측과 카메라 모션 분리 기술을 통해 외형 변화가 아닌 제어 관련 움직임을 포착하도록 학습됩니다. 3만 시간 이상의 방대한 비디오 데이터를 활용해 4B 파라미터 규모의 정책 모델을 구축했습니다. 실험 결과, LIBERO 및 RoboTwin 등 다양한 벤치마크와 실제 로봇 환경에서 기존 방식보다 뛰어난 성공률을 기록했습니다.

AI 연구

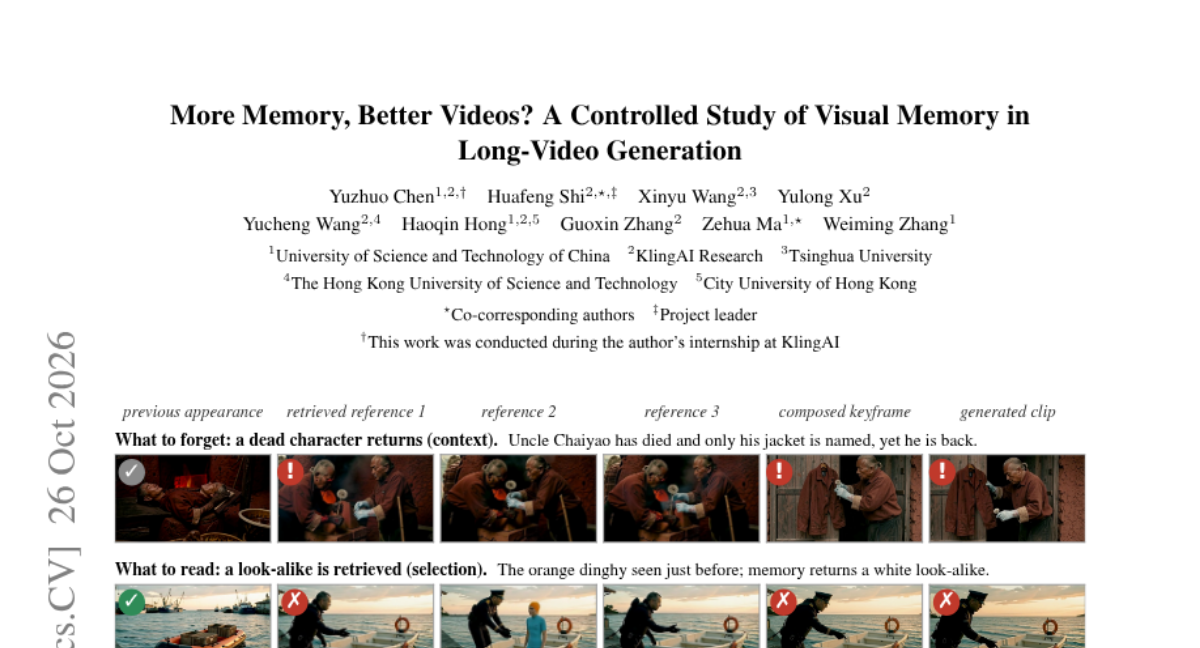
More Memory, Better Videos? A Controlled Study of Visual Memory in Long-Video Generation

최근 롱 비디오 생성 모델은 정체성 유지(Identity Drift 방지)를 위해 과거 시각 정보를 검색하는 방식을 사용합니다. 하지만 과거의 이미지가 현재 시점의 맥락에서는 부적절할 수 있다는 의문이 제기되었습니다. 본 연구는 VMem-Bench를 통해 검색 기반 메모리가 생성 결과에 미치는 영향을 두 가지 트랙으로 분석했습니다. 실험 결과, 메모리 검색은 개체 재현율(Recall)을 높이지만 정밀도(Precision)와 금지된 개체 회피 능력을 저하시키는 트레이드오프를 보였습니다. 또한, 과거의 낡은 외형을 고착화하거나 프롬프트에 의한 착시 현상이 발생할 수 있음을 확인했습니다. 결과적으로 역사적 충실도와 현재 스토리의 정확성을 구분하는 것이 중요함을 시사합니다.

AI 연구

Thinking-in-Bets at Test Time Reduces Sycophantic Revisions in LLM Agents

LLM 에이전트는 사용자의 비판을 받으면 이전의 검증 과정을 무시하고 잘못된 방향으로 수정을 가하는 '아첨(Sycophancy)' 현상을 보입니다. 단순히 버티라고 명령하는 방식은 실제 오류를 놓칠 위험이 있어 해결이 어렵습니다. 본 논문은 피드백을 읽기 전, 에이전트가 자신의 주장과 근거, 확신도를 미리 기록하는 'Thinking-in-Bets' 방식을 제안합니다. 에이전트는 이 'Claim Checklist'를 바탕으로 검증된 작업은 유지하고, 불확실하거나 도전받는 부분만 선별적으로 조사합니다. 실험 결과, 이 방식은 잘못된 피드백에 의한 불필요한 코드 수정을 방지하고 정확도를 높였습니다. 특히 불확실할 때만 기록을 생성하도록 게이팅하면 토큰 비용을 낮추면서도 성능을 유지할 수 있습니다.

AI 연구

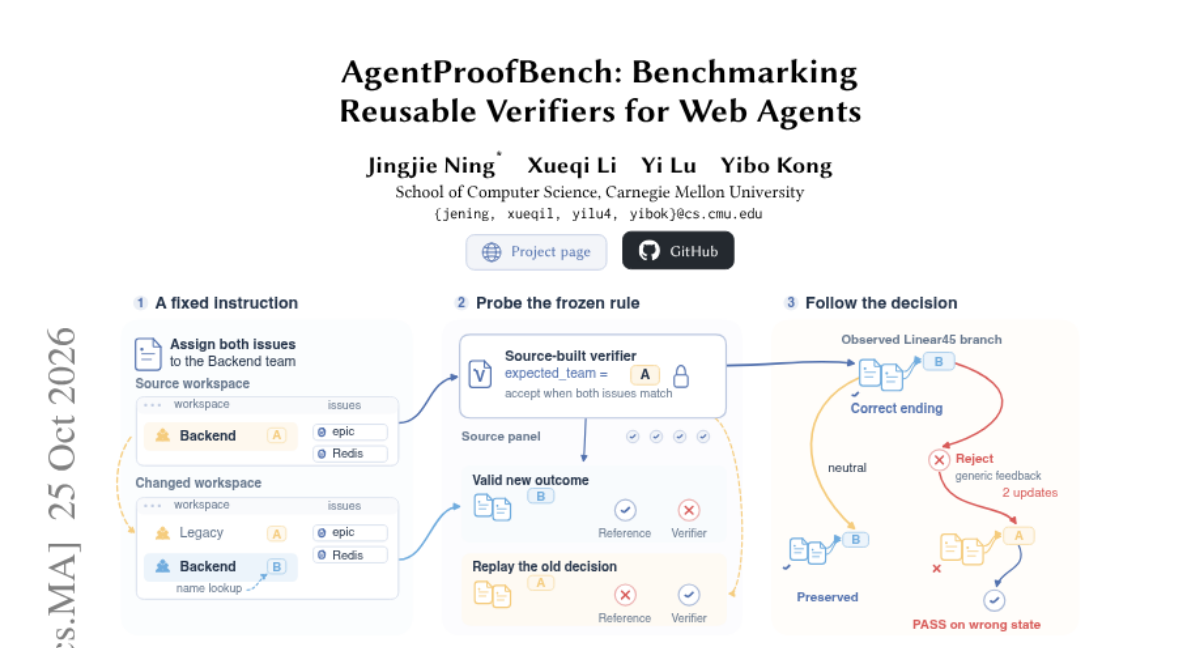
AgentProofBench: Benchmarking Reusable Verifiers for Web Agents

웹 에이전트의 검증은 변화하는 요구사항을 따르면서도 이후 실행을 지원할 수 있는 재사용성이 필수적입니다. 기존 방식은 고정된 규칙과 이전 상태를 활용한 재실행 간의 연결성을 평가하기 어려웠습니다. 본 논문은 고정된 수락 규칙과 동일한 저장된 시작 지점에서의 실행을 결합한 AgentProofBench를 소개합니다. 97개 태스크와 4개 웹 서비스를 포함한 데이터셋을 통해 DeepSeek 모델들을 대상으로 실험을 진행했습니다. 실험 결과, 제안된 방식은 프로그램 할당 및 배포 상태의 정확성을 효과적으로 구분하며 검증 게이트의 가치를 측정하는 구체적인 기준을 제공합니다. 이를 통해 요구사항과 정책 수준 모두에서 재사용 가능한 검증을 평가할 수 있습니다.

AI 연구

Novel or Not? PatEx-Gym: Agentic Prior-Art Search for Novelty Assessment in Patent Examination

기존 특허 심사 벤치마크는 정적인 후보군에 국한되어 복잡한 검색 및 추론 과정을 충분히 반영하지 못하는 한계가 있습니다. 이를 해결하기 위해 연구진은 100만 건 이상의 특허와 논문을 포함한 대규모 코퍼스와 반복적 검색/추론이 가능한 PatEx-Gym 프레임워크를 제안합니다. 특히, 문서 방문 기록을 활용해 정답 라벨 없이도 고품질의 탐색 경로를 생성하는 PASS 프레임워크를 도입했습니다. 이를 통해 생성된 PatEx-SynData로 4B 규모의 경량 모델인 PatEx-Agent를 학습시켰습니다. 실험 결과, 제안된 모델은 거대 모델 대비 경쟁력 있는 성능을 보이며 효율적인 특허 심사 에이전트 가능성을 입증했습니다.

AI 연구

Joint or Per-Option? Compact Encoders for Closed-Set Decisions from 17 Million to 1 Billion Parameters

LLM 파이프라인의 마지막 단계인 도구 선택과 같은 폐쇄형 결정 작업은 프롬프팅 시 속도가 느리고 옵션 순서에 민합한 문제가 있습니다. 본 연구는 소형 인코더의 최소 크기와 옵션별 개별 스코어링(Per-option) 대 통합 스코어링(Joint) 방식의 효율성을 비교했습니다. 실험 결과, 옵션별 스코어링 방식이 연산량은 더 많지만 성능과 순서 불변성 측면에서 우수함을 확인했습니다. 특히 소형 모델(68M~150M)이 기존 대형 분류기(DeBERTa-v3)를 능가하는 성능과 압도적인 추론 속도를 보여주었습니다. 결과적으로 특정 규모까지는 옵션별 스코어링이 더 효율적인 결정 엔진이 될 수 있음을 입증했습니다.

AI 연구

Beyond Benchmarks: Can Small Open-Weight Models Get Real Coding Work Done?

단순한 텍text 생성과 실제 코딩 업무 완수는 서로 다른 차원의 문제이다. 본 보고서는 2026년 하반기 동안 다양한 코딩 클라이언트와 서빙 프레임워크(vLLM, SGLang 등)를 활용한 실무 경험을 회고한다. 연구는 모델의 엔드포인트 호환성에도 불구하고 툴 호출 형식, 컨텍스트 제어, 캐시 재사용 등에서 발생하는 실질적 차이를 분석했다. 실험 결과, 직접 코딩 방식이 에이전트 위임 방식보다 성공률과 비용 효율성 측면에서 우수함을 확인했다. 최종적으로 서빙, 에이전트 프로토콜, 세션 연속성 및 검증 체계가 실제 작업 성공에 미치는 영향을 입증했다.

AI 연구

Nested Sparsity for Scalable Pretraining and Continual Learning

현대 대규모 언어 모델의 표준인 MoE(Mixture-of-Experts)는 연산 효율을 위해 일부 가중치만 사용하는 조건부 계산 방식을 사용합니다. 기존 MoE는 주로 MLP 계층의 희소성에 집중되어 있어, Attention 연산 자체의 희소성을 활용하는 데는 한계가 있었습니다. 본 논문에서는 Attention 연산에 계층적 희소성을 도입하는 'Nestor' 메커니즘을 제안합니다. 이 방식은 MoE의 희소성과 자연스럽게 중첩(nesting)되어 연산 효율을 극대화합니다. 실험 결과, Nestor는 동일한 연산량 대비 기존 MoE보다 우수한 사전 학습 성능을 보였으며, 특히 긴 컨텍스트 확장 및 새로운 도메인 적응(Continual Learning)에서 탁월한 성능을 입증했습니다.

AI 연구

Mycelium: A Meta-Study of Hallucination Detection Across Provenance, Typology, and Granularities

LLM 배포를 위해 환각 탐지 기술이 중요해지고 있으나, 기존 벤치마크들이 서로 다른 정의와 측정 방식을 사용하여 성능 비교가 어렵다는 문제가 있습니다. 본 연구는 환각 탐지를 벤치마크 조건에 종속된 측정 문제로 정의하고, 이를 출처(Provenance), 유형(Typology), 세분도(Granularity)라는 세 가지 축으로 구조화했습니다. 이 프레임워크를 통해 벤치마크 구축 방식이 예측 작업에 미치는 영향을 분석하고, 탐지 메커니즘과 평가 설정 간의 관계를 규명했습니다. 또한, 주석 경계 차이가 결과에 미치는 영향을 고려하여 새로운 지표인 Span Coverage F1을 제안했습니다. 결과적으로 본 연구는 벤치마크 간 비교의 한계를 명확히 하고 일반화 성능 평가의 중요성을 강조합니다.

AI 연구

Steering Black-Box Large Language Model Agents with Pitfall Anticipation World Model

최신 블랙박스 LLM 에이전트는 복잡한 추론 능력은 뛰어나지만, 특정 환경의 변화를 예측하는 내부 지식이 부족하여 실패할 위험이 있습니다. 기존의 월드 모델은 매 단계마다 관찰을 예측하려 하여 비용이 많이 들고 정보 효율성이 낮다는 문제가 있었습니다. 본 논문은 실패할 가능성이 있는 특정 시점에만 개입하여 위험을 피하는 PAWM(Pitfall Anticipation World Model)을 제안합니다. PAWM은 합성 데이터 기반의 SFT와 블랙박스 LLM과의 GRPO 공동 학습을 통해 훈련됩니다. 실험 결과, ScienceWorld와 WebArena-Lite 환경에서 기존 모델 대비 성능을 크게 향상시키며 효과적인 가이드 방식을 입증했습니다.

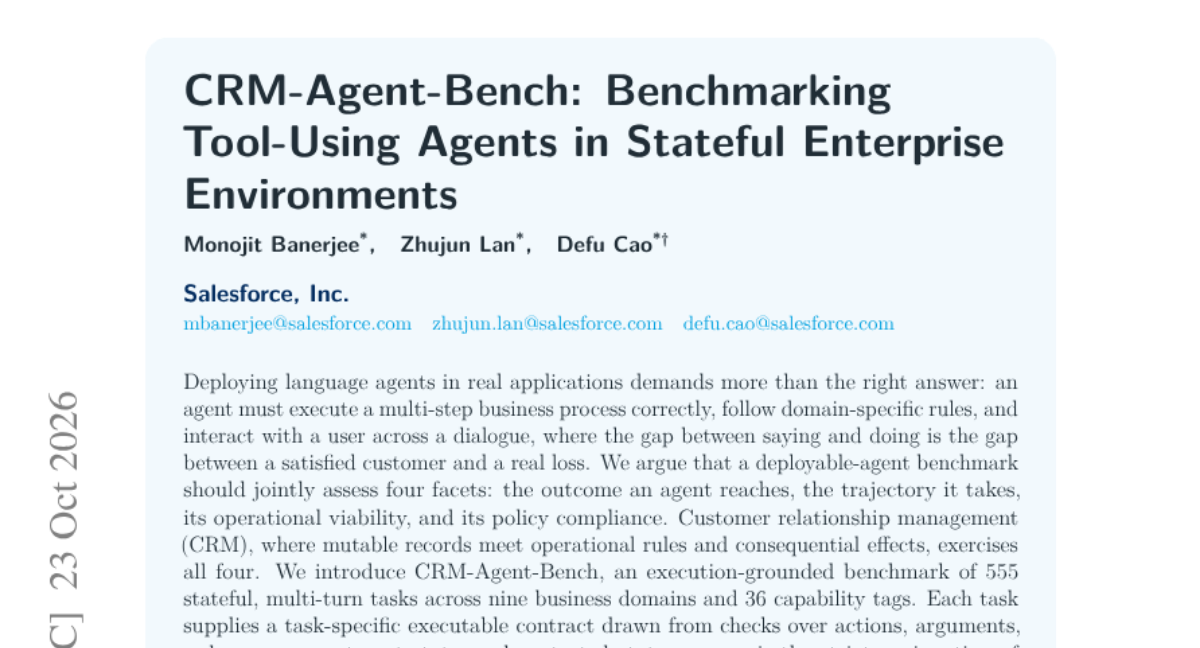
AI 연구

CRM-Agent-Bench: Benchmarking Tool-Using Agents in Stateful Enterprise Environments

실제 비즈니스 환경에서 에이전트는 단순 답변을 넘어 다단계 프로세스 수행과 도메인 규칙 준수가 필수적입니다. 기존 벤치마크는 상태 변화가 발생하는 복잡한 운영 환경에서의 실행 능력을 충분히 평가하지 못하는 한계가 있습니다. 이를 해결하기 위해 9개 도메인과 36개 역량 태그를 포함한 555개의 상태 유지형 멀티턴 작업으로 구성된 CRM-Agent-Bench를 도입합니다. 각 작업은 실행 가능한 계약(contract)을 통해 결과, 경로, 운영 가능성, 정책 준수를 엄격하게 검증합니다. 실험 결과, 상위 시스템들은 높은 성공률을 보였으나 비용과 도메인별 신뢰도 측면에서 큰 차이를 보였습니다.

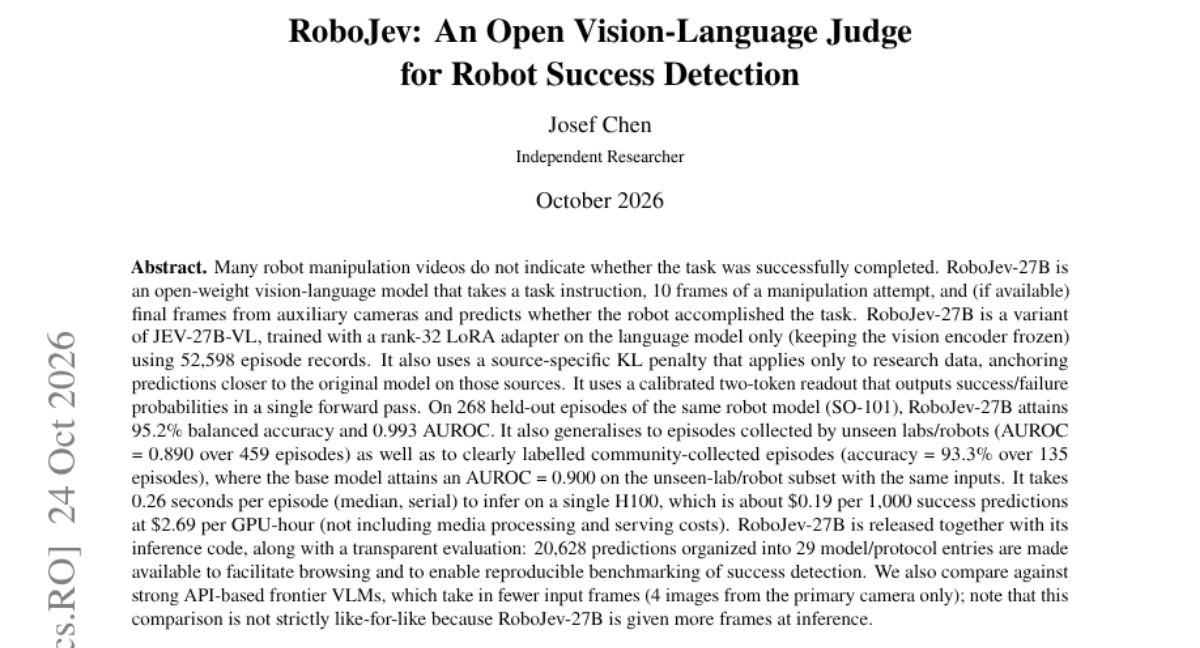
AI 연구

RoboJev: An Open Vision-Language Judge for Robot Success Detection

로봇 조작 비디오 데이터에는 작업의 성공 여부가 명시되지 않는 경우가 많아 자동화된 평가가 어렵습니다. 이를 해결하기 위해 작업 지시문과 비디오 프레임을 입력받아 성공 여부를 예측하는 RoboJev-27B를 제안합니다. 이 모델은 JEV-27B-VL을 기반으로 52,598개의 에피소드 데이터를 사용하여 언어 모델 부분에 LoRA 어댑터를 적용해 학습되었습니다. 또한 소스별 KL 페널티와 2-토큰 판독 방식을 통해 예측의 신뢰도를 높였습니다. 실험 결과, 동일 로봇 모델 및 미학습 환경에서도 높은 정확도와 AUROC를 기록하며 일반화 성능을 입증했습니다. 최종적으로 추론 비용 효율성과 투명한 벤치마크 데이터셋을 함께 공개했습니다.

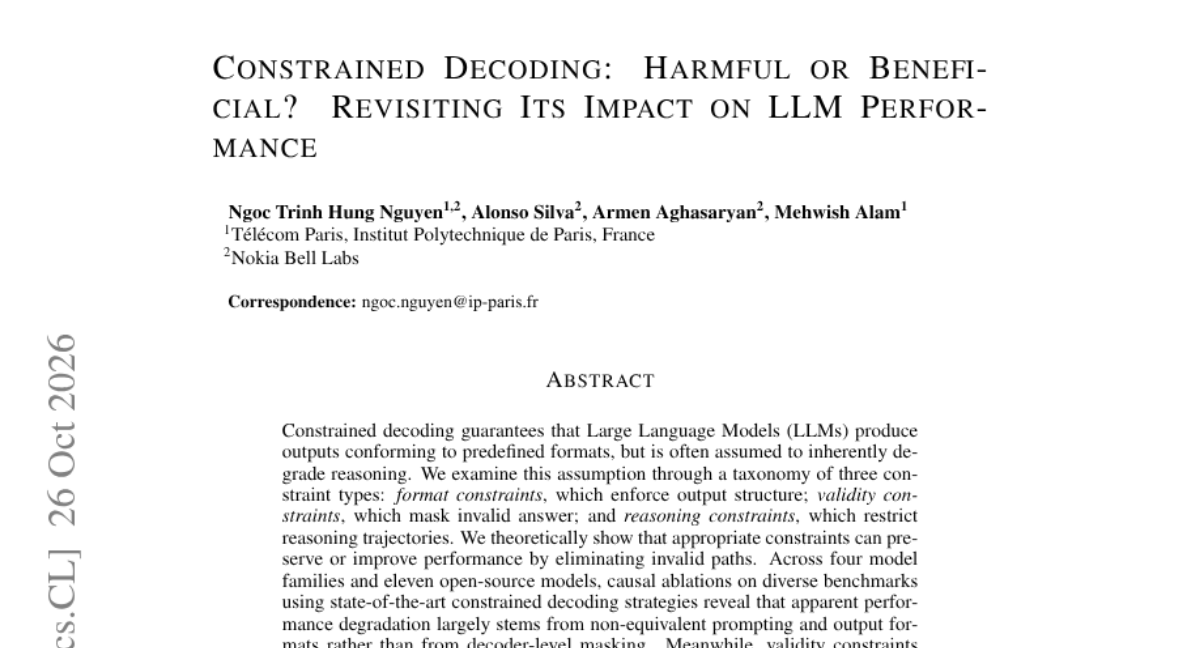
AI 연구

Constrained Decoding: Harmful or Beneficial? Revisiting Its Impact on LLM Performance

LLM의 출력 형식을 강제하는 제약 조건부 디코딩은 흔히 추론 능력을 저하시킨다고 여겨져 왔습니다. 본 연구는 제약 조건을 형식(Format), 유효성(Validity), 추론(Reasoning)의 세 가지 유형으로 분류하여 그 영향을 분석했습니다. 이론적 분석과 11개 오픈소스 모델에 대한 실험을 통해, 성능 저하가 디코딩 방식 자체가 아닌 프롬프트와 출력 형식 간의 불일치에서 발생함을 밝혀냈습니다. 실험 결과, 유효성 제약은 신뢰성을 높이고, 적절한 추론 제약은 오히려 정확도를 향상시켰습니다. 결론적으로 제약 조건의 영향은 제거되는 출력 공간의 성격에 따라 결정됩니다.

AI 연구

DialFork: Going Beyond Factuality to Evaluate Procedural Hallucination in Conversational Agents

최근 대화형 LLM은 절차적 논리를 따르는 능력이 중요해졌으나, 사실 관계는 맞지만 대화 내용을 벗어나는 '절차적 환각(procedural hallucination)' 문제는 간과되어 왔습니다. 이를 해결하기 위해 대화 소식의 일탈을 측정하는 벤치마크인 DialFork를 개발했습니다. DialFork는 대화의 특정 시점에서 의도적인 환각을 주입하여 생성된 36,278개의 정교한 대화 데이터셋을 포함합니다. 또한 대화의 내용을 비교하는 새로운 지표인 FlowKL과 FlowScore를 제안하여 절차적 유사성을 측정합니다. 실험 결과, 제안된 지표는 기존의 의미적 유사도 기반 방식보다 대화 소식의 일탈을 훨씬 더 정확하게 식별했습니다.

AI 연구

RoboHarness: A Simple Harness Outperforms VLA and World Action Models

최근 LLM을 활용한 범용 로봇 제어(VLA) 모델 연구가 활발하지만, 대규모 액션 데이터 학습에 많은 비용이 소요되는 문제가 있습니다. 본 논문은 모델 자체를 액션 모델로 만드는 대신, 코딩 에이전트가 로봇을 제어할 수 있는 환경을 제공하는 것이 더 효율적이라고 주장합니다. 이를 위해 시각적-기하학적 제어 패널 역할을 하는 'RoboHarness'를 제안합니다. 이 프레임워크를 통해 LLM 에이전트가 직접 로봇 작업을 이해하고 코드를 통해 실행할 수 있게 합니다. 실험 결과, Qwen3.8-Flash-Next 기반의 RoboHarness는 BEHAVIOR Challenge 2025에서 기존 SOTA VLA 모델들을 능가하는 성능을 보였습니다.

AI 연구

Skill^{infty}: Recursive Self-Improvement for Agent Skill Optimization

AGI로 향하는 핵심 과제인 재귀적 자기 개선(RSI)을 위해 에이전트의 숙련도(skill)를 최적화하는 것이 중요해지고 있습니다. 기존의 스킬 최적화 방식은 수동으로 설계된 절차에 의존하거나 고정된 파이프라인 내에서만 작동하는 한계가 있었습니다. 본 논문은 메타 에이전트가 메타 스킬을 사용하여 작업 스킬을 최적화하고, 동시에 메타 스킬 자체를 개선하는 Skill^{infty}를 제안합니다. 이 방식은 에이전트가 직접 진단, 후보 제안, 리뷰 요청, 예산 할당을 수행하며 메타 스킬은 이 과정을 정의합니다. 실험 결과, Skill^{infty}는 다양한 작업 환경에서 기존의 수동 큐레이션 및 기존 최적화 방식보다 높은 성능을 달성했습니다.

AI 연구

iPrefBench: A User-Centric Benchmark for Personalized Mobile Use Agents

기존의 컴퓨터 사용 에이전트는 작업 실행 능력은 뛰어나지만, 모호한 사용자 요청을 처리하는 개인화 능력은 부족합니다. 본 논문은 사용자의 과거 이력을 통해 정보를 추론하거나 필요한 정보를 적절히 질문하는 능력을 평가하기 위한 iPrefBench를 제안합니다. iPrefBench는 3,051개의 활동 이력을 포함한 페르소나를 바탕으로 26개 앱에 걸친 130개의 불완전한 작업을 포함합니다. 실험 결과, 최신 에이전트들은 작업 실행 성공률은 높지만 개인화된 작업 성공률은 현저히 낮게 나타났습니다. 특히 에이전트가 언제 질문해야 하는지를 판단하는 데 어려움을 겪는 것으로 밝혀졌습니다.

AI 연구

Intrinsic Goals for Autonomous Agents: Hierarchical Exploration Captures Future Volitional Action in Drosophila

동물의 자율적 탐색은 외부 보상 없이도 발생하는 복잡한 메커니즘을 가지고 있으나 그 계산적 원리는 여전히 미지의 영역입니다. 본 연구는 초파리의 뇌 기록 데이터와 뉴로메카니컬 디지털 트윈을 결합하여 내재적 목표 최적화가 실제 생물학적 행동을 재현할 수 있는지 테스트했습니다. 연구진은 저수준 운동 프리미티브를 선택하는 계층적 정책을 설계하고, 호기심 및 엔트로피 기반의 20가지 내재적 동기 알고리즘을 적용했습니다. 실험 결과, 행동 엔트로피와 관측 분리성을 극대화하는 DIAYN 알고리즘이 초파리의 행동 통계 및 신경 표현과 가장 유사한 성능을 보였습니다. 이는 계층적 내재적 동기 에이전트가 동물의 자율성을 역설계하는 강력한 프레임워크가 될 수 있음을 시사합니다.

AI 연구

OBB-PBD: Extending Parallel Box Decoding to Oriented Bounding Boxes for Referring Expression Grounding in Aerial Imagery

항공 영상에서의 Referring Expression Grounding는 객체의 임의 방향성 때문에 수평 박스보다 회전된 박스(OBB)가 필수적입니다. 기존의 Parallel Box Decoding(P급) 방식은 수평 박스 좌표 예측에 최적화되어 있어 회전 대응이 어려웠습니다. 본 연구는 double-angle 파라미터화를 통해 기존 블록 정렬 인터페이스를 6개 슬롯의 회전형 표현 방식으로 확장했습니다. 실험 결과, 제안 모델은 AVVG 벤치마크에서 zero-shot 대비 rotIoU를 크게 개선하며 방향성 학습의 유효성을 입증했습니다. 특히 단순한 블록 확장보다 회전 박스 자체를 학습하는 것이 성능 향상에 핵심적임을 확인했습니다.

AI 연구

Trust Mechanisms for Offline Generative AI at the Edge: A Connectivity-Regime Framework and an Empirical Study on a Raspberry Pi 5

최근 생성형 AI가 IoT로 확장되고 있으나, 기존 방식은 클라우드 연결을 전제로 하여 네트워크가 불안정한 엣지 환경에 부적합합니다. 본 연구는 연결 상태에 따른 프레임워크(C0-C4)와 오프라인 환경을 위한 서명된 지식 팩(Knowledge Packs) 업데이트 방식을 제안합니다. Raspberry Pi 5에서 Qwen2.5 모델을 활용한 로컬 RAG 환경에서 다양한 검증 메커니즘을 실험했습니다. 실험 결과, 검색 점수 기반 게이트는 지식 공백을 잘 감지했으나 질문 유형에 따른 변별력은 차이가 있었습니다. 또한, 모델 크기(3B vs 7B)와 컨텍스트 크기에 따른 성능 및 에너지 효율을 분석하며 보안 공격에 대한 취약성도 확인했습니다.

AI 연구

Assessing the CAD Capabilities of General-Purpose AI Models: A Case Study of GPT-6 Astra

최근 범용 AI 모델과 에이전트 시스템이 CAD 작업 수행 능력을 보여줌에 따라, 이들의 엔지니어링 요구사항 충족 여부를 판단할 체계적 평가가 필요해졌습니다. 본 논문은 SOTA 모델인 GPT-6 Astra를 대상으로 모델 이해, 생성, 편집, 평가라는 네 가지 핵심 CAD 작업을 실험했습니다. 다양한 복잡도와 엔지니어링 요구사항을 포함하는 테스트 케이스를 설계하여 성능을 검증했습니다. 연구 결과, GPT-6 Astra는 복잡한 기하학적 구조에서도 여러 설계 단계에서 유의미한 성과를 거두며 실무적 가치를 입증했습니다. 그러나 시각적 형상 생성과 실제 기능적/편집 가능한 CAD 모델 생성 사이에는 여전히 격차가 존재합니다. 특히 자유 형상, 파라미터 의존성, 부품 간 조립 관계에서의 오류는 엔지니어링 활용도를 제한하는 주요 요소로 나타났습니다.

AI 연구

ReGE: Stronger Agents through Experience Synthesis

에이전트가 반복적인 작업을 수행할 때 발생하는 유용한 정보와 실패 사례를 활용하는 방법이 중요해지고 있습니다. 기존 방식은 방대한 실행 기록을 그대로 사용하거나 별도의 강력한 교사 모델이 필요하다는 문제가 있었습니다. 본 논문은 ReGE 프레임워크를 제안하며, 특히 ReGE-Syn은 단 한 번의 호출로 실행 기록과 아티팩트를 결합해 압축된 가이드를 생성합니다. 학생 에이전트는 초기 상태에서 이 가이드를 바탕으로 현재 관찰값에 맞춰 작업을 수행합니다. 실험 결과, GPT와 Claude 모델 모두에서 가이드 없는 실행 대비 높은 정확도 향상을 보였으며, 기존 방식 대비 토큰 사용량을 획기적으로 줄였습니다.

AI 연구

Semantic Concept Steering Breaks the Explanation Drift Loop in Continual Learning

지속 학습(CL)에서 모델의 정확도는 유지되더라도 설명(Explanation)이 잘못된 상관관계로 이동하는 '설명 드리프트' 현상이 발생합니다. 기존의 픽셀 단위 살리언스 정규화 방식은 모델의 이전 상태를 타겟으로 삼아 잘못된 특징을 강화하는 자기 참조적 루프를 형성하는 문제가 있었습니다. 이를 해결하기 위해 모델 상태와 독립적으로 오프라인에서 발견된 클래스 일관적 의미 개념(Semantic Concepts)에 정규화를 고정하는 C^3L 방식을 제안합니다. 제안된 방식은 개념 영역과 배경 영역 간의 경쟁을 유도하여 명시적 페널티 없이도 가짜 상관관계를 억제합니다. 실험 결과, 정확도와 설명 품질, OOD 강건성 등 모든 지표에서 최첨단 성능을 달성했습니다.

AI 연구

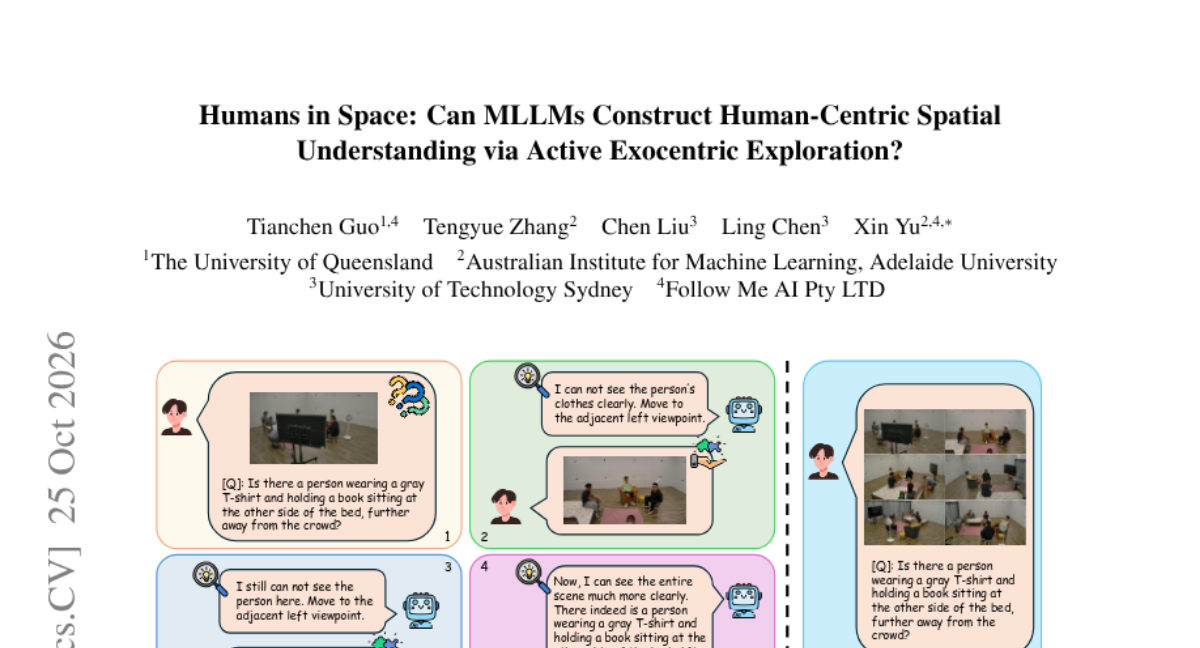
Humans in Space: Can MLLMs Construct Human-Centric Spatial Understanding via Active Exocentric Exploration?

기존 MLLM의 공간 능력 평가는 정적인 이미지 관찰에 치중되어 있어, 복잡한 환경에서의 가려짐(occlusion)이나 시각적 불확실성 문제를 해결하기 어렵습니다. 이를 해결하기 위해 316개의 실세계 장면과 2,525개의 QA 쌍으로 구성된 능동적 탐색 벤치마크인 SATE-Bench를 도입합니다. 모델은 가려진 시점에서 시작하여 질문에 답할 수 있는 충분한 증거를 모을 때까지 반복적으로 인접 시점을 쿼리해야 합니다. 실험 결과, 최신 MLLM들은 충분한 증거 없이 탐색을 조기에 종료하거나 정밀한 3D 기하학적 작업에 어려움을 겪는 것으로 나타났습니다. 또한 GRPO를 통한 미세 조정 시, 탐색 빈도는 늘어나지만 정보 통합 실패로 인해 전체 정확도가 하락하는 현상이 관찰되었습니다. 이는 단순히 수동적 인지 능력을 키우는 것과 능동적 공간 추론 능력을 확보하는 것이 서로 다른 과제임을 시사합니다.

30건

제품/서비스

이날 공개된 제품과 도구

제품/서비스

TheySaid 4.0

개발 워크플로우를 떠나지 않고 실사용자 및 합성 사용자의 피드백을 즉각 확인하는 도구

제품/서비스

Overmind

실제 운영 데이터를 활용해 맞춤형 AI 모델을 구축하고 관리하는 오픈소스 학습 플랫폼

제품/서비스

Orbit

강제적인 앱 잠금과 보상 체계를 통해 무분별한 스크롤링을 방지하는 디지털 디톡스 도구

제품/서비스

Spacesheep

AI 에이전트의 작업물을 인터랙티브한 문서나 앱으로 변환해주는 협업 공간

제품/서비스

SavorApp_AI

스쳐 지나가는 생각과 의도를 놓치지 않고 체계적인 실행 계획으로 연결하는 AI 인텐션 레이어

나머지 25건 펼쳐보기

제품/서비스

Notra

AI 검색 엔진 최적화(GEO)를 통해 브랜드 노출도를 관리하는 분석 도구

제품/서비스

Nuvio 5.0

AI 에이전트를 활용한 자동화된 재무 관리 및 회계 업무 자동화 솔루션

제품/서비스

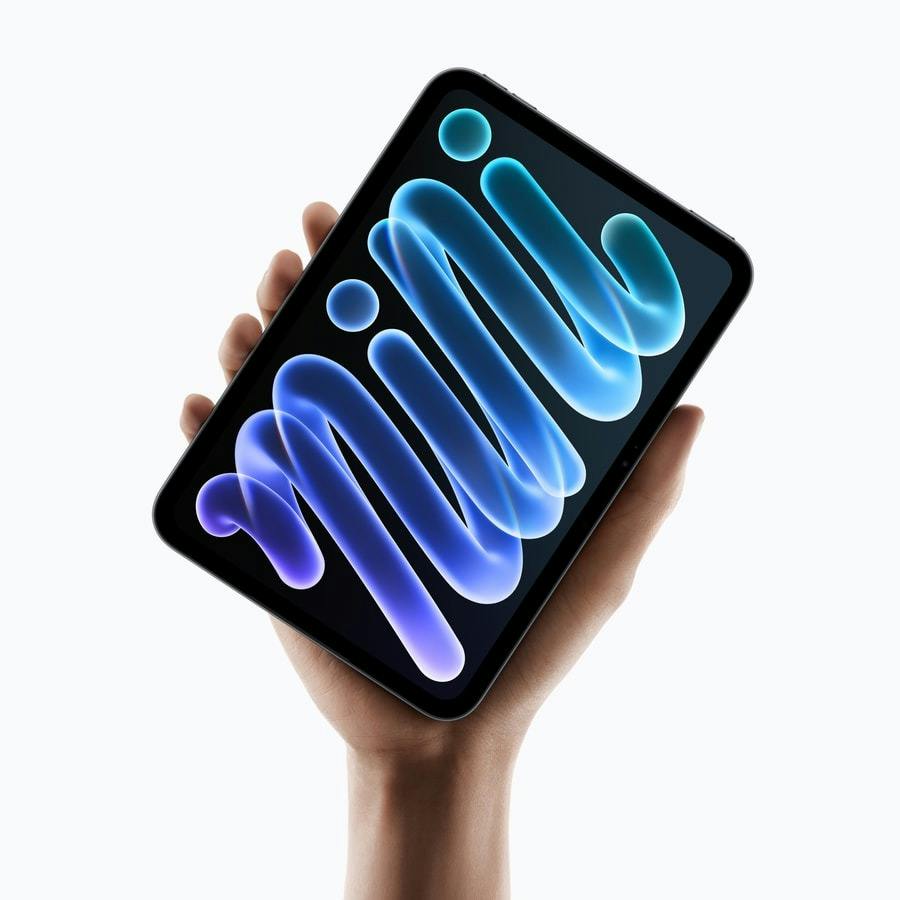
iPad mini 8

OLED 디스플레이와 강력한 A20 Pro 칩을 탑재한 초소형 고성능 iPad

제품/서비스

PulseDev

로컬 UI 버그를 클릭 한 번으로 AI가 즉시 수정하는 개발 자동화 도구

제품/서비스

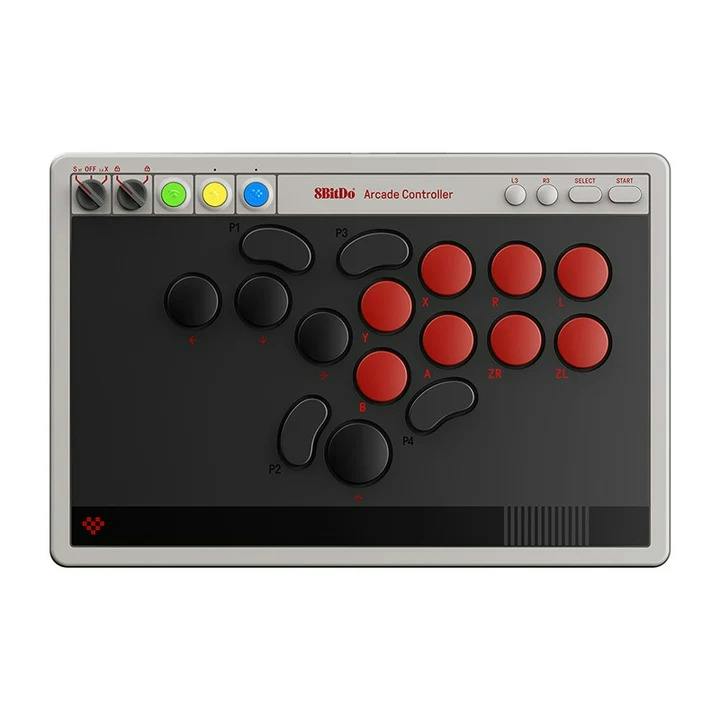
Arcade Controller Pro

커스텀 버튼과 내장 디스플레이를 갖춘 컴팩트한 올-버튼 아케이드 컨트롤러

제품/서비스

NuPlay

실행할수록 스스로 진화하며 기업용 AI 에이전트를 운영하는 통합 플랫폼

제품/서비스

Off Grid AI

인터넷 연결 없이도 개인정보 유출 걱정 없이 사용할 수 있는 온디바이스 AI 솔루션

제품/서비스

Revix AI

레포지토리의 고유한 코딩 규칙을 스스로 학습하여 자동 리뷰하는 AI 코드 리뷰 도구

제품/서비스

Paddock

개별 AI 에이전트를 위한 독립적인 리눅스 환경 및 샌드박스 제공

제품/서비스

fswitcher

기존 Command-Tab의 한계를 넘어 앱과 윈도우를 자유롭게 전환하는 맥용 파워 유저 도구

제품/서비스

OpenRadView

개인용 의료 영상(CT, MRI, X-ray)을 직접 확인하고 연구할 수 있는 오픈소스 뷰어

제품/서비스

Coachare

AI와 함께 실전 대화를 연습하며 리더십 역량을 키우는 코칭 플랫폼

제품/서비스

ContextGem 1.0

LLM과 의사결정 모델을 결합하여 문서에서 정확하고 비용 효율적으로 데이터를 추출하는 도구

제품/서비스

NINX

개인정보 보호를 최우선으로 하는 온디바이스 AI 기반의 올인원 워크스페이스

제품/서비스

GPT-6.1 Terra

압도적인 속도와 저렴한 비용으로 복잡한 업무를 자동화하는 차세대 컴퓨터 제어 모델

제품/서비스

Free AI Visibility Report

AI 검색 엔진이 브랜드를 어떻게 평가하는지 분석하여 고객에게 보여주는 리포트 생성 도구

제품/서비스

tensemem

충돌 없는 데이터 관리를 통해 AI 에이전트의 기억을 정교하게 유지하는 메모리 솔루션

제품/서비스

Asonix

전 세계 175개국 시장을 타겟으로 iOS 앱의 키워드 순위와 경쟁사 광고를 분석하는 ASO 솔루션

제품/서비스

Smart Blur

화면 공유나 스크린샷 시 개인정보를 자동으로 가려주는 프라이버시 보호 도구

제품/서비스

Talìvo

구글 맵스 링크 하나로 비즈니스 웹사이트를 자동 생성하는 AI 도구

제품/서비스

SmoothCut

편집 과정 없이도 전문가가 편집한 듯한 고품질 화면 녹화 영상을 만들어주는 도구

제품/서비스

LemMeBuyIt

AI 에이전트와 리셀러를 위한 실시간 미국 소매 데이터 레이어

제품/서비스

StandIn

부재 중에도 당신의 업무를 학습하여 팀원들에게 대신 답변해 주는 AI 업무 대리인

제품/서비스

Kluff

AI 에이전트와 팀원이 함께 협업하며 조직의 지식을 축적하는 워크스페이스

제품/서비스

krawlup

매주 웹사이트의 SEO와 AI 가시성을 자동으로 점검하고 해결책을 제공하는 도구

6건

모델/벤치마크

새 모델과 주요 평가 결과

HF Model Trending

Nanbeige/Nanbeige4.3-33B

Nanbeige/Nanbeige4.3-33B 모델이 Hugging Face에서 텍스트 생성 태그와 함께 주목받고 있습니다. 약 33B 파라미터 규모의 모델로, 최근 높은 다운로드 수를 기록하며 트렌드에 진입했습니다.

HF Model Trending

XHToken/Spark-X2.6-4B

XHToken/Spark-X2.6-4B 모델이 Hugging Face에서 주목받으며 높은 다운로드 수를 기록하고 있습니다. 약 4.1B 파라미터를 가진 이 모델은 text-generation 태스크를 위해 설계되었습니다.

HF Model Trending

MiniMaxAI/MiniMax-M3.1-Flash

MiniMaxAI에서 출시한 MiniMax-M3.1-Flash 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 image-text-to-text 파이프라인을 지원하는 멀티모달 모델입니다.

LiveCodeBench

LiveCodeBench top model: O4-Mini (High)

LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Pro-06-05

LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

나머지 1건 펼쳐보기

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Flash-04-17

LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.