지난 소식

2026.10.29

이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.

20건

뉴스

주요 기사와 기업의 공식 발표

NPR

Tech: The AI Bubble Has Already Burst In China. Could The U.S. Be Next? : 1A - NPR

중국 내 AI 투자 거품이 실질적인 수익 모델 부재로 인해 이미 붕괴되었음을 분석하며, 미국 시장이 직면할 수 있는 경제적·기술적 리스크를 경고합니다. 막대한 자본이 투입된 LLM(Large Language Model) 기술이 실제 산업 현장의 생산성 향상으로 연결되지 못할 때 발생하는 시장의 변동성을 다룹니다.
The New York Times

A.I. by the Numbers - The New York Times

The New York Times의 'A.I. by the Numbers'는 인공지능 기술의 발전 속도와 사회적 영향력을 정량적 데이터로 분석한 시리즈 리포트입니다. AI 모델의 파라미터 규모, 컴퓨팅 자원 소모량, 그리고 산업 전반에 미치는 경제적 지표를 중심으로 기술적 진보를 조명합니다.

Reuters

China's new export curbs draw a line around its AI crown jewels - Reuters

중국 정부가 핵심 AI 기술 및 관련 장비의 해외 유출을 방지하기 위해 새로운 수출 통제 조치를 도입하며 자국의 AI 주도권을 보호하려 하고 있습니다. 이는 첨단 반도체와 AI 모델 기술이 국가 안보와 직결된다는 판단하에 전략적 자산(Crown Jewels)을 보호하기 위한 조치입니다.

Politico

The Fed's new headache: An AI boom that turns to bust - Politico

AI 산업의 급격한 팽창이 가져올 거품 붕괴 위험이 연방준비제도(Fed)의 통화 정책 결정에 새로운 변수로 부상하고 있습니다. 막대한 자본 투입이 실질적인 수익 모델로 전환되지 못할 경우, AI 붐의 종말이 거시 경제의 불안정성을 초래할 수 있다는 경고입니다.

Stanford University

Stanford instructors tap AI for deeper learning - Stanford University

Stanford University의 교수진이 교육 현장에서 LLM(Large Language Model)을 단순한 지식 전달 도구가 아닌, 비판적 사고와 심층 학습을 유도하는 교육적 파트너로 활용하는 사례를 소개합니다. AI를 활용해 학생들의 학습 과정을 개인화하고, 교수자와 학생 간의 상호작용을 강화하는 새로운 교육 모델을 제시합니다.

나머지 15건 펼쳐보기

WIRED

AI Emergency Alerts Are Coming. Humans Might Not Be Ready - WIRED

기상 이변과 재난 상황이 빈번해짐에 따라, 인간의 불완전한 커뮤니케이션을 보완하기 위한 LLM 기반의 긴급 경보 시스템 도입이 가속화되고 있습니다. 현재는 기술적 정확도와 신뢰성 확보를 위한 과도기 단계에 있으나, 향후 AI가 재난 대응의 핵심적인 정보 전달 도구로 자리 잡을 전망입니다.

Utah State University

College Of Arts & Sciences Builds AI Fluency Through Faculty Workshop - Utah State University

유타 주립대학교(USU) 문리대학은 교수진의 AI 활용 역량 강화를 위해 5주간의 'AI Fluency and Mindset Workshop' 시리즈를 운영하며 교육 현장의 AI 통합 모델을 실험했습니다. 이번 워크숍은 단순한 도구 사용법을 넘어, 윤리적 가이드라인과 비판적 사고를 결합한 실무 중심의 AI 리터러시 구축을 목표로 합니다.

Bloomberg.com

Wall Street’s AI Debt Machine Is Starting to Choke on Supply - Bloomberg.com

월스트리트의 막대한 자본이 투입된 AI 인프라 확충이 공급 과잉과 수익성 증명이라는 현실적 장벽에 직면하며 투자 회수(ROI) 압박을 받고 있습니다. 하드웨어 공급망과 데이터센터 구축 속도가 가속화됨에 따라, 투입된 자본 대비 실질적인 서비스 가치를 창출해야 하는 기술적 전환점에 도달했습니다.

ESG Dive

AI finds its place in sustainable investment strategies: Morgan Stanley - ESG Dive

모건 스탠리의 최신 조사 결과, 기관 투자자들은 AI 도입을 별도의 주제가 아닌 지속 가능한 투자 전략의 핵심 요소로 통합하고 있습니다. 투자자들은 AI의 에너지 소비와 같은 환경적 영향뿐만 아니라 고용 및 공급망에 미치는 경제적 영향까지 관리 범위에 포함시키고 있습니다.

Google DeepMind

Genie 4: A new generation of world simulation

Google DeepMind가 발표한 Genie 4는 실시간 상호작용이 가능한 차세대 월드 시뮬레이션 모델입니다. Gemini 모델을 기반으로 정교한 물리 엔진, 자연스러운 인체 움직임, 네이티브 오디오를 결합하여 현실적인 가상 세계를 구현합니다.

Google DeepMind

Gemini 4 Carbon: Our next frontier model

Google DeepMind가 차세대 프런티어 모델인 Gemini 4 Carbon을 공개했습니다. 이 모델은 최첨단 사이버 보안 기능과 장기적 추론 능력을 갖춘 가장 강력한 모델입니다.

Google DeepMind

Beyond tree cover: mapping the world’s forest types

Google DeepMind가 전 세계 산림 유형을 분류하는 Forest Typology (ForTy) 2020 지도를 공개했습니다. 이 지도는 지구의 토지를 6가지 산림 및 토지 이용 유형으로 분류하며 10미터 해상도를 제공합니다.

OpenAI News

Legora is building the agentic operating system for legal work

Legora가 OpenAI의 모델들을 활용하여 법률 업무를 위한 에이전트형 운영체제를 구축하고 있습니다. 이를 통해 법률 워크플로우를 가속화하고 계약 분석 범위를 확장하여 변호사들이 더 가치 있는 업무에 집중할 수 있도록 지원합니다.

OpenAI News

Retell uses OpenAI models to help power 100M monthly calls

Retell이 OpenAI 모델을 활용하여 월간 1억 건의 통화를 처리하는 성과를 거두었습니다. GPT-4o(Astra)는 Retell의 voice agent benchmark에서 최고 성능을 기록했으며, Codex는 직원당 연간 매출액(annual revenue run rate)을 160만 달러로 달성하는 데 기여했습니다.

OpenAI News

OpenAI expands partnership with Oracle to bring its apps to ChatGPT

OpenAI와 Oracle이 파트너십을 확장하여 비즈니스 애플리케이션과 AI 에이전트를 ChatGPT에 통합하기로 했습니다. 이번 협력을 통해 새로운 Oracle 서비스가 강화되고 ChatGPT 내에서 다양한 비즈니스 앱을 활용할 수 있게 됩니다.

Google Cloud AI

Expanding Claude availability and deployment choice on Google Cloud

Google Cloud에서 Anthropic이 직접 관리하는 Claude 모델 배포 옵션이 일반 제공(GA)됩니다. 이를 통해 개발자는 기존의 Google 관리형 옵션과 더불어 더 넓은 선택지를 갖게 되어 Google Cloud 내에서 AI 워크로드를 통합할 수 있습니다.

26건

커뮤니티

Hacker News, GeekNews, Reddit 반응

Hacker News

Anthropic S-1

Anthropic의 S-1 상장 서류 공개에 따라 기업 가치와 실질적인 AI 수요 사이의 관계가 핵심 쟁점으로 떠올랐습니다. 시장은 AI 코딩 도구와 같은 실질적인 Killer App의 등장과 그에 따른 수익성 확보 여부에 주목하고 있습니다.

Hacker News

Ghostty 1.4

Ghostty 터미널의 1.4.0 메이저 업데이트가 발표되었으며, 성능 최적화와 보안 취약점 해결이 핵심입니다. 커뮤니티에서는 새로운 라이브러리인 libghostty의 발전과 기존 터미널과의 기능 차이에 주목하고 있습니다.

Hacker News

Three new discoveries in mathematics, computer science, and physics

수학, 컴퓨터 과학, 물리학 분야에서 이루어진 세 가지 새로운 발견에 대한 소식과 이에 대한 학계 및 커뮤니티의 반응을 다룹니다. 특히 복잡도 이론과 양자장론 등 심오한 학문적 성과가 OpenAI의 연구 역량과 결합되어 논의되고 있습니다.
Hacker News

Kimi K3.1 Pro and K3.1 Pro Highspeed

Kimi가 강력한 성능의 오픈 웨이트 모델인 K3.1 Pro 시리즈를 공개하며 코딩과 에이전트 성능에서 독보적인 수치를 기록했습니다. 커뮤니티에서는 모델의 정체성 혼선 문제와 보안 측면의 접근 방식에 대해 주목하고 있습니다.
나머지 21건 펼쳐보기

Hacker News

Microsoft offers mass buyouts for roughly a quarter of its workforce

Microsoft가 전체 인력의 약 4분의 1에 해당하는 대규모 희망퇴직 프로그램을 실시하며 조직 개편에 나섰습니다. 이에 대해 전직 직원들의 실무 생산성 저하 문제와 대규모 감원이 가져올 고용 시장의 충격이 주요 쟁점으로 떠오르고 있습니다.

Hacker News

Evidence of a spying operation by ICE against left-wing social movements

미국 이민세관집행국(ICE)이 좌파 사회 운동 단체를 감시하기 위해 기술적 수단을 활용했다는 의혹이 제기되었습니다. 클라우드 플랫폼과 메신저 보안 취약점을 이용한 감시 방식이 드러나며 프라이버시 침해 논란이 일고 있습니다.

Hacker News

Genie 4

Google DeepMind가 발표한 새로운 AI 모델 Genie 4에 대해 기술적 완성도와 생성 오류를 둘러싼 커뮤니티의 논쟁이 이어지고 있습니다. 생성된 영상 속 객체의 일관성 문제와 기술적 진보 사이의 간극이 핵심 쟁점입니다.

Hacker News

Apple Music 404 Not Found

Apple Music 서비스 내에 숨겨진 고전 게임 기능이 발견되어 사용자들 사이에서 화제가 되고 있습니다. 과거의 인터페이스에 대한 향수와 숨겨진 기능의 발견이 결합되어 커뮤니티의 관심을 끌고 있습니다.

GeekNews / Hada

PROLED XDR 디스플레이와 터치를 탑재한 MacBook Pro

탠덤 OLED와 터치 인터페이스의 결합은 노트북 디스플레이의 시각적 품질과 조작 편의성을 동시에 확보하려는 시도입니다. 이는 고성능 작업과 직관적인 제어를 동시에 요구하는 전문가용 노트북 시장의 새로운 기준을 제시합니다.

GeekNews / Hada

Gemini 4 Carbon - 사이버 보안과 장기 에이전트 작업 역량을 강화한 모델

Gemini 4 Carbon은 단순한 질의응답을 넘어 장기적인 에이전트 작업과 보안 방어라는 실무적 엔지니어링 영역에 초점을 맞춘 모델입니다. 이는 AI가 자율적인 문제 해결사로서의 역할을 수행하며 전문적인 코딩 및 보안 워크플로우에 깊이 통합될 수 있음을 시사합니다.

GeekNews / Hada

Amazon, 위성 기업 Globalstar를 약 17.4조원에 인수하기로 합의

Amazon은 Globalstar 인수를 통해 독자적인 위성 네트워크를 구축하고 SpaceX의 Starlink에 대응할 기술적 기반을 마련했습니다. 이는 클라우드와 연결성을 결합한 차세대 통신 시장에서의 주도권을 확보하려는 전략적 움직임입니다.

GeekNews / Hada

CNC를 활용한 석재 조각

정밀한 5축 CNC 기술이 전통적인 석재 조각 공정을 자동화하며 건축 예술의 생산성을 극대화하고 있습니다. 이는 비용과 시간 제약으로 인해 단순화되었던 고전적 건축 양식을 현대 기술로 재현할 수 있는 기술적 토대를 제공합니다.

GeekNews / Hada

Emacs, 50주년을 맞다

Emacs는 단순한 편집기를 넘어 사용자 정의가 가능한 매크로 기반의 강력한 프레임워크로서의 본질을 유지해 왔습니다. 반세기가 지난 지금도 생명력을 유지하는 것은 소프트웨어의 확장성과 사용자 중심 설계가 가진 힘을 보여줍니다.

GeekNews / Hada

ICE, 미국 역사상 최대 규모급 좌파 감시 작전 수행 중

정부 기관의 수사 권한이 정치적 반대 세력을 감시하는 수단으로 전용될 수 있다는 법적·윤리적 쟁점이 발생했습니다. 이는 국가 안보를 명분으로 한 광범위한 정보 수집이 시민의 기본권과 충돌할 때 발생하는 민주주의적 위기를 시사합니다.

Reddit

Models are chasing unrealistic benchmarks but the working-level intelligence is already achieved

최근 AI 모델들이 실무와 거리가 먼 복잡한 벤치마크 점수 경쟁에 치중하고 있다는 비판이 제기되었습니다. 사용자가 요구한 핵심 작업에 충실하기보다 불필요한 과잉 성능을 보여주는 것이 현재의 평가 방식이며, 이는 시장 가치를 유지하기 위한 의도적인 소식일 수 있다고 분석합니다.

Reddit

got this recording and have no idea what they’re saying lol

사용자가 외국어로 된 긴 녹음 파일을 영어로 번역하고 이해하기 위한 효율적인 방법을 찾고 있습니다. 수동 번역의 어려움을 피하기 위해 전체 내용을 영어 텍스트로 변환할 수 있는 도구나 방법론에 대해 질문했습니다.

Reddit

Most of the top open-source repositories allow AI-assisted code

대부분의 주요 오픈소스 저장소가 AI를 활용한 코드 작성을 허용하고 있다는 사실이 논의되었습니다. 이는 오픈소스 생태계에서 AI 보조 도구의 수용 범위가 넓어지고 있음을 시사합니다.

Reddit

Cyber-Tiel-Coder-35B-A3B-MTP-UD-IQ3_XXS.gguf A GREAT MODEL

Cyber-Tiel-Coder-35B-A3B-MTP-UD-IQ3_XXS.gguf 모델의 성능 테스트 결과, 매우 낮은 양자화 수준임에도 불구하고 추론 능력이 저하되지 않은 뛰어난 성능을 보여줍니다. CPU 환경에서도 초당 7-8 토큰의 속도로 구동 가능하여 소형 양자화 모델 중 최상위권의 성능을 제공합니다.

Reddit

What exactly is the ground truth for speech alignment task?

음성 정렬(Speech Alignment) 작업에서 인간이 주석을 단 데이터셋을 진정한 정답(Ground Truth)으로 간주할 수 있는지에 대한 의문을 제기하고 있습니다. 성능 평가의 기준과 최고 수준의 정렬 모델을 구축하는 방법, 그리고 그 성능을 검증하는 방식에 대한 기술적 고민을 담고 있습니다.

47건

논문

읽어볼 만한 AI 연구

AI 연구

ChronoReplay: One Answer Interface Is Not Enough for Streaming Spatial Intelligence

공간 VLM 학습 시 특정 질문(예: 어느 쪽인가?)에만 집중하면 거리 추정 등 다른 중요한 공간적 관계가 무시되는 '인터페이스 락인' 현상이 발생합니다. 이를 해결하기 위해 ChronoReplay는 이질적인 공간 감독 데이터를 시간 순서가 있는 에피소드로 재구성하여 학습합니다. 학습 과정에서 소스 데이터의 원래 목표를 유지하면서 다양한 작업군 간의 균형을 맞추는 방식을 채택합니다. 실험 결과, 단일 체크포인트만으로도 여러 공간 벤치마크에서 성능 향상을 동시에 달дя했습니다. 또한 적응형 프레임 선택을 통해 추론 시 시각적 비용을 낮추면서도 성능을 유지할 수 있음을 입증했습니다.

AI 연구

Multiscale Policy Optimization for Long-Horizon LLM Agents

LLM 에이전트는 토큰 단위로 행동을 생성하지만, 환경과의 상호작용은 턴 단위로 이루어지는 특성이 있습니다. 기존 방식은 토큰 간의 세밀한 보상 할당과 턴 단위의 거시적 보상 사이의 불일치 문제를 겪습니다. 이를 해결하기 위해 제안된 Multiscale Policy Optimization(MPO)은 다중 스케일 이득 추정(MAE)과 턴 단위 중요도 샘플링을 결합합니다. 이 방법론은 신용 할당(Credit Assignment)을 턴 스케일에 맞춰 정렬함으로써 최적화를 수행합니다. 다양한 검색, 도구 사용, 자동화 작업 실험 결과, 기존 RL 베이스라인 대비 일관된 성능 향상을 입증했습니다.

AI 연구

The Trinity:Capability-Driven Recursive Self-Improvement for Multimodal Agents

멀티모달 지능은 환경과 에이전트 간의 상호작용을 통해 진화하지만, 이질적인 환경 구축 비용과 수동적인 태스크 설계 방식이 확장성의 병목 현상으로 작용합니다. 본 논문은 서로 다른 모달리티를 가진 태스크들이 동일한 핵심 역량을 공유할 수 있다는 통찰에 기반하여 'The Trinity' 프레임워크를 제안합니다. 이 프레임워크는 Creator, Explorer, Evolver라는 세 가지 역할을 통해 태스크를 표면적 카테고리가 아닌 계층적 역량 트리(Capability Tree)로 재구성합니다. Creator는 공통 요구사항을 추출해 검증 가능한 시뮬레이션 환경을 생성하고, Explorer는 재사용 가능한 모듈을 진화시키며, Evolver는 실행 궤적을 바탕으로 역량 중심의 태스크 구조를 최적화합니다. 실험 결과, 제안된 방식은 다양한 벤치마크와 미학습 태스크에서 성능을 크게 향상시키며 실세계 로봇 작업에서도 유효함을 입증했습니다.

AI 연구

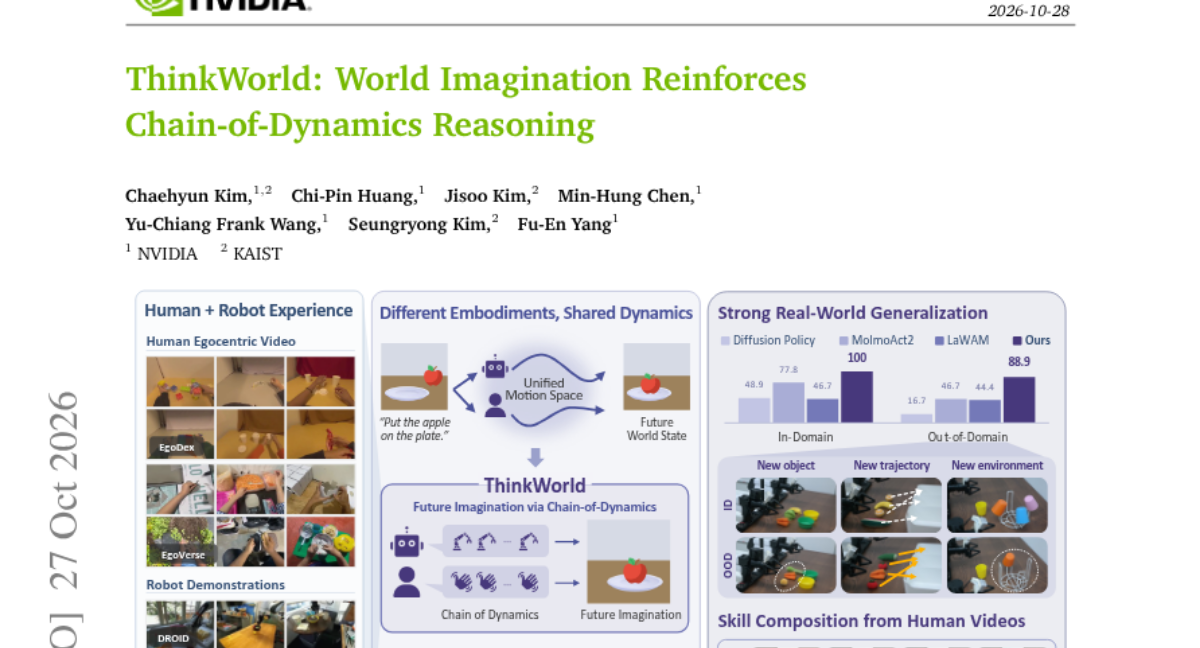
PDRVLA: A Vision-Language-Action Model with Physical Dynamics Representations

기존 VLA 모델은 시각적 관찰과 언어 지시를 통해 동작을 생성하지만, 물리적 역학에 대한 이해가 부족하다는 한계가 있습니다. 비디오 월드 모델은 장면의 역학을 잘 포착하지만, 미래 비디오를 직접 생성하는 방식은 제어 루프에 높은 지연 시간을 발생시킵니다. 이를 해결하기 위해 PDRVLA는 비디오 생성 없이 시각-언어 특징에서 물리적 토큰을 추출하는 경량 물리 동역학 모듈을 제안합니다. 이 모듈은 미래의 RGB, 깊이, 광학 소식(optical-flow) 특징을 직접 예측하며, 동결된 사전 학습 비디오 월드 모델을 보조 감독 도구로 활용합니다. 실험 결과, LIBERO 및 SimplerEnv 등 다양한 시뮬레이션 벤치마크에서 높은 성공률을 기록하며 성능을 입증했습니다.

AI 연구

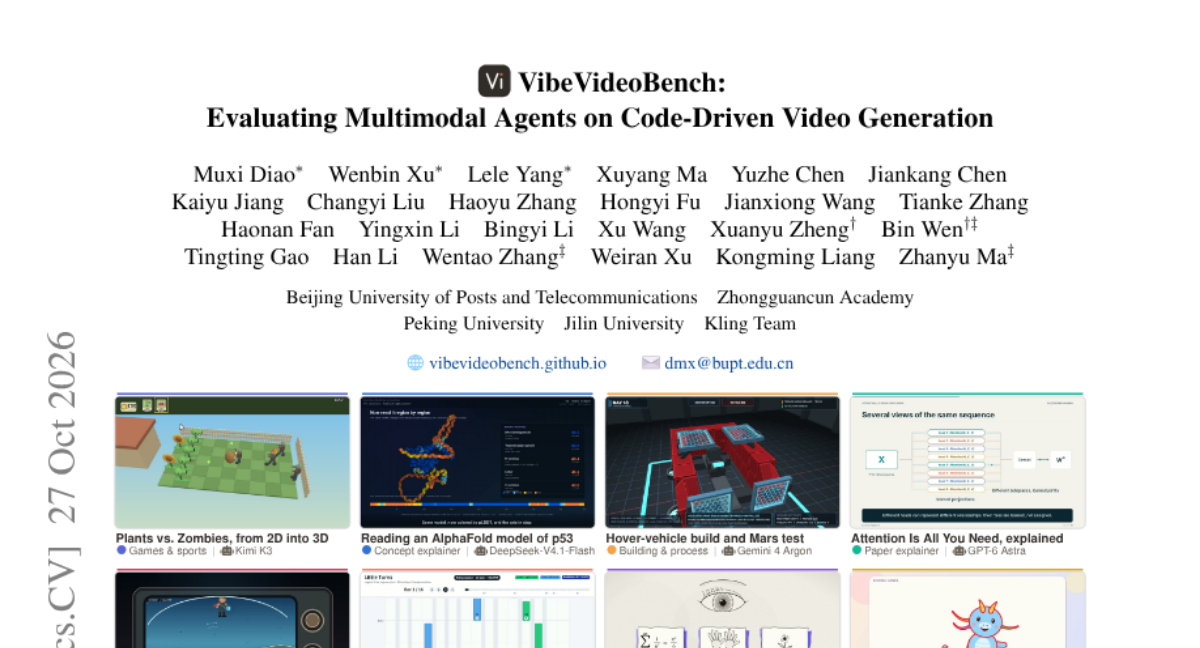
VibeVideoBench: Evaluating Multimodal Agents on Code-Driven Video Generation

기존 확산 모델 기반 비디오 생성은 정확한 수식, 차트, 규칙 준수 및 정교한 내레이션 동기화에 한계가 있습니다. 이를 해결하기 위해 코드를 작성하여 프레임과 사운드를 렌더링하는 멀티모달 에이전트 방식이 부상하고 있습니다. 본 논문은 이러한 에이전트의 능력을 평가하기 위해 239개의 태스크로 구성된 VibeVideoBench를 도입합니다. 샌드박스 환경에서 에이전트가 직접 코드를 실행하여 MP4 결과물을 생성하며, 프로그램 체크와 VLM 기반의 계층적 평가를 수행합니다. 실험 결과, 최신 에이밍 시스템들이 높은 성능을 보였으나 계획 수립 실패로 인한 렌더링 지연 문제가 주요 실패 원인으로 나타났습니다.

나머지 42건 펼쳐보기

AI 연구

Hy-Nomas: Towards Free-form Interactive World Generation

상호작용형 월드 생성 모델은 이전 상태를 유지하면서 연속적인 명령을 수행해야 하는 과제를 안고 있습니다. 본 논문은 8B 확산 모델 백본을 기반으로 자유 형식의 텍스트와 연속적인 카메라 제어를 지원하는 Hy-Nomas를 제안합니다. 핵심 설계는 구조화된 비디오 캡션과 액션 중심의 인과적 어텐션(causal attention)을 결합하여, 설명적 맥락은 유지하되 액션 명령은 해당 시간대에만 적용되도록 합니다. 또한 Prompt Enhancer를 통해 사용자 요청과 상호작용 이력을 구조화된 조건으로 변환하며, 단계별 커리큘럼 학습을 통해 모델의 생성 능력을 점진적으로 고도화합니다. 실험 결과, Hy-Nomas는 기존 월드 모델 대비 우수한 성능을 입증하였습니다.

AI 연구

Memory Tax: Dissecting the Net Value of Agent Memory

장기 에이전트(Long-horizon agents)에서 메모리 활용이 증가하고 있으나, 메모리 구축이 단순 RAG 대비 갖는 순 가치는 불분명합니다. 본 연구는 대규모 벤치마크를 통해 많은 전용 메모리 시스템이 오히려 단순 RAG보다 성능이 낮다는 점을 발견했습니다. 연구진은 메모리 구축 과정에서 발생하는 이득(Benefit)과 손실(Tax)을 분석하여, 정보 재구성 과정에서 발생하는 '이중적 편차'를 규명했습니다. 메모리 설계가 정보를 요약하거나 재조직하는 과정에서 증거를 누락하거나 가리는 현상이 성능 저하의 원인임을 밝힙습니다. 이를 통해 단순 성능 지표를 넘어 메모리의 순 가치를 평가하는 새로운 관점을 제시합니다.

AI 연구

Can Discrete Tokens Serve as Semantically Lossless Representations of Visual Signals?

언어 모델처럼 시각 정보를 이산적 토큰으로 변환하는 방식은 멀티모달 모델링에 유리하지만, 양자화 오차로 인한 의미 손실이 성능의 한계로 여겨져 왔습니다. 본 논문은 양자화 오차보다 가용 비트 예산(bit budget)이 성능의 핵심 결정 요인임을 밝히며 기존 가설을 반박합니다. 이를 위해 고정 차원의 상호 보완적 뷰를 양자화하는 Factorized Vector Quantization(FVQ) 방식을 제안합니다. 제안된 모델은 대규모 데이터로 학습되어 기존 이산 표현 모델들을 압도하며, Qwen3-VL과 같은 강력한 연속 표현 모델과 대등한 성능을 달성했습니다. 결과적으로 이산적 시각 표현이 차세대 멀티모달 파운데이션 모델의 핵심 기술이 될 수 있음을 입증했습니다.

AI 연구

HABIT-Bench: Evaluating Habit Induction from Longitudinal Weak Evidence in Agent Memory

LLM 에이전트와 사용자의 장기 상호작용에서 사용자의 습관을 파악하는 것은 중요하지만, 개별 관찰 데이터는 습관의 전체 맥락을 담기에 불충분한 경우가 많습니다. 단순히 과거 대화 기록을 저장하는 것만으로는 복잡한 습관을 추론하고 적절한 시점에 적용하는 능력을 보장할 수 없습니다. 본 논문은 약한 증거로부터 습관을 추론하고 이를 후속 요청에 적용하는 능력을 평가하기 위한 HABIT-Bench를 제안합니다. 합성 데이터와 제어된 습관 그래프를 활용하여 음식, 금융, 소프트웨어, 여행 등 다양한 도메인의 수백 세션에 걸친 사용자 이력을 구축했습니다. 실험 결과, 최신 메모리 기법들을 적용하더라도 습관 추론 및 적용 성능은 여전히 낮게 나타났습니다. 이는 과거 기록에 대한 접근 권한과 실제 습관을 추론하여 사용하는 능력 사이에 큰 격차가 존재함을 시사합니다.

AI 연구

CodeCap-Bench: Can Code Serve as a Good Video Caption?

기존의 자연어 기반 비디오 캡셔닝은 복잡한 공간 구조와 시간적 역동성을 표현할 때 모호하거나 설명이 길어지는 문제가 있습니다. 본 연구에서는 그래픽 프리미티브와 시간 함수를 활용하는 '코드 기반 비디오 묘사'라는 새로운 패러다임을 탐구합니다. 제안된 코드 캡션이 자연어보다 추론 정확도와 비디오 재구성 충실도 면에서 우수함을 입증했습니다. 이를 평가하기 위해 5개 카테고리의 구조화된 2D 콘텐츠를 포함한 CodeCap-Bench 벤치마크를 도입했습니다. 실험 결과, 최신 폐쇄형 MLLM은 가능성을 보여주었으나 복잡한 시간적 역동성을 포착하는 데는 여전히 한계가 있으며 오픈소스 모델은 격차가 더 컸습니다.

AI 연구

Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?

최근 Test-Time Training(TTT)은 과학적 발견 작업에서 뛰어난 성능을 보였으나, 온라인 가중치 업데이트로 인한 높은 연산 비용이 문제로 지적되었습니다. 이를 해결하기 위해 모델 가중치를 직접 수정하지 않고 외부 메모리를 지속적으로 업데이트하는 Test-Time Memory Evolution(TTME)을 제안합니다. TTME는 경험을 메모리에 증류하여 후속 탐색을 가이드하는 플러그 앤 플레이 방식의 적응형 방법론입니다. 동일한 프레임워크 내에서 TTT와 비교 실험을 진행한 결과, TTME는 모든 수학적 과제에서 TTT를 능가하는 성능을 보였습니다. 동시에 연산량(FLOPs)은 약 83-85%, 실행 시간은 약 48-58%를 절감하며 효율성을 입증했습니다.

AI 연구

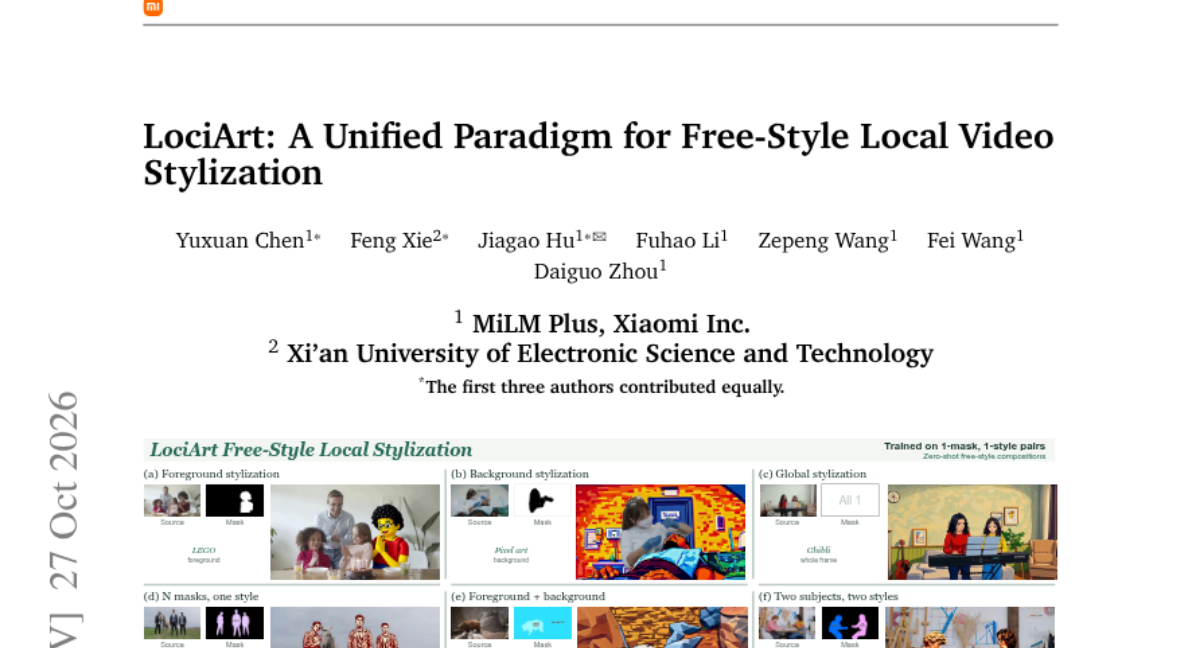
LociArt: A Unified Paradigm for Free-Style Local Video Stylization

기존 비디오 스타일링은 전체 장면을 변형하는 데 집중하여 특정 영역만 정교하게 편집하는 데 어려움이 있었습니다. 이를 해결하기 위해 영역 지정과 스타일 적용을 동시에 수행하면서 비대상 콘텐츠를 보존하는 LociArt 프레임워크를 제안합니다. 핵심 모듈인 GRNStyle은 스타일 정체성을 방향 벡터로 임베딩하는 polar style-aware mask와 기하학적 제어를 위한 representation-geometry conditioning을 결합합니다. 또한, 학습을 위해 자동화된 파이프라인을 통해 구축된 100K 규모의 LociArt-100K 데이터셋을 활용합니다. 실험 결과, 제안 방식은 기존 방법론 대비 뛰어난 지역적 스타일 품질과 공간 제어 능력을 보여주었습니다.

AI 연구

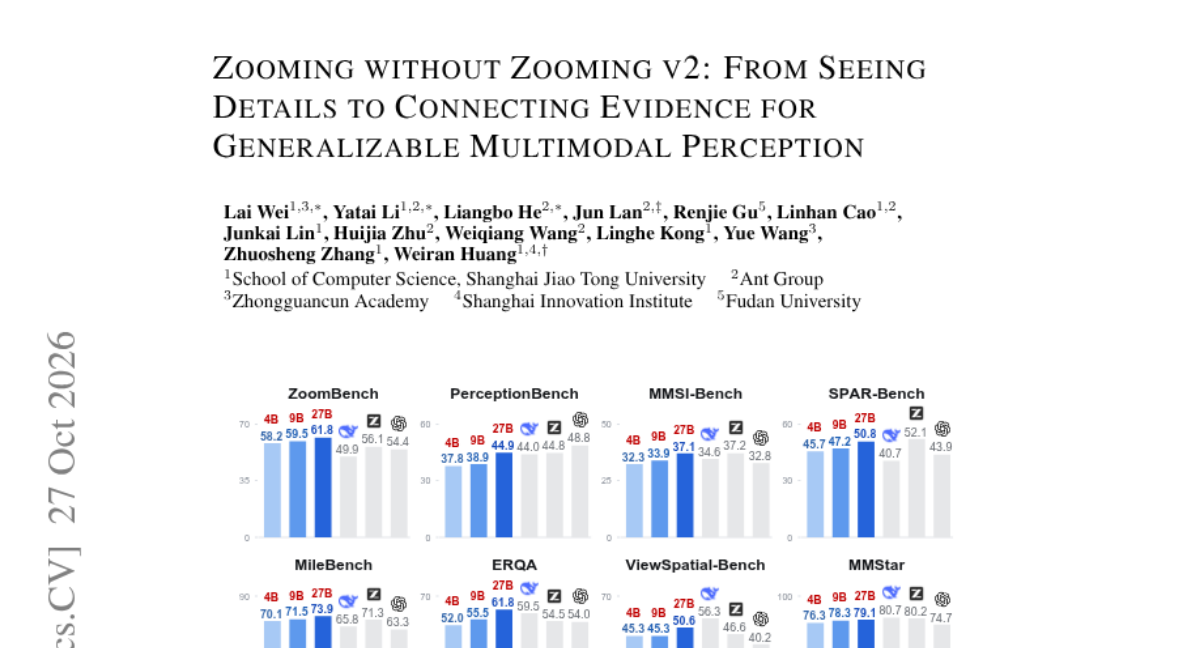
Zooming without Zooming v2: From Seeing Details to Connecting Evidence for Generalizable Multimodal Perception

멀티모달 지능의 핵심인 공간 지각과 롱 컨텍스트 이해를 위해서는 고품질의 타겟 데이터 확보가 필수적이지만 비용이 매우 높습니다. 연구진은 이 두 작업이 '증거 연결(connecting evidence)'이라는 공통된 핵심 능력을 공유한다는 점에 주목했습니다. 이를 위해 단일 이미지 내 관련 영역의 확대 뷰를 활용하여 비교, 집계, 체이닝이 필요한 질문을 생성하는 EvidenceConnect 프레임워크를 제안합니다. 생성된 데이터는 VLM 간의 합의와 영역 제거 테스트를 통해 품질을 검증하며, RLVR 방식으로 모델을 학습시킵니다. 그 결과, 특정 벤치마크에 특화되지 않고도 공간 지각, 에이전트 작업, 일반적 시각 추론 성능이 크게 향상되었습니다.

AI 연구

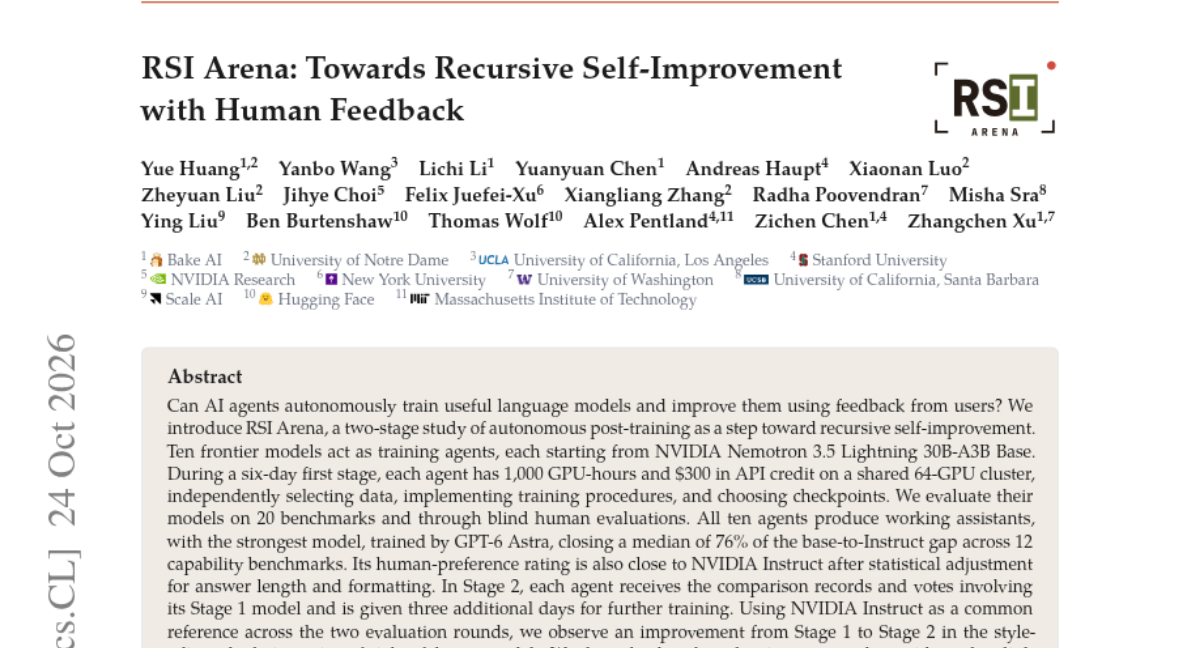
RSI Arena: Towards Recursive Self-Improvement with Human Feedback

AI 에이전트가 인간의 피드백을 통해 스스로 유용한 언어 모델을 학습하고 개선할 수 있는지에 대한 의문에서 시작되었습니다. 연구진은 자율적 사후 학습(post-training)을 연구하기 위해 RSI Arena 프레임워크를 도입했습니다. 10개의 프런티어 모델 에이전트가 주어진 자원 내에서 독립적으로 데이터 선택, 학습 절차 구현, 체크포인트 결정을 수행하며 모델을 학습시켰습니다. 실험 결과, 에이전트들은 모두 작동 가능한 어시스턴트 모델을 생성했으며, 특히 2단계 피드백 루프를 통해 모델 성능이 개선되는 양상을 보였습니다. 다만 벤치마크 점수 향상과 인간 선호도 사이의 명확한 상관관계는 부족했으며, 일부 모델에서 답변 길이 증가나 유해성 준수와 같은 부작용이 관찰되었습니다.

AI 연구

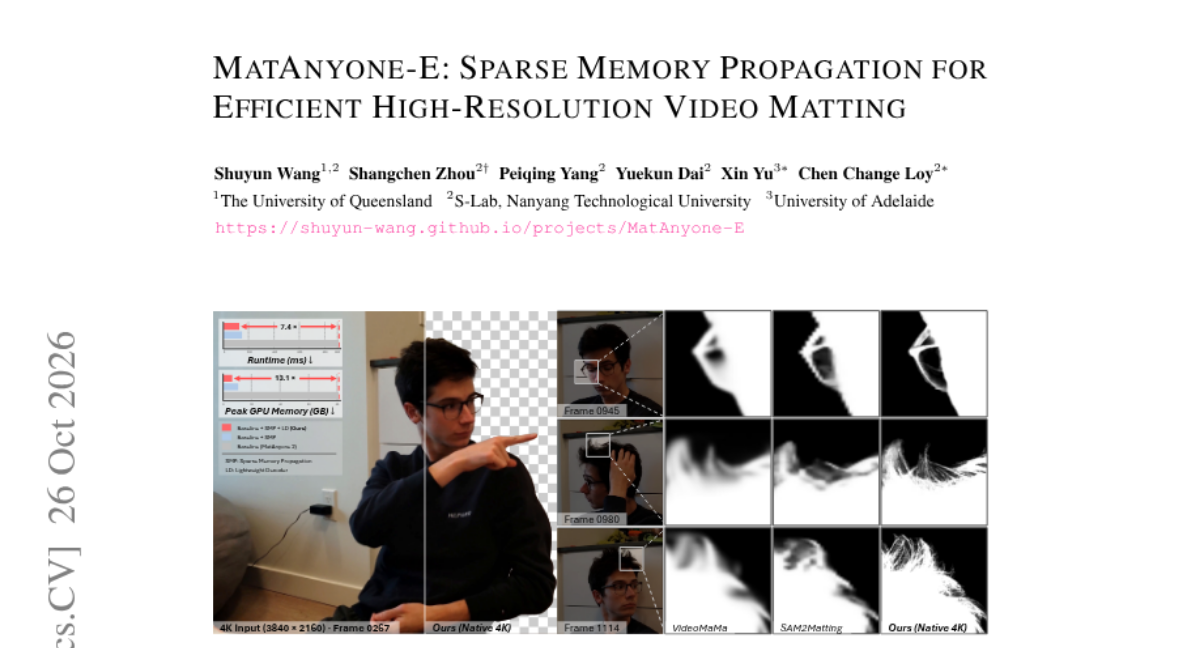
MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting

고해상도 비디오 매팅은 미세한 디테일 유지와 프레임 간 일관성 확보가 필수적이지만, 해상도가 높아질수록 메모리 기반 방식의 연산 비용이 급증하는 문제가 있습니다. 이를 해결하기 위해 MatAnyone-E는 저해상도 단계에서 불확실한 영역과 관련 메모리 후보를 먼저 식별하는 방식을 제안합니다. 이후 식별된 영역에 대해서만 선택적으로 고해상도 매칭을 수행하고, 나머지 영역은 저해상도 결과를 재사용하여 연산량을 최적화합니다. 또한 런타임 병목을 고려한 경량 디코더를 설계하여 고해상도 매트 생성 비용을 추가로 절감했습니다. 실험 결과, MatAnyone 2와 대등한 품질을 유지하면서도 4K 해상도에서 GPU 메모리 사용량을 7.6% 수준으로 낮추고 추론 속도를 대폭 향상시켰습니다.

AI 연구

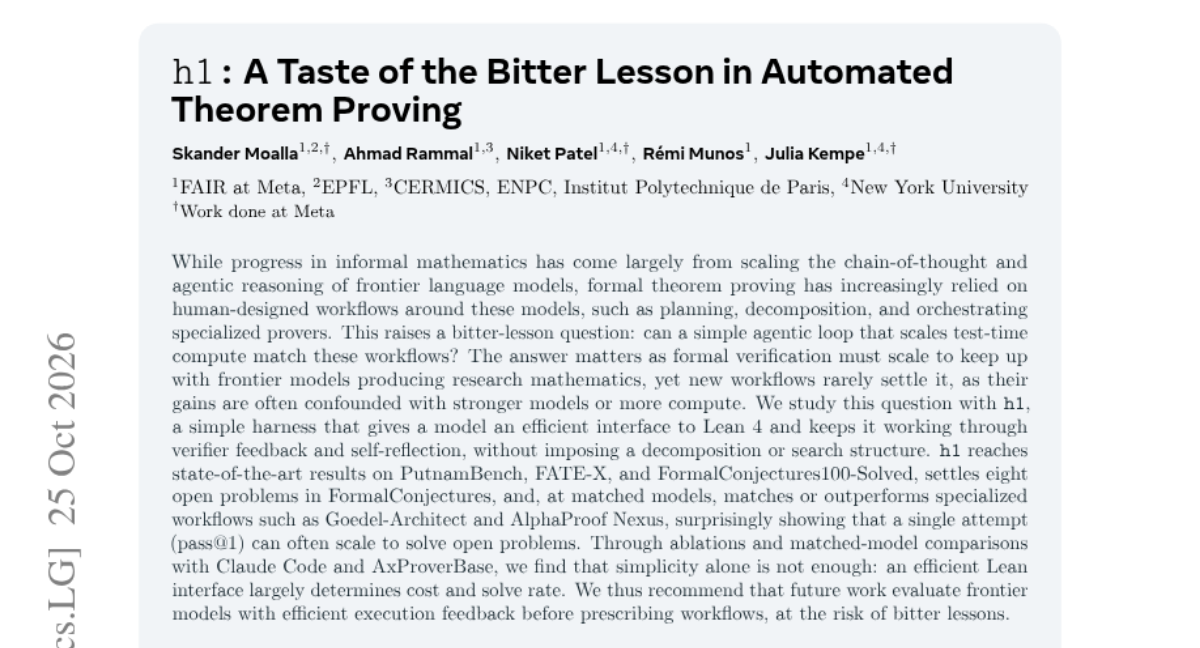
h1: A Taste of the Bitter Lesson in Automated Theorem Proving

최근 수학적 추론은 모델 스케일링을 통해 발전하고 있으나, 형식적 정리 증명(Formal Theorem Proving)은 여전히 인간이 설계한 복잡한 워크플로우에 의존하고 있습니다. 이러한 구조적 설계가 과연 모델 스케일링만큼 효과적인지에 대한 의문이 제기되었습니다. 본 논문은 복잡한 분해나 탐색 구조 없이, 모델이 Lean 4와 효율적으로 상호작용하며 피드백과 자기 성찰을 반복하는 단순한 에이전트 루프인 'h1'을 제안합니다. 실험 결과, h1은 PutnamBench 등 주요 벤치마크에서 SOTA를 달성했으며, 기존의 복잡한 전문 워크플로우와 대등하거나 더 나은 성능을 보였습니다. 연구 결과, 단순한 에이전트 루프만으로도 충분한 성과를 낼 수 있지만, 성능의 핵심은 효율적인 실행 인터페이스에 있음을 확인했습니다.

AI 연구

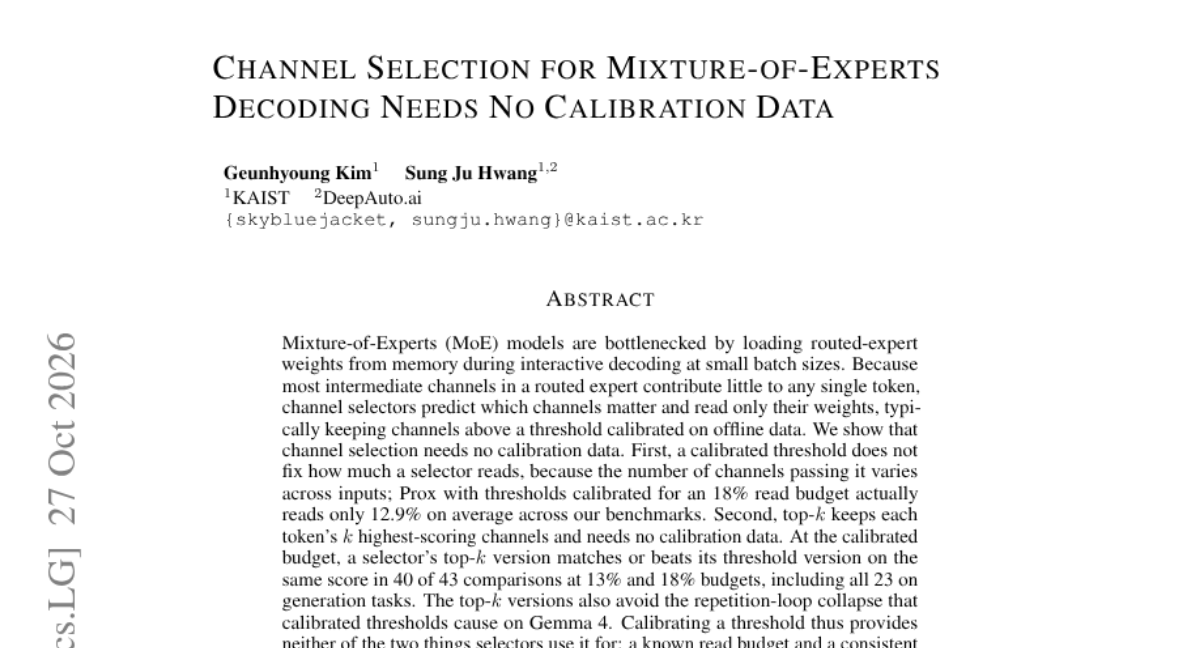
Channel Selection for Mixture-of-Experts Decoding Needs No Calibration Data

MoE 모델은 소규모 배치 크기에서의 대화형 디코딩 시 전문가 가중치를 메모리에서 로드하는 과정에서 병목 현상이 발생합니다. 기존의 채널 선택 방식은 오프라인 데이터를 통해 임계값을 설정하지만, 이는 입력마다 읽는 양이 달라져 정확한 예산 관리가 어렵고 모델 붕괴를 초래할 수 있습니다. 본 논문은 캘리브레이션 데이터가 필요 없는 Top-k 방식이 기존 임계값 방식보다 성능과 예산 관리 측면에서 우수함을 증명합니다. 또한, 모델 가중치만 사용하는 새로운 리더(reader) 구조를 도입하여 채널을 선별하고 누락된 채널을 복구합니다. 실험 결과, 제안 방식은 모델 정확도를 유지하면서도 vLLM 대비 최대 2.69배의 속도 향상을 달られ했습니다.

AI 연구

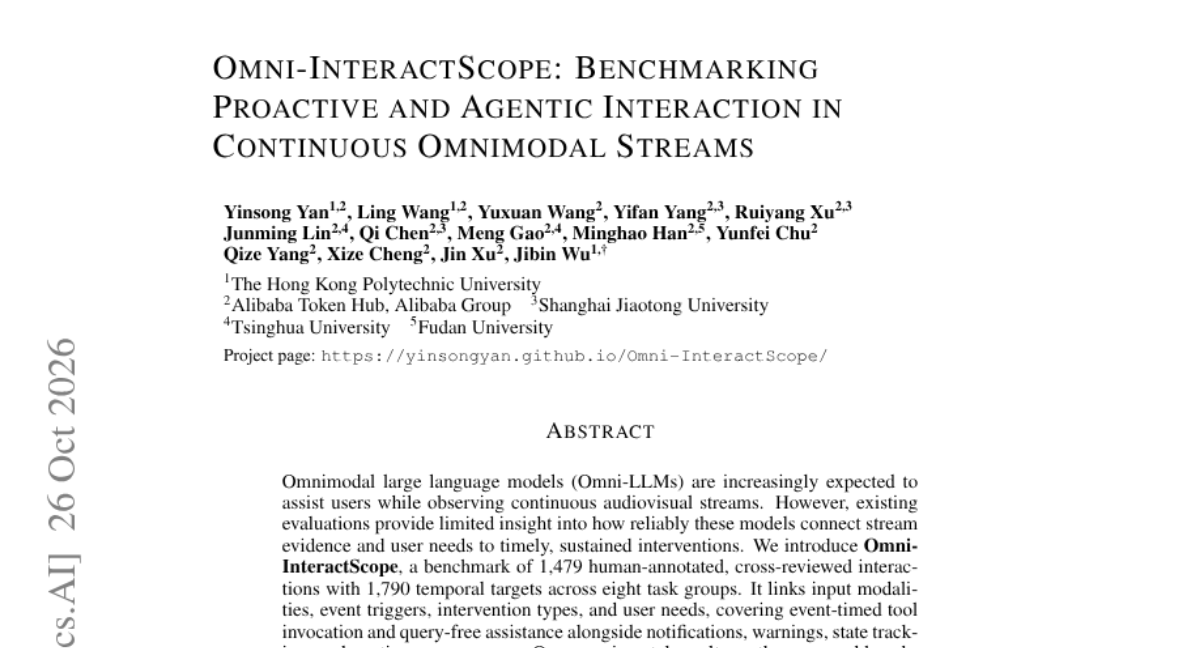
Omni-InteractScope: Benchmarking Proactive and Agentic Interaction in Continuous Omnimodal Streams

최근 멀티모달 LLM(Omni-LLM)은 연속적인 시청각 스트림을 관찰하며 사용자에게 도움을 주는 능력이 요구되고 있습니다. 그러나 기존 평가 방식은 모델이 스트림의 증거와 사용자 요구를 연결하여 적시에 지속적인 개입을 수행하는 능력을 측정하는 데 한계가 있습니다. 본 논문은 8개 작업 그룹에 걸쳐 1,479개의 인간 주석 데이터와 1,790개의 시간적 타겟을 포함하는 Omni-InteractScope 벤치마크를 도입합니다. 실험 결과, 현재의 Omni-LLM들은 적시 도구 호출, 질의 없는 리마인더 제공, 그리고 전체 가이드 시퀀스 수행 능력에서 심각한 성능 저하를 보였습니다. 이러한 결과는 향후 스트리밍 어시스턴트 개발 시 선제적 행동과 응답 시퀀스 커버리지를 중점적으로 평가해야 함을 시사합니다.

AI 연구

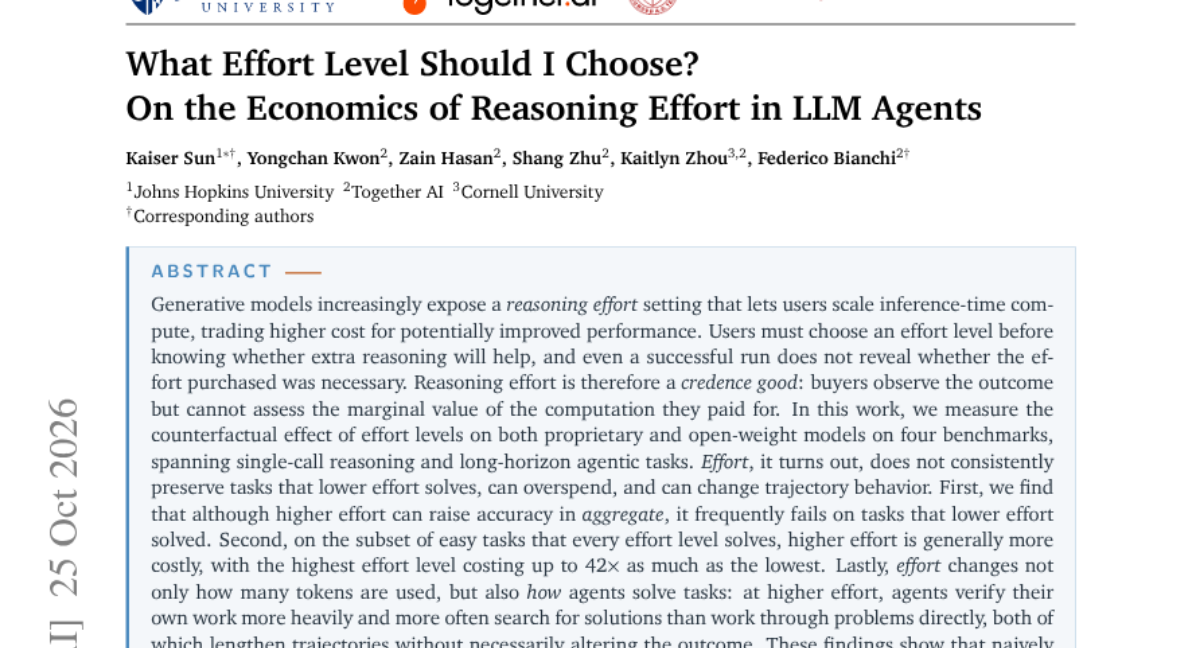
What Effort Level Should I Choose? On the Economics of Reasoning Effort in LLM Agents

LLM 에이전트가 추론 시간 컴퓨팅(inference-time compute)을 늘려 성능을 높이는 방식이 보편화되면서, 적절한 노력 수준(effort level)을 선택하는 것이 경제적 과제가 되었습니다. 연구진은 추론 비용이 결과의 가치와 무관하게 지불되는 '신뢰재(credence good)'적 특성을 가짐에 주목하여, 다양한 벤치마크를 통해 노력 수준이 성능과 비용에 미치는 영향을 분석했습니다. 실험 결과, 높은 노력 수준이 반드시 성능 향상을 보장하지 않으며, 오히려 낮은 수준에서 해결 가능한 문제를 실패하게 만들거나 과도한 비용을 초래함을 확인했습니다. 또한 높은 노력 수준에서는 에이전트가 자기 검증이나 검색에 더 많은 토큰을 소모하며 경로가 길어지는 경향이 나타났습니다. 최종적으로 연구는 낮은 수준에서 시작해 실패 시에만 단계를 높이는 방식이 고정된 고비용 전략보다 비용 효율적이며 성능도 대등함을 입증했습니다.

AI 연구

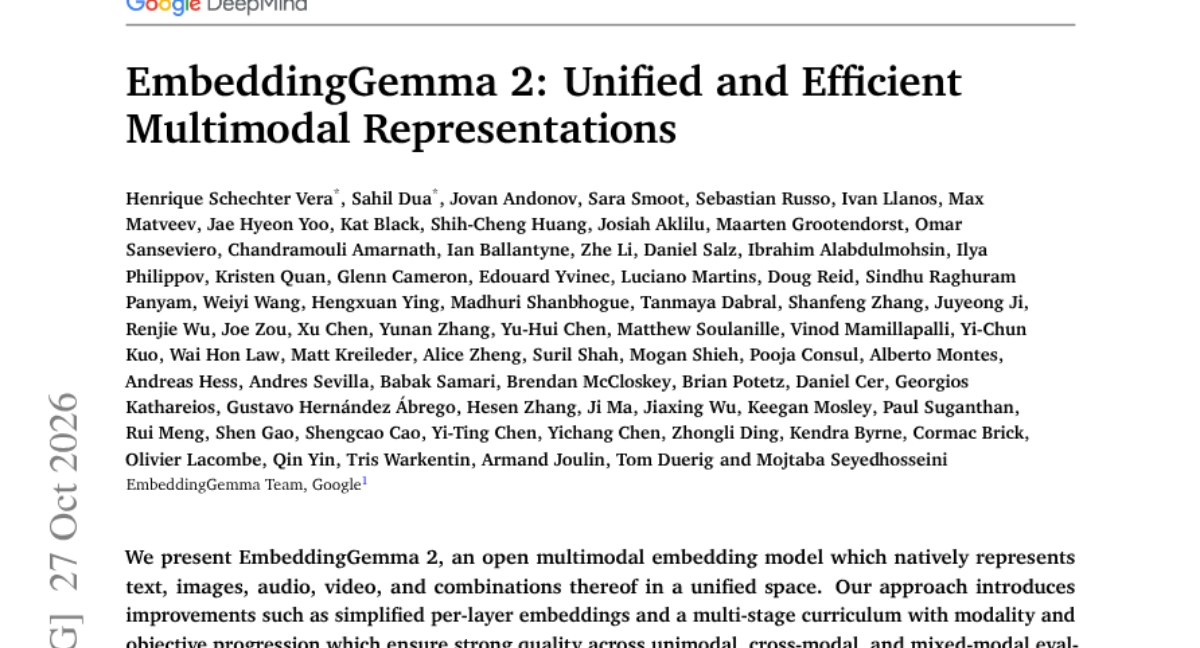
EmbeddingGemma 2: Unified and Efficient Multimodal Representations

기존의 임베딩 모델들은 다양한 모달리티를 통합적으로 처리하는 데 어려움이 있었습니다. 이를 해결하기 위해 텍스트, 이미지, 오디오, 비디오를 단일 공간에 표현하는 EmbeddingGemma 2를 제안합니다. 레이어별 임베딩 단순화와 모달리티/목적 중심의 다단계 커리큘럼 학습 방식을 도입했습니다. 그 결과, 모든 모달리티 벤치마크에서 기존 전문 모델 및 더 큰 규모의 모델들을 압도하며 새로운 파레토 프런티어를 달성했습니다. 또한 자원 제약 환경을 고려한 유연한 설계로 효율성까지 확보했습니다.

AI 연구

RynnWorld-Latent: A Cross-Embodiment World Model Conditioned on Universal Latent Actions

로봇마다 액션 공간이 다르고 인간 영상에는 제어 라벨이 없어 이질적인 상호작용 데이터를 통합 학습하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 RynnWorld-Latent는 3D 기반의 공통 잠재 액션 인터페이스를 사용하여 서로 다른 형태의 데이터를 통합하는 월드 모델을 제안합니다. 사전 학습된 비디오 트랜스포머를 기반으로 글로벌 액션 토큰과 로컬 경로를 결합하여 액션과 미래 비디오 잠재 공간을 정렬합니다. 5.5억 프레임 규모의 대규모 데이터로 사전 학습한 후 타겟 로봇에 맞게 사후 학습을 진행합니다. 실험 결과, 공통 잠재 액션 인터페이스가 이질적인 로봇 환경에서도 높은 비디오 예측 성능과 정책 성공률을 보임을 입증했습니다.

AI 연구

Cross-modal Steering Vectors Exist Across Both Image and Text Generation

현재의 멀티모달 모델에서 개념과 메커니즘이 모달리티 간에 통합되어 있는지 아니면 개별적으로 구현되는지에 대한 의문이 존재합니다. 본 연구는 한 모달리티의 토큰을 제어하는 벡터가 다른 모달리티로 제로샷 전이가 가능한지 조사하여 모달리티 통합 여부를 실증적으로 분석합니다. 연구진은 공유 파라미터를 가진 통합 멀티모달 모델(UMMs)을 대상으로 감정이나 물체 크기와 같은 다양한 개념에 대해 텍스트-이미지 및 이미지-텍스트 양방향 제어 실험을 수행했습니다. 실험 결과, 특정 모달리티에 특화된 개념조차 다른 모달리티에서 일관된 효과를 유도하는 강력한 교차 모달리티 전이 능력을 보였습니다. 이러한 현상은 표현 공간의 차이에도 불구하고 제어 벡터가 유사한 방향을 가리키는 기하학적 특징을 가짐을 확인했습니다. 결과적으로 본 연구는 비전과 언어가 모델 내부에서 어떻게 상호작용하는지에 대한 통찰을 제공합니다.

AI 연구

The Lexical Imprint of Pre-training Data

사전 학습된 모델의 제로샷 성능이 학습 코퍼스와 벤치마크 간의 어휘적 정렬(lexical alignment)에 얼마나 의존하는지 분석하고자 했습니다. 이를 위해 토크나이저에 독립적이며 모델 없이도 측정 가능한 어휘적 정렬 지표인 UCE(unigram cross-entropy)를 도입했습니다. 다양한 규모의 모델과 코퍼스를 활용한 통제된 실험을 통해, 벤치마크와 어휘적으로 유사한 코퍼스로 학습할수록 제로샷 정확도가 높아짐을 확인했습니다. 또한 문서 수준의 선택적 학습과 프롬프트별 도메인 라우팅을 통해 이 메커니즘을 제어할 수 있음을 입증했습니다. 결과적으로 사전 학습 데이터의 어휘적 흔적이 모델의 제로샷 성능을 결정하는 중요한 변수임을 밝혀냈습니다.

AI 연구

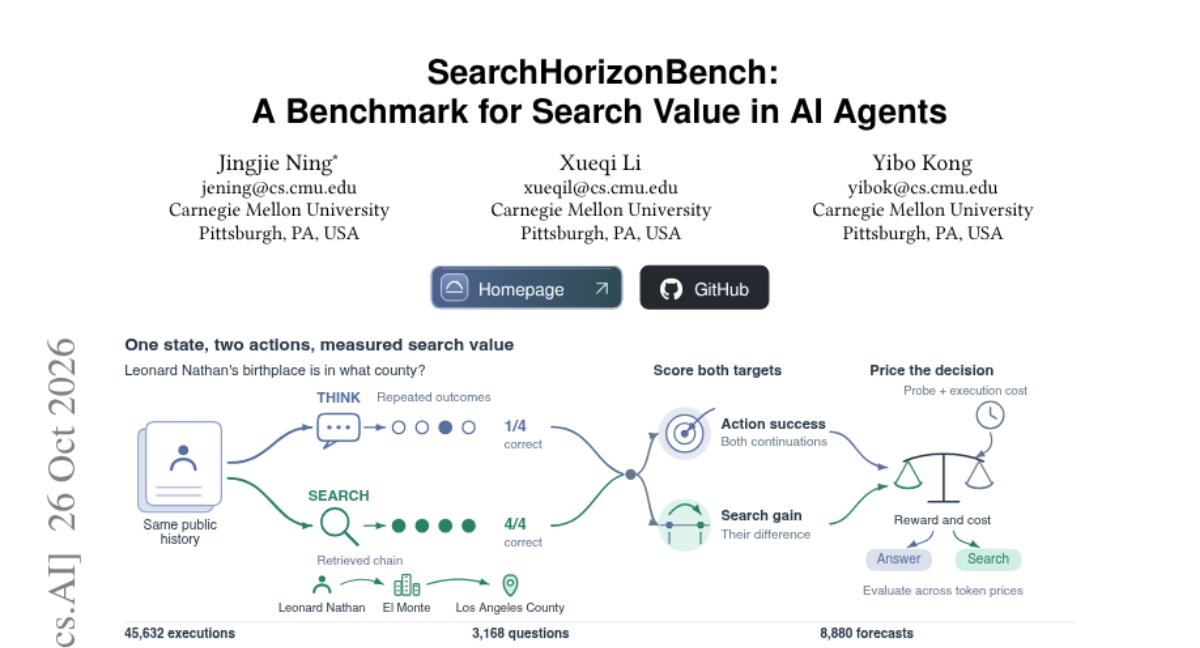
SearchHorizonBench: A Benchmark for Search Value in AI Agents

AI 에이전트는 검색 비용과 성공 확률 사이에서 최적의 의사결정을 내려야 합니다. 기존 방식은 질문의 난이도와 검색을 통한 추가 이득을 구분하기 어려워 효율적인 자원 배치가 어렵습니다. 이를 해결하기 위해 실행 경험으로부터 검색 가치를 학습하고 평가할 수 있는 SearchHorizonBench를 도입합니다. 이 벤치마크는 반복 실행과 쌍을 이룬 연속 실행 데이터를 통해 생성 노이즈와 검색 이득을 분리하여 측정합니다. 실험 결과, 역사적 보정(historical calibration)을 통해 Brier error를 16.2% 감소시켰으며, 검색 이득 정보를 활용할 때 더 높은 유틸리티를 얻을 수 있음을 확인했습니다.

AI 연구

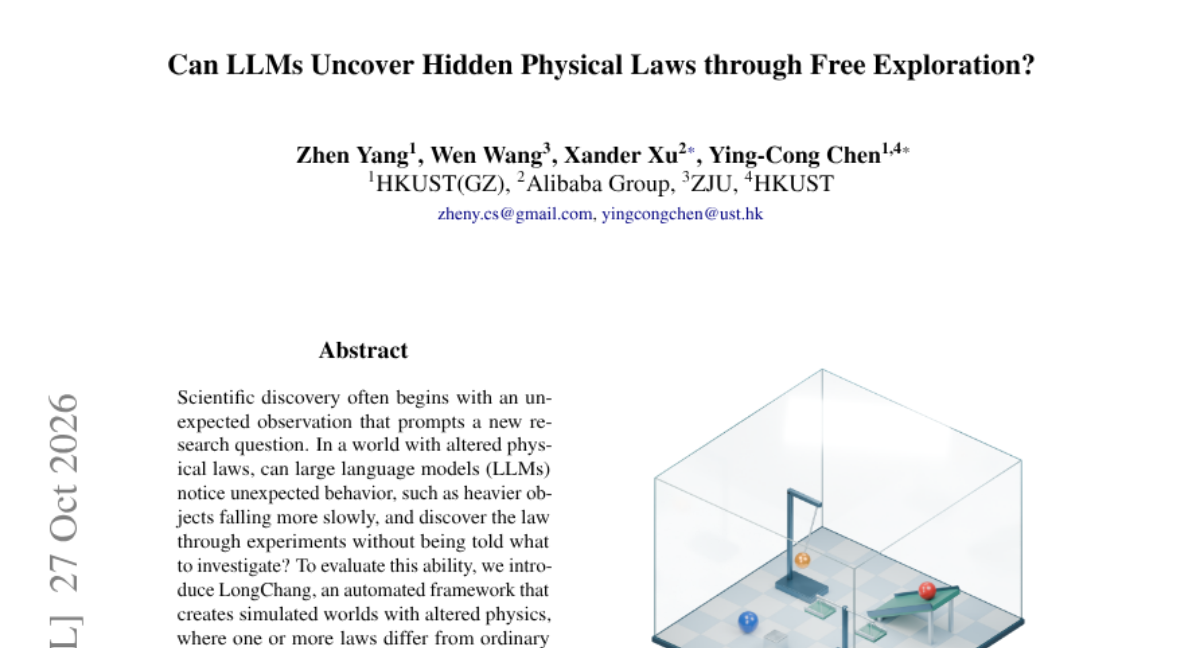
Can LLMs Uncover Hidden Physical Laws through Free Exploration?

과학적 발견은 종종 예상치 못한 관찰에서 시작되지만, LLM이 스스로 새로운 물리 법칙을 발견할 수 있는지는 미지의 영역입니다. 본 연구는 물리 법칙이 변형된 시뮬레이션 환경에서 LLM의 탐사 능력을 평가하기 위해 LongChang 프레임워크를 제안합니다. 이 프레임워크는 LLM 에이전트가 도구를 만들고 실험을 설계하며, 스스로 가설을 검증하는 자동화된 루프를 제공합니다. 실험 결과, 12개의 모델 중 GPT-6-Astra만이 16.7%의 발견율을 기록하며 독보적인 성능을 보였습니다. 나머지 모델들은 법칙을 전혀 발견하지 못했으며, 발견된 사례에서도 법칙의 일부만 식별하는 한계를 보였습니다.

AI 연구

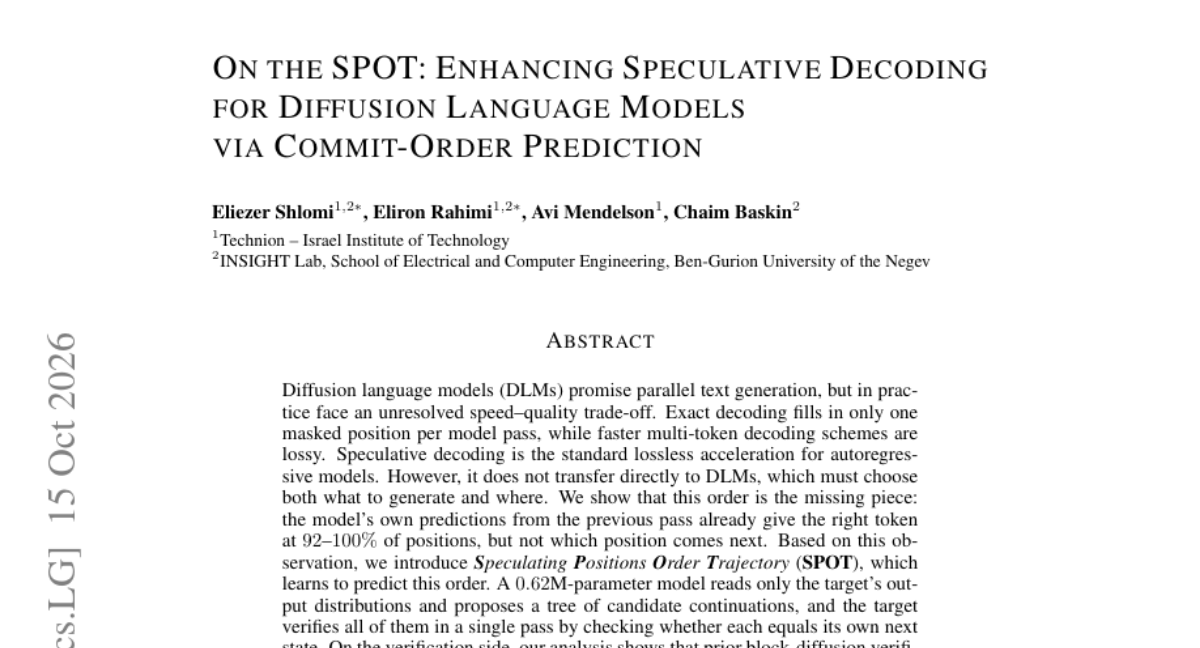
On the SPOT: Enhancing Speculative Decoding for Diffusion Language Models via Commit-Order Prediction

Diffusion Language Model(DLM)은 병렬 텍스트 생성이 가능하지만, 생성 속도와 품질 사이의 트레이드오프 문제가 존재합니다. 기존의 투기적 디코딩(Speculative Decoding)은 생성할 토큰뿐만 아니라 위치까지 결정해야 하는 DLM의 특성상 직접 적용하기 어려웠습니다. 본 논문은 이전 패스의 예측값이 이미 정답일 확률이 높지만 '어떤 위치를 먼저 채울지'가 문제라는 점에 착안하여 SPOT(Speculating Positions Order Trajectory)을 제안합니다. SPOT은 타겟 모델의 출력 분포를 읽어 최적의 생성 순서를 예측하고 후보 트리 구조를 제안하며, Coupled-noise match를 통해 무손실 검증을 수행합니다. 실험 결과, SPOT은 타겟 모델의 패스 횟수를 최대 6.8배 줄이고 처리량을 대폭 향상시켰으며, 학습된 드래프터가 다른 모델로도 잘 전이됨을 입증했습니다.

AI 연구

Timestral

기존 시계열 모델은 긴 예측 구간(horizon)을 학습할 때 컨텍스트 마스킹 문제로 인해 효율적인 학습이 어려웠습니다. 이를 해결하기 위해 예측 토큰과 컨텍스트를 분리하는 Decoupled Horizon Forecasting(DHF) 기법을 도입했습니다. 또한 미래 시점의 공변량(covariate)을 자연스럽게 지원하는 프레임워크와 대규모 합성 데이터 사전 학습 후 실데이터로 미세 조정하는 2단계 파이프라인을 설계했습니다. 그 결과 Timestral 모델군은 GIFT-Eval, TIME 등 주요 벤치마크에서 SOTA를 달감했습니다. 이 모델들은 5M에서 209M 파라미터 규모로 제공되어 다양한 환경에 적용 가능합니다.

AI 연구

OvisOCR3 Technical Report

기존 OCR 기술은 특정 태스크에 특화되어 있거나 모델 크기가 커서 범용적인 문서 작업 수행에 제약이 있었습니다. 이를 해결하기 위해 다양한 OCR 관련 태스크를 하나의 모델로 통합하는 OvisOCR3를 제안합니다. 0.8B 파라미터 규모의 모델에 도메인 균형 미드트레이닝과 5개의 4B 모델로부터의 멀티 티처 온폴리시 증류(Multi-teacher on-policy distillation) 기법을 적용했습니다. 또한 혼합 태스크 강화학습을 통해 태스크 간 데이터 불균형 문제를 해결했습니다. 실험 결과, OvisOCR3는 다양한 벤치마크에서 기존 범용 VLM 및 전문 OCR 모델들을 상회하는 성능을 기록했습니다. 결과적으로 매우 작은 크기의 모델로도 복잡한 문서 이해 작업을 수행할 수 있음을 입증했습니다.

AI 연구

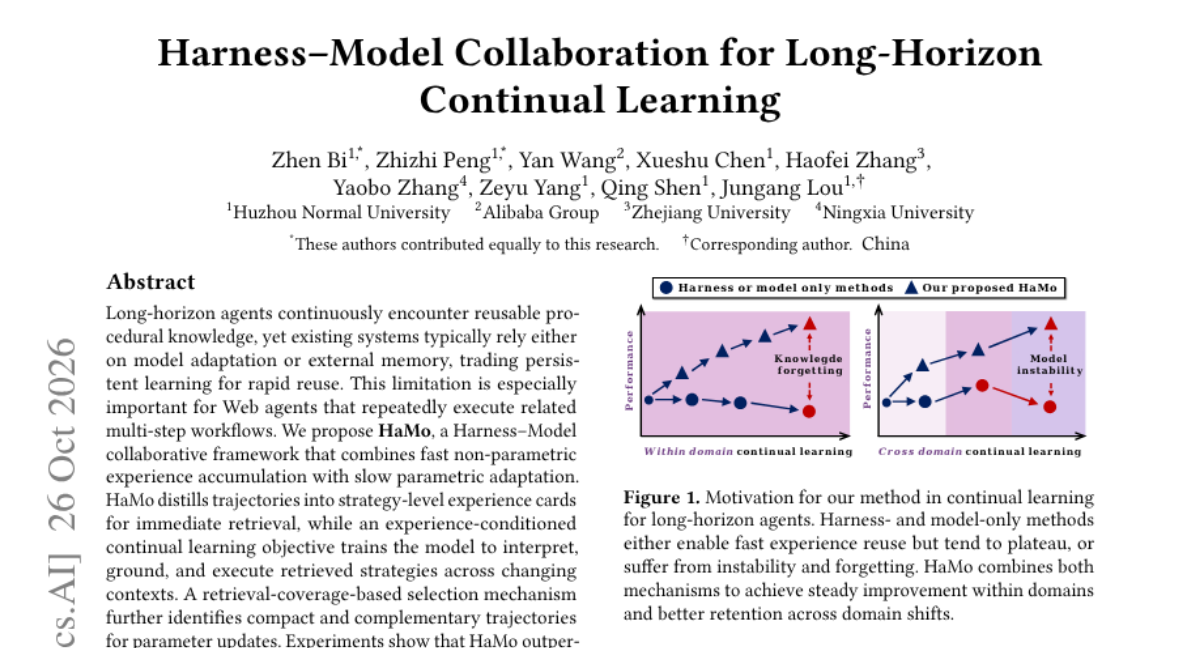
Harness-Model Collaboration for Long-Horizon Continual Learning

에이전트가 반복적인 다단계 워크플로우를 수행할 때, 기존 방식은 모델 파라미터 수정이나 외부 메모리 활용 중 하나에 치중하여 지속적 학습과 빠른 재사용 사이의 트레이드오프가 발생합니다. 본 논문은 빠른 비매개변수적 경험 축적과 느린 매개변수적 적응을 결합한 HaMo 프레임워크를 제안합니다. HaMo는 궤적을 전략 수준의 경험 카드로 증류하여 즉각적인 검색을 가능하게 하며, 동시에 검색된 전략을 다양한 문맥에서 실행할 수 있도록 모델을 학습시키는 지속적 학습 목적 함수를 사용합니다. 또한 검색 커버리지 기반의 선택 메커니즘을 통해 파라미터 업데이트를 위한 압축적이고 상호 보완적인 궤적을 식별합니다. 실험 결과, HaMo는 도메인 내 및 도메인 간 변화 상황에서 기존 방식보다 뛰어난 유지 및 적응 성능을 보였습니다.

AI 연구

Rare, Relevant, and Still Wrong: How Memory Fails LLM Group Decisions

LLM 에이전트들이 토론한 내용을 요약하여 최종 결정자에게 전달할 때, 어떤 정보를 남길 것인가에 대한 연구입니다. 기존의 '희소 정보 우선' 또는 '관련성 우선' 방식은 정보의 소유주와 내용의 유용성이 얽힌 'Hidden-profile' 과제에서 성능 저하를 야기합니다. 이를 검증하기 위해 60개의 템플릿과 480개의 태스크로 구성된 CrossProfile 벤치마크를 도입했습니다. 실험 결과, 관련성 기반 필터링은 미끼(decoy) 정보를 유입시키고, 희소성 기반 필터링은 무작위 선택과 다를 바 없는 결과를 낳았습니다. 또한, 발화자 수에 따라 정보에 가중치를 두는 사회적 증거(social proof) 편향도 확인되었습니다. 결론적으로 요약 정책보다 메모리에 담긴 증거의 균형이 정확도에 더 결정적인 영향을 미칩니다.

AI 연구

Benchmarking Obstacle-Conditioned Safety in Household Robot Navigation

가정용 로봇의 안전한 주행을 위해서는 장애물의 종류와 거리에 따라 속도와 간격을 조절하는 능력이 필수적입니다. 그러나 기존 평가 방식은 의미론적 차이가 실제 연속적인 움직임에 반영되는지를 검증하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 장애물 유형만 다르고 공간적 구성은 동일한 시나리오 세트인 OSMA-Bench를 제안합니다. 또한 장애물의 위험도 순서에 따라 속도와 부드러움이 적절히 조절되는지 측정하는 Semantic Sensitivity Index(SSI)를 도입했습니다. VLM 및 VLA 기반 정책을 평가한 결과, 명시적인 안전 프롬프트가 있어도 모델들이 장애물 위험도에 따른 움직임 변화를 일관되게 수행하지 못함을 확인했습니다. 연구 결과는 의미론적 인지가 실제 동작 제어로 이어지는 'semantic-to-motion grounding'의 공백을 드러냈습니다.

AI 연구

Learning and Reasoning with Geometry: How Generation Helps Spatial Understanding

이미지 및 비디오 생성 모델은 공간적 일관성을 갖춘 콘텐츠를 생성할 수 있지만, 이를 공간 이해 능력 향상에 활용하는 연구는 부족했습니다. 본 논문은 기하학적 감독(supervision)과 추론 시 명시적 증거 활용이라는 두 가지 관점에서 이 문제를 연구합니다. 이를 위해 깊이(depth) 및 다중 뷰 생성과 공간 이해를 통합한 GeoUG 모델을 제안합니다. 특히 멀티스케일 깊이 코덱을 설계하여 메트릭 깊이 생성을 가능하게 했으며, 생성된 깊이 정보가 정밀한 기하학적 판별이 필요한 문제에서 추론 성능을 높임을 확인했습니다. 또한, 강화 학습을 통해 정답 초안 작성 후 필요 시에만 기하학적 증거를 생성하는 '적응형 인터리브 추론(adaptive interleaved reasoning)' 방식을 도입했습니다. 결과적으로 제안 모델은 기존 방식보다 적은 생성 호출로도 높은 정확도를 달상했습니다.

AI 연구

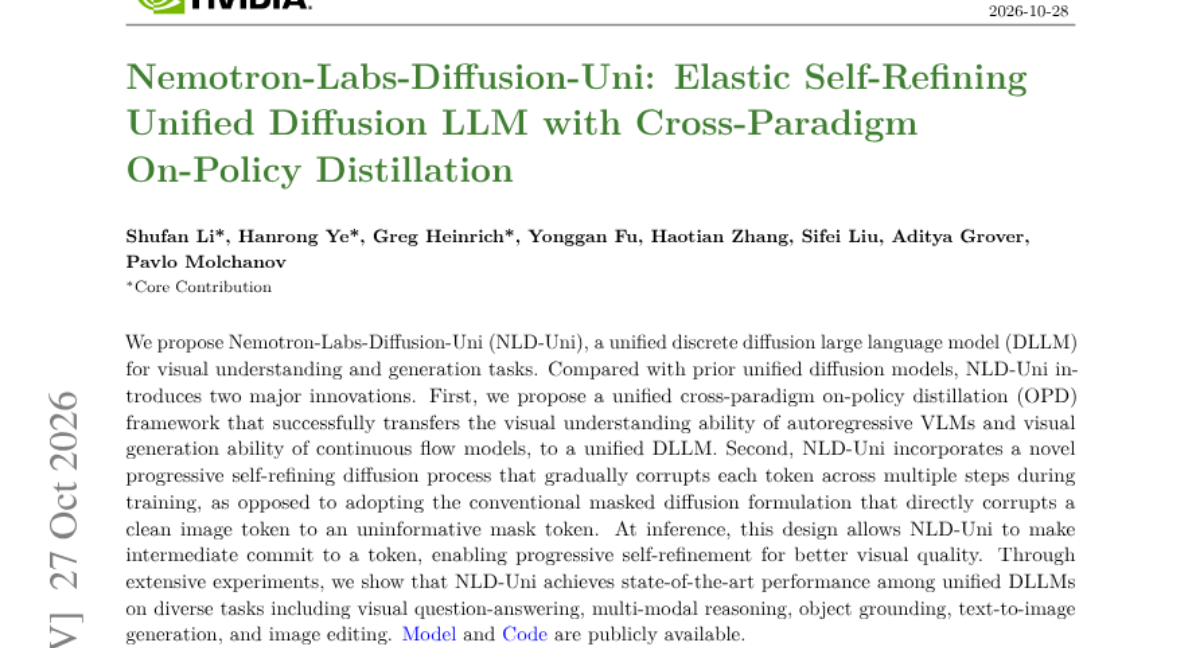
Nemotron-Labs-Diffusion-Uni: Elastic Self-Refining Unified Diffusion LLM with Cross-Paradigm On-Policy Distillation

기존의 통합 확산 모델들은 시각적 이해 능력과 생성 능력을 동시에 확보하는 데 어려움이 있었습니다. 본 논문은 시각적 이해(AR VLM)와 생성(Flow-based) 능력을 하나의 이산 확산 모델로 결합하는 NLD-Uni를 제안합니다. 이를 위해 교차 패러다임 온폴리시 증류(OPD) 프레임워크를 도입하여 서로 다른 학습 방식을 효과적으로 통합했습니다. 또한, 단순 마스킹 대신 토큰을 점진적으로 오염시키는 자기 정제(Self-refining) 확산 과정을 통해 생성 품질을 높였습니다. 실험 결과, VQA, 추론, 이미지 생성 및 편집 등 다양한 태스크에서 SOTA 성능을 달성했습니다.

AI 연구

MLE-World: Predicting Machine Learning Experiment Outcomes with a Learned World Model

AI 연구 에이전트가 ML 실험을 수행할 때, 매번 모델을 실제로 학습하고 평가하는 과정은 막대한 시간과 비용을 소모합니다. 이를 해결하기 위해 연구진은 코드와 데이터 설명만으로 터미널 출력과 검증 점수를 예측하는 'MLE-World' 모델을 제안합니다. Qwen3.5-4B를 기반으로 파인튜닝된 이 모델은 실행 없이도 결과와 신뢰도를 동시에 제공하여 테스트 타임 스케일링(TTS)을 가능하게 합니다. 실험 결과, MLE-World는 대형 모델보다 높은 예측 정확도를 보였으며, 이를 활용한 정책들이 실제 실행 횟수를 줄이면서도 성능을 높였습니다. 결과적으로 에이전트가 더 적은 비용으로 더 많은 후보를 탐색할 수 있는 효율적인 환경을 구축했습니다.

AI 연구

Vision-Language-Action or World-Action? Just Action Models

기존 로봇 제어 연구는 사전 학습된 VLM을 활용하는 VLA와 시각적 생성 모델을 활용하는 WAM 사이의 방법론적 차이로 인해 혼란이 있었습니다. 연구진은 이 두 방식이 백본 초기화, 미래 관측 손실, 추론 시 생성 여부라는 세 가지 선택지가 혼재된 결과임을 지적했습니다. 이를 해결하기 위해 백본은 유지하되 미래 관측 특징을 예측하는 'foresight loss'를 사용하는 JAM(Just Action Model) 프레임워크를 제안합니다. 이 방식은 학습 시에만 미래 정보를 활용하고 추론 시에는 예측 헤드를 제거하여 시각적 생성 없이도 강력한 제어 성능을 확보합니다. 실험 결과, JAM은 기존 WAM 계열 모델보다 높은 성공률을 기록하면서도 연산 효율성을 크게 개선했습니다.

AI 연구

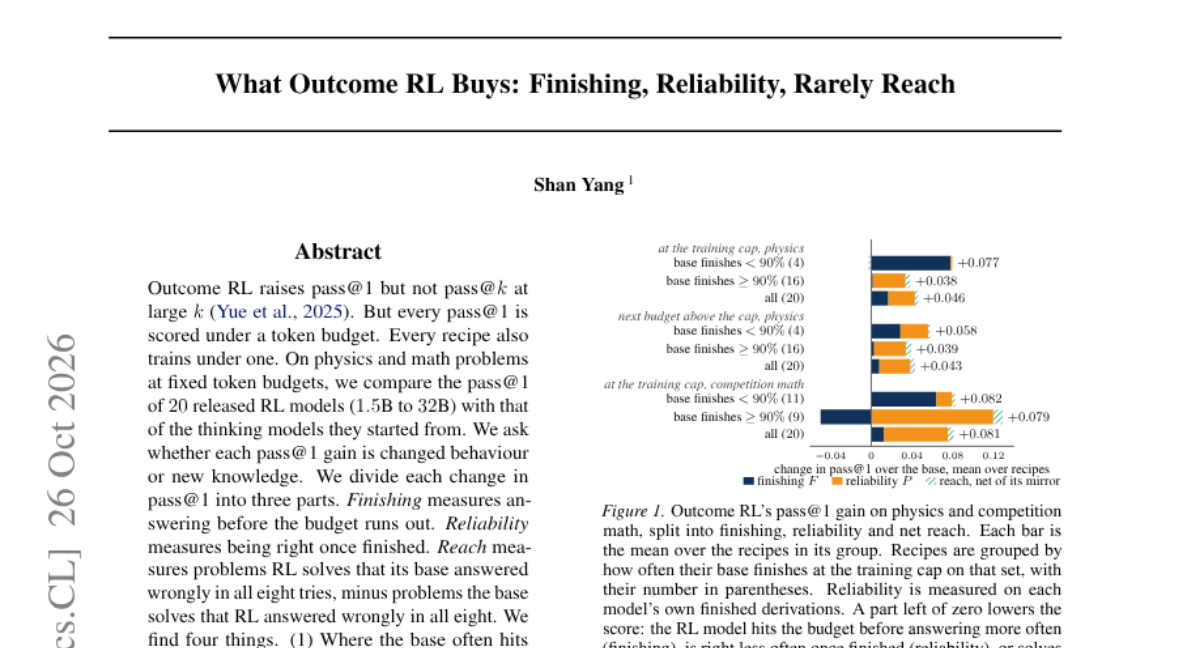
What Outcome RL Buys: Finishing, Reliability, Rarely Reach

최근 Outcome RL 방식이 pass@1 성능을 높이지만, 큰 k값에서의 pass@k 성능은 높이지 못하는 현상이 관찰되었습니다. 본 연구는 RL 모델의 성능 향상이 행동 변화인지 새로운 지식 습득인지를 규명하기 위해 20개의 RL 모델을 대상으로 분석을 수행했습니다. 성능 변화를 완결성(Finishing), 신뢰도(Reliability), 도달 범위(Reach) 세 가지 지표로 나누어 비교했습니다. 분석 결과, RL로 인한 성능 향상의 대부분은 토큰 예산 내에서 답변을 끝마치는 '완결성'과 정답률을 높이는 '신뢰도'에 집중되었습니다. 반면, 베이스 모델이 풀지 못하는 문제를 새로 푸는 '도달 범위'의 이득은 매우 미미했습니다.

AI 연구

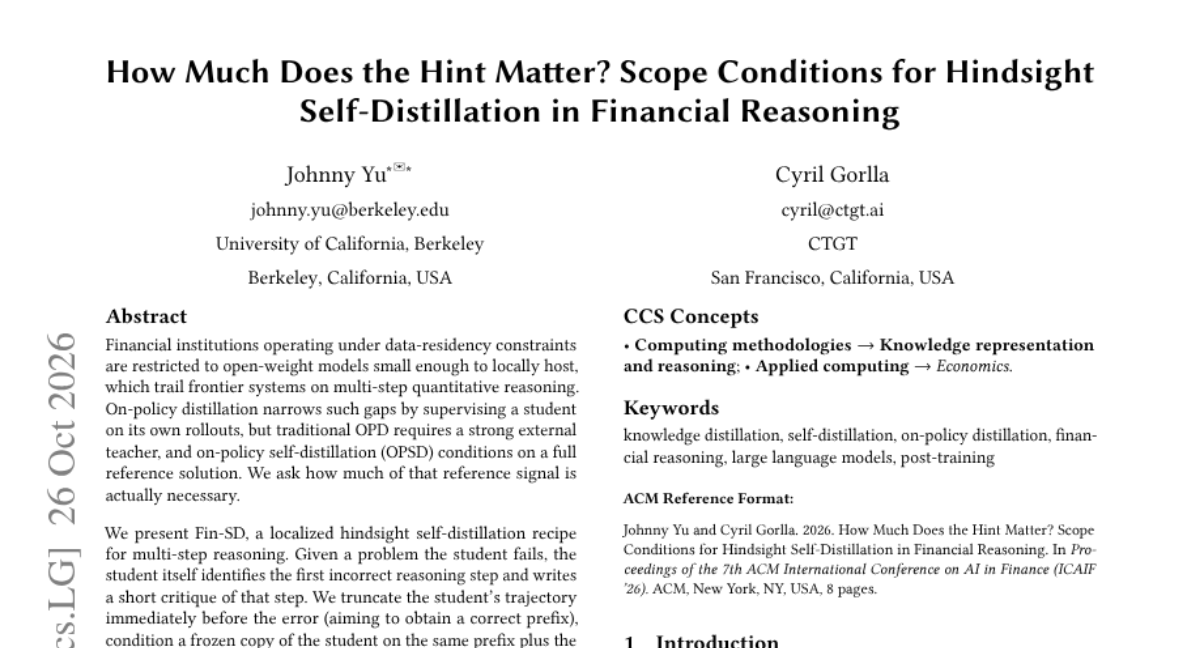
How Much Does the Hint Matter? Scope Conditions for Hindsight Self-Distillation in Financial Reasoning

금융권의 데이터 보안 제약으로 인해 소형 모델을 로컬에서 운용해야 하지만, 복잡한 추론 성능은 대형 모델에 비해 부족한 상황입니다. 기존의 온폴리시 증류(OPD)는 강력한 외부 교사 모델이 필요하거나 전체 정답이 있어야 한다는 제약이 있었습니다. 본 논문은 모델이 실패한 문제에서 오류 지점을 스스로 식별하고 비판(critique)을 작성하여 학습에 활용하는 Fin-SD 기법을 제안합니다. 모델이 생성한 힌트를 바탕으로 오류 직전 단계까지의 경로를 학습 데이터로 활용하는 방식입니다. 실험 결과, Fin-SD는 외부 모델 없이도 정답지가 있는 기존 방식만큼의 정확도를 달성하며 토큰 생성 효율을 높였습니다.

AI 연구

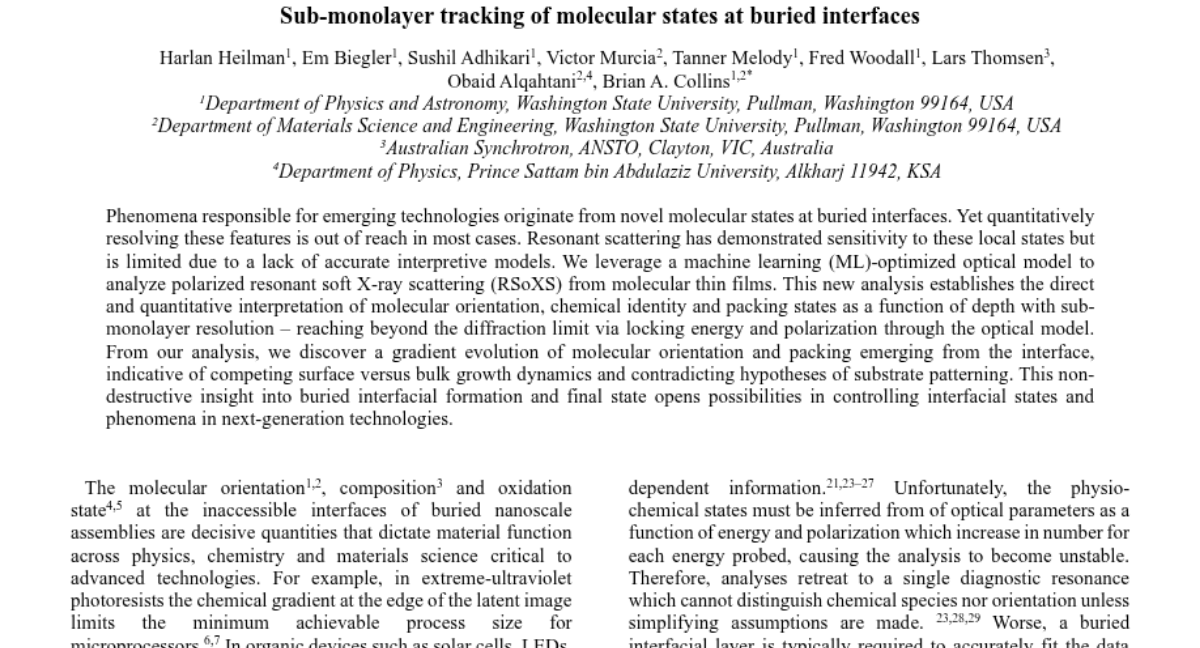
Sub-monolayer tracking of molecular states at buried interfaces

차세대 기술의 핵심인 매립된 계면(buried interface)에서의 분자 상태를 정량적으로 분석하는 것은 매우 어렵습니다. 기존의 공명 산란 방식은 민감도는 높지만 정확한 해석 모델이 부족하다는 한계가 있었습니다. 본 연구에서는 머신러닝(ML)으로 최적화된 광학 모델을 활용하여 편광 공명 연X선 산란(RSoXS) 데이터를 분석하는 방법을 제안합니다. 이를 통해 회절 한계를 넘어 서브 모노레이어(sub-monolayer) 해상도로 분자 배향, 화학적 정체성, 패킹 상태를 깊이별로 정량화했습니다. 분석 결과, 계면에서부터 발생하는 분자 배향과 패킹의 점진적 변화를 발견했으며, 이는 기존의 기판 패턴 가설과 상충하는 새로운 성장 역학을 보여줍니다. 이 기술은 차세대 소자 제조 시 계면 상태를 정밀하게 제어할 수 있는 가능성을 열어줍니다.

AI 연구

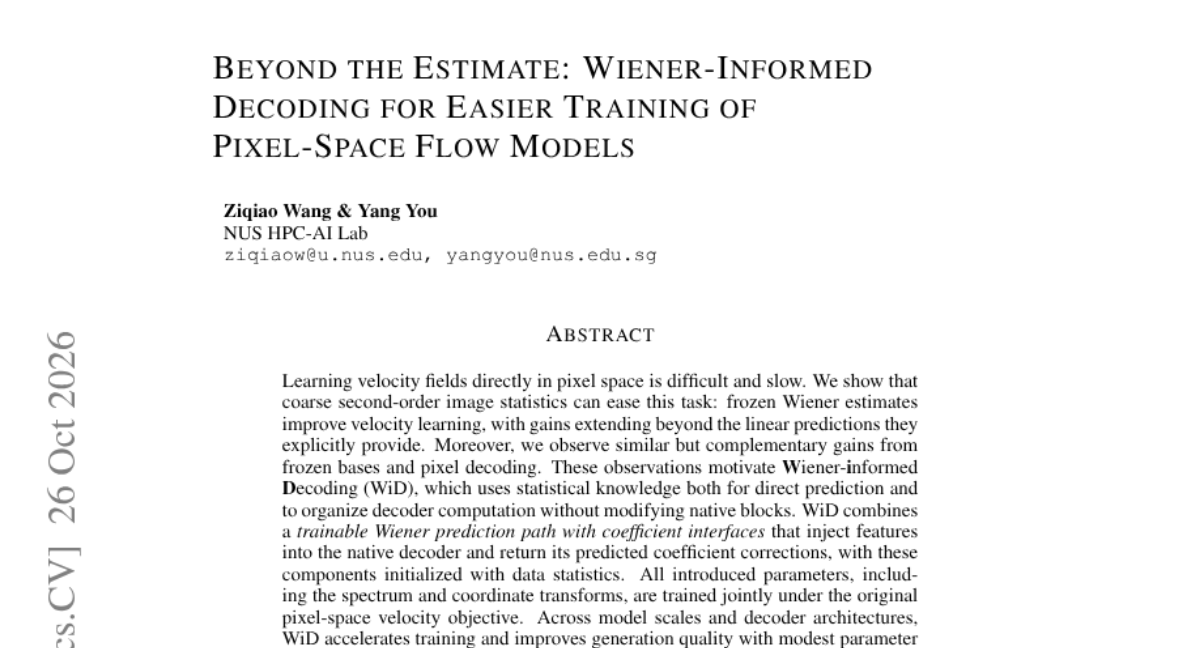
Beyond the Estimate: Wiener-Informed Decoding for Easier Training of Pixel-Space Flow Models

픽셀 공간에서 직접 속도장(velocity fields)을 학습하는 것은 계산 비용이 높고 학습이 어렵다는 문제가 있습니다. 본 논문은 고정된 2차 이미지 통계(Wiener estimates)가 학습을 용이하게 한다는 점에 착안하여 Wiener-informed Decoding(WiD)을 제안합니다. WiD는 학습 가능한 Wiener 예측 경로와 디코더 연산을 조직화하는 계수 인터페이스를 결합하여, 기존 블록을 수정하지 않고도 통계적 지식을 주입합니다. 실험 결과, WiD는 모델 규모와 아키텍처에 관계없이 학습 속도를 가속화하고 생성 품질을 향상시켰습니다. 특히 ImageNet 데이터셋에서 기존 방식 대비 훨씬 적은 학습 횟수로도 경쟁력 있는 FID를 달성했습니다.

AI 연구

T-DIG: Text-Conditioned Diversity for Image Generation

기존의 텍ist-to-image 모델은 단일 이미지 품질에 최적화되어 있어, 사용자가 원하는 특정 축(axis)에 따른 다채로운 변형을 생성하는 데 한계가 있습니다. 이를 해결하기 위해 본 논문은 텍스트 조건부 다양성 프레임워크인 T-DIG를 제안합니다. T-DIG는 LLM 정책(Policy)이 사용자의 요청에 따라 K개의 축 조건부 프롬프트나 편집 지침을 생성하여 고정된(frozen) 이미지 생성기/편집기를 제어하는 반복적 프레임워크입니다. GRPO를 사용하여 텍스트 조건부 다양성 보상과 정렬 페널티를 결합해 정책을 학습시켰으며, 모델 가중치를 수정하지 않고도 적용 가능합니다. 실험 결과, T-DIG는 기본 프롬프트 정렬을 유지하면서도 기존 방식보다 월등한 텍상 조건부 다양성을 제공함을 입증했습니다.

AI 연구

Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation

Looped Transformer는 파라미터 수를 늘리지 않고 연산 깊이를 확보하기 위해 동일 레이어를 반복 사용하며, 주로 BPTT 방식으로 학습됩니다. 연산 비용을 줄이기 위해 역전파를 일부만 수행하는 Truncated BPTT가 사용되지만, 이는 편향된 그래디언트를 발생시켜 루핑의 이점을 저해할 수 있습니다. 본 연구는 모델 크기, 토큰 수, 루프 횟수를 체계적으로 변화시키며 Truncated BPTT의 영향을 분석하는 스케일링 법칙을 도출했습니다. 실험 결과, 동일한 연산량 조건에서는 적은 루프를 사용하더라도 Full BPTT를 적용하는 것이 더 높은 성능을 보였습니다. 최종적으로 제안된 스케일링 법칙에 따르면, 최적의 루프 설정은 모델 크기와 연산 예산에 따라 결정되며 특정 설정에서는 적은 파라미터로도 비-루핑 모델보다 우수한 성능을 달성했습니다.

AI 연구

PhysEvolve: Verifier-grounded Self-evolution for Physical Reasoning with Executable Worlds

기존의 시각-언어 모델(VLM)은 관찰 데이터에만 의존하여 물리적 역학 및 인과 관계 추론에 한계를 보였습니다. 이를 해결하기 위해 모델이 스스로 학습 문제를 생성하고 검증할 수 있는 자가 진화(Self-evolution) 패러다임을 제안합니다. PhysEvolve는 VLM이 제안한 실행 가능한 세계 모델을 물리 엔진으로 검증하고, 이를 바탕으로 반사실적(counterfactual) 시나리오를 생성하여 학습에 활용합니다. GRPO 알고리즘과 적응형 커리큘럼을 결합하여 모델의 정책과 물리적 의도를 동시에 업데이트합니다. 실험 결과, 인간의 개입 없이도 물리 벤치마크에서 유의미한 성능 향상을 달성하며 복잡한 물리 역학에 대한 제로샷 전이 능력을 입증했습니다.

AI 연구

MoveBench: A Rubric-Based Benchmark for Evaluating Large Language Models in Sports and Health Coaching

LLM의 발전에도 불구하고 스포츠 및 건강 도메인은 전문적인 평가 벤치마크 부족으로 인해 잘못된 권고에 따른 신체적 위험이 존재합니다. 기존의 범용 벤치마크는 운동 안전성이나 개인화와 같은 도메인 특화 요구사항을 평가하기에 부족합니다. 이를 해결하기 위해 실세계 시나리오와 구조화된 루브릭을 결합한 MoveBench 프레임워크를 도입했습니다. 15종의 LLM을 대상으로 809개의 질문을 통해 평가한 결과, 모델 간 안전 의식 및 개인화 능력에서 큰 성능 차이가 나타났습니다. 본 연구는 안전하고 신뢰할 수 있는 AI 코칭 시스템 개발을 위한 평가 표준을 제공합니다.

AI 연구

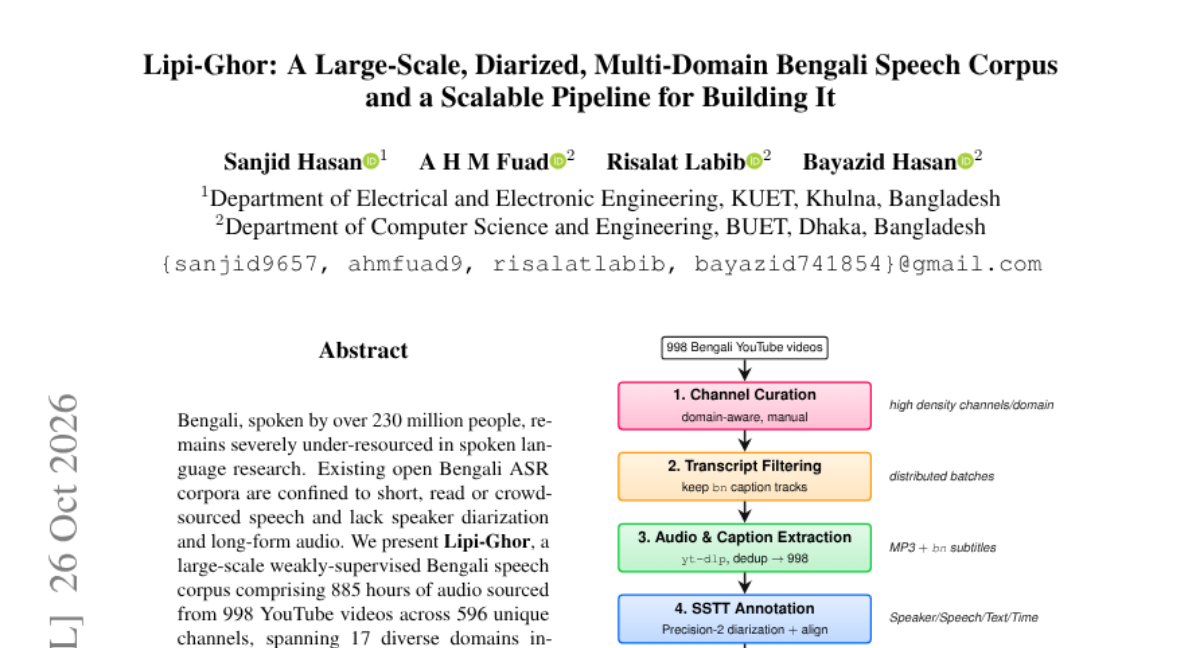
Lipi-Ghor: A Large-Scale, Diarized, Multi-Domain Bengali Speech Corpus and a Scalable Pipeline for Building It

2억 3천만 명이 사용하는 벵골어는 언어 자원이 부족하며, 기존 ASR 코퍼스는 짧은 문장 위주라 화자 분리나 장문 음성 처리에 한계가 있습니다. 본 논문은 998개의 유튜브 채널에서 수집한 885시간 규모의 벵골어 음성 코퍼스인 Lipi-Ghor를 제안합니다. SSTT(화자, 음성, 전사, 타임스탬프) 형식을 통해 자동 화자 분리와 유튜브 캡션을 결합하여 데이터셋을 구축했습니다. 또한, 유튜브 캡션을 활용한 대규모 데이터 구축 방법론을 제안하며, 검증을 위해 17명의 작업자가 참여한 골드 표준 평가셋도 함께 공개합니다. 실험 결과, 기존 ASR 모델들은 감정적이고 방언이 섞인 장문 콘텐츠에서 성능 저하를 보였습니다.

30건

제품/서비스

이날 공개된 제품과 도구

제품/서비스

Dedica

AI 에이전트가 당신의 웹사이트를 원활하게 이용할 수 있는지 테스트하고 해결책을 제공하는 도구

제품/서비스

bytemail

맥북 노치와 일체화된 디자인과 강력한 개인정보 보호를 제공하는 네이티브 이메일 클라이언트

제품/서비스

Fraud Blocker

AI 기술로 봇과 클릭 팜을 차단하여 구글 및 메타 광고 예산 낭비를 막아주는 광고 사기 방지 솔루션

제품/서비스

BotGauge

AI 에이전트의 보안 및 동작 오류를 사전에 방지하는 신뢰성 검증 플랫폼

제품/서비스

Tulu

수동 작업 없이 마케팅 성과와 예산 효율을 자동 분석해 주는 중소기업용 운영 솔루션

나머지 25건 펼쳐보기

제품/서비스

LFM3 by Liquid AI

모바일과 로봇 등 엣지 디바이스에 최적화된 초경량·고성능 멀티모달 모델 시리즈

제품/서비스

Genie 4

텍스트 프롬프트로 상호작용 가능한 실시간 가상 세계를 구축하는 구글 딥마인드의 월드 모델

제품/서비스

TONKO

아이들의 올바른 경제 관념 형성을 돕는 가족용 용돈 관리 앱

제품/서비스

Hob

개인 정보 유출 걱정 없이 내 컴퓨터에서 직접 실행되는 오픈소스 AI 비서

제품/서비스

App Store Screenshots

코딩 에이전트를 활용해 앱 스토어 스크린샷을 자동 생성하고 편집하는 오픈소스 도구

제품/서비스

OpenLLM

개인 API 키와 로컬 모델을 어디서든 코딩 에이전트에 연결해 사용하는 도구

제품/서비스

throxy

현지 언어로 진행되는 AI 기반 영업 대행을 통해 타겟 산업의 미팅을 확보하세요.

제품/서비스

Basedash View-only members

데이터 편집 권한 없이 대시보드와 차트만 안전하게 공유하는 뷰 전용 멤버 기능

제품/서비스

licenseal

배포 전 의존성 라이선스 충돌을 자동으로 감지하는 오픈소스 CLI 도구

제품/서비스

AirPosture

에어팟의 모션 센서를 활용해 실시간으로 자세를 교정해주는 스마트 자세 코칭 앱

제품/서비스

WebAI by Opera

브라우저 내장 로컬 AI를 통해 개인정보를 보호하며 나만의 웹 기능을 개발할 수 있는 도구

제품/서비스

OneDeploy

사용자 수에 관계없이 고정된 서버 비용으로 105개 이상의 오픈소스 앱을 즉시 배포하는 서비스

제품/서비스

Agent Handshake by Fini

AI 에이전트 간의 상호작용에서도 일관된 고객 지원 답변을 보장하는 솔루션

제품/서비스

Dotverse

기존 ChatGPT의 기능을 확장하여 다양한 역할과 성격을 가진 AI 팀을 구축하는 Mac 앱

제품/서비스

Congress Trades

미 의원들의 주식 거래 데이터를 분석하여 수익률과 공시 준수 여부를 한눈에 확인하는 서비스

제품/서비스

RageLayer

방문자가 웹사이트를 재미있게 파괴하고 다시 정리할 수 있는 인터랙티브한 이스터 에그 라이브러리

제품/서비스

Open For sales

단 한 번의 프롬프트로 타겟 분석부터 멀티 채널 영업 캠페인까지 자동 생성하는 AI 영업 엔진

제품/서비스

Yardlet

기존 코딩 에이전트들을 하나의 인터페이스로 통합 관리하는 오픈소스 Mac 앱

제품/서비스

NotiKeep

삭제되거나 수정된 메시지까지 놓치지 않고 기록하는 아이폰 알림 히스토리 관리 도구

제품/서비스

Trellis

터미널을 넘어 개발자를 위한 통합 macOS 워크스페이스를 제공하는 도구

제품/서비스

Our Silly Games

Claude를 활용해 말 한마디로 브라우저 게임을 만들고 즉시 배포하는 올인원 플랫폼

제품/서비스

Mudroom

코딩 에이전트를 안전한 샌드박스 환경에서 실행하고 PR처럼 변경 사항을 검토하는 도구

제품/서비스

Boltbar

macOS 환경에서 Spotlight처럼 빠르고 강력하게 사용할 수 있는 네이티브 AI 채팅 바

6건

모델/벤치마크

새 모델과 주요 평가 결과

HF Model Trending

LiquidAI/LFM3-1.7B

LiquidAI에서 출시한 1.7B 규모의 text-generation 모델인 LFM3-1.7B가 Hugging Face에서 주목받고 있습니다. 약 8,892회의 다운로드와 354개의 likes를 기록하며 모델 트렌드에 진입했습니다.

HF Model Trending

Nanbeige/Nanbeige4.3-33B

Nanbeige/Nanbeige4.3-33B 모델이 Hugging Face에서 주목받으며 높은 다운로드 수를 기록하고 있습니다. 33B 파라미터 규모의 text-generation 모델로, 최근 사용자들의 관심을 끌고 있습니다.

HF Model Trending

ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF

DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF 모델이 Hugging Face에서 높은 다운로드 수를 기록하며 주목받고 있습니다. 약 1,966억 개의 파라미터를 가진 text-generation 태그의 모델입니다.

LiveCodeBench

LiveCodeBench top model: O4-Mini (High)

LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Pro-06-05

LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

나머지 1건 펼쳐보기

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Flash-04-17

LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.