지난 소식

2026.10.31

이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.

20건

뉴스

주요 기사와 기업의 공식 발표

NBC News

Tech stocks wipe out more than $1.5 trillion as concerns deepen about the AI boom - NBC News

AI 인프라 구축을 위한 막대한 자본 지출(CAPEX)이 실제 수익(ROI)으로 직결되지 않는다는 회의론이 확산하며 나스닥 100 지수가 4.2% 급락하고 1.5조 달러 이상의 시가총액이 증발했습니다. Amazon과 Intel의 실적 발표가 촉매제가 되어, AI 모델 개발과 데이터 센터 구축에 투입되는 천문학적 비용에 대한 시장의 불확실성이 심화되었습니다.

Yahoo Finance

Markets lashed by tech rout as earnings fan AI fears - Yahoo Finance

미국 빅테크 기업들의 실적 부진이 AI 투자 과잉에 대한 시장의 공포를 자극하며 글로벌 기술주 폭락을 야기했습니다. 특히 Intel과 Amazon의 실적 발표가 AI 산업의 수익성 의구심을 증폭시키며 나스닥 지수가 급락하는 등 시장의 중심축이 기술주에서 안전 자산으로 이동하는 양상을 보였습니다.

Vatican News

Vatican hosts dialogue on AI and human dignity - Vatican News

바티칸과 글로벌 AI 전문가들이 모여 인공지능 기술의 급격한 발전 속에서 인간의 존엄성과 통제권을 유지하기 위한 윤리적·제도적 가이드라인을 논의했다. 이번 회담은 기술적 진보가 인류의 보편적 가치를 앞서지 않도록 '설계 단계부터의 사회적 정의(Social Justice by Design)'를 실현하는 것을 목표로 한다.

MIT News

Q&A: Hey AI, who should I vote for this year? - MIT News

MIT 연구진은 2026년 미국 중간선거를 앞두고 LLM(Large Language Model)이 정치적 담론과 유권자의 의사결정에 미치는 영향을 실시간으로 모니터링하는 'LLM Election Observatory' 대시보드를 구축했습니다. 이 프로젝트는 AI가 제공하는 정보의 편향성, 프레이밍(Framing), 그리고 사용자 프로필에 따른 응답 변화를 체계적으로 기록하여 투명한 데이터 환경을 제공하는 것을 목표로 합니다.

나머지 15건 펼쳐보기

CNN

Wall Street sell-off deepens as investors question returns on ‘monster AI splurge’ - CNN

AI 인프라에 대한 천문학적인 자본 지출(Capex)이 실질적인 수익(ROI)으로 연결되지 못한다는 우려가 커지며 월스트리트의 기술주 매도세가 심화되었습니다. 투자자들은 단순한 AI 기술 낙관론을 넘어, 막대한 데이터 센터 구축 비용이 기업의 재무제표와 현금 내용에 미치는 부정적 영향을 면밀히 검토하기 시작했습니다.

The University of Chicago Booth School of Business

Does the Economy Have Too Much Riding on AI? - The University of Chicago Booth School of Business

AI 산업에 대한 막대한 자본 투입이 글로벌 경제의 새로운 리스크 요인으로 부상함에 따라, 전문가들은 1999년 닷컴 버블과 현재의 구조적 차이 및 잠재적 금융 취약성을 분석합니다. 특히 하이퍼스케일러(Hyperscalers)와 칩 공급업체 간의 자금 순환 구조가 경제 전반에 미칠 영향에 대해 전문가들의 의견이 갈리고 있습니다.

BBC

Google value plunges by $500bn as its own AI search hits ad sales - BBC

Alphabet의 AI 기반 검색 요약 기능이 기존 검색 광고 수익을 잠식하는 '자기 잠식(Cannibalization)' 현상이 발생하며 시가총액이 5,000억 달러 급락했습니다. 이는 AI 기술로 인한 비즈니스 모델의 근본적 변화와 막대한 인프라 투자 비용 사이의 충돌을 보여주는 사례입니다.

Assembly Speaker Robert Rivas

ICYMI: Assembly Takes Action on AI Oversight at Special Committee Hearing - Assembly Speaker Robert Rivas

캘리포니아 주 의회가 AI Oversight(AI 감독 및 규제)를 위한 특별 위원회 청문을 개최하여 인공지능 기술의 사회적 영향과 규제 프레임워크를 논의했습니다. 이번 청문회는 AI 기술의 급격한 발전 속에서 공공 정책과 기술적 안전장치 사이의 균형을 맞추기 위한 정책적 움직임을 담고 있습니다.

Google DeepMind

Genie 4: A new generation of world simulation

Google DeepMind가 발표한 Genie 4는 실시간 상호작용이 가능한 차세대 월드 시뮬레이션 모델입니다. Gemini 모델을 기반으로 정교한 물리 엔진, 자연스러운 인체 움직임, 네이티브 오디오를 결합하여 현실적인 가상 세계를 구현합니다.

Google DeepMind

Gemini 4 Carbon: Our next frontier model

Google DeepMind가 차세대 프런티어 모델인 Gemini 4 Carbon을 공개했습니다. 이 모델은 최첨단 사이버 보안 기능과 장기적 추론 능력을 갖춘 가장 강력한 모델입니다.

Google DeepMind

Beyond tree cover: mapping the world’s forest types

Google DeepMind가 발표한 Forest Typology (ForTy) 2020은 지구의 토지를 6가지 산림 및 토지 이용 유형으로 분류한 글로벌 10미터 해상도 지도입니다. 이 데이터는 연간 시계열 정보를 포함하여 전 세계 산림 유형을 정밀하게 매핑합니다.

OpenAI News

Community safety report and new protections for teens

OpenAI가 ChatGPT 내 폭력 방지를 위해 안전 장치를 강화하고 청소년을 위한 새로운 보호 조치를 도입합니다. 또한 공공 안전 보고에 대한 새로운 약속을 통해 안전 관리 체계를 공고히 합니다.

OpenAI News

An updated Model Spec for more capable and beneficial AI

OpenAI가 더 유능하고 유익한 AI를 만들기 위해 업데이트된 Model Spec을 발표했습니다. 이 Spec은 AI가 올바른 판단을 내리고 인간의 주체성과 의도를 따를 수 있도록 돕는 다섯 가지 핵심 가치를 담고 있습니다.

OpenAI News

How we detect frontier model misalignment

OpenAI는 프론티어 모델의 정렬 불량(misalignment)과 승인되지 않은 에이전트 동작을 감지하기 위해 계층적 모니터링 방식을 사용합니다. 이를 통해 보안 사고가 심각해지기 전 대응팀이 개입할 수 있는 환경을 구축합니다.

Google Cloud AI

Expanding Claude availability and deployment choice on Google Cloud

Google Cloud에서 Anthropic이 직접 관리하는 Claude 모델 배포 옵션이 일반 제공(GA)됩니다. 이를 통해 개발자는 기존의 Google 관리형 옵션과 더불어 더 넓은 선택지를 갖게 되어 Google Cloud 내에서 AI 워크로드를 통합할 수 있습니다.

26건

커뮤니티

Hacker News, GeekNews, Reddit 반응

Hacker News

Patrick Stewart has died

배우 패트릭 스튜어트의 별세 소식이 전해지며 그가 남긴 예술적 업적과 삶의 태도에 대한 추모가 이어지고 있습니다. 커뮤니티에서는 그의 연기 철학과 사회적 영향력을 되새기는 반응이 주를 이룹니다.

Hacker News

Binance-hacker-1029 – $5.6B stolen from Binance

바이낸스에서 발생한 56억 달러 규모의 대규모 해킹 사건과 그에 따른 자산 동결 현황을 다루고 있습니다. 보안 사고의 원인으로 DevOps 엔지니어의 단말기 침해 가능성이 제기되며 보안 관리의 중요성이 부각되었습니다.

Hacker News

We're releasing the weights of Mistral Large 4

Mistral이 1조 개의 파라미터를 가진 멀티모달 모델인 Mistral Large 4(Le Chonk)의 가중치를 공개하며 오픈 웨이트 모델의 새로운 기준을 제시했습니다. 코딩과 사이버 보안 성능을 극대화하면서도 추론 효율성을 높여 비용 효율적인 배포가 가능하도록 설계되었습니다.

Hacker News

Why is this fingerprinting script creating bioweapons?

웹 브라우저 핑거프린팅 스크립트를 분석하여 수집된 데이터의 위험성을 경고하는 기술적 탐구 사례입니다. 10,000개 이상의 웹사이트를 크롤링하여 발견한 정교한 캔버스 핑거프린팅 기법과 그로 인한 프라이버시 침해 가능성을 다룹니다.

Hacker News

Ghostty 1.4

Ghostty 터미널의 1.4.0 메이저 업데이트가 발표되었으며, 성능 최적화와 그래픽 구현 기능이 대폭 강화되었습니다. 커뮤니티에서는 새로운 라이브러리 구조와 기존 터미널과의 기능 차이에 대해 활발한 논의가 이루어지고 있습니다.

나머지 21건 펼쳐보기

Hacker News

Apple's git still trusts the compromised eMudhra certificates

eMudhra 인증서 유출 사고 이후에도 Apple의 macOS 시스템이 해당 인증서를 여전히 신뢰하고 있어 발생하는 보안 취약점을 다룹니다. 이로 인해 macOS 시스템 라이브러리를 사용하는 git 등 다양한 도구들이 위험에 노출되었습니다.

Hacker News

Three new discoveries in mathematics, computer science, and physics

OpenAI가 수학, 컴퓨터 과학, 물리학 분야에서 이루어진 세 가지 새로운 발견을 발표했습니다. 커뮤니티에서는 이번 연구 성과와 OpenAI의 학술적 접근 방식에 대해 다양한 반응이 나오고 있습니다.

Hacker News

Microsoft offers mass buyouts for roughly a quarter of its workforce

Microsoft가 전체 인력의 약 4분의 1에 해당하는 대규모 희망퇴직 프로그램을 실시하며 조직 개편에 나섰습니다. 이에 대해 전직 직원들의 실무 생산성 저하 문제와 대규모 감원이 가져올 고용 시장의 충격이 주요 쟁점으로 떠오르고 있습니다.

Hacker News

Genie 4

Google DeepMind가 발표한 새로운 비디오 생성 모델 Genie 4에 대해 기술적 완성도와 생성 오류를 둘러싼 커뮤니티의 논쟁이 이어지고 있습니다. 기술적 진보를 높게 평가하는 시각과 생성된 영상 내 객체 일관성 문제를 지적하는 시각이 공존합니다.

Hacker News

Gemini 4 Carbon

Google의 새로운 Gemini 4 모델 라인업 발표와 이에 따른 모델 계층화 전략에 대한 기술적 논의를 다룹니다. 사용자들은 모델의 복잡한 구조와 실질적인 활용성 사이의 간극에 주목하고 있습니다.
GeekNews / Hada

ICE, 가면을 되찾으려 삭제 요청 대행업체를 고용하다

정부 기관의 유출된 데이터가 공익적 목적으로 활용될 때 발생하는 법적·윤리적 책임 소재를 다루고 있습니다. 개인정보 보호와 언론의 알 권리 사이의 대립이 기술적 플랫폼 운영의 핵심 쟁점으로 부상했습니다.

GeekNews / Hada

AI는 SRE를 대체하는 게 아니라 숙련도를 떨어뜨리고 있음

AI 자동화로 인해 운영 업무의 효율은 높아지지만, 엔지니어의 숙련도 저하라는 기술적 부채가 쌓이는 상황입니다. 향후 SRE는 자동화 시스템이 해결하지 못하는 고난도 문제를 해결할 수 있는 고도의 전문성을 유지하는 것이 핵심 과제가 될 것입니다.

GeekNews / Hada

63억 달러 규모 Binance 해킹, 단 20분 만에 실행됨

이번 사건은 핫월렛의 보안 취약점을 이용한 정교한 코드 삽입 공격이 대규모 자산 탈취로 이어진 사례입니다. 자동화된 공격 로직과 철저한 사전 테스트가 결합될 경우, 중앙화 거래소의 보안망이 순식간에 무력화될 수 있음을 시사합니다.

GeekNews / Hada

Azure의 가장 약한 고리, 테넌트 간 완전한 침해 취약점 5건

클라우드 서비스의 공유 자원 관리 구조에서 발생하는 권한 격리 실패가 이번 취약점의 기술적 핵심입니다. 테넌트 간 경계가 무너질 수 있는 설계 결함을 방지하기 위해 클라우드 서비스 제공업체의 엄격한 자격 증명 격리 정책이 필수적임을 시사합니다.

GeekNews / Hada

Pico CSS, 더 이상 유지보수하지 않음

AI가 코드 작성을 보조하며 필요한 스타일만 생성하는 시대가 오면서, 특정 목적에 특화된 최소형 프레임워크의 입지가 좁아지고 있습니다. 이는 프레임워크 중심의 개발 환경이 점차 생성형 AI 기반의 맞춤형 코드 생성 환경으로 변화하고 있음을 시사합니다.

Reddit

AI and Tech Stocks are in Free Fall

AI 및 기술주 주가가 급격한 하락세를 보이고 있다는 소식이 전해졌습니다. 시장의 변동성이 커지며 관련 기술주들에 대한 우려가 제기되는 상황입니다.

Reddit

Reading order is the part of PDF parsing that quietly breaks downstream NLP

PDF 문서의 읽기 순서 오류가 NLP 작업에 미치는 문제를 해결하기 위해 개발된 1.3B 규모의 문서 파싱 모델 OXR이 공개되었습니다. 이 모델은 레이아웃 분석과 텍스트 인식을 동시에 수행하여 표, 수식, 코드 등을 포함한 구조화된 데이터를 정확하게 추출합니다.

Reddit

vLLM now has PLE disk offload support on nightly

vLLM의 나이틀리(nightly) 빌드에 PLE 디스크 오프로드 기능이 추가되었습니다. 이를 통해 모델 추론 시 메모리 제약을 극복할 수 있는 새로운 가능성이 열렸습니다.

Reddit

What exactly is the ground truth for speech alignment task?

음성 정렬(Speech Alignment) 작업에서 인간이 주석을 단 데이터셋을 진정한 정답(Ground Truth)으로 간주할 수 있는지에 대한 의문을 제기하고 있습니다. 성능 평가의 기준과 최고 수준의 정렬 모델을 구축하는 방법, 그리고 그 성능을 검증하는 방식에 대한 기술적 고민을 담고 있습니다.
37건

논문

읽어볼 만한 AI 연구

AI 연구

Intrinsic Distribution Matching

최근 1~2단계의 적은 스텝으로 고품질 이미지를 생성하는 기술이 중요해졌으나, 적은 단계에서는 프롬프트 세부 사항을 정확히 렌더링하기 어렵습니다. 기존의 DMD 방식은 별도의 스코어 네트워크를 사용하지만, 본 논문은 명시적인 모멘트 제약(moment constraint)이 학습된 스코어 감독 성능을 개선할 수 있는지 질문합니다. 이를 위해 역-KL 발산(reverse-KL)을 가우시안 모멘트 성분과 비가우시안 잔차로 분해하여 제약 가능한 통계량을 식별했습니다. 제안하는 IDM 방식은 전체 DMD 보정 기능을 유지하면서, 외부 인코더 없이 생성기 자체의 EMA 복사본을 사용하여 피처 평균과 좌표별 표준편차를 일치시킵니다. 실험 결과, IDM은 Z-Image-Turbo 및 Qwen-Image 모델에서 기존 방식 대비 높은 텍스트-이미지 정렬 성능을 달리는 것을 확인했습니다.

AI 연구

A-RSI: Adaptive Task Refresh for Zero-Data Multimodal Self-Improvement

모델의 재귀적 자기 개선 과정에서 언제 새로운 학습 경험이 필요한지 결정하는 것은 매우 중요합니다. 기존 방식은 주로 어떤 데이터를 생성할지에만 집중하며, 모델의 불확실한 예측에 의존해 정답을 만드는 경향이 있습니다. 본 논문은 학습 로그의 보상 변화와 정확도를 모니터링하여 학습 신호가 감소할 때 과제를 갱신하는 A-RSI를 제안합니다. 정적 프로그램 라이브러리를 통해 멀티모달 질문과 정답을 생성하며, 외부 데이터나 인간의 라벨 없이도 검증 가능한 과제를 생성합니다. 실험 결과, 800개의 새로운 과제 도입만으로 주요 벤치마크 성능을 57.77에서 61.05로 향상시켰습니다.
AI 연구

Your Benchmark Is an Empirical Measure Over Difficulty

기존의 벤치마크는 단순한 문제 집합을 넘어 난이도에 대한 경험적 측도를 형성하지만, 이에 대한 이론적 분석은 부족했습니다. 본 연구는 벤치마크가 의도와 다르게 난이도 분포가 치우치는 '측도 불일치(measure mismatch)'와 특정 난이도 구간이 누락되는 '커버리지 공백(coverage gaps)' 문제를 정식화합니다. 이를 진단하기 위한 두 가지 지표를 제안하고 25개 주요 벤치마크를 분석한 결과, 많은 벤치마크가 특정 난이도에 편중되어 있음을 확인했습니다. 마지막으로 공백을 메우기 위해 난이도 타겟형 문항 재작성 알고리즘인 BenchFill을 제안합니다.

AI 연구

Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs

Diffusion Vision-Language Models(DVLMs)는 매 디노이징 단계마다 전체 입력(이미지 포함)을 처리하므로 막대한 연산 비용이 발생합니다. 기존의 시각 토큰 프루닝 방식은 정보 손실 위험이 있고 매 단계 이미지를 처리해야 한다는 한계가 있습니다. 본 논문은 이미지 없이 예측한 결과와 이미지 기반 예측이 일치하는 구간이 많다는 점에 착안하여, 예측 불일치가 발생할 때만 이미지를 처리하는 LOWN 방식을 제안합니다. LOWN은 예측 일치 여부를 통해 이미지 처리 여부와 언마스킹할 토큰 수를 동적으로 결정합니다. 실험 결과, 추가 학습 없이도 성능 저하를 최소화하면서 디코딩 FLOPs를 약 35.3% 수준으로 낮추는 성과를 거두었습니다.
AI 연구

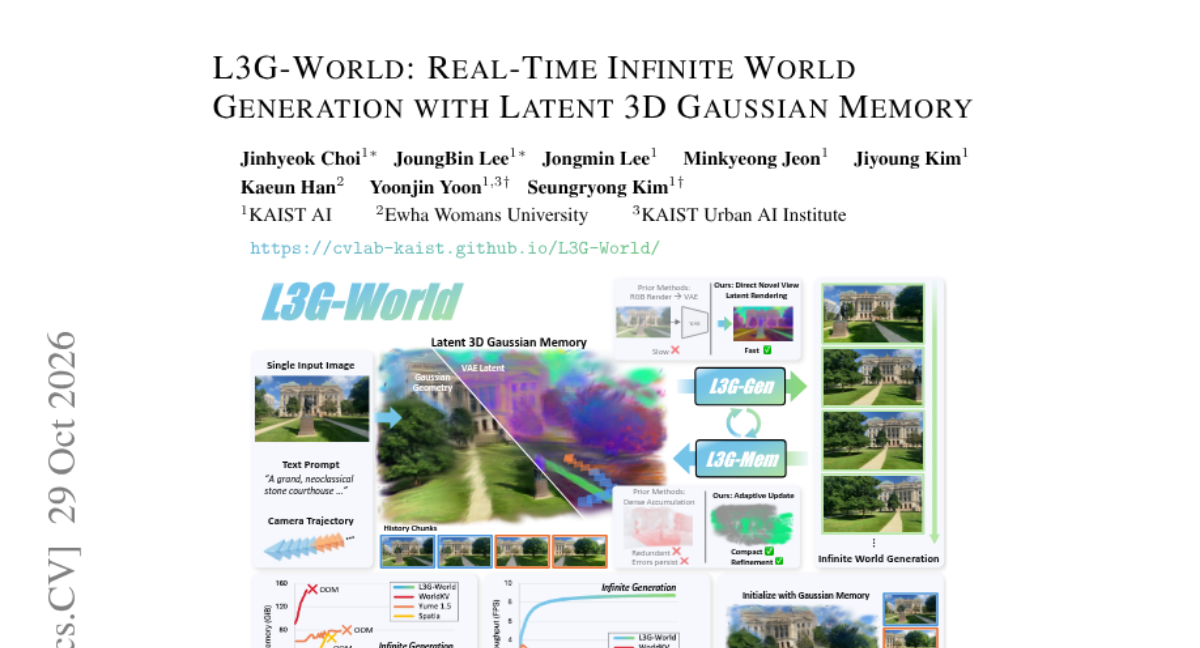
L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory

기존의 인터랙티브 월드 모델은 긴 시간 동안 탐험할 때 공간 일관성을 유지하기 어렵고, 메모리 크기가 생성 길이에 비례하여 늘어나는 문제가 있었습니다. 또한 기존 3D 메모리 방식은 렌더링 후 다시 인코딩하는 과정 때문에 실시간 생성이 불가능했습니다. 본 논문은 효율적인 피드포워드 재구성과 압축된 3D 표현을 결합한 Latent 3D Gaussian Memory(L3G)를 제안합니다. L3G-World는 메모리 업데이트 모듈과 비디오 확산 트랜스포머(DiT)가 교차로 작동하며 공간 일관성을 유지합니다. 메모리 업데이트는 관찰된 영역에 가우시안을 생성/정제하여 메모리 크기를 스트림 길이가 아닌 장면 크기에 맞게 관리합니다. 결과적으로 기존 방식 대비 압도적인 속도 향상을 달обра며 9 FPS의 실시간 세계 생성을 달성했습니다.
나머지 32건 펼쳐보기

AI 연구

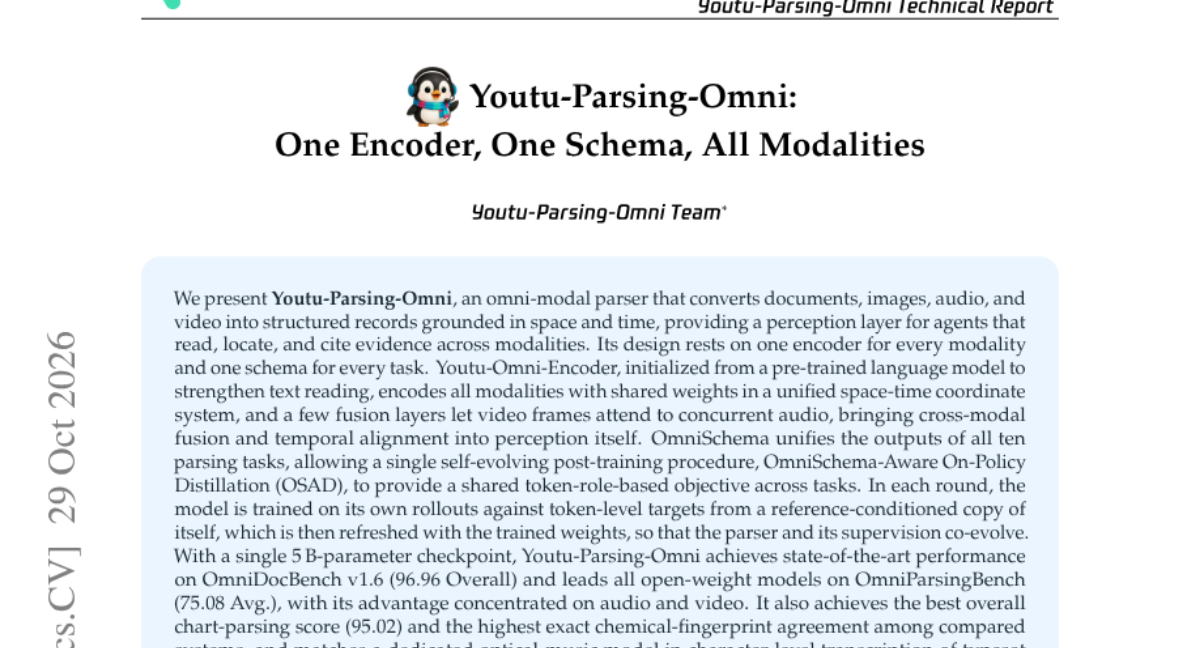
Youtu-Parsing-Omni: One Encoder, One Schema, All Modalities

기존의 멀티모달 모델들은 다양한 데이터 형식을 처리하기 위해 복잡한 구조를 요구하는 경우가 많았습니다. 본 논문은 모든 모달리티를 하나의 인코더와 하나의 스키마로 통합하는 Youtu-Parsing-Omni를 제안합니다. Youtu-Omni-Encoder는 공유 가중치를 통해 시공간 좌표계 내에서 모든 모달리티를 인코딩하며, OSAD라는 자기 진화형 사후 학습 방식을 통해 태스크 간 정렬을 수행합니다. 실험 결과, 이 모델은 OmniDocBench 및 OmniParsingBench 등 주요 벤치마크에서 SOTA 성능을 달كيل 뿐만 아니라 차트 및 악보 파싱에서도 탁월한 성능을 보였습니다. 결과적으로 단일 5B 파라미터 체크포인트만으로 강력한 범용 파싱 능력을 입증했습니다.

AI 연구

WorkFactory: Turning Professional Intents into Executable Work for Scalable Agent Training

에이전트의 지도 학습을 위해서는 신뢰할 수 있는 전문가 데모가 포함된 다양한 전문 작업 데이터가 필요합니다. 그러나 작업 정보가 누락되거나 일관되지 않으면 작업 수행이 방해받고 학습 품질이 저하되는 문제가 발생합니다. 이를 해결하기 위해 의도로부터 정보 지원 그래프를 구축하여 작업 인스턴스화를 가이드하는 WorkFactory 프레임워크를 제안합니다. 프로브 실행(Probe executions)을 통해 정보 부족을 식별하고 작업을 수정함으로써 실행 가능한 태스크를 생성합니다. 이를 통해 612개 직업군에 걸친 11만 개 이상의 작업을 구축하고 WorkPilot 모델 시리즈를 학습시켰습니다. 실험 결과, 제안된 방법론이 전문 작업 벤치마크 성능을 크게 향상시킴을 확인했습니다.

AI 연구

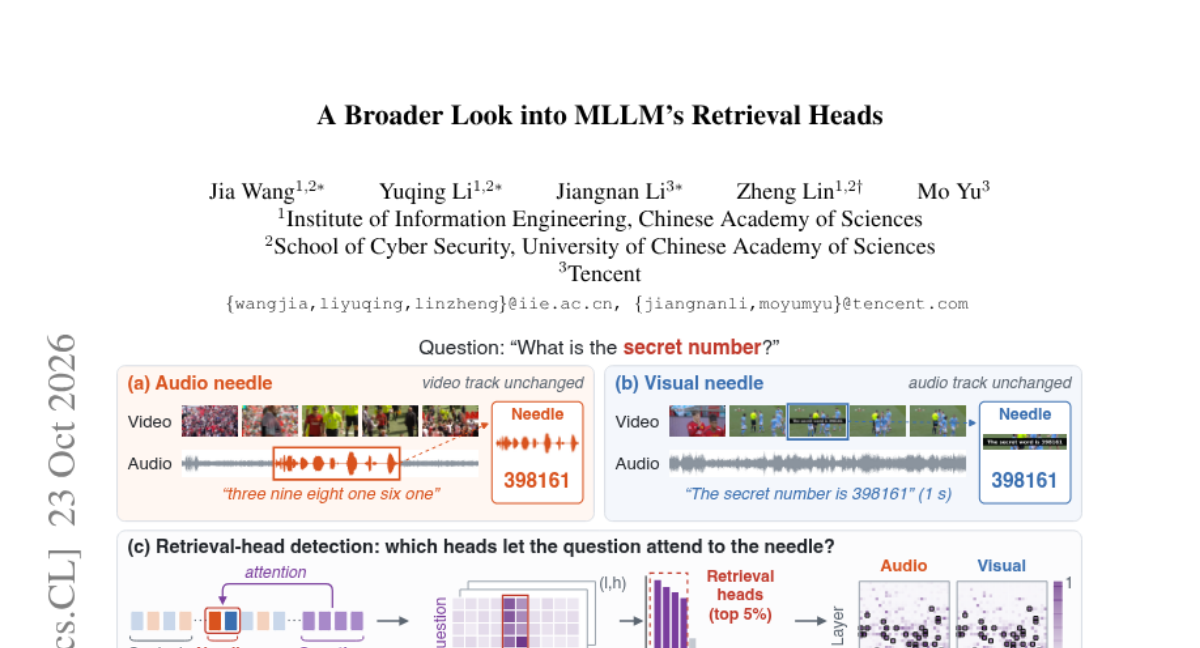
A Broader Look into MLLM's Retrieval Heads

멀티모달 거대언어모델(MLLM)은 긴 입력에서 관련 증거를 찾는 능력이 중요하지만, 기존 연구는 특정 모달리티에 국한되어 있었습니다. 본 논문은 오디오-비주얼 등 다양한 모달리티가 추가될 때 retrieval heads의 메커니즘이 어떻게 확장되는지 분석했습니다. 실험 결과, retrieval heads는 모달리티 간에 상당 부분 공유되며 매우 희소한(sparse) 형태로 존재함을 확인했습니다. 이러한 heads를 랭킹 목적 함수로 최적화함으로써 문서 이해 및 멀티모달 검색 성능을 유의미하게 개선했습니다. 결과적으로 기능적 어텐션 헤드는 모델 분석과 성능 향상 모두를 위한 핵심 요소임을 입증했습니다.

AI 연구

Read, Allocate, Route: Role-Coupled Tokenization for Pixel-Space Generative Transformers

픽셀 공간의 생성 트랜스포머는 패치당 하나의 토큰을 사용하여 고해상도 디테일을 구현할 때 연산 비용이 급증하는 문제가 있습니다. 저자들은 저주파 구조는 글로벌 통신이 필요하지만, 고주파 디테일은 국소적 모델링만으로도 충분하다는 점에 주목했습니다. 이를 위해 각 공간 앵커를 여러 슬롯으로 확장하고 DCT 계수를 분할 할당하는 SpecSlot 방식을 도입했습니다. 저주파 슬롯만 글로벌 어텐션에 참여시키고 나머지 슬롯은 로컬로 상호작용하게 하여 시퀀스 길이를 유지하며 디테일을 높였습니다. 실험 결과, ImageNet 고해상도 생성에서 기존 모델 대비 낮은 연산 비용(FLOPs)으로 더 우수한 FID 성능을 달성했습니다.

AI 연구

Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models

사용자의 멀티모달 요청을 실제 작동하는 애플리케이션 수정으로 변환하는 에이전트 평가의 필요성이 커지고 있습니다. 본 논문은 26,314개의 실제 사용자 코딩 세션에서 추출한 273개의 태스크로 구성된 Co-Design Bench를 소개합니다. 이 벤치마크는 로컬 편집(ME)과 저장소 편집(RE) 두 트랙을 통해 이해도, UI 변환, 기능 구현 능력을 평가합니다. 평가를 위해 정답 코드 대신 전문가가 작성한 2,331개의 수락 기준(acceptance criteria)과 검증 프로토콜을 사용합니다. 실험 결과, 모델들은 부분적인 요구사항은 충족하지만 전체 태스크를 완벽히 완수하는 데는 어려움을 겪는 것으로 나타났습니다.

AI 연구

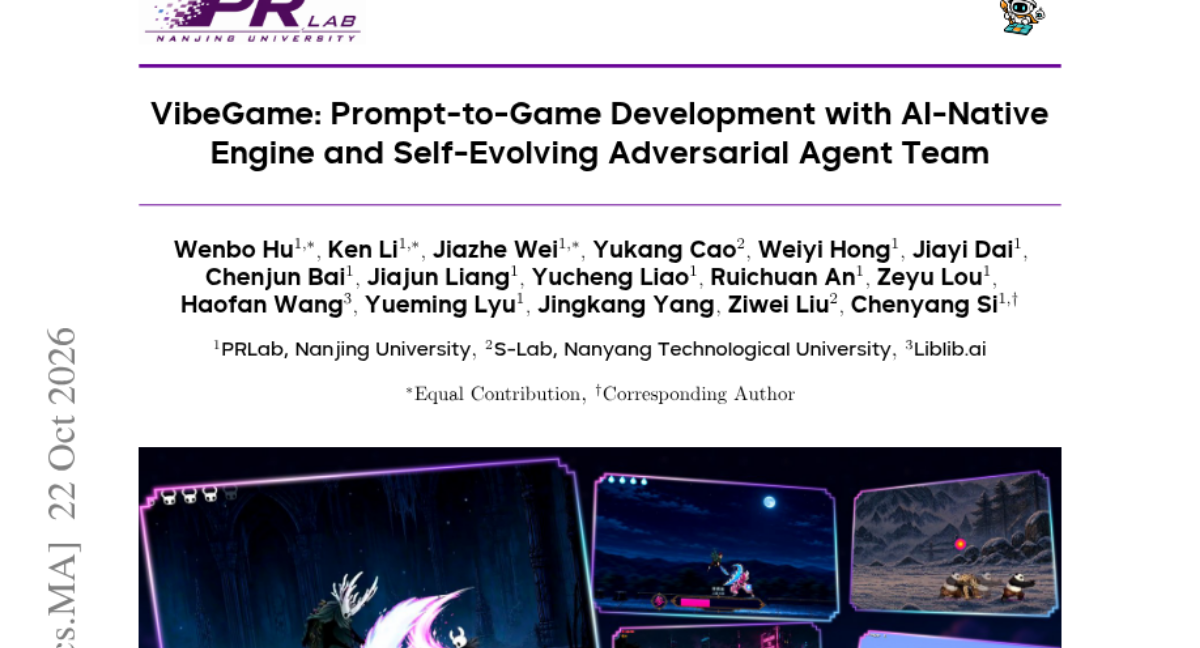
VibeGame: Prompt-to-Game Development with AI-Native Engine and Self-Evolving Adversarial Agent Team

LLM 에이전트를 통한 소프트웨어 개발은 발전하고 있으나, 코드와 에셋, 물리 엔진 등이 복합적으로 작용하는 게임 개발로의 확장은 여전히 어렵습니다. 본 논문은 자연어와 이미지를 통해 완전한 2격 2D 게임 프로젝트를 생성하는 VibeGame 프레임워크를 제안합니다. 이 시스템은 게임 상태를 스키마 검증이 가능한 구조화된 텍스트로 표현하는 AI 네이티브 엔진을 통해 에이전트가 상태를 검사하고 동작을 검증할 수 있게 합니다. 또한, 8개의 전문 에이전트로 구성된 적대적 에이전트 팀(Adversarial Agent Team)을 통해 구현과 리뷰를 분리하여 문제 해결 루프를 구축했습니다. 마지막으로 생성된 프로젝트를 재사용 가능한 모듈로 정제하는 자기 진화 메커니즘을 도입했습니다. 실험 결과, VibeGame은 기존 에이전트 프레임워크 대비 뛰어난 게임 생성 성능을 입증했습니다.

AI 연구

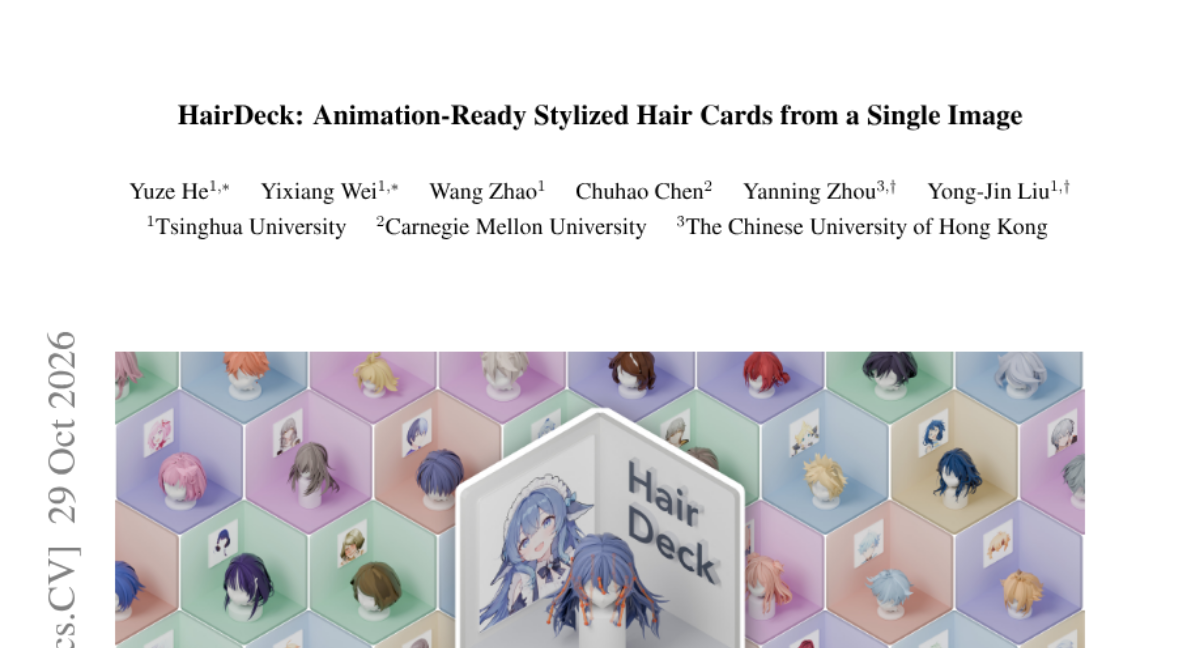
HairDeck: Animation-Ready Stylized Hair Cards from a Single Image

게임 및 아바타 제작 시 스타일라이즈드 캐릭터의 헤어 카드는 아티스트가 직접 배치하는 리본 형태의 기하 구조를 의미합니다. 기존 방식은 실사 위주이거나 단일 메시를 생성하며, 기존의 CHARM 방식은 자기회귀 방식으로 생성하여 효율성이 낮았습니다. 본 논문은 헤어 카드를 순서가 없는 집합(unordered set)으로 정의하고, 각 카드를 하나의 토큰으로 처리하는 Set Diffusion Transformer를 제안합니다. 이를 통해 단일 이미지로부터 애니메이션용 스프링 본 체인과 헤어 카드를 동시에 생성합니다. 실험 결과, 기존 CHARM 대비 속도는 33배 빠르면서도 기하학적 오차를 크게 줄이며 우수한 성능을 보였습니다.

AI 연구

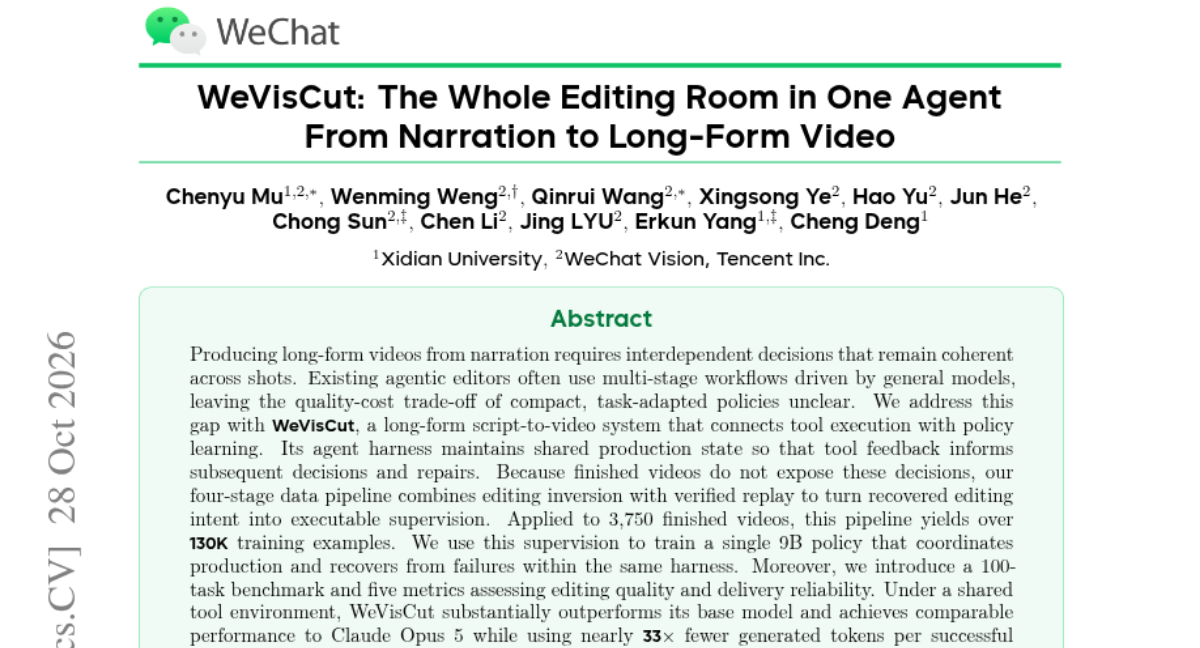
WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video

긴 분량의 영상을 제작하려면 샷 간의 일관성을 유지하는 복잡한 의사결정이 필요하지만, 기존의 다단계 에이전트는 비용과 품질 사이의 균형을 맞추기 어려웠습니다. 이를 해결하기 위해 WeVisCut은 도구 실행과 정책 학습을 결합한 스크립트-투-비디오 시스템을 제안합니다. 에이전트 하네스는 공유된 제작 상태를 유지하여 도구 피드백을 바탕으로 의사결정과 오류 복구를 수행합니다. 데이터 파이프라인은 편집 역추적과 검증된 재생 방식을 결합하여 13만 개 이상의 학습 데이터를 생성합니다. 이를 통해 학습된 9B 모델은 단일 에이전트로서 제작 조율 및 실패 복구 기능을 수행합니다. 실험 결과, WeVisCut은 기존 모델보다 우수한 성능을 보이면서도 토큰 사용량을 획기적으로 줄여 효율성을 입증했습니다.

AI 연구

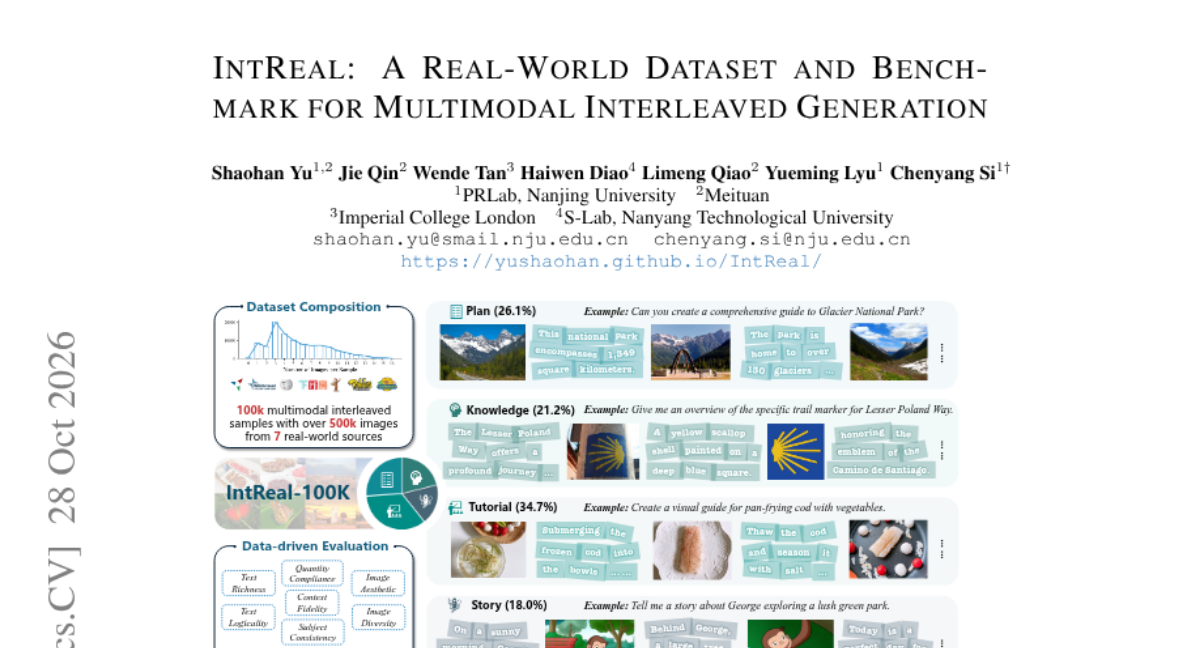
IntReal: A Real-World Dataset and Benchmark for Multimodal Interleaved Generation

인간은 텍스트와 이미지가 자연스럽게 섞인 멀티모달 콘텐츠를 소비하지만, 이를 생성하는 기술은 아직 충분히 연구되지 않았습니다. 기존 연구는 명확한 태스크 정의와 학습 데이터가 부족하며, 모델의 성능을 세부적으로 진단할 평가 프로토콜도 부재한 상황입니다. 이를 해결하기 위해 4개 카테고리의 실세계 데이터셋인 IntReal-100K와 7개 차원의 정밀 진단이 가능한 IntReal Evaluation Suite를 제안합니다. 실험 결과, 제안된 평가 방식은 인간의 판단과 높은 일치도를 보이며 모델별 강점과 약점을 명확히 식별했습니다. 또한 IntReal-100K를 통한 학습이 생성 성능을 향상시키며, 단일 모달리티 최적화만으로도 혼합 생성 능력이 개선될 수 있음을 입증했습니다.

AI 연구

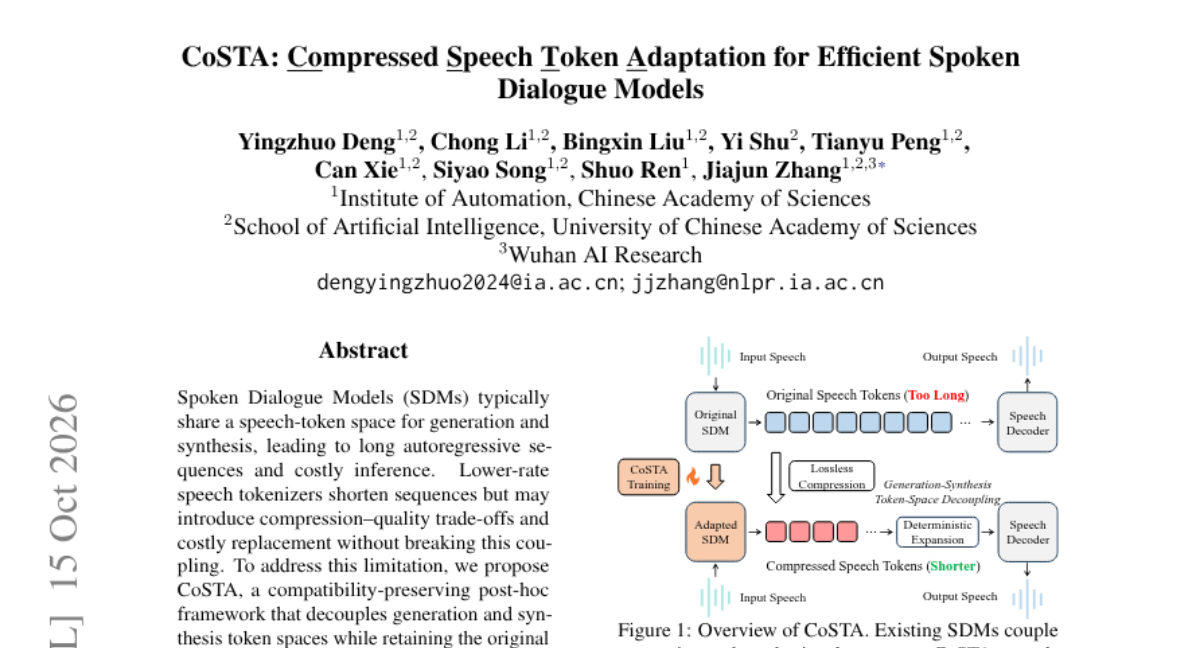
CoSTA: Compressed Speech Token Adaptation for Efficient Spoken Dialogue Models

기존의 음성 대화 모델(SDM)은 생성과 합성 토큰 공간을 공유하여 긴 시퀀스로 인한 높은 추론 비용 문제를 겪습니다. 저율(low-rate) 토크나이저를 사용하면 시퀀스는 짧아지지만 품질 저하나 기존 모델과의 호환성 문제가 발생합니다. 이를 해결하기 위해 CoSTA는 기존 토크나이저와 디코더를 유지하면서 생성과 합성 토큰 공간을 분리하는 post-hoc 프레임워크를 제안합니다. CoSTA는 어휘 확장, 발음 적응, 대화 적응 과정을 거쳐 압축된 토큰을 생성한 뒤, 합성 전 다시 원래의 토큰 공간으로 결정론적 확장을 수행합니다. 실험 결과, 응답 품질을 유지하면서도 생성 속도를 약 1.7배 높이고 지연 시간과 처리량을 개선했습니다.

AI 연구

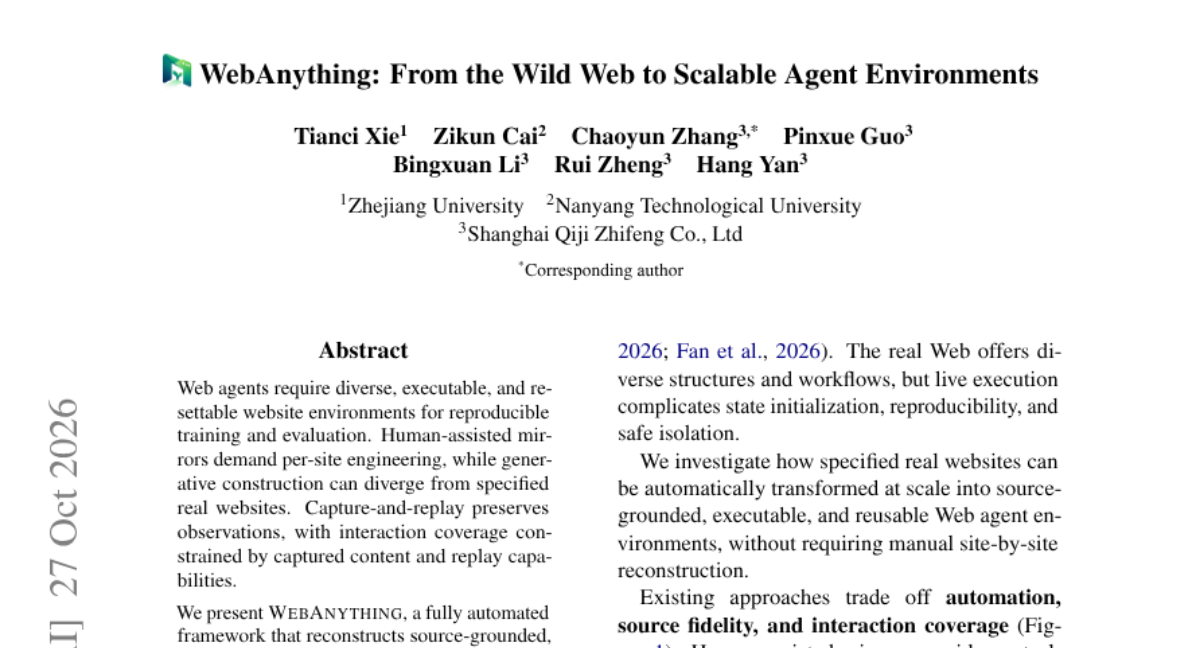
WebAnything: From the Wild Web to Scalable Agent Environments

웹 에이전트 학습을 위해서는 실행 및 초기화가 가능한 다양한 웹 환경이 필요하지만, 기존의 수동 미러링은 사이트별 엔지니어링이 필요하고 생성형 방식은 실제 웹과 괴리될 위험이 있습니다. 본 논문은 실제 URL로부터 소스 기반의 재사용 가능한 웹 환경을 자동 구축하는 WebAnything 프레임워크를 제안합니다. Explorer-Builder가 브라우저 구조와 상호작용 결과를 수집하고, 독립적인 검증기가 후보를 확인하며 국소적 복구 또는 타겟팅된 재수집을 가이드합니다. 실험 결과, 14개 도메인에 걸쳐 244개의 웹 아티팩트를 구축하였으며 기존 방식보다 높은 충실도(fidelity)를 달성했습니다. 또한 Qwen3.5-9B 모델을 이 데이터로 파인튜닝했을 때 다양한 웹 에이전트 벤치마크에서 성능 향상을 입증했습니다.

AI 연구

Glance: The Generator Is Its Own Reranker

기존 RAG 시스템은 Reranker와 Generator가 별도의 모델로 운영되어 모델 상주 비용과 중복된 연산이 발생하는 문제가 있었습니다. 이를 해결하기 위해 Glance는 하나의 백본 모델에 경량 어댑터와 포인터 헤드를 결합한 방식을 제안합니다. 공유된 Prefill 단계에서 생성된 KV 캐시를 활용하여, 별도의 재입력 없이 짧은 relevance probe를 통해 후보 문서들을 스코어링합니다. 실험 결과, Glance는 SciFact 및 NFCorpus에서 기존 bge-reranker-v2-m3보다 높은 성능을 보였으며 HotpotQA에서도 우수한 답변 정확도를 기록했습니다. 특히 대규모 컨텍스트에서도 성능이 유지되며, 단일 백본만으로 효율적인 Reranking이 가능함을 입증했습니다.

AI 연구

Multi-Token Prediction Done Right

최근 언어 모델 학습에서 성능 향상과 추론 가속을 위해 Multi-Token Prediction(MTP)이 널리 사용되고 있습니다. 그러나 기존 MTP 학습 방식은 잔차(residual) 성분이 차기 토큰 예측(NTP)과 다중 토큰 학습 모두를 방해하는 결함이 있음을 발견했습니다. 이를 해결하기 위해 저자들은 KL 발산(KL divergence) 신호만 정확히 추출하여 역전파하는 'KL gradient-recovery trick'을 도입했습니다. 이 기법을 적용한 Soft-MTP는 추가 파라미터나 연산 오버헤드 없이 기존 MTP의 노이즈를 제거하고 유용한 신호만 활용합니다. 실험 결과, 다양한 규모에서 NTP 퍼플렉시티 개선, 더 빠른 추측적 디코딩(speculative decoding), 그리고 수학 및 코드 추론 능력 향상을 입증했습니다.

AI 연구

Investor's Last Exam: Can AI Agents Do Equity Investment Without Seeing the Future?

기존 금융 벤치마크는 단편적인 지식이나 워크플로우 평가에 치중되어 있어, 실제 투자 결정에 필요한 전체 연구 과정을 평가하기 어려웠습니다. 이를 해결하기 위해 전문 투자자들이 설계한 주식 리서치 벤용 벤치마크인 Investor's Last Exam(ILE)을 도입했습니다. ILE는 시점별 데이터가 엄격히 통제된 데이터베이스, 전문 분석 업무 중심의 태스크 분류, 그리고 근거-가정-판단을 연결하는 전문가 프레임워크를 특징으로 합니다. 실험 결과, 최신 모델들이 전반적인 리서치 능력은 보여주었으나 실제 예측 및 모델링 성능은 현저히 낮게 나타났습니다. 결과적으로 ILE는 AI 에이전트의 분석 역량이 어떻게 투자 성과로 이어지는지 추적하고 진단할 수 있는 기반을 제공합니다.

AI 연구

AskStream: When and What to Ask Proactively under Uncertainty in Streaming Video Understanding

최근 멀티모달 모델은 수동적 응답을 넘어 능동적 에이전트로 진화하고 있으나, 기존 방식은 정보가 완전하다는 가정하에 동작하는 한계가 있습니다. 실제 환경에서는 비디오나 사용자로부터 발생하는 불확실성으로 인해 정보가 불완전한 경우가 많으며, 이는 모델의 무한 대기나 환각 현상을 유발합니다. 본 논문은 프로액티브 상호작용에 '질문(ask)'이라는 제3의 액션을 도입하여 부족한 정보를 능동적으로 요청하도록 정의합니다. 이를 위해 비디오 및 사용자 불확실성을 모두 고려한 최초의 멀티턴 벤치마크인 AskStream을 제안합니다. 실험 결과, 최신 모델들도 제안된 벤치마크에서 낮은 성능을 보여 현재의 능동적 정보 탐색 능력이 매우 부족함을 입증했습니다.

AI 연구

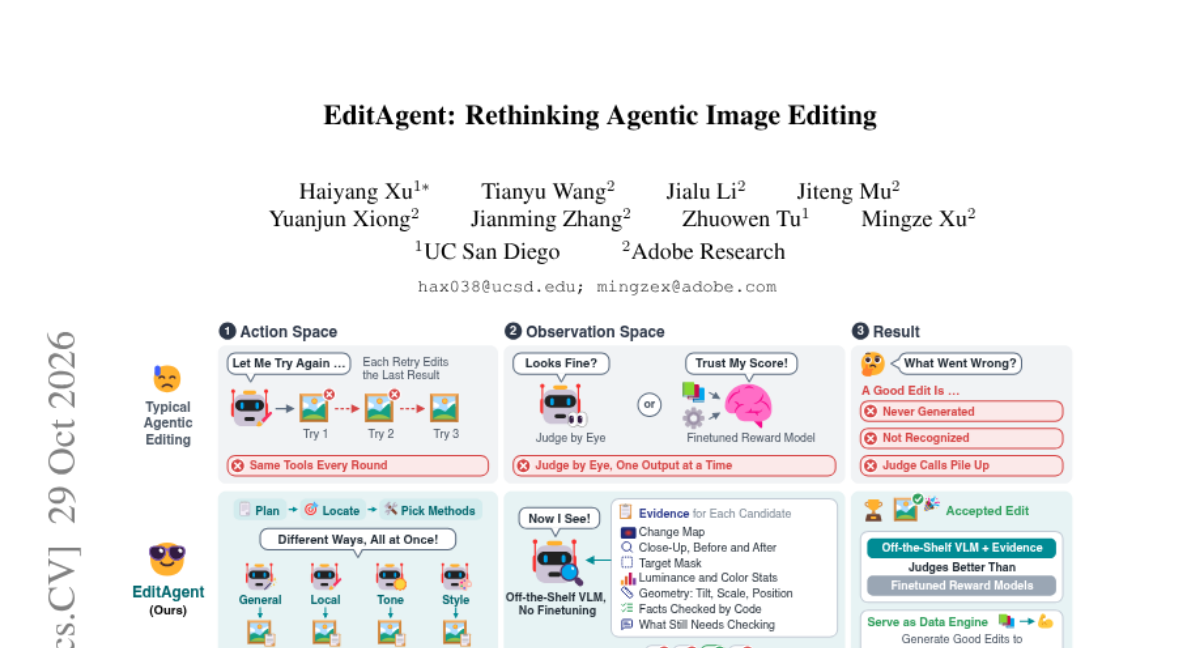
EditAgent: Rethinking Agentic Image Editing

기존의 에이전트 기반 이미지 편집기는 실패 시 동일한 도구만 반복 사용하거나 시각적 판단에만 의존하는 한계가 있습니다. 연구진은 에이전트의 행동 공간(Action Space)과 판단을 위한 관찰 공간(Observation Space)이 제한적이라는 점에 주목했습니다. 이를 해결하기 위해 범용 편집기와 전문화된 편집기를 결Fal하고, 각 후보에 검증 기록을 첨리하는 EditAgent를 제안합니다. EditAgent는 병렬 생성과 리스트 방식의 한 번의 판단을 통해 효율성을 높였습니다. 실험 결과, 기존 오픈 웨이트 모델들의 성능을 개선하고 강력한 편집기 학습을 위한 데이터 엔진 역할까지 수행함을 입증했습니다.

AI 연구

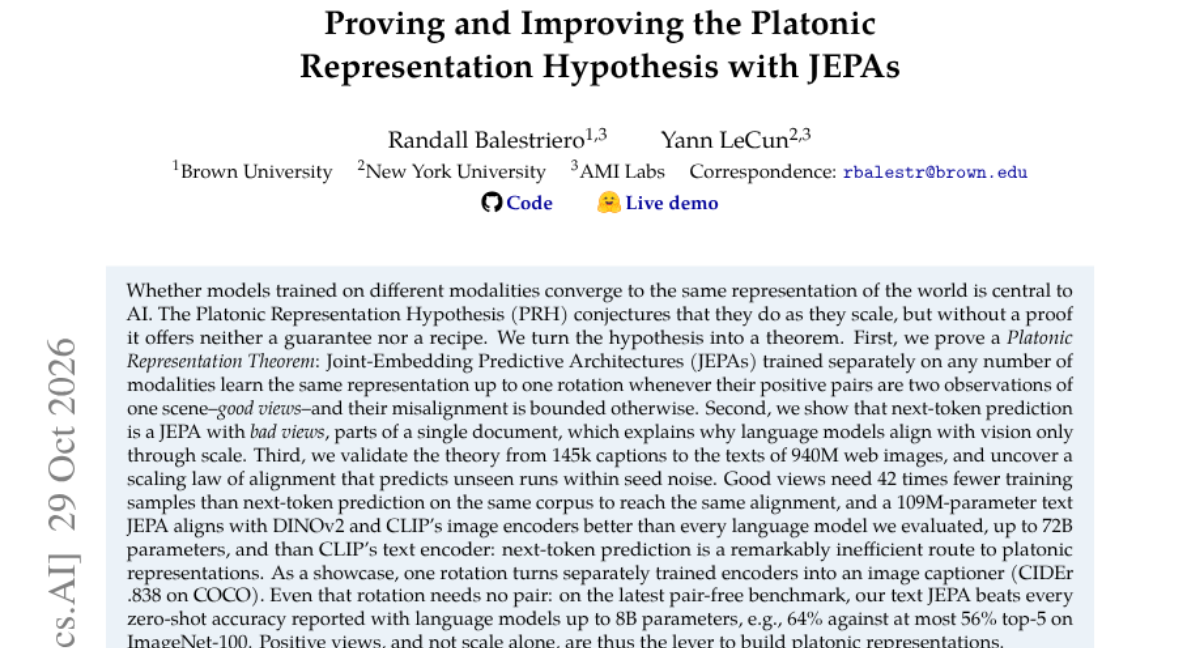
Proving and Improving the Platonic Representation Hypothesis with JEPAs

서로 다른 모달리티로 학습된 모델들이 동일한 세계 표현으로 수렴한다는 '플라토닉 표현 가설(PRH)'은 스케일링에 따른 현상일 뿐 수학적 증명이 부족했습니다. 본 논문은 JEPAs(Joint-Embedding Predictive Architectures)를 통해 이 가설을 정리된 정리(Theorem)로 변환합니다. 연구 결과, 단순한 다음 토큰 예측(Next-token prediction)은 문서의 일부를 학습하는 '나쁜 관점'을 가진 JEPA로 작용하여 정렬 효율이 낮음을 밝혀냈습니다. 반면, 동일한 장면의 서로 다른 관점을 학습하는 '좋은 관점' 방식은 훨씬 적은 데이터로도 강력한 정렬을 달성합니다. 실험을 통해 제안된 방식이 기존 대규모 언어 모델보다 적은 파라미터로도 더 뛰어난 시각-언어 정렬 성능을 보임을 입증했습니다.

AI 연구

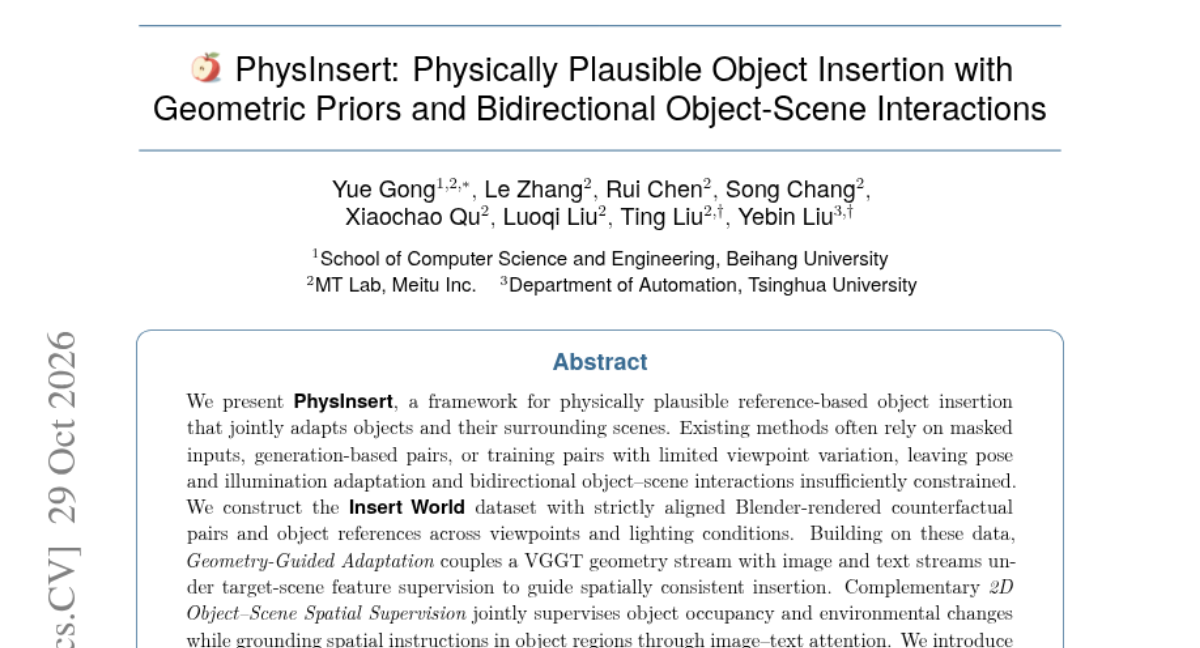
PhysInsert: Physically Plausible Object Insertion with Geometric Priors and Bidirectional Object-Scene Interactions

기존의 객체 삽입 방식은 마스킹된 입력이나 제한된 시점의 데이터에 의존하여 포즈, 조명 적응 및 객체-장면 간의 상호작용 제약이 부족했습니다. 이를 해결하기 위해 다양한 시점과 조명 조건이 정렬된 'Insert World' 데이터셋을 구축했습니다. 제안하는 PhysInsert는 VGGT 기하학 스트림을 활용한 기하학 가이드 적응과 객체 점유 및 환경 변화를 동시에 제어하는 2D 객체-장면 공간 감독 방식을 결합합니다. 실험 결과, 기존 방식보다 향상된 이미지 충실도를 보였으며 사용자 연구에서도 배치 정확도와 조명/원근법 통합 능력이 우수함을 입증했습니다.

AI 연구

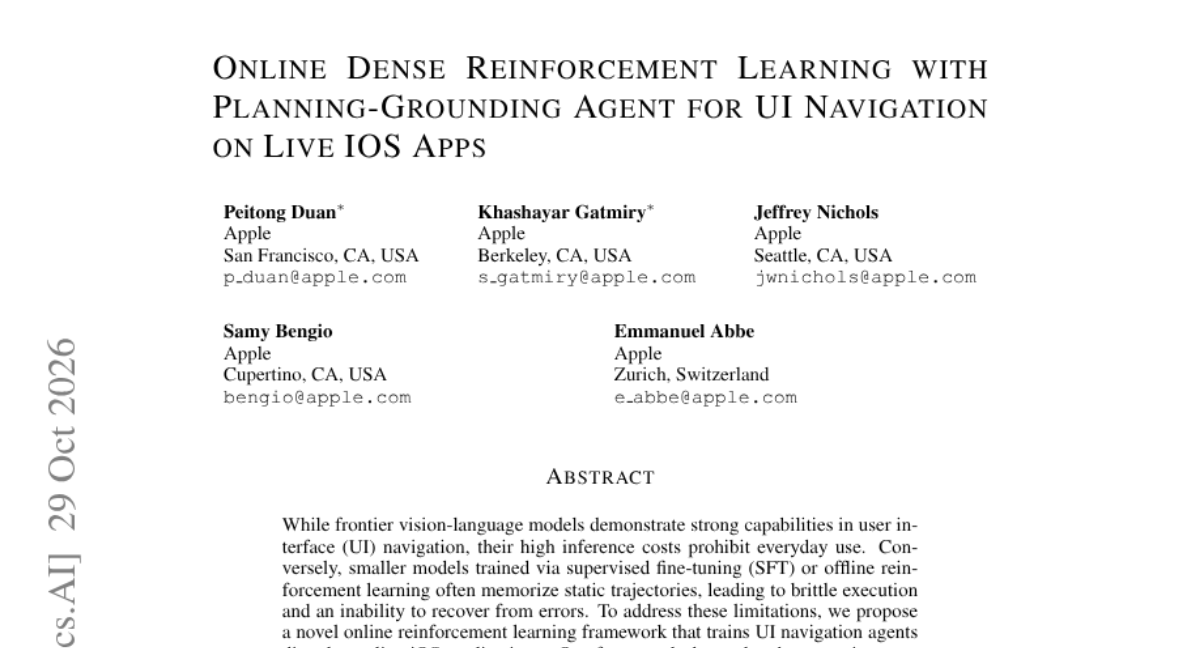
Online Dense Reinforcement Learning with Planning-Grounding Agent for UI Navigation on Live IOS Apps

기존의 거대 시각-언어 모델은 높은 추론 비용이 문제였고, 소형 모델은 SFT나 오프라인 RL로 인해 정적 궤적에 매몰되어 오류 복구 능력이 부족했습니다. 이를 해결하기 위해 실시간 iOS 앱 환경에서 직접 학습하는 새로운 온라인 RL 프레임워크를 제안합니다. 에이전트를 Planning 에이전트와 UI Grounding 모델로 분리하고, LLM-as-a-Judge를 통해 단계별 보상과 최종 보상을 결합한 밀집 보상 체계를 구축했습니다. 또한, 유사한 시각적 상태를 활용해 크리틱 안정성을 높이는 GiGPPO 알고리즘과 수백 대의 가상 iOS 기기를 관리하는 인프라를 도입했습니다. 실험 결과, 제안된 8B 모델은 SFT 대비 뛰어난 일반화 성능을 보였으며 Gemini Pro급의 성능을 달성했습니다.

AI 연구

AB-Attention: Accurate Block Attention for Accelerating Video Diffusion Transformers

비디오 확산 트랜스포머는 고품질 영상 생성에 탁월하지만, 3D 풀 어텐션의 이차 복잡도 문제로 인해 추론 비용이 매우 높습니다. 기존의 동적 블록 희소 어텐션은 높은 희소도에서 정확도가 떨어지거나, 블록 단위 선택 방식이 세밀한 토큰 정보를 반영하지 못하는 한계가 있습니다. 이를 해결하기 위해 제안된 AB-Attention은 쿼리 블록 내 클러스터링을 통해 중요도를 추정하는 IBCS와 포함 확률 가중치를 적용한 SIP 방식을 도입합니다. 또한, 텐서 코어 연산 효율을 유지하면서도 작은 크기의 KV 블록을 모아 처리하는 커널을 통해 정밀한 선택을 지원합니다. 실험 결과, Wan2.1 및 HunyuanVideo 모델에서 89~92%의 높은 희소도를 달에서도 성능 저하를 최소화하며 최대 2.23배의 속도 향상을 달성했습니다.

AI 연구

SO-101 Bench: Accessible Spatial Manipulation

저가형 로봇 팔인 SO-101은 로봇 학습의 입문점으로 쓰이지만, 기존 벤치마크는 단순한 작업 위주이거나 물리적 하드웨어에만 국한되어 있었습니다. 본 논문은 실제 SO-101 환경의 디지털 트윈인 Isaac Lab 기반 'SO-101 Bench'를 소개합니다. 이 벤치마크는 다양한 객체와 공간 제약 조건(회전, 가려짐 등)을 포함하며, 시뮬레이션과 실물 로봇 간의 순위 상관관계가 완벽하게 일치함을 입증했습니다. 실험 결과, LLM 에이전트가 코드를 작성하고 학습된 정책에 파지(grasping)를 맡기는 방식이 가장 높은 성능을 보였습니다. 결과적으로 시뮬레이션이 실물 로봇의 성능 순위를 정확히 예측할 수 있음을 보여주었습니다.

AI 연구

ABF-Bench: A Verifiable Benchmark for Agentic Blockchain Forensics

블록체인 포렌식은 자금 세탁 수법이 끊임없이 변하는 적대적이고 개방적인 환경에서 이루어집니다. 기존의 추적 방식은 복잡한 경로와 다양한 수법에 대응하기 어렵고 검증이 까다롭습니다. 본 논문은 모든 추적 결과가 온체인 기록을 근거로 제시되어야 하는 검증 가능한 벤치마크인 ABF-Bench를 제안합니다. 실제 자금 세탁 사례를 바탕으로 멀티홉 전송, DeFi, 크로스체인, 믹서 등을 포함한 복잡한 태스크를 구축했습니다. 실험 결과, 제안된 에이전트 하네스는 일반 범용 에이전트보다 높은 재현율을 보였으며, 고정 순서 추적기보다 증거 확보 속도와 미공개 수탁 서비스 식별 능력에서 우수함을 입증했습니다.

AI 연구

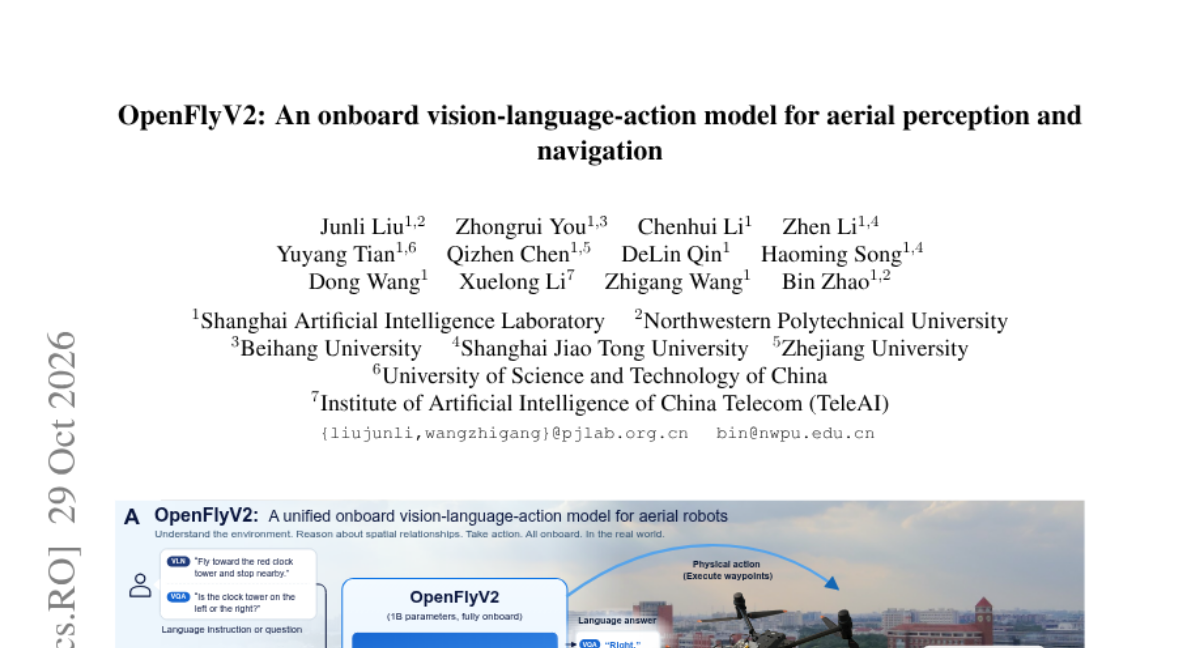
OpenFlyV2: An onboard vision-language-action model for aerial perception and navigation

기존의 항공 로봇 시스템은 개별 기능에 특화되어 있거나 고성능 오프보드 연산에 의존하여 폐쇄 루프 제어가 어렵다는 문제가 있었습니다. 본 논문은 시각-언어 표현을 공유하여 의미 이해, 공간 추론, 연속적 비행 제어를 하나의 모델로 수행하는 OpenFlyV2 아키텍처를 제안합니다. 압축된 액션 전문가(Action Expert)와 모션 인지형 시간 메모리를 통해 저사양 플랫폼에서도 효율적인 제어가 가능하도록 설계했습니다. 시뮬레이션 기반의 대규모 데이터셋을 활용해 학습된 결과, NVIDIA Jetson Orin NX 환경에서 10Hz의 속도로 온보드 실행이 가능함을 입증했습니다. 최종적으로 실세계 데이터 없이도 시뮬레이션에서 학습된 모델이 실제 쿼드로터에 제로샷으로 전이되어 성공적인 내비게이션 성능을 보여주었습니다.

AI 연구

Your LR Schedule May Not Be Principled: Effective Learning Rate Scheduling in Weight-Normalized Training

최근 Weight-Normalization(WN) 방식이 Weight Decay(WD)의 대안으로 주목받으며 성능 향상을 보였으나, 그 원인이 명확하지 않았습니다. 본 연구는 WN의 성능 향상이 정규화 자체보다 유도된 유효 학습률(ELR) 궤적에 의해 발생함을 증명했습니다. 이에 따라 명목 LR이 아닌 ELR을 타겟팅하는 새로운 스케줄링 방식인 AIR(Affine Inverse-square-Root decay)를 제안합니다. 실험 결과, AIR는 기존 Cosine 스케줄보다 낮은 최종 손실과 더 높은 하이퍼파라미터 강건성을 보여주었습니다. 또한, 동일한 ELR 궤적을 WD에 적용했을 때도 동일한 학습 역학이 나타남을 확인하여 ELR이 스케줄링의 핵심 객체임을 입증했습니다.

AI 연구

Training Foundation Models with a Single Algorithm

기존 파운데이션 모델 학습은 사전 학습, SFT, RL 등 단계별로 알고리즘과 데이터가 분리되어 진행되었습니다. 연구진은 이러한 단계적 분리가 필수적이지 않다는 점에 주목하여, RL 목적 함수를 최대 우도 추정(MLE) 방식으로 재정의했습니다. 이를 통해 모든 학습 단계를 하나의 우도 기반 알고리즘으로 통합하는 'Unified Training' 프레임워크를 제안합니다. 이 방식은 학습 과정을 데이터의 종류와 비율을 결정하는 문제로 단순화하며, 정적 데이터와 RL 생성 데이터를 단일 트레이너에서 혼합 학습합니다. 실험 결과, 통합 학습은 연산 효율성과 작업 커버리지를 개선하며 지속적 학습을 위한 강력한 기반을 제공함을 입증했습니다.

AI 연구

Scaling Lean Theorem Proving for Real-World Code Verification

기존의 수학적/프로그래밍적 벤치마크는 점차 포화 상태에 이르러 실세계 코드 검증 능력을 측정하기 어려워지고 있습니다. 이를 해결하기 위해 재귀적 에이전트, 비동기 탐색, 탄력적 정교화 서비스를 결합한 EasyProver 시스템을 제안합니다. 또한, 경쟁 프로그래밍 문제를 고난도 검증 과제로 변환하는 Aegis 파이프라인을 도입하여 실질적인 구현 수준의 과제를 생성합니다. 실험 결과, EasyProver는 PutnamBench와 IMO 문제 등에서 탁월한 성능을 보였으며, Aegis를 통해 생성된 1만 개 이상의 복잡한 Rust-Lean 과제에서도 높은 검증 성공률을 기록했습니다. 이 연구는 자동화된 정형 검증과 RL 학습을 위한 고난도 데이터셋 제공에 기여합니다.

AI 연구

After One-Click Video: The Inflow of Service-Type Content, the Failure of the Recommendation Pool Mechanism, and the BoLe System

LLM을 활용한 '원클릭 영상' 제작 기술로 인해 서비스형 콘텐츠가 폭발적으로 증가하는 시대가 도래했습니다. 이러한 콘텐츠는 단순 필요 충족을 목적으로 하며, 창작자 수의 제약이 있는 작업형 콘텐츠와 달리 무한히 생성될 수 있어 콘텐츠 생태계의 균형을 무너뜨립니다. 고정된 사용자 주의력을 기반으로 하는 기존의 추천 풀 메커니즘은 콘텐츠 양이 임계치를 넘어서면 질적 저하와 함께 실패하게 됩니다. 이를 해결하기 위해 기계적 검증과 신뢰 기반의 인간 검증을 결합한 'BoLe 시스템'을 제안합니다. 결과적으로 이 모델은 콘텐츠 유형에 따른 차별적 필터링을 통해 생태계의 지속 가능성을 확보하는 방안을 제시합니다.

AI 연구

Unlocking Any-Order Generation in Pretrained Autoregressive Image Models

기존의 자기회귀(AR) 이미지 생성 모델은 고정된 래스터 스캔 순서로 학습되어 인페인팅이나 편집과 같은 유연한 작업에 제약이 있었습니다. 이를 해결하기 위해 기존 모델을 처음부터 다시 학습하는 대신, 이미 학습된 분포를 활용하는 효율적인 적응 방식을 제안합니다. 방법론으로는 타겟 위치 식별 문제를 해결하는 '미래 인지 위치 임베딩(future-aware positional embeddings)'과 안정적인 최적화를 위한 '순서 커리큘럼(ordering curriculum)'을 사용합니다. 실험 결과, 기존 모델의 추론 스택을 유지하면서도 MaskGIT 대비 우수한 인페인팅 성능을 보였으며 적은 추가 연산 비용으로 유연한 생성 능력을 확보했습니다.

AI 연구

Matched Capabilities, Different Behaviors: A Controlled Study of MCP and CLI Interfaces for Language Agents

언어 에이전트가 외부 도구를 사용하는 과정에서 인터페이스 표현 방식이 모델의 의사결정에 미치는 영향이 중요해지고 있습니다. 본 연구는 동일한 기능을 제공하더라도 MCP와 CLI처럼 표현 방식이 다를 때 에이전트의 행동이 어떻게 변하는지 분석합니다. 이를 위해 동일한 시맨틱 액션 계약을 기반으로 인터페이스를 비교하는 MICA 방법론을 도입했습니다. 실험 결과, 인터페이스 표현 방식의 차이가 작업 성능, 상호작용 비용, 실패 경로 등에 상당한 차이를 유발함을 확인했습니다. 이를 해결하기 위해 시맨틱 의사결정은 유지하되 인터페이스 구현만 최적화하는 DART 프레임워크를 제안합니다. 결과적으로 DART는 벤치마크 점수를 높이고 토큰 비용을 크게 절감하는 성과를 보였습니다.

AI 연구

Broken on Arrival: Non-Functional Quantized LLM Artifacts in Public Model Registries and How to Catch Them

개발자들은 로컬 실행을 위해 공개 저장소에서 양자화된 LLM을 다운로드하지만, 기존 저장소들은 파일의 기능적 무결성을 검증하지 않습니다. 연구진은 Ollama와 Hugging Face의 수백 개 GGUF 태그를 대상으로 코드 생성 능력을 테스트했습니다. 분석 결과, 일부 공식 태그에서도 심각한 기능 저하가 발견되었으며, 이는 파일 손상이 아닌 양자화 과정의 설정 문제임이 밝혀졌습니다. 특히 저비트 양자화 모델에서 이러한 문제가 두드러졌으며, 단순한 재현성이 기능적 정상 작동을 보장하지 않음을 확인했습니다. 이를 해결하기 위해 연구진은 감사 데이터와 함께 검증 도구인 quantcheck를 공개합니다.

AI 연구

FDSML: Formula-Driven Supervised Metric Learning with Parameter-Aware Triplet Loss

기존의 수식 기반 사전 학습(FDSL)은 이산적인 클래스 레이블에만 의존하여 생성 과정의 연속성을 활용하지 못하는 한계가 있었습니다. 본 논문은 이미지 생성 파라미터 자체에서 관계적 감독 신호를 도출하는 FDSML 방식을 제안합니다. 이를 위해 클래스 내 변동성을 높인 FineFractalDB 데이터셋과 파라미터 공간의 거리를 반영하는 PA-Triplet Loss를 결합했습니다. 실험 결과, FDSML은 기존 FDSL 대비 이미지 검색(Retrieval) 성능을 크게 향상시켰으며 분류 및 강건성 측면에서도 경쟁력을 입증했습니다. 이는 단순 레이블 기반 분류보다 파라미터 기반의 관계적 학습이 전이 학습에 더 강력한 신호를 제공함을 시사합니다.

30건

제품/서비스

이날 공개된 제품과 도구

제품/서비스

Vaani Developer Platform

코딩 없이 인간처럼 대화하는 AI 음성 에이전트를 구축하는 플랫폼

제품/서비스

Knocket AI

웹사이트 방문자와 간편하게 소통할 수 있는 가벼운 라이브 채팅 솔루션

제품/서비스

SpeakON Agent

일상적인 음성 명령을 실제 업무 실행으로 연결하는 AI 에이전트

제품/서비스

MCP Server by XWiki

XWiki의 지식 베이스를 다양한 AI 에이전트와 안전하게 연결하는 오픈소스 MCP 서버

제품/서비스

Canva Brush

디자인 구조를 이해하고 자연어로 편집을 수행하는 AI 디자인 에이전트

나머지 25건 펼쳐보기

제품/서비스

Chopstick

사용자의 반복 작업을 감지하여 자동으로 맥 위젯을 생성하는 자동화 도구

제품/서비스

fastbrowse

모든 웹 요소를 분석하여 다음 단계를 스스로 결정하는 초고속 오픈소스 브라우저 에이전트

제품/서비스

Teable Mobile

모바일에서도 팀의 업무 시스템과 자동화를 구축할 수 있는 데이터베이스 솔루션

제품/서비스

iSurge

맥(Mac) 사용자를 위한 올인원 시스템 모니터링 및 관리 도구

제품/서비스

Nocto

맥북 노치 영역을 활용해 미디어 제어, 화상 회의 참여, 클립보드 관리를 한 번에 해결하는 생산성 도구

제품/서비스

Faylee

버그 리포트를 단 하나의 링크로 생성하여 AI 코딩 에이전트가 즉시 수정할 수 있게 돕는 도구

제품/서비스

SparkBots AI (Powered by Jev)

웹페이지와 PDF에서 핵심 정보를 즉시 추출하고 분석하는 초고속 AI 자동화 도구

제품/서비스

ilse

실행 중인 React 앱의 UI를 클릭만으로 즉시 수정하고 AI 에이전트와 연동하는 개발 도구

제품/서비스

Cluinn

회의 중 실시간 답변과 자동 기록을 제공하는 Mac 전용 AI 비서

제품/서비스

Norah Studio

Mac, iPad, iPhone에서 음악을 탐구하고 재창조하는 올인원 크리에이티브 스튜디오

제품/서비스

Axonnic

로봇의 정밀한 손동작 학습을 위한 근육 신호 기반 웨어러블 슬리브

제품/서비스

StepGrab

클릭 한 번으로 가이드 제작부터 편집까지 끝내는 윈도우 지원 스크린샷 자동화 도구

제품/서비스

Kestrix

HCL 기반의 DAG 구조로 복잡한 CI/CD 파이프라인을 효율적으로 관리하는 리포지토리 불문 CI 컨트롤 플레인

제품/서비스

StereoLift Live

PC 데스크톱 화면을 메타 퀘스트에서 실감 나는 3D로 감상하는 솔루션

제품/서비스

sitesolide

AI로 만든 앱을 개인 서버에 즉시 배포할 수 있는 간편한 오픈소스 도구

제품/서비스

Blooper.ai

팀의 창의적 의사결정을 학습하여 효율적인 영상 제작을 돕는 AI 워크스페이스

제품/서비스

Prosyo

ChatGPT나 Claude를 통해 타겟을 지정하면 미팅 예약까지 자동으로 수행하는 AI 영업 담당자(SDR)

제품/서비스

coffeechat.me

단순한 미팅 예약을 넘어, 대화의 목적을 확인하고 만남을 선택하는 따뜻한 스케줄링 도구

제품/서비스

Relic AI

저장한 모든 자료를 한곳에 모으고, AI로 즉시 질문하여 답을 얻는 개인 지식 저장소

제품/서비스

Minted

SVG 파일을 실감 나는 3D 골드 메달리온 디자인으로 변환해주는 SwiftUI 전용 라이브러리

제품/서비스

CaptureHop

Meta Quest의 스크린샷과 영상을 홈 Wi-Fi를 통해 PC나 스마트폰으로 간편하게 전송하는 도구

제품/서비스

opencommerce

단일 엔드포인트로 모든 온라인 쇼핑몰의 검색부터 결제까지 처리하는 AI 에이전트용 커머스 SDK

제품/서비스

AI-Atlas

코드 실력을 기반으로 GitHub AI 프로젝트의 가치를 검증하고 점수화하는 분석 도구

제품/서비스

Tadado

할로윈 테마로 새롭게 단장한 파티 게임, 새로운 '임포스터 모드'와 무료 스푸키 덱 출시

제품/서비스

Bento

클릭 한 번으로 맥 데스크탑을 깔끔한 폴더 구조로 정리해주는 데스크탑 관리 도구

6건

모델/벤치마크

새 모델과 주요 평가 결과

HF Model Trending

nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B

NVIDIA에서 공개한 NVIDIA-Nemotron-3.5-Transcribe-30B-A4B 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 자동 음성 인식(ASR) 작업을 위해 설계된 30B 규모의 모델입니다.

HF Model Trending

mistralai/Mistral-Large-4-1T-A52B

Mistral AI에서 공개한 Mistral-Large-4-1T-A52B 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 이미지와 텍스트를 동시에 처리하는 image-text-to-text 파이프라인을 지원합니다.

HF Model Trending

baidu/Unlimited-OCR-2

Baidu에서 공개한 Unlimited-OCR-2 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 image-text-to-text 파이프라인을 지원하는 OCR 관련 모델입니다.

LiveCodeBench

LiveCodeBench top model: O4-Mini (High)

LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Pro-06-05

LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.

나머지 1건 펼쳐보기

LiveCodeBench

LiveCodeBench top model: Gemini-2.5-Flash-04-17

LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.