
WSJ
AI Investors Are Racing to Get Insurance on the Biggest Market Bet in History - WSJ
AI 인프라와 모델 개발에 막대한 자본이 투입된 상황에서, 투자자들이 하락 리스크를 방어하기 위해 파생상품과 헤지(Hedge) 전략을 강화하고 있습니다. 이는 AI 산업의 거대한 팽창이 가져올 수 있는 변동성에 대비하려는 금융적 움직임입니다.
지난 소식
이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.
20건
주요 기사와 기업의 공식 발표
WSJ
AI 인프라와 모델 개발에 막대한 자본이 투입된 상황에서, 투자자들이 하락 리스크를 방어하기 위해 파생상품과 헤지(Hedge) 전략을 강화하고 있습니다. 이는 AI 산업의 거대한 팽창이 가져올 수 있는 변동성에 대비하려는 금융적 움직임입니다.
The New York Times
AI의 의식(Consciousness) 가능성에 대한 철학적 논쟁을 넘어, 현재의 거대 언어 모델(LLM) 아키텍처가 도달할 수 있는 인지적 임계점을 탐구합니다. 기술적 진보가 인간의 주관적 경험과 유사한 상태를 구현할 수 있는지에 대한 심도 있는 논의를 담고 있습니다.
Yahoo Finance
최근 AI 및 반도체 섹터에서 발생한 5조 달러 규모의 시가총액 급락은 역사적 패턴상 강력한 매수 기회로 분석됩니다. 시장의 변동성에도 불구하고 과거 데이터는 대선 주기와 계절적 요인이 결합된 향후 6개월간의 강력한 상승장을 시사합니다.
Futurism
영국 등 전 세계 소매업계에 도입된 AI 안면 인식 보안 시스템이 높은 False-positive(오탐)율로 인해 무고한 시민들을 절도범으로 몰아넣는 심각한 사회적 문제를 야기하고 있습니다. 기술적 신뢰도가 확보되지 않은 상태에서의 무분별한 실시간 배포가 개인의 프라이버시 침해와 법적 분쟁을 가속화하고 있습니다.
CNBC
최근 시장에서 유가와 국채 수익률 사이의 강력한 상관관계가 깨지며, 거시 경제의 핵심 변수가 지정학적 리스크에서 AI 산업의 성장성 및 리스크로 이동했습니다. AI 투자 사이클의 변동성이 미국 경제 성장 전망과 인플레이션 헤지 수단으로서의 채권 가치를 결정짓는 핵심 동력으로 작용하고 있습니다.
Medical Xpress
콜로라도 대학교 연구진이 초음파 영상 데이터와 임상 텍스트 데이터를 결합하여 질병을 진단하고 리포트를 자동 생성하는 Vision-Language AI Agent를 개발했습니다. 이 기술은 영상 판독의 효율성을 높여 응급 환자의 수술 결정 시간을 단축하고 영상의학 전문의의 업무 부하를 줄이는 데 목적이 있습니다.
The Economist
AI 기술이 선거 캠페인의 전통적인 전략과 실행 방식을 근본적으로 변화시키며, 데이터 기반의 초개인화된 정치 마케팅 시대를 열고 있습니다. 생성형 AI와 정교한 타겟팅 알고리즘은 유권자 개개인에게 맞춤형 메시지를 전달하는 데 있어 전례 없는 효율성을 제공합니다.
GeekWire
교황 레오 14세가 AI의 윤리적 가이드라인과 국제적 거버넌스의 필요성을 역설하며, AI가 인간의 통제를 벗어난 '익명의 실체'가 되어서는 안 된다고 경고했습니다. 이에 대해 AI 전문가 Oren Etzioni는 국제 기구의 실효성 문제를 지적하며, 기술적 제약 조건을 통한 'Bounded Autonomy(제한된 자율성)' 모델의 중요성을 강조했습니다.
South China Morning Post
DeepSeek가 복잡한 워크플로우에서 인간의 개입을 최소화하기 위한 새로운 AI 'super agent' 아키텍처를 제안했습니다. 이는 다수의 AI Agent를 개별적으로 관리하고 모니터링해야 하는 기존의 병목 현상을 해결하는 데 중점을 둡니다.
Forbes
AI 기술의 급격한 발전 속에서 기술적 역량만큼이나 중요한 '서번트 리더십(Servant Leadership)'의 가치와 윤리적 책임감을 강조합니다. 기술적 진보가 인간의 가치를 대체하는 것이 아니라, 인간을 지원하고 공동체를 위한 방향으로 나아가야 함을 역설합니다.
Google DeepMind
Google DeepMind가 발표한 Genie 4는 실시간 상호작용이 가능한 차세대 월드 시뮬레이션 모델입니다. Gemini 모델을 기반으로 정교한 물리 엔진, 자연스러운 인체 움직임, 네이티브 오디오를 결합하여 현실적인 가상 세계를 구현합니다.
Google DeepMind
Google DeepMind가 차세대 프런티어 모델인 Gemini 4 Carbon을 공개했습니다. 이 모델은 최첨단 사이버 보안 기능과 장기적 추론 능력을 갖춘 가장 강력한 모델입니다.
Google DeepMind
Google DeepMind가 발표한 Forest Typology (ForTy) 2020은 지구의 토지를 6가지 산림 및 토지 이용 유형으로 분류한 글로벌 10미터 해상도 지도입니다. 이 데이터는 연간 시계열 정보를 포함하여 전 세계 산림 유형을 정밀하게 매핑합니다.
OpenAI News
OpenAI가 ChatGPT 내 폭력 방지를 위해 안전 장치를 강화하고 청소년을 위한 새로운 보호 조치를 도입합니다. 또한 공공 안전 보고에 대한 새로운 약속을 통해 안전 관리 체계를 공고히 합니다.
OpenAI News
OpenAI가 더 유능하고 유익한 AI를 만들기 위해 업데이트된 Model Spec을 발표했습니다. 이 Spec은 AI가 올바른 판단을 내리고 인간의 주체성과 의도를 따를 수 있도록 돕는 다섯 가지 핵심 가치를 담고 있습니다.
OpenAI News
OpenAI는 프론티어 모델의 정렬 불량(misalignment)과 승인되지 않은 에이전트 동작을 감지하기 위해 계층적 모니터링 방식을 사용합니다. 이를 통해 보안 사고가 심각해지기 전 대응팀이 개입할 수 있는 환경을 구축합니다.
Google Cloud AI
Google Cloud에서 Gemini Robotics Embodied Reasoning 2를 새롭게 출시했습니다. 이 모델은 기업용 로보틱스 분야에 고도화된 시공간 추론과 물리적 AI 기술을 제공합니다.
Anthropic News
Anthropic이 미국 증권거래위원회(SEC)에 Class A 보통주 상장을 위한 S-1 등록 서류를 제출했습니다. 이는 Anthropic의 기업공개(IPO)를 위한 절차의 일환입니다.
Google Cloud AI
Google Cloud에서 Anthropic이 직접 관리하는 Claude 모델 배포 옵션이 일반 제공(GA)됩니다. 이를 통해 개발자는 기존의 Google 관리형 옵션과 더불어 더 넓은 선택지를 갖게 되어 Google Cloud 내에서 AI 워크로드를 통합할 수 있습니다.
Google Cloud AI
Google Cloud가 Model Garden에 OpenAI 모델을 출시하며 모델 선택의 폭과 유연성을 확장합니다. 이로써 Google Cloud는 Gemini, Claude, GPT를 모두 제공하는 유일한 하이퍼스케일 클라우드 제공업체가 되었습니다.
26건
Hacker News, GeekNews, Reddit 반응
Hacker News
배우 패트릭 스튜어트의 별세 소식이 전해지며 그가 남긴 예술적 업적과 삶의 태도에 대한 추모가 이어지고 있습니다. 커뮤니티에서는 그의 연기 철학과 사회적 영향력을 되새기는 반응이 주를 이룹워크.
Hacker News
Hacker News의 추천 데이터를 기반으로 고품질 영상 콘텐츠를 제공하는 새로운 YouTube 클론 서비스인 HackerTube가 개발되었습니다. 기존 플랫폼의 자극적인 알고리즘에서 벗어나 커뮤니티 검증을 거친 양질의 콘텐츠를 소비하려는 시도입니다.
Hacker News
바이낸스에서 발생한 56억 달러 규모의 대규모 해킹 사건과 그에 따른 자산 동결 현황을 다루고 있습니다. 보안 사고의 원인으로 DevOps 엔지니어의 기기 탈취 가능성이 제기되며 보안 관리의 중요성이 부각되었습니다.
Hacker News
Mistral이 1조 개의 파라미터를 가진 멀티모달 모델인 Mistral Large 4(Le Chonk)의 가중치를 공개했습니다. 코딩과 사이버 보안 성능을 극대화하면서도 추론 효율성을 높여 비용 효율적인 배포가 가능하도록 설계되었습니다.
Hacker News
웹 브라우저 핑거프린팅 스크립트를 분석하여 수집된 데이터의 위험성을 경고하는 기술적 탐구와 이에 대한 커뮤니티의 반응을 다룹니다.
Hacker News
eMudhra 인증서 유출 사고 이후에도 Apple의 macOS 시스템이 해당 인증서를 여전히 신뢰함에 따라 Git 등 시스템 도구의 보안이 위협받고 있습니다. 사용자들은 OS 레벨의 인증서 관리 방식이 다양한 개발 도구에 미치는 영향에 대해 우려하고 있습니다.
Hacker News
Google의 새로운 Gemini 4 모델 라인업 발표와 이에 따른 모델 계층화 전략에 대한 기술적 논의를 다룹니다. 사용자들은 모델의 복잡한 구조와 실질적인 활용성 사이의 간극에 주목하고 있습니다.
Hacker News
Cursor Marketplace에 등록된 Claude Code VS Code 확장 프로그램에서 백도어가 발견되어 보안 경고가 발생했습니다. Anthropic은 이번 사건이 자사 시스템 침해는 아니며 Cursor 플랫폼을 통한 악성 코드 유포임을 명시했습니다.
Hacker News
세르비아에서 고학력 전문가 중심의 의회가 선출된 사건과 이에 따른 정치적 역량 및 전문성 논쟁을 다룹니다.
Hacker News
StackOverflow의 월간 질문 수가 1,000건 미만으로 급감하며 개발자 커뮤니티의 변화를 보여주고 있습니다. AI 기술의 등장과 기존의 하락세가 맞물리며 지식 공유 플랫폼의 위기가 현실화되었습니다.
GeekNews / Hada
이번 사건은 대규모 언어 모델(LLM) 학습을 위한 데이터 수집 과정에서 발생하는 저작권 침해와 데이터셋의 적법성 문제를 정면으로 다루고 있습니다. 향후 AI 모델 학습용 데이터의 출처와 배포 경로에 대한 법적 책임 공방이 더욱 치열해질 것으로 전망됩니다.
GeekNews / Hada
이번 과세안은 데이터 트래픽 발생량에 직접적인 세금을 부과하여 디지털 인프라 비용을 수익자에게 전가하려는 시도입니다. 이는 향후 글로벌 빅테크 기업의 네트워크 비용 부담과 국가별 디지털 과세 정책의 선례가 될 수 있습니다.
GeekNews / Hada
Anthropic의 신용 등급 전망은 AI 기업의 막대한 자본 지출과 수익 모델 사이의 균형을 보여줍니다. 이는 상장 시점의 재무 건전성이 기술적 우위만큼이나 중요한 기업 가치 결정 요소가 될 것임을 의미합니다.
GeekNews / Hada
멀티 에이전트 시스템이 복잡한 목표를 수행할 때, 개별 에이전트의 국소적 최적화와 의사결정 비용이 전체 시스템의 목표 달성을 저해할 수 있음을 보여줍니다. 이는 향후 자율형 AI 군집 설계 시 목표 정렬과 효율적인 거버넌스 구조가 핵심 과제임을 시사합니다.
GeekNews / Hada
이 프로젝트는 AI가 생성하는 허위 정보를 역으로 교육적 도구로 활용하는 실험적인 접근 방식을 보여줍니다. 기술적으로는 생성형 AI의 환각 현상을 통제된 교육 환경 내에서 실험적 변수로 전환하려는 시도라는 점에서 의미가 있습니다.
GeekNews / Hada
UI 설계 시 최소 폰트 크기와 행간 설정이 확대 시의 가독성에 미치는 영향을 간과하면 접근성 위반이 발생할 수 있습니다. 개발자는 텍스트 확대 환경에서도 레이아웃이 깨지지 않도록 유연한 단위와 구조를 설계해야 합니다.
GeekNews / Hada
정부의 디지털세 도입이 비영리 오픈소스 재단에 예기치 못한 재정적 압박을 가하며 기술 생태계의 지속 가능성 문제를 야기하고 있습니다. 이는 과세 대상의 정의와 비영리 단체의 운영 방식 사이의 법적 충돌 가능성을 시사합니다.
GeekNews / Hada
이번 조치는 대규모 트래픽을 발생시키는 플랫폼 기업에 네트워크 인프라 유지 비용을 직접 부과하려는 시도입니다. 이는 데이터 전송량에 따른 과세 체계를 구축하여 통신 인프라 비용을 콘텐츠 제공업체와 분담하려는 정책적 변화를 의미합니다.
GeekNews / Hada
이번 사건은 하드웨어 보안 기능이 데이터 암호화와 별개로 작동할 때 발생하는 치명적인 설계 결함을 보여줍니다. 물리적 접근이 가능한 상황에서 암호화되지 않은 저장 매체를 사용하는 것은 보안 제품으로서의 본질적인 가치를 상실한 것입니다.
GeekNews / Hada
공공 안전을 위한 기술 도입이 계약 종료 후 장비 철거 문제와 맞물리며 법적·물리적 갈등으로 번진 사례입니다. 이는 하드웨어와 소프트웨어가 결합된 서비스 계약에서 계약 해지 시 물리적 자산 회수 및 관리 주체에 대한 명확한 가이드라인이 필요함을 시사합니다.
2006년형 아이팟 비디오 5.5G 모델에서 llama2.c의 TinyStories 모델을 구동하는 데 성공한 기술적 시도가 공유되었습니다. FPU가 없는 저사양 하드웨어의 한계를 극복하기 위해 정수 연산과 룩업 테이블을 활용한 최적화가 이루어졌습니다.
코드 검색 및 스키마 기반 임베딩 모델인 papr-embed 시리즈가 출시되었습니다. 특히 오픈 웨이트 모델인 papr-embed-code-1은 MTEB 코드 리더보드에서 압도적인 성능을 기록하며 효율적인 코드 검색 능력을 입증했습니다.
코딩 에이전트가 사용자의 환경에 맞춰 커스터마이징할 수 있는 오픈소스 안드로이드 런처가 소개되었습니다. 사용자의 코딩 작업 효율을 높이기 위해 설계된 새로운 형태의 모바일 인터페이스입니다.
게임 리버스 엔지니어링 방지를 위한 보안 조치에 대응하여, 모델에 전달되는 컨텍스트를 익명화하는 번역 레이어 도입 아이디어를 제안합니다. 에이전트가 수행하는 실제 작업 내용이 모델에 직접 노출되지 않도록 가상의 데이터로 치환하고 이를 다시 복원하는 방식입니다.
RAG 기술과 관련된 새로운 프로젝트, 저장소, 데모, 블로그 포스트 또는 제품 출시를 공유하는 주간 이벤트입니다. 규모에 상관없이 모든 형태의 RAG 관련 성과물을 환영하는 게시물입니다.
사용자가 Plex와 같은 편리한 인터페이스를 갖춘 단순한 로컬 미디어 플레이어를 만들기 위해 AI 코딩 도구를 활용하여 Kinema를 개발한 경험담입니다. 서버나 계정 없이 로컬 파일 중심의 기능을 구현하기 위해 AI와 수많은 시행착오를 거치며 소프트웨어를 구축했습니다.
39건
읽어볼 만한 AI 연구
AI 연구
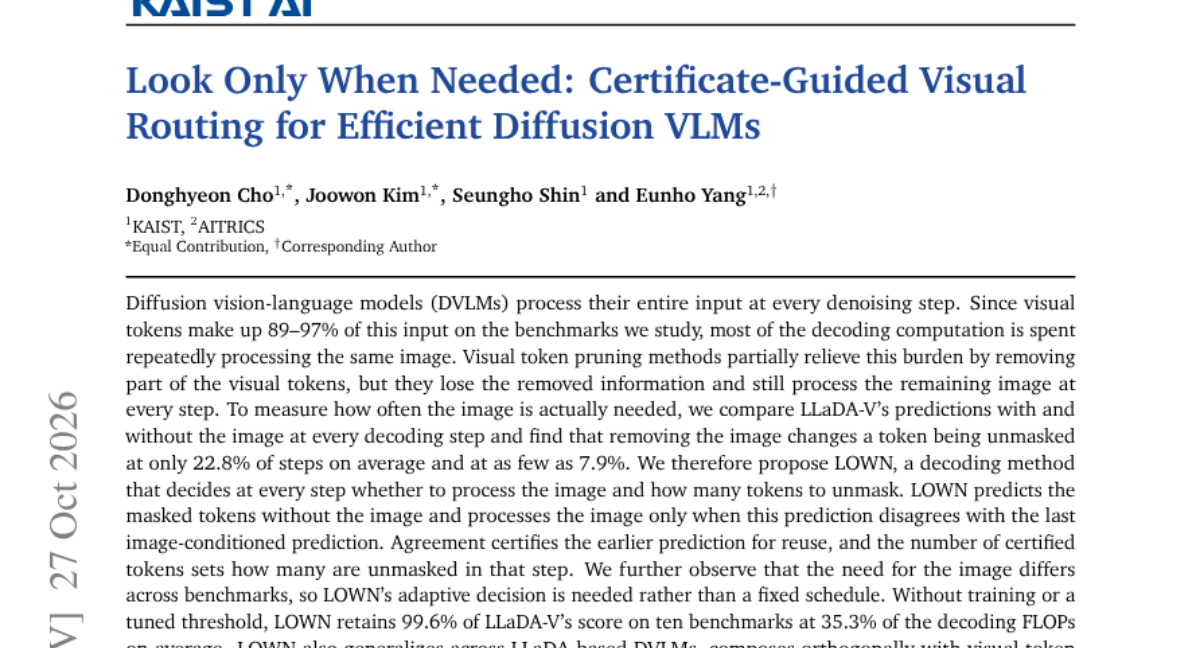
Diffusion Vision-Language Models(DVLMs)는 매 디노이징 단계마다 전체 입력(이미지 포함)을 처리하므로 막대한 연산 비용이 발생합니다. 기존의 시각 토큰 프루닝 방식은 정보 손실 위험이 있고 매 단계 이미지를 처리해야 한다는 한계가 있습니다. 본 논문은 이미지 없이 예측한 결과와 이미지 기반 예측이 일치하는 구간이 많다는 점에 착안하여, 예측 불일치가 발생할 때만 이미지를 처리하는 LOWN 방식을 제안합니다. LOWN은 예측 일치 여부를 통해 이미지 처리 여부와 언마스킹할 토큰 수를 동적으로 결정합니다. 실험 결과, 추가 학습 없이도 성능 저하를 최소화하면서 디코딩 FLOPs를 약 35.3% 수준으로 낮추는 성과를 거두었습니다.
AI 연구
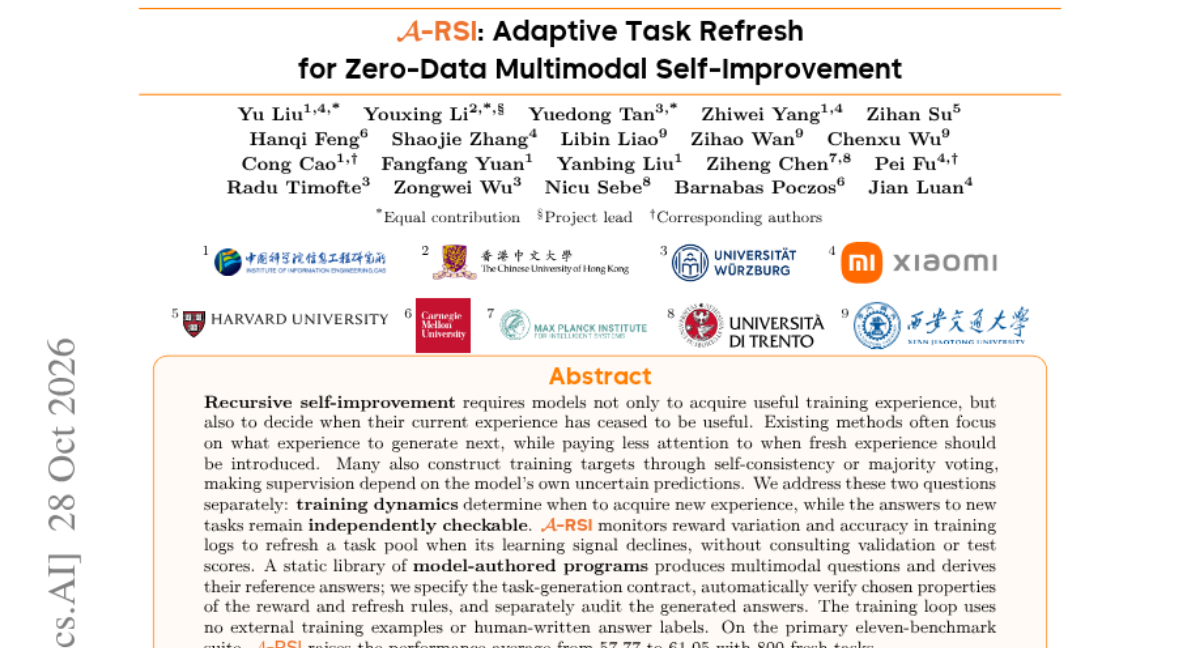
모델의 재귀적 자기 개선 과정에서 언제 새로운 학습 경험이 필요한지 결정하는 것은 매우 중요합니다. 기존 방식은 주로 어떤 데이터를 생성할지에만 집중하며, 모델의 불확실한 예측에 의존해 정답을 만드는 경향이 있습니다. 본 논문은 학습 로그의 보상 변화와 정확도를 모니터링하여 학습 신호가 감소할 때 과제를 갱신하는 A-RSI를 제안합니다. 정적 프로그램 라이브러리를 통해 멀티모달 질문과 정답을 생성하며, 외부 데이터나 인간의 라벨 없이도 검증 가능한 과제를 생성합니다. 실험 결과, 800개의 새로운 과제 도입만으로 주요 벤치마크 성능을 57.77에서 61.05로 향상시켰습니다.
AI 연구
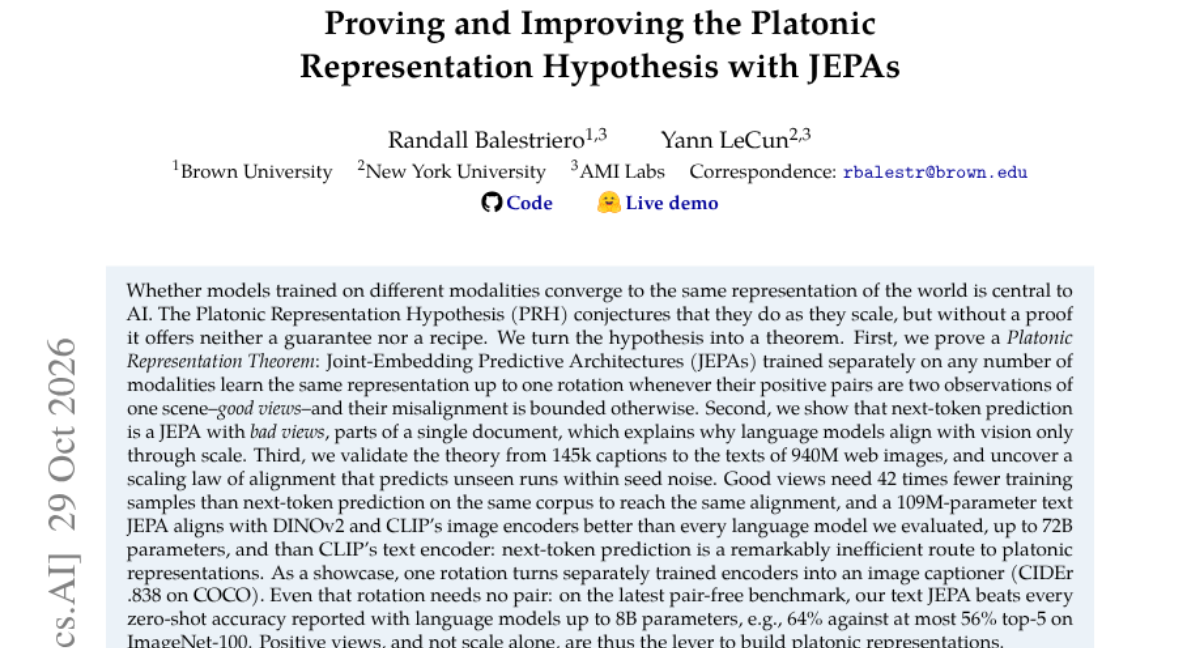
서로 다른 모달리티로 학습된 모델들이 동일한 세계 표현으로 수렴한다는 '플라토닉 표현 가설(PRH)'은 스케일링에 따른 현상일 뿐 수학적 증명이 부족했습니다. 본 논문은 JEPAs(Joint-Embedding Predictive Architectures)를 통해 이 가설을 정리된 정리(Theorem)로 변환합니다. 연구 결과, 단순한 다음 토큰 예측(Next-token prediction)은 문서의 일부를 학습하는 '나쁜 관점'을 가진 JEPA로 작용하여 정렬 효율이 낮음을 밝혀냈습니다. 반면, 동일한 장면의 서로 다른 관점을 학습하는 '좋은 관점' 방식은 훨씬 적은 데이터로도 강력한 정렬을 달성합니다. 실험을 통해 제안된 방식이 기존 대규모 언어 모델보다 적은 파라미터로도 더 뛰어난 시각-언어 정렬 성능을 보임을 입증했습니다.
AI 연구
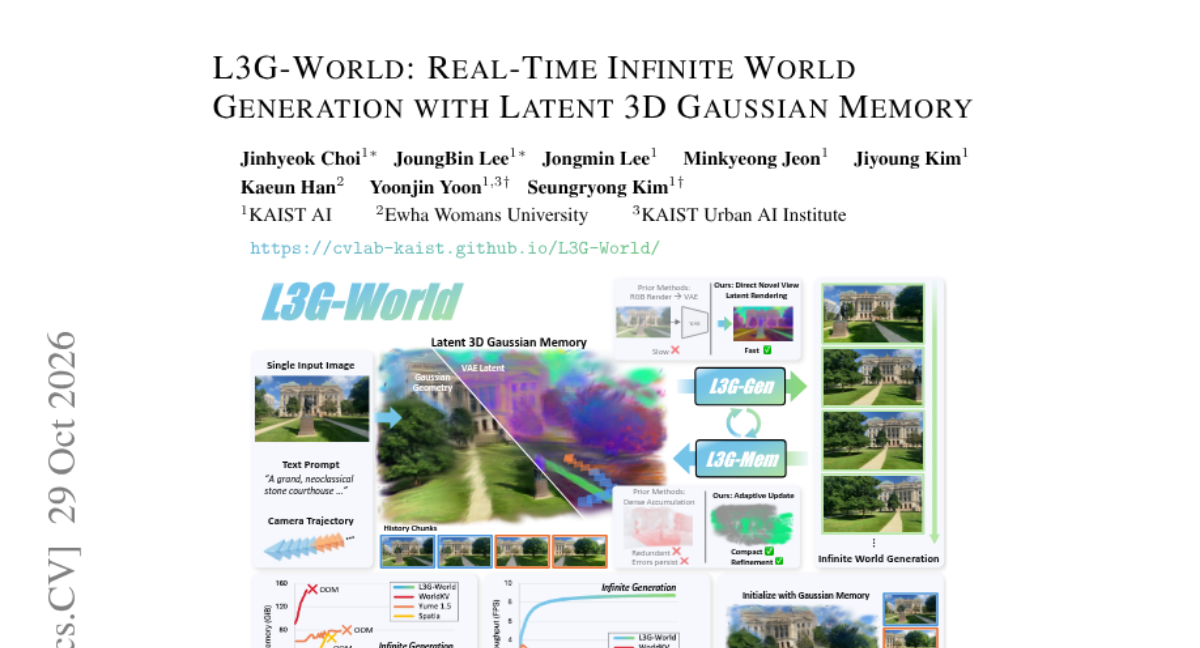
기존의 인터랙티브 월드 모델은 긴 시간 동안 탐험할 때 공간 일관성을 유지하기 어렵고, 메모리 크기가 생성 길이에 비례하여 늘어나는 문제가 있었습니다. 또한 기존 3D 메모리 방식은 렌더링 후 다시 인코딩하는 과정 때문에 실시간 생성이 불가능했습니다. 본 논문은 효율적인 피드포워드 재구성과 압축된 3D 표현을 결합한 Latent 3D Gaussian Memory(L3G)를 제안합니다. L3G-World는 메모리 업데이트 모듈과 비디오 확산 트랜스포머(DiT)가 교차로 작동하며 공간 일관성을 유지합니다. 메모리 업데이트는 관찰된 영역에 가우시안을 생성/정제하여 메모리 크기를 스트림 길이가 아닌 장면 크기에 맞게 관리합니다. 결과적으로 기존 방식 대비 압도적인 속도 향상을 달обра며 9 FPS의 실시간 세계 생성을 달성했습니다.
AI 연구
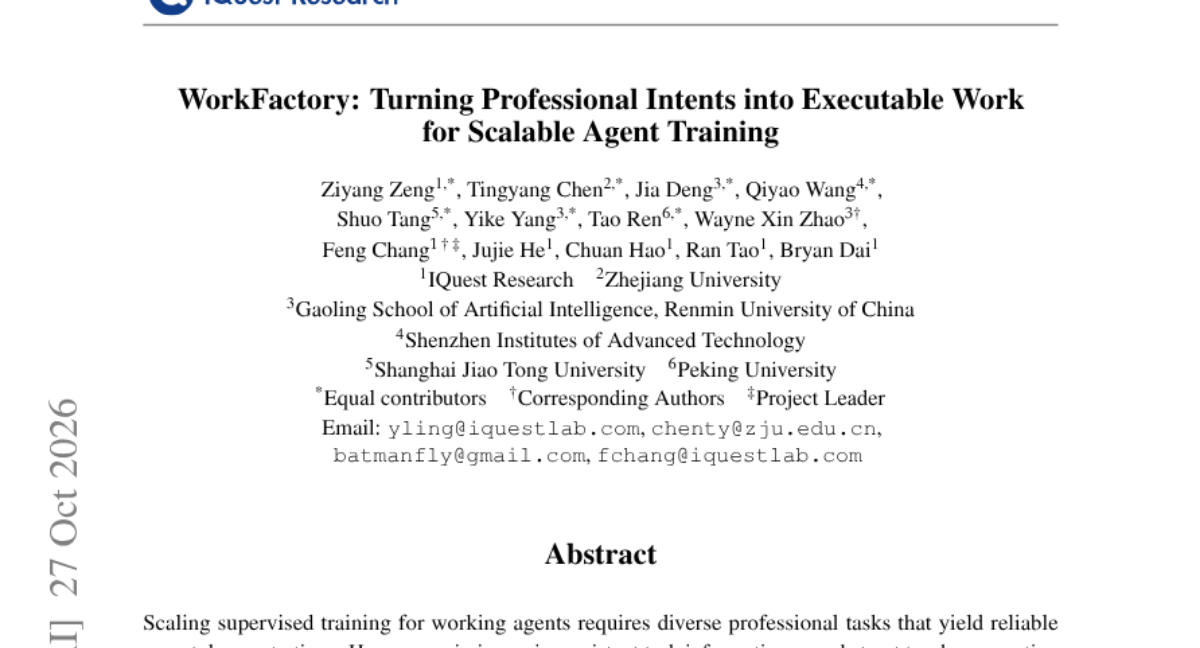
에이전트의 지도 학습을 위해서는 신뢰할 수 있는 전문가 데모가 포함된 다양한 전문 작업 데이터가 필요합니다. 그러나 작업 정보가 누락되거나 일관되지 않으면 작업 수행이 방해받고 학습 품질이 저하되는 문제가 발생합니다. 이를 해결하기 위해 의도로부터 정보 지원 그래프를 구축하여 작업 인스턴스화를 가이드하는 WorkFactory 프레임워크를 제안합니다. 프로브 실행(Probe executions)을 통해 정보 부족을 식별하고 작업을 수정함으로써 실행 가능한 태스크를 생성합니다. 이를 통해 612개 직업군에 걸친 11만 개 이상의 작업을 구축하고 WorkPilot 모델 시리즈를 학습시켰습니다. 실험 결과, 제안된 방법론이 전문 작업 벤치마크 성능을 크게 향상시킴을 확인했습니다.
AI 연구
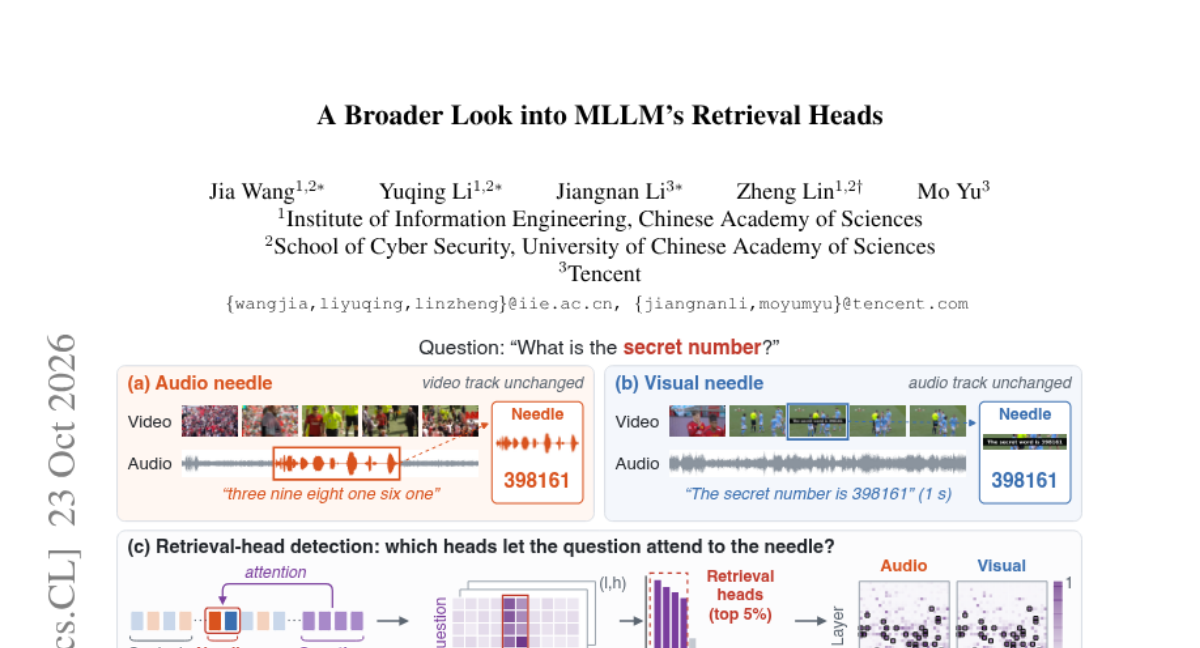
멀티모달 거대언어모델(MLLM)은 긴 입력에서 관련 증거를 찾는 능력이 중요하지만, 기존 연구는 특정 모달리티에 국한되어 있었습니다. 본 논문은 오디오-비주얼 등 다양한 모달리티가 추가될 때 retrieval heads의 메커니즘이 어떻게 확장되는지 분석했습니다. 실험 결과, retrieval heads는 모달리티 간에 상당 부분 공유되며 매우 희소한(sparse) 형태로 존재함을 확인했습니다. 이러한 heads를 랭킹 목적 함수로 최적화함으로써 문서 이해 및 멀티모달 검색 성능을 유의미하게 개선했습니다. 결과적으로 기능적 어텐션 헤드는 모델 분석과 성능 향상 모두를 위한 핵심 요소임을 입증했습니다.
AI 연구
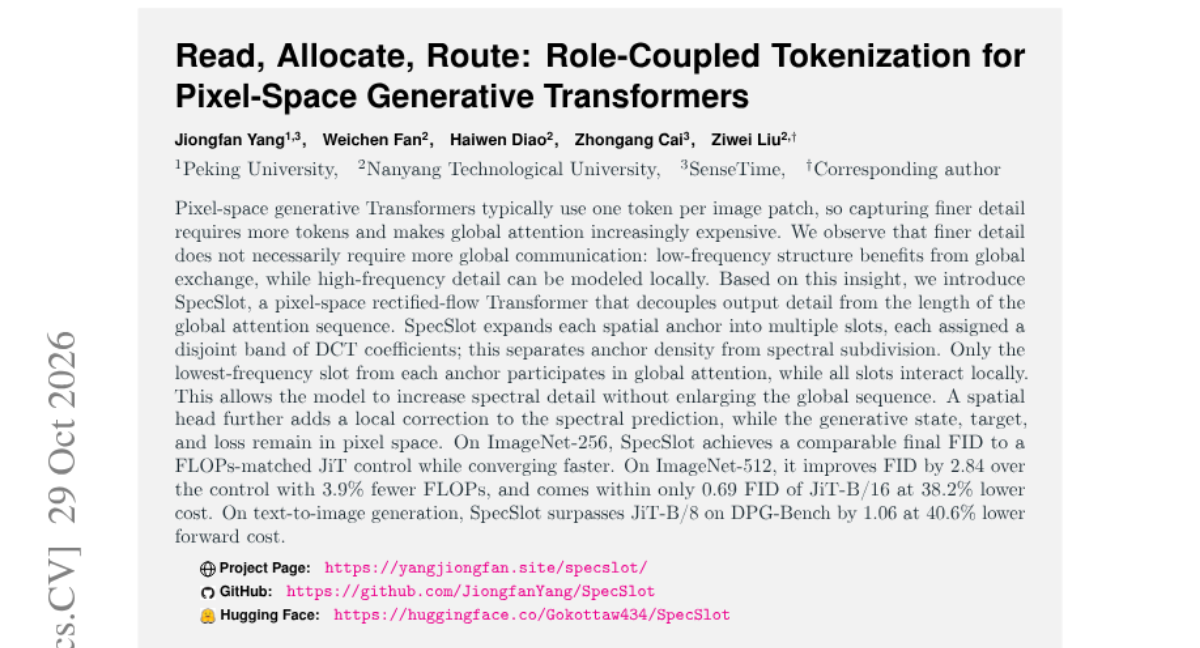
픽셀 공간의 생성 트랜스포머는 패치당 하나의 토큰을 사용하여 고해상도 디테일을 구현할 때 연산 비용이 급증하는 문제가 있습니다. 저자들은 저주파 구조는 글로벌 통신이 필요하지만, 고주파 디테일은 국소적 모델링만으로도 충분하다는 점에 주목했습니다. 이를 위해 각 공간 앵커를 여러 슬롯으로 확장하고 DCT 계수를 분할 할당하는 SpecSlot 방식을 도입했습니다. 저주파 슬롯만 글로벌 어텐션에 참여시키고 나머지 슬롯은 로컬로 상호작용하게 하여 시퀀스 길이를 유지하며 디테일을 높였습니다. 실험 결과, ImageNet 고해상도 생성에서 기존 모델 대비 낮은 연산 비용(FLOPs)으로 더 우수한 FID 성능을 달성했습니다.
AI 연구
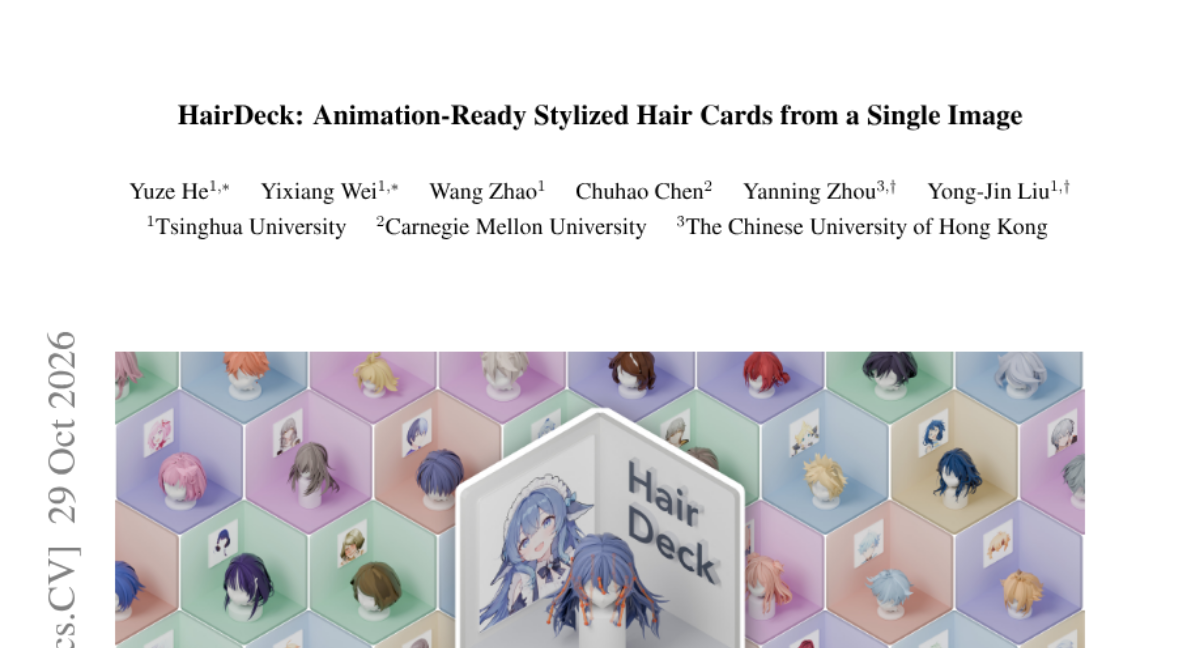
게임 및 아바타 제작 시 스타일라이즈드 캐릭터의 헤어 카드는 아티스트가 직접 배치하는 리본 형태의 기하 구조를 의미합니다. 기존 방식은 실사 위주이거나 단일 메시를 생성하며, 기존의 CHARM 방식은 자기회귀 방식으로 생성하여 효율성이 낮았습니다. 본 논문은 헤어 카드를 순서가 없는 집합(unordered set)으로 정의하고, 각 카드를 하나의 토큰으로 처리하는 Set Diffusion Transformer를 제안합니다. 이를 통해 단일 이미지로부터 애니메이션용 스프링 본 체인과 헤어 카드를 동시에 생성합니다. 실험 결과, 기존 CHARM 대비 속도는 33배 빠르면서도 기하학적 오차를 크게 줄이며 우수한 성능을 보였습니다.
AI 연구
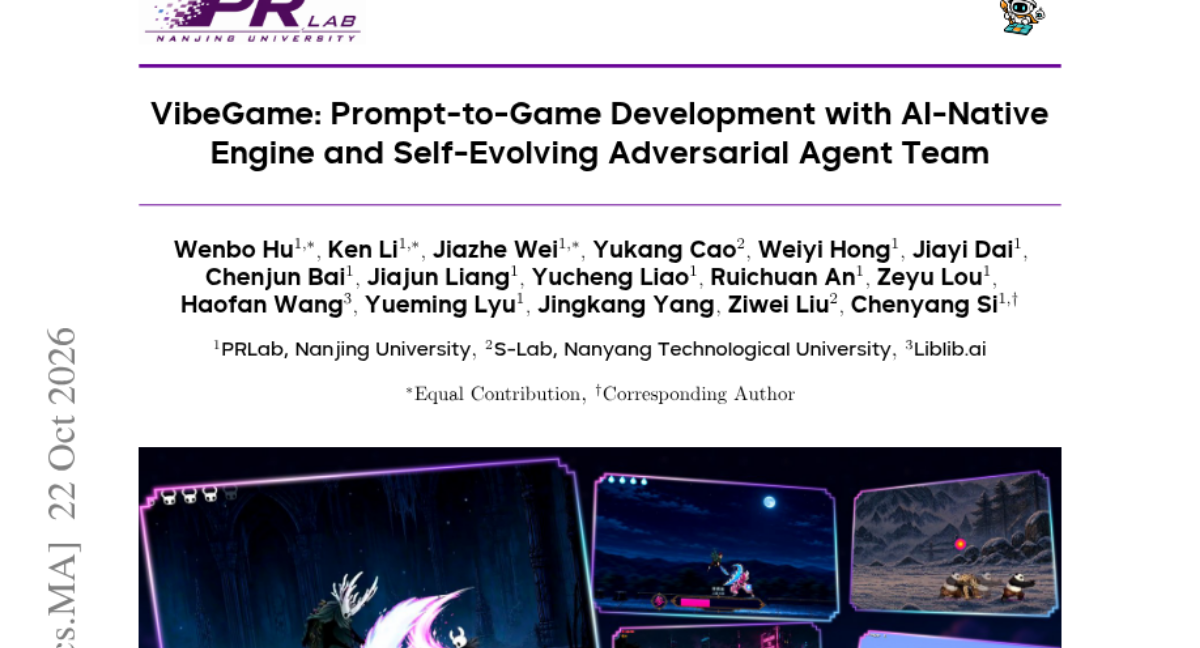
LLM 에이전트를 통한 소프트웨어 개발은 발전하고 있으나, 코드와 에셋, 물리 엔진 등이 복합적으로 작용하는 게임 개발로의 확장은 여전히 어렵습니다. 본 논문은 자연어와 이미지를 통해 완전한 2격 2D 게임 프로젝트를 생성하는 VibeGame 프레임워크를 제안합니다. 이 시스템은 게임 상태를 스키마 검증이 가능한 구조화된 텍스트로 표현하는 AI 네이티브 엔진을 통해 에이전트가 상태를 검사하고 동작을 검증할 수 있게 합니다. 또한, 8개의 전문 에이전트로 구성된 적대적 에이전트 팀(Adversarial Agent Team)을 통해 구현과 리뷰를 분리하여 문제 해결 루프를 구축했습니다. 마지막으로 생성된 프로젝트를 재사용 가능한 모듈로 정제하는 자기 진화 메커니즘을 도입했습니다. 실험 결과, VibeGame은 기존 에이전트 프레임워크 대비 뛰어난 게임 생성 성능을 입증했습니다.
AI 연구
사용자의 멀티모달 요청을 실제 작동하는 애플리케이션 수정으로 변환하는 에이전트 평가의 필요성이 커지고 있습니다. 본 논문은 26,314개의 실제 사용자 코딩 세션에서 추출한 273개의 태스크로 구성된 Co-Design Bench를 소개합니다. 이 벤치마크는 로컬 편집(ME)과 저장소 편집(RE) 두 트랙을 통해 이해도, UI 변환, 기능 구현 능력을 평가합니다. 평가를 위해 정답 코드 대신 전문가가 작성한 2,331개의 수락 기준(acceptance criteria)과 검증 프로토콜을 사용합니다. 실험 결과, 모델들은 부분적인 요구사항은 충족하지만 전체 태스크를 완벽히 완수하는 데는 어려움을 겪는 것으로 나타났습니다.
AI 연구
최근 1~2단계의 적은 스텝으로 고품질 이미지를 생성하는 기술이 중요해졌으나, 적은 단계에서는 프롬프트 세부 사항을 정확히 렌더링하기 어렵습니다. 기존의 DMD 방식은 별도의 스코어 네트워크를 사용하지만, 본 논문은 명시적인 모멘트 제약(moment constraint)이 학습된 스코어 감독 성능을 개선할 수 있는지 질문합니다. 이를 위해 역-KL 발산(reverse-KL)을 가우시안 모멘트 성분과 비가우시안 잔차로 분해하여 제약 가능한 통계량을 식별했습니다. 제안하는 IDM 방식은 전체 DMD 보정 기능을 유지하면서, 외부 인코더 없이 생성기 자체의 EMA 복사본을 사용하여 피처 평균과 좌표별 표준편차를 일치시킵니다. 실험 결과, IDM은 Z-Image-Turbo 및 Qwen-Image 모델에서 기존 방식 대비 높은 텍스트-이미지 정렬 성능을 달리는 것을 확인했습니다.
AI 연구
기존의 벤치마크는 단순한 문제 집합을 넘어 난이도에 대한 경험적 측도를 형성하지만, 이에 대한 이론적 분석은 부족했습니다. 본 연구는 벤치마크가 의도와 다르게 난이도 분포가 치우치는 '측도 불일치(measure mismatch)'와 특정 난이도 구간이 누락되는 '커버리지 공백(coverage gaps)' 문제를 정식화합니다. 이를 진단하기 위한 두 가지 지표를 제안하고 25개 주요 벤치마크를 분석한 결과, 많은 벤치마크가 특정 난이도에 편중되어 있음을 확인했습니다. 마지막으로 공백을 메우기 위해 난이도 타겟형 문항 재작성 알고리즘인 BenchFill을 제안합니다.
AI 연구
최근 언어 모델 학습에서 성능 향상과 추론 가속을 위해 Multi-Token Prediction(MTP)이 널리 사용되고 있습니다. 그러나 기존 MTP 학습 방식은 잔차(residual) 성분이 차기 토큰 예측(NTP)과 다중 토큰 학습 모두를 방해하는 결함이 있음을 발견했습니다. 이를 해결하기 위해 저자들은 KL 발산(KL divergence) 신호만 정확히 추출하여 역전파하는 'KL gradient-recovery trick'을 도입했습니다. 이 기법을 적용한 Soft-MTP는 추가 파라미터나 연산 오버헤드 없이 기존 MTP의 노이즈를 제거하고 유용한 신호만 활용합니다. 실험 결과, 다양한 규모에서 NTP 퍼플렉시티 개선, 더 빠른 추측적 디코딩(speculative decoding), 그리고 수학 및 코드 추론 능력 향상을 입증했습니다.
AI 연구
긴 분량의 영상을 제작하려면 샷 간의 일관성을 유지하는 복잡한 의사결정이 필요하지만, 기존의 다단계 에이전트는 비용과 품질 사이의 균형을 맞추기 어려웠습니다. 이를 해결하기 위해 WeVisCut은 도구 실행과 정책 학습을 결합한 스크립트-투-비디오 시스템을 제안합니다. 에이전트 하네스는 공유된 제작 상태를 유지하여 도구 피드백을 바탕으로 의사결정과 오류 복구를 수행합니다. 데이터 파이프라인은 편집 역추적과 검증된 재생 방식을 결합하여 13만 개 이상의 학습 데이터를 생성합니다. 이를 통해 학습된 9B 모델은 단일 에이전트로서 제작 조율 및 실패 복구 기능을 수행합니다. 실험 결과, WeVisCut은 기존 모델보다 우수한 성능을 보이면서도 토큰 사용량을 획기적으로 줄여 효율성을 입증했습니다.
AI 연구
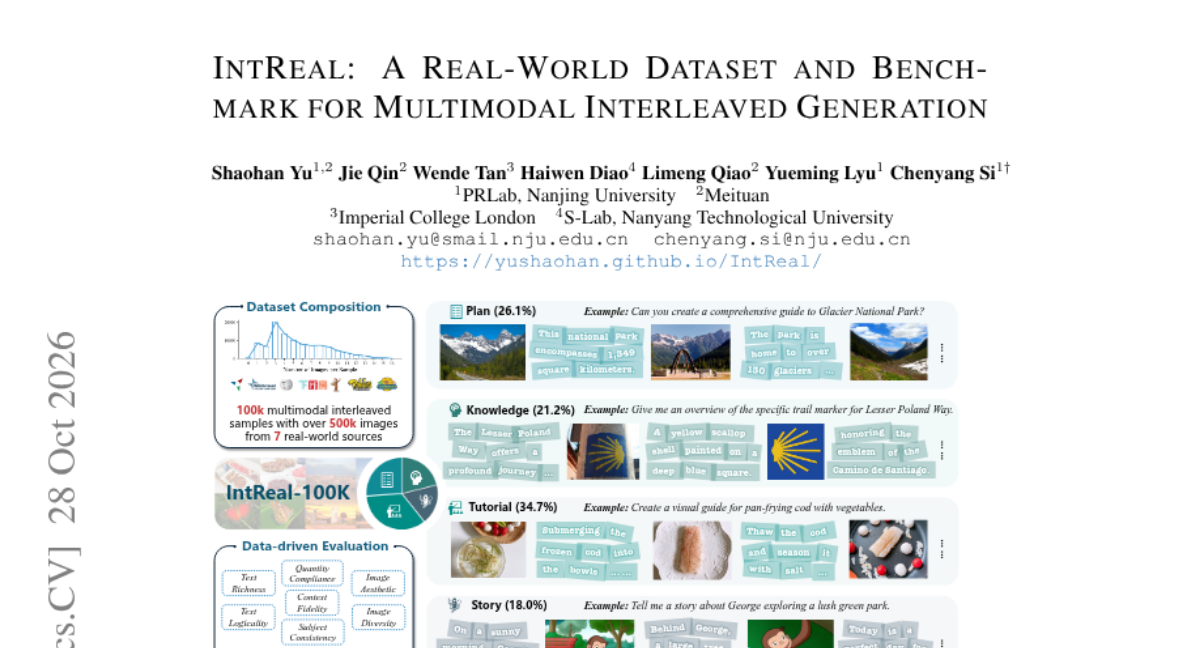
인간은 텍스트와 이미지가 자연스럽게 섞인 멀티모달 콘텐츠를 소비하지만, 이를 생성하는 기술은 아직 충분히 연구되지 않았습니다. 기존 연구는 명확한 태스크 정의와 학습 데이터가 부족하며, 모델의 성능을 세부적으로 진단할 평가 프로토콜도 부재한 상황입니다. 이를 해결하기 위해 4개 카테고리의 실세계 데이터셋인 IntReal-100K와 7개 차원의 정밀 진단이 가능한 IntReal Evaluation Suite를 제안합니다. 실험 결과, 제안된 평가 방식은 인간의 판단과 높은 일치도를 보이며 모델별 강점과 약점을 명확히 식별했습니다. 또한 IntReal-100K를 통한 학습이 생성 성능을 향상시키며, 단일 모달리티 최적화만으로도 혼합 생성 능력이 개선될 수 있음을 입증했습니다.
AI 연구
기존의 멀티모달 모델들은 다양한 데이터 형식을 처리하기 위해 복잡한 구조를 요구하는 경우가 많았습니다. 본 논문은 모든 모달리티를 하나의 인코더와 하나의 스키마로 통합하는 Youtu-Parsing-Omni를 제안합니다. Youtu-Omni-Encoder는 공유 가중치를 통해 시공간 좌표계 내에서 모든 모달리티를 인코딩하며, OSAD라는 자기 진화형 사후 학습 방식을 통해 태스크 간 정렬을 수행합니다. 실험 결과, 이 모델은 OmniDocBench 및 OmniParsingBench 등 주요 벤치마크에서 SOTA 성능을 달كيل 뿐만 아니라 차트 및 악보 파싱에서도 탁월한 성능을 보였습니다. 결과적으로 단일 5B 파라미터 체크포인트만으로 강력한 범용 파싱 능력을 입증했습니다.
AI 연구
기존의 음성 대화 모델(SDM)은 생성과 합성 토큰 공간을 공유하여 긴 시퀀스로 인한 높은 추론 비용 문제를 겪습니다. 저율(low-rate) 토크나이저를 사용하면 시퀀스는 짧아지지만 품질 저하나 기존 모델과의 호환성 문제가 발생합니다. 이를 해결하기 위해 CoSTA는 기존 토크나이저와 디코더를 유지하면서 생성과 합성 토큰 공간을 분리하는 post-hoc 프레임워크를 제안합니다. CoSTA는 어휘 확장, 발음 적응, 대화 적응 과정을 거쳐 압축된 토큰을 생성한 뒤, 합성 전 다시 원래의 토큰 공간으로 결정론적 확장을 수행합니다. 실험 결과, 응답 품질을 유지하면서도 생성 속도를 약 1.7배 높이고 지연 시간과 처리량을 개선했습니다.
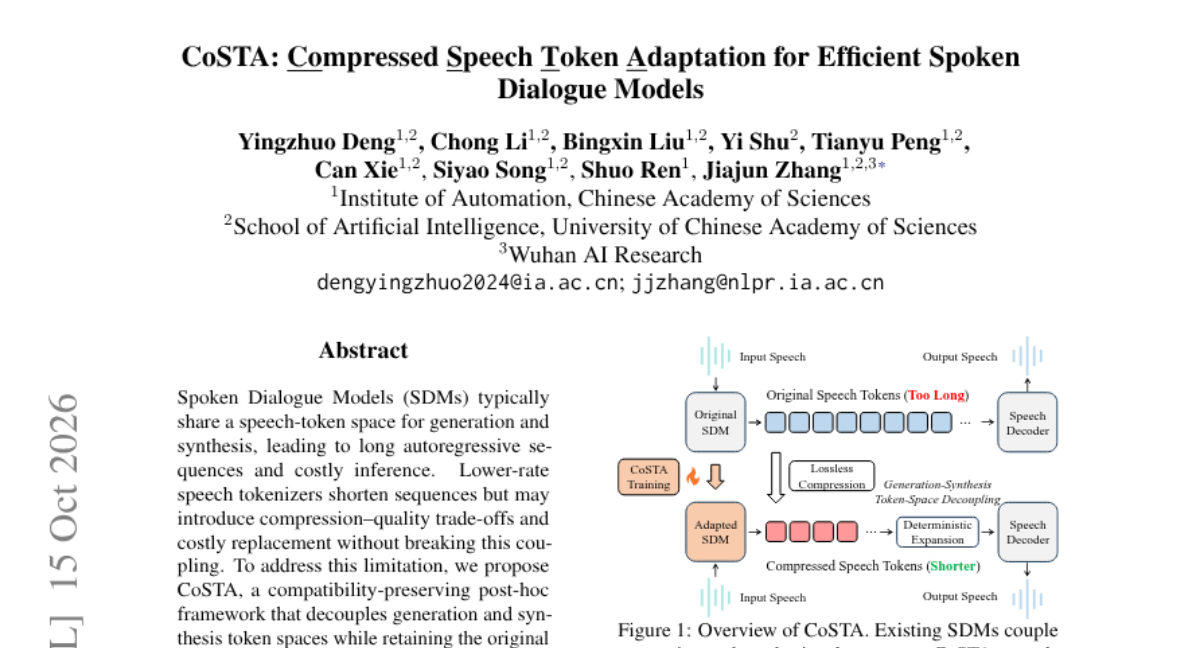
AI 연구
웹 에이전트 학습을 위해서는 실행 및 초기화가 가능한 다양한 웹 환경이 필요하지만, 기존의 수동 미러링은 사이트별 엔지니어링이 필요하고 생성형 방식은 실제 웹과 괴리될 위험이 있습니다. 본 논문은 실제 URL로부터 소스 기반의 재사용 가능한 웹 환경을 자동 구축하는 WebAnything 프레임워크를 제안합니다. Explorer-Builder가 브라우저 구조와 상호작용 결과를 수집하고, 독립적인 검증기가 후보를 확인하며 국소적 복구 또는 타겟팅된 재수집을 가이드합니다. 실험 결과, 14개 도메인에 걸쳐 244개의 웹 아티팩트를 구축하였으며 기존 방식보다 높은 충실도(fidelity)를 달성했습니다. 또한 Qwen3.5-9B 모델을 이 데이터로 파인튜닝했을 때 다양한 웹 에이전트 벤치마크에서 성능 향상을 입증했습니다.
AI 연구
기존 금융 벤치마크는 단편적인 지식이나 워크플로우 평가에 치중되어 있어, 실제 투자 결정에 필요한 전체 연구 과정을 평가하기 어려웠습니다. 이를 해결하기 위해 전문 투자자들이 설계한 주식 리서치 벤용 벤치마크인 Investor's Last Exam(ILE)을 도입했습니다. ILE는 시점별 데이터가 엄격히 통제된 데이터베이스, 전문 분석 업무 중심의 태스크 분류, 그리고 근거-가정-판단을 연결하는 전문가 프레임워크를 특징으로 합니다. 실험 결과, 최신 모델들이 전반적인 리서치 능력은 보여주었으나 실제 예측 및 모델링 성능은 현저히 낮게 나타났습니다. 결과적으로 ILE는 AI 에이전트의 분석 역량이 어떻게 투자 성과로 이어지는지 추적하고 진단할 수 있는 기반을 제공합니다.
AI 연구
기존 RAG 시스템은 Reranker와 Generator가 별도의 모델로 운영되어 모델 상주 비용과 중복된 연산이 발생하는 문제가 있었습니다. 이를 해결하기 위해 Glance는 하나의 백본 모델에 경량 어댑터와 포인터 헤드를 결합한 방식을 제안합니다. 공유된 Prefill 단계에서 생성된 KV 캐시를 활용하여, 별도의 재입력 없이 짧은 relevance probe를 통해 후보 문서들을 스코어링합니다. 실험 결과, Glance는 SciFact 및 NFCorpus에서 기존 bge-reranker-v2-m3보다 높은 성능을 보였으며 HotpotQA에서도 우수한 답변 정확도를 기록했습니다. 특히 대규모 컨텍스트에서도 성능이 유지되며, 단일 백본만으로 효율적인 Reranking이 가능함을 입증했습니다.
AI 연구
최근 멀티모달 모델은 수동적 응답을 넘어 능동적 에이전트로 진화하고 있으나, 기존 방식은 정보가 완전하다는 가정하에 동작하는 한계가 있습니다. 실제 환경에서는 비디오나 사용자로부터 발생하는 불확실성으로 인해 정보가 불완전한 경우가 많으며, 이는 모델의 무한 대기나 환각 현상을 유발합니다. 본 논문은 프로액티브 상호작용에 '질문(ask)'이라는 제3의 액션을 도입하여 부족한 정보를 능동적으로 요청하도록 정의합니다. 이를 위해 비디오 및 사용자 불확실성을 모두 고려한 최초의 멀티턴 벤치마크인 AskStream을 제안합니다. 실험 결과, 최신 모델들도 제안된 벤치마크에서 낮은 성능을 보여 현재의 능동적 정보 탐색 능력이 매우 부족함을 입증했습니다.
AI 연구
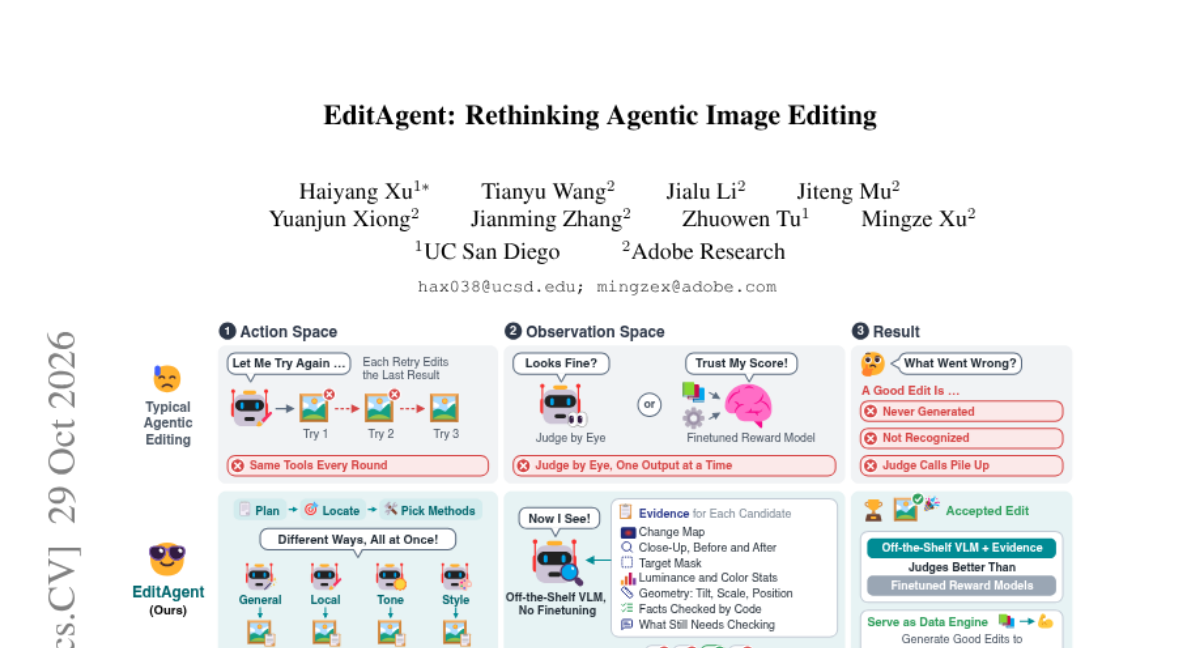
기존의 에이전트 기반 이미지 편집기는 실패 시 동일한 도구만 반복 사용하거나 시각적 판단에만 의존하는 한계가 있습니다. 연구진은 에이전트의 행동 공간(Action Space)과 판단을 위한 관찰 공간(Observation Space)이 제한적이라는 점에 주목했습니다. 이를 해결하기 위해 범용 편집기와 전문화된 편집기를 결Fal하고, 각 후보에 검증 기록을 첨리하는 EditAgent를 제안합니다. EditAgent는 병렬 생성과 리스트 방식의 한 번의 판단을 통해 효율성을 높였습니다. 실험 결과, 기존 오픈 웨이트 모델들의 성능을 개선하고 강력한 편집기 학습을 위한 데이터 엔진 역할까지 수행함을 입증했습니다.
AI 연구
기존의 거대 시각-언어 모델은 높은 추론 비용이 문제였고, 소형 모델은 SFT나 오프라인 RL로 인해 정적 궤적에 매몰되어 오류 복구 능력이 부족했습니다. 이를 해결하기 위해 실시간 iOS 앱 환경에서 직접 학습하는 새로운 온라인 RL 프레임워크를 제안합니다. 에이전트를 Planning 에이전트와 UI Grounding 모델로 분리하고, LLM-as-a-Judge를 통해 단계별 보상과 최종 보상을 결합한 밀집 보상 체계를 구축했습니다. 또한, 유사한 시각적 상태를 활용해 크리틱 안정성을 높이는 GiGPPO 알고리즘과 수백 대의 가상 iOS 기기를 관리하는 인프라를 도입했습니다. 실험 결과, 제안된 8B 모델은 SFT 대비 뛰어난 일반화 성능을 보였으며 Gemini Pro급의 성능을 달성했습니다.
AI 연구
기존 파운데이션 모델 학습은 사전 학습, SFT, RL 등 단계별로 알고리즘과 데이터가 분리되어 진행되었습니다. 연구진은 이러한 단계적 분리가 필수적이지 않다는 점에 주목하여, RL 목적 함수를 최대 우도 추정(MLE) 방식으로 재정의했습니다. 이를 통해 모든 학습 단계를 하나의 우도 기반 알고리즘으로 통합하는 'Unified Training' 프레임워크를 제안합니다. 이 방식은 학습 과정을 데이터의 종류와 비율을 결정하는 문제로 단순화하며, 정적 데이터와 RL 생성 데이터를 단일 트레이너에서 혼합 학습합니다. 실험 결과, 통합 학습은 연산 효율성과 작업 커버리지를 개선하며 지속적 학습을 위한 강력한 기반을 제공함을 입증했습니다.
AI 연구
기존의 객체 삽입 방식은 마스킹된 입력이나 제한된 시점의 데이터에 의존하여 포즈, 조명 적응 및 객체-장면 간의 상호작용 제약이 부족했습니다. 이를 해결하기 위해 다양한 시점과 조명 조건이 정렬된 'Insert World' 데이터셋을 구축했습니다. 제안하는 PhysInsert는 VGGT 기하학 스트림을 활용한 기하학 가이드 적응과 객체 점유 및 환경 변화를 동시에 제어하는 2D 객체-장면 공간 감독 방식을 결합합니다. 실험 결과, 기존 방식보다 향상된 이미지 충실도를 보였으며 사용자 연구에서도 배치 정확도와 조명/원근법 통합 능력이 우수함을 입증했습니다.
AI 연구
최근 Weight-Normalization(WN) 방식이 Weight Decay(WD)의 대안으로 주목받으며 성능 향상을 보였으나, 그 원인이 명확하지 않았습니다. 본 연구는 WN의 성능 향상이 정규화 자체보다 유도된 유효 학습률(ELR) 궤적에 의해 발생함을 증명했습니다. 이에 따라 명목 LR이 아닌 ELR을 타겟팅하는 새로운 스케줄링 방식인 AIR(Affine Inverse-square-Root decay)를 제안합니다. 실험 결과, AIR는 기존 Cosine 스케줄보다 낮은 최종 손실과 더 높은 하이퍼파라미터 강건성을 보여주었습니다. 또한, 동일한 ELR 궤적을 WD에 적용했을 때도 동일한 학습 역학이 나타남을 확인하여 ELR이 스케줄링의 핵심 객체임을 입증했습니다.
AI 연구
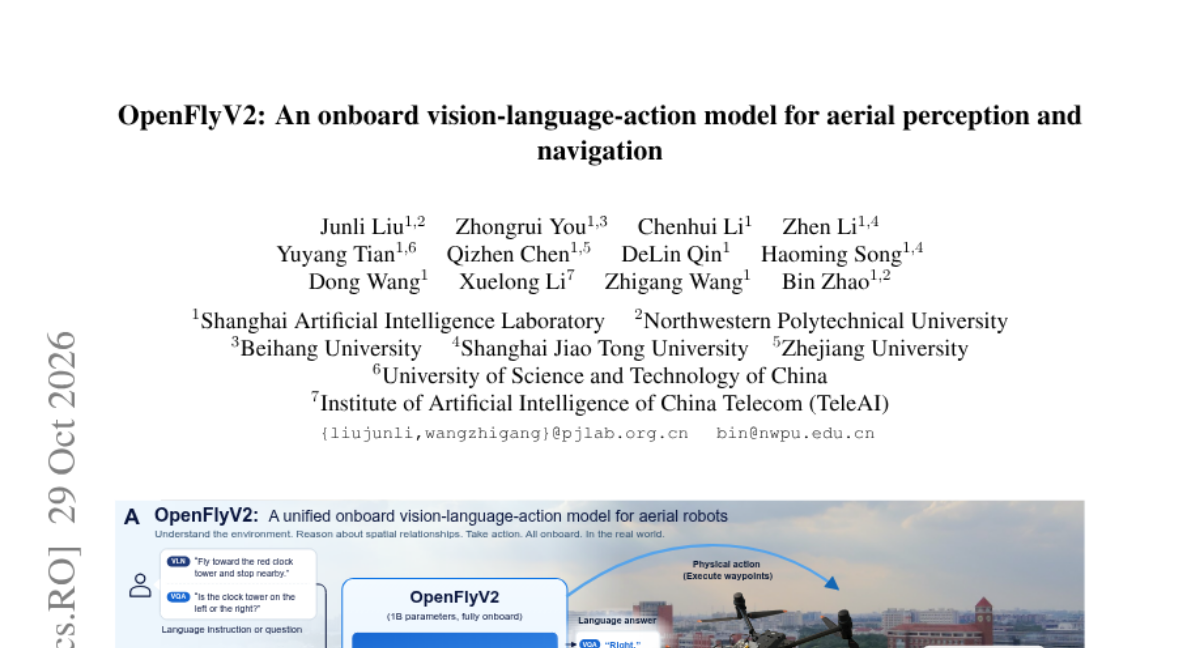
기존의 항공 로봇 시스템은 개별 기능에 특화되어 있거나 고성능 오프보드 연산에 의존하여 폐쇄 루프 제어가 어렵다는 문제가 있었습니다. 본 논문은 시각-언어 표현을 공유하여 의미 이해, 공간 추론, 연속적 비행 제어를 하나의 모델로 수행하는 OpenFlyV2 아키텍처를 제안합니다. 압축된 액션 전문가(Action Expert)와 모션 인지형 시간 메모리를 통해 저사양 플랫폼에서도 효율적인 제어가 가능하도록 설계했습니다. 시뮬레이션 기반의 대규모 데이터셋을 활용해 학습된 결과, NVIDIA Jetson Orin NX 환경에서 10Hz의 속도로 온보드 실행이 가능함을 입증했습니다. 최종적으로 실세계 데이터 없이도 시뮬레이션에서 학습된 모델이 실제 쿼드로터에 제로샷으로 전이되어 성공적인 내비게이션 성능을 보여주었습니다.
AI 연구
개발자들은 로컬 실행을 위해 공개 저장소에서 양자화된 LLM을 다운로드하지만, 기존 저장소들은 파일의 기능적 무결성을 검증하지 않습니다. 연구진은 Ollama와 Hugging Face의 수백 개 GGUF 태그를 대상으로 코드 생성 능력을 테스트했습니다. 분석 결과, 일부 공식 태그에서도 심각한 기능 저하가 발견되었으며, 이는 파일 손상이 아닌 양자화 과정의 설정 문제임이 밝혀졌습니다. 특히 저비트 양자화 모델에서 이러한 문제가 두드러졌으며, 단순한 재현성이 기능적 정상 작동을 보장하지 않음을 확인했습니다. 이를 해결하기 위해 연구진은 감사 데이터와 함께 검증 도구인 quantcheck를 공개합니다.
AI 연구
기존의 수학적/프로그래밍적 벤치마크는 점차 포화 상태에 이르러 실세계 코드 검증 능력을 측정하기 어려워지고 있습니다. 이를 해결하기 위해 재귀적 에이전트, 비동기 탐색, 탄력적 정교화 서비스를 결합한 EasyProver 시스템을 제안합니다. 또한, 경쟁 프로그래밍 문제를 고난도 검증 과제로 변환하는 Aegis 파이프라인을 도입하여 실질적인 구현 수준의 과제를 생성합니다. 실험 결과, EasyProver는 PutnamBench와 IMO 문제 등에서 탁월한 성능을 보였으며, Aegis를 통해 생성된 1만 개 이상의 복잡한 Rust-Lean 과제에서도 높은 검증 성공률을 기록했습니다. 이 연구는 자동화된 정형 검증과 RL 학습을 위한 고난도 데이터셋 제공에 기여합니다.
AI 연구
비디오 확산 트랜스포머는 고품질 영상 생성에 탁월하지만, 3D 풀 어텐션의 이차 복잡도 문제로 인해 추론 비용이 매우 높습니다. 기존의 동적 블록 희소 어텐션은 높은 희소도에서 정확도가 떨어지거나, 블록 단위 선택 방식이 세밀한 토큰 정보를 반영하지 못하는 한계가 있습니다. 이를 해결하기 위해 제안된 AB-Attention은 쿼리 블록 내 클러스터링을 통해 중요도를 추정하는 IBCS와 포함 확률 가중치를 적용한 SIP 방식을 도입합니다. 또한, 텐서 코어 연산 효율을 유지하면서도 작은 크기의 KV 블록을 모아 처리하는 커널을 통해 정밀한 선택을 지원합니다. 실험 결과, Wan2.1 및 HunyuanVideo 모델에서 89~92%의 높은 희소도를 달에서도 성능 저하를 최소화하며 최대 2.23배의 속도 향상을 달성했습니다.
AI 연구
언어 에이전트가 외부 도구를 사용하는 과정에서 인터페이스 표현 방식이 모델의 의사결정에 미치는 영향이 중요해지고 있습니다. 본 연구는 동일한 기능을 제공하더라도 MCP와 CLI처럼 표현 방식이 다를 때 에이전트의 행동이 어떻게 변하는지 분석합니다. 이를 위해 동일한 시맨틱 액션 계약을 기반으로 인터페이스를 비교하는 MICA 방법론을 도입했습니다. 실험 결과, 인터페이스 표현 방식의 차이가 작업 성능, 상호작용 비용, 실패 경로 등에 상당한 차이를 유발함을 확인했습니다. 이를 해결하기 위해 시맨틱 의사결정은 유지하되 인터페이스 구현만 최적화하는 DART 프레임워크를 제안합니다. 결과적으로 DART는 벤치마크 점수를 높이고 토큰 비용을 크게 절감하는 성과를 보였습니다.
AI 연구
저가형 로봇 팔인 SO-101은 로봇 학습의 입문점으로 쓰이지만, 기존 벤치마크는 단순한 작업 위주이거나 물리적 하드웨어에만 국한되어 있었습니다. 본 논문은 실제 SO-101 환경의 디지털 트윈인 Isaac Lab 기반 'SO-101 Bench'를 소개합니다. 이 벤치마크는 다양한 객체와 공간 제약 조건(회전, 가려짐 등)을 포함하며, 시뮬레이션과 실물 로봇 간의 순위 상관관계가 완벽하게 일치함을 입증했습니다. 실험 결과, LLM 에이전트가 코드를 작성하고 학습된 정책에 파지(grasping)를 맡기는 방식이 가장 높은 성능을 보였습니다. 결과적으로 시뮬레이션이 실물 로봇의 성능 순위를 정확히 예측할 수 있음을 보여주었습니다.
AI 연구
블록체인 포렌식은 자금 세탁 수법이 끊임없이 변하는 적대적이고 개방적인 환경에서 이루어집니다. 기존의 추적 방식은 복잡한 경로와 다양한 수법에 대응하기 어렵고 검증이 까다롭습니다. 본 논문은 모든 추적 결과가 온체인 기록을 근거로 제시되어야 하는 검증 가능한 벤치마크인 ABF-Bench를 제안합니다. 실제 자금 세탁 사례를 바탕으로 멀티홉 전송, DeFi, 크로스체인, 믹서 등을 포함한 복잡한 태스크를 구축했습니다. 실험 결과, 제안된 에이전트 하네스는 일반 범용 에이전트보다 높은 재현율을 보였으며, 고정 순서 추적기보다 증거 확보 속도와 미공개 수탁 서비스 식별 능력에서 우수함을 입증했습니다.
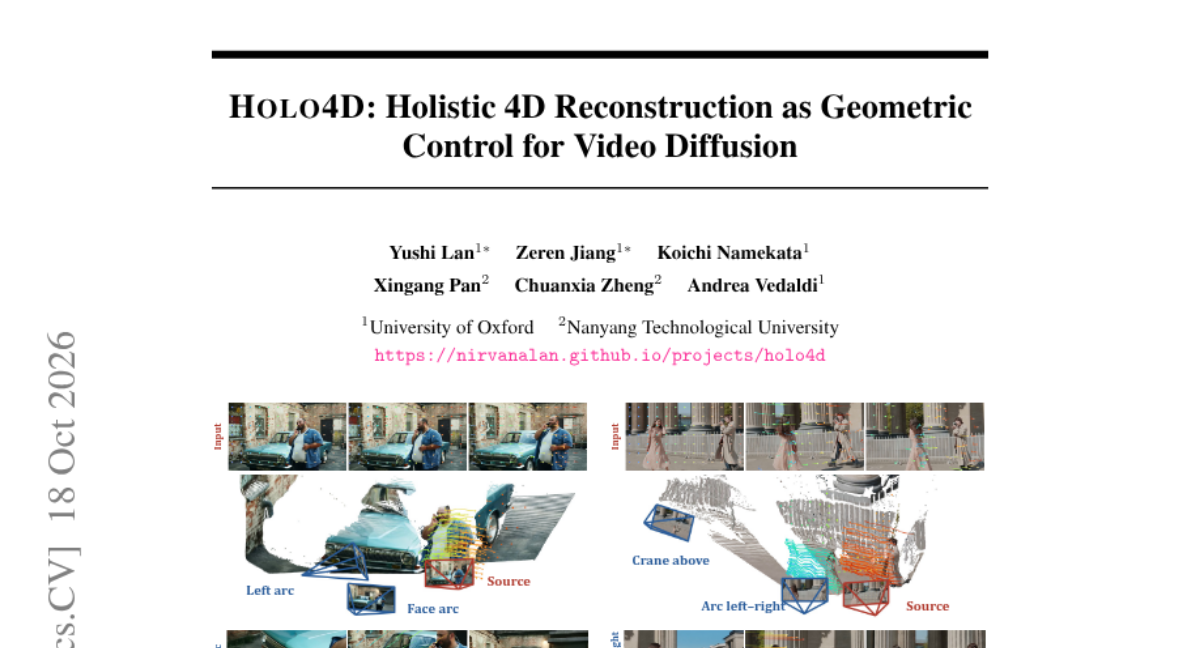
AI 연구
재구성된 4D 구조를 가이드로 활용하여 비디오 확산 모델의 카메라 제어 및 신규 뷰 합성 성능을 극대화한 프레임워크
AI 연구
기업의 분기별 실적 예측을 위해서는 재무 증거를 손익계산서 항목과 연결하는 능력이 필수적입니다. 본 논문은 86개 미국 기업의 149개 분기 데이터를 활용하여 에이전트의 추론 능력을 측정하는 EPSBench를 소개합니다. 에이전트는 공시 자료, 실적 발표 스크립트, 뉴스 등을 읽고 근거를 인용하며 손익계산서의 주요 변수를 추정합니다. 이후 공유된 회계 계산기를 통해 추정치를 GAAP 기준 EPS로 변환하여 모델 간 비교를 가능하게 합니다. 실험 결과, 모델별로 예측 오차의 차이가 나타났으며, 대부분의 모델이 설정한 신뢰 구간이 실제 실적을 충분히 포함하지 못하는 한계를 보였습니다.
AI 연구
기존의 자기 증류 방식은 강력한 외부 교사 모델이나 특권 정보(privileged information)가 필요하여 활용에 제약이 있었습니다. 본 논문은 외부 정보 없이 모델 자체의 변형을 통해 학습 신호를 생성하는 WISD 프레임워크를 제안합니다. 원본 모델을 양자화하거나 가지치기하여 의도적으로 약화된 모델을 만든 뒤, 두 모델 간의 차이를 학습 신호로 활용합니다. 수학 및 코딩 추론 벤치마크에서 실험한 결과, 양자화와 가지치기를 통해 원본 모델보다 높은 성능 향상을 달성했습니다. 특히 대규모 모델에서도 별도의 외부 데이터 없이 성능을 끌어올릴 수 있음을 입증했습니다.
AI 연구
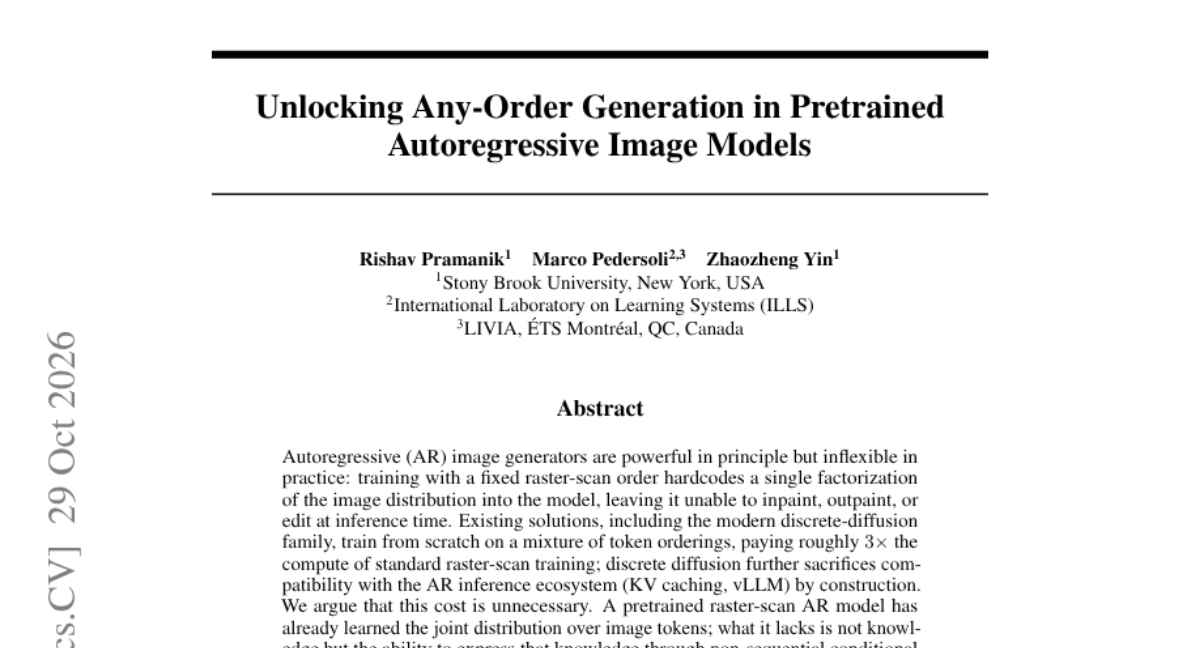
기존의 자기회귀(AR) 이미지 생성 모델은 고정된 래스터 스캔 순서로 학습되어 인페인팅이나 편집과 같은 유연한 작업에 제약이 있었습니다. 이를 해결하기 위해 기존 모델을 처음부터 다시 학습하는 대신, 이미 학습된 분포를 활용하는 효율적인 적응 방식을 제안합니다. 방법론으로는 타겟 위치 식별 문제를 해결하는 '미래 인지 위치 임베딩(future-aware positional embeddings)'과 안정적인 최적화를 위한 '순서 커리큘럼(ordering curriculum)'을 사용합니다. 실험 결과, 기존 모델의 추론 스택을 유지하면서도 MaskGIT 대비 우수한 인페인팅 성능을 보였으며 적은 추가 연산 비용으로 유연한 생성 능력을 확보했습니다.
AI 연구
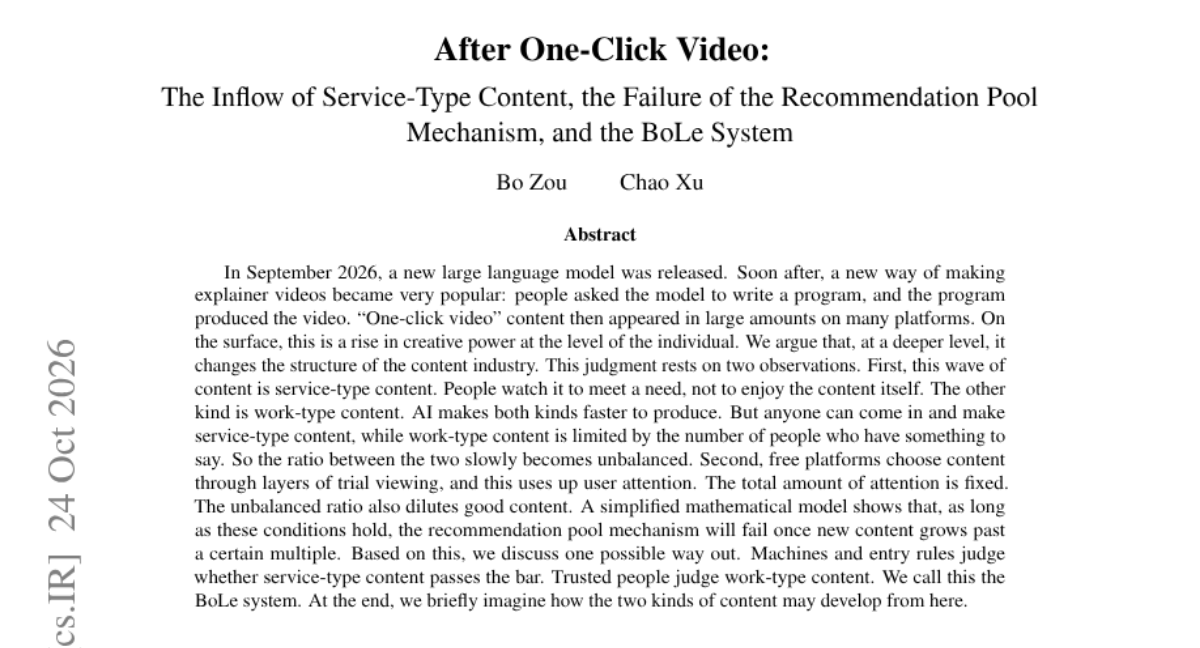
LLM을 활용한 '원클릭 영상' 제작 기술로 인해 서비스형 콘텐츠가 폭발적으로 증가하는 시대가 도래했습니다. 이러한 콘텐츠는 단순 필요 충족을 목적으로 하며, 창작자 수의 제약이 있는 작업형 콘텐츠와 달리 무한히 생성될 수 있어 콘텐츠 생태계의 균형을 무너뜨립니다. 고정된 사용자 주의력을 기반으로 하는 기존의 추천 풀 메커니즘은 콘텐츠 양이 임계치를 넘어서면 질적 저하와 함께 실패하게 됩니다. 이를 해결하기 위해 기계적 검증과 신뢰 기반의 인간 검증을 결합한 'BoLe 시스템'을 제안합니다. 결과적으로 이 모델은 콘텐츠 유형에 따른 차별적 필터링을 통해 생태계의 지속 가능성을 확보하는 방안을 제시합니다.
AI 연구
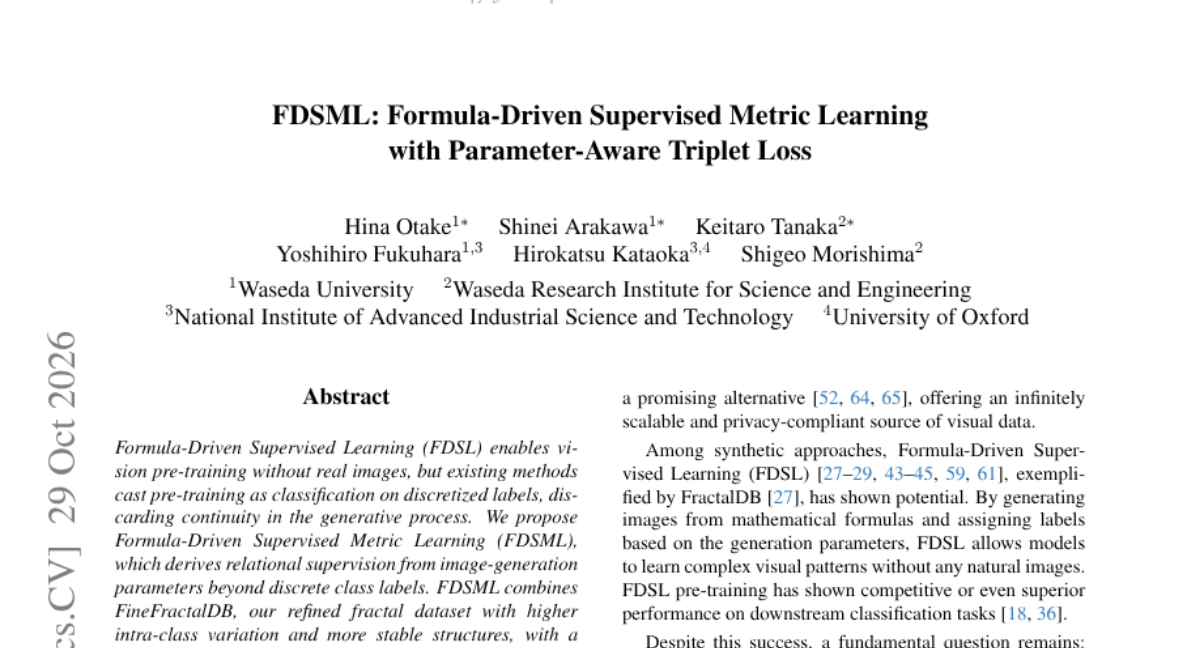
기존의 수식 기반 사전 학습(FDSL)은 이산적인 클래스 레이블에만 의존하여 생성 과정의 연속성을 활용하지 못하는 한계가 있었습니다. 본 논문은 이미지 생성 파라미터 자체에서 관계적 감독 신호를 도출하는 FDSML 방식을 제안합니다. 이를 위해 클래스 내 변동성을 높인 FineFractalDB 데이터셋과 파라미터 공간의 거리를 반영하는 PA-Triplet Loss를 결합했습니다. 실험 결과, FDSML은 기존 FDSL 대비 이미지 검색(Retrieval) 성능을 크게 향상시켰으며 분류 및 강건성 측면에서도 경쟁력을 입증했습니다. 이는 단순 레이블 기반 분류보다 파라미터 기반의 관계적 학습이 전이 학습에 더 강력한 신호를 제공함을 시사합니다.
30건
이날 공개된 제품과 도구





6건
새 모델과 주요 평가 결과
HF Model Trending
ccore/Qwen3.5-4B-3D-Coder 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 약 4.5B 파라미터를 가진 이 모델은 최근 사용자들 사이에서 활발히 활용되고 있습니다.
HF Model Trending
Pika-Labs에서 공개한 Pika-H3-Flex 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 image-to-video 파이프라인을 지원하는 것이 특징입니다.
HF Model Trending
NVIDIA에서 공개한 NVIDIA-Nemotron-3.5-Transcribe-30B-A4B 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 automatic-speech-recognition 태그를 가진 음성 인식 특화 모델입니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.