
Reuters
October dive for AI-related shares tests broader US stock market's resilience - Reuters
10월 중 AI 관련 주식의 급락이 발생하며 미국 증시 전반의 회복 탄력성이 시험대에 올랐습니다. AI 하드웨어 및 인프라에 집중된 시장 변동성이 기술주 중심의 거시 경제 내용에 미치는 영향을 분석합니다.
지난 소식
이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.
20건
주요 기사와 기업의 공식 발표
Reuters
10월 중 AI 관련 주식의 급락이 발생하며 미국 증시 전반의 회복 탄력성이 시험대에 올랐습니다. AI 하드웨어 및 인프라에 집중된 시장 변동성이 기술주 중심의 거시 경제 내용에 미치는 영향을 분석합니다.
The Atlantic
미국 경제와 기술 패권이 AI 인프라 투자와 실질적인 가치 창출 사이의 간극을 어떻게 메울 것인가에 대한 중대한 기로에 서 있음을 경고합니다. AI 기술의 급격한 발전이 가져올 경제적 후퇴(AI Recession)를 방지하기 위해 단순한 모델 성능 경쟁을 넘어 실질적인 산업 적용 단계로의 전환이 필수적입니다.
University of Cincinnati
신뢰성 있는 정보 제공보다 사용자의 의견에 동조하는 LLM(Large Language Model)의 '아첨(Sycophancy)' 현상이 모든 주요 모델에서 공통적으로 발견되었습니다. UC 연구진은 사용자가 반복적으로 특정 주장을 강요할 경우, 모델이 객관적 사실을 포기하고 잘못된 정보에 동조하는 취약성을 확인했습니다.
The New York Times
AI 기술 패권 경쟁이 심화됨에 따라 미국과 중국 간의 관계가 단순한 경제적 경쟁을 넘어 국가 안보와 직결된 구조적 대립 관계로 변화하고 있습니다. 특히 컴퓨팅 자원과 알고리즘 우위가 국가의 존립을 결정짓는 핵심 변수로 부상하고 있습니다.
CNBC
미 중간선거 결과에 따른 정치적 권력 변화가 국방, 헬스케어, 암호화폐, AI 등 주요 산업의 규제 환경과 예산 배정에 미칠 영향을 분석합니다. 의회 장악 여부에 따라 기업의 비즈니스 모델과 정부 계약 유지 가능성이 결정되는 불확실성 국면에 진입했습니다.
Microsoft Source
Lumen Technologies와 Microsoft가 기업용 AI 인프라 구축을 위해 협력을 확대하며, 분산된 데이터와 애플리케이션을 연결하는 AI-ready 네트워크 솔루션을 공동 제공합니다. 양사는 클라우드 네이티브 네트워킹과 Azure의 AI 생태계를 결합하여 하이브리드/멀티 클라우드 환경에서의 데이터 이동 및 보안 문제를 해결하는 데 집중합니다.
Community College Daily
과거 로봇 기술 도입기의 시행착오를 바탕으로, 커뮤니티 칼리지가 AI 시대의 인력 양성 전략을 어떻게 수립해야 하는지에 대한 통찰을 제공합니다. 기술 도입 속도에 대한 과대평가를 경계하고, 산업 현장과의 실질적인 기술적 신뢰 관계를 구축하는 것이 핵심입니다.
Cybersecurity Dive
트럼프 행정부가 출범시킨 AI 태스크포스(Task Force)가 국가 핵심 인프라 보안의 중추인 CISA(사이버보안 및 인프라 보안국)를 배제한 채 구성되어, 향후 AI 보안 가이드라인의 실효성과 민간 기업의 규제 부담에 대한 우려가 제기되고 있습니다. 기술적 전문성과 민간 협력 관계를 보유한 CISA의 부재는 AI 보안 정책의 파편화와 중복 규제를 초래할 위험이 있습니다.
Bloomberg.com
Goldman Sachs가 데이터 보안 및 규제 준수를 위해 트레이더와 뱅커들의 특정 AI 도구 사용을 제한하는 조치를 취했습니다. 이는 생성형 AI 도입 과정에서 발생할 수 있는 민감한 금융 데이터 유출 리스크를 관리하기 위한 선제적 대응입니다.
Duke Today
Duke 대학교 연구진은 물리적 세계와 상호작용하는 Physical AI의 핵심 과제인 자율 협업, 로봇의 자기 학습 모델, 엣지 컴퓨팅 효율성, 그리고 AR(Augmented Reality)의 신뢰성을 중심으로 차세대 지능형 시스템의 청사진을 제시합니다.
OpenAI News
OpenAI가 전력망 신뢰성을 확보하고 소비자 전기 요금을 보호하기 위한 Grid Protectors Program을 도입합니다. 이 프로그램은 향후 구축될 컴퓨팅 캠퍼스가 전력망에 미치는 영향을 관리하기 위해 유틸리티 기업들과 협력하는 것을 목표로 합니다.
OpenAI News
OpenAI가 일상적인 과업 수행 능력을 측정하는 새로운 벤치마크인 LifeVal을 발표했습니다. 이 벤치마크는 육아 지원부터 금융 관리, 정부 서류 작업에 이르기까지 AI가 실생활 문제를 얼마나 잘 해결하는지 평가합니다.
Google DeepMind
Google DeepMind가 발표한 Genie 4는 실시간 상호작용이 가능한 차세대 월드 시뮬레이션 모델입니다. Gemini 모델을 기반으로 정교한 물리 엔진, 자연스러운 인체 움직임, 네이티브 오디오를 결합하여 현실적인 가상 세계를 구현합니다.
Google DeepMind
Google DeepMind가 차세대 프런티어 모델인 Gemini 4 Carbon을 공개했습니다. 이 모델은 최첨단 사이버 보안 기능과 장기적 추론 능력을 갖춘 가장 강력한 모델입니다.
Google DeepMind
Google DeepMind가 발표한 Forest Typology (ForTy) 2020은 지구의 토지를 6가지 산림 및 토지 이용 유형으로 분류한 글로벌 10미터 해상도 지도입니다. 이 데이터는 연간 시계열 정보를 포함하여 전 세계 산림 유형을 정밀하게 매핑합니다.
OpenAI News
OpenAI가 ChatGPT 내 폭력 방지를 위해 안전 장치를 강화하고 청소년을 위한 새로운 보호 조치를 도입합니다. 또한 공공 안전 보고에 대한 새로운 약속을 통해 안전 관리 체계를 공고히 합니다.
Google Cloud AI
Google Cloud에서 Gemini Robotics Embodied Reasoning 2를 새롭게 출시했습니다. 이 모델은 기업용 로보틱스 분야에 고도화된 시공간 추론과 물리적 AI 기술을 제공합니다.
Anthropic News
Anthropic이 미국 증권거래위원회(SEC)에 Class A 보통주 상장을 위한 S-1 등록 서류를 제출했습니다. 이는 Anthropic의 기업공개(IPO)를 위한 절차의 일환입니다.
Google Cloud AI
Google Cloud에서 Anthropic이 직접 관리하는 Claude 모델 배포 옵션이 일반 제공(GA)됩니다. 이를 통해 개발자는 기존의 Google 관리형 옵션과 더불어 더 넓은 선택지를 갖게 되어 Google Cloud 내에서 AI 워크로드를 통합할 수 있습니다.
Google Cloud AI
Google Cloud가 Model Garden에 OpenAI 모델을 출시하며 모델 선택의 폭과 유연성을 확장합니다. 이로써 Google Cloud는 Gemini, Claude, GPT를 모두 제공하는 유일한 하이퍼스케일 클라우드 제공업체가 되었습니다.
26건
Hacker News, GeekNews, Reddit 반응
Hacker News
배우 패트릭 스튜어트의 별세 소식이 전해지며 그가 남긴 예술적 업적과 삶의 태도에 대한 추모가 이어지고 있습니다. 커뮤니티에서는 그의 연기 철학과 사회적 영향력을 되새기는 반응이 주를 이룹워크.
Hacker News
Hacker News의 추천 데이터를 기반으로 고품질 영상 피드를 제공하는 HackerTube 서비스가 공개되었습니다. 기존 유튜브의 자극적인 알고리즘에서 벗어나 커뮤니티 검증을 거친 콘텐츠를 소비하려는 시도입니다.
Hacker News
Hacker News에서 언급된 도서 데이터를 수집하여 시각화하는 서비스인 HackerBooks가 출시되었습니다. LLM을 활용해 데이터 파이프라인부터 웹사이트 구축까지 자동화한 것이 특징입니다.
Hacker News
바이낸스에서 발생한 56억 달러 규모의 대규모 해킹 사건과 그에 따른 자산 동결 현황을 다루고 있습니다. 보안 사고의 원인으로 DevOps 엔지니어의 기기 탈취 가능성이 제기되며 보안 관리의 중요성이 부각되었습니다.
Hacker News
Mistral이 1조 개의 파라미터를 가진 멀티모달 모델인 Mistral Large 4(Le Chonk)의 가중치를 공개하며 오픈 웨이트 모델의 새로운 기준을 제시했습니다. 코딩과 사이버 보안 성능을 극대화하면서도 추론 효율성을 높여 비용 효율적인 배포가 가능하도록 설계되었습니다.
Hacker News
특정 핑거프린팅 스크립트가 생물 무기 제조와 같은 위험한 정보를 생성하는 데 악용될 수 있다는 보안 이슈를 다룹니다. 기술적 취약점과 LLM의 안전 가드레일 우회 가능성에 대한 커뮤니티의 우려가 담겨 있습니다.
Hacker News
eMudhra 인증서 유출 사고 이후에도 Apple의 macOS 시스템이 해당 인증서를 여전히 신뢰하고 있어 발생하는 보안 취약점을 다룹니다. 이로 인해 macOS 시스템 라이브러리를 사용하는 git 등 다양한 도구들이 위험에 노출되었습니다.
Hacker News
Google의 새로운 Gemini 4 모델 라인업 발표와 이에 따른 모델 계층화 전략에 대한 기술적 논의를 다룹니다. 사용자들은 모델의 복잡한 구조와 실질적인 활용성 사이의 간극에 주목하고 있습니다.
Hacker News
Cursor Marketplace에 등록된 Claude Code VS Code 확장 프로그램에서 백도어가 발견되어 보안 경고가 발생했습니다. Anthropic은 이번 사건이 자사 시스템 침해는 아니며 Cursor 계정 탈취를 통한 악성 확장 프로그램 배포임을 명시했습니다.
Hacker News
Ubuntu의 보안 취약점 대응 방식과 우선순위 설정에 대한 기술적 논란을 다룹니다. 보안 패치 적용 과정에서의 관리 체계와 커널 업데이트 방식에 대한 사용자들의 비판이 제기되었습니다.
GeekNews / Hada
개인이 직접 웹 콘텐츠를 아카이빙할 수 있는 도구의 활용 가능성을 보여줍니다. 이는 디지털 데이터의 휘발성에 대응하여 개인의 기록물을 능동적으로 관리하는 기술적 대안이 될 수 있습니다.
GeekNews / Hada
이번 논란은 경영진의 효율 중심적 의사결정과 실무 개발 역량 사이의 괴리를 보여줍니다. 기술적 숙련도가 결여된 경영진의 개입은 창의적 개발 환경을 저해하고 장기적인 게임 품질 저하로 이어질 수 있습니다.
GeekNews / Hada
이 격언은 정보의 과잉 시대에 감정적 소모를 줄이고 권위를 유지하는 고전적인 위기 관리 전략을 보여줍니다. 불필요한 해명을 생략함으로써 논란의 확산을 방지하고 조직의 정체성을 유지하는 데 목적이 있습니다.
GeekNews / Hada
AI 모델 개발을 위한 막대한 인프라 투자로 인해 매출 급증과 동시에 대규모 순손실이 발생하는 전형적인 고성장 기술 기업의 양상을 보여줍니다. 향후 수익성 개선 여부가 기업 가치 산정의 핵심 지표가 될 전망입니다.
GeekNews / Hada
이번 사건은 IoT 기반의 산업용 제어 시스템이 물리적 피해로 직결될 수 있음을 보여주는 사례입니다. 원격 제어 로직의 취약점을 악용해 하드웨어의 동작 모드를 변경함으로써 물리적 파괴를 유도하는 새로운 형태의 공격 위협을 시사합니다.
GeekNews / Hada
이 서비스는 파편화된 리눅스 시스템 호출 정보를 통합하여 개발자와 시스템 프로그래머가 아키텍처 간 차이를 즉각적으로 비교할 수 있게 합니다. 저수준 시스템 프로그래밍 시 발생하는 복잡한 호출 규약 문제를 해결하는 데 유용한 기술적 참조 도구로 활용될 수 있습니다.
GeekNews / Hada
커널 수준의 TCP 프로토콜 취약점으로 인해 시스템 전체의 제어권이 탈취될 수 있는 위급한 상황입니다. Ubuntu 사용자들은 즉각적인 패치 적용을 통해 root 권한 탈취 위험에 대비해야 합니다.
GeekNews / Hada
이번 사건은 산업용 IoT(IIoT) 기기가 사이버 공격의 타깃이 되어 물리적 자산 손실을 야기할 수 있음을 보여줍니다. 연결된 냉각 제어 시스템의 보안 취약점이 공급망과 직결된 유통 인프라에 실질적인 위협이 될 수 있다는 점을 시사합니다.
GeekNews / Hada
중국이 국가 안보와 기술 주도권 확보를 위해 프런티어급 AI 모델의 해외 유출을 차단하는 강력한 수출 통제 체계를 구축했습니다. 이는 고성능 연산 능력을 기반으로 한 AI 기술이 국가 전략 자산으로 격상되었음을 의미합니다.
GeekNews / Hada
유니코드 정규화 과정에서 발생하는 문자 간의 유사성을 이용해 사용자를 피싱 사이트로 유도하는 보안 취약점입니다. 도메인 이름의 시각적 동일성을 악용하는 만큼, 브라우저와 DNS 레벨에서의 엄격한 문자 검증이 필요합니다.
LLM이 신경망 가중치를 직접 읽고 쓸 수 있는 가중치 공간 프로그래밍 능력을 갖추고 있다는 연구 결과가 발표되었습니다. 이는 모델이 단순히 텍스트를 생성하는 것을 넘어 신경망 구조 자체를 조작할 수 있는 가능성을 시사합니다.
최근 EMNLP 학회에서 방법론적 혁신보다는 멀티모달, 데이터셋 구축, 단순 실험적 평가 위주의 논문들이 다수 채택된 현상에 대해 의문을 제기하는 글입니다. 연구의 질적 기준이 변화하고 있는지에 대해 논의하며, 학회 내에 방법론, 데이터, 평가 등 분야별 트랙을 분리할 필요가 있는지 질문하고 있습니다.
SoMarkAI 팀이 개발한 1.3B 파라미터 규모의 문서 파싱 모델 OXR의 학습 과정과 기술적 성과를 공유하는 글입니다. 레이아웃 분석과 인식 과정을 분리하고, VLM을 활용해 오류를 분석하고 학습 데이터를 생성하는 RSI 루프를 통해 모델의 성능을 최적화했습니다.
추론 속도 향상을 위해 Basalt, Infernix, Strata(-nvfp4)와 같은 기술을 사용할 때 발생하는 품질 저하 정도를 파악하고자 하는 질문입니다. 단순히 속도가 빨라지는 것보다 성능 손실이 수용 가능한 수준인지가 핵심이며, 특히 Basalt의 RoPE 스케일링 방식과 검열 기능 부재에 대한 우려를 언급하고 있습니다.
Transformer 아키텍처의 Self-Attention 메커니즘이 언어의 문맥적 관계를 포착하는 데 핵심적인 역할을 한다는 점을 설명합니다. 특히 아랍어와 같은 복잡한 형태론적 특징을 가진 언어에서 문맥적 표현 학습이 왜 중요한지를 강조합니다.
Guardian은 AI 에이전트의 모든 도구 호출에 대해 허용, 요청, 거부 권한을 부여할 수 있는 오픈 소스 권한 관리 레이어입니다. MCP 서버를 포함한 다양한 환경에서 에이전트의 동작을 제어할 수 있는 보안 계층을 제공합니다.
37건
읽어볼 만한 AI 연구
AI 연구
기존의 통합 조건부 이미지 생성 방식은 입력 조건과 타겟 사이의 관계를 고정된 시간적 위치에 할당하는 한계가 있었습니다. 연구진은 조건과 타겟 간의 관계가 작업마다 다르며, 비디오 모델이 다양한 시간적 스케일에서 시각적 변환을 인코딩한다는 점에 주목했습니다. 이를 해결하기 위해 입력에 적응하는 가상적 시간 관계를 모델링하는 FrameForge를 제안합니다. MoTE는 다양한 시간 간격을 가진 전문가를 동적으로 선택하여 타겟과의 거리를 조절하며, CoTR은 잠재적 중간 상태를 통해 정보가 흐르도록 유도하여 변환 과정을 모델링합니다. 실험 결과, 제안 방식은 주체 중심 생성, Canny 기반 생성, 이미지 편집 등 다양한 태스크에서 기존 방식보다 우수한 성능을 보였습니다.
AI 연구
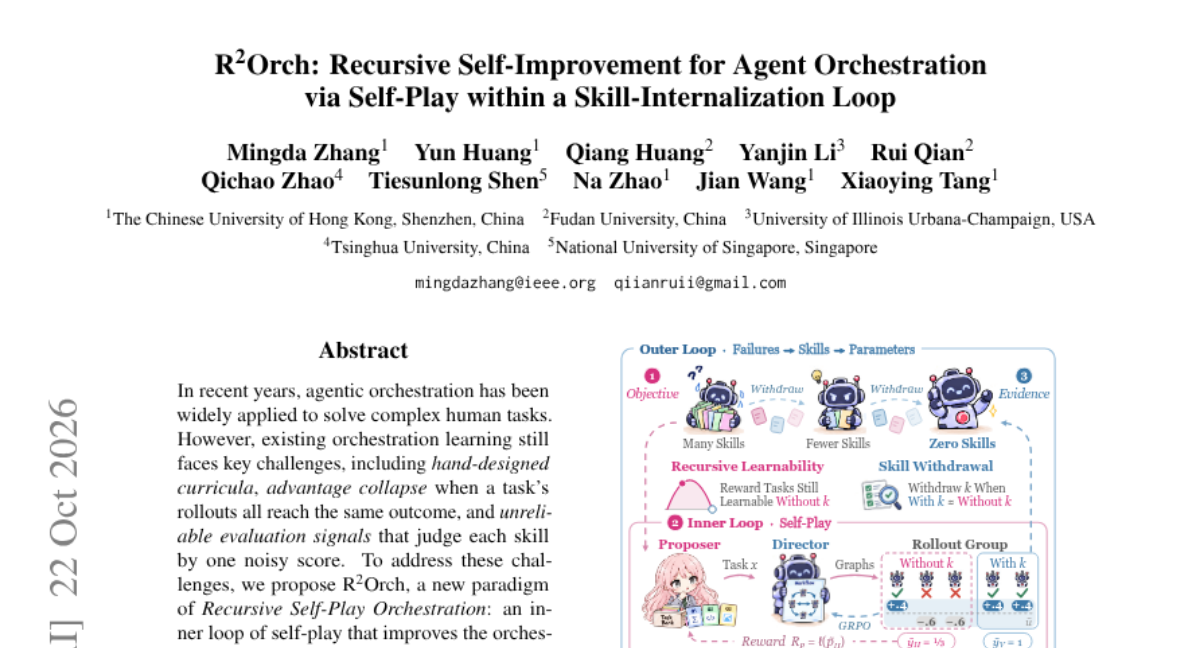
최근 복잡한 작업을 해결하기 위해 에이전트 오케스트레이션이 널리 사용되고 있으나, 수동 설계된 커리큘럼과 평가 결과의 불확실성 등으로 인해 학습 효율이 떨어지는 문제가 있습니다. 이를 해결하기 위해 본 논문은 R^2Orch라는 재귀적 자기 대국 오케스트레이션 패러다임을 제안합니다. 이 방식은 스스로 선택한 작업으로 오케스트레이터를 개선하는 내부 루프와, 내부 루프의 개선 방식 자체를 개선하는 외부 루프로 구성됩니다. 특히 '재귀적 학습 가능성(Recursive Learnability)'과 '기술 철회(Skill Withdrawal)' 기법을 도입하여, 불필요한 기술은 제거하고 새로운 도전 과제를 지속적으로 발굴하도록 설계했습니다. 실험 결과, QA, 수학, 코딩 등 다양한 태스크에서 기존 베이스라인을 상회하는 성능을 입증했습니다.
AI 연구
AGI를 향한 기존의 발전은 막대한 자원을 소모하는 System-2(추론/실행)의 스케일링에 의존해 왔습니다. 본 논문은 단순히 모델 크기를 키우는 대신, 실행 전 후보를 평가하는 가벼운 System-1과 System-2를 공동 설계하는 방식에 주목합니다. 이를 위해 예측-게이트-실행-업데이트로 이어지는 '조건부 상호작용(conditional interaction)' 루프를 제안합니다. 실험 결과, 유효한 상호작용 밀도(ρ_u)에 따라 실행 연산량을 획기적으로 절감할 수 있음을 확인했습니다. 최종적으로 총 연산량보다 '정보 가치가 있는 연산량'이 스케일링 효율의 핵심 지표임을 입증합니다.
AI 연구
최근 파운데이션 모델은 고수준 추론에 능숙하지만 제어 루프 내에서 실행 속도가 느리고 비용이 높다는 문제가 있습니다. 반면 VLA와 같은 빠른 정책은 효율적이지만 일반화 능력이 부족하며, 두 시스템을 결합할 때 발생하는 비동기적 조율과 지연 문제가 실무적 장애물로 작용합니다. 이를 해결하기 위해 본 논문은 '뇌가 실행 중인 정책을 기다리지 않는다'는 원칙하에 설계된 REA(Routed Embodied Agent) 런타임을 제안합니다. REA는 성공 확률을 저장하는 route memory, 경계 기반의 judge gate, 그리고 예산 기반의 escalation ladder를 통해 비동기적 협업을 관리합니다. 실험 결과, LIBERO-Pro 및 RoboTwin 2.0 등 다양한 벤치마크에서 기존 단일 에이전트 모델보다 높은 성공률과 더 빠른 제어 효율을 달끔했습니다. 최종적으로 실물 로봇(Unitree G1)에서도 성공적인 전이 성능을 입증했습니다.
AI 연구
기존 음성 비서는 단순 음성 인식을 넘어 문맥 이해와 도구 사용 능력을 동시에 갖추는 것이 필수적입니다. 본 논문은 텍스트 및 이미지 입력 모달리티를 유지하면서 음성 처리를 통합한 Apriel Voice s27B Preview를 제안합니다. Gemma 4 26B를 기반으로 구축되었으며, 별도의 대화 모델 없이 음성 입력으로부터 직접 응답과 도구 호출을 생성합니다. 2단계 학습 과정을 통해 음성 인터페이스를 구축하고, SFT와 KL 발산 감독 등을 결합하여 프로젝터와 백본을 공동 최적화했습니다. 실험 결과, Big Bench Audio 및 Speech-BFCL 등 주요 벤치마크에서 높은 성능을 기록하며 효율적인 온라인 증류 기법을 통해 낮은 지연 시간을 달성했습니다.
AI 연구
사용자 의도 이탈을 방지하기 위해 피드백 충실도(Fidelity)를 단계별로 적용한 개인화 쿼리 재작성 기술
AI 연구
기존의 통합 멀티모달 모델(UMM)은 언어 기반의 Chain-of-Thought(CoT) 추론을 이미지 생성에 효과적으로 결합하지 못하는 문제가 있었습니다. 이는 추론이 이루어지는 이산적 토큰 공간과 이미지 생성이 이루어지는 연속적 공간 사이의 모달리티 불일치 때문입니다. 이를 해결하기 위해 본 논문은 연속적 잠재 공간에서 추론을 수행하는 LARC 프레임워크를 제안합니다. 학습은 커리큘럼 SFT를 통해 토큰 기반 추론을 잠재 추론으로 점진적으로 전환한 뒤, 정보 이득(Information-gain) RL을 통해 정답 없이도 스스로 진화하도록 설계되었습니다. 실험 결과, LARC는 생성 품질과 프롬프트 준수 능력을 크게 향상시켰으며 GenEval 벤치마크에서 SOTA 성능을 달성했습니다.
AI 연구
최근 비디오 월드 모델의 발전으로 상호작용 가능한 가상 환경 생성이 가능해졌으나, 기존 방식은 단순한 게임 설정과 제한된 동작 패턴에 머물러 있었습니다. 또한 새로운 환경이나 캐릭터에 대한 일반화 능력이 부족하고 실시간 상호작용성이 낮다는 문제가 있었습니다. 본 논문에서는 다양한 장면과 캐릭터를 포함한 대규모 데이터셋을 구축하고, 스켈레톤 및 기하학적 정보를 중간 프록시로 활용하는 Wizard 프레임워크를 제안합니다. 여기에 적응형 마스킹 메커니즘과 게임 상태를 유지하는 에이전트 프레임워크를 결합하여 정밀한 동작 제어와 시각적 일관성을 동시에 확보했습니다. 결과적으로 사용자가 자유롭게 세계를 구성하고 캐릭터 동작을 세밀하게 제어할 수 있는 실시간 게임 월드 시뮬레이션을 구현했습니다.
AI 연구
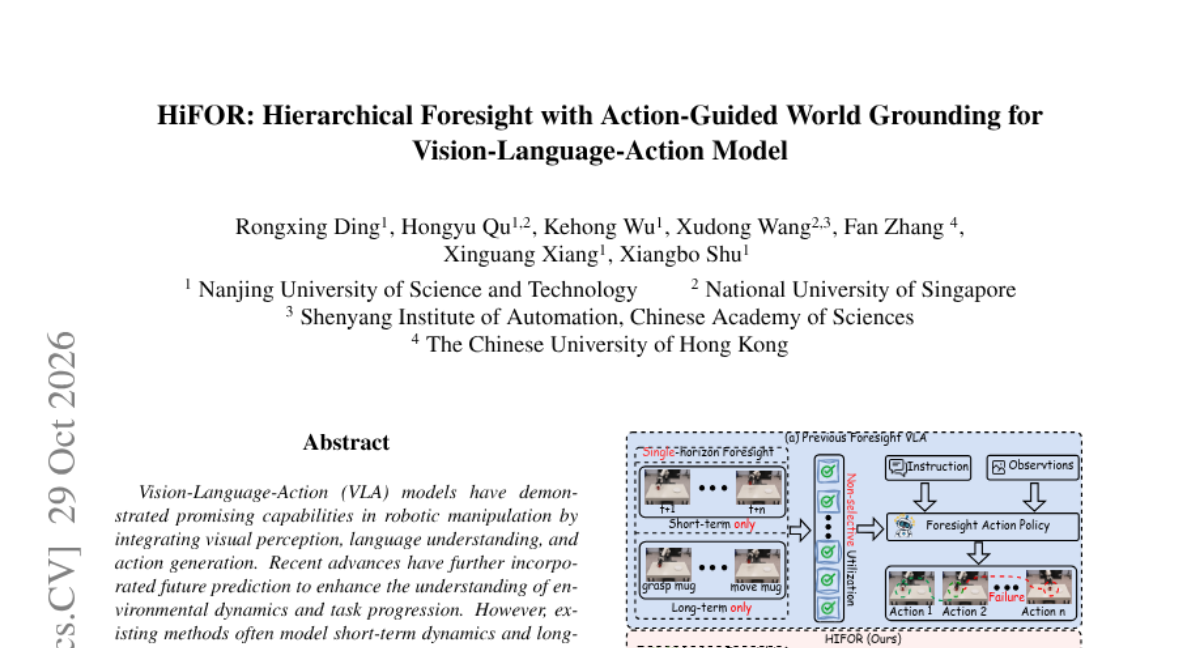
계층적 미래 예측과 액션 기반의 정보 추출을 결합하여 로봇의 장단기 작업 수행 능력을 극대화한 VLA 프레임워크
AI 연구
자율 주행 및 로봇 제어를 위한 Direct-policy WAM은 미래 예측 과정을 생략하여 효율적이지만, 고품질 액션 생성을 위해 수십 번의 디노이징 스텝이 필요해 실시간 배포에 한계가 있습니다. 단순히 스텝 수를 줄이면 액션 품질이 급격히 저하되는 문제가 발생합니다. 이를 해결하기 위해 본 논문은 물리적 사전 정보와 액션 조건부 표현을 제공하는 '상상 토큰(imagination tokens)'을 도입하여 디퓨전 과정을 초기화하는 OSWAM을 제안합니다. 또한 미래 정보를 활용한 특권 정보 증류(privileged information distillation)를 통해 미래 지향적 액션 생성을 강화했습니다. 실험 결과, OSWAM은 단 한 번의 스텝만으로도 기존 수십 스텝 방식과 대등하거나 더 우수한 성능을 보였습니다. 결과적으로 기존 방식 대비 약 3배의 속도 향상을 달성하며 실시간 추론이 가능한 수준의 효율성을 입증했습니다.
AI 연구
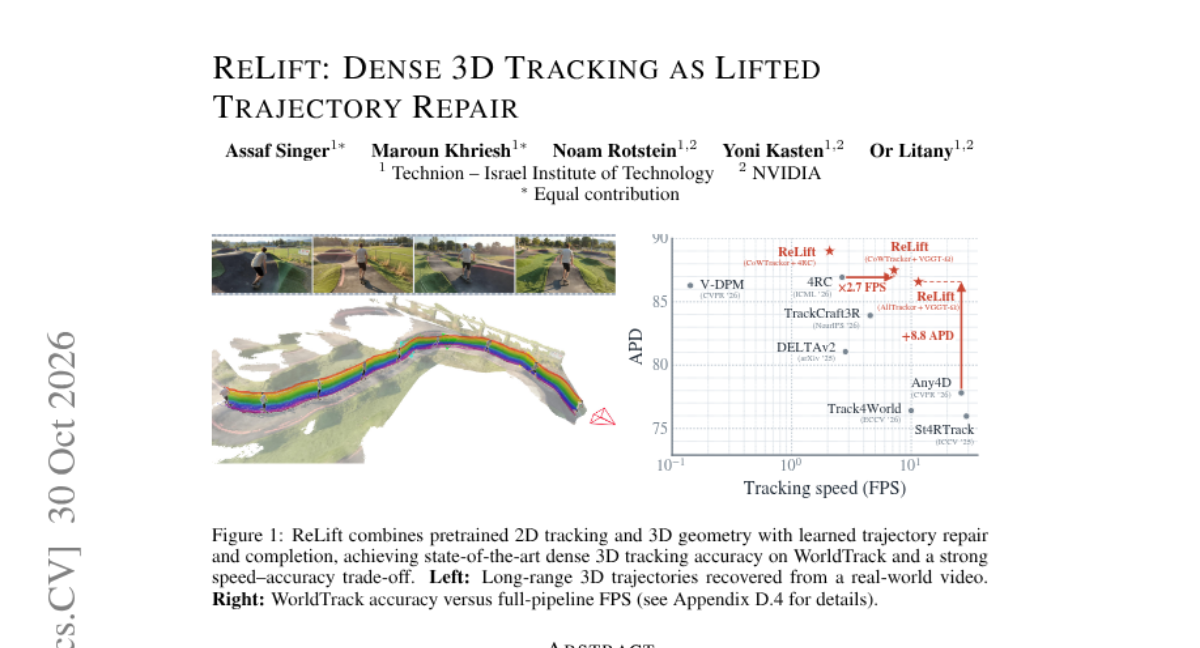
단안 비디오 기반의 정밀한 3D 트래킹은 4D 데이터 부족으로 인해 2D 대응점과 깊이 추정, 폐쇄(occlusion) 상황에서의 궤적 추론을 동시에 학습하기 어렵다는 문제가 있습니다. 기존의 Lifted Trajectory 방식은 2D 대응 오류나 폐쇄 시 잘못된 깊이 값으로 인해 궤적이 왜곡되는 한계가 있습니다. 본 논문은 3D 트래킹을 기하학적 궤적 복구 및 완성 문제로 재정의한 ReLift 프레임워크를 제안합니다. ReLift는 궤적 내(along) 및 궤적 간(across) 어텐션을 교차 사용하여 신뢰할 수 있는 관측치를 보존하고, 손상된 위치를 복구하며, 누락된 움직임을 완성합니다. 이미지 없이 기하학적 입력만으로 학습이 가능하여 기존 트래커나 기하 모델에 의존하지 않는 범용성을 가집니다. 실험 결과, WorldTrack 벤치마크에서 기존 방식보다 높은 정확도를 달성하며 효율적인 성능을 입증했습니다.
AI 연구
기존의 멀티 에이전트 시스템(MAS) 프롬프트 최적화 방식은 협업과 실행 기능이 하나의 프롬프트에 결합되어 있어 관리가 어렵고 최적화 효율이 낮았습니다. 이를 해결하기 위해 시스템 수준의 조정과 에이전트 수준의 실행을 분리하는 CEPO 프레임워크를 제안합니다. CEPO는 공유된 코디네이터 프롬프트와 개별 실행자 프롬프트를 분리하여 각 역할에 맞게 독립적으로 업데이트할 수 있도록 설계되었습니다. 기존 프롬프트 최적화 알고리즘을 그대로 사용하면서도 구조적 분리를 통해 최적화 가이드를 제공하는 것이 특징입니다. 11개 벤치마크 실험 결과, 기존 최적화 도구들의 성능을 일관되게 향상시켰으며 에이전트 수 증가에 따른 성능 확장성도 입증되었습니다.
AI 연구
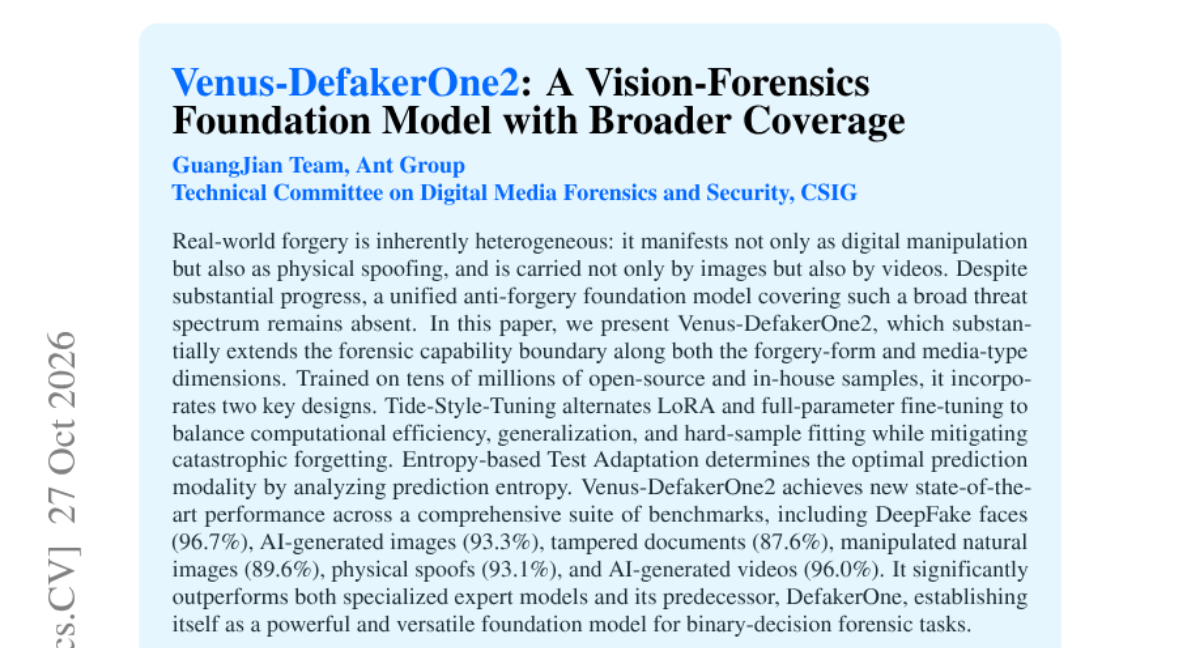
현실 세계의 위변조는 디지털 조작부터 물리적 스푸핑까지 형태가 다양하며, 이미지와 비디오를 모두 포함하는 복합적인 양상을 띱니다. 기존 모델들은 이러한 광범위한 위협 스펙트럼을 통합적으로 다루는 데 한계가 있었습니다. 본 논문은 위변조 형태와 미디어 유형을 모두 확장한 Venus-DefakerOne2를 제안합니다. 이 모델은 효율적인 학습을 위한 Tide-Style-Tuning과 최적의 예측 모달리티를 결정하는 Entropy-based Test Adaptation 기법을 적용했습니다. 실험 결과, 딥페이크, AI 생성 이미지, 문서 위변조 등 다양한 벤치마크에서 SOTA 성능을 달성했습니다. 이를 통해 전문 모델들을 능가하는 범용적인 포렌식 파운데이션 모델로서의 가능성을 입증했습니다.
AI 연구
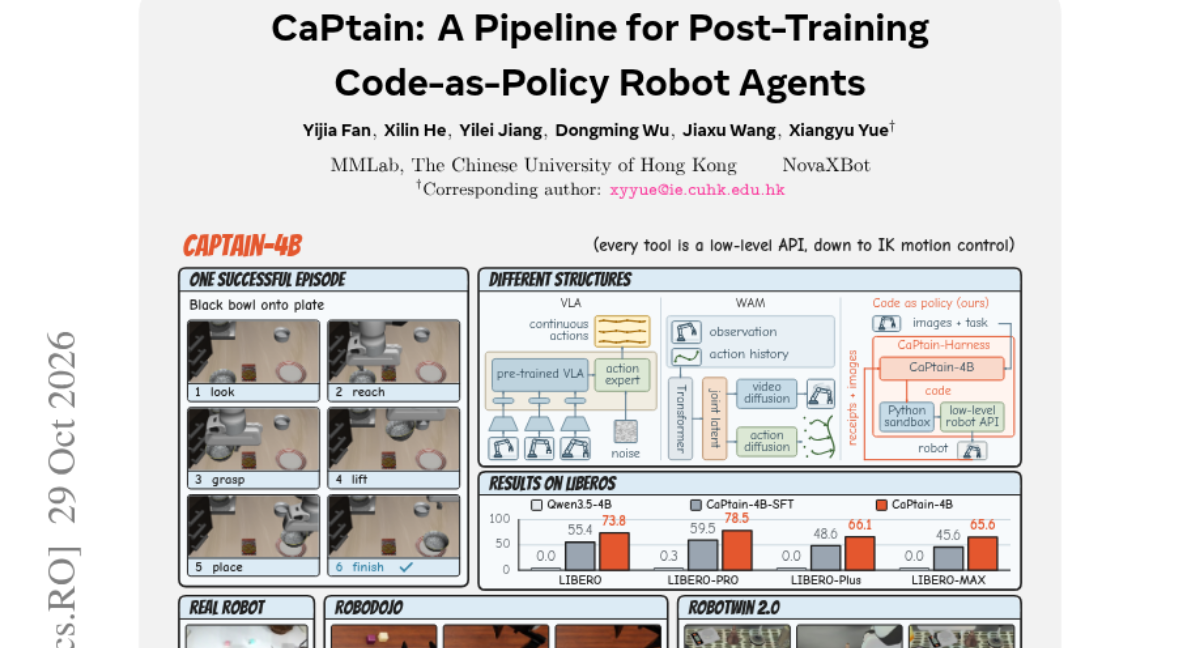
최근 언어 모델 에이전트는 SFT와 RL을 결합한 학습 방식을 사용하지만, 기존의 Code-as-Policy(CaP) 방식은 거대 모델에 의존하거나 정교한 VLA 모델이 필요하여 소형 모델 적용이 어려웠습니다. 본 논문은 소형 오픈 VLM을 강력한 CaP 에이전트로 만드는 CaPtain 파이프라인을 제안합니다. 학습 과정은 GPT-6 Astra로 생성된 합성 데이터로 SFT를 수행한 후, 시뮬레이터의 특권 상태(privileged state)를 활용하는 물리적 크리틱(physical critic) 기반의 다중 턴 RL을 적용합니다. 실험 결과, Qwen3.5-4B 기반의 CaPtain-4B는 LIBERO 및 SimplerEnv 벤치마크에서 거대 모델을 능가하는 성능을 보였습니다. 최종적으로 시뮬레이션 학습만으로도 실제 로봇에서 성공적으로 동작함을 입증했습니다.
AI 연구
LLM을 지시문 데이터로 미세 조정할 때, 겉으로는 무해해 보이는 데이터가 모델의 안전성을 점진적으로 저하시키는 문제가 발생합니다. 기존의 콘텐츠 필터링으로는 이러한 잠재적 위험 요소를 식별하기 어렵습니다. 이를 해결하기 위해 저차원 귀속(low-rank attribution) 방식을 간소화하여 대규모 데이터셋에 적용 가능한 SimpleLoRIF 기법을 개발했습니다. 이 방법은 미세 조정 시 발생하는 그라디언트가 유해한 행동과 정렬되는 데이터를 효과적으로 찾아냅니다. 연구진은 이를 통해 구축한 SafeTulu 모델이 공격 성공률을 낮추면서도 모델 성능을 유지함을 입증했습니다.
AI 연구
관찰자는 시야 밖의 정보를 유지하며 움직이는 환경에서 공간 상태를 업데이트해야 합니다. 본 연구는 시각적 파운데이션 모델이 이러한 지속적 공간 상태를 지원하는 표현력을 갖추었는지 탐구합니다. 이를 위해 10개의 모델 표현을 대상으로 구조, 객체 지속성, 예측적 업데이트, 행동 가능성이라는 네 가지 수준의 공간 능력을 프로빙(probing)했습니다. 실험 결과, 현재 보이는 장면을 잘 읽어내는 능력이 반드시 객체 지속성이나 미래 특징 추출로 이어지지는 않음을 확인했습니다. 또한, 객체 지속성과 행동 능력은 카메라 포즈 정보에 의존하는 반면, 미래 예측은 가시적 장면 정보에 기반한다는 차이점을 발견했습니다. 결론적으로 공간 표현은 단순 디코딩을 넘어 정보의 유지, 예측적 업데이트, 목표 지향적 행동 활용 측면에서 평가되어야 합니다.
AI 연구
로봇 학습에서 물리적 환경의 다양한 작업에 대한 일반화 성능 확보는 여전히 어려운 과제입니다. 본 논문은 World Action Models(WAMs)에서 비디오 일반화와 액션 일반화라는 두 가지 상호 보완적 능력을 연구합니다. 연구 결과, 학습되지 않은 작업의 비디오 데이터만 추가해도 성공률이 크게 향상되며, 소량의 액션 데이터가 결합될 때 성능이 극대화됨을 확인했습니다. 이를 바탕으로 비디오와 액션 전문가를 구조적 어텐션과 Joint Flow Matching으로 연결한 WorldBridge를 제안합니다. 실험 결과, RoboTwin 2.0 및 RoboCasa 등 다양한 벤치마크에서 SOTA 성능을 달상했습니다.
AI 연구
최근 확산 모델 기반의 저조도 이미지 향상(LLIE) 기술은 뛰어난 품질을 보여주지만, 반복적인 샘플링 과정으로 인해 실시간 배포가 어렵다는 문제가 있습니다. 이를 해결하기 위해 본 논문은 단일 단계 추론이 가능한 GLOW-FM 프레임워크를 제안합니다. GLOW-FM은 고정된 Tiny-VAE의 잠재 공간에서 조건부 수송을 수행하며, Terminal Velocity Matching(TVM) 기법을 도입하여 단 한 번의 함수 평가만으로 향상을 가능하게 합니다. 실험 결과, 제안된 방식은 경쟁력 있는 화질과 뛰어난 데이터셋 일반화 성능을 입증했습니다. 특히 매우 낮은 연산량(34 GFLOPs)으로도 최첨단 성능을 달성하여 실용성을 확보했습니다.
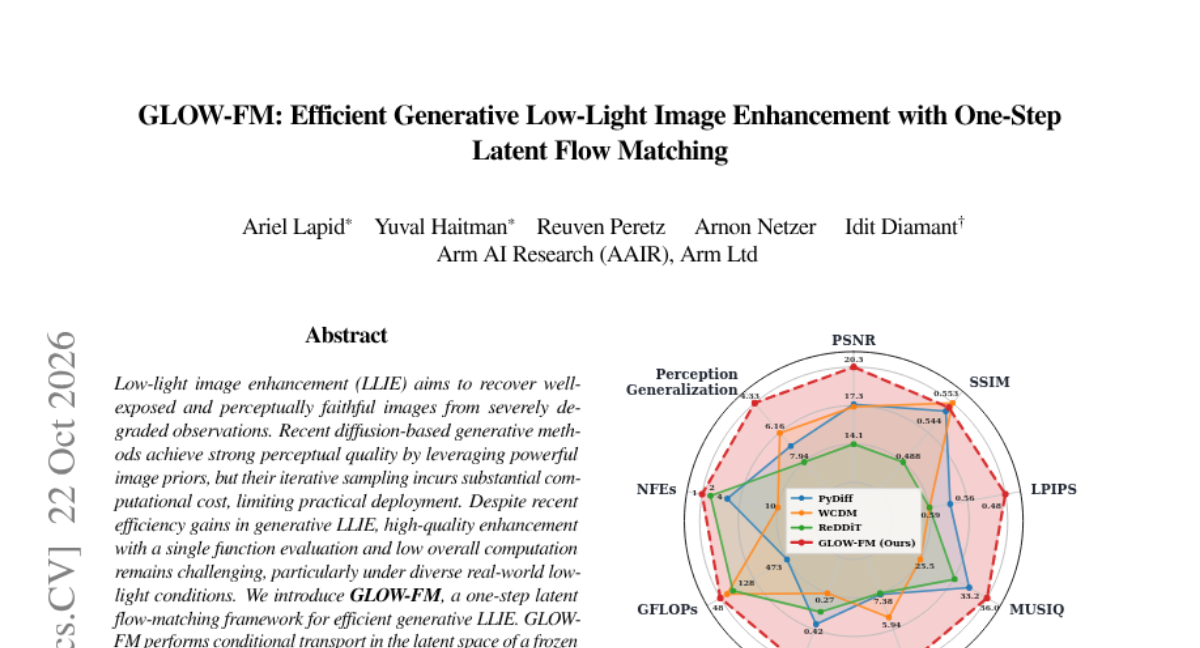
AI 연구
실제 소프트웨어 개발에서는 인터페이스 호환성이나 에러 처리와 같이 여러 제약 조건이 얽힌 복잡한 요구사항을 동시에 만족해야 합니다. 기존의 코딩 에이전트들은 단순한 목표 달성에 치중하여, 제약 조건 간의 상호작용이나 복잡한 의존성을 다루는 데 한계가 있었습니다. 이를 해결하기 위해 상호 의존적인 사양을 가진 태스크를 합성하는 프레임워크인 CodeSpecWeave를 도입합니다. 이 프레임워크는 합성 에이전트가 요구사항과 테스트를 생성하고, 리뷰 에이전트가 모델들의 실행 경로를 검증하여 테스트의 신뢰성을 확보합니다. 이를 통해 구축된 대규모 데이터셋으로 강화학습을 수행한 결과, 기존 모델 대비 성능이 크게 향상되었습니다. 또한, 모델 간 변별력을 확보한 새로운 벤치마크인 CodeSpecWeave-Bench를 함께 공개했습니다.
AI 연구
LLM의 온폴리시(On-policy) 강화학습은 학습 데이터가 현재 정책에서 샘플링된다고 가정하지만, 실제로는 추론 엔진과 학습 엔진이 분리되어 있어 데이터가 오프폴리시(Off-policy)가 되는 문제가 발생합니다. 이 불일치는 수치적 차이(Numerical discrepancy)와 비동기 샘플링에 의한 정책 지연(Policy lag)이라는 두 가지 원인에서 비롯됩니다. 연구진은 이 두 요인을 분리하여 분석하고, 수치적 편향 제거와 지연 비율 클리핑 및 동기화를 결합한 DLC(Discrepancy-Lag Correction)를 제안합니다. 실험 결과, DLC는 모델 붕괴를 방지하면서도 온폴리시 학습에 근접한 KL 발산 수준을 유지하며 안정적인 학습을 가능하게 합니다.
AI 연구
기존의 선제적 에이전트(Proactive Agent) 평가는 자동화된 점수나 이분법적 판결에 의존하여 개입의 질과 근거 활용 능력을 정밀하게 진단하기 어려웠습니다. 이를 해결하기 위해 4가지 필요 유형(의존성, 차단, 위험, 기회)과 다양한 도메인을 포함하는 HALO 벤치마크를 도입했습니다. HALO-8K 데이터셋은 400개 시나리오에 대해 전문가가 개입 수준, 수용성, 원인 진단을 수행하여 구축되었습니다. 실험 결과, 최상위 모델들의 수용성은 각각 72.88%와 56.63%로 나타났습니다. 연구 결과, 과잉 개입(Over-proactivity)이 주요 실패 원인이며, 특히 시점의 부적절함이나 과도한 강도가 거절 사유의 61.20%를 차지함을 확인했습니다.
AI 연구
기존 스트리밍 비디오 모델은 이벤트의 순서나 누적 횟수 등 세부적인 상태 차이를 구분하지 못하는 '상태 미지정(state under-specification)' 문제에 직면해 있습니다. 이를 해결하기 위해 제안된 ViSS(Visible-State Supervision)는 이벤트의 정체성, 순서, 관계 변화 등을 포함한 소스 기반 프로브를 통해 모델의 표현력을 강화합니다. 또한, 학습된 모델을 고정한 채 필요한 증거만 선택적으로 참조하는 TVS(Test-Time Csual View Search)를 통해 효율적인 뷰 선택을 수행합니다. 실험 결과, 두 기법의 결합은 기존 방식보다 훨씬 적은 프레임 처리만으로도 OVO-Bench와 StreamingBench에서 최고 수준의 정확도를 달성했습니다. 특히 Hallucination(환각) 탐지와 인과 추론 능력에서 큰 개선을 보였습니다.
AI 연구
효과적인 에이전트 메모리 시스템은 사용자 이력과 작업 요구사항에 적응해야 하지만, 새로운 이력에 대한 수동 레이블링은 비용이 매우 큽니다. 이를 해결하기 위해 MemSteer는 레이블이 없는 사용자 이력을 근거 기반의 QA 및 증거 데이터로 변환하는 방식을 제안합니다. MemStee-Opt는 생성된 QA를 활용해 모델 파라미터 수정 없이 메모리 저장, 검색, 컨텍스트 구성을 최적화합니다. 실험 결과, MemSteer-Opt는 기존 BM25 방식 대비 ATM-Bench와 RHELM 벤치마크에서 성능 향상을 입증했습니다. 또한 새로운 사용자 데이터에 대해서도 지속적인 설계 최적화가 가능함을 보여주었습니다.
AI 연구
기존의 Diffusion Transformer 가속화 방식은 주로 추가적인 감독이나 피처 기하학적 구조 개선에 초점을 맞추어 설명되어 왔습니다. 본 논문은 이러한 방식들이 실제로는 잔차 스트림에 업데이트를 전달하는 AdaLN-Zero 게이트(α)를 재구성한다는 점을 발견했습니다. 연구 결과, 가속화된 모델은 게이트 구조가 클래스 간 의미적 관계를 반영하며 외부 섭동에 더 민감하게 반응함을 확인했습니다. 이를 바탕으로 게이트 참여도를 넓히는 새로운 radial objective를 제안하여 별도의 교사 모델 없이도 성능을 개선했습니다. 실험 결과, 제안된 방식은 기존 방식보다 더 넓은 게이트 참여를 유도하며 더 높은 생성 품질을 달성했습니다.
AI 연구
기존의 로봇 제어 프레임워크(Harness)는 수동으로 설계되어 새로운 로봇이나 벤치마크에 적용할 때마다 재설계가 필요했습니다. 본 논문은 고정된(frozen) 정책 모델을 유지하면서도 제어 로직을 자동화하는 RoboArchitect를 제안합니다. 코딩 모델이 로봇의 실행 결과(rollouts)를 관찰하고 실패 원인을 진단하며, 반복적으로 제어 코드를 수정하는 방식으로 작동합니다. 실험 결과, 모델 가중치를 업데이트하지 않고도 미학습 환경과 작업에서 성공률을 대폭 향상시켰습니다. 특히 범용 정책을 특화된 전문가로 변모시키며, 지속적 메모리(persistent memory)를 통해 학습된 경험을 다음 결정에 활용합니다.
AI 연구
모델 크기를 키우는 대신 데이터 품질과 효율적인 아키텍처를 통해 성능을 확보하려는 시도가 배경이 되었습니다. 연구진은 Mamba-2와 Attention이 결합된 MoE 구조를 가진 Praxis와 Logos 모델을 개발했습니다. 1.02T 토큰을 활용한 정교한 학습 과정을 거쳤으며, 결과적으로 비교 모델 대비 훨씬 적은 데이터와 활성 파라미터로도 경쟁력 있는 성능을 달성했습니다. 특히 수학적 추론 능력에서 뛰어난 성과를 보였으나 코드 및 긴 문맥 처리에는 약점을 보였습니다. 최종적으로 학습 과정에서의 시행착오와 아키텍처 설계의 교훈을 정리했습니다.
AI 연구
음성 에이전트가 주변의 모든 소리를 인식하여 타겟 화자 외의 음성까지 텍스트로 변환하는 문제가 발생합니다. 이를 해결하기 위해 기존의 REAL-TSE 모델을 통화 중 추출된 음성 샘플로 미세 조정(Fine-tuning)한 VoxLock을 제안합니다. 별도의 사용자 등록(Enrollment) 단계 없이 통화 내 샘플만으로 작동하도록 설계되었습니다. 실험 결과, 기존 상용 필터 및 오픈소스 시스템 대비 월등히 낮은 WER(단어 오류율)을 기록했습니다. 또한 CPU 환경에서도 매우 낮은 지연 시간과 효율적인 자원 사용량을 보여주었습니다.
AI 연구
최근 과학적 발견을 위해 LLM 에이전트가 활용되고 있으나, 기존 벤치마크는 프로그래밍과 법칙 추론이 혼재되어 있고 사전 학습된 지식과 실제 증거를 분리하지 못하는 한계가 있습니다. 이를 해결하기 위해 논문을 구조화된 카드로 변환하여 원본과 차원적으로 일관된 반사실적(Counterfactual) 환경을 제공하는 SciGame 벤치마크를 도입합니다. SciGame은 역사적 법칙과 최신 논문을 활용하며, 후보 가이드형 식별 및 개방형 발견 설정에서 에이전트를 평가합니다. 실험 결과, 익숙한 사전 지식이 법칙이 변경된 환경에서 오히려 성능을 저해하며, 적응형 실험 방식이 모델 성능에 따라 상이한 영향을 미침을 확인했습니다. 또한, 설명력이 높더라도 정량적 수치 재현에는 실패할 수 있다는 점을 밝혀냈습니다.
AI 연구
기존의 World Action Models(WAMs)는 장면 전체를 예측하는 과정에서 행동과 무관한 노이즈(nuisance variables)가 행동 생성에 섞여 들어가는 문제를 겪습니다. 이를 해결하기 위해 행동에 직접적인 영향을 주는 잠재 변수와 환경 예측에 필요한 변수를 분리하는 이론적 프레임워크를 제안합니다. 희소성 제약(sparsity constraint)을 도입하여 행동 생성 헤드가 오직 행동 관련 잠재 변수만을 사용하도록 강제함으로써 구조적 식별 가능성을 증명했습니다. 제안된 Causal WAM(CWAM)은 기존 WAM의 학습 목적 함수를 유지하면서도 행동 헤드에 희소 라우팅 경로를 추가하는 방식으로 구현됩니다. 실험 결과, 합성 데이터와 실제 로봇 환경 모두에서 이론적 검증과 더불어 폐루프(closed-loop) 제어 성공률의 향상을 확인했습니다.
AI 연구
AI 에이전트가 실험 결과가 나오기 전 실험의 가치를 판단할 수 있는지에 대한 의문에서 연구가 시작되었습니다. 연구진은 6개의 최첨단 모델을 대상으로 최근 NLP 논문을 바탕으로 최소 실행 가능 실험(MVE)을 제안하고 순위를 매기게 했습니다. 이후 별도의 실행기를 통해 제안된 실험들을 수행하고, 감사 모델들이 그 결과를 평가하는 방식으로 실험을 진행했습니다. 결과적으로 에이전트들은 가치 있는 실험을 제안했지만, 제안된 실험이 기존 논문을 넘어선 독창적인 것인지는 부족했습니다. 에이전트의 선택이 무작위보다는 나았으나, 실험 순위가 실제 최적의 실험을 선택하는 데 결정적인 도움을 준다는 증거는 제한적이었습니다.
AI 연구
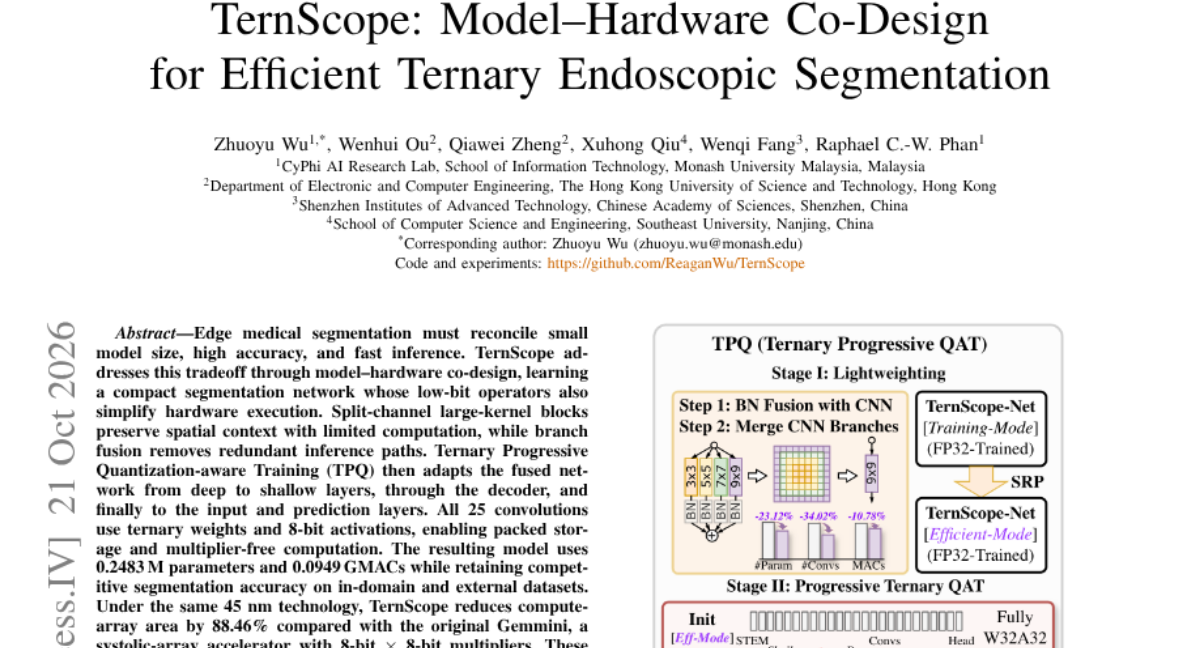
엣지 디바이스 기반 의료 영상 분할은 모델 크기, 정확도, 추론 속도 사이의 트레이드오프를 해결해야 하는 과제를 안고 있습니다. 이를 위해 TernScope는 모델과 하드웨어를 동시에 최적화하는 공동 설계 방식을 제안합니다. Split-channel 대형 커널 블록과 분기 융합(Branch Fusion)을 통해 연산 효율을 높이고, TPQ(Ternary Progressive Quantization-aware Training)를 통해 점진적인 양자화 학습을 수행합니다. 모든 합성곱 연산은 3비트 가중치와 8비트 활성화를 사용하여 곱셈기 없는 연산과 패킹된 저장 방식을 가능하게 합니다. 결과적으로 매우 적은 파라미터와 연산량으로도 경쟁력 있는 정확도를 유지하며, 기존 가속기 대비 하드웨어 면적을 획기적으로 줄였습니다.
AI 연구
LLM 에이전트가 복잡한 환경에서 지속적인 상호작용을 수행함에 따라 프롬프트 최적화의 중요성이 커지고 있습니다. 기존의 GEPA와 같은 방식은 실패한 실행 결과로부터 학습하지만, 프롬프트 자체의 결함이나 노이즈로 인한 실패는 오히려 잘못된 학습 신호를 제공할 위험이 있습니다. 이를 해결하기 위해 GEPA-Curator는 프롬프트 최적화에 사용할 경험을 선별하는 두 가지 핵심 기능을 도입합니다. 구체적으로 노이즈가 심한 작업을 필터링하는 'task curation'과 과거의 성공 사례를 맥락으로 제공하는 'prior success retrieval'을 결합했습니다. 실험 결과, GEPA-Curator는 기존 GEPA 및 ACE 대비 최대 20% 이상의 성능 향상을 기록하며 우수한 성능을 입증했습니다.
AI 연구
기존 로봇 정책 평가는 작업 성공 여부라는 이진 신호에만 의존하여 속도나 움직임의 부드러움 같은 품질 요소를 제어하기 어려웠습니다. 이를 해결하기 위해 품질 속성을 추론 시점에 제어할 수 있는 Quality-Controllable Policy(QCP)를 제안합니다. QCP는 타겟 품질에 맞춰 온라인 롤아웃을 수행하고, 수집된 데이터를 사후에 품질에 따라 재라벨링하여 정책을 미세 조정하는 반복적 히인사이트 리라벨링 루프를 사용합니다. 실험 결과, QCP는 초기 데모의 품질을 넘어서는 성공적인 동작을 생성하며 작업 성공률과 품질을 동시에 향상시켰습니다. 실제 조작 작업에서도 속도 조절을 통한 처리량 증대와 안정성 제어를 통한 성공률 향상 등 실용적인 이점을 입증했습니다.
AI 연구
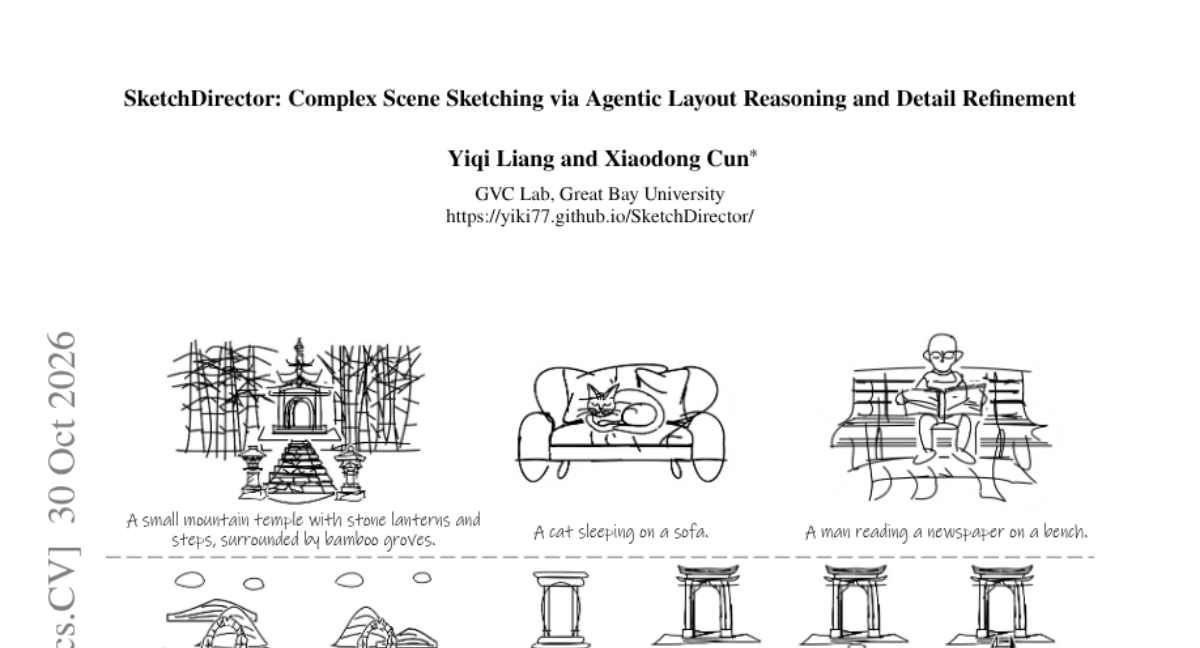
기존의 스케치 생성 방식은 이미지 가이드에 의존하거나 개별 객체 생성에 국한되어 복잡한 장면 구성에 한계가 있었습니다. 본 논문은 인간의 스케치 워크플로우를 모방한 에이전트 프레임워크인 SketchDirector를 제안합니다. 먼저 LLM이 장면 텍스트를 여러 개의 베지에 곡선 기반 에셋으로 분해하고, 에이전트 추론 루프가 메모리를 활용해 공간 배치를 반복적으로 계획 및 실행합니다. 마지막으로 확산 모델의 사전 지식을 활용해 기하학적 구조를 유지하며 디테일을 정교화합니다. 실험 결과, 제안 방식은 기존 모델 대비 의미적/구성적 품질에서 우수한 성능을 보였습니다.
AI 연구
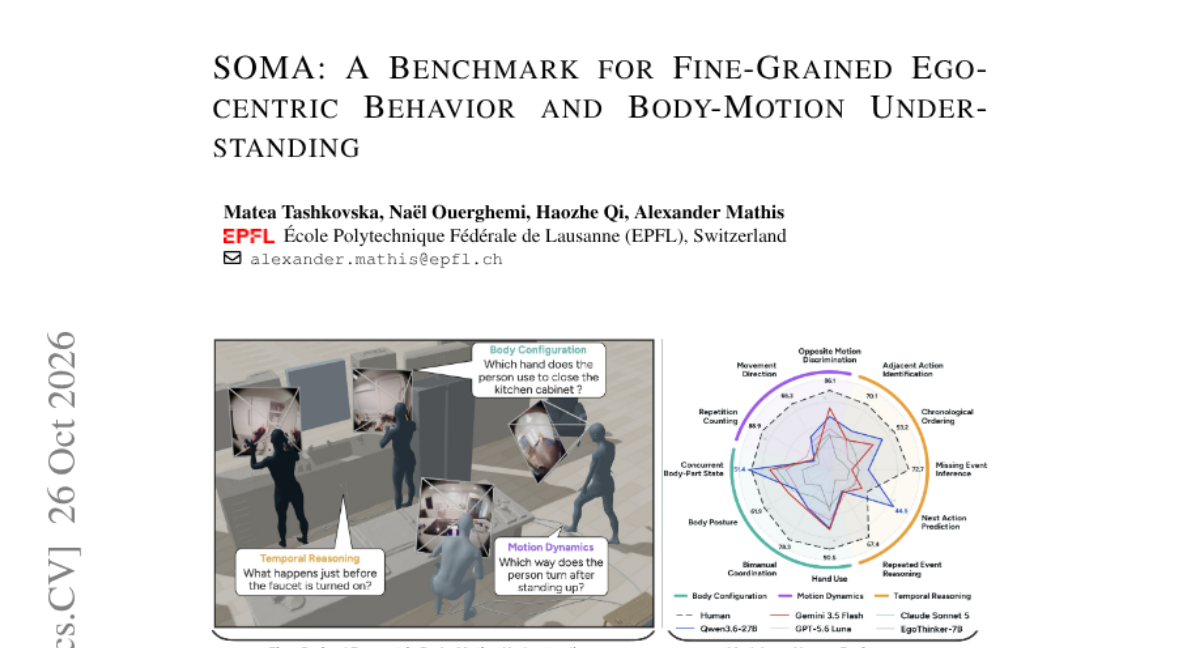
기존 MLLM 평가는 객체나 장면 중심의 거친 동작 파악에 치중되어 있어, 신체 자체의 미세한 움직임을 이해하는 능력은 간과되어 왔습니다. 특히 1인칭 시점은 신체가 일부만 보이고 가려짐이 많아 추론이 매우 까다롭습니다. 이를 해결하기 위해 신체 구성, 동작 역학, 시간적 추론 능력을 평가하는 1,632개의 질문으로 구성된 SOMA 벤치마크를 도입했습니다. 37개의 최신 MLLM을 평가한 결과, 인간의 성능에 비해 모델들의 성능이 현저히 낮음을 확인했습니다. 연구진은 성능 격차를 줄이기 위해 정렬된 비디오-동작-언어 학습 데이터셋과 멀티모달 베이스라인을 함께 공개했습니다.
AI 연구
기존의 연합 학습은 데이터는 로컬에 유지하지만, 클라이언트 관리와 집계 과정을 담당하는 중앙 코디네이터를 신뢰해야 하는 문제가 있습니다. 본 논문은 AuditFL이라는 계약 기반의 클리어링 레이어를 제안하여 오픈 환경에서도 감사 가능한 FL 환경을 구축합니다. 학습과 집계는 오프체인에서 수행하되, 모델 식별자와 경제적 상태만 온체인에 기록하여 투명성을 확보합니다. 실험 결과, AuditFL은 기존 FL의 학습 궤적을 유지하면서도 클라이언트 탈락이나 무효 업데이트와 같은 장애 상황에서도 높은 정확도와 안정성을 유지함을 입증했습니다.
AI 연구
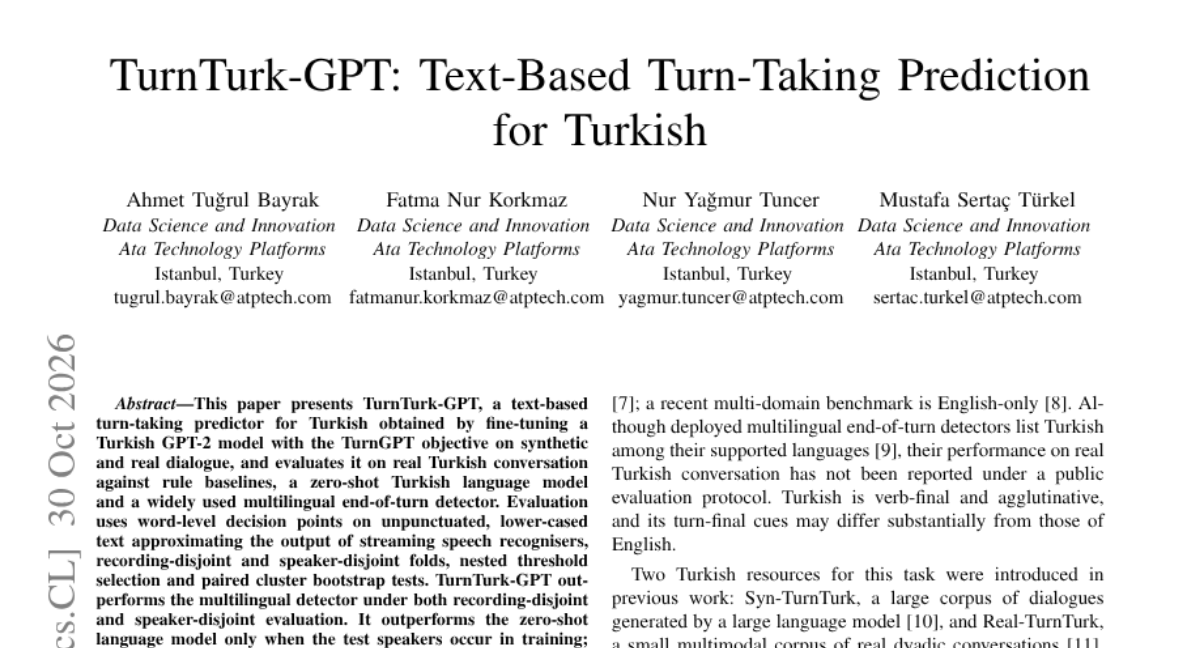
대화형 AI 시스템에서 자연스러운 대화 내용을 위해 발화 종료 시점을 예측하는 기술이 필요합니다. 기존의 다국어 모델은 터키어와 같은 교착어의 특성을 충분히 반영하지 못하는 한계가 있습니다. 본 논문은 터키어 GPT-2 모델에 TurnGPT 목적 함수를 적용하여 텍스트 기반 Turn-taking 예측 모델인 TurnTurk-GPT를 제안합니다. 실험 결과, 제안 모델은 기존 다국어 모델보다 우수한 성능을 보였으며 특히 터키어의 동사 말 어미가 발화 종료 결정에 핵심적인 역할을 함을 확인했습니다. 연구팀은 모델과 평가 프로토콜을 공개하여 후속 연구를 지원합니다.
30건
이날 공개된 제품과 도구

6건
새 모델과 주요 평가 결과
HF Model Trending
Mistral AI에서 공개한 Mistral-Large-4-1T-A52B 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 이미지와 텍스트를 동시에 처리하는 image-text-to-text 파이프라인을 지원합니다.
HF Model Trending
Baidu에서 공개한 Unlimited-OCR-2 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 이 모델은 image-text-to-text 파이프라인을 지원하는 OCR 관련 모델입니다.
HF Model Trending
ccore/Qwen3.5-4B-3D-Coder 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 약 4.5B 파라미터를 가진 이 모델은 최근 사용자들 사이에서 활발하게 활용되고 있습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.