
Reuters
US bank regulator issues first-ever AI guidance for examiners - Reuters
미국 금융 감독 당국이 금융기관의 AI 도입에 따른 리스크를 관리하기 위해 검사관(Examiner)을 위한 최초의 AI 가이드라인을 발표했습니다. 이는 금융권의 AI 도입 가속화에 대응하여 규제 당국이 기술적 검증 역량을 확보하려는 움직임입니다.
지난 소식
이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.
20건
주요 기사와 기업의 공식 발표
Reuters
미국 금융 감독 당국이 금융기관의 AI 도입에 따른 리스크를 관리하기 위해 검사관(Examiner)을 위한 최초의 AI 가이드라인을 발표했습니다. 이는 금융권의 AI 도입 가속화에 대응하여 규제 당국이 기술적 검증 역량을 확보하려는 움직임입니다.
Politico
미 민주당이 실리콘밸리의 AI 기술 독점과 그로 인한 사회적 부작용을 규제하기 위한 강력한 정책적 움직임을 예고하고 있습니다. 이는 단순한 윤리적 가이드를 넘어, 거대 기술 기업(Big Tech)의 영향력을 제어하려는 정치적·제도적 개입의 시작을 의미합니다.
Time Magazine
미국 선거 결과, AI 산업의 무분별한 확장을 지지하는 '가속주의(Accelerationism)' 세력이 막대한 자금 투입에도 불구하고 유권자들의 강력한 반대에 부딪히며 참패했습니다. 유권자들은 AI 기술 자체보다 데이터 센터 건설로 인한 에너지 비용 상승, 소음, 환경 문제 등 실질적인 지역 사회의 피해를 더 큰 위협으로 인식하며 '안전 우선(Pro-safety)' 후보들에게 힘을 실었습니다.
WSJ
CrowdStrike가 AI 보안 역량 강화를 위해 두 개의 AI 보안 스타트업을 총 4억 9,500만 달러(약 6,800억 원)에 인수할 계획입니다. 이번 인수는 생성형 AI 시대의 위협에 대응하기 위한 전략적 자산 확보를 목적으로 합니다.
Axios
Meta가 AI 기반 코딩 자동화 스타트업을 인수하며 소프트웨어 개발 생태계 주도권 확보를 위한 전략적 행보를 시작했습니다. 이번 인수는 단순한 도구 확보를 넘어, LLM 기반의 코딩 Agent 기술을 자사 인프라에 통합하여 개발 워크플로우 전체를 장악하려는 의도로 풀이됩니다.
Yahoo Finance
미 중간선거에서 민주당이 승리하며 AI 규제 강화 우려가 커지자, 소프트웨어 중심의 빅테크는 상승하고 하드웨어 중심의 AI 인프라주는 하락하는 차별화 장세가 나타났습니다. 투자자들은 규제 리스크와 인프라 투자 대비 수익성(ROI) 문제를 저울질하며 섹터 내 포트폴리오를 재편하고 있습니다.
NBC News
미국 선거 결과로 인한 정치적 불확실성이 해소되며 나스닥(Nasdaq)과 S&P 500이 급등했으나, 민주당의 압승이 데이터 센터 건설 규제라는 새로운 리스크를 야기했습니다. 특히 텍사스, 오하이오, 조지아 등 주요 주(State)의 주지사직 변화로 인해 AI 인프라 확장에 제동이 걸릴 가능성이 제기되었습니다.
Fox Business
미 중간선거에서 민주당이 의회를 장악함에 따라 AI 인프라 규제와 데이터 센터 건설에 대한 불확실성이 증대되었으나, 분점 정부 체제가 가져올 정책적 안정성이 시장의 변동성을 완화할 것으로 전망됩니다. 특히 AI 산업은 전력 및 용수 소비 문제로 인한 규제 리스크와 인프라 확장 사이의 균형점을 찾는 국면에 진입했습니다.
Quanta Magazine
Anthropic의 연구원 Jack Lindsey는 LLM의 내부 상태를 인위적으로 조작하는 '디지털 신경외과' 기법을 통해 모델이 자신의 내부 상태를 감지하는 '자기 성찰(Introspection)' 능력이 있는지 실험했습니다. 실험 결과, 특정 개념이 주입된 모델이 이를 스스로 감지하고 설명하는 현상이 관찰되어 AI의 의식 여부에 대한 새로운 논쟁을 불러일으켰습니다.
Bloomberg
미국 대선 결과에 따른 정책 변화가 AI Data Center 인프라 시장의 급격한 변동성을 예고하고 있습니다. 에너지 정책과 규제 환경의 변화는 데이터 센터 구축 비용과 전력 수급 계획에 직접적인 영향을 미칠 것으로 전망됩니다.
Google DeepMind
Google DeepMind가 발표한 Google Antigravity는 화학 정보학 분야의 에이전트 기반 워크플로우를 가속화하는 기술입니다. 이 기술은 화합물 검색 및 새로운 강직성 매크로사이클(rigidified macrocycles) 제안을 통해 신약 개발 과정을 효율화합니다.
OpenAI News
Daybreak Red가 AWS GovCloud (US-East) 환경에서 사용 가능해졌습니다. 이번 출시를 통해 승인된 고객들은 Amazon Bedrock을 통해 GPT-5.6 Cyber 모델을 활용할 수 있습니다.
Google Cloud AI
Google Cloud AI가 물리 공학 분야의 에이전트 성능을 평가하기 위한 새로운 벤치마크인 PLE를 도입했습니다. 이 벤치마크는 실제 기계, 전기, 토목 및 구조 공학 과제를 통해 최첨단 AI 에이전트의 능력을 검증합니다.
OpenAI News
ChatGPT와 Codex가 물리적 세계를 위한 엔지니어링 워크플로우를 어떻게 가속화하는지 소개합니다. CAD, PCB 설계, 시뮬레이션 등 다양한 엔지니어링 분야에서의 활용 방안을 다룹니다.
OpenAI News
Cisco가 네트워크 인텔리전스와 OpenAI 모델을 결합하여 기업 보안을 강화하는 방안을 공개했습니다. 이를 통해 더욱 적응력 있는 방어 체계를 구축하는 방법을 다룹니다.
Google Cloud AI
Google Cloud의 최신 AI 관련 발표와 혁신 사례를 소개합니다. 이번 달에 공개된 새로운 기능과 가이드를 통해 Google Cloud AI의 발전 과정을 확인할 수 있습니다.
Google DeepMind
Google DeepMind가 발표한 Genie 4는 실시간 상호작용이 가능한 차세대 월드 시뮬레이션 모델입니다. Gemini 모델을 기반으로 정교한 물리 엔진, 자연스러운 인체 움직임, 네이티브 오디오를 결합하여 현실적인 가상 세계를 구현합니다.
Google DeepMind
Google DeepMind가 차세대 프런티어 모델인 Gemini 4 Carbon을 공개했습니다. 이 모델은 최첨단 사이버 보안 기능과 장기적 추론 능력을 갖춘 가장 강력한 모델입니다.
Google Cloud AI
Google Cloud에서 Gemini Robotics Embodied Reasoning 2를 새롭게 출시했습니다. 이 모델은 기업용 로보틱스 분야에 고도화된 시공간 추론과 물리적 AI 기술을 제공합니다.
Anthropic News
Anthropic이 미국 증권거래위원회(SEC)에 Class A 보통주 상장을 위한 S-1 등록 서류를 제출했습니다. 이는 Anthropic의 기업공개(IPO)를 위한 절차의 일환입니다.
24건
Hacker News, GeekNews, Reddit 반응
Hacker News
LLM이 직접 신경망 가중치를 읽고 수정하여 성능을 최적화하는 'Weight-Space Programming' 기술이 공개되었습니다. 이 기술은 기존의 경사 하강법 없이도 모델의 문제를 진단하고 성능을 비약적으로 향상시킵니다.
Hacker News
Hacker News의 추천 데이터를 기반으로 고품질 영상 콘텐츠를 제공하는 새로운 YouTube 클론 서비스인 HackerTube가 공개되었습니다. 기존 플랫폼의 자극적인 알고리즘에서 벗어나 커뮤니티 검증을 거친 지식 중심의 피드를 제공하는 것이 핵심입니다.
Hacker News
Hacker News에서 언급된 도서 데이터를 수집하여 시각화한 서비스인 HackerBooks가 공개되었습니다. LLM을 활용해 데이터 파이프라인부터 웹사이트 구축까지 자동화한 것이 특징입니다.
Hacker News
Mistral이 1조 개의 파라미터를 가진 멀티모달 모델인 Mistral Large 4(Le Chonk)의 가중치를 공개하며 오픈 웨이트 모델의 새로운 기준을 제시했습니다. 코딩과 사이버 보안 성능을 극대화하면서도 추론 효율성을 높여 비용 효율적인 배포가 가능하도록 설계되었습니다.
Hacker News
심각한 커널 취약점 CVE-2026-98432에 대한 Ubuntu의 패치 지연이 커뮤니티의 거센 비판을 받고 있습니다. 보안 구독 모델을 운영하는 기업형 배포판이 커뮤니티 기반 배포판보다 대응이 늦다는 점이 신뢰도 위기로 번지고 있습니다.
Hacker News
특정 핑거프린팅 스크립트가 의도치 않게 위험한 생물 무기 제조 정보를 생성할 수 있다는 보안 취약점을 다룹니다. LLM의 안전 가드레일이 특정 프롬프트에 의해 우회될 수 있음을 보여주는 사례입니다.
Hacker News
Postman이 사용자 동의 없이 AI 플러그인을 자동 설치하고 API 데이터를 공유하려 한다는 보안 이슈가 제기되었습니다. 개발자 도구로서의 신뢰도가 하락하며 커뮤니티 내에서 거센 비판이 일고 있습니다.
Hacker News
Astra의 Qwen 모델 가중치 수정 방식이 과장되었다는 비판이 제기되었습니다. 연구 성과를 과하게 포장했다는 전문가들의 지적과 함께 기술적 실체에 대한 논쟁이 이어지고 있습니다.
Hacker News
Cursor Marketplace에 등록된 Claude Code VS Code 확장 프로그램에서 백도어가 발견되어 보안 경고가 발생했습니다. Anthropic은 이번 사건이 자사 시스템 침해는 아니며 Cursor 플랫폼을 통한 악성 코드 유포임을 명시했습니다.
Hacker News
단순히 차량 내 시간을 변경하기 위해 내비게이션 시스템의 펌웨어를 추출하고 탈옥(Jailbreaking)을 시도한 기술적 과정을 다룹니다. 사용자의 집요한 디버깅 과정과 그에 따른 보안 취약점 노출이 커뮤니티의 관심을 끌었습니다.
GeekNews / Hada
이번 사고는 AI 에이전트를 활용한 고도화된 공격이 인프라 자격 증명을 탈취할 수 있음을 보여준 사례입니다. 기업은 AI 서비스 도입 시 데이터 유출 위험을 고려하여 API 토큰 관리와 접근 제어 정책을 더욱 엄격히 수립해야 합니다.
GeekNews / Hada
사용 가능한 무선 통신 장비가 자원 순환 없이 폐기될 위기에 처한 상황을 보여줍니다. 아마추어 무선 커뮤니티 내의 원활한 장비 인계와 데이터 기반의 접수 시스템 확인이 시급한 과제로 제시되었습니다.
GeekNews / Hada
데이터센터와 AI 가속기 중심의 사업 구조 개편이 AMD의 매출 성장을 견인하며 인텔과의 격차를 벌리고 있습니다. 이는 클라이언트 시장의 변동성을 서버와 AI 인프라 매출로 상쇄하는 고수익 구조로의 전환을 의미합니다.
GeekNews / Hada
고객 응대 자동화 과정에서 발생하는 정형화된 문체는 문제 해결 여부와 관계없이 고객에게 불신을 심어줄 수 있습니다. 기술적 정확도만큼이나 인간적인 맥락이 담긴 소통이 고객 경험(CX) 관리의 핵심임을 보여주는 사례입니다.
GeekNews / Hada
과학적 검증은 단순한 결과의 일치 여부를 넘어 인간의 비판적 이해와 책임이 결합된 과정이어야 합니다. AI 시대의 과학은 알고리즘의 효율성보다 지식의 근거를 확보하고 사회적 가치를 반영하는 주체적 판단력을 유지하는 데 초점을 맞춰야 합니다.
GeekNews / Hada
GitHub의 핵심 서비스들이 동시에 영향을 받은 이번 장애는 개발 워크플로우 전반에 걸친 가용성 저하를 야기했습니다. 서비스 복구는 완료되었으나, 향후 발표될 근본 원인 분석(RCA) 결과에 따라 인프라 안정성 확보가 핵심 과제가 될 전망입니다.
GeekNews / Hada
데이터센터의 급격한 확장이 지역 사회의 에너지 및 수자원 인프라와 충돌하며 사회적 갈등이 심화되고 있습니다. 이는 향후 데이터센터 부지 선정과 운영 방식에 있어 지역 주민과의 합의가 핵심적인 변수가 될 것임을 시사합니다.
GeekNews / Hada
이번 사건은 개발 환경의 신뢰를 악용한 공급망 공격과 사회공학적 기법이 결합했을 때 발생하는 막대한 경제적 피해를 보여줍니다. 개발 도구와 오픈소스 구성요소에 대한 검증 체계가 보안의 핵심 취약점이 될 수 있음을 시사합니다.
GeekNews / Hada
대규모 파라미터와 MoE 구조를 결합하여 에이전트 역량을 극대화한 고성능 모델의 공개입니다. 방대한 컨텍스트 창과 강화학습을 통해 전문적인 작업 수행 능력을 확보한 것이 기술적 핵심입니다.
GeekNews / Hada
미국 의회 권력 구조가 민주당 중심으로 재편됨에 따라 트럼프 행정부의 정책에 대한 강력한 견제와 조사가 이루어질 전망입니다. 민주당은 확보한 위원회 권한을 통해 전임 행정부의 정책과 관련 사업들을 정밀 조사할 수 있는 법적 토대를 마련하게 되었습니다.
팔로알토 소재 기업이 3,200만 달러를 투입하여 처음부터 학습시킨 65B 규모의 밀집(dense) LLM인 Ripple-65B를 공개했습니다. 이 기업은 장기적으로 칩 설계 분야에도 집중할 계획입니다.
웹 디자인 회사를 운영하는 작성자가 가격 전략과 영업 방식의 변화를 통해 월 매출을 2만 달러에서 7만 4천 달러로 대폭 끌어올린 성공 사례를 공유했습니다. 고객 수를 늘리는 대신 가치 중심의 고가 전략과 AI를 활용한 맞춤형 제안 방식을 도입한 것이 핵심입니다.
특정 하드웨어에만 최적화된 파편화된 커스텀 엔진 개발 현상을 해결하기 위해, 이를 모듈화하여 재사용 가능한 데이터베이스로 만드는 아이디어가 제안되었습니다. 개별 엔진의 핵심 기술을 추출하여 저장함으로써 누구나 자신의 환경에 맞는 최적의 추론 엔진을 쉽게 구축할 수 있는 생태계를 지향합니다.
AI 기술이 소프트웨어에만 머물러 있다는 점을 지적하며, 진정한 AI 네이티브 하드웨어의 형태와 인터페이스에 대한 의문을 제기하는 글입니다. 과거 GUI나 터치스크린처럼 하드웨어와 소프트웨어가 결합된 혁신이 AI 시대에도 재현될 수 있을지 논의를 유도하고 있습니다.
47건
읽어볼 만한 AI 연구
AI 연구
AGI 구현을 위해 단일 모델 대신 다양한 전문 모델과 도구를 결합하는 방식이 주목받고 있습니다. 하지만 작업별로 최적의 후보를 동적으로 선택하면서 성능과 비용 사이의 균형을 맞추는 것은 매우 어려운 문제입니다. 본 논문은 범용 AI 시스템을 위한 모델 및 정책 라우팅 연구 프레임워크인 'Route Anything'을 제안합니다. 연구진은 25개 벤치마크와 45만 개 이상의 실행 데이터를 포함하는 옴니모달 궤적 매트릭스를 구축하여 이론적 토대를 마련했습니다. 실험 결과, 학습된 라우터는 고정된 단일 모델보다 높은 성능을 보이면서도 평균 8.82배의 효율성 향상을 달성했습니다.
AI 연구
기존 LLM 기반 심리치료 시뮬레이터는 정돈된 사례 설명에 의존하여, 실제 내담자가 겪는 모호하고 감정적인 발화 특성을 재현하는 데 한계가 있었습니다. 본 논문은 심리적 경험이 개별적인 표현으로 구체화되는 과정을 모델링하는 Pandora 프레임워크를 제안합니다. Pandora는 치료사의 개입에 따라 심리적/관계적 상태를 업데이트하고, 주관적 평가와 전략을 수립한 뒤, 별도의 표현 플래너(Expression Planner)를 통해 내담자 특유의 언어 패턴을 결합합니다. 115개의 사례를 활용한 실험 결과, 제안 모델은 기존 베이스라인 대비 높은 표현 유사도와 정보 공개 정렬 점수를 기록했습니다. 특히 표현 계획 단계가 포함될 때 AI 특유의 정형화된 말투가 크게 감소하며 실제 인간과 유사한 발화 양상을 보였습니다.
AI 연구
최근 대형 추론 모델은 강력한 성능을 보이지만, 이미 충분한 정보가 확보된 후에도 계속되는 긴 Chain-of-Thought로 인해 과도한 추론 비용이 발생합니다. 기존의 추론 압축 방식은 전체 경로를 줄이는 데 집중할 뿐, 현재 상태에서 추가 추론이 필요한지에 대한 국소적 판단에는 소홀했습니다. 본 논문은 모델 스스로 과잉 추론 상태를 감지하고, 동일 지점에서 더 짧고 검증된 답변을 생성하여 DPO로 학습하는 LoCo 방식을 제안합니다. 이를 통해 모델은 단순히 짧은 답변을 만드는 것이 아니라, 언제 추론을 지속하고 언제 종료할지를 학습하게 됩니다. 실험 결과, 수학 및 코드 생성 벤치마크에서 정확도를 유지하거나 향상시키면서도 생성 길이를 대폭 단축하는 성과를 거두었습니다.
AI 연구
기존의 단일샷 편집 방식은 장면, 시점, 피사체 변화가 빈번한 장편 멀티샷 영상에서 일관성을 유지하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 데이터 생성, 모델링, 평가를 통합적으로 다루는 MoviEdit 프레임워크를 제안합니다. 데이터 측면에서는 수동 작업 없이 87K개의 쌍을 생성하는 자동화 파이프라인을 구축했습니다. 모델 구조는 압축된 표현에서 전역적 일관성을 잡는 경량 양방향 단계와, 이를 전체 영상으로 전파 및 정교화하는 자기회귀(autoregressive) 단계로 구성됩니다. 실험 결과, MoviEdit는 기존 오픈소스 모델을 압도하며 업계 최고 수준의 성능을 보여주었습니다.
AI 연구
비디오 생성 기술이 단순 렌더링을 넘어 의미적 제어(Semantic Control) 단계로 진화함에 따라, 생성 품질을 결정하는 멀티모달 이해 역량이 중요해졌습니다. 본 보고서는 Kling 모델 개발 과정에서 얻은 통찰을 바탕으로 데이터, 정렬, 평가로 이어지는 전체 체인을 분석합니다. 핵심은 다양한 입력을 통합하는 Kling-MLLM을 기반으로, 캡셔닝을 고밀도 의미 계약으로 정의하고 에이전트 기반 프롬프트 강화(PE)를 통해 사용자 의도를 정교화하는 것입니다. 또한, 텍스트 인코더는 언어 능력보다 지각적 학습(Perceptual Training)이 중요하며, 보상 모델링은 설명 가능한 비판과 빠른 스코어링을 분리하여 설계해야 함을 보여줍니다. 이러한 체계적 접근은 제어 가능한 비디오 생성을 위한 실질적인 가이드를 제공합니다.
AI 연구
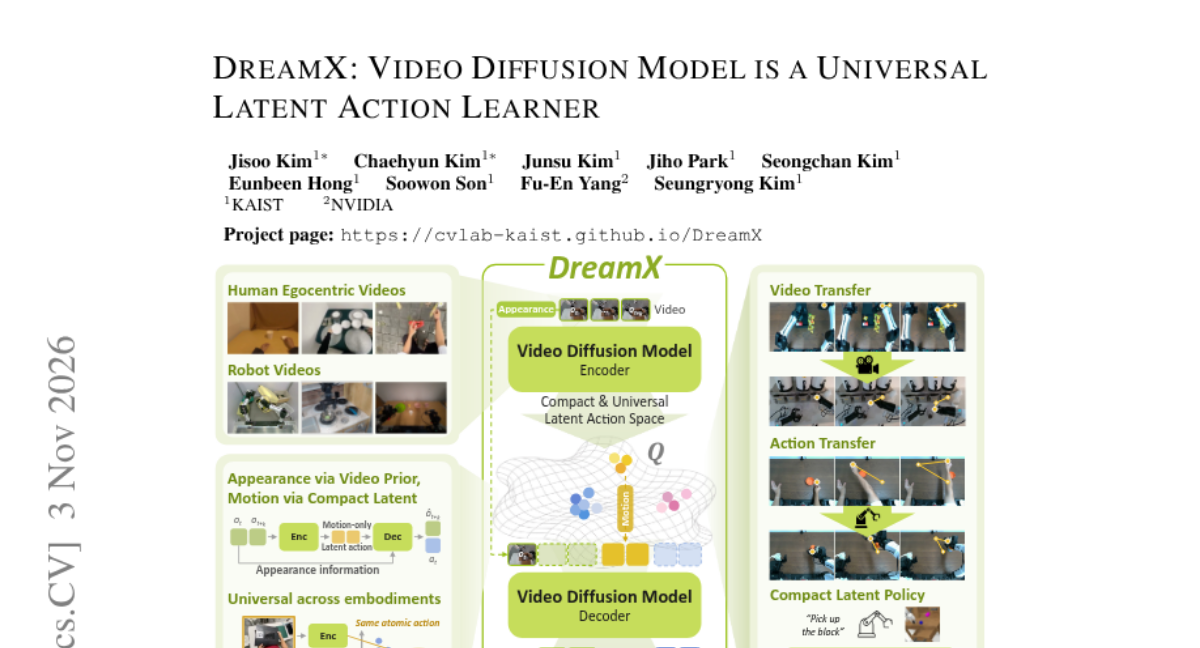
기존의 잠재 액션 모델은 시각적 변화와 실제 동작이 얽혀 있어 다른 환경이나 로봇에 적용하기 어려웠습니다. 본 논문은 사전 학습된 비디오 확산 모델을 활용하여 범용적인 잠재 액션 학습기인 DreamX를 제안합니다. DreamX는 비디오 모델의 풍부한 시공간 특징을 활용해 각 프레임을 매우 압축된 토큰 형태로 변환하며, 생성적 사전 지식을 통해 외형과 분리된 동작 역학을 포착합니다. 이를 통해 인간과 로봇, 다양한 환경 간의 공유 액션 인터페이스를 구축했습니다. 실험 결과 LARY-Bench에서 SOTA를 달성했으며, 제로샷 액션 전이와 효율적인 정책 학습 능력을 입증했습니다.
AI 연구
범용 로봇 정책은 다양한 환경에서 작동해야 하지만, 물리적 실험의 가변성으로 인해 재현이 어렵다는 문제가 있습니다. 이를 해결하기 위해 분산형 평가 프레임워크인 RoboColosseum을 도입하여, 서로 다른 환경에 위치한 로봇 네트워크를 통해 표준화된 프로토콜로 정책을 평가합니다. 연구팀은 4종의 로봇 하드웨어와 VLA 정책 및 AI 에이전트들을 대상으로 Open Track(제로샷 비교)과 Fine-tune Track(미세 조정 성능)을 수행했습니다. 실험 결과, 프론티어 에이전트들이 전문 VLA 정책에 필적하는 성능을 보였으나 모든 시스템이 완전한 작업 성공에는 어려움을 겪었습니다. 또한, 초기 성능 순위가 미세 조정 후의 성능을 예측하기 어렵다는 점과 작업 성공률 외에 '부분적 진행도'를 측정하는 것이 중요함을 확인했습니다.
AI 연구
Composed Image Retrieval(CIR)은 참조 이미지와 수정 텍스트를 결합해 타겟 이미지를 찾는 작업입니다. 기존 MLLM 기반 방식은 합성 쿼리를 하나의 임베딩으로 직접 매핑하여 모델의 합성 이해 능력을 충분히 활용하지 못하는 문제가 있었습니다. 본 논문은 쿼리 이해와 판별적 임베딩 생성을 분리하는 FactEmbed 방식을 제안합니다. FactEmbed는 중간 단계의 타겟 상상(target imagination) 목적 함수를 통해 분리된 잠재 변수(latents)가 타겟 의미를 먼저 파악하도록 유도합니다. 이후 분리된 표현을 MLLM의 깊은 어텐션 레이어로 증류하고 요소별 대조 손실을 최적화하여 검색 성능을 높입니다. 실험 결과, FactEmbed는 기존 CIR 벤치마크에서 우수한 성능을 입증했습니다.
AI 연구
기존의 에이전트 모델 학습은 복잡한 중간 학습 단계와 정교한 최적화 기법을 필요로 하는 경우가 많았습니다. Axion 1.0은 이를 해결하기 위해 데이터 구축, 도구 활용, 강화 학습으로 이어지는 단순하고 효율적인 3단계 학습 방식을 제안합니다. 첫 번째 SFT 단계에서는 모델 자체의 해결 전략을 활용한 적대적 데이터 생성을 통해 추론 능력을 강화하고, 두 번째 단계에서는 검증 가능한 실세계 데이터 기반의 파이프라인으로 도구 활용 능력을 확장합니다. 마지막으로 강화 학습을 통해 장기 추론 및 환경 상호작용 능력을 극대화합니다. 그 결과, Axion 1.0은 단순한 학습 과정만으로도 상용 모델에 필적하는 강력한 에이전트 성능을 달성하며 전체 학습 과정을 오픈 소스로 공개했습니다.
AI 연구
최근 LLM 에이전트는 다양한 도구를 조합하여 복잡한 워크플로우를 수행하지만, 기존의 데이터 중심 환경 생성 방식은 실제 도구 인터페이스와의 불일치 및 실행 불가능한 시나리오 생성이라는 문제를 가집니다. 이를 해결하기 위해 제안된 ToolSpace는 실제 MCP 서비스의 실행 트레이스에서 데이터, 상태, 재시도 의존성을 추출하는 도구 중심 프레임워크입니다. 결정론적 규칙을 사용하여 도구 간 관계를 그래프로 클러스터링하고, 상태 변화가 있는 환경에 대해서만 데이터베이스를 합성하며 쿼리형 도구는 기록된 반환값을 재현합니다. 이후 상태 인지 무작위 보행(state-aware random walk)과 롤백 과정을 통해 검증된 시나리오를 자연어 태스크로 역컴파일합니다. 실험 결과, 생성된 고난도 벤치마크에서 기존 모델들의 성능이 크게 하락했으며, ToolSpace를 통한 학습 시 모델 성능이 비약적으로 향상되었습니다.
AI 연구
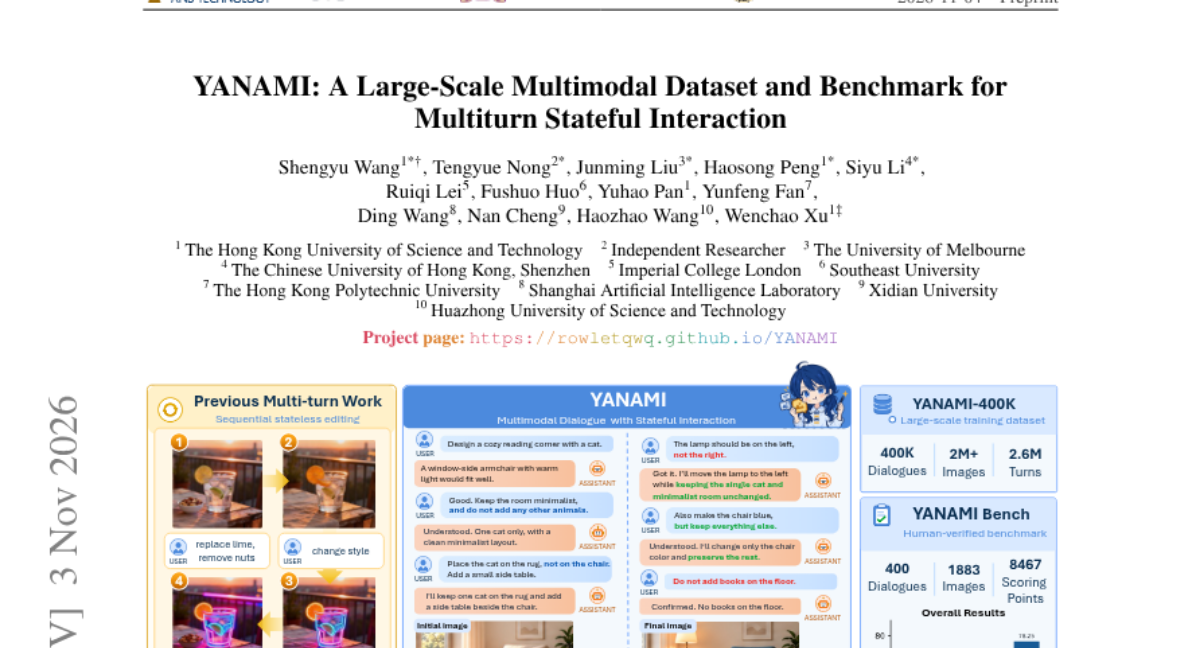
기존의 통합 멀티모달 모델(UMM) 데이터셋은 단발성 작업에 치중되어 있어, 대화가 진행됨에 따라 변화하는 상태를 추적하고 유지하는 능력을 평가하기 어렵습니다. 이를 해결하기 위해 대화 상태의 유지, 업데이트, 시각적 구현을 요구하는 대규모 멀티모달 데이터셋인 YANAMI-400K와 벤치마크인 YANAMI-Bench를 도입합니다. YANAMI-400K는 이미지 융합, 편집, 월드 모델링, 시각적 추론 등 4가지 시나리오를 포함하는 40만 개의 멀티턴 대화로 구성됩니다. 실험 결과, YANAMI-400K로 모델을 미세 조정했을 때 이미지 편집 및 멀티턴 상태 상호작용 능력이 크게 향상되었습니다. 반면 기존 모델들은 여전히 변화하는 대화 상태를 유지하고 이를 시각적으로 구현하는 데 어려움을 겪는 것으로 나타났습니다.
AI 연구
멀티모달 학습의 발전은 고품질 지시어 데이터의 부족과 높은 주석 비용 문제로 인해 제약을 받고 있습니다. 기존의 원시 비디오를 정밀한 학습 데이터로 변환하는 것은 매우 까다로운 작업입니다. 이를 해결하기 위해 본 논문은 비디오에서 이해, 편집, 통합 작업을 위한 지시어 데이터를 합성하는 자동화 파이프라인인 VidUEU-Agent를 제안합니다. 이 에이전트는 전역 인지, 키프레임 추출, 메타데이터 구축 및 합성의 4단계 과정을 거치며, 하위 작업 학습 결과에 따라 데이터 분포를 자율적으로 반복 최적화합니다. 이를 통해 구축된 100K 규모의 VidUEU-100K 데이터셋은 다양한 벤치마크에서 모델 성능을 크게 향상시켰습니다.
AI 연구
개별 에이전트 역량과 팀 조직 구조, 상호작용 규칙을 동시에 진화시켜 복잡한 태스크에 최적화된 팀을 구성하는 프레임워크
AI 연구
GUI 웹 에이전트 개발을 위해서는 안정적이고 현실적인 환경이 필요하지만, 실제 웹은 콘텐츠 변화와 접근 제한 문제로 평가가 어렵고 기존 합성 환경은 기능적 깊이가 부족합니다. 이를 해결하기 위해 연구진은 153개의 실행 가능한 도커화된 웹 환경인 WebHarber를 제안합니다. WebHarbor는 인간과 에이전트의 협업을 통해 시각적 충실도와 기능적 워크플로우를 유지하며 진화하는 방식으로 구축되었습니다. 이를 통해 3,518개의 다단계 및 인증 기반 워크플로우 태스크를 확보했습니다. 실험 결과, WebHarbor에서 RL로 학습된 Qwen 4B 모델이 미학습 태스크에 대한 일반화 성능과 경쟁력 있는 성능을 보였습니다.
AI 연구
LLM 에이전트의 하네스(Harness) 최적화는 모델 가중치 수정 없이 성능을 높일 수 있지만, 기존 방식은 주로 품질 향상에만 집중합니다. 품질과 비용을 동시에 최적화하려 할 경우, 최종 배포 기준을 중간 단계에 적용하면 나중에 더 발전할 가능성이 있는 후보가 조기에 탈락하는 문제가 발생합니다. 이를 해결하기 위해 ParetoSaddler는 중간 후보 승격과 최종 배포 선택 과정을 분리하는 방식을 제안합니다. 각 반복 단계에서 Bayesian bootstrap Pareto support를 사용하여 품질이나 비용 측면에서 신뢰할 수 있는 진전을 보이는 후보를 선별하고, 이들이 이후 최적화의 부모가 될 수 있도록 유지합니다. 실험 결과, ClawMark와 GAIA2 벤치마크에서 품질 향상과 비용 절감을 동시에 달성하며 기존 품질 중심 최적화보다 우수한 효율성을 입증했습니다.
AI 연구
분자 발견은 방대한 탐색 공간에서 상충하는 생물학적 목표를 균형 있게 해결해야 하는 과제를 안고 있습니다. 기존의 AI 에이전트는 자동화에는 능숙하지만, 새로운 작업에 맞춰 워크플로를 최적화하거나 경험을 통해 개발 역량을 높이는 데 한계가 있었습니다. 본 논문에서는 워크플로와 모델 아키텍처의 체계적 최적화 및 태스크 간 메모리를 결합한 MoLRSI 에이전트를 제안합니다. MoLRSI는 실행 피드백과 정제 결과를 바탕으로 검색 정책을 재귀적으로 개선하며, 이를 통해 워크플로 자체와 개발 전략을 동시에 발전시킵니다. 실험 결과, 항생제 발굴 및 펩타이드 설계 작업에서 기존 전문가 주도 방식 및 타 모델보다 월등한 실험적 히트율을 달성했습니다.
AI 연구
Speculative Decoding은 LLM 추론 속도를 높이지만, 기존 시스템은 병렬 드래프팅의 잠재력을 완전히 활용하지 못하는 문제가 있습니다. 연구진은 단일 요청 시의 낮은 연산 효율, 배치 처리 시의 속도 저하, 그리고 배포 환경마다 다른 최적화 요구사항을 주요 과제로 식별했습니다. 이를 해결하기 위해 알고리즘과 시스템 최적화를 자동으로 수행하는 에이전트 루프인 SpecPilot을 제안합니다. SpecPilot은 비용 모델을 통해 성능 격차를 식별하고, 병렬 에이전트가 최적화 방향을 탐색하며, 토큰 강제(Token forcing)를 통해 품질 저하를 방지합니다. 실험 결과, 학습이나 품질 손실 없이 단일 요청 시 최대 10.87배, 배치 환경에서도 3.93배의 속도 향상을 달리며 기존 시스템 대비 압도적인 성능을 입증했습니다.
AI 연구
코딩 에이전트가 제안하는 셸 명령의 실행 여부를 결정하는 자동 승인 시스템의 중요성이 커지고 있습니다. 기존 방식은 명령 텍스트 자체에만 의존하여, 명령이 호출하는 코드나 워크스페이스 상태에 따른 실제 동작을 예측하기 어렵다는 문제가 있습니다. 본 논문은 샌드박스 환경에서 명령을 미리 실행하여 관찰된 효과를 기반으로 승인 여부를 결정하는 Caper를 제안합니다. Caper는 스냅샷 기반 샌드박스에서 명령을 사전 실행하고, 독립적인 승인자가 관찰된 효과를 분석하여 실행 여부를 결정합니다. 실험 결과, Caper는 기존 시스템 대비 유해한 결과 발생률을 대폭 낮추면서도 안전한 작업에 대한 차단율을 최소화하며 우수한 성능을 입증했습니다.
AI 연구
기존의 컴퓨터 사용 에이전트(CUA)는 시각적 GUI 조작과 코드/터미널 실행을 하나의 정책 내에서 결합하는 데 어려움이 있었습니다. 본 논문은 4B 파라미터 규모의 하이브리드 CUA인 Mage-VL-sowork를 제안합니다. 이를 위해 재사용 가능한 스킬 조건부 생성 워크플로우인 Mage-CUA-Forge를 구축하여 약 29만 개의 태스크를 효율적으로 합성했습니다. 학습은 미드트레이닝, SFT, RL로 이어지는 5단계 커리큘럼을 통해 진행되며, 고정된 교사 모델 대신 진화하는 하네스를 통해 고품질 궤적을 생성합니다. 결과적으로 OSWorld-Verified 벤치마크에서 동급 파라미터 대비 최고 성능을 달성하며 온디바이스 지능의 가능성을 보여주었습니다.
AI 연구
새로운 도메인 환경에서 파운데이션 모델은 학습 데이터 부족과 신뢰할 수 있는 감독 신호의 부재라는 문제에 직면합니다. 이를 해결하기 위해 Recursa는 인간 전문가나 더 강력한 교사 모델 없이도 스스로 경험을 통해 적응하는 시스템을 제안합니다. Recursa는 도메인 지식, 실행 지침, 과거 경험 및 성찰을 저장하는 지식 저장소(Knowledge Repository)를 활용합니다. 도메인 자료로부터 저장소를 초기화한 후, 병렬 학습자가 작업을 수행하고 국소적 개선 사항을 합성하며, 이를 검증하여 저장소에 병합하는 재귀적 과정을 거칩니다. 실험 결과, Harvey LAB의 Firm Knowledge 벤치마크에서 기존 모델 대비 성능 향상을 입증했습니다.
AI 연구
기존의 이미지 내 기계 번역(IIMT) 방식은 대규모의 번역 전후 쌍 데이터셋을 필요로 하는 학습 기반 방식에 의존해 왔습니다. 본 논문은 최신 텍스트-이미지(T2I) 생성 모델의 다국어 능력을 활용하여 학습이 필요 없는 IIMT 프레임워크인 FlowTranslator를 제안합니다. OCR과 LLM을 통해 번역 프롬프트를 생성한 뒤, 이를 확산 모델(Diffusion Model)에 주입하는 방식을 취합니다. 특히 정확하고 자연스러운 텍스트 생성을 위해 RCR(Region Coupling Release)과 CE(Coupling Expansion)라는 두 가지 궤적 제어 기법을 도입했습니다. 실험 결과, 기존 학습 기반 모델인 UniTranslator를 상회하는 성능을 보였으며 실질적인 이미지 번역 작업에서 우수한 정확도를 입증했습니다.
AI 연구
기존의 로봇 월드 모델은 명령된 액션 준수, 멀티뷰 일관성 유지, 장기 시뮬레이션 시 발생하는 오차 누적 문제에 직면해 있습니다. 이를 해결하기 위해 22개 플랫폼의 3만 시간 이상의 로봇 데모를 활용한 PrimeSim을 제안합니다. 액션-프레임 대응력을 높이는 통합 액션 표현과 뷰 인식 인터리브 어텐션을 통해 멀티뷰 일관성을 확보했습니다. 또한, fast-video/slow-memory 포스트트레이닝 프레임워크를 도입하여 효율적인 자기회귀적 시뮬레이션을 구현했습니다. 그 결과, PrimeSim은 높은 FPS와 안정적인 장기 롤아웃 성능을 보이며 정책 최적화를 위한 신뢰할 수 있는 시뮬레이터를 제공합니다.
AI 연구
기존의 On-policy Self-distillation(OPSD)은 학습 과정에서 교사 모델의 참조 범위를 고정하거나 응답 단위로만 조정하여 토큰별 미세한 차이를 반영하지 못했습니다. 본 논문은 교사 모델에 대한 선호도가 응답 내에서도 토큰마다 다를 수 있다는 점에 주목합니다. 이를 위해 다수의 후보 교사 풀에서 각 토큰에 가장 적합한 교사를 선택하는 MTA-OPSd 방식을 제안합니다. 실험 결과, 수학적 추론 작업에서 기존 OPSD 방식보다 우수한 성능 향상을 입증했습니다. 결과적으로 토큰 수준의 적응형 감독이 모델 성능 향상에 핵심적임을 보여줍니다.
AI 연구
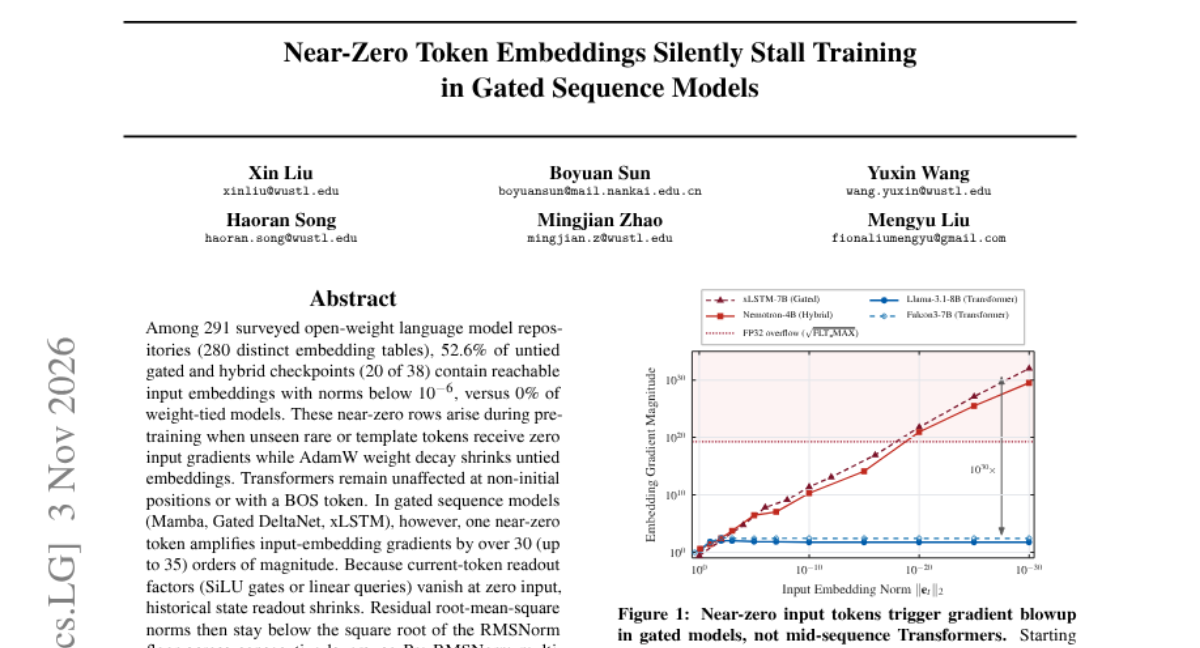
최근 공개된 Gated 및 하이브리드 시퀀스 모델의 약 52.6%에서 임베딩 노름이 극도로 낮은 현상이 발견되었습니다. 이는 학습 중 드문 토큰에 대한 그래디언트 부재와 AdamW 가중치 감쇠가 결합되어 발생하며, 특히 Gated 모델에서 그래디언트를 수십 자릿수만큼 증폭시키는 문제를 일으킵니다. 이로 인해 RMSNorm 구조에서 그래디언트가 폭주하여 FP32 클리핑 시 무한대(Inf)로 넘어가 학습 업데이트가 소실되는 현상이 발생합니다. 본 논문은 이미 배포된 모델을 위한 GroupClip과 사전 학습 단계에서의 GateFloor 기법을 제안합니다. 실험 결과, 제안된 방법들은 성능 저하 없이 문제를 해결하고 손상된 임베딩을 복구할 수 있음을 입증했습니다.
AI 연구
기존의 Speculative Decoding은 모델의 동작을 바꾸지 않는 시스템 최적화 기법으로만 여겨져 왔습니다. 그러나 장기 추론 작업에서는 검증 과정에서의 수치적 노이즈가 누적되어 최종 출력 분포와 추론 정확도에 영향을 미친다는 점을 발견했습니다. 본 논문은 이러한 노이즈를 제어하기 위해 드래프트 모델이 의도적으로 거부될 지점을 학습하는 방식을 제안합니다. 에이전트의 결정적 추론 지점을 식별하여 드래프트 모델이 해당 지점에서 거부되도록 학습함으로써, 중요한 추론 토큰은 타겟 모델이 직접 생성하도록 유도합니다. 결과적으로 타겟 모델의 파라미터를 수정하지 않고도 복잡한 코딩 벤치마크에서 에이전트의 성공률을 높였습니다.
AI 연구
실제 소프트웨어 개발은 하나의 작업이 아닌 여러 미완성 과제를 병행하는 경우가 많습니다. 기존 벤치마크는 단일 이슈 해결 능력에만 집중하여, 작업 간 전환 시 발생하는 문맥 복구 능력을 측정하지 못하는 한계가 있습니다. 이를 해결하기 위해 동일 저장소 내에서 여러 미완성 작업을 교차 수행하는 'Switch-SWE' 벤치마크를 도입했습니다. 실험 결과, 작업 전환 시 에이전트의 해결 능력이 평균 11.5%p 하락하며 요구사항 혼선과 상태 손실이 발생하는 것을 확인했습니다. 이를 방지하기 위해 작업 관련 이력 선택 및 상태 요약을 수행하는 컨텍스트 관리 모듈을 제안했습니다. 제안된 모듈은 모델별로 작업 전환 시 완료율을 최대 15.5%p 향상시켰습니다.
AI 연구
AI 리뷰어가 논문 수정 과정을 적절히 평가하는지 확인하기 위해 PaperTrajectory-2026 데이터셋을 활용한 대규모 연구를 수행했습니다. 연구진은 5개 AI 컨퍼런스의 6,959개 논문 수정 이력을 바탕으로 14개 차원의 변화와 리뷰어 점수를 분석했습니다. 분석 결과, 실질적인 주요 개선 사항이 이루어져도 리뷰어 점수는 변하지 않거나 점수 변화의 방향성이 일치하지 않는 현상이 발견되었습니다. 또한, 리뷰어의 주관적인 의견이 객관적인 수정 성과를 상쇄하거나 역전시키는 경향이 확인되었습니다. 결론적으로 현재의 AI 리뷰 시스템은 논문의 실질적 개선을 일관되게 반영하지 못하고 있습니다.
AI 연구
실시간 환경에서 시각적 에이전트는 추론과 행동 사이의 정교한 조율이 필요하지만, 변화하는 환경에 대응하는 데 어려움이 있습니다. 본 연구는 리그 오브 레전드(LoL) 환경에서 자원 관리, 전투, 협동 등 36가지 챔피언별 과업을 포함하는 LOLPlay 벤치마크를 제안합니다. 에이전트는 스크린샷과 마우스-키보드 입력을 통해 상호작용하며, 자동화된 초기화 및 82개의 하위 목표 체크를 통해 수행도를 측정합니다. 실험 결과, GPT-6 Astra 모델이 가장 높은 성공률을 기록했으나, 추론 시간을 늘리는 것이 반드시 성능 향상으로 이어지지는 않았습니다. 이는 실시간 제어에서 과도한 추론이 오히려 상호작용 기회를 줄이는 비용을 발생시킴을 시사합니다.
AI 연구
최신 오픈 웨이트 모델에서 후반 토큰 생성 비용이 초반보다 최대 7배까지 높아지는 비용 불균형 문제가 발생하고 있습니다. 본 논문은 긴 컨텍스트를 유지하는 대신 빈번한 압축(Compaction)을 사용하는 방안을 제안합니다. 다양한 장기적 작업(Long-horizon) 및 긴 입력 작업에서 컨텍스트를 짧게 유지하더라도 모델 성능 저하가 거의 없음을 확인했습니다. 특히 소프트웨어 엔지니어링 작업에서 모델 성능이 붕괴되지 않음을 입증하며 'Semantic State Space Models(SSSMs)' 개념을 제시합니다. 결과적으로 무조건적인 긴 컨텍스트 모델의 필요성에 의문을 제기합니다.
AI 연구
기존 모델은 고정된 연산량으로 인해 복잡한 문제 해결이나 효율적인 토큰 생성에 제약이 있었습니다. 이를 해결하기 위해 nGPT 백본을 기반으로 입력, 공유 재귀, 출력 블록이 결합된 Dory1.0-4B를 제안합니다. 모델은 재귀적 루프 구조를 통해 추론 시 연산량을 가변적으로 조절할 수 있으며, 난이도 기반 루프 커리큘럼을 통해 학습되었습니다. 실험 결과, 루프 횟수를 늘릴수록 코딩 및 에이전트 작업에서 성능이 향상되었으며, 더 큰 규모의 모델들을 능가하는 효율성을 보였습니다. 특히 KV 캐시 최적화를 통해 메모리 사용량을 최소화하면서도 높은 정확도를 유지했습니다.
AI 연구
로봇 파운데이션 모델의 발전에도 불구하고 새로운 작업 학습을 위한 원격 조작(Teleoperation) 데이터 수집은 여전히 비용이 많이 듭는 작업입니다. 기존의 인간 영상 기반 데이터는 로봇의 복잡한 관절 구조와 시각적/동작적 차이로 인해 직접적인 활용에 한계가 있었습니다. 본 논문은 인간의 동작은 유지하되 인간을 로봇으로 교체하는 '가상 피팅' 개념의 RoboTryOn을 제안합니다. 참조 이미지를 통해 타겟 로봇의 외형을 유지하면서 배경과 물체를 보존하며, 스켈레톤 기반 모션 가이드를 통해 일관된 비디오를 생성합니다. 또한 역역학 모델(IDM)을 통해 합성된 영상에서 액션 라벨을 추출하여 정책 학습에 활용합니다. 실험 결과, 실제 로봇 시연 없이도 양손 조작 등 어려운 작업의 성공률을 2%에서 60%로 높였으며, 원격 조작 데이터와 대등한 성능을 약 1/3의 비용으로 달성했습니다.
AI 연구
로봇 범용 에이전트는 장면 해석, 행동, 작업 조건 충족이라는 복합적인 능력이 필요하지만, 최신 VLM이 이를 얼마나 충족하는지는 불분명합니다. 이를 위해 기하학, 공간 추론, 어포던스, 작업 계획, 조작 능력을 평가하는 1,000개 케이스 규모의 'Embodied Agent Arena' 벤치마크를 제안합니다. 실험 결과, 폐쇄형 모델이 모든 영역에서 우수했으나 오픈 소스 모델은 공간 추론은 가능해도 계획 및 조작 성공률은 현저히 낮았습니다. 특히 유효한 영역 추정이 반드시 실행 가능한 행동 지점으로 이어지지 않으며, 실행 과정에서 하위 목표는 달성하되 최종 상태를 유지하지 못하는 문제가 발견되었습니다. 또한 코드 수정이나 자기 검토와 같은 추가 연산이 반드시 작업 완수로 이어지지 않는다는 점을 확인했습니다.
AI 연구
기존의 3D 생성, 편집, 완성 작업은 국소적인 수정이 필요함에도 전체 에셋을 재생성하는 방식이어서 작업 간 분절과 콘텐츠 불일치 문제가 발생했습니다. 연구진은 특정 영역만 합성하고 나머지는 유지하는 'Selective Modeling' 패러다임을 제안하여 세 작업을 하나의 프레임워크로 통합했습니다. 이를 위해 특정 영역에만 노이즈와 손실을 적용하는 'region-selective denoising'과 멀티 조건 제어가 가능한 'Omni3DiT' 아키텍처를 설계했습니다. 이 방식은 별도의 쌍(paired) 데이터 없이도 일반 3D 에셋만으로 학습이 가능하며, 작업 간 일관성을 유지합니다. 실험 결과, 기존 SOTA 모델들을 상회하는 성능을 보였으며 생성과 편집 모두에서 높은 정밀도를 달성했습니다.
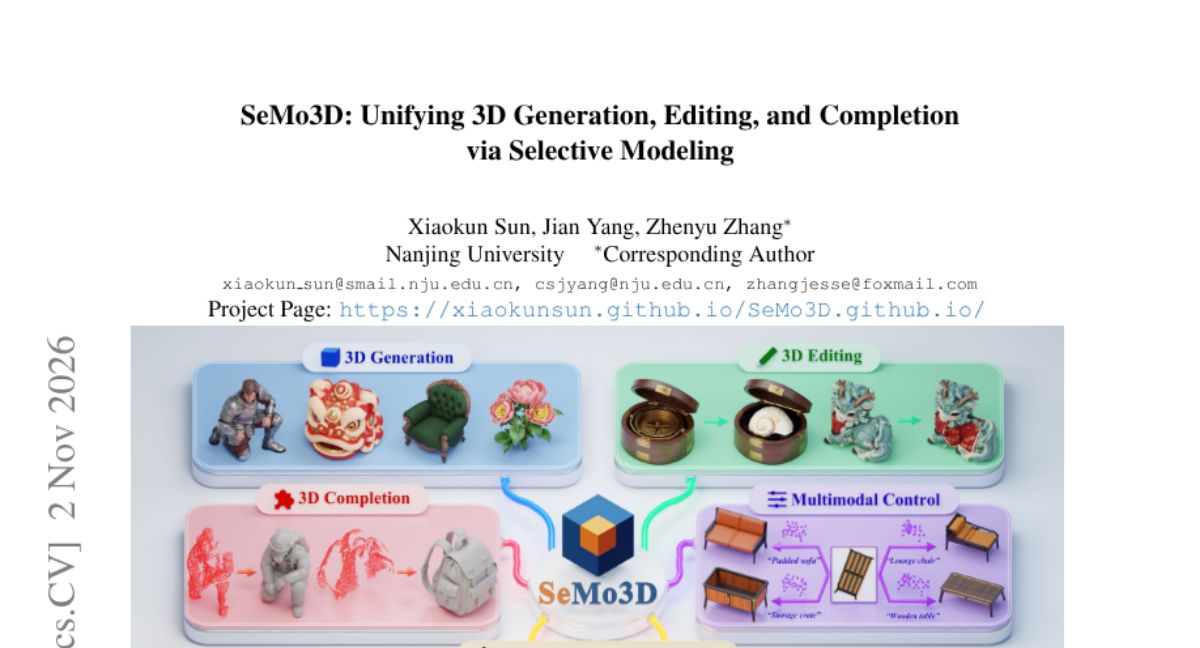
AI 연구
최근 유전체 파운데이션 모델이 DNA 서열 설계 및 편집에 활용되고 있으나, 기존 벤치마크는 실제 설계에 필요한 핵심 역량을 충분히 측정하지 못합니다. 이를 해결하기 위해 DNA 모델의 예측 및 설계 능력을 테스트하는 BEND 2.0 벤치마크를 제안합니다. 5개의 실험 데이터셋 기반 8개 태스크를 통해 모델 성능과 표현형(representation) 활용 방식의 영향을 분석했습니다. 연구 결과, 고정된 표현형에 선형 판독기를 적용하는 방식이 모델 자체 출력만큼 효과적이며, 기능적 사후 학습이 성능을 크게 향상시킴을 확인했습니다. 또한, 평균적인 효과 예측이 맥락 특이적 효과를 보장하지 않으며, 복합 변이 예측이 상호작용 예측을 의미하지 않는다는 점을 밝혀냈습니다.
AI 연구
최근 MoE 모델 학습 시 AdamW 대신 Muon 옵티마이저를 사용하는 사례가 늘고 있습니다. 연구진은 Muon이 MoE 레이어의 전문가 부하 균형을 맞추는 데 미치는 영향을 분석했습니다. 55M 및 108M 파라미터 규모의 모델을 통해 Muon이 첫 번째 MoE 레이어의 bias span(불균형 지표)을 크게 증가시킴을 확인했습니다. 이러한 현상은 Muon이 라우터를 학습할 때 더욱 두드러지며, 특정 전문가에게 부하가 쏠리는 현상을 유발합니다. 실험 결과, 라우터 학습 시 입력값의 방향성이 일치하며 특정 전문가가 과도하게 선택되는 문제가 발생했습니다. 최종적으로 학습률 조정이나 라우터 옵티마이저 분리 등을 통해 이 문제를 완화할 수 있음을 보여주었습니다.
AI 연구
초음파 생체 계측은 수동 캘리퍼 배치로 인해 검사자 간 편차가 발생하는 문제가 있습니다. 기존 방식은 작업별로 특화된 예측 헤드를 사용하거나 공간적 모호성을 충분히 모델링하지 못하는 한계가 있었습니다. 본 논문은 임상 질문을 통해 랜드마크를 탐지하는 비전-언어 모델인 Kev-Bio를 제안합니다. 이 모델은 언어 모델의 결정 표현을 사용하여 캘리퍼 엔드포인트 쿼리를 생성하고, 이를 공유된 밀집 특징과 매칭하여 공간 확률 지도를 생성합니다. 실험 결과, 제안 모델은 다양한 해부학적 뷰를 포함한 데이터셋에서 기존 베이스라인보다 우수한 성능을 기록했습니다.
AI 연구
RAG 환경에서 검색된 소스 간의 정보 충돌은 다양한 원인(논쟁, 오래된 정보, 허위 정보 등)으로 발생하며, 이를 정확히 분류하는 것은 생성 모델의 응답 품질에 결정적인 영향을 미칩니다. 기존 연구는 LLM을 통한 분류가 효과적임을 보여주었으나, 높은 비용과 지연 시간이라는 과제가 있었습니다. 본 연구는 텍스트 생성 대신 확률값을 반환하는 Decision Model이 이 분류 작업을 얼마나 효율적으로 수행할 수 있는지 분석했습니다. 실험 결과, 대부분의 Decision Model이 기존 LLM(Gemini 2.5 Flash)과 대등하거나 더 나은 성능을 보이면서도 비용은 4~39배, 지연 시간은 2.6~6.0배 낮았습니다. 또한, 신뢰도가 낮은 쿼리만 상위 모델로 전달하는 캐스케이드 방식이 비용 효율적인 대안이 될 수 있음을 확인했습니다.
AI 연구
에이전트 학습을 위한 롱 호라이즌(Long-horizon) 태스크 생성 방식이 주로 단순 턴 수나 LLM의 주관적 라벨링에 의존하고 있습니다. 연구 결과, 기존 방식은 작업의 난이도보다는 모델의 습관을 반영하거나 단순 작업량만 늘리는 경향이 있음을 발견했습니다. 이를 해결하기 위해 이전 단계의 출력을 확인해야만 다음 명령을 내릴 수 있는 '깊이(Depth)' 개념을 정의하고 이를 측정하는 방식을 제안합니다. 제안된 DEPTH 프레임워크는 실제 소프트웨어 환경에서 단계별로 작업을 생성하여 진정한 의존성을 확보합니다. 실험 결과, 제안된 105개 태스크는 기존 데이터셋보다 높은 깊이와 작업량을 가지며 모델의 성능을 효과적으로 변별합니다. 마지막으로 이 데이터로 파인튜닝된 모델이 기존 벤치마크 성능을 향상시킴을 입증했습니다.
AI 연구
MoE 모델의 학습 없는 전문가 프루닝은 어떤 전문가를 제거할지와 제거된 전문가를 어떻게 대체할지에 대한 두 가지 결정을 포함합니다. 기존 방식은 이 두 과정을 동시에 처리하여 각 요소의 개별 영향을 파악하기 어렵습니다. 본 연구는 마스크를 고정한 상태에서 다양한 대체 연산자와 라우팅 스케일 조정 방식이 성능에 미치는 영향을 비교 분석했습니다. 실험 결과, 생존한 전문가의 게이트 스케일을 조정하는 것이 성능에 가장 큰 영향을 미치는 핵심 요소임을 발견했습니다. 또한, 새로운 저차원 맵 방식인 'tilted novice'를 제안하여 기존 방식보다 우수한 성능을 입증했습니다. 마지막으로 평가 방식과 데이터셋에 따라 결론이 크게 달라질 수 있음을 지적하며 보고 가이드라인을 제안합니다.
AI 연구
최근 이미지 생성과 이해를 통합한 멀티모달 모델(UMM)이 등장했으나, 기존의 단일 경로 언러닝 방식은 두 기능 사이의 개념 삭제 효과를 동시에 보장하지 못합니다. 본 연구는 생성과 이해 양쪽 경로에서 타겟 개념을 모두 억제하면서도 다른 능력을 유지하는 '교차 경로 개념 언러닝'을 연구합니다. 이를 위해 30개의 타겟 개념과 60개의 인접 개념을 포함하는 진단 벤치마크인 UUBench를 도입했습니다. 실험 결과, 기존 방식들은 생성이나 이해 중 한쪽 경로에 치우치는 한계를 보였습니다. 이를 해결하기 위해 제안된 UniForget는 두 경로 모두에서 높은 삭제율을 달성하며 기존 베이스라인을 상회하는 성능을 보여주었습니다. 마지막으로 성능과 모델 능력 보존 사이의 트레이드오프 관계를 분석했습니다.
AI 연구
기존의 궤적 단위 GRPO 방식은 작업 전체를 매번 처음부터 실행해야 하므로 학습 효율이 낮고 피드백이 모호하다는 문제가 있다. 본 논문은 학습 위치(Where)와 롤아웃 범위(How far)를 동시에 최적화하는 2단계 적응형 학습 프레임워크를 제안한다. 먼저 전문가 궤적에서 재사용 가능한 중간 체크포인트를 구축하고, 액션 불일치(Action Disagreement)를 통해 학습이 필요한 피벗 지점을 선정한다. 1단계에서는 피벗 지점에서 1단계 RL을 수행하여 국소적 의사결정을 개선하고, 2단계에서는 작업 진행도에 따라 학습 범위를 점진적으로 확장한다. 실험 결과, 기존 GRPO 대비 환경 상호작용을 56-61% 줄이면서도 성능을 향상시켰다.
AI 연구
LLM이 수사 및 감시 업무에 투입될 가능성이 커지고 있으나, 실제 환경에서는 정답(Ground Truth)이 없어 모델의 정확도를 측정하기 어렵습니다. 이를 해결하기 위해 펜실베이니아주 앨런타운을 모델링한 도시 규모 시뮬레이션 엔진인 Kierston과 이를 활용한 벤치마크인 KierstonBench를 개발했습니다. 시뮬레이션은 12만 명 이상의 가상 거주자의 활동과 통신, 금융, 행정 기록을 생성하며, 모델은 제한된 인터페이스를 통해 분산된 기록을 연결하며 수사 과제를 수행합니다. 16개 모델을 평가한 결과, 대부분의 모델은 기록 기반 조사에 실패하거나 잘못된 식별을 수행했습니다. 일부 최첨단 모델만이 과제를 해결했으나, 여전히 기만적인 정보에 속거나 근거 없는 가정을 하는 한계를 보였습니다.
AI 연구
웹상에는 방대한 아랍어 오디오가 존재하지만, 정교하게 전사된 방언별 데이터는 매우 부족한 상황입니다. 연구진은 알제리, 이집트, 이라크, 사우디, 시리아 방언을 포함하는 39,000시간 규모의 GigaSpeech 3 코퍼스를 구축했습니다. 소량의 수동 전사 데이터를 기반으로 SSL(자기지도학습) 기반 라벨링 모델을 학습시킨 후, 이를 웹 오디오에 적용하는 방식으로 데이터를 확장했습니다. 데이터 선택 및 노이즈 스튜던트(Noisy-student) 정제 과정을 거쳐 최종 코퍼스를 완성했습니다. 실험 결과, 구축된 데이터로 학습된 모델은 기존 최고 수준의 외부 모델보다 낮은 WER(단어 오류율)을 달성하며 우수한 성능을 입증했습니다.
AI 연구
AlphaFold 3를 이용한 단백질 복합체 구조 예측은 MSA의 깊이와 체인 간 페어링 방식에 크게 의존하지만, 기존의 일률적인 방식은 타겟마다 최적의 성능을 보장하지 못합니다. 본 논문은 고정된 AF3 모델을 블랙박스 실험 도구로 활용하는 자율 에이전트를 제안합니다. 이 에이전트는 생물학적 가설을 세우고, 예측기 라벨 없이 신호만을 활용해 MSA를 재구성하며 서열 선택과 페어링 정책을 반복적으로 정교화합니다. 1,015개의 인터페이스 벤치마크 테스트 결과, 에이전트는 기본 파이프라인보다 적은 MSA를 사용하면서도 모든 벤치마크에서 더 높은 DockQ 점수를 달성했습니다. 특히 종 간 이종 복합체(inter-species heteromers)에서 가장 큰 성능 향상을 보였으며, 이는 MSA 설계가 타겟 의존적인 문제임을 입증합니다.
AI 연구
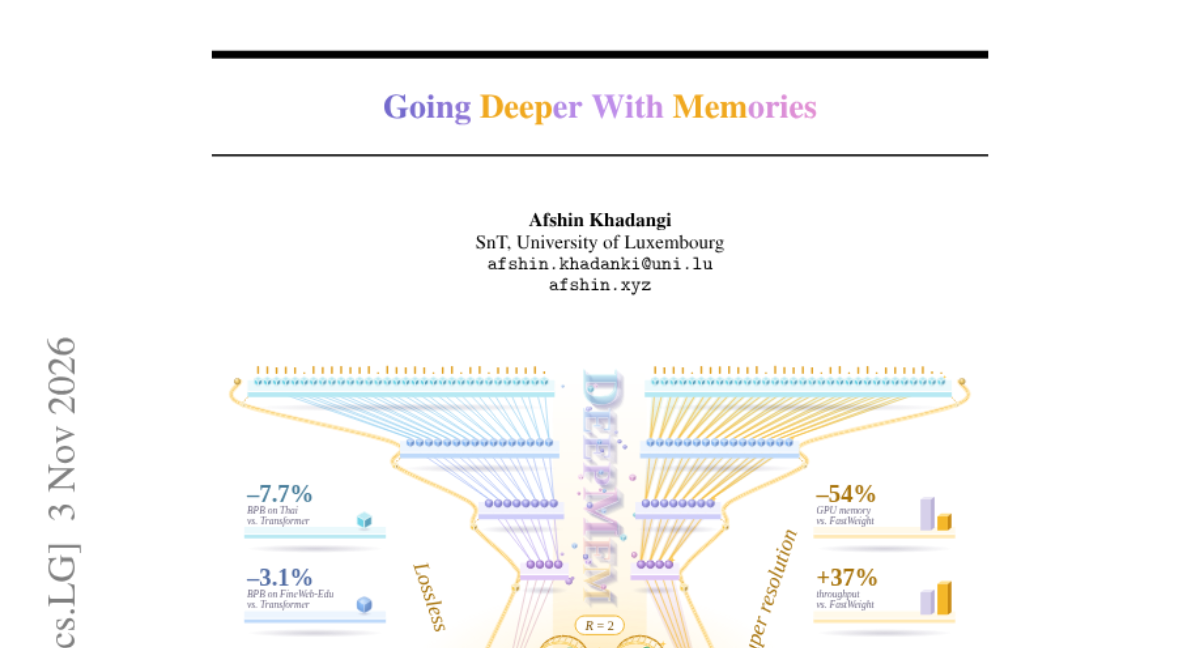
바이트 수준 언어 모델은 토크나이저 의존성을 없애지만, 모든 바이트를 풀 해상도로 처리하는 것은 연산 비용이 매우 높습니다. 이를 해결하기 위해 시맨틱 압축과 정밀한 바이트 보존을 분리하는 인버터블 서브밴드 변환 기반의 DeepMem 아키텍처를 도입합니다. 인코더에는 Fast weight memory 블록을, 병목 구간에는 반복적 공유 상태 계산을, 디코더에는 어텐션 기반 초해상도 복원 방식을 적용합니다. 실험 결과, FineWeb-Edu 및 FLORES 다국어 벤치마크에서 기존 바이트 수준 트랜스포머보다 우수한 성능을 기록했습니다. 또한, 병목 구간 정제 방식을 통해 풀 해상도 추론 대비 약 7,600배 적은 FLOPs로 경쟁력 있는 성능을 달성했습니다.
AI 연구
금융 도메인에서 NLP 기술은 널리 사용되고 있으나, 동적인 시장 환경에서 맥락적 정확성을 유지하는 데 어려움이 있었습니다. 이를 해결하기 위해 검색 기반 방식과 생성 모델을 결합한 RAG(Retrieval-Augmented Generation) 시스템을 제안합니다. 본 연구는 주식 시장 정보와 관련된 응답 생성을 위해 검색과 생성 접근 방식을 통합하는 시스템을 설계했습니다. ROUGE 지표를 통해 생성된 텍스트의 유사도를 평가하고 응답 지연 시간(Latency)을 측정했습니다. 실험 결과, 높은 ROUGE 점수와 1.16초의 평균 응답 시간을 기록하며 정확성과 신속성을 동시에 입증했습니다.
AI 연구
Linux와 RTOS가 결합된 이기종 임베디드 보드에서는 타이밍 이슈 발생 시 태스크를 도메인 간 이동시키는 전략이 제안됩니다. 본 논문은 QFabric 프로토타입을 통해 태스크 배치를 소프트 실시간 계약 위반에 따른 '가드된 복구(guarded recovery)' 과정으로 정의합니다. 연구진은 양쪽 도메인에 컴파일된 태스크를 모니터링하고, 정적/용량 검증 및 휴지기(quiescent) 경계에서의 전환, 그리고 검증 기간(probation)을 거치는 메커니즘을 제안했습니다. 실험 결과, Linux의 간섭이 MCU 경로의 지연시간을 크게 증폭시킴을 확인하였으며, 잘못된 이동을 방지하는 가드 메커니즘의 중요성을 입증했습니다. 결론적으로 이기종 보드에서의 마이그레이션은 Linux 간섭으로부터 태스크를 완전히 격리할 수 없음을 보여줍니다.
30건
이날 공개된 제품과 도구


6건
새 모델과 주요 평가 결과
HF Model Trending
ccore에서 공개한 Qwen3.5-4B-3D-Coder 모델이 높은 다운로드 수를 기록하며 주목받고 있습니다. 약 4.5B 파라미터를 가진 이 모델은 최근 사용자들 사이에서 활발하게 활용되고 있습니다.
HF Model Trending
LiquidAI에서 출시한 1.7B 규모의 text-generation 모델인 LFM3-1.7B가 Hugging Face에서 주목받고 있습니다. 약 5.5만 회의 다운로드와 1,400개 이상의 좋아요를 기록하며 높은 관심을 받고 있습니다.
HF Model Trending
Mistral AI에서 공개한 Mistral-Large-4-1T-A52B 모델이 Hugging Face에서 주목받고 있습니다. 이 모델은 이미지와 텍스트를 동시에 처리하는 image-text-to-text 파이프라인을 지원합니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.