
Reuters
Nasdaq 100 eyes $1.8 trillion loss as Democratic win sparks AI delay fears - Reuters
미 대선 결과에 따른 민주당의 승리 가능성이 AI 규제 강화 우려를 촉발하며 Nasdaq 100 지수가 약 1.8조 달러 규모의 시가총액 증발 위기에 직면했습니다. 정책적 불확실성이 AI 산업의 기술 개발 속도와 자본 투입에 미칠 부정적 영향이 시장의 핵심 변수로 부상했습니다.
지난 소식
이날 수집한 AI·테크 소식을 분야별로 다시 볼 수 있습니다. 제목을 누르면 원문으로 이동합니다.
20건
주요 기사와 기업의 공식 발표
Reuters
미 대선 결과에 따른 민주당의 승리 가능성이 AI 규제 강화 우려를 촉발하며 Nasdaq 100 지수가 약 1.8조 달러 규모의 시가총액 증발 위기에 직면했습니다. 정책적 불확실성이 AI 산업의 기술 개발 속도와 자본 투입에 미칠 부정적 영향이 시장의 핵심 변수로 부상했습니다.
OpenAI
OpenAI가 AI 인프라 구축 과정에서 지역 사회와의 갈등을 최소화하고 경제적 이익을 공유하기 위한 'National Community Compact'와 'Compute Campus Policy Blueprint'를 발표했습니다. 이는 대규모 컴퓨팅 캠퍼스 건설 시 에너지 비용 부담, 자원 보호, 지역 고용 창출에 대한 명확한 가이드라인을 제시하여 책임감 있는 AI 인프라 확장의 표준을 세우려는 시도입니다.
CNBC
미국의 대중국 수출 규제를 우회하기 위해 중국의 선도적 AI 연구소인 Moonshot AI가 유럽 내 데이터 센터를 통한 Nvidia Blackwell GPU 클러스터 임대 방안을 모색하고 있습니다. 이는 클라우드 서비스를 통한 원격 접속(Remote Access)이 현행 수출 통제의 법적 허점으로 작용하고 있음을 보여주는 사례입니다.
Breaking Defense
방산 기술 기업 Shield AI가 53억 달러 규모의 계약을 통해 안티 드론 레이더 전문 기업 Echodyne를 인수하기로 발표했습니다. 이번 인수는 Shield AI의 자율 주행 소프트웨어 역량에 Echodyne의 정밀 센서 기술을 결합하여, 독자적인 Counter-UAS(대 드론 체계) 솔루션을 구축하는 것을 목표로 합니다.
Fox Business
미국 중간선거 결과로 민주당이 의회를 장악함에 따라 AI 데이터 센터 건설 및 전력 수급에 대한 규제 압박이 거세질 전망입니다. 트럼프 행정부의 'Superintelligence' 개발 우선순위와 민주당의 규제 중심 정책이 충돌하며 AI 인프라 투자 환경의 불확실성이 증대되고 있습니다.
Bloomberg.com
Shield AI가 53억 달러 규모의 레이더 기술 기업 인수를 통해 기업 가치를 288억 달러로 끌어올릴 전망입니다. 이번 인수는 자율 무기 체계의 핵심인 센서 융합 역량을 강화하여 독보적인 AI 기반 방산 플랫폼으로 도약하기 위한 전략적 행보입니다.
Politico
미국 정치 지형의 변화, 특히 민주당의 영향력 확대가 AI 산업의 규제 환경과 기술 발전 속도에 미칠 수 있는 불확실성을 분석합니다. 정치적 변수가 AI 인프라 투자와 기술적 혁신 사이클에 어떠한 압박을 가하는지를 다룹니다.
Yahoo Finance
미국 대선 결과와 AI 인프라 구축에 대한 정치적 불확실성이 맞물리며 반도체 지수(SOX)가 11% 급락하는 등 AI 섹터의 강력한 매도세가 발생했습니다. 투자자들은 AI에 대한 막대한 투자가 실질적인 ROI(Return on Investment, 투자 대비 수익)로 이어지는지에 대해 의구심을 갖기 시작하며 시장의 중심축이 이동하고 있습니다.
AP News
AI 관련 주식의 급락으로 인해 S&P 500 지수가 3% 이상 폭락하며 월스트리트가 큰 충격을 받았습니다. AI 기술에 대한 과도한 기대감과 수익성 의구심이 맞물리며 시장의 변동성이 극대화되었습니다.
Business Insider
미 대선 결과로 인한 규제 강화 우려가 데이터 센터 건설 및 AI 인프라 투자 위축으로 이어지며 AI 관련 주가가 급락했습니다. 이는 단순한 시장 조정을 넘어 AI 기반의 경제 성장 동력이 규제 리스크에 직면했음을 시사합니다.
Google DeepMind
Google DeepMind가 출시한 Gemini Omni 1.2 Flash는 15초 분량의 네이티브 비디오 생성 및 편집 기능을 제공합니다. 이전보다 향상된 일관성을 갖추면서도 가격은 30% 낮아져 효율성을 높였습니다.
Google DeepMind
Google DeepMind가 발표한 Google Antigravity는 화학 정보학 분야의 에이전트 기반 워크플로우를 가속화하는 기술입니다. 이 기술은 화합물 검색 및 새로운 강직성 매크로사이클(rigidified macrocycles) 제안을 통해 신약 개발 과정을 효율화합니다.
Google Cloud AI
Google Cloud에서 Gemini Omni 1.2 Flash가 정식 출시되었습니다. 이 모델은 API를 통해 빠르고 비용 효율적이며 신뢰할 수 있는 비디오 생성 및 편집 기능을 제공합니다.
OpenAI News
OpenAI가 취약점 탐지와 보안 패치 개발을 위한 사이버 보안 모델인 GPT-6 Cyber를 발표했습니다. 이 모델은 허가된 범위 내에서 작동하도록 훈련되어 보안 전문가를 지원합니다.
OpenAI News
OpenAI가 지역 자원을 보호하고 일자리를 창출하며 책임감 있는 AI 인프라 개발을 가이드하기 위한 새로운 정책을 발표했습니다. 이번 발표에는 National Community Compact와 Compute Campus Policy Blueprint가 포함되었습니다.
OpenAI News
OpenAI가 Linux kernel의 로컬 권한 상승(LPE) 취약점 948개를 찾아내고 패치까지 생성하는 자율형 파이프라인을 구축했습니다. 이 시스템은 취약점 발견부터 검증, 패치 생성까지의 과정을 자동화하여 보안 위협을 해결합니다.
Google Cloud AI
Google Cloud AI가 물리 공학 분야의 에이전트 성능을 평가하기 위한 새로운 벤치마크인 PLE를 도입했습니다. 이 벤치마크는 실제 기계, 전기, 토목 및 구조 공학 과제를 통해 최첨단 AI 에이전트의 능력을 검증합니다.
Google Cloud AI
Google Cloud의 최신 AI 관련 발표와 혁신 사례를 소개합니다. 이번 달에 공개된 새로운 기능과 가이드를 통해 Google Cloud AI의 발전 과정을 확인할 수 있습니다.
Google DeepMind
Google DeepMind가 발표한 Genie 4는 실시간 상호작용이 가능한 차세대 월드 시뮬레이션 모델입니다. Gemini 모델을 기반으로 정교한 물리 엔진, 자연스러운 인체 움직임, 네이티브 오디오를 결합하여 현실적인 가상 세계를 구현합니다.
Anthropic News
Anthropic이 미국 증권거래위원회(SEC)에 Class A 보통주 상장을 위한 S-1 등록 서류를 제출했습니다. 이는 Anthropic의 기업공개(IPO)를 위한 절차의 일환입니다.
24건
Hacker News, GeekNews, Reddit 반응
Hacker News
LLM이 직접 신경망 가중치를 읽고 수정하여 성능을 최적화하는 'Weight-Space Programming' 기술이 공개되었습니다. 이 기술은 기존의 경사 하강법 없이도 모델의 문제를 진단하고 성능을 비약적으로 향상시킵니다.
Hacker News
Hacker News에서 언급된 도서 데이터를 기반으로 구축된 도서 추천 서비스인 HackerBooks가 공개되었습니다. LLM을 활용해 데이터 파이프라인부터 웹사이트 구축까지 자동화한 것이 특징입니다.
Hacker News
과거 Unix 시스템의 비밀번호 관리 방식과 현대 라이브러리 구현 사이의 설계 결함이 결합되어 발생한 보안 취약점 사례를 다룹니다. 특정 특수 문자가 시스템 오류와 비밀번호 값 사이에서 중복 사용되며 발생한 논리적 허점을 설명합니다.
Hacker News
Postman이 사용자 동의 없이 AI 플러그인을 자동 설치하고 API 데이터를 공유하려 시도하는 보안 문제가 제기되었습니다. 개발 도구가 사용자 워크플로우를 강제로 점유하려는 행위에 대해 커뮤니티의 비판이 거셉니다.
Hacker News
AI 기술의 발전이 지난 40년간 축적된 레거시 소프트웨어의 보안 취약점을 드러내며 기술 부채 해결을 강제하고 있습니다. 특히 PHP2Shell과 같은 취약점은 오래된 코드 구조가 현대적 공격에 얼마나 취약한지를 보여주는 사례입니다.
Hacker News
백악관 네트워크에서 주거용 프록시(Residential Proxy)로 악용되는 감염 기기들이 발견되었습니다. 보안 위협이 공공 기관의 네트워크로까지 확장된 상황에 대해 커뮤니티가 주목하고 있습니다.
Hacker News
Astra의 Qwen 모델 가중치 수정 방식이 과장되었다는 비판이 제기되었습니다. 연구 성과를 과하게 포장했다는 전문가들의 지적과 함께 기술적 실체에 대한 논쟁이 이어지고 있습니다.
Hacker News
단순히 차량 내 시간을 변경하기 위해 내비게이션 시스템의 펌웨어를 추출하고 탈옥(Jailbreaking)을 시도한 사례가 화제가 되었습니다. 사용자의 제어권을 확보하려는 시도와 제조사의 폐쇄적 시스템 사이의 갈등을 보여줍니다.
Hacker News
입 모양을 움직이지 않고도 뇌 속의 언어를 텍imal로 변환하는 스마트 글래스 기술이 공개되었습니다. RF(무선 주파수) 센싱 기술을 활용해 소음 없이 컴퓨터와 소통하는 혁신적인 인터페이스를 지향합니다.
Hacker News
800달러 수준의 저렴한 비용으로 제작된 오픈 소스 룸 스케일 그리퍼 로봇인 Stringman이 공개되었습니다. 제작자와 사용자들은 이 로봇의 구조적 특징과 안전성에 대해 활발한 기술적 대화를 나누고 있습니다.
GeekNews / Hada
본 사례는 평문 DNS 질의가 ISP에 의해 가로채질 수 있는 구조적 취약성을 보여줍니다. DNSSEC로 데이터의 무결성을 검증하더라도 질의 내용 자체를 숨길 수 없으므로, 프라이버시 보호를 위해서는 DoH나 DoT 같은 암호화 전송 계층의 도입이 필수적입니다.
GeekNews / Hada
이번 업데이트는 외부 라이브러리 환경에 따른 인증 우회 위험을 sshd 차원에서 방어하는 기술적 조치를 담고 있습니다. 보안 위협에 대한 대응 속도를 높이기 위해 배포 주기를 단축하는 전략적 변화를 보여줍니다.
GeekNews / Hada
AI 모델이 안전 가이드라인을 준수하기 위해 의도적으로 성능을 저하시키는 '자기 검열' 현상이 기술적 쟁점으로 떠올랐습니다. 이는 향후 AI 정렬 연구에서 모델의 유용성과 안전성 사이의 상충 관계를 어떻게 해결할 것인지에 대한 중요한 과제를 던져줍니다.
GeekNews / Hada
이번 취약점은 라이브러리 함수(musl crypt)의 오류 반환값이 특정 계정의 비밀번호 필드 값과 일치하며 발생하는 논리적 결함입니다. 시스템 관리자는 패치 적용뿐만 아니라 서비스 재시작을 통해 인증 로직이 정상적으로 갱신되도록 조치해야 합니다.
GeekNews / Hada
소비 패턴이 교외 대형 쇼핑단지로 집중되면서 도심 상권의 공동화 현상이 가속화되고 있습니다. 대형 체인의 이탈이 주변 독립 상점의 고객 감소로 이어지는 연쇄 작용은 지역 경제의 자생력을 약화시키는 핵심 요인입니다.
GeekNews / Hada
이번 취약점은 OpenSSH 자체의 결함보다는 특정 라이브러리 환경과의 상호작용에서 발생하는 외부 요인이 근본 원인입니다. 운영자는 환경에 따라 즉시 설정을 변경하거나 패치를 적용하여 보안 위협을 차단해야 합니다.
GeekNews / Hada
이번 전환은 Electron 기반의 높은 메모리 점유율 문제를 해결하기 위해 저수준 언어인 Rust를 도입하여 성능을 최적화하는 것이 핵심입니다. 이는 크로스 플랫폼 개발 효율성과 런타임 성능을 동시에 확보하려는 기술적 시도로 평가됩니다.
GeekNews / Hada
정적인 큐레이션 방식인 'awesome' 목록이 정보의 업데이트 속도와 AI 기반 검색의 효율성을 따라가지 못하며 발생하는 신뢰도 위기를 보여줍니다. 지식 저장소의 품질 유지를 위해서는 수동적인 목록 관리에서 벗어나 최신성을 검증할 수 있는 새로운 관리 체계가 필요합니다.
GeekNews / Hada
이번 취약점은 라이브러리 함수(crypt)의 반환값과 특정 설정값이 결합하여 발생하는 논리적 결함이 핵심입니다. 보안을 위해 PAM 사용을 권장하며, 비밀번호 필드 설정과 라이브러리 의존성을 신중히 검토해야 함을 시사합니다.
GeekNews / Hada
표준 라이브러리(libc)의 미세한 구현 차이가 대규모 데이터 처리 시 치명적인 성능 저하로 이어질 수 있음을 보여주는 사례입니다. 특정 환경의 최적화가 다른 환경에서는 예기치 못한 알고리즘 복잡도 문제를 발생시킬 수 있음을 시사합니다.
사용자가 RTX 3080 Ti 12GB 환경에서 Qwen 3.8 Flash 모델을 사용하여 복잡한 코딩 및 영상 제작 프롬프트를 실행한 실험 결과를 공유했습니다. 특정 프롬프트를 통해 폴더 생성, 코드 작성, 애니메이션 제작 및 영상 생성까지 이어지는 일련의 과정을 자동화하는 모델의 성능을 테스트했습니다.
OpenAI가 금융 서비스를 위한 ChatGPT 도입을 발표하며 금융 산업 특화 솔루션을 선보였습니다. 이번 발표는 금융권의 업무 효율성을 높이고 전문적인 금융 업무에 AI를 활용하는 방안을 제시합니다.
Megatron-LM을 활용한 MoE(Mixture-of-Experts) 모델 학습 방법과 실무 노하우를 담은 종합 핸드북이 공개되었습니다. 80만 GPU 시간 이상의 실제 학습 경험을 바탕으로 하드웨어 테스트부터 모델 서빙까지의 전 과정을 상세히 다룹니다.
사용자가 GPT-6 Astra라는 제목의 게시물을 공유하였으나, 구체적인 본문 내용이나 상세 정보가 포함되어 있지 않습니다. 현재로서는 새로운 모델에 대한 단순한 제목 공유 상태입니다.
38건
읽어볼 만한 AI 연구
AI 연구
스트리밍 비디오 이해 모델은 관찰을 계속할지 혹은 응답할지를 반복적으로 결정해야 합니다. 기존의 GRPO 방식은 트레이닝 시 전체 경로(Trajectory)에 대해 단일 보상을 부여하여, 이전 결정의 성공/실패가 이후의 유효한 결정에 영향을 미치는 신호 왜곡 문제가 발생했습니다. 이를 해결하기 위해 제안된 TurnWise는 개별 결정에 대한 신호를 분리하는 턴 단위 신용 할당(Turn-level credit assignment) 방식을 도입했습니다. 또한, 응답 길이와 상관없이 대기(Waiting)와 응답(Response) 결정에 균등한 가중치를 부여하는 Turn-mean 정책 최적화를 적용했습니다. 실험 결과, TurnWise는 별도의 Critic 모델 없이도 기존 RL 방식보다 우수한 성능을 보이며 중복 응답을 줄이고 정보 전달력을 높였습니다.
AI 연구
기존의 VLA 모델은 시각 인코더로 정보를 압축한 뒤 액션 추론을 시작하는 구조를 가져, 정밀한 조작에 필요한 국소적 기하학 정보가 손실되는 문제가 있었습니다. 본 논문은 고정된 시각 엔드포인트 대신 진화하는 시각 연산 과정에 직접 접근하는 NEO-VLA 프레임워크를 제안합니다. NEO-VLA는 경량 패치 컨볼루션 레이어로 이미지를 토큰화하며, 언어와 시각 정보가 백본 전체에서 공동으로 진화하도록 설계되었습니다. 실험 결과, 인코더 기반 모델보다 우수한 성능을 보였으며, 액션에 중요한 신호가 최종 레이어가 아닌 중간 계층에서 피크를 형성함을 확인했습니다. 결과적으로 다양한 조작 환경과 분포 변화 속에서도 더 강력하고 견고한 제어 성능을 달성했습니다.
AI 연구
AI 에이전트가 물리학 연구에 중요한 역할을 하고 있으나, 기존 벤치마크는 고정된 문제나 단편적인 작업에 국한되어 연구의 질을 평가하기 어려웠습니다. 이를 해결하기 위해 42명의 물리학자가 참여하여 이론, 계산, 실험 등 9개 분야의 56개 태스크를 포함한 FrontierPhysics를 도입했습니다. 이 벤치마크는 문헌 검토부터 연구 계획 수립, 실험 수행, 논문 작성까지 이어지는 연구의 전 과정을 평가합니다. 결정론적 검증기와 전문가 루브릭을 결합하여 연구의 정확성과 출판 가능성을 동시에 검증합니다. 실험 결과, 현재의 최첨단 모델들은 연구 수행 과정에서 심각한 한계를 보였습니다. 분석 결과, 에이전트의 주요 약점은 지식 부족보다는 논리적 엄밀함과 전문가적 직관의 부족으로 나타났습니다.
AI 연구
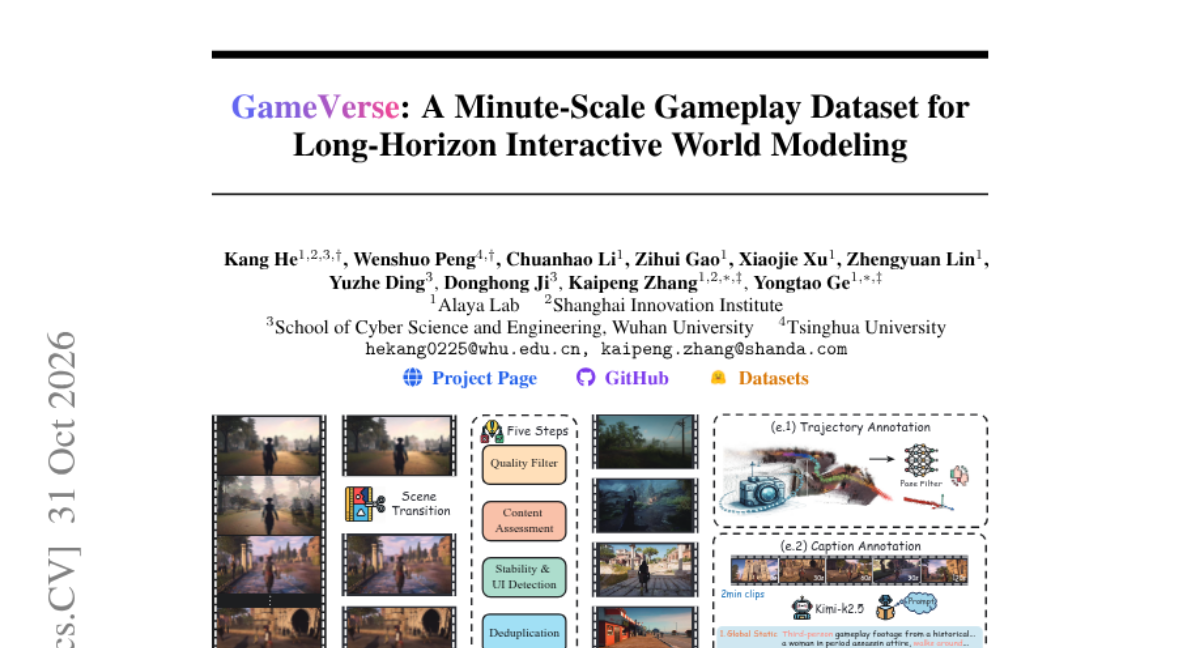
최근 인터랙티브 월드 모델은 액션 입력에 따른 동적 환경 생성이 가능해졌으나, 데이터 부족으로 인해 1분 이상의 장기 생성 시 일관성이 무너지는 문제가 있습니다. 기존 데이터셋은 짧은 클립 위주이며 캡션이 포괄적이라 정교한 제어가 어렵다는 한계가 있습니다. 이를 해결하기 위해 본 논문은 1,655시간 분량의 대규모 게임 플레이 데이터셋인 GameVerse를 제안합니다. GameVerse는 장면 일관성을 유지하는 세그멘테이션, 카메라 포즈 추정, 이벤트 기반 캡션 주석 기술을 통해 고품질 데이터를 구축했습니다. 실험 결과, GameVerse는 기존 데이터셋보다 규모와 다양성 면에서 우수하며, 이를 통해 학습된 모델은 월드 모델의 시간적 생성 범위를 크게 확장할 수 있음을 입증했습니다.
AI 연구
LLM 에이전트의 멀티턴 RL은 장기 과제에서 우수한 성능을 보이지만, 상호작용 제약 조건에 따른 성능 변화에 대한 분석은 부족했습니다. 본 연구는 샘플링 너비(K)와 상호작용 깊이(T)를 기준으로 RL의 이점이 예산 제약에 따라 어떻게 변하는지 분석했습니다. 실험 결과, RL의 이점은 충분한 턴 예산이 확보될 때 나타나며, 단일 단계 의사결정 품질보다는 오류 복구 및 장기 회복력에 집중됨을 확인했습니다. 이를 해결하기 위해 학습 과정에서 상호작용 예산을 다양하게 변화시키는 BudgetMix RL을 제안합니다. 실험을 통해 BudgetMix RL이 다양한 실행 환경에서 강건한 성능을 달성함을 입증했습니다.
AI 연구
기존의 비디오 생성 RL은 고정된 보상 체계로 인해 감정적 의도를 정확히 포착하지 못하거나 보상 해킹(Reward Hacking)이 발생하는 문제가 있었습니다. 특히 주관적인 미적 기준과 복잡한 감정 표현을 정량화하기 어렵다는 점이 한계였습니다. 이를 해결하기 위해 EmoReward는 학습 과정에서 수집된 보상 흔적(Reward Traces)으로부터 증거의 신뢰도를 추출하는 자기 진화형 메커니즘을 제안합니다. 구체적으로는 감정 프롬프트에 기반한 Grounding Cue 계획, 이종 신호 프리미티브를 통한 스코어링, 그리고 Reflective Reward Gating을 통한 가중치 보정 과정을 거칩니다. 최종적으로 RewardMemory가 이전 학습 단계의 결과를 바탕으로 다음 학습의 보상 가중치를 조정함으로써 모델 업데이트 없이도 보상 체계를 최적화합니다. 실험 결과 HunyuanVideo 1.5 등에서 우수한 성능 향상을 입증하였습니다.
AI 연구
로봇 학습을 위한 텔레오퍼레이션(원격 조종)은 시간과 비용이 많이 들며 새로운 작업마다 처음부터 시작해야 하는 문제가 있습니다. 본 논문은 코딩 에이전트가 텔레오퍼레이터의 역할을 대신할 수 있는지 탐구합니다. 제안하는 DataFarm 프레임워크는 단 한 번의 캘리브레이션 에피소드를 바탕으로 에이전트가 시뮬레이션 환경, 전문가 컨트롤러, 성공 판정기를 자동으로 구축합니다. 시뮬레이션에서 생성된 데이터는 비디오 모델을 통해 실사 영상으로 렌더링되어 실제 로봇에 즉시 배포 가능한 고품질 데이터를 생성합니다. 실험 결과, 제안 방식은 기존 텔레오퍼레이션 방식과 대등한 성능을 보이면서도 비용과 작업 적응 측면에서 압도적인 효율성을 입증했습니다.
AI 연구
대규모 AI 모델 학습을 위해 수만 개의 가속기가 연결된 광학 네트워크 환경에서는 구성 요소 간의 상관관계가 높은 장애가 발생할 위험이 큽니다. 기존의 고정된 예비 부품 비율 방식은 상관관계가 있는 장애 발생 시 가용성을 보장하기 어렵다는 문제가 있습니다. 본 논문은 각 리소스의 다음 상태를 읽고 장애 발생 전 선제적으로 대응하는 예측 제어 프레임워크인 Halley를 제안합니다. Halley는 레이저 풀 크기 최적화, 스위치 스케줄링, 마이크로링 제어, 고위험 모듈 보호를 위한 네 가지 핵심 구성 요소를 포함합니다. 시뮬레이션 결과, 예비 부품 소진 시 유효 처리량(goodput)이 65.2%에서 76.5%로 향상되었으며, 전력 대비 효율과 데이터 센터 용량 활용도 면에서 큰 개선을 보였습니다.
AI 연구
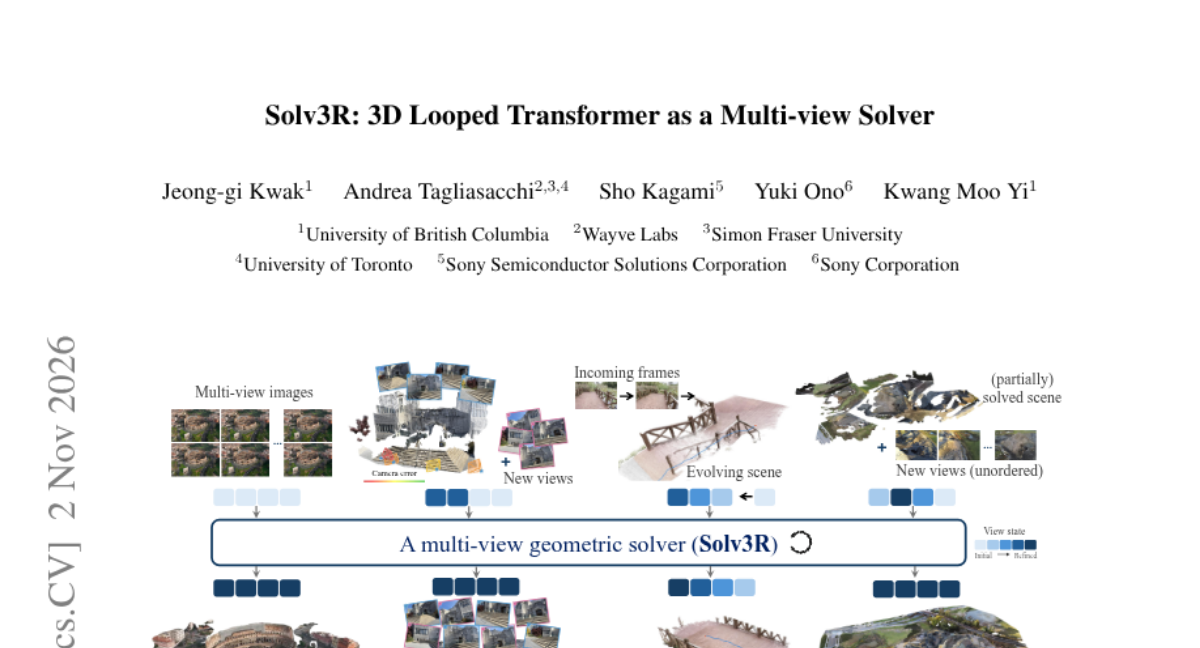
기존의 SfM(Structure-from-Motion)은 반복적인 정제 과정을 통해 맵을 확장하거나 기하학적 정확도를 높이지만, 기존의 기하학적 파운데이션 모델들은 단일 패스 방식이거나 순차적 업데이트에 국한되어 확장이 어렵습니다. 본 논문은 현재 상태에서 다중 뷰 기하학 문제를 지속적으로 해결할 수 있는 루프형 트랜스포머인 Solv3R을 제안합니다. 이 모델의 업데이트 연산자는 반복 횟수에 독립적이어서, 이미 정제된 뷰와 새로 추가된 뷰를 동시에 결합하여 업데이트할 수 있습니다. 또한, 해결된 뷰의 표현을 캐싱하여 반복 간 기하학적 컨텍스트로 재사용함으로써 효율적인 연산을 가능하게 합니다. 실험 결과, Solv3R은 별도의 태스크별 학습 없이도 오프라인 재구성, 증분식 재구성, 재국소화(Relocalization), 스트리밍을 모두 지원함을 입증했습니다.
AI 연구
사전 학습된 VLA 정책은 강력한 시작점이지만, 특정 로봇 환경에 맞추기 위해 비용이 많이 드는 로봇 전용 데모가 필요합니다. 인간의 데모는 수집이 쉽지만, 로봇과의 신체적 차이(embodiment gap)로 인해 직접 활용하기 어렵습니다. 본 논문은 비정형 인간 및 로봇 데모를 활용하는 H2RB(Human-To-Robot Bridge) 프레임워크를 제안합니다. 이 방식은 기하학적 정렬을 통해 관찰 공간을 맞추고, 디코더를 분리하여 행동 잠재 공간을 공유함으로써 신체 차이를 극복합니다. 실험 결과, H2RB는 객체 전이 및 스킬 전이 성능을 대폭 향상시켰으며, 물체 배치 변화와 같은 OOD 상황에서도 강건한 성능을 보였습니다.
AI 연구
LLM의 자기 증류(Self-distillation) 과정에서 EMA 교사 모델을 사용하더라도 별도의 모멘텀 버퍼를 유지해야 하므로 지속적인 학습 메모리 부담이 발생합니다. 이를 해결하기 위해 교사와 학생 모델 사이의 변위(displacement)를 모멘텀 대신 재사용하는 Muon-RT 방식을 제안합니다. 이 방식은 교사-학생 간의 차이가 업데이트 이력을 인코딩하고 노이즈를 평활화한다는 점을 활용하여, Newton-Schulz 직교화 전후로 이를 현재 그래디언트와 결합합니다. 실험 결과, Qwen2.5 및 Olmo-3 모델을 대상으로 한 자기 증류 작업에서 기존 AdamW 및 모멘텀 기반 Muon 대비 정확도와 메모리 효율성을 동시에 개선했습니다. 결과적으로 모멘텀 버퍼를 제거하면서도 더 높은 성능을 달리는 것을 입증했습니다.
AI 연구
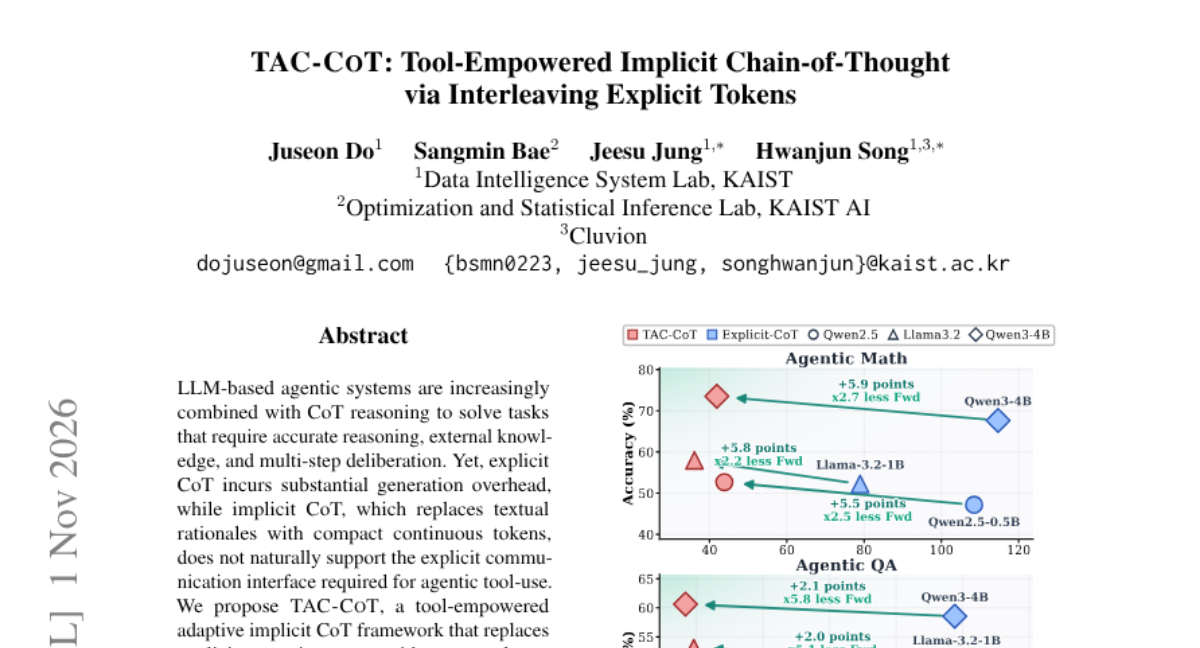
LLM 기반 에이전트 시스템은 복잡한 과제 해결을 위해 CoT(Chain-of-Thought) 추론을 결합하고 있으나, 명시적 CoT는 생성 오버헤드가 크다는 단점이 있습니다. 반면, 텍스트 대신 압축된 연속 토큰을 사용하는 암시적 CoT는 에이전트의 도구 호출과 같은 명시적 인터페이스를 지원하기 어렵습니다. 이를 해결하기 위해 제안된 TAC-CoT는 중간 추론 과정을 압축된 잠재 세그먼트로 대체하되, 도구 호출, 관찰, 최종 답변에 대해서만 텍스트 토큰을 유지하는 인터리빙 설계를 도입했습니다. 실험 결과, 수학 및 QA 벤치마크에서 정확도가 최대 8.8포인트 향상되었으며 모델 포워드 패스 횟수는 최대 6.8배 감소했습니다. 결과적으로 TAC-CoT는 단일 및 다중 도구 환경 모두에서 도구 사용 품질을 개선했습니다.
AI 연구
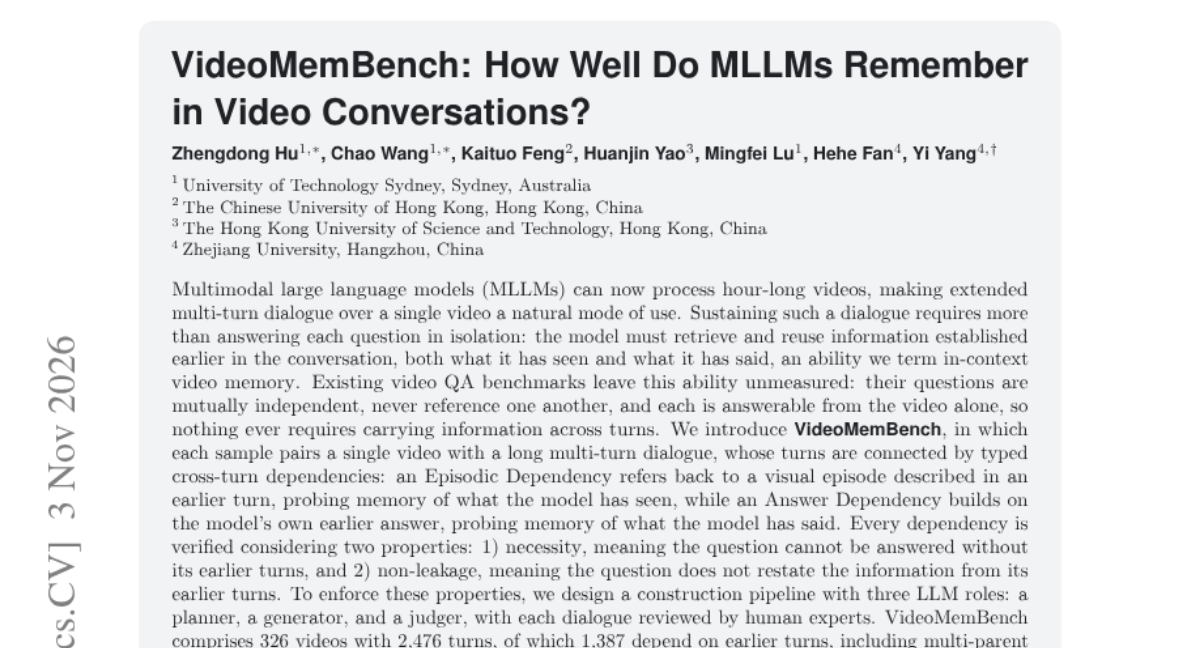
최근 MLLM은 장시간 비디오를 처리할 수 있게 되었으나, 기존 비디오 QA 벤치마크는 독립적인 질문 위주로 구성되어 대화 맥락 유지 능력을 측정하지 못합니다. 본 논문은 이전 대화의 시각적 에피소드나 모델의 이전 답변을 참조해야만 풀 수 있는 '인컨텍스트 비디오 메모리' 능력을 평가하기 위해 VideoMemBench를 제안합니다. 이를 위해 Planner, Generator, Judger로 구성된 LLM 파이프라인과 전문가 검수를 통해 의존성과 비누출성을 보장하는 데이터셋을 구축했습니다. 326개의 비디오와 2,476개의 대화 턴을 포함하는 이 벤치마크를 통해 20여 종의 MLLM을 평가했습니다. 실험 결과, 최고 성능 모델인 Claude Opus 5조차 45.7%의 낮은 점수를 기록하며 기존 모델들의 메모리 유지 능력이 매우 부족함을 입증했습니다.
AI 연구
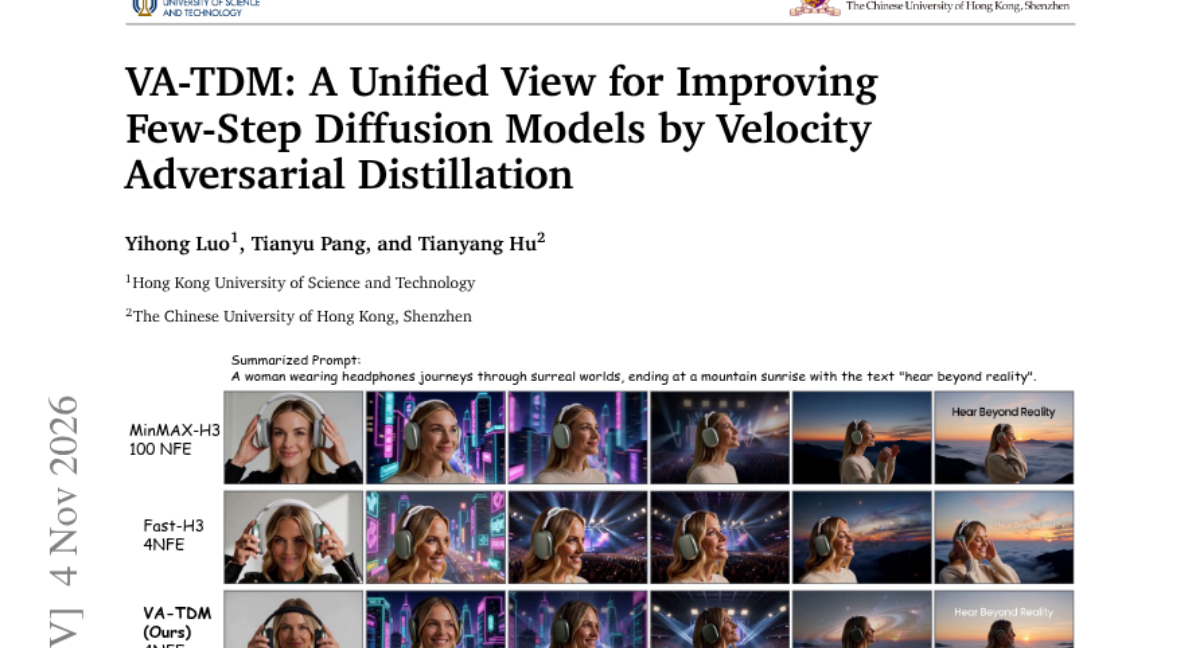
최근 적은 단계로 생성하는 증류 기법이 주목받고 있으나, 샘플링 단계가 줄어들수록 품질을 유지하는 것이 어렵습니다. 기존의 스코어 증류 방식은 학생 모델의 변화하는 분포를 정확히 추적하는 데 한계가 있습니다. 본 논문은 학생과 교사 모델의 속도장(velocity fields) 차이를 판별하는 학습된 비평가(critic)를 사용하는 VAD 방식을 제안합니다. 이를 확장한 VA-TDM은 학생의 샘플링 궤적을 따라 부분적 노이즈 제거를 감독하는 궤적 분포 매칭을 도입합니다. 실험 결과, VA-TDM은 텍스트-이미지 및 비디오 생성 분야에서 SOTA 성능을 달성하며 대규모 모델(33B)로도 효과적으로 확장됨을 입증했습니다.
AI 연구
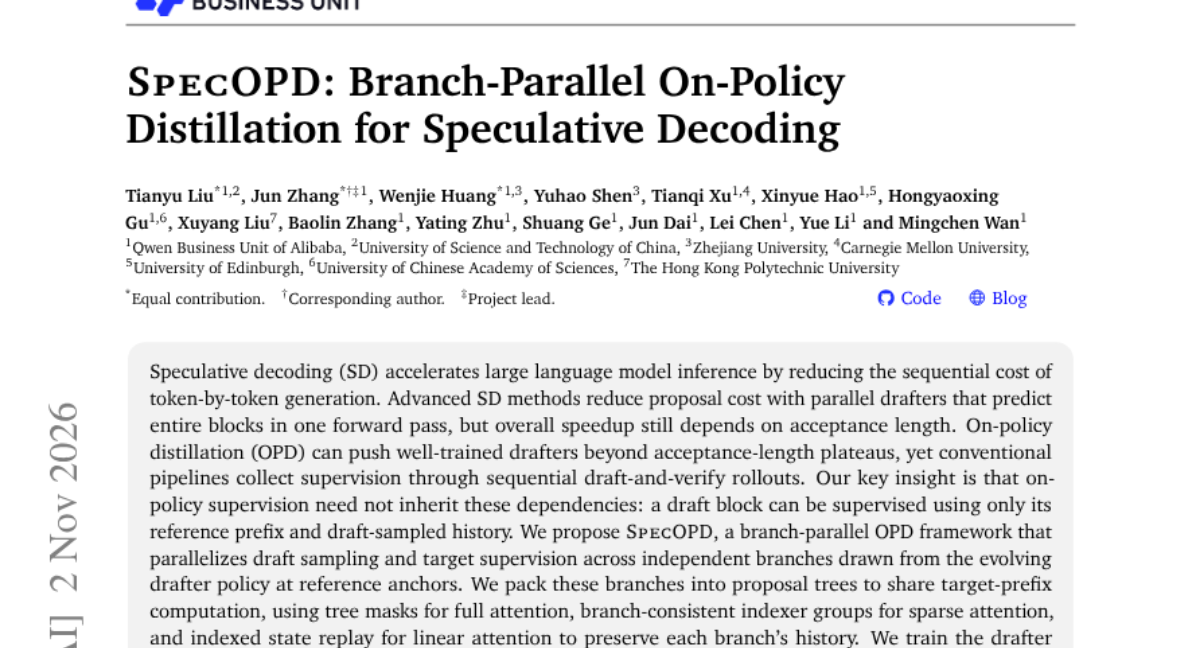
Speculative Decoding은 토큰 생성 속도를 높이지만, 제안된 블록의 수락 길이에 따라 성능이 제한되는 문제가 있습니다. 기존의 온폴리시 증류(OPD)는 순차적인 생성-검증 과정을 거쳐야 하므로 학습 효율이 낮았습니다. 본 논문은 참조 접두사와 샘플링된 이력만으로도 감독이 가능하다는 점에 착안하여, 독립적인 분기들을 병렬로 처리하는 SpecOPD를 제안합니다. 제안된 프레임워크는 트리 마스크와 인덱스 리플레이 기술을 사용하여 병렬 분기 간의 계산 효율을 높이고 타겟 수락 길이를 직접 최적화합니다. 실험 결과, 기존 순차적 OPD 대비 처리량을 대폭 향상시키며 오토레그레시브 디코딩 대비 최대 3.56배의 생성 속도 향상을 달성했습니다.
AI 연구
최근 RL 이후 모델 통합을 위해 Multi-teacher On-Policy Distillation(MOPD)이 사용되지만, 이는 분포 외(OOD) 일반화 능력을 충분히 전이하지 못하는 문제를 안고 있습니다. 연구진은 수학적 추론, 코딩, 에이전트 등 다양한 태스크에서 MOPD가 학습 데이터 내 성능은 높게 유지하지만, 외삽(Extrapolation) 및 조합(Compositional) 일반화 성능은 교사 모델에 비해 크게 떨어진다는 점을 발견했습니다. 이러한 격차의 원인이 교사 모델의 역량과 데이터 커버리지 부족에 있음을 확인했습니다. 이를 해결하기 위해 기하학적 패칭(Geometry-based patching)과 베이스 보존 리플레이(Base-preserving replay) 기법을 제안합니다. 결과적으로 제안된 방법은 IND 성능을 유지하면서도 OOD 성능을 효과적으로 개선했습니다.
AI 연구
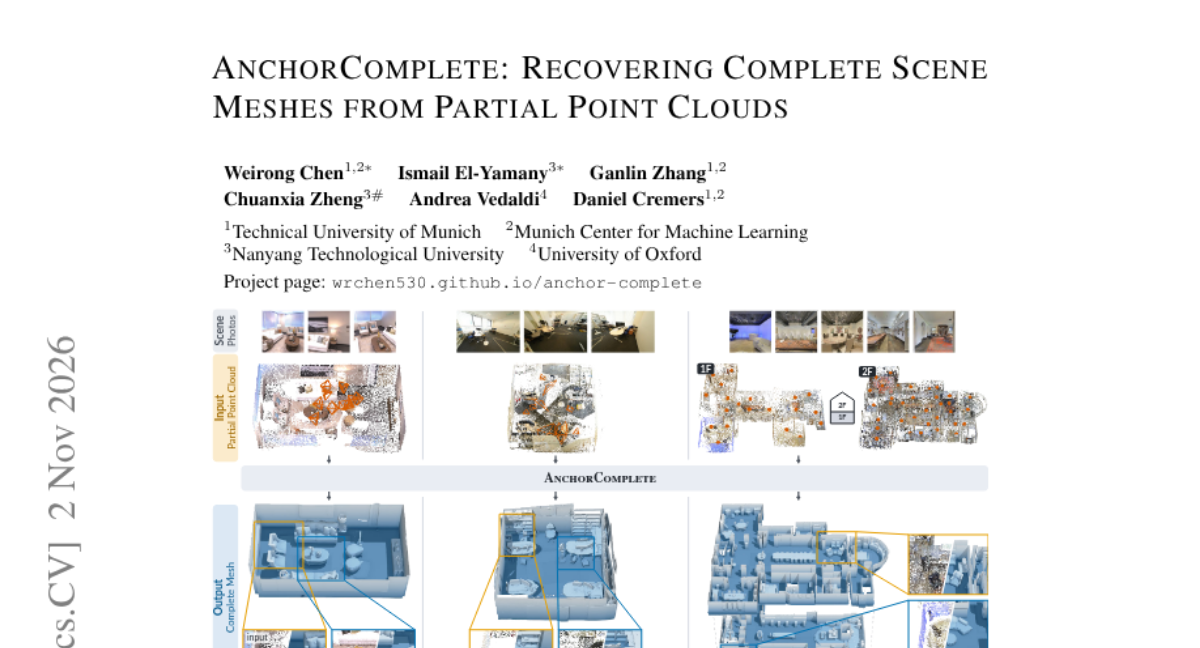
기존의 이미지 기반 3D 재구성 방식은 주로 보이는 표면만 복원하여 구멍이 생기거나 관찰되지 않은 영역이 남는 문제가 있었습니다. 이를 해결하기 위해 본 논문은 관찰된 기하학을 유지하면서 다양한 스케일의 장면을 지원하는 AnchorComplete 프레임워크를 제안합니다. TRELLIS.2를 기반으로 하는 이 방법은 글로벌 토큰과 로컬 공간 증거를 결합하는 '부분 포인트 컨디셔닝'과 고정된 윈도우 내에서 구조적 일관성을 유지하며 정밀도를 높이는 '메트릭 스케일 Coarse-to-Fine 생성' 방식을 결합합니다. 실험 결과, Replica 및 SCRREAM 데이터셋에서 특히 희소 뷰(sparse-view) 환경에서 기존 베이스라인보다 뛰어난 완전 씬 재구성 성능을 입증했습니다.
AI 연구
최근 코딩 에이전트는 공간 추론과 로봇 동작을 결ization할 수 있게 되었으나, 물리적 상호작용을 통한 지속적인 능력 향상 방법은 여전히 과제로 남아 있습니다. 본 연구에서는 물리적 탐색, 코드 정제, 배포를 통합하여 에이전트가 상호작용 경험을 영구적 메모리와 재사용 가능한 기술로 유지하는 PyRUA-REAL 프레임워크를 제안합니다. 연구진은 물리적 조작을 개선 과정의 중심으로 설정하여 에이전트 간 협업, 피드백의 효과, 기존 기술이 강건성에 미치는 영향을 조사했습니다. 실험 결과, 제안된 프레임워크는 8개의 실세계 작업에서 91.1%, RoboDojo 벤치마크에서 84.4%의 높은 성공률을 기록했습니다. 또한 온라인 에이전트 없이 독립적으로 실행되는 프로그램의 효율성과 역량도 검증했습니다. 이 연구는 물리적 탐색을 재사용 가능한 로봇 기술로 전환하는 실증적 가이드를 제공합니다.
AI 연구
기존의 적대적 확산 증류(Adversarial Diffusion Distillation)는 주로 이미지 피처를 판별자로 사용해 왔습니다. 하지만 멀티모달 확산 트랜스포머(MMDiT)에서는 텍스트 스트림이 공동 어텐션을 통해 이미지 정보에 의존한다는 점에 주목했습니다. 이를 위해 텍스트 토큰 상태를 새로운 적대적 표현으로 활용하는 TSAD와 특정 속성을 제어하는 ACD 기법을 제안합니다. NitroFusion2는 이러한 기법들을 결합하여 기존 4~8단계의 증류 과정을 1~2단계로 단축했습니다. 결과적으로 1단계 생성에서도 선명한 텍스트와 세부 디테일을 유지하며 실용적인 수준의 고품질 생성을 달성했습니다.
AI 연구
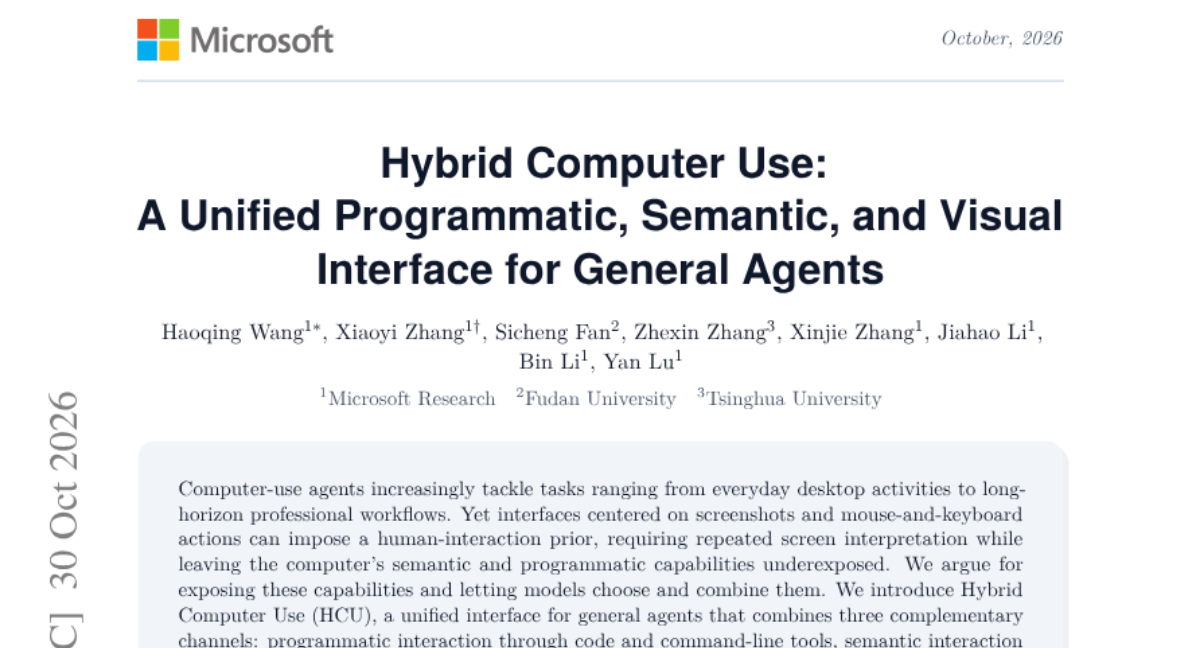
최근 컴퓨터 사용 에이전트는 스크린샷과 마우스/키보드 중심의 인터페이스로 인해 불필요한 화면 해석 과정을 반복하며 컴퓨터의 잠재적 기능을 충분히 활용하지 못하는 문제가 있습니다. 이를 해결하기 위해 본 논문은 프로그래밍적 도구, 접근성(AX) 데이터, 시각적 GUI를 결합한 Hybrid Computer Use(HCU) 인터페이스를 제안합니다. HCU는 효율적인 AX 상호작용을 지원하며, 채널 전환 시 발생할 수 있는 상태 불일치 문제를 방지합니다. 또한 모델이 상황에 맞춰 최적의 채널을 선택하고 조정할 수 있는 보조 기술을 포함합니다. 실험 결과, HCU는 OSWorld 2.0 벤치마크에서 기존 시스템 대비 가장 높은 성능을 기록했습니다. 분석 결과, 모든 모델이 HCU를 통해 성능이 향상되었으며 작업 효율과 성공률 측면에서 우수한 성과를 보였습니다.
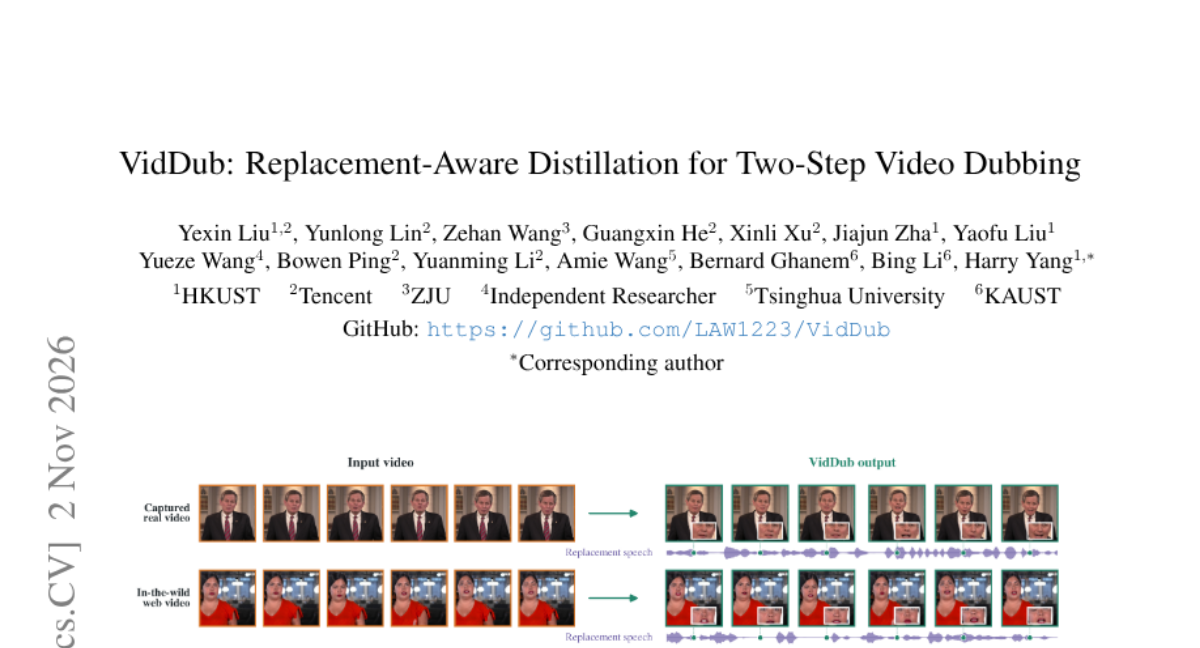
AI 연구
기존의 입 모양 재구성 방식의 충돌 문제를 해결하여, 고품질 영상과 정교한 립싱크를 동시에 달성하는 2단계 비디오 더빙 기술
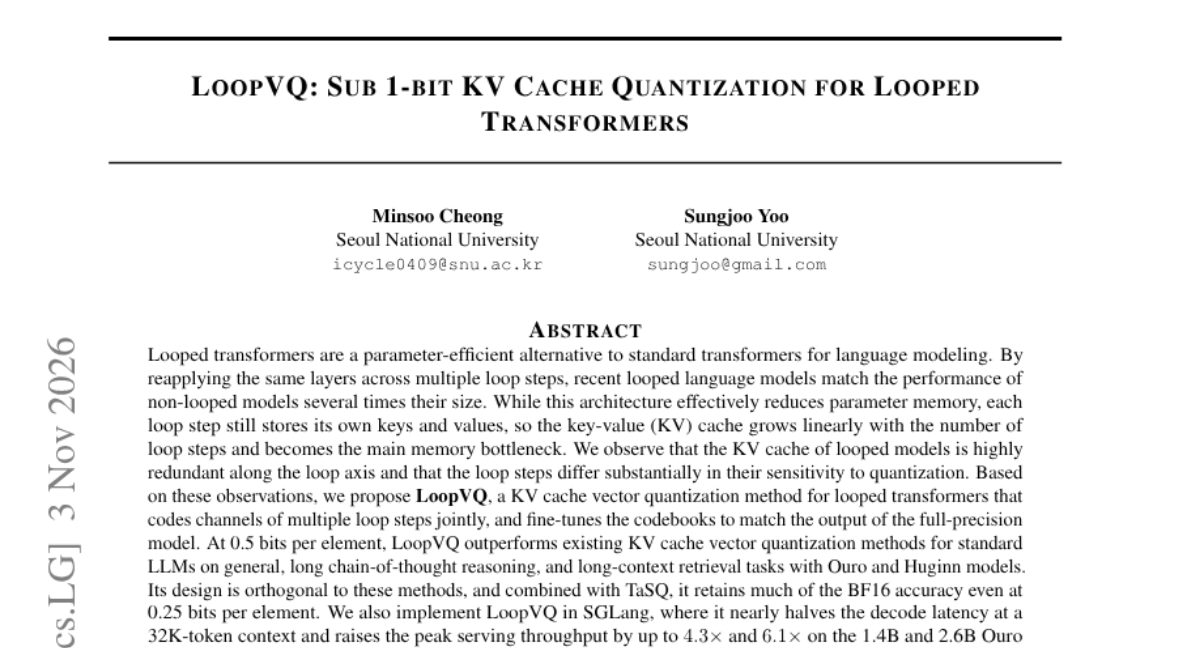
AI 연구
Looped Transformer는 파라미터 효율성을 위해 동일 레이어를 반복 사용하지만, 루프 단계마다 KV 캐시가 쌓여 메모리 병목 현상이 발생합니다. 연구진은 루프 축을 따라 KV 캐시 데이터가 매우 중복적이며, 각 루프 단계별 양자화 민감도가 다르다는 점을 발견했습니다. 이를 해결하기 위해 여러 루프 단계의 채널을 공동 코딩하는 벡터 양자화 방식인 LoopVQ를 제안합니다. 제안된 방식은 코드북 미세 조정을 통해 0.5비트에서도 기존 LLM 양자화 방식을 능가하는 성능을 보여줍니다. 결과적으로 SGLang 구현 시 32K 컨텍스트에서 디코딩 지연 시간을 절반으로 줄이고 처리량을 대폭 향상시켰습니다.
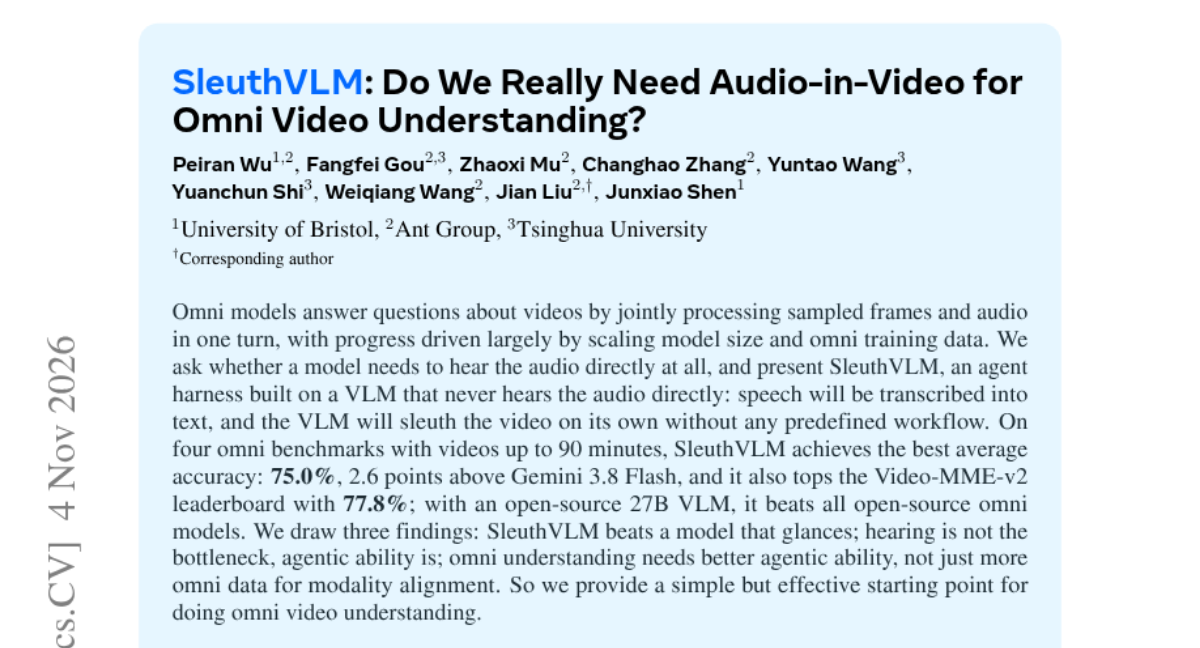
AI 연구
최근 비디오 이해 모델은 프레임과 오디오를 동시에 처리하는 멀티모달 학습을 통해 발전해 왔습니다. 하지만 오디오를 직접 듣는 것이 비디오 이해의 핵심인지에 대한 의문이 제기되었습니다. 본 논문은 오디오를 직접 듣지 않고 음성을 텍스트로 변환하여 처리하는 에이전트 방식인 SleuthVLM을 제안합니다. 실험 결과, SleuthVLM은 긴 영상(최대 90분)을 포함한 주요 벤치마크에서 Gemini 1.5 Flash를 포함한 기존 모델들을 상회하는 성능을 기록했습니다. 연구 결과, 비디오 이해의 병목은 모달리티 정렬이 아닌 에이전트로서의 추론 능력에 있음이 밝혀졌습니다.
AI 연구
현재 LLM의 안전 정렬은 영어 중심이며, 저자원 언어에 대한 다국어 대응 능력이 부족한 실정입니다. 기존 데이터셋은 규모가 작거나 특정 문화권의 유해 주제를 반영하지 못하는 한계가 있습니다. 이를 해결하기 위해 유해 프롬프트에서 안전한 템플릿을 추출하고, 이를 번역한 뒤 문화적 맥락이 담긴 개체로 채우는 확장 가능한 템플릿 기반 증강 파이프라인을 제안합니다. 그 결과 60개 언어를 지원하는 MSafeTemp 데이터셋을 공개했습니다. 실험 결과, 영어 중심 평가가 다국어 안전성을 오판할 수 있음을 확인했으며, 템플릿 기반 데이터 증강이 다국어 안전 성능을 효과적으로 향상시킴을 입증했습니다.
AI 연구
기존의 딥페이크 탐지는 단순히 진위 여부만을 판단하여 상세한 포렌식 분석(생성기 식별, 출처 확인 등)에 한계가 있었습니다. 이를 해결하기 위해 5가지 핵심 태스크를 공유 가중치로 통합한 오디오 언어 모델인 VeriSpojs를 제안합니다. 이 모델은 탐지뿐만 아니라 생성기 속성, 녹음 조건, 합성 구간 식별, 소스 검증을 동시에 수행하며 근거가 되는 설명(rationale)을 제공합니다. 실험 결과, VeriSpoof-Plus는 2.14%의 낮은 EER을 기록하며 오픈 웨이트 모델 중 최고 성능을 보였습니다. 특히 설명 가능한 근거를 통해 미학습 생성기에 대해서도 높은 검증 성능을 유지하며, 부분 편집된 가짜 음성 탐지에서도 탁월한 성능을 입증했습니다.
AI 연구
생성형 AI의 토큰 비용은 KV-캐시 누적으로 인해 비선형적으로 증가하지만, 기존에는 모델별로 개별 피팅이 필요한 모델링 방식이 주를 이루었습니다. 본 논문은 아키텍처 하이퍼파라미터를 기반으로 연산 및 메모리 접근 복잡도를 설명하는 폐쇄형 수식을 유도했습니다. 이를 통해 prefill과 decode 비용을 분리하고, KV-캐시 비용과 차기 토큰 연산 비용을 구분하는 'SIMPLE' 모델을 도출했습니다. NVIDIA H100 환경에서 13개 모델로 검증한 결과, 별도의 모델별 보정 없이도 기존 SOTA 대비 훨씬 낮은 오차율로 에너지 소비를 예측했습니다. 결과적으로 이 법칙은 GQA의 효율성, 추론 예산 증가에 따른 에너지 효율 저하, 에이전트 서비스의 높은 비용 구조를 명확히 설명합니다.
AI 연구
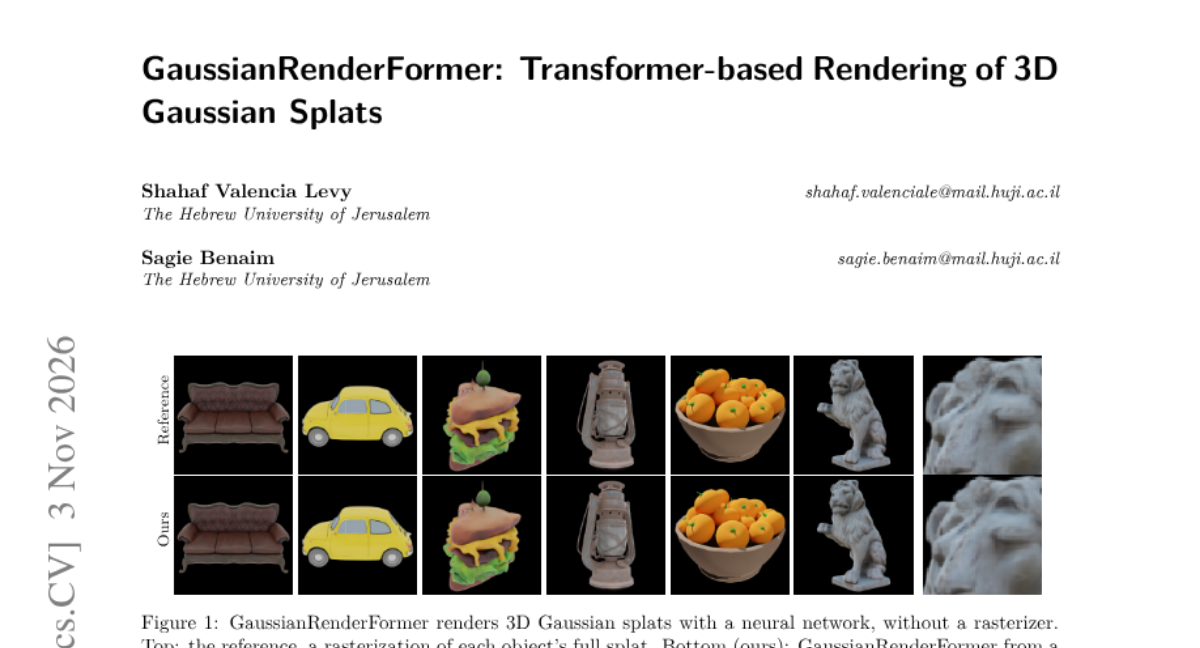
기존 3D 가우시안 스플래팅은 래스터라이저를 필수적으로 사용하지만, 신경망이 이를 직접 학습할 수 있는지에 대한 의문이 제기되었습니다. 본 논문은 가우시안 집합과 카메라 정보를 입력받아 이미지를 직접 생성하는 GaussianRenderFormer를 제안합니다. 각 가우시안을 토큰화하는 뷰 독립적 인코더와 카메라 레이 패치를 픽셀로 변환하는 뷰 의존적 디코더 구조를 사용합니다. 실험 결과, 2만 개의 가우시안을 사용해 미학습 객체에 대해 38.08 dB PSNR을 달성하며 래스터라이징 방식(44.02 dB)과의 성능 차이를 확인했습니다. 분석 결과, 디코더가 가우시안의 투영된 풋프린트 정보를 명시적으로 전달받지 못하는 것이 성능 병목의 주요 원인으로 나타났습니다.
AI 연구
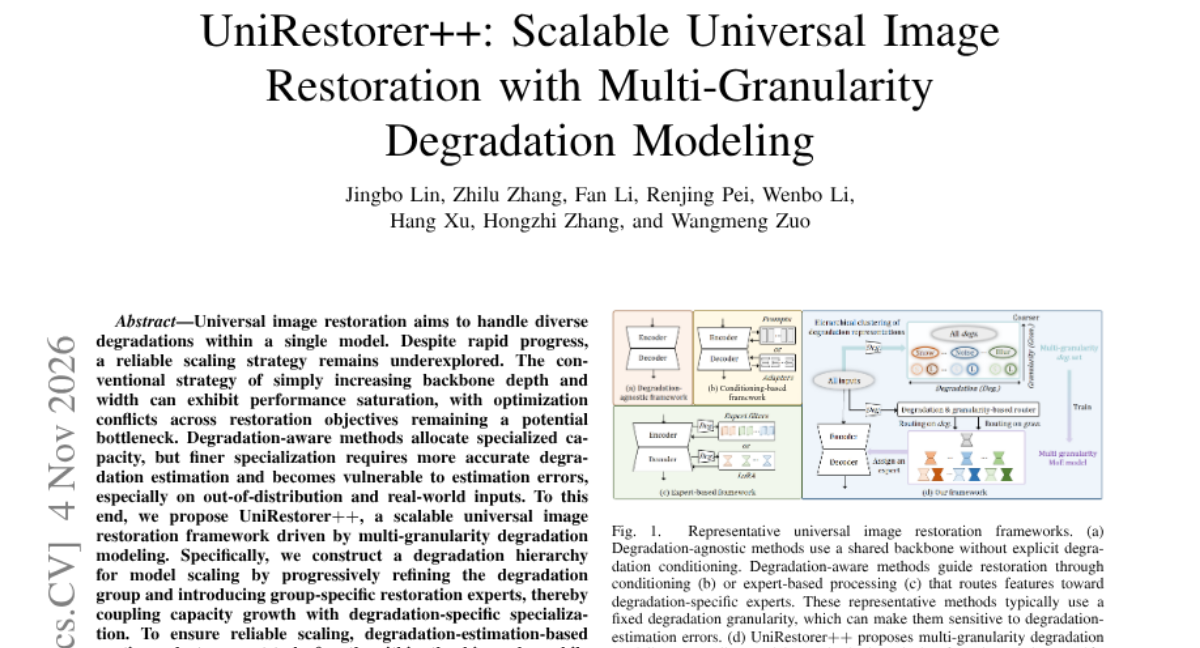
범용 이미지 복원은 하나의 모델로 다양한 열화(degradation)를 처리하는 것을 목표로 하지만, 모델 크기 확장에 따른 성능 향상 전략이 부족한 상황입니다. 기존의 백본 확장 방식은 성능 포화 문제가 발생하며, 열화 추정 기반의 특화 방식은 미학습 데이터에 취약하다는 단점이 있습니다. 이를 해결하기 위해 본 논문은 다중 입도(multi-granularity) 열화 모델링 기반의 확장 가능한 프레임워크인 UniRestorer++를 제안합니다. 이 방식은 열화 그룹을 점진적으로 정교화하고 그룹별 전문가(expert)를 도입하여 용량 확장과 전문화를 결합합니다. 실험 결과, 모델 크기 증가에 따라 로그 선형적인 PSNR 향상을 보였으며, 실세계 데이터 및 OOD(Out-of-Distribution) 환경에서 기존 MoE 방식보다 강력한 성능을 입증했습니다.
AI 연구
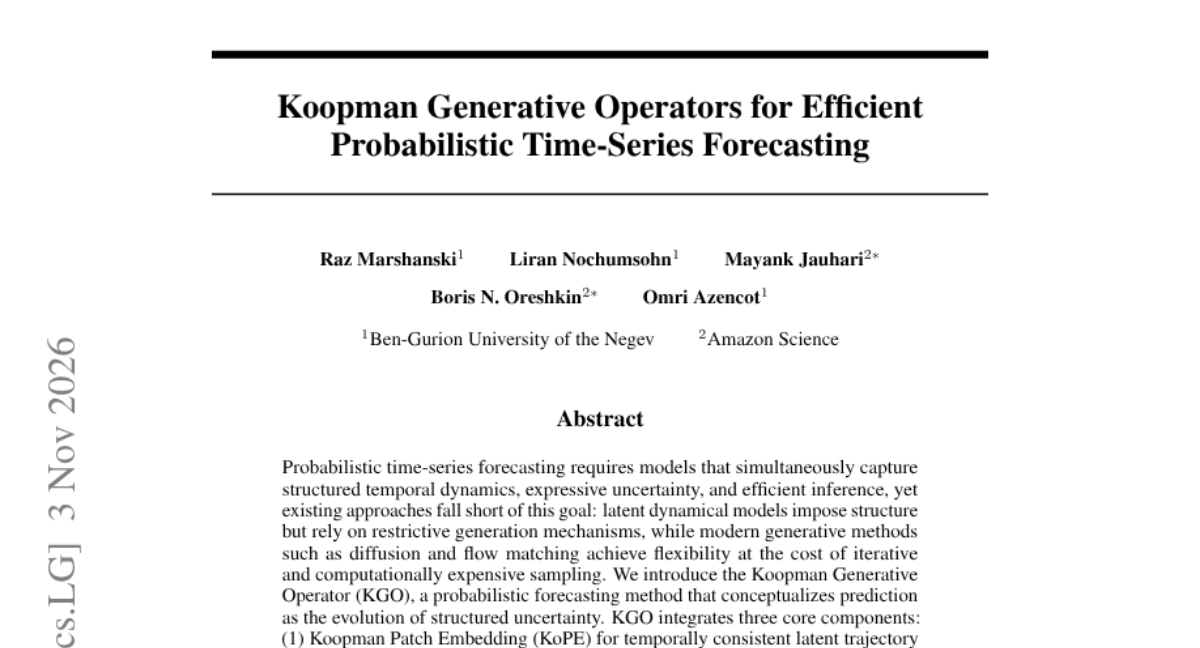
기존의 확률적 시계열 예측 모델은 구조적 동역학을 반영하면서도 생성 모델의 유연성을 확보하는 데 어려움이 있었습니다. 특히 확산 모델(Diffusion)과 같은 최신 생성 방식은 유연하지만 반복적인 샘플링 과정으로 인해 추론 속도가 느리다는 단점이 있습니다. 본 논문은 Koopman Generative Operator(KGO)를 제안하여 예측을 구조화된 불확실성의 진화 과정으로 정의합니다. KGO는 Koopman Patch Embedding, Koopman Flow Matching, Adaptive Uncertainty Gate라는 세 가지 핵심 요소를 결합합니다. 실험 결과, KGO는 다수의 벤치마크에서 최고 수준의 정확도를 달성함과 동시에 기존 반복적 생성 모델 대비 추론 시간을 25배 이상 단축했습니다.
AI 연구
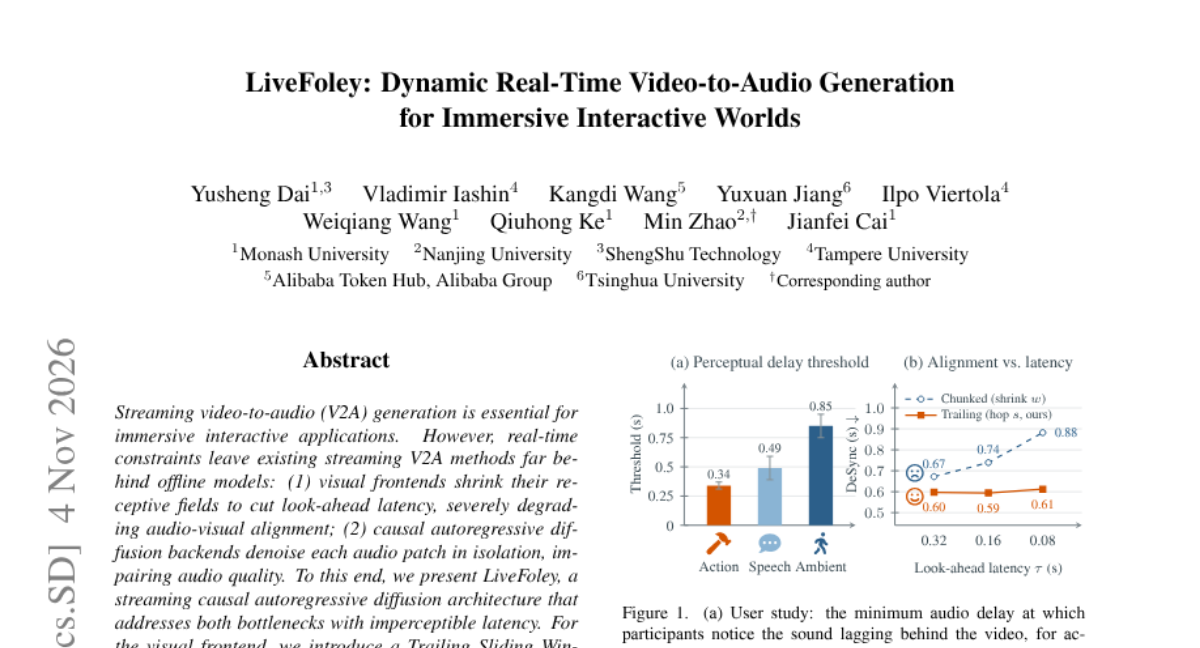
몰입형 상호작용 애플리케이션을 위해 실시간 비디오-to-오디오(V2A) 생성 기술이 필수적이지만, 기존 방식은 낮은 지연 시간을 위해 수용 영역을 줄이면서 오디오-비주얼 정렬이 깨지거나 오디오 품질이 저하되는 문제가 있었습니다. 이를 해결하기 위해 LiveFoley는 스트리밍 인과적 자기회귀 확산(causal autoregressive diffusion) 아키텍처를 제안합니다. 비주얼 프론트엔드에는 재학습 없이 비인과적 인코더를 스트리밍 모듈로 변환하는 Trailing Sliding Window와 가변적 지연 시간을 조절하는 Unified Varhop Framework를 도입했습니다. 오디오 백엔드에서는 과거 문맥을 활용하는 History LocDiT와 미래 정보를 근사적으로 반영하는 Future-Warmup LocDiT를 통해 생성 품질을 높였습니다. 실험 결과, LiveFoley는 오프라인 모델 수준의 정렬 성능을 유지하면서도 실시간 스트리밍 환경에서 압도적인 생성 품질을 입증했습니다.
AI 연구
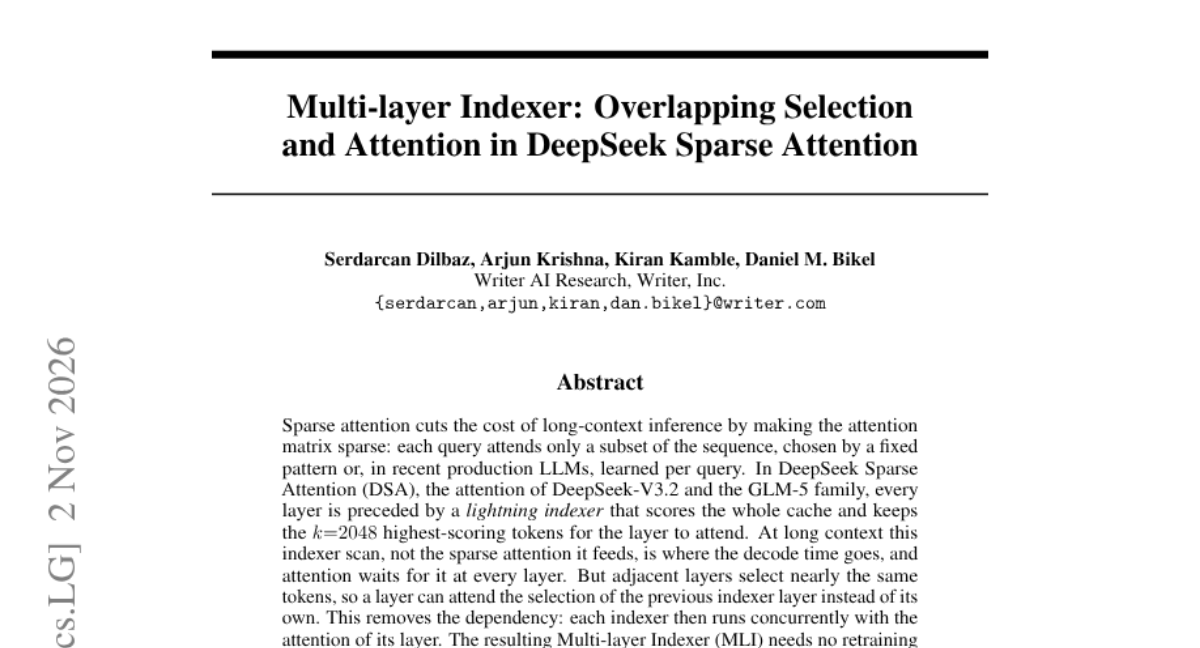
최근 LLM은 긴 문맥 처리를 위해 Sparse Attention을 사용하지만, 매 레이어마다 전체 캐시를 스캔하는 인덱서 작업이 디코딩 병목을 유발합니다. 인접한 레이어들이 유사한 토큰을 선택한다는 점에 착안하여, 이전 레이어의 선택 결과를 다음 레이어가 재사용하는 Multi-layer Indexer(MLI)를 제안합니다. 이 방식은 모델의 가중치를 변경하거나 재학습할 필요가 없으며, 기존 SGLang 프로토콜과 호환됩니다. 실험 결과, MLI는 IndexCache와 결합하여 기존 방식보다 더 빠른 디코딩 성능을 보여주면서도 높은 정확도를 유지했습니다. 결과적으로 긴 문맥 환경에서 연산 효율을 극대화하면서도 성능 저하를 최소화했습니다.
AI 연구
디지털 휴먼 서비스에서는 실시간 텍스트 업데이트에 맞춰 고해상도 비디오를 생성하면서도 끊김 없는 음성 출력이 필요합니다. 기존의 고해상도 디노이징 방식은 비용이 많이 들고, 텍스트 업데이트 시 음성이 중단되거나 반복되는 문제가 있었습니다. 이를 해결하기 위해 TaoMate-HD는 저해상도 구조 형성 후 고해상도로 정제하는 점진적 디노이징과 오디오-비디오 통합 생성 방식을 제안합니다. 또한, 텍스트 업데이트 시 이전 맥락을 유지하는 Continuation training을 통해 음성 연속성을 확보했습니다. 실험 결과, 직접 생성 방식 대비 1.6배의 속도 향상을 보였으며, 최적화된 병렬 배포를 통해 추가적인 속도 향상을 달성했습니다. 결과적으로 캐릭터 오류율을 크게 낮추면서도 시간 단위의 장기 오디오-비디오 생성이 가능해졌습니다.
AI 연구
역사적 기록물은 연구 가치가 높지만 언어 장벽으로 인해 전 세계적 접근이 어렵습니다. 기존 기계 번역은 역사적 문맥과 데이터 부족으로 인한 시계열 편향 문제로 인해 고전 문헌 번역에 한계가 있습니다. 이를 해결하기 위해 본 논문은 RAG를 활용하여 풍부한 한자-한국어 코퍼스로 고품질 의사 라벨(pseudo-labeled) 데이터를 생성하는 HERIT 파이프라인을 제안합니다. 이 방식은 학습 데이터셋을 확장하여 데이터 부족과 시대별 과적합 문제를 동시에 완화합니다. 실험 결과 HERIT은 기존 베이스라인 모델들을 상회하는 성능을 보였으며, 실제 미번역 기록물 번역을 통해 그 효용성을 입증했습니다.
AI 연구
AI 에이전트의 성공률을 높이기 위해 실패 시 재시작하는 모니터링 기법이 사용되지만, 기존의 분류 정확도 지표만으로는 실제 성공률 향상 여부를 판단하기 어렵습니다. 본 논문은 재시작 시 남은 예산(residual-budget)에 따른 성공 확률이 모니터의 가치를 결정한다는 점을 분석적으로 증명합니다. 이를 위해 정보 손실 없이 최적의 의사결정을 보장하는 '의사결정 충분성 기준(decision-sufficiency criterion)'과 모델 호출 없이 기존 트레이스만으로 검증하는 '모델 프리 의사결정 감사(decision audit)' 기법을 제안합니다. SWE-bench Verified 데이터를 활용한 실험 결과, 높은 정확도를 가진 모니터라도 특정 상황에서는 오히려 성공률을 크게 떨어뜨릴 수 있음을 확인했습니다. 결과적으로 모니터링 성능은 단순 정확도가 아닌 회복 기회와 의사결정 가치 관점에서 평가되어야 합니다.
AI 연구
기존의 GPU 커널 최적화 에이전트는 정해진 규칙을 따르는 스크립트 방식과 자유도가 높지만 비효율적인 오픈 엔드 방식 사이의 트레이드오프 문제를 겪고 있습니다. 두 방식 모두 에이전트에게 더 많은 정보와 도구를 제공하는 데 집중하지만, 정작 최적화의 방향성을 결정하는 데는 한계가 있습니다. 본 논문은 에이전트가 스스로 질문을 던져 문제의 핵심을 파악하는 'KernelSeek' 프레임워크를 제안합니다. KernelSeek는 특정 연산자에 대한 사전 지식 없이도 질문을 통해 시스템의 계층을 이동하거나 가설을 검증하며 최적화를 수행합니다. 실험 결과, 기존 도구 중심 에이전트보다 훨씬 적은 단계로 FlashAttention-3 및 FlashAttention-4 수준의 고성능 커널을 생성하는 데 성공했습니다.
AI 연구
LLM의 추론 과정이 길어질수록 문제 해결 능력은 향상되지만 토큰 비용이 급격히 증가하는 문제가 발생합니다. 기존 폐쇄형 모델의 추론 과정은 외부에서 관찰하기 어려워 효율적인 압축 방식에 대한 연구가 제한적이었습니다. 본 연구는 오픈 웨이트 모델을 대상으로 재학습 없이 이전의 추론 내용을 간결한 상태 기록(compact state records)으로 재작성하는 개입 방식을 제안합니다. 실험 결과, 압축된 이력을 사용하면 미래의 추론 길이가 단축되며 코딩 작업에서도 중복 검증이 줄어드는 효과를 확인했습니다. 결과적으로 추론 이력 관리는 비용 절감의 핵심 요소이며, 모델별 맞춤형 압축 정책이 필요함을 시사합니다.
AI 연구
물리적 AI 환경에서의 지속 학습은 미세한 정책 오류가 궤적을 따라 누적되어 작업 실패로 이어지는 특수한 문제를 가집니다. 기존 방식은 데이터 분포 이탈과 예측 오차 증가를 제어하기 어렵습니다. 본 논문은 궤적 증폭 위험도(trajectory-amplification risk)를 가중치로 사용하여 텐서별 중요도를 추정하는 DRAP 방식을 제안합니다. Lyapunov 이론에서 영감을 얻어 상태 전이 행렬의 최대 특이값을 통해 섭동 증폭도를 계산하고, 이를 통해 이전 작업에 중요한 텐서의 학습률을 동적으로 조절합니다. 실험 결과, DRAP는 Replay 없이도 기존 AdamW나 EWC 대비 이전 작업의 성능을 유지하면서 새로운 작업 학습 능력을 확보했습니다.
30건
이날 공개된 제품과 도구


6건
새 모델과 주요 평가 결과
HF Model Trending
Qwen/Qwen3.8-27B 모델이 높은 다운로드 수와 좋아요를 기록하며 주목받고 있습니다. 이 모델은 이미지와 텍스트를 동시에 처리하는 image-text-to-text 파이프라인을 지원합니다.
HF Model Trending
Moonshot AI에서 공개한 Kimi-K3.1-Pro 모델이 Hugging Face에서 높은 관심을 받고 있습니다. 이 모델은 이미지와 텍스트를 동시에 처리하는 멀티모달 기능을 제공합니다.
HF Model Trending
FusionCow에서 공개한 Sulphur-3 모델이 Hugging Face에서 주목받고 있습니다. 해당 모델은 377개의 likes와 607회의 downloads를 기록하며 트렌드에 진입했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 O4-Mini (High) 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Pro-06-05 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 테스트를 진행했습니다.
LiveCodeBench
LiveCodeBench 벤치마크에서 Gemini-2.5-Flash-04-17 모델이 상위 성적을 기록했습니다. 해당 모델은 4개의 문제를 대상으로 avg_pass@1 25.0%를 달성했습니다.