
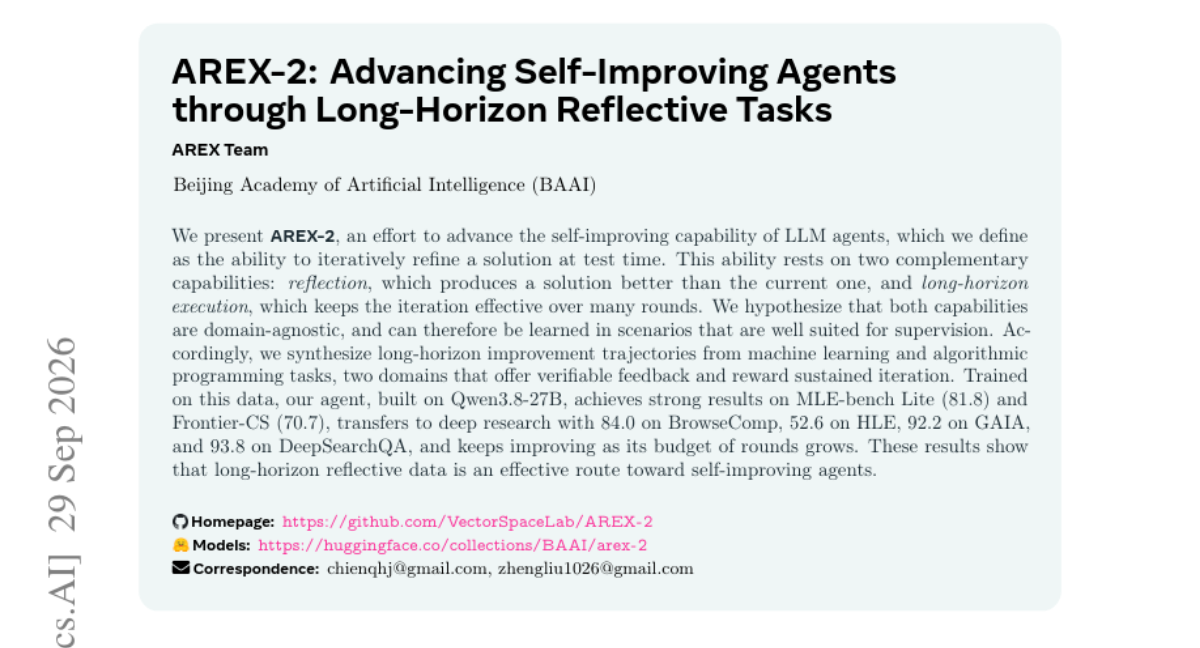
AREX-2: Advancing Self-Improving Agents through Long-Horizon Reflective Tasks
장기적 실행과 성찰 능력을 결합하여 테스트 시점에 스스로 성능을 개선하는 자가 개선(Self-improving) 에이전트 프레임워크 제안
논문이 다루는 내용
LLM 에이전트의 핵심 역량인 자가 개선 능력을 높이기 위해 성찰(Reflection)과 장기적 실행(Long-horizon execution) 능력을 결합하는 연구가 필요합니다. 기존 방식은 반복적인 개선 과정에서 성능이 유지되거나 향상되는 데 어려움이 있었습니다. 본 논문은 검증 가능한 피드백을 제공하는 ML 및 알고리즘 프로그래밍 태스크를 활용하여 장기적 개선 궤적 데이터를 합성했습니다. 이를 통해 학습된 AREX-2(Qwen3.8-27B 기반)는 MLE-bench Lite 및 Frontier-CS 등 다양한 벤치마크에서 강력한 성능을 보였습니다. 결과적으로 반복 횟수가 늘어날수록 성능이 향상되는 효과적인 자가 개선 경로를 입증했습니다.
핵심 결과
-
성찰(Reflection)과 장기적 실행(Long-horizon execution)의 결합을 통한 자가 개선 메커니즘 구축
-
검증 가능한 피드백이 가능한 ML/알고리즘 도메인을 활용한 고품질 학습 데이터 합성
-
반복 횟수(Budget)가 증가함에 따라 성능이 지속적으로 향상되는 확장성 입증
실무에서 볼 만한 점
에이전트가 단순히 한 번의 답변을 내놓는 것을 넘어, 복잡한 문제를 해결하기 위해 스스로 계획을 수정하고 반복 수행하는 능력을 어떻게 학습시킬지에 대한 실질적인 방법론을 제시합니다.
읽을 때 확인할 점
-
알고리즘/코딩 문제처럼 정답 검증이 가능한 도메인에서 에이전트의 반복 루프 실험
-
반복 횟수(Iteration budget) 증가에 따른 성능 향상 곡선 및 비용 효율성 분석
-
합성된 장기 궤적 데이터가 다른 도메인(Research, QA)으로 전이되는 양상 확인