
Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
터미널 에이전트의 실행 신뢰도를 높이기 위해 모델과 실행 환경 사이의 '중간 검증 단계(Mid-Harness)'를 도입하여 테스트 타임 연산 효율을 극대화하는 방법론입니다.
논문이 다루는 내용
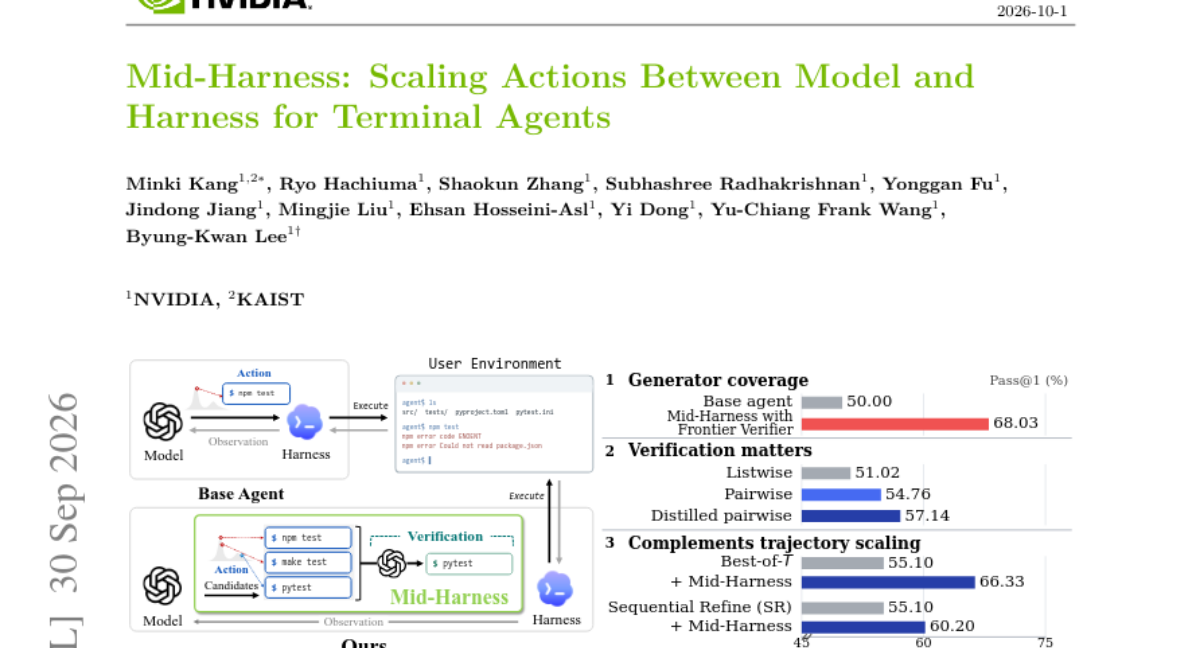
터미널 에이전트는 모델이 생성한 명령어가 환경을 직접 변경하기 때문에, 잘못된 명령어가 실행될 경우 이후 작업이 불가능해지는 문제가 발생합니다. 본 연구는 모델과 실행 환경(Harness) 사이의 경계에서 테스트 타임 연산(Test-time compute)을 할당하여 액션의 신뢰도를 높이는 방법을 조사합니다. 이를 위해 생성 모델과 실행 환경을 수정하지 않고, 실행 전 후보 액션을 샘플링하고 검증하는 'Mid-Harness' 프레임워크를 제안합니다. 실험 결과, 강력한 검증기를 활용할 경우 적은 수의 샘플링만으로도 성공률을 크게 높일 수 있음을 확인했습니다. 또한, 검증 결과의 지식 증류(Distillation)와 액션/경로 스케일링의 조합이 효율적인 성능 향상을 이끌어냈습니다.
핵심 결과
-
Mid-Harness: 생성 모델과 실행 환경을 변경하지 않고 중간에 샘플링 및 검증 단계를 추가하는 프레임워크 제안
-
액션 스케일링(Action Scaling): 모델의 생성 능력을 넘어, 검증기를 통해 유효한 액션을 선택하는 것이 성능 향상의 핵심임을 입증
-
효율적 연산 배분: 단순히 더 많은 경로를 생성하는 것보다, 액션 단계에서의 검증과 선택이 비용 대비 성능(Pass@1)이 우수함
실무에서 볼 만한 점
에이전트가 실제 시스템(CLI, 서버 등)에 명령을 내릴 때 발생하는 '환경 오염' 문제를 해결하고, 모델 교체 없이도 성능을 높일 수 있는 실용적인 구조를 제시합니다.
읽을 때 확인할 점
-
기존 에이전트 워크플로우에 '후보군 생성 -> 검증 -> 실행' 구조의 미들웨어를 도입해보기
-
강력한 모델(예: GPT-4o)을 검증기로, 가벼운 모델을 생성기로 사용하는 하이브리드 구조 테스트
-
검증 로직을 Pairwise(쌍별 비교) 방식으로 설계하여 액션의 유효성 판단 실험