
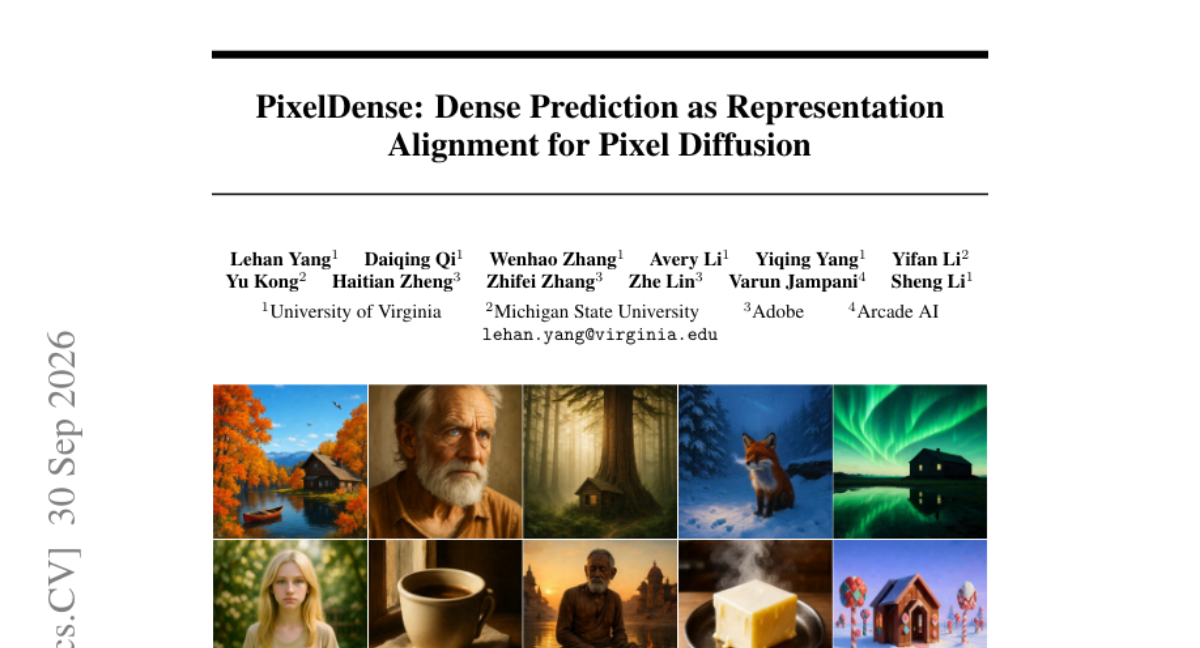
PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
의미론적(Semantic) 및 기하학적(Geometric) 특징을 분리된 투영 스트림으로 학습하여 픽셀 확산 모델의 생성 품질과 구조적 정밀도를 동시에 높인 기술
논문이 다루는 내용
기존의 표현 정렬(REPA) 방식은 주로 CLIP과 같은 의미론적 인코더에만 의존하여 공간 구조 정보를 충분히 활용하지 못했습니다. 여러 모델을 동시에 학습할 경우 의미론적 그래디언트와 기하학적 그래디언트가 충돌하여 성능이 저하되는 문제가 발생합니다. 이를 해결하기 위해 PixelDense는 의미론적 스트림(DINOv2, SAM2)과 기하학적 스트림(Depth Anything v2, Metric3D v2)을 분리하고 직교성 페널티를 적용하는 구조를 제안합니다. 결과적으로 PixelGen과 DeCo 등에서 기존 대비 향상된 생성 성능을 보였으며, 특히 구조적 정밀도와 편집 시 레이아웃 유지 능력이 크게 개선되었습니다.
핵심 결과
-
의미론적(Semantic) 및 기하학적(Geometric) 특징을 위한 독립적인 투영 스트림 설계
-
두 스트림 간의 간섭을 방지하기 위한 가중치 공간 직교성 페널티(Orthogonality Penalty) 도입
-
학습 시에는 다중 모델을 활용하고 추론 시에는 제거하여 효율적인 생성 성능 확보
실무에서 볼 만한 점
이미지 생성 모델 학습 시 단순한 의미론적 정렬을 넘어, 정교한 구조와 레이아웃 유지가 필요한 픽셀 기반 확산 모델의 성능을 극대화할 수 있는 방법론을 제시합니다.
읽을 때 확인할 점
-
DINOv2 외에 다른 기하학적 모델(예: Marigold)을 활용한 스트림 확장 실험
-
직교성 페널티 계수 변화에 따른 생성 품질 및 학습 안정성 분석
-
제안된 분리형 투영 구조를 기존 Diffusion Transformer 구조에 이식 테스트