
Omni-Embed-Mini: Binding Modalities Without Forgetting via Dense Distillation
텍스트 성능 저하 없이 6가지 모달리티를 통합하는 초경량(0.9B) 멀티모달 임베딩 모델 개발
논문이 다루는 내용
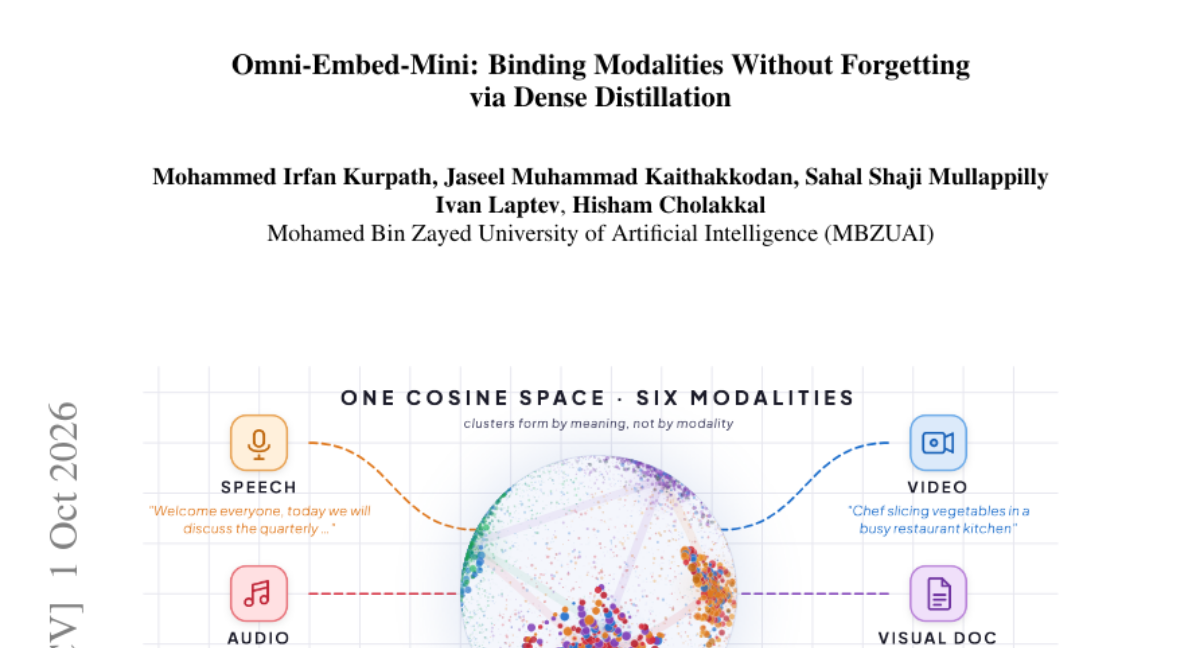
기존의 멀티모달 임베딩 모델은 새로운 모달리티를 추가할 때 텍스트 검색 성능이 저하되거나 모델 크기가 지나치게 커지는 문제가 있었습니다. 이를 해결하기 위해 텍스트 백본의 가중치를 고정한 상태에서 다른 모달리티를 정렬하는 Omni-Embed-Mini를 제안합니다. 캡션된 미디어 샘플을 활용해 고정된 텍스트 백본을 교사(Teacher)로 삼는 밀집 증류(Dense Distillation) 방식을 사용합니다. 학습 시에는 Matryoshka SigLIP 손실과 하이브리드 하드 네거티브 마이닝을 결합하여 효율적인 정렬을 수행합니다. 그 결과, 텍스트 성능을 유지하면서도 기존 모델 대비 훨씬 작은 크기로 다양한 모달리티를 통합하는 데 성공했습니다.
핵심 결과
-
텍스트 백본 가중치를 고정하여 기존 텍스트 검색 성능 저하(Catastrophic Forgetting)를 원천 차단
-
캡션된 미디어와 고정된 텍스트 임베딩을 매칭하는 밀집 증류(Dense Distillation) 기법 도입
-
Matryoshka SigLIP 및 하이브리드 하드 네거티브 마이닝을 통한 효율적 학습
실무에서 볼 만한 점
텍스트 검색 성능을 유지하면서 이미지, 오디오, 비디오 등을 하나의 벡터 공간에 통합할 수 있어, 멀티모달 RAG 시스템 구축 시 모델 크기와 성능 사이의 트레이드오프를 획기적으로 줄여줍니다.
읽을 때 확인할 점
-
제공된 0.9B 모델을 활용하여 기존 텍스트 검색 성능 변화 측정 실험
-
다양한 미디어(이미지, 오디오 등)를 입력했을 때의 임베딩 공간 분포 시각화
-
특정 도메인 데이터셋에 대한 하이브리드 네거티브 마이닝 효과 검증