
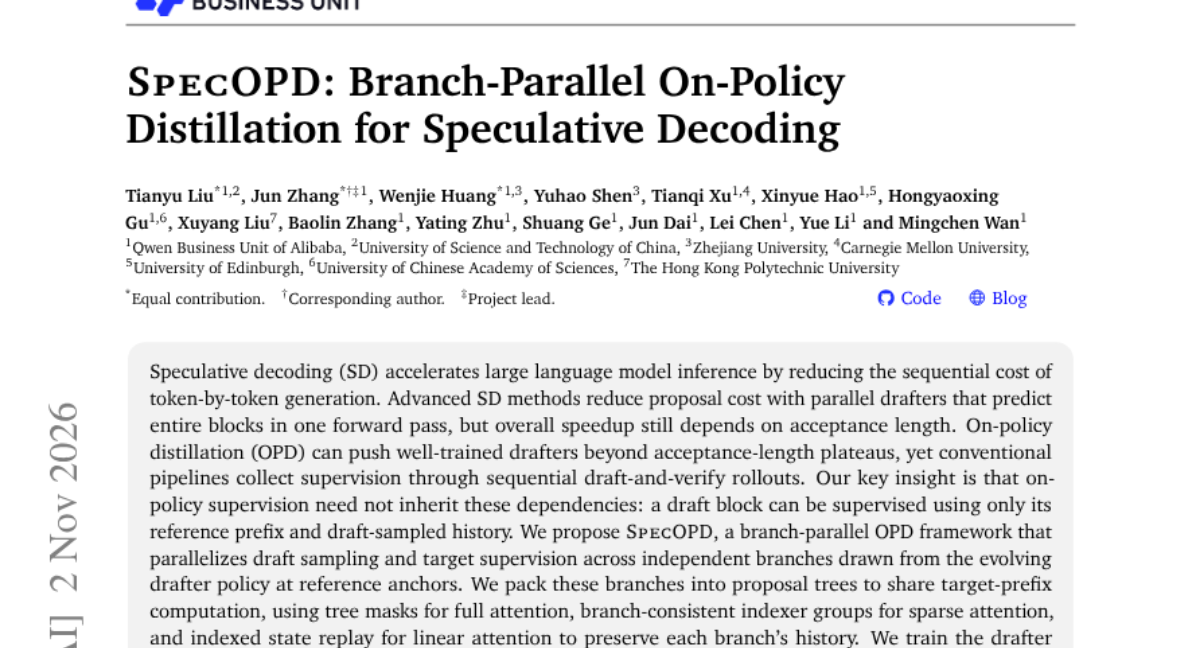
SpecOPD: Branch-Parallel On-Policy Distillation for Speculative Decoding
병렬 분기 학습 방식을 통해 Speculative Decoding의 Drafter 성능과 처리량을 극대화한 온폴리시 증류(OPD) 프레임워크
논문이 다루는 내용
Speculative Decoding은 토큰 생성 속도를 높이지만, 제안된 블록의 수락 길이에 따라 성능이 제한되는 문제가 있습니다. 기존의 온폴리시 증류(OPD)는 순차적인 생성-검증 과정을 거쳐야 하므로 학습 효율이 낮았습니다. 본 논문은 참조 접두사와 샘플링된 이력만으로도 감독이 가능하다는 점에 착안하여, 독립적인 분기들을 병렬로 처리하는 SpecOPD를 제안합니다. 제안된 프레임워크는 트리 마스크와 인덱스 리플레이 기술을 사용하여 병렬 분기 간의 계산 효율을 높이고 타겟 수락 길이를 직접 최적화합니다. 실험 결과, 기존 순차적 OPD 대비 처리량을 대폭 향상시키며 오토레그레시브 디코딩 대비 최대 3.56배의 생성 속도 향상을 달성했습니다.
핵심 결과
-
병렬 분기(Branch-Parallel) 구조를 통한 온폴리시 데이터 수집 및 학습 효율 극대화
-
트리 마스크 및 인덱스 기반 상태 리플레이를 활용한 효율적인 병렬 어텐션 연산
-
수락 길이(Acceptance Length)를 직접 타겟팅하는 E2E-TV 대리 목적 함수 도입
실무에서 볼 만한 점
LLM 추론 가속화 시 발생하는 병목 현상을 해결하기 위해, 학습 단계에서부터 병렬 생성 구조를 고려한 고성능 Drafter를 구축하는 방법을 제시합니다.
읽을 때 확인할 점
-
제안된 트리 마스크 및 인덱스 리플레이 로직의 PyTorch 구현 가능성 검토
-
기존 순차적 OPD 방식과 SpecOPD의 학습 수렴 속도 및 데이터 효율성 비교 실험
-
다양한 모델 아키텍처(GQA, Sparse-Linear 등)에서의 확장성 테스트