
VA-TDM: A Unified View for Improving Few-Step Diffusion Models by Velocity Adversarial Distillation
속도 적대적 증류(VAD)를 통해 적은 단계만으로도 고품질 이미지/비디오 생성이 가능한 통합 프레임워크 제안
논문이 다루는 내용
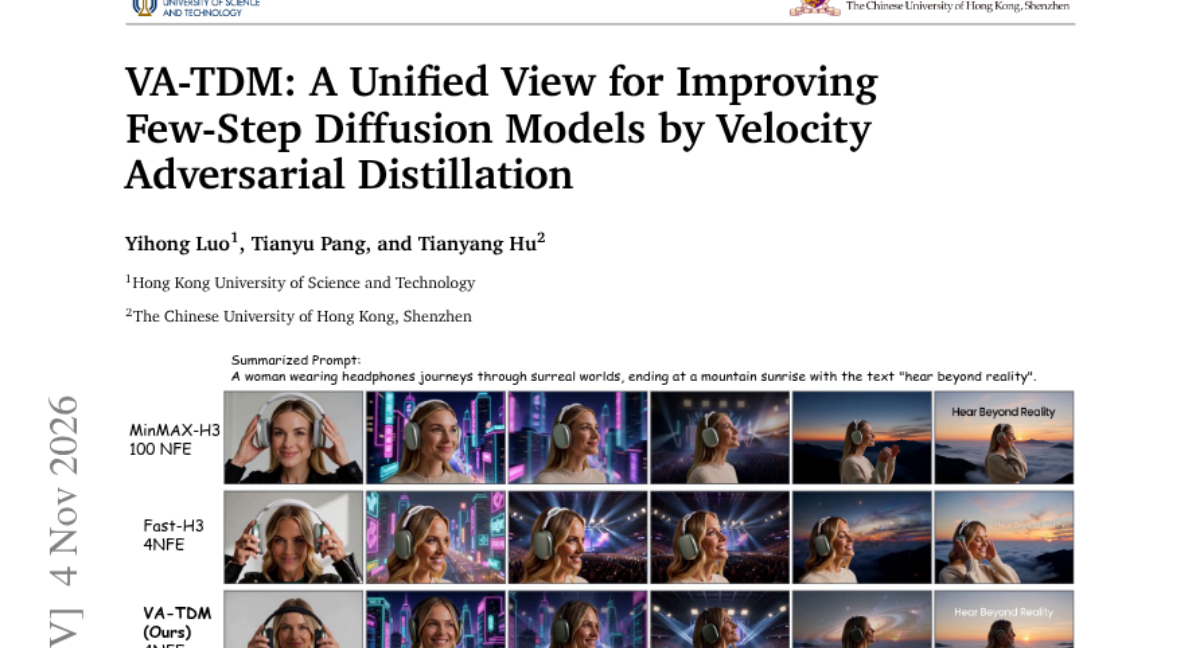
최근 적은 단계로 생성하는 증류 기법이 주목받고 있으나, 샘플링 단계가 줄어들수록 품질을 유지하는 것이 어렵습니다. 기존의 스코어 증류 방식은 학생 모델의 변화하는 분포를 정확히 추적하는 데 한계가 있습니다. 본 논문은 학생과 교사 모델의 속도장(velocity fields) 차이를 판별하는 학습된 비평가(critic)를 사용하는 VAD 방식을 제안합니다. 이를 확장한 VA-TDM은 학생의 샘플링 궤적을 따라 부분적 노이즈 제거를 감독하는 궤적 분포 매칭을 도입합니다. 실험 결과, VA-TDM은 텍스트-이미지 및 비디오 생성 분야에서 SOTA 성능을 달성하며 대규모 모델(33B)로도 효과적으로 확장됨을 입증했습니다.
핵심 결과
-
VAD(Velocity Adversarial Distillation): 비평가를 통해 학생과 교사의 속도장 차이를 피드백으로 활용하는 통합 프레임워크
-
VA-TDM: 학생의 샘플링 궤적을 고려한 전이 인식 온라인 속도 학습 및 이중 형태 VAD 감독 적용
-
SOTA 성능: 4단계 샘플링만으로도 기존 모델 대비 압도적인 이미지 및 비디오 생성 품질 달성
실무에서 볼 만한 점
적은 연산 비용(few-step)으로도 고품질 생성 모델을 구축할 수 있는 방법론을 제시하여, 실시간 생성 서비스 구현에 매우 유용합니다.
읽을 때 확인할 점
-
제시된 VAD 손실 함수를 기존 Diffusion/Flow 모델의 증류 과정에 적용해보기
-
텍스트-비디오 생성 모델의 샘플링 단계 축소 실험에 적용해보기
-
학습된 비평가(critic)가 실제 생성 품질과 얼마나 상관관계를 갖는지 검증하기