논문
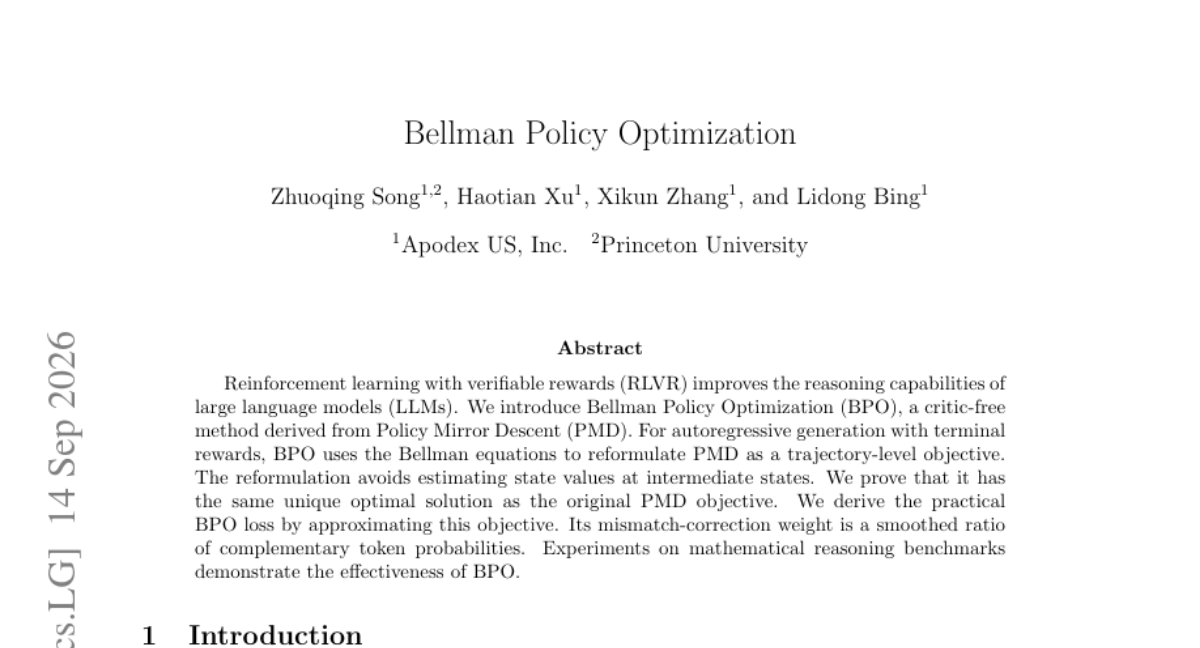
Bellman Policy Optimization
Critic 없이 Bellman 방정식을 활용하여 LLM의 추론 능력을 최적화하는 효율적인 RLVR 방법론
논문이 다루는 내용
최근 LLM의 추론 능력을 높이기 위해 검증 가능한 보상을 사용하는 RLVR 방식이 주목받고 있습니다. 기존의 Policy Mirror Descent(PMD) 방식은 중간 상태의 가치를 추정해야 하는 복잡함이 있었습니다. 본 논문은 BPO(Bellman Policy Optimization)를 제안하여 PMD를 궤적 수준의 목적 함수로 재구성함으로써 Critic 없이도 최적해를 찾을 수 있게 합니다. 이 방식은 중간 상태 가치 추정 과정을 생략하면서도 원래 PMD와 동일한 최적해를 가짐을 증명했습니다. 실험 결과, 수학적 추론 벤치마크에서 BPO의 효과가 입증되었습니다.
핵심 결과
-
Critic 없이 동작하는 Critic-free RLVR 방법론 제안
-
Bellman 방정식을 통한 PMD의 궤적 수준 목적 함수 재구성
-
중간 상태 가치 추정 없이도 원래 PMD와 동일한 최적해 보장
실무에서 볼 만한 점
가치 함수(Value Function) 학습에 필요한 복잡한 Critic 모델 없이도 LLM의 최종 보상(Terminal Reward)을 효율적으로 최적화할 수 있습니다.
읽을 때 확인할 점
-
수학적 추론 태스크에 BPO 손실 함수 적용 실험
-
기존 PPO(Critic 기반) 방식과 BPO의 학습 안정성 비교
-
토큰 확률 비율 기반의 mismatch-correction 가중치 영향도 분석