논문
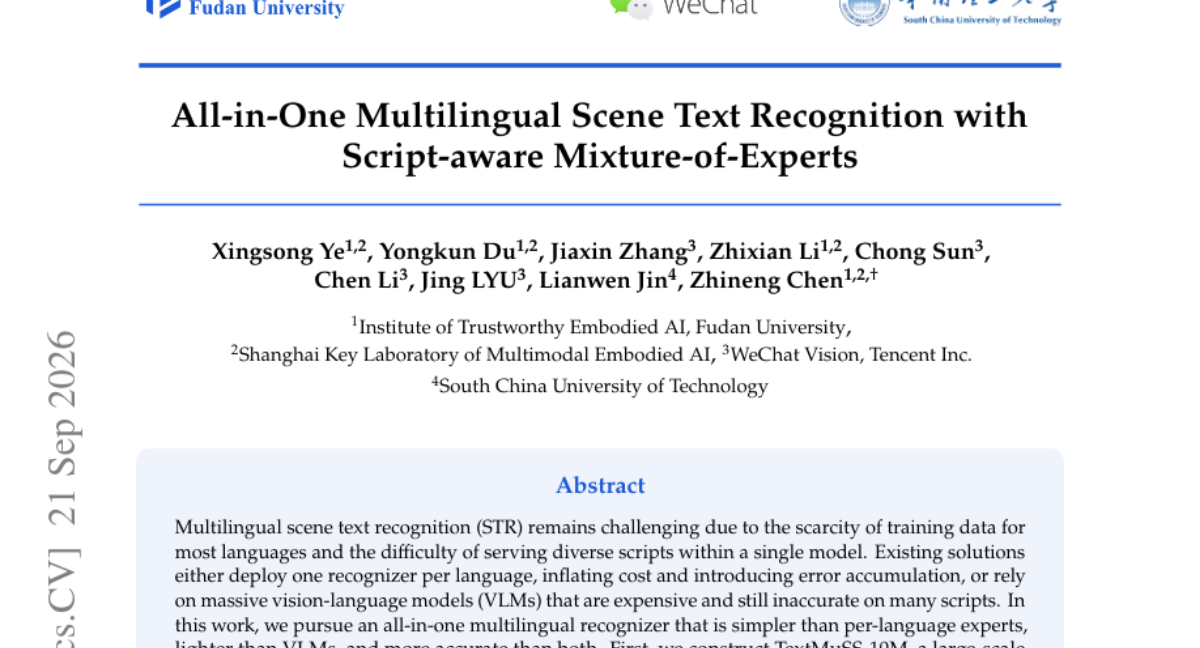
All-in-One Multilingual Scene Text Recognition with Script-aware Mixture-of-Experts
단일 모델로 수많은 언어를 처리하는 경량·고성능 다국어 장면 텍스트 인식(STR) 기술
논문이 다루는 내용
기존의 다국어 텍스트 인식 방식은 언어별로 모델을 따로 배포하여 비용이 높거나, 거대 시각-언어 모델(VLM)을 사용하여 비용 대비 정확도가 떨어지는 문제가 있었습니다. 본 논문에서는 이를 해결하기 위해 대규모 합성 데이터셋인 TextMuSS-10M을 구축하여 데이터 부족 문제를 해결했습니다. 또한, 단일 인코더와 스크립트별 전문가를 활용하는 ScriptMoE 아키텍처를 제안했습니다. 이 방식은 이미지 수준의 라우터가 적절한 전문가를 선택하고 공유 전문가가 언어 간 지식을 통합합니다. 실험 결과, 제안 모델은 기존 SOTA 모델과 VLM보다 높은 정확도를 달성하면서도 훨씬 적은 파라미터로 효율적인 성능을 보여주었습니다.
핵심 결과
-
10개 스크립트, 229개 언어를 포함하는 대규모 합성 데이터셋 TextMuSS-10M 구축
-
스크립트 인지형 MoE(ScriptMoE) 구조를 통한 효율적인 다국어 처리
-
VLM 대비 훨씬 적은 파라미터로 동등하거나 더 높은 정확도 달성
실무에서 볼 만한 점
모델 하나로 수많은 언어를 지원하면서도 VLM보다 가볍고 빠르기 때문에, 모바일이나 엣지 디바이스 환경의 다국어 OCR 서비스 구축에 매우 유용합니다.
읽을 때 확인할 점
-
제안된 ScriptMoE 구조를 기존 OCR 파이프라인에 이식하여 성능 변화 측정
-
특정 언어(희귀 스크립트)에 대한 데이터 증강 효과 검증
-
실제 서비스 환경에서의 추론 속도(Latency)와 정확도 간의 트레이드오프 분석