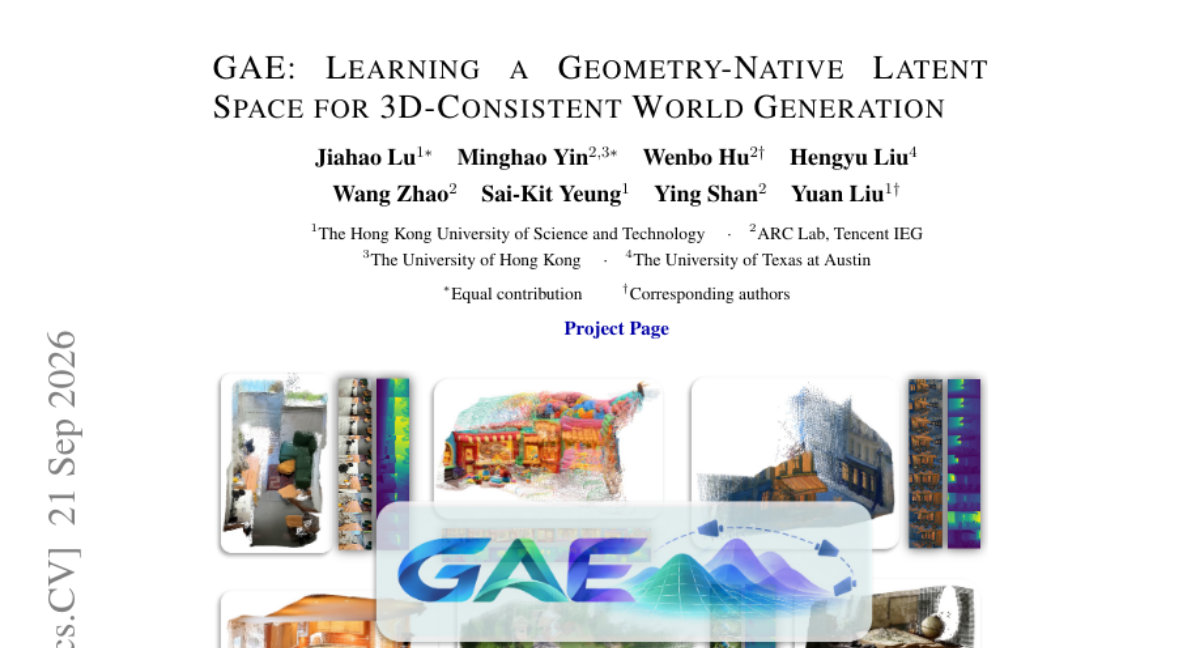
GAE: Learning a Geometry-Native Latent Space for 3D-Consistent World Generation
기하학적 구조를 내재한 잠재 공간(Latent Space) 설계를 통해 3D 일관성이 유지되는 고화질 영상 생성을 구현함
논문이 다루는 내용
기존의 시각적 생성 모델은 실사 이미지는 잘 만들지만, 3D 장면의 일관성을 유지하는 데 어려움을 겪습니다. 이는 생성 모델이 외형 중심의 잠재 공간을 사용하는 반면, 인지 모델은 기하학적 구조를 포함하는 공간을 사용하기 때문입니다. 본 논문은 기하학적 기초 모델의 특징을 생성용 잠재 공간으로 재매개변수화하는 GAE(Geometry-Native Autoencoder)를 제안합니다. GAE의 잠재 공간은 외형, 깊이, 카메라, 포인트 맵을 동시에 디코딩할 수 있는 구조를 가집니다. 실험 결과, 기존 방식 대비 시각적 품질(FVD)과 카메라 궤적 오차를 크게 개선하며 3D 일관성을 확보했습니다. 결과적으로 기하학적 잠재 공간이 인지와 생성 사이의 공통 인터페이스가 될 수 있음을 입증했습니다.
핵심 결과
-
기하학적 구조를 내재한(Geometry-native) 압축된 잠재 공간 설계
-
외형, 깊이, 카메라, 포인트 맵을 동시에 복원 가능한 통합 디코더 구조
-
인식(Perception)과 생성(Generation)을 잇는 공통의 잠재 공간 인터페이스 제안
실무에서 볼 만한 점
3D 일관성이 필수적인 디지털 트윈, 가상 환경 생성, 로봇 시뮬레이션 분야에서 생성 모델의 신뢰도를 높이는 데 중요합니다.
읽을 때 확인할 점
-
제안된 GAE 구조를 기존 Diffusion/Flow 모델의 잠재 공간에 교체 적용해보기
-
다양한 카메라 궤적 환경에서 생성된 영상의 3D 재구성 정확도 테스트
-
기하학적 특징이 외형 디테일(Texture) 생성에 미치는 영향 분석