논문
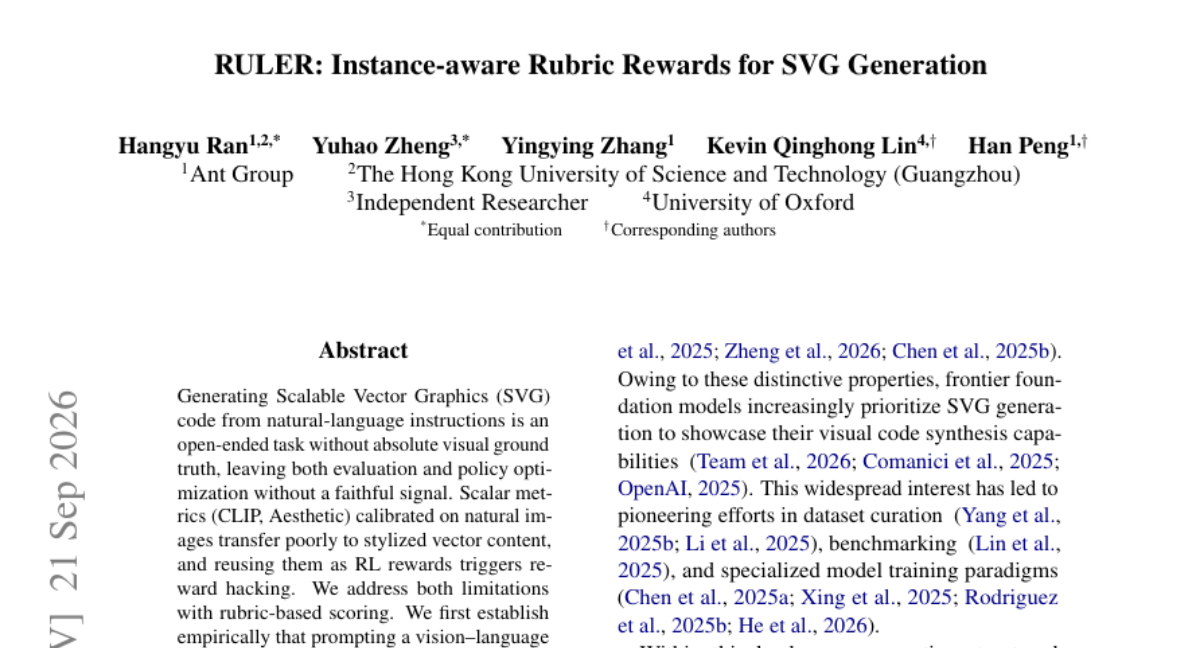
RULER: Instance-aware Rubric Rewards for SVG Generation
정답(Ground Truth)이 없는 SVG 생성 태스크를 위해 다축 루브릭 기반의 VLM 보상 체계를 구축하여 RL 성능을 극대화한 연구
논문이 다루는 내용
자연어 지시를 통한 SVG 생성은 절대적인 시각적 정답이 없어 평가와 정책 최적화가 어렵습니다. 기존의 CLIP이나 미적 점수 같은 스칼라 지표는 벡터 그래픽 특성을 반영하지 못해 보상 해킹(Reward Hacking) 문제를 야기합니다. 본 논문은 다축 루브릭을 활용한 VLM 판사(Judge)가 인간의 판단과 더 높은 상관관계를 가짐을 입증하고, 이를 기반으로 RULER 프레임워크를 제안합니다. RULER는 각 지시사항을 6가지 의미적/시각적/스타일적 항목의 루브릭으로 변환하고, GRPO를 통해 세밀한 보상을 최적화합니다. 실험 결과, RULER는 별도의 정답 쌍 없이도 기존 전문 모델을 능가하며 대규모 모델 수준의 성능을 달성했습니다.
핵심 결과
-
다축 루브릭(Multi-axis Rubric) 기반의 VLM 보상 체계 구축
-
지시문별로 최적화된 6가지 항목의 인스턴스 인식 루브릭 설계
-
정답 데이터 없이 텍스트 기반 루브릭만으로 RL 최적화 수행
실무에서 볼 만한 점
정답 데이터(Ground Truth)가 부족한 생성형 AI 태스크에서 VLM을 활용한 정교한 보상 설계가 성능 향상의 핵심임을 보여줍니다.
읽을 때 확인할 점
-
제시된 6가지 루브릭 항목을 다른 도메인(예: UI 디자인)에 적용해보기
-
GRPO와 같은 RL 알고리즘에 VLM 판사 점수를 보상으로 사용하는 파이프라인 구축
-
루브릭 항목 간의 가중치 변화가 생성 결과물에 미치는 영향 분석